
Kursus
Bekerja dengan Llama 3
2 jam
15.7K
Llama 4 Scout dipasarkan memiliki jendela konteks masif hingga 10 juta token, tetapi pelatihannya dibatasi pada ukuran masukan maksimum 256k token. Ini berarti kinerja dapat menurun dengan masukan yang lebih besar. Untuk mencegah hal ini, kita dapat menggunakan Llama 4 dengan pipeline retrieval-augmented generation (RAG).
Dalam tutorial ini, saya akan menjelaskan langkah demi langkah cara membangun pipeline RAG menggunakan ekosistem LangChain dan membuat aplikasi web yang memungkinkan pengguna mengunggah dokumen dan mengajukan pertanyaan tentangnya.
Kami terus memberi kabar terbaru kepada pembaca tentang hal-hal terkini di AI melalui The Median, buletin gratis setiap Jumat yang merangkum cerita-cerita utama pekan ini. Berlangganan dan tetap tajam hanya dalam beberapa menit setiap minggu:
Llama 4 hadir dengan jendela konteks 10 juta token, yang berarti kita dapat memberinya 100 buku dan menerima jawaban kontekstual tentang buku-buku tersebut. Namun, terlepas dari fitur yang mengesankan ini, ada alasan kuat untuk memasangkan Llama 4 dengan RAG. Berikut alasannya:
Walaupun Llama 4 mendukung jendela konteks yang sangat besar, pelatihannya dibatasi pada ukuran masukan maksimum 256k token. Kinerja model dapat menurun ketika masukan mendekati atau melampaui ambang ini. RAG mengurangi masalah ini dengan mengambil hanya informasi yang paling relevan, sehingga masukan tetap ringkas dan terfokus.
RAG memungkinkan pengambilan informasi yang sangat relevan dari basis data vektor, sehingga Llama 4 memproses masukan yang lebih kecil dan lebih terarah. Pendekatan ini meningkatkan efisiensi sekaligus akurasi.
Memproses masukan besar dengan jendela konteks penuh Llama 4 dapat sangat mahal secara komputasi. Dengan RAG, hanya data yang paling relevan yang diambil dan diproses, sehingga beban komputasi dan biaya terkaitnya berkurang signifikan.
Dalam tutorial ini, saya akan menjelaskan langkah demi langkah cara membangun pipeline retrieval-augmented generation sederhana yang memungkinkan Anda memuat berkas .docx dan mengajukan pertanyaan tentang isinya.
Pertama, kita perlu membuat kunci API GroqCloud dan menyimpannya sebagai variabel lingkungan. Selanjutnya, kita akan memasang semua paket Python yang diperlukan untuk memuat, memecah, memvektorisasi, dan mengambil konteks, serta menghasilkan respons.
%%capture
%pip install langchain
%pip install langchain-community
%pip install langchainhub
%pip install langchain-chroma
%pip install langchain-groq
%pip install langchain-huggingface
%pip install unstructured[docx]Kita akan menyiapkan objek model menggunakan API Groq dengan memberikan nama model dan kunci API. Demikian pula, kita akan mengunduh model embedding dari Hugging Face dan memuatnya sebagai model embedding kita.
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=groq_api_key)

embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1")Kita akan memuat berkas .docx dari folder root dan memecahnya menjadi potongan berukuran 1000 karakter.
from langchain_community.document_loaders import DirectoryLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter

# Initialize the text splitter
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"]
)

# Load the .docx files
loader = DirectoryLoader("./", glob="*.docx", use_multithreading=True)
documents = loader.load()

# Split the documents into chunks
chunks = text_splitter.split_documents(documents)

# Print the number of chunks
print(len(chunks))29Inisialisasi Chroma vector store dan berikan potongan teks ke basis data vektor. Teks akan diubah menjadi embedding sebelum disimpan. Setelah itu, kita akan menjalankan pencarian kemiripan untuk menguji apakah vector store kita terisi dengan benar.
from langchain_chroma import Chroma

vectorstore = Chroma.from_documents(
    documents=chunks,
    embedding=embed_model,
    persist_directory="./Vectordb",
)

query = "What is this tutorial about?"
docs = vectorstore.similarity_search(query)
print(docs[0].page_content)
Learn how to Fine-tune Stable Diffusion XL with DreamBooth and LoRA on your personal images.
Let's try another prompt:
Prompt:Selanjutnya, kita akan mengubah vector store menjadi retriever dan membuat templat prompt untuk pipeline RAG.
# Create retriever
retriever = vectorstore.as_retriever()

# Import PromptTemplate
from langchain_core.prompts import PromptTemplate

# Define a clearer, more professional prompt template
template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.

Context:
{context}

Question:
{question}

Answer:"""

# Create the PromptTemplate
rag_prompt = PromptTemplate.from_template(template)
Terakhir, kita akan membuat rantai RAG yang menyediakan konteks dan pertanyaan dalam prompt RAG, meneruskannya melalui model Llama 4, lalu menghasilkan respons yang bersih.
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
Sekarang kita akan menanyakan dokumen tersebut kepada rantai RAG.
from IPython.display import display, Markdown

response = rag_chain.invoke("What this tutorial about?")
Markdown(response)
This tutorial is about setting up and using the Janus project, specifically Janus Pro, a multimodal model that can understand images and generate images from text prompts, and building a local solution to use the model privately on a laptop GPU. It covers learning about the Janus Series, setting up the Janus project, building a Docker container to run the model locally, and testing its capabilities with various image and text prompts.Seperti yang Anda lihat, responsnya sangat akurat dan sadar konteks. Jika Anda mengalami masalah saat menjalankan kode di atas, silakan merujuk ke workbook DataLab ini: Pipeline RAG Llama 4.
Pada bagian ini, kita akan mengubah kode pipeline RAG yang telah dibahas menjadi aplikasi obrolan fungsional menggunakan paket Gradio. Untuk memulai, Anda perlu memasang Gradio menggunakan perintah pip berikut:
$ pip install gradioAplikasi ini dirancang sederhana dan mudah digunakan, memungkinkan pengguna mengunggah satu berkas .docx, beberapa berkas .docx, atau arsip .zip yang berisi berkas .docx. Pengguna kemudian dapat mengajukan pertanyaan tentang isi dari semua berkas yang diunggah, memberikan cara cepat dan efisien untuk mengambil informasi.
Fitur aplikasi:
Mari kita satukan semuanya:
main.py:
# ========== Standard Library ==========
import os
import tempfile
import zipfile
from typing import List, Optional, Tuple, Union
import collections


# ========== Third-Party Libraries ==========
import gradio as gr
from groq import Groq
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import DirectoryLoader, UnstructuredFileLoader
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

# ========== Configs ==========
TITLE = """<h1 align="center">🗨️🦙 Llama 4 Docx Chatter</h1>"""
AVATAR_IMAGES = (
    None,
    "./logo.png",
)

# Acceptable file extensions
TEXT_EXTENSIONS = [".docx", ".zip"]

# ========== Models & Clients ==========
GROQ_API_KEY = os.getenv("GROQ_API_KEY")
client = Groq(api_key=GROQ_API_KEY)
llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=GROQ_API_KEY)
embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1")

# ========== Core Components ==========
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"],
)

rag_template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.
Context:
{context}
Question:
{question}
Answer:"""
rag_prompt = PromptTemplate.from_template(rag_template)


# ========== App State ==========
class AppState:
    vectorstore: Optional[InMemoryVectorStore] = None
    rag_chain = None


state = AppState()

# ========== Utility Functions ==========


def load_documents_from_files(files: List[str]) -> List:
    """Load documents from uploaded files directly without moving."""
    all_documents = []

    # Temporary directory if ZIP needs extraction
    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                # Extract ZIP inside temp_dir
                with zipfile.ZipFile(file_path, "r") as zip_ref:
                    zip_ref.extractall(temp_dir)

                # Load all docx from extracted zip
                loader = DirectoryLoader(
                    path=temp_dir,
                    glob="**/*.docx",
                    use_multithreading=True,
                )
                docs = loader.load()
                all_documents.extend(docs)

            elif ext == ".docx":
                # Load single docx directly
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                all_documents.extend(docs)

    return all_documents


def get_last_user_message(chatbot: List[Union[gr.ChatMessage, dict]]) -> Optional[str]:
    """Get last user prompt."""
    for message in reversed(chatbot):
        content = (
            message.get("content") if isinstance(message, dict) else message.content
        )
        if (
            message.get("role") if isinstance(message, dict) else message.role
        ) == "user":
            return content
    return None


# ========== Main Logic ==========


def upload_files(
    files: Optional[List[str]], chatbot: List[Union[gr.ChatMessage, dict]]
):
    """Handle file upload - .docx or .zip containing docx."""
    if not files:
        return chatbot

    file_summaries = []  # <-- Collect formatted file/folder info
    documents = []

    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            filename = os.path.basename(file_path)
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                file_summaries.append(f"📦 **{filename}** (ZIP file) contains:")
                try:
                    with zipfile.ZipFile(file_path, "r") as zip_ref:
                        zip_ref.extractall(temp_dir)
                        zip_contents = zip_ref.namelist()

                        # Group files by folder
                        folder_map = collections.defaultdict(list)
                        for item in zip_contents:
                            if item.endswith("/"):
                                continue  # skip folder entries themselves
                            folder = os.path.dirname(item)
                            file_name = os.path.basename(item)
                            folder_map[folder].append(file_name)

                        # Format nicely
                        for folder, files_in_folder in folder_map.items():
                            if folder:
                                file_summaries.append(f"📂 {folder}/")
                            else:
                                file_summaries.append(f"📄 (root)")
                            for f in files_in_folder:
                                file_summaries.append(f"   - {f}")

                    # Load docx files extracted from ZIP
                    loader = DirectoryLoader(
                        path=temp_dir,
                        glob="**/*.docx",
                        use_multithreading=True,
                    )
                    docs = loader.load()
                    documents.extend(docs)

                except zipfile.BadZipFile:
                    chatbot.append(
                        gr.ChatMessage(
                            role="assistant",
                            content=f"❌ Failed to open ZIP file: {filename}",
                        )
                    )

            elif ext == ".docx":
                file_summaries.append(f"📄 **{filename}**")
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                documents.extend(docs)

            else:
                file_summaries.append(f"❌ Unsupported file type: {filename}")

    if not documents:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="No valid .docx files found in upload."
            )
        )
        return chatbot

    # Split documents
    chunks = text_splitter.split_documents(documents)
    if not chunks:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="Failed to split documents into chunks."
            )
        )
        return chatbot

    # Create Vectorstore
    state.vectorstore = InMemoryVectorStore.from_documents(
        documents=chunks,
        embedding=embed_model,
    )
    retriever = state.vectorstore.as_retriever()

    # Build RAG Chain
    state.rag_chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | rag_prompt
        | llm
        | StrOutputParser()
    )

    # Final display
    chatbot.append(
        gr.ChatMessage(
            role="assistant",
            content="**Uploaded Files:**\n"
            + "\n".join(file_summaries)
            + "\n\n✅ Ready to chat!",
        )
    )
    return chatbot


def user_message(
    text_prompt: str, chatbot: List[Union[gr.ChatMessage, dict]]
) -> Tuple[str, List[Union[gr.ChatMessage, dict]]]:
    """Add user's text input to conversation."""
    if text_prompt.strip():
        chatbot.append(gr.ChatMessage(role="user", content=text_prompt))
    return "", chatbot


def process_query(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Process user's query through RAG pipeline."""
    prompt = get_last_user_message(chatbot)
    if not prompt:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please type a question first.")
        )
        return chatbot

    if state.rag_chain is None:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please upload documents first.")
        )
        return chatbot

    chatbot.append(gr.ChatMessage(role="assistant", content="Thinking..."))

    try:
        response = state.rag_chain.invoke(prompt)
        chatbot[-1].content = response
    except Exception as e:
        chatbot[-1].content = f"Error: {str(e)}"

    return chatbot


def reset_app(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Reset application state."""
    state.vectorstore = None
    state.rag_chain = None
    return [
        gr.ChatMessage(
            role="assistant", content="App reset! Upload new documents to start."
        )
    ]


# ========== UI Layout ==========

with gr.Blocks(theme=gr.themes.Soft()) as demo:
    gr.HTML(TITLE)
    chatbot = gr.Chatbot(
        label="Llama 4 RAG",
        type="messages",
        bubble_full_width=False,
        avatar_images=AVATAR_IMAGES,
        scale=2,
        height=350,
    )

    with gr.Row(equal_height=True):
        text_prompt = gr.Textbox(
            placeholder="Ask a question...", show_label=False, autofocus=True, scale=28
        )
        send_button = gr.Button(
            value="Send",
            variant="primary",
            scale=1,
            min_width=80,
        )
        upload_button = gr.UploadButton(
            label="Upload",
            file_count="multiple",
            file_types=TEXT_EXTENSIONS,
            scale=1,
            min_width=80,
        )
        reset_button = gr.Button(
            value="Reset",
            variant="stop",
            scale=1,
            min_width=80,
        )

    send_button.click(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    text_prompt.submit(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    upload_button.upload(
        fn=upload_files, inputs=[upload_button, chatbot], outputs=[chatbot], queue=False
    )
    reset_button.click(fn=reset_app, inputs=[chatbot], outputs=[chatbot], queue=False)

demo.queue().launch()Sekarang, kita akan menjalankan aplikasi web dan menguji fungsinya. Untuk memulai aplikasi, jalankan perintah berikut di terminal:
$ python main.py Setelah server web aktif, buka URL berikut atau salin dan tempel secara manual ke peramban Anda untuk mengakses antarmuka web: http://127.0.0.1:7860
Berikut tampilan antarmuka obrolan kami:
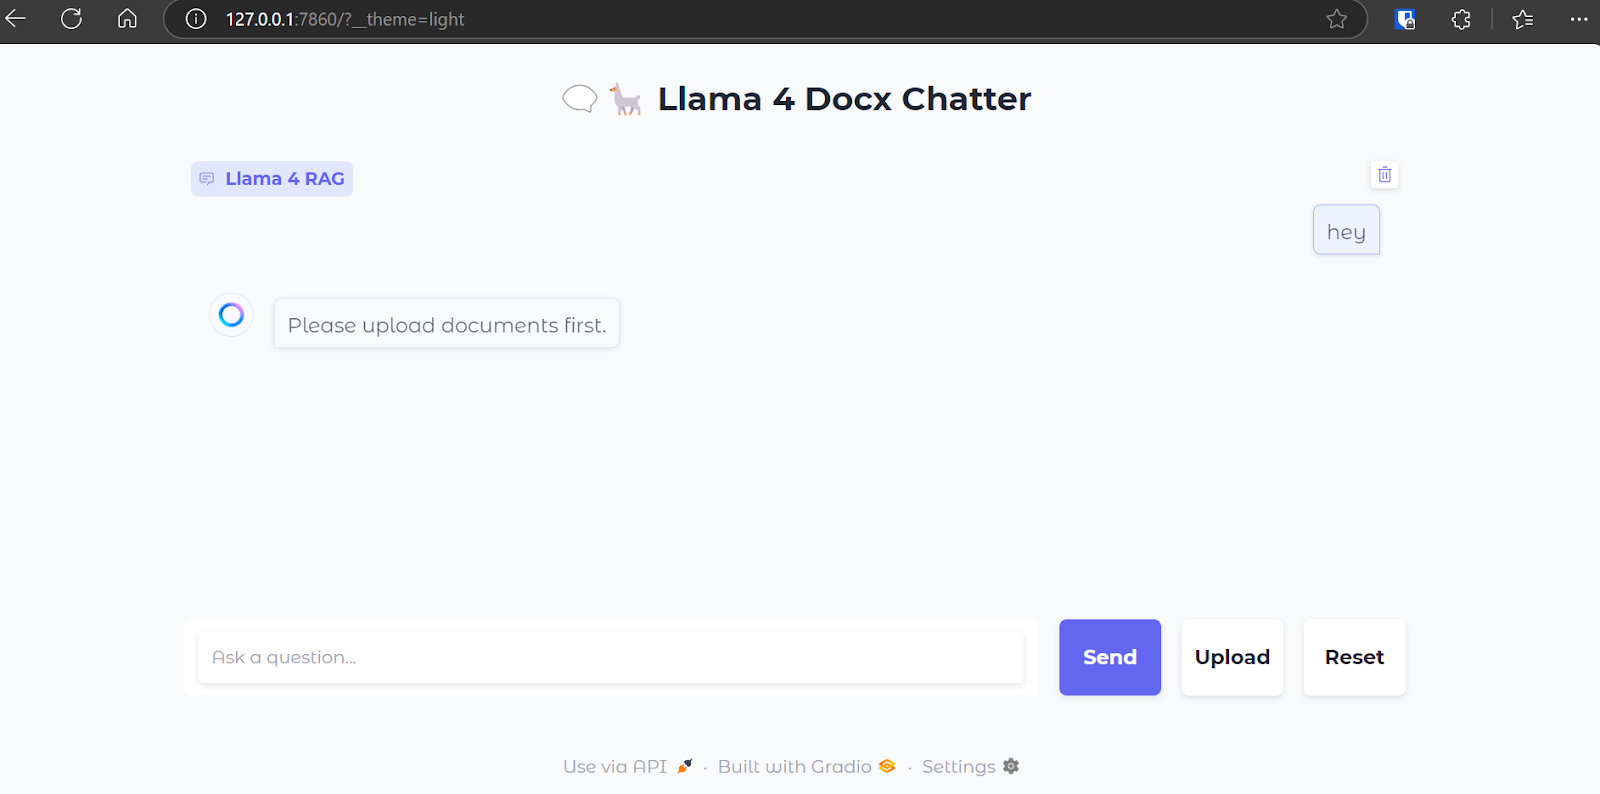
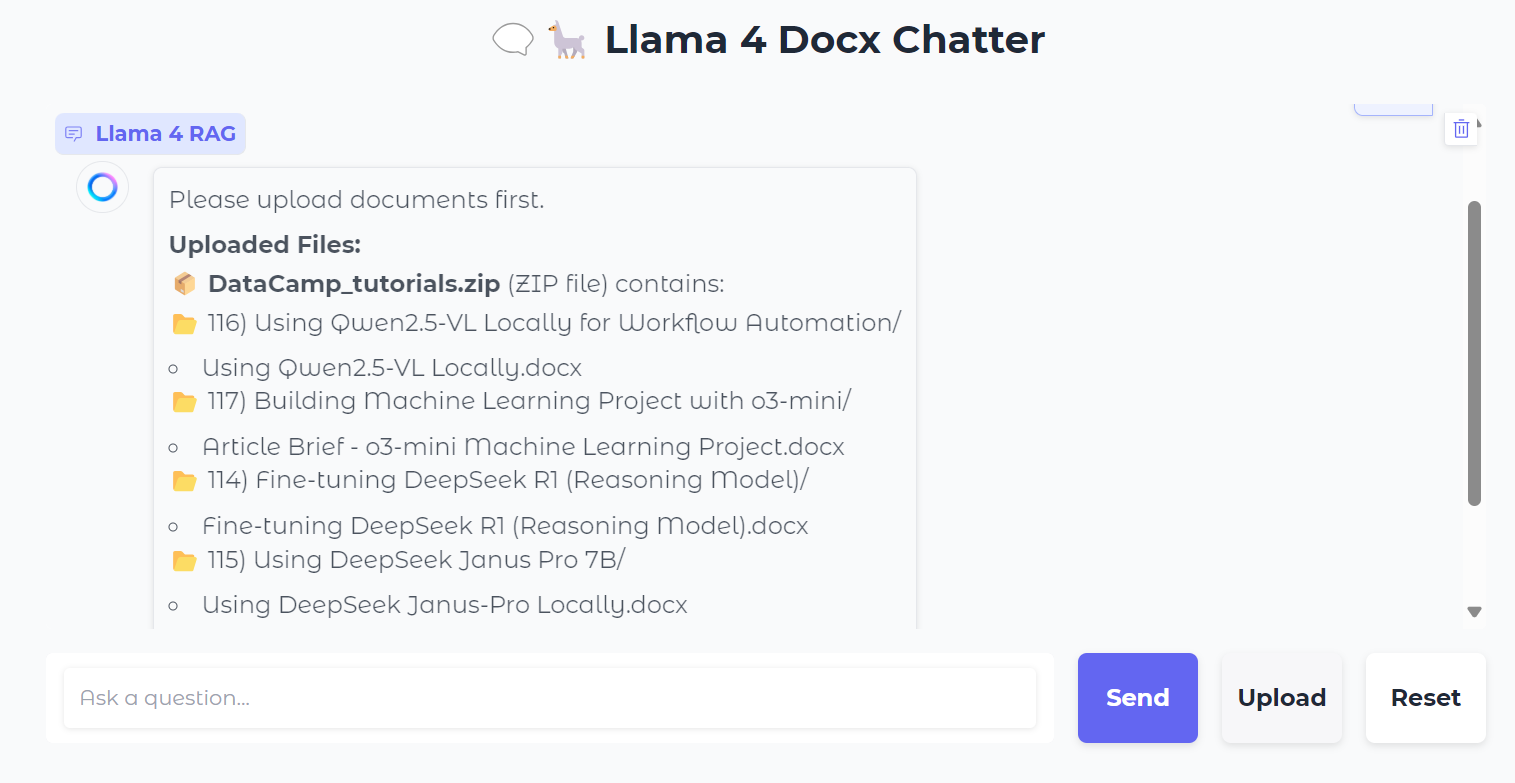
Kita akan mengunggah berkas .zip yang berisi berkas .docx, dan saat melakukannya, Anda akan melihat semua folder dan berkas di dalam berkas zip tersebut.
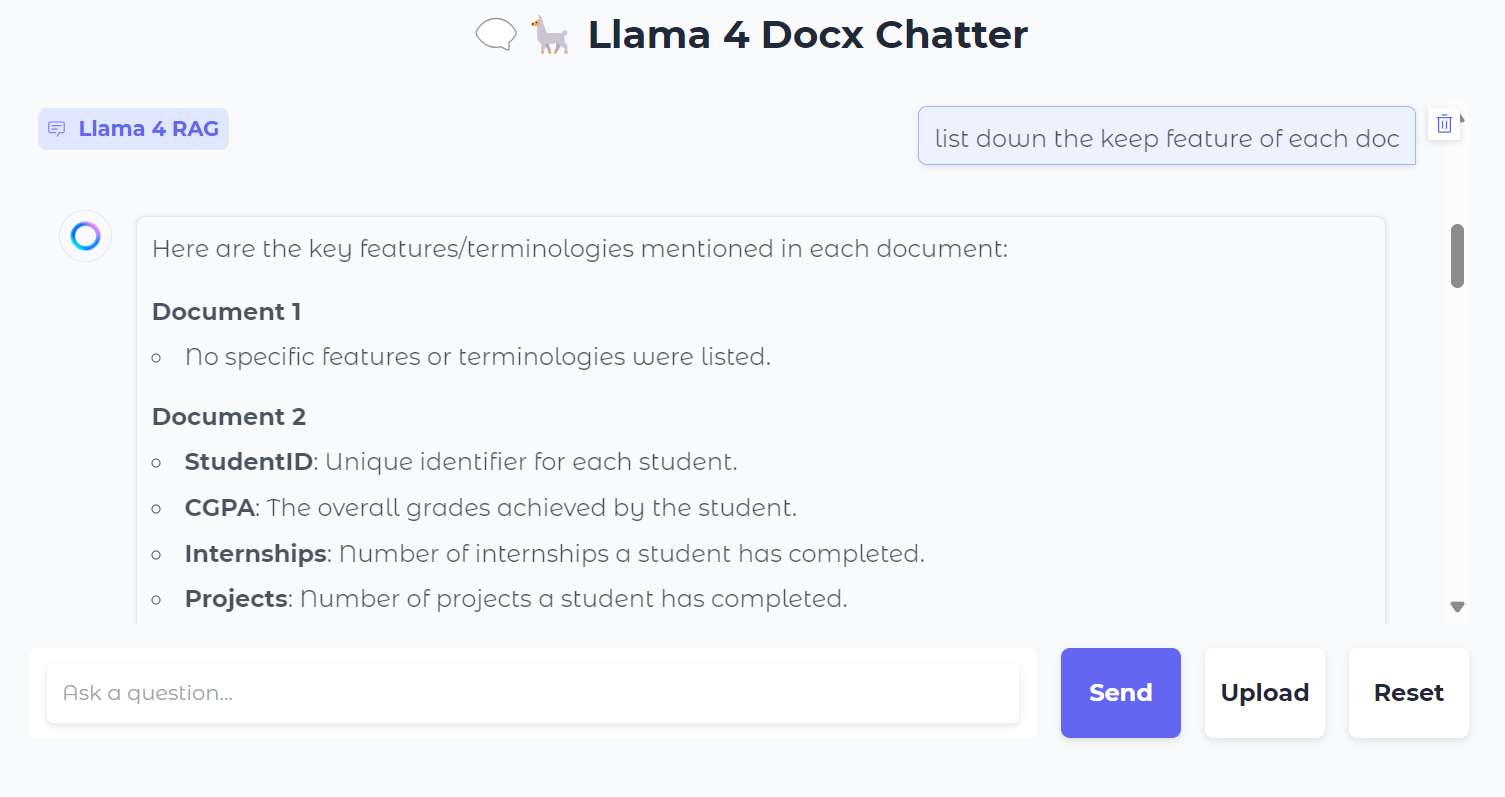
Selanjutnya, kita dapat mengajukan pertanyaan spesifik tentang dokumen-dokumen tersebut:
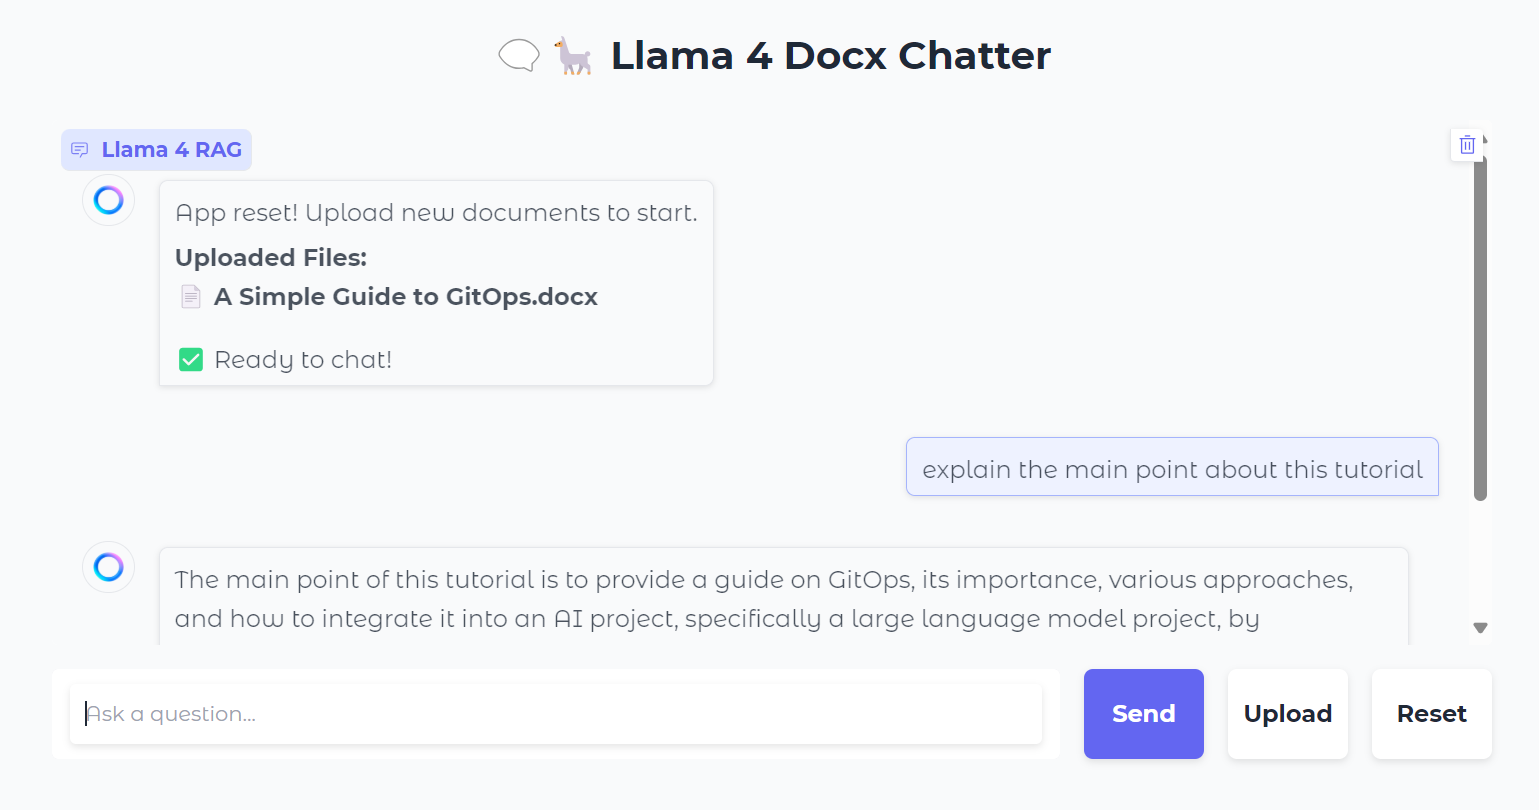
Anda juga dapat menekan tombol “Reset” untuk mengunggah berkas baru dan mengobrol tentangnya hanya dalam beberapa detik.
Setelah mengujinya secara lokal, Anda dapat dengan mudah menerapkan aplikasi web di Hugging Face Space secara gratis. Berikut tautan ke aplikasi yang sudah diterapkan: kingabzpro/Llama-4-RAG
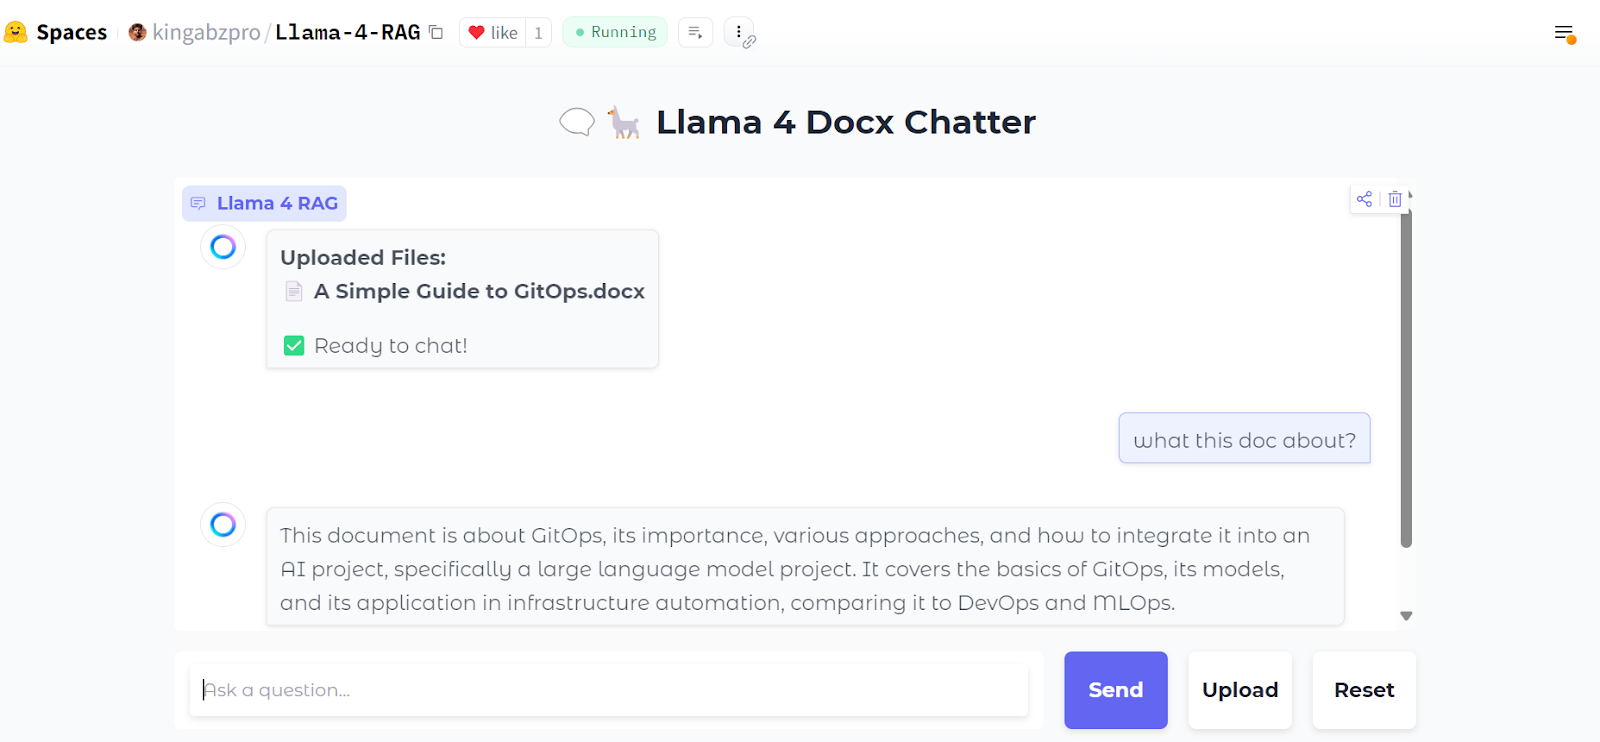
Sumber: kingabzpro/Llama-4-RAG
Kode sumber, notebook, dan berkas konfigurasi dapat ditemukan di repositori kingabzpro/Llama-4-RAG.
Bahkan dengan hadirnya model ber-jendela konteks panjang, RAG tidak akan menjadi usang. RAG tetap menjadi metode yang efisien dan hemat biaya untuk mengambil informasi dari sumber eksternal, memberikan konteks tambahan bagi model.
Selain itu, sistem RAG secara inheren lebih ekonomis untuk dioperasikan dibandingkan memberi model konteks yang sangat luas secara langsung, yang memerlukan sumber daya komputasi besar. Hal ini menjadikan RAG solusi yang praktis dan skalabel untuk banyak kasus penggunaan.
Untuk mempelajari lebih lanjut tentang Llama 4, lihat sumber berikut:
Pelajari AI lewat kursus-kursus ini!
Kursus
Kursus
Program
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



