
Corso
Lavorare con Llama 3
2 ore
15.7K
Llama 4 Scout è pubblicizzato come dotato di una finestra di contesto enorme da 10 milioni di token, ma il suo addestramento è stato limitato a una dimensione massima dell’input di 256k token. Ciò significa che le prestazioni possono degradare con input più grandi. Per evitarlo, possiamo usare Llama 4 con una pipeline di retrieval-augmented generation (RAG).
In questo tutorial, ti spiegherò passo dopo passo come costruire una pipeline RAG usando l’ecosistema LangChain e creare un’applicazione web che permetta agli utenti di caricare documenti e porre domande su di essi.
Teniamo i nostri lettori aggiornati sulle ultime novità dell’IA inviando The Median, la nostra newsletter gratuita del venerdì che riassume le notizie chiave della settimana. Iscriviti e resta al passo in pochi minuti a settimana:
Llama 4 offre una finestra di contesto da 10 milioni di token, il che significa che possiamo fornirgli 100 libri e ricevere risposte contestuali su di essi. Tuttavia, nonostante questa caratteristica impressionante, ci sono ottimi motivi per abbinare Llama 4 a RAG. Ecco perché:
Sebbene Llama 4 supporti una finestra di contesto enorme, il suo addestramento è stato limitato a un input massimo di 256k token. Le prestazioni del modello possono degradare quando gli input si avvicinano o superano questa soglia. RAG mitiga il problema recuperando solo le informazioni più rilevanti, mantenendo l’input conciso e mirato.
RAG consente di recuperare informazioni altamente pertinenti da un database vettoriale, permettendo a Llama 4 di elaborare input più piccoli e mirati. Questo approccio migliora sia l’efficienza sia l’accuratezza.
Elaborare input enormi con l’intera finestra di contesto di Llama 4 può essere costoso a livello computazionale. Con RAG, vengono recuperati ed elaborati solo i dati più rilevanti, riducendo notevolmente il carico computazionale e i costi associati.
In questo tutorial, spiegherò passo dopo passo come creare una semplice pipeline di retrieval-augmented generation che ti consenta di caricare un file .docx e fare domande sul suo contenuto.
Per prima cosa, dobbiamo creare una chiave API GroqCloud e salvarla come variabile d’ambiente. Poi installeremo tutti i pacchetti Python necessari per caricare, dividere, vettorializzare e recuperare il contesto, oltre a generare le risposte.
%%capture
%pip install langchain
%pip install langchain-community
%pip install langchainhub
%pip install langchain-chroma
%pip install langchain-groq
%pip install langchain-huggingface
%pip install unstructured[docx]Configuriamo l’oggetto modello usando l’API Groq, fornendo il nome del modello e la chiave API. Allo stesso modo, scaricheremo il modello di embedding da Hugging Face e lo caricheremo come nostro modello di embedding.
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=groq_api_key)

embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1")Caricheremo il file .docx dalla cartella radice e lo divideremo in blocchi da 1000 caratteri.
from langchain_community.document_loaders import DirectoryLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter

# Initialize the text splitter
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"]
)

# Load the .docx files
loader = DirectoryLoader("./", glob="*.docx", use_multithreading=True)
documents = loader.load()

# Split the documents into chunks
chunks = text_splitter.split_documents(documents)

# Print the number of chunks
print(len(chunks))29Inizializza il Chroma vector store e fornisci i blocchi di testo al database vettoriale. Il testo verrà convertito in embedding prima di essere archiviato. Dopodiché, eseguiremo una ricerca per similarità per verificare che il nostro vector store sia popolato correttamente.
from langchain_chroma import Chroma

vectorstore = Chroma.from_documents(
    documents=chunks,
    embedding=embed_model,
    persist_directory="./Vectordb",
)

query = "What is this tutorial about?"
docs = vectorstore.similarity_search(query)
print(docs[0].page_content)
Learn how to Fine-tune Stable Diffusion XL with DreamBooth and LoRA on your personal images.
Let's try another prompt:
Prompt:Successivamente, convertiremo il nostro vector store in un retriever e creeremo un template di prompt per la pipeline RAG.
# Create retriever
retriever = vectorstore.as_retriever()

# Import PromptTemplate
from langchain_core.prompts import PromptTemplate

# Define a clearer, more professional prompt template
template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.

Context:
{context}

Question:
{question}

Answer:"""

# Create the PromptTemplate
rag_prompt = PromptTemplate.from_template(template)
Infine, creeremo la RAG chain che fornisce sia il contesto sia la domanda nel prompt RAG, la passeremo attraverso il modello Llama 4 e poi genereremo una risposta pulita.
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
Ora chiederemo alla RAG chain informazioni sul documento.
from IPython.display import display, Markdown

response = rag_chain.invoke("What this tutorial about?")
Markdown(response)
This tutorial is about setting up and using the Janus project, specifically Janus Pro, a multimodal model that can understand images and generate images from text prompts, and building a local solution to use the model privately on a laptop GPU. It covers learning about the Janus Series, setting up the Janus project, building a Docker container to run the model locally, and testing its capabilities with various image and text prompts.Come puoi vedere, la risposta è estremamente accurata e sensibile al contesto. Se riscontri problemi nell’esecuzione del codice sopra, fai riferimento a questo workbook DataLab: Llama 4 RAG pipeline.
In questa sezione, trasformeremo il codice della pipeline RAG vista in precedenza in un’app di chat funzionante usando il pacchetto Gradio. Per iniziare, devi installare Gradio con il seguente comando pip:
$ pip install gradioL’applicazione è pensata per essere semplice e intuitiva, consentendo di caricare un singolo file .docx, più file .docx o un archivio .zip contenente file .docx. È poi possibile porre domande sui contenuti di tutti i file caricati, ottenendo un modo rapido ed efficiente per recuperare informazioni.
L’app offre:
Mettiamo tutto insieme:
main.py:
# ========== Standard Library ==========
import os
import tempfile
import zipfile
from typing import List, Optional, Tuple, Union
import collections


# ========== Third-Party Libraries ==========
import gradio as gr
from groq import Groq
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import DirectoryLoader, UnstructuredFileLoader
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

# ========== Configs ==========
TITLE = """<h1 align="center">🗨️🦙 Llama 4 Docx Chatter</h1>"""
AVATAR_IMAGES = (
    None,
    "./logo.png",
)

# Acceptable file extensions
TEXT_EXTENSIONS = [".docx", ".zip"]

# ========== Models & Clients ==========
GROQ_API_KEY = os.getenv("GROQ_API_KEY")
client = Groq(api_key=GROQ_API_KEY)
llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=GROQ_API_KEY)
embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1")

# ========== Core Components ==========
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"],
)

rag_template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.
Context:
{context}
Question:
{question}
Answer:"""
rag_prompt = PromptTemplate.from_template(rag_template)


# ========== App State ==========
class AppState:
    vectorstore: Optional[InMemoryVectorStore] = None
    rag_chain = None


state = AppState()

# ========== Utility Functions ==========


def load_documents_from_files(files: List[str]) -> List:
    """Load documents from uploaded files directly without moving."""
    all_documents = []

    # Temporary directory if ZIP needs extraction
    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                # Extract ZIP inside temp_dir
                with zipfile.ZipFile(file_path, "r") as zip_ref:
                    zip_ref.extractall(temp_dir)

                # Load all docx from extracted zip
                loader = DirectoryLoader(
                    path=temp_dir,
                    glob="**/*.docx",
                    use_multithreading=True,
                )
                docs = loader.load()
                all_documents.extend(docs)

            elif ext == ".docx":
                # Load single docx directly
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                all_documents.extend(docs)

    return all_documents


def get_last_user_message(chatbot: List[Union[gr.ChatMessage, dict]]) -> Optional[str]:
    """Get last user prompt."""
    for message in reversed(chatbot):
        content = (
            message.get("content") if isinstance(message, dict) else message.content
        )
        if (
            message.get("role") if isinstance(message, dict) else message.role
        ) == "user":
            return content
    return None


# ========== Main Logic ==========


def upload_files(
    files: Optional[List[str]], chatbot: List[Union[gr.ChatMessage, dict]]
):
    """Handle file upload - .docx or .zip containing docx."""
    if not files:
        return chatbot

    file_summaries = []  # <-- Collect formatted file/folder info
    documents = []

    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            filename = os.path.basename(file_path)
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                file_summaries.append(f"📦 **{filename}** (ZIP file) contains:")
                try:
                    with zipfile.ZipFile(file_path, "r") as zip_ref:
                        zip_ref.extractall(temp_dir)
                        zip_contents = zip_ref.namelist()

                        # Group files by folder
                        folder_map = collections.defaultdict(list)
                        for item in zip_contents:
                            if item.endswith("/"):
                                continue  # skip folder entries themselves
                            folder = os.path.dirname(item)
                            file_name = os.path.basename(item)
                            folder_map[folder].append(file_name)

                        # Format nicely
                        for folder, files_in_folder in folder_map.items():
                            if folder:
                                file_summaries.append(f"📂 {folder}/")
                            else:
                                file_summaries.append(f"📄 (root)")
                            for f in files_in_folder:
                                file_summaries.append(f"   - {f}")

                    # Load docx files extracted from ZIP
                    loader = DirectoryLoader(
                        path=temp_dir,
                        glob="**/*.docx",
                        use_multithreading=True,
                    )
                    docs = loader.load()
                    documents.extend(docs)

                except zipfile.BadZipFile:
                    chatbot.append(
                        gr.ChatMessage(
                            role="assistant",
                            content=f"❌ Failed to open ZIP file: {filename}",
                        )
                    )

            elif ext == ".docx":
                file_summaries.append(f"📄 **{filename}**")
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                documents.extend(docs)

            else:
                file_summaries.append(f"❌ Unsupported file type: {filename}")

    if not documents:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="No valid .docx files found in upload."
            )
        )
        return chatbot

    # Split documents
    chunks = text_splitter.split_documents(documents)
    if not chunks:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="Failed to split documents into chunks."
            )
        )
        return chatbot

    # Create Vectorstore
    state.vectorstore = InMemoryVectorStore.from_documents(
        documents=chunks,
        embedding=embed_model,
    )
    retriever = state.vectorstore.as_retriever()

    # Build RAG Chain
    state.rag_chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | rag_prompt
        | llm
        | StrOutputParser()
    )

    # Final display
    chatbot.append(
        gr.ChatMessage(
            role="assistant",
            content="**Uploaded Files:**\n"
            + "\n".join(file_summaries)
            + "\n\n✅ Ready to chat!",
        )
    )
    return chatbot


def user_message(
    text_prompt: str, chatbot: List[Union[gr.ChatMessage, dict]]
) -> Tuple[str, List[Union[gr.ChatMessage, dict]]]:
    """Add user's text input to conversation."""
    if text_prompt.strip():
        chatbot.append(gr.ChatMessage(role="user", content=text_prompt))
    return "", chatbot


def process_query(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Process user's query through RAG pipeline."""
    prompt = get_last_user_message(chatbot)
    if not prompt:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please type a question first.")
        )
        return chatbot

    if state.rag_chain is None:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please upload documents first.")
        )
        return chatbot

    chatbot.append(gr.ChatMessage(role="assistant", content="Thinking..."))

    try:
        response = state.rag_chain.invoke(prompt)
        chatbot[-1].content = response
    except Exception as e:
        chatbot[-1].content = f"Error: {str(e)}"

    return chatbot


def reset_app(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Reset application state."""
    state.vectorstore = None
    state.rag_chain = None
    return [
        gr.ChatMessage(
            role="assistant", content="App reset! Upload new documents to start."
        )
    ]


# ========== UI Layout ==========

with gr.Blocks(theme=gr.themes.Soft()) as demo:
    gr.HTML(TITLE)
    chatbot = gr.Chatbot(
        label="Llama 4 RAG",
        type="messages",
        bubble_full_width=False,
        avatar_images=AVATAR_IMAGES,
        scale=2,
        height=350,
    )

    with gr.Row(equal_height=True):
        text_prompt = gr.Textbox(
            placeholder="Ask a question...", show_label=False, autofocus=True, scale=28
        )
        send_button = gr.Button(
            value="Send",
            variant="primary",
            scale=1,
            min_width=80,
        )
        upload_button = gr.UploadButton(
            label="Upload",
            file_count="multiple",
            file_types=TEXT_EXTENSIONS,
            scale=1,
            min_width=80,
        )
        reset_button = gr.Button(
            value="Reset",
            variant="stop",
            scale=1,
            min_width=80,
        )

    send_button.click(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    text_prompt.submit(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    upload_button.upload(
        fn=upload_files, inputs=[upload_button, chatbot], outputs=[chatbot], queue=False
    )
    reset_button.click(fn=reset_app, inputs=[chatbot], outputs=[chatbot], queue=False)

demo.queue().launch()Ora eseguiremo l’applicazione web e testeremo le sue funzionalità. Per avviare l’applicazione, esegui il seguente comando nel terminale:
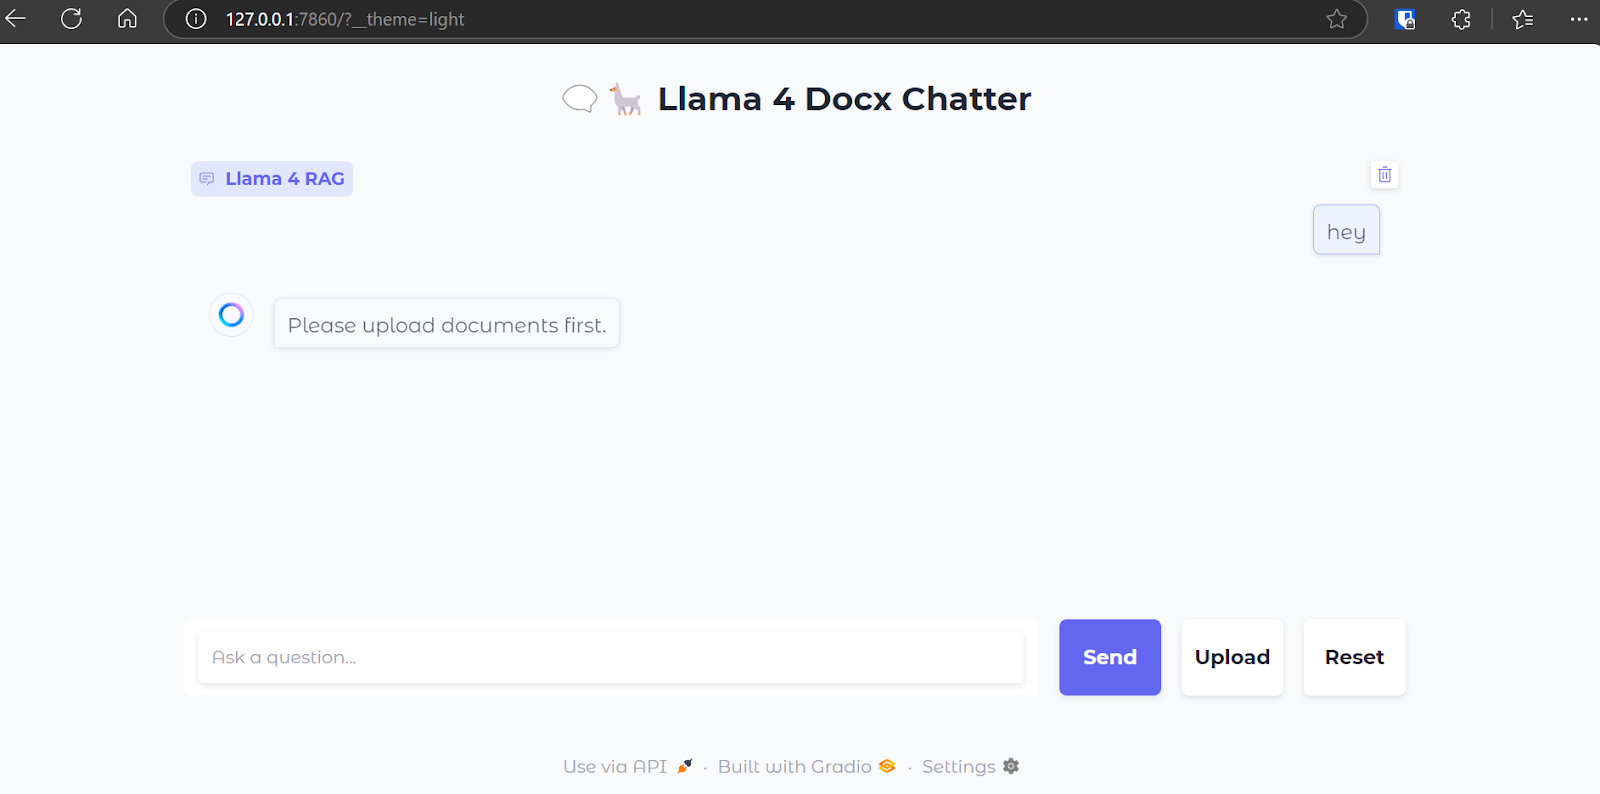
$ python main.py Una volta che il server web è attivo, vai al seguente URL o copialo e incollalo manualmente nel browser per accedere all’interfaccia web: http://127.0.0.1:7860
Ecco come appare la nostra interfaccia di chat:
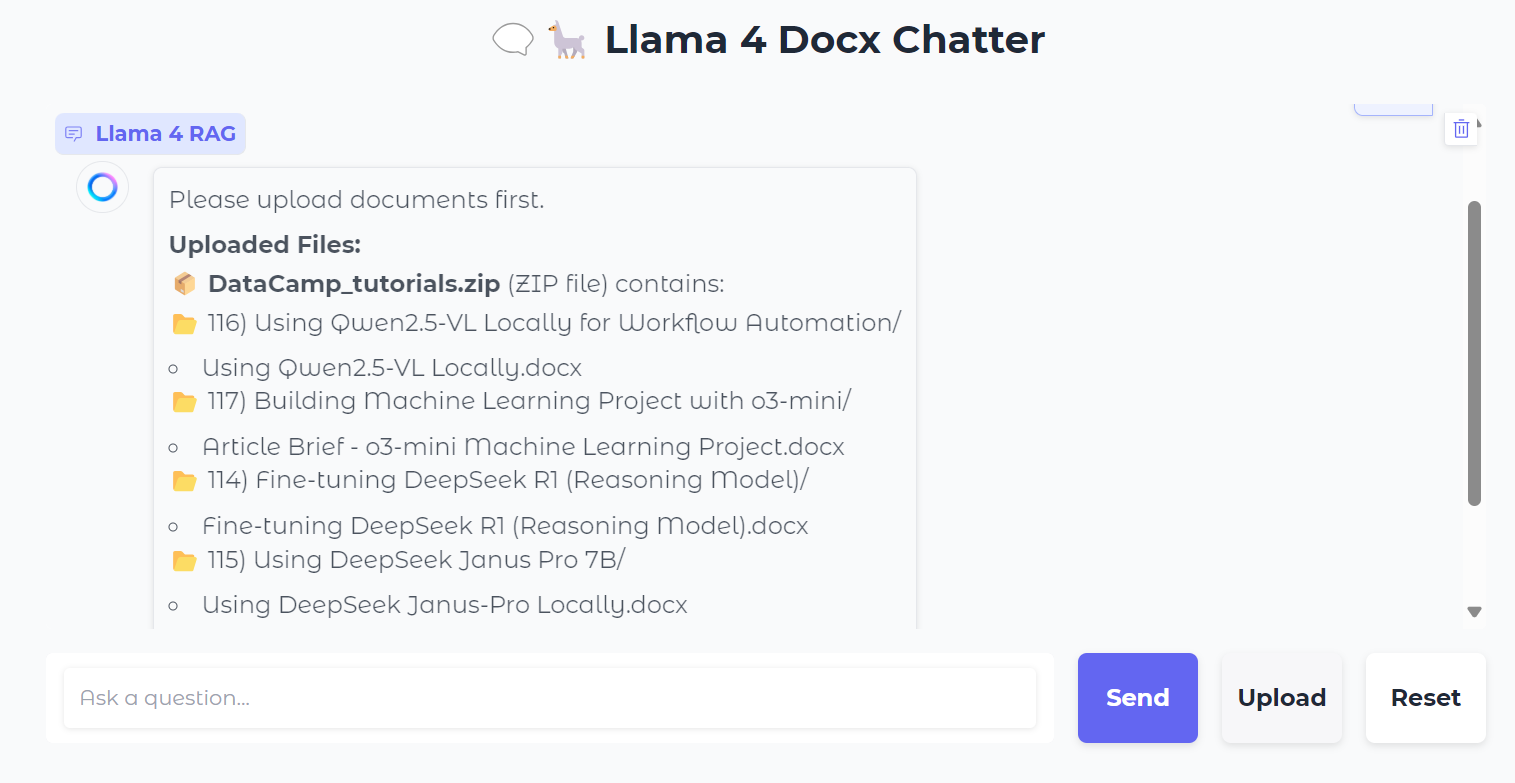
Caricheremo un file .zip contenente file .docx e, durante il caricamento, vedrai tutte le cartelle e i file presenti nell’archivio.
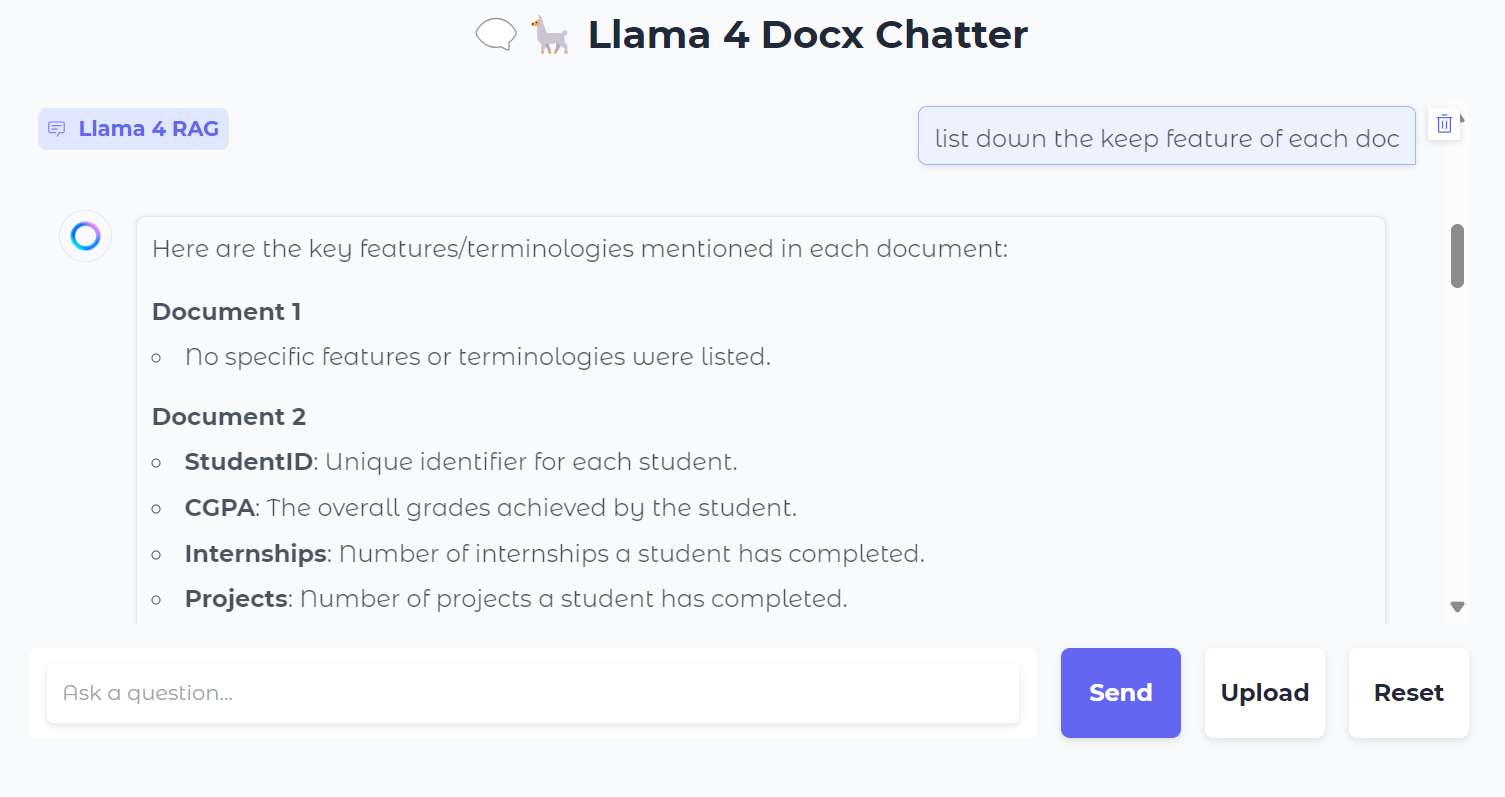
Successivamente, possiamo fare domande specifiche sui documenti:
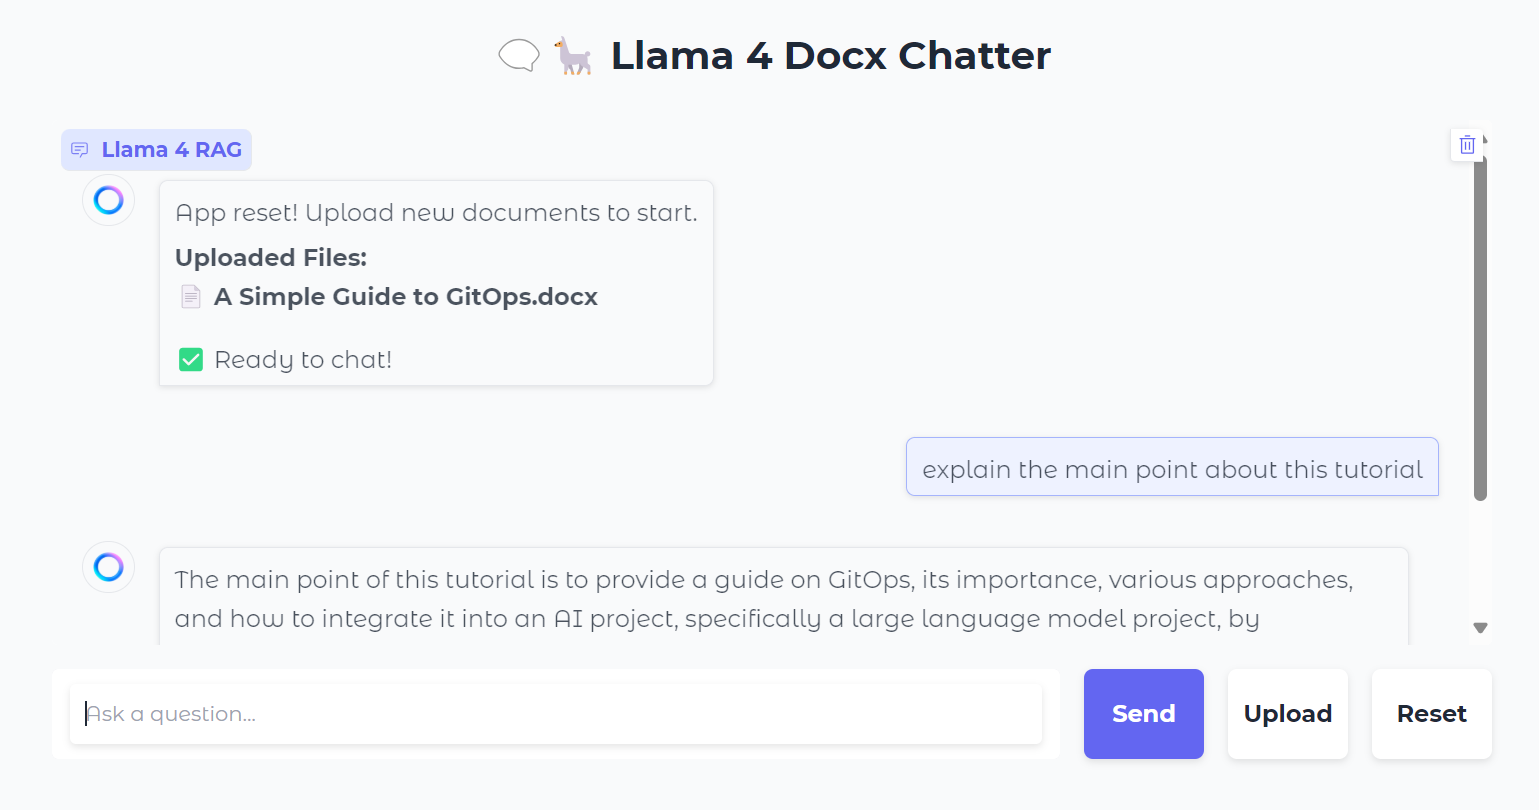
Puoi anche premere il pulsante “Reset” per caricare un nuovo file e chattare a riguardo in pochi secondi.
Dopo averla testata in locale, puoi distribuire facilmente l’app web su Hugging Face Space gratuitamente. Ecco il link all’app distribuita: kingabzpro/Llama-4-RAG
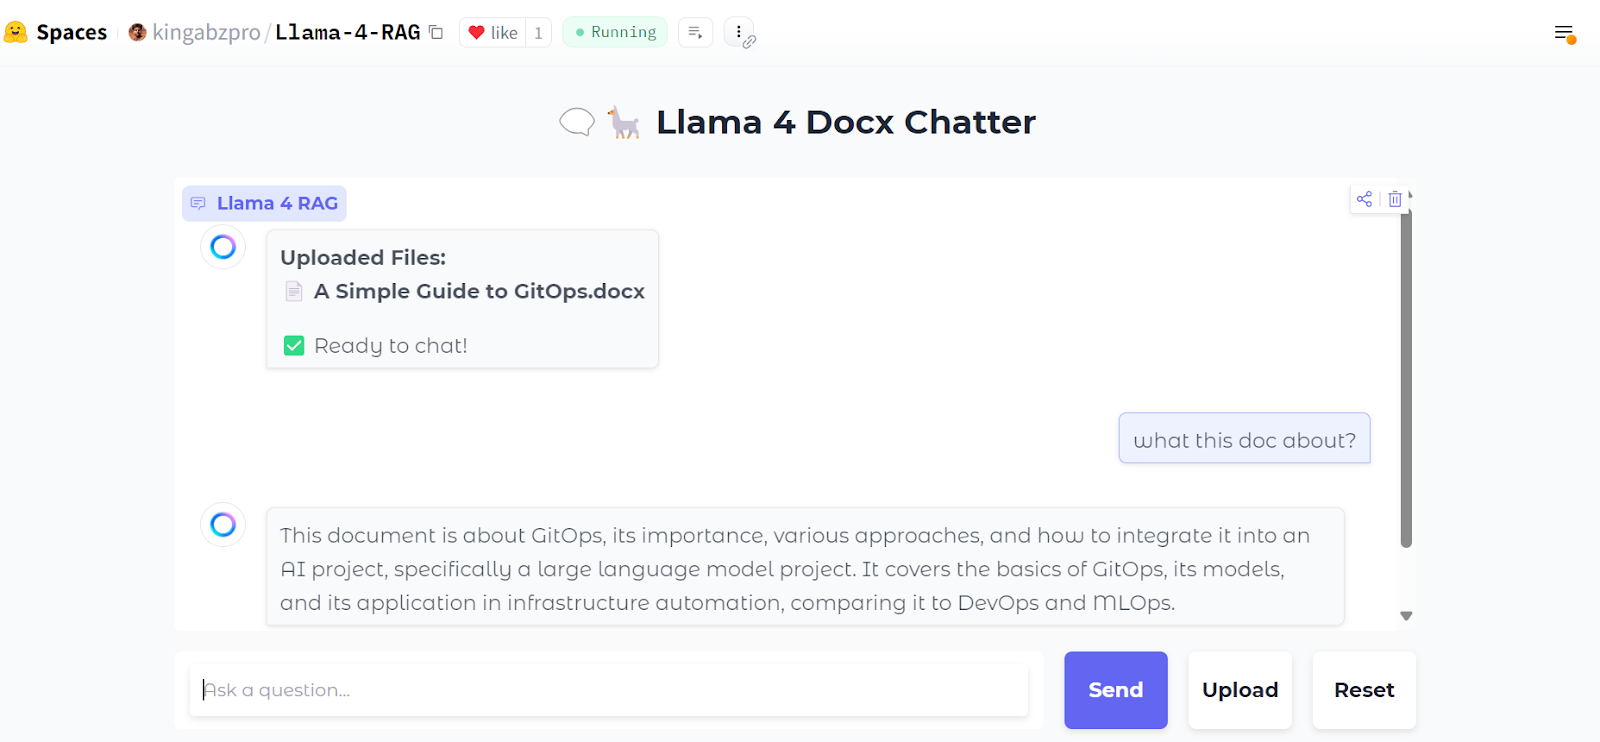
Fonte: kingabzpro/Llama-4-RAG
Il codice sorgente, il notebook e i file di configurazione sono disponibili nel repository kingabzpro/Llama-4-RAG.
Anche con l’arrivo di modelli con finestre di contesto lunghe, RAG non diventerà mai obsoleto. RAG resta un metodo efficiente ed economico per recuperare informazioni da risorse esterne, fornendo contesto aggiuntivo ai modelli.
Inoltre, i sistemi RAG sono intrinsecamente più economici da gestire rispetto a fornire un contesto esteso direttamente a un modello, operazione che richiede notevoli risorse computazionali. Questo rende RAG una soluzione pratica e scalabile per molti casi d’uso.
Per saperne di più su Llama 4, dai un’occhiata a queste risorse:
Impara l’IA con questi corsi!
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



