
कोर्स
Llama 3 के साथ काम करना
2 घंटा
15.5K
Llama 4 Scout को 10 मिलियन टोकन के बड़े संदर्भ विंडो के रूप में मार्केट किया जाता है, लेकिन इसका प्रशिक्षण अधिकतम 256k टोकन इनपुट तक सीमित था। इसका मतलब है कि बड़े इनपुट पर प्रदर्शन गिर सकता है। इसे रोकने के लिए, हम retrieval-augmented generation (RAG) पाइपलाइन के साथ Llama 4 का उपयोग कर सकते हैं।
इस ट्यूटोरियल में, मैं चरण-दर-चरण समझाऊंगा कि LangChain इकोसिस्टम का उपयोग करके RAG पाइपलाइन कैसे बनाएं और एक वेब एप्लिकेशन कैसे तैयार करें, जिसमें उपयोगकर्ता दस्तावेज़ अपलोड कर सकें और उनके बारे में प्रश्न पूछ सकें।
हम अपने पाठकों को AI की ताज़ा जानकारी के साथ अपडेट रखते हैं, The Median भेजकर—हमारा निःशुल्क शुक्रवार का न्यूज़लेटर जो हफ्ते की प्रमुख खबरों को सरलता से प्रस्तुत करता है। सदस्यता लें और हर हफ्ते कुछ ही मिनटों में अपडेट रहें:
Llama 4 में 10 मिलियन टोकन का संदर्भ विंडो आता है, यानी हम इसे 100 किताबें फीड कर सकते हैं और उनके बारे में संदर्भित उत्तर प्राप्त कर सकते हैं। हालांकि यह फीचर प्रभावशाली है, फिर भी Llama 4 को RAG के साथ जोड़ने के ठोस कारण हैं। कारण ये हैं:
भले ही Llama 4 बड़े संदर्भ विंडो को सपोर्ट करता है, इसका प्रशिक्षण अधिकतम 256k टोकन इनपुट तक सीमित था। जब इनपुट इस सीमा के पास या उससे अधिक हो जाते हैं, तो मॉडल का प्रदर्शन घट सकता है। RAG केवल सबसे प्रासंगिक जानकारी को प्राप्त कर इस समस्या को कम करता है, जिससे इनपुट संक्षिप्त और केंद्रित रहता है।
RAG एक vector database से अत्यधिक प्रासंगिक जानकारी प्राप्त करने में सक्षम बनाता है, जिससे Llama 4 छोटे और अधिक लक्षित इनपुट प्रोसेस करता है। यह तरीका दक्षता और शुद्धता दोनों को बेहतर बनाता है।
Llama 4 के पूर्ण संदर्भ विंडो के साथ विशाल इनपुट प्रोसेस करना कम्प्यूटेशनल रूप से महंगा हो सकता है। RAG का उपयोग करके, केवल सबसे प्रासंगिक डेटा ही निकाला और प्रोसेस किया जाता है, जिससे कम्प्यूटेशनल लोड और संबंधित लागतें काफी कम हो जाती हैं।
इस ट्यूटोरियल में, मैं चरण-दर-चरण समझाऊंगा कि एक सरल retrieval-augmented generation पाइपलाइन कैसे बनाई जाए, जिसमें आप एक .docx फ़ाइल लोड कर सकें और उसकी सामग्री पर प्रश्न पूछ सकें।
सबसे पहले, हमें एक GroqCloud API कुंजी बनानी है और उसे एक environment variable के रूप में सहेजना है। अगला, हम वे सभी आवश्यक Python पैकेज इंस्टॉल करेंगे जो संदर्भ को लोड, विभाजित, वेक्टराइज़ और रिट्रीव करने के साथ-साथ प्रतिक्रियाएँ जनरेट करने के लिए जरूरी हैं।
%%capture
%pip install langchain
%pip install langchain-community
%pip install langchainhub
%pip install langchain-chroma
%pip install langchain-groq
%pip install langchain-huggingface
%pip install unstructured[docx]हम Groq API का उपयोग करके मॉडल ऑब्जेक्ट सेट करेंगे, जिसमें मॉडल का नाम और API कुंजी दी जाएगी। इसी तरह, हम Hugging Face से एम्बेडिंग मॉडल डाउनलोड करेंगे और उसे अपने एम्बेडिंग मॉडल के रूप में लोड करेंगे।
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=groq_api_key)

embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1")हम रूट फ़ोल्डर से .docx फ़ाइल लोड करेंगे और उसे 1000 अक्षरों के खंडों में विभाजित करेंगे।
from langchain_community.document_loaders import DirectoryLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter

# Initialize the text splitter
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"]
)

# Load the .docx files
loader = DirectoryLoader("./", glob="*.docx", use_multithreading=True)
documents = loader.load()

# Split the documents into chunks
chunks = text_splitter.split_documents(documents)

# Print the number of chunks
print(len(chunks))29Chroma वेक्टर स्टोर इनिशियलाइज़ करें और टेक्स्ट खंडों को वेक्टर डेटाबेस में दें। स्टोर करने से पहले टेक्स्ट को एम्बेडिंग्स में बदला जाएगा। उसके बाद, हम समानता खोज चलाएंगे ताकि जाँचा जा सके कि हमारा वेक्टर स्टोर ठीक से भरा हुआ है या नहीं।
from langchain_chroma import Chroma

vectorstore = Chroma.from_documents(
    documents=chunks,
    embedding=embed_model,
    persist_directory="./Vectordb",
)

query = "What is this tutorial about?"
docs = vectorstore.similarity_search(query)
print(docs[0].page_content)
Learn how to Fine-tune Stable Diffusion XL with DreamBooth and LoRA on your personal images.
Let's try another prompt:
Prompt:अब हम अपने वेक्टर स्टोर को एक रिट्रीवर में बदलेंगे और RAG पाइपलाइन के लिए एक प्रॉम्प्ट टेम्पलेट बनाएंगे।
# Create retriever
retriever = vectorstore.as_retriever()

# Import PromptTemplate
from langchain_core.prompts import PromptTemplate

# Define a clearer, more professional prompt template
template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.

Context:
{context}

Question:
{question}

Answer:"""

# Create the PromptTemplate
rag_prompt = PromptTemplate.from_template(template)
अंत में, हम RAG चेन बनाएंगे जो RAG प्रॉम्प्ट में संदर्भ और प्रश्न दोनों प्रदान करती है, उसे Llama 4 मॉडल से पास करती है, और फिर एक साफ-सुथरा उत्तर जनरेट करती है।
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
अब हम दस्तावेज़ के बारे में RAG चेन से प्रश्न पूछेंगे।
from IPython.display import display, Markdown

response = rag_chain.invoke("What this tutorial about?")
Markdown(response)
This tutorial is about setting up and using the Janus project, specifically Janus Pro, a multimodal model that can understand images and generate images from text prompts, and building a local solution to use the model privately on a laptop GPU. It covers learning about the Janus Series, setting up the Janus project, building a Docker container to run the model locally, and testing its capabilities with various image and text prompts.जैसा कि आप देख सकते हैं, प्रतिक्रिया अत्यंत सटीक और संदर्भ-सचेत है। यदि उपरोक्त कोड चलाने में कोई समस्या आती है, तो इस DataLab वर्कबुक को देखें: Llama 4 RAG पाइपलाइन।
इस खंड में, हम ऊपर बताई गई RAG पाइपलाइन के कोड को Gradio पैकेज का उपयोग करते हुए एक कार्यशील चैट एप्लिकेशन में बदलेंगे। शुरू करने के लिए, आपको निम्न pip कमांड से Gradio इंस्टॉल करना होगा:
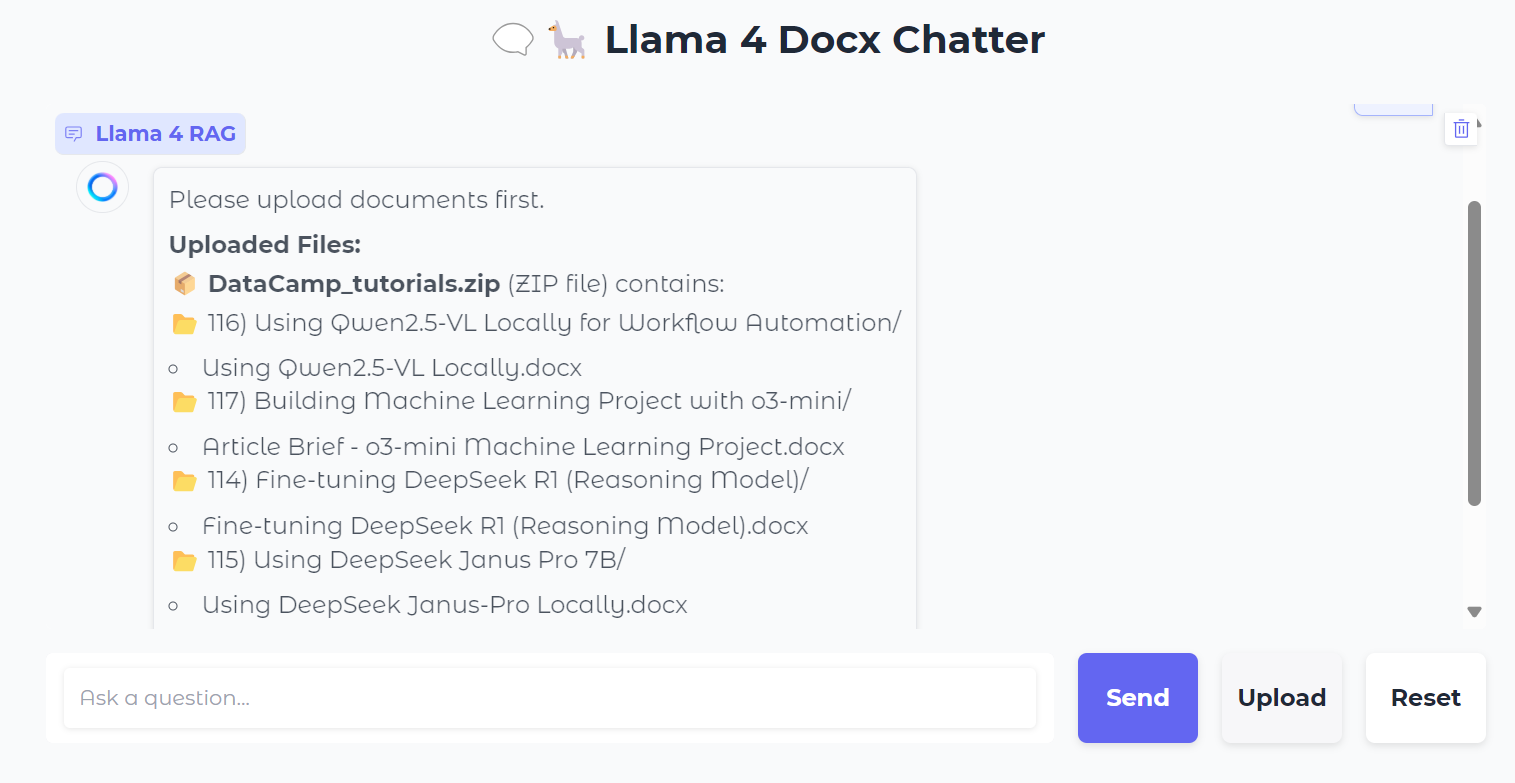
$ pip install gradioएप्लिकेशन सरल और उपयोगकर्ता-मित्रवत बनाया गया है, जिससे उपयोगकर्ता एकल .docx फ़ाइल, कई .docx फ़ाइलें, या .docx फ़ाइलों वाला .zip आर्काइव अपलोड कर सकते हैं। इसके बाद उपयोगकर्ता सभी अपलोड की गई फ़ाइलों की सामग्री पर प्रश्न पूछ सकते हैं, जिससे जानकारी तेजी और कुशलता से प्राप्त होती है।
एप्लिकेशन की प्रमुख विशेषताएँ:
आइए सब कुछ एक साथ रख दें:
main.py:
# ========== Standard Library ==========
import os
import tempfile
import zipfile
from typing import List, Optional, Tuple, Union
import collections


# ========== Third-Party Libraries ==========
import gradio as gr
from groq import Groq
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import DirectoryLoader, UnstructuredFileLoader
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

# ========== Configs ==========
TITLE = """<h1 align="center">🗨️🦙 Llama 4 Docx Chatter</h1>"""
AVATAR_IMAGES = (
    None,
    "./logo.png",
)

# Acceptable file extensions
TEXT_EXTENSIONS = [".docx", ".zip"]

# ========== Models & Clients ==========
GROQ_API_KEY = os.getenv("GROQ_API_KEY")
client = Groq(api_key=GROQ_API_KEY)
llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=GROQ_API_KEY)
embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1")

# ========== Core Components ==========
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"],
)

rag_template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.
Context:
{context}
Question:
{question}
Answer:"""
rag_prompt = PromptTemplate.from_template(rag_template)


# ========== App State ==========
class AppState:
    vectorstore: Optional[InMemoryVectorStore] = None
    rag_chain = None


state = AppState()

# ========== Utility Functions ==========


def load_documents_from_files(files: List[str]) -> List:
    """Load documents from uploaded files directly without moving."""
    all_documents = []

    # Temporary directory if ZIP needs extraction
    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                # Extract ZIP inside temp_dir
                with zipfile.ZipFile(file_path, "r") as zip_ref:
                    zip_ref.extractall(temp_dir)

                # Load all docx from extracted zip
                loader = DirectoryLoader(
                    path=temp_dir,
                    glob="**/*.docx",
                    use_multithreading=True,
                )
                docs = loader.load()
                all_documents.extend(docs)

            elif ext == ".docx":
                # Load single docx directly
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                all_documents.extend(docs)

    return all_documents


def get_last_user_message(chatbot: List[Union[gr.ChatMessage, dict]]) -> Optional[str]:
    """Get last user prompt."""
    for message in reversed(chatbot):
        content = (
            message.get("content") if isinstance(message, dict) else message.content
        )
        if (
            message.get("role") if isinstance(message, dict) else message.role
        ) == "user":
            return content
    return None


# ========== Main Logic ==========


def upload_files(
    files: Optional[List[str]], chatbot: List[Union[gr.ChatMessage, dict]]
):
    """Handle file upload - .docx or .zip containing docx."""
    if not files:
        return chatbot

    file_summaries = []  # <-- Collect formatted file/folder info
    documents = []

    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            filename = os.path.basename(file_path)
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                file_summaries.append(f"📦 **{filename}** (ZIP file) contains:")
                try:
                    with zipfile.ZipFile(file_path, "r") as zip_ref:
                        zip_ref.extractall(temp_dir)
                        zip_contents = zip_ref.namelist()

                        # Group files by folder
                        folder_map = collections.defaultdict(list)
                        for item in zip_contents:
                            if item.endswith("/"):
                                continue  # skip folder entries themselves
                            folder = os.path.dirname(item)
                            file_name = os.path.basename(item)
                            folder_map[folder].append(file_name)

                        # Format nicely
                        for folder, files_in_folder in folder_map.items():
                            if folder:
                                file_summaries.append(f"📂 {folder}/")
                            else:
                                file_summaries.append(f"📄 (root)")
                            for f in files_in_folder:
                                file_summaries.append(f"   - {f}")

                    # Load docx files extracted from ZIP
                    loader = DirectoryLoader(
                        path=temp_dir,
                        glob="**/*.docx",
                        use_multithreading=True,
                    )
                    docs = loader.load()
                    documents.extend(docs)

                except zipfile.BadZipFile:
                    chatbot.append(
                        gr.ChatMessage(
                            role="assistant",
                            content=f"❌ Failed to open ZIP file: {filename}",
                        )
                    )

            elif ext == ".docx":
                file_summaries.append(f"📄 **{filename}**")
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                documents.extend(docs)

            else:
                file_summaries.append(f"❌ Unsupported file type: {filename}")

    if not documents:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="No valid .docx files found in upload."
            )
        )
        return chatbot

    # Split documents
    chunks = text_splitter.split_documents(documents)
    if not chunks:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="Failed to split documents into chunks."
            )
        )
        return chatbot

    # Create Vectorstore
    state.vectorstore = InMemoryVectorStore.from_documents(
        documents=chunks,
        embedding=embed_model,
    )
    retriever = state.vectorstore.as_retriever()

    # Build RAG Chain
    state.rag_chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | rag_prompt
        | llm
        | StrOutputParser()
    )

    # Final display
    chatbot.append(
        gr.ChatMessage(
            role="assistant",
            content="**Uploaded Files:**\n"
            + "\n".join(file_summaries)
            + "\n\n✅ Ready to chat!",
        )
    )
    return chatbot


def user_message(
    text_prompt: str, chatbot: List[Union[gr.ChatMessage, dict]]
) -> Tuple[str, List[Union[gr.ChatMessage, dict]]]:
    """Add user's text input to conversation."""
    if text_prompt.strip():
        chatbot.append(gr.ChatMessage(role="user", content=text_prompt))
    return "", chatbot


def process_query(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Process user's query through RAG pipeline."""
    prompt = get_last_user_message(chatbot)
    if not prompt:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please type a question first.")
        )
        return chatbot

    if state.rag_chain is None:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please upload documents first.")
        )
        return chatbot

    chatbot.append(gr.ChatMessage(role="assistant", content="Thinking..."))

    try:
        response = state.rag_chain.invoke(prompt)
        chatbot[-1].content = response
    except Exception as e:
        chatbot[-1].content = f"Error: {str(e)}"

    return chatbot


def reset_app(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Reset application state."""
    state.vectorstore = None
    state.rag_chain = None
    return [
        gr.ChatMessage(
            role="assistant", content="App reset! Upload new documents to start."
        )
    ]


# ========== UI Layout ==========

with gr.Blocks(theme=gr.themes.Soft()) as demo:
    gr.HTML(TITLE)
    chatbot = gr.Chatbot(
        label="Llama 4 RAG",
        type="messages",
        bubble_full_width=False,
        avatar_images=AVATAR_IMAGES,
        scale=2,
        height=350,
    )

    with gr.Row(equal_height=True):
        text_prompt = gr.Textbox(
            placeholder="Ask a question...", show_label=False, autofocus=True, scale=28
        )
        send_button = gr.Button(
            value="Send",
            variant="primary",
            scale=1,
            min_width=80,
        )
        upload_button = gr.UploadButton(
            label="Upload",
            file_count="multiple",
            file_types=TEXT_EXTENSIONS,
            scale=1,
            min_width=80,
        )
        reset_button = gr.Button(
            value="Reset",
            variant="stop",
            scale=1,
            min_width=80,
        )

    send_button.click(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    text_prompt.submit(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    upload_button.upload(
        fn=upload_files, inputs=[upload_button, chatbot], outputs=[chatbot], queue=False
    )
    reset_button.click(fn=reset_app, inputs=[chatbot], outputs=[chatbot], queue=False)

demo.queue().launch()अब हम वेब एप्लिकेशन चलाएँगे और इसकी क्षमताओं का परीक्षण करेंगे। एप्लिकेशन शुरू करने के लिए, टर्मिनल में यह कमांड चलाएँ:
$ python main.py जब वेब सर्वर चालू हो जाए, तो इस URL पर जाएँ या इसे अपने ब्राउज़र में कॉपी-पेस्ट करें ताकि वेब इंटरफ़ेस तक पहुँचा जा सके: http://127.0.0.1:7860
हमारा चैट इंटरफ़ेस कुछ इस तरह दिखता है:
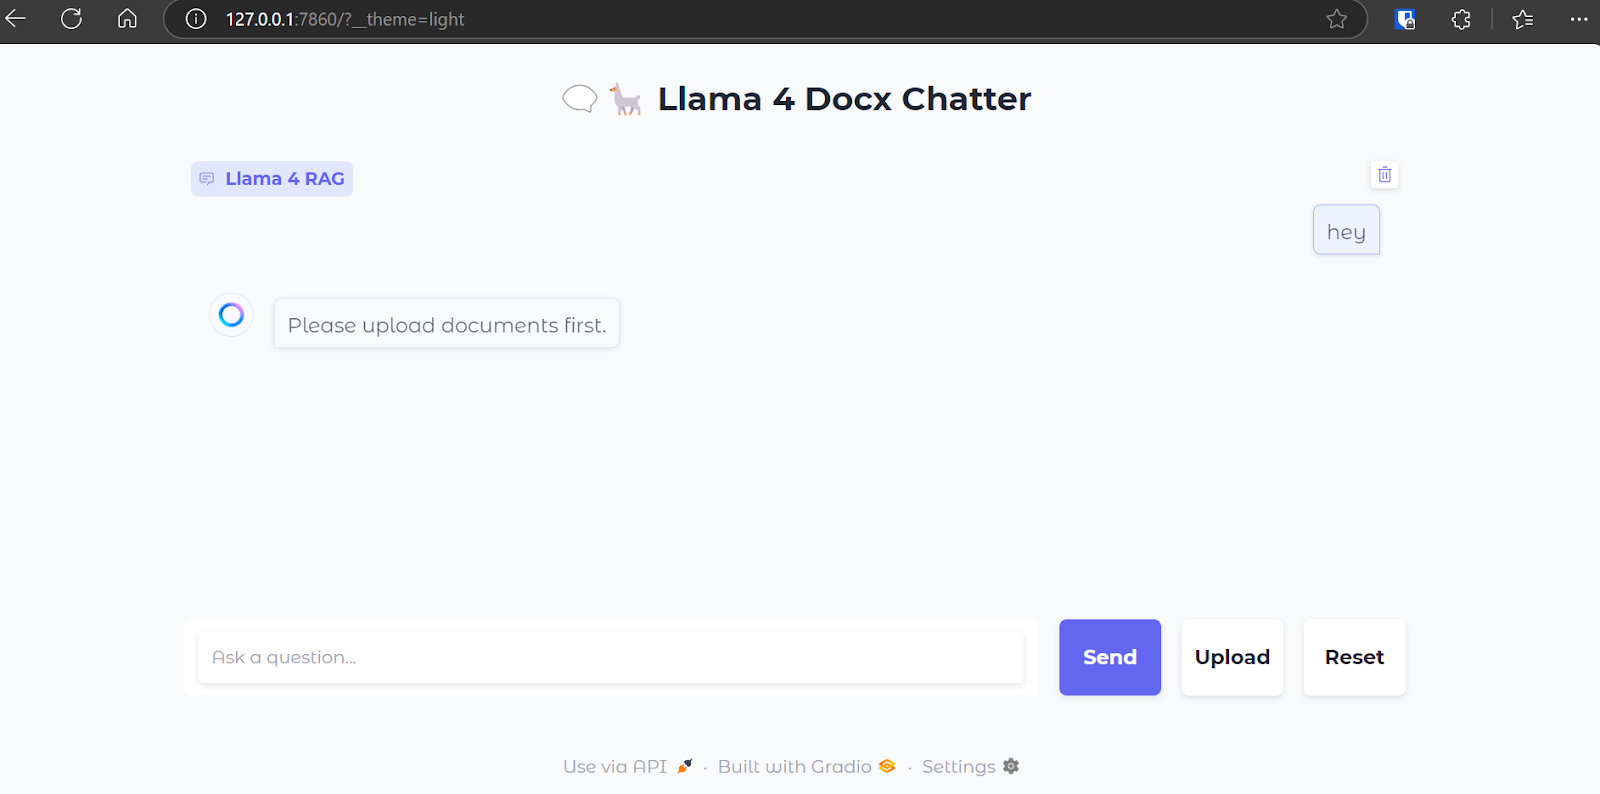
हम .docx फ़ाइलों वाला एक .zip फ़ाइल अपलोड करेंगे, और ऐसा करते ही आप zip फ़ाइल के भीतर सभी फ़ोल्डर और फ़ाइलें देखेंगे।
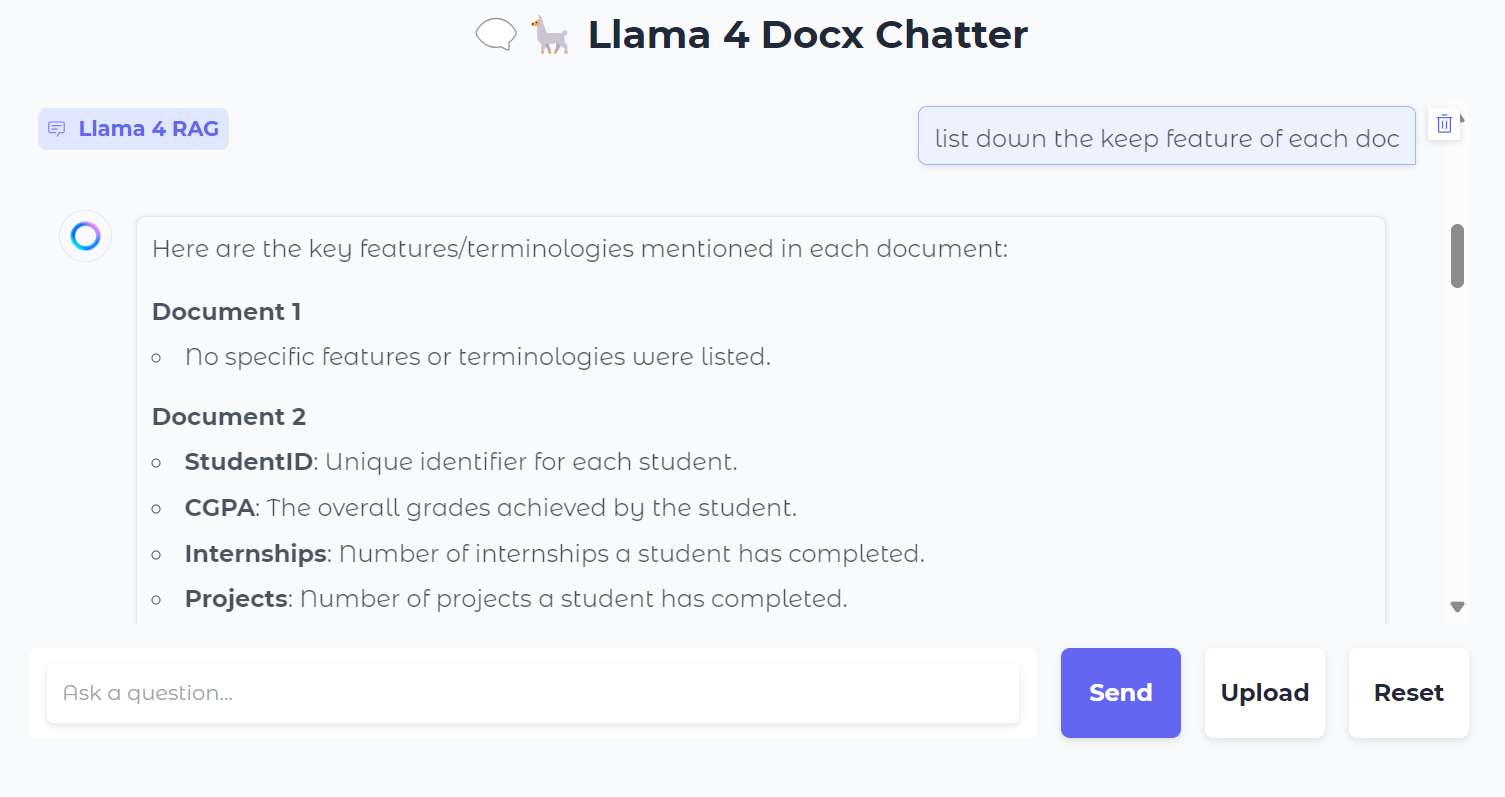
इसके बाद, हम दस्तावेज़ों के बारे में विशिष्ट प्रश्न पूछ सकते हैं:
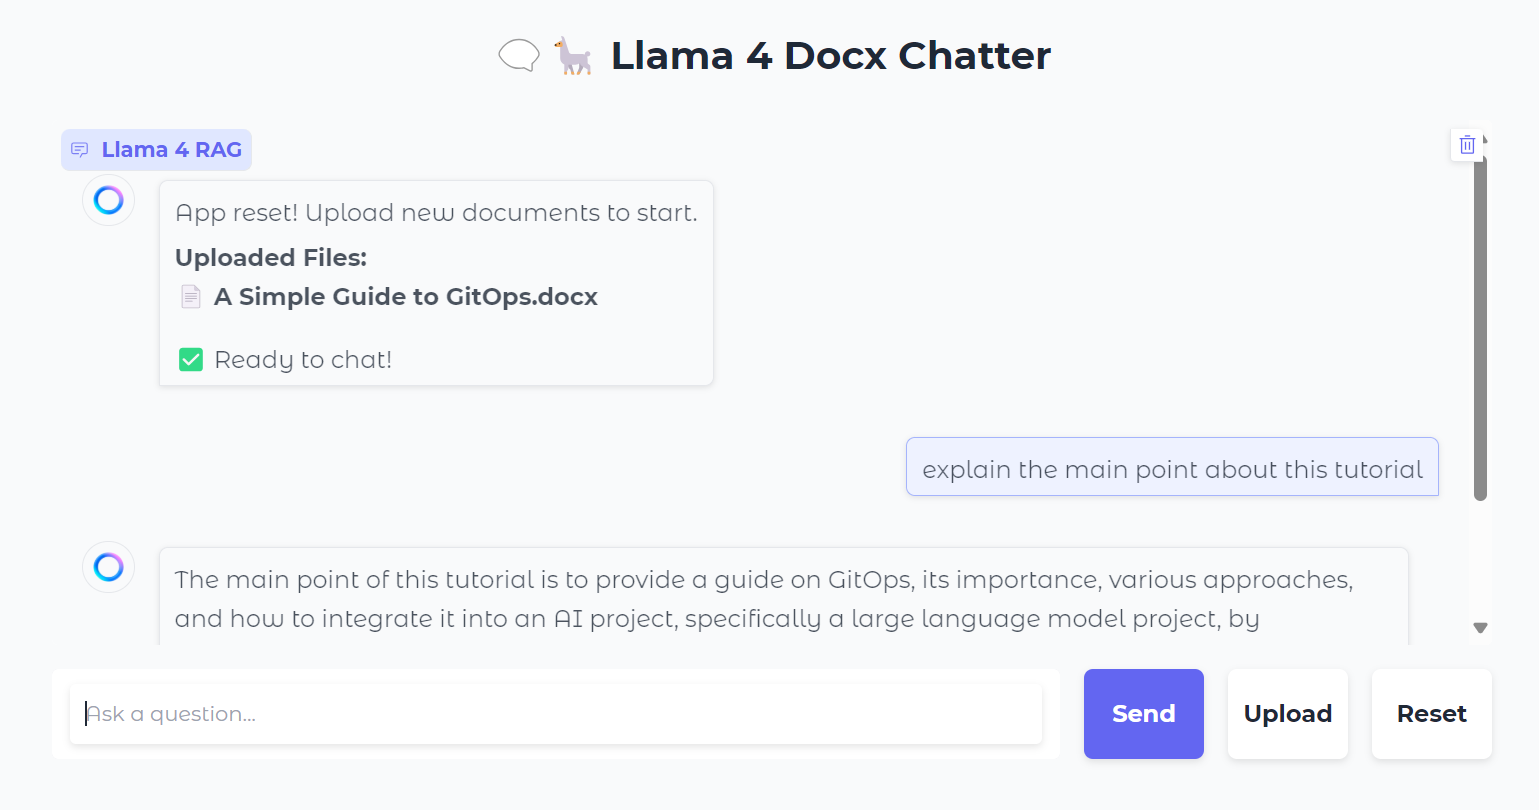
आप “Reset” बटन दबाकर कुछ ही सेकंड में नई फ़ाइल अपलोड कर सकते हैं और उस पर चैट कर सकते हैं।
स्थानीय रूप से परीक्षण करने के बाद, आप वेब एप्लिकेशन को Hugging Face Space पर आसानी से निःशुल्क डिप्लॉय कर सकते हैं। डिप्लॉय किए गए ऐप का लिंक यहाँ है: kingabzpro/Llama-4-RAG
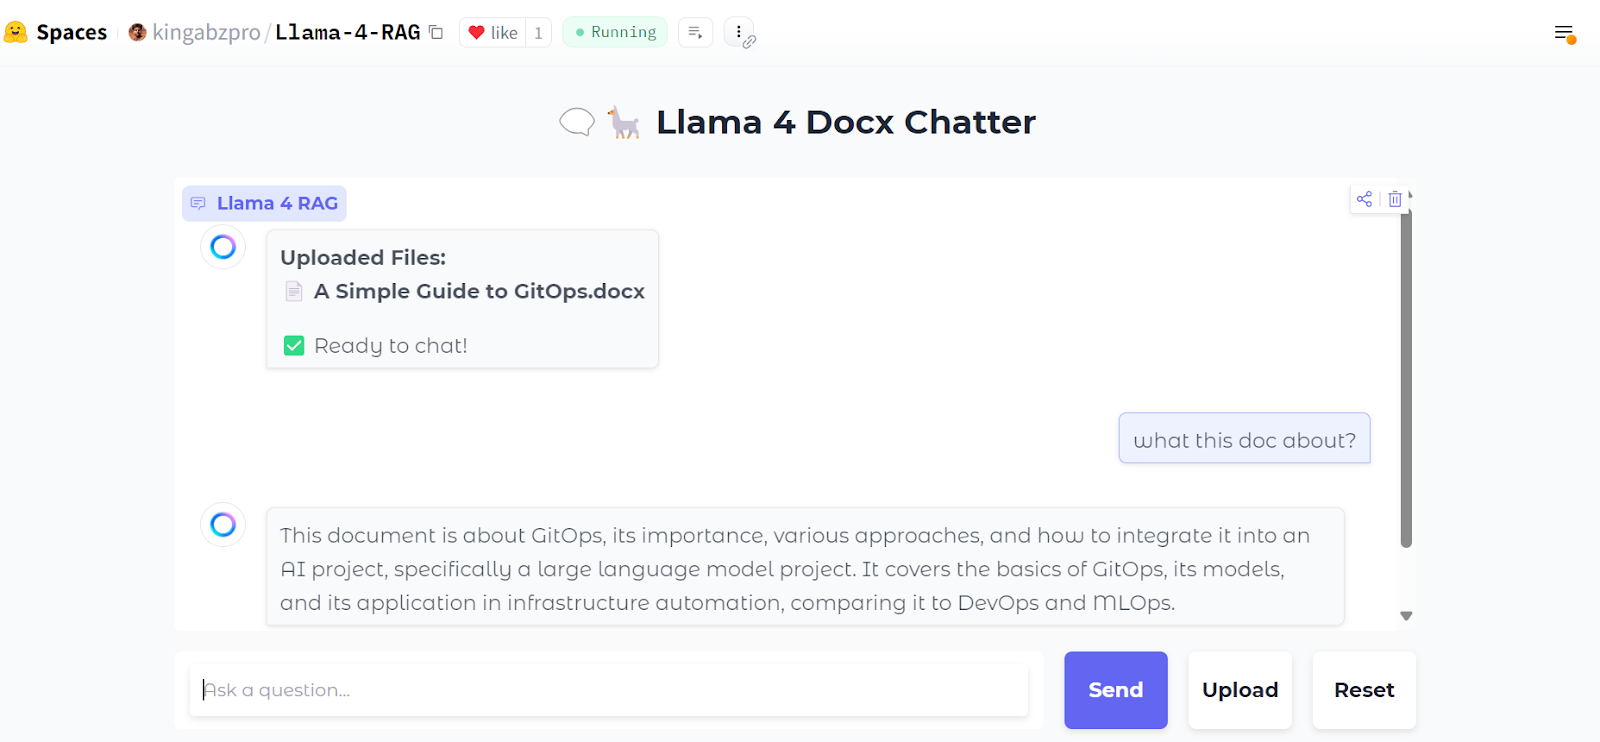
स्रोत: kingabzpro/Llama-4-RAG
सोर्स कोड, नोटबुक, और कॉन्फ़िगरेशन फ़ाइलें kingabzpro/Llama-4-RAG रिपॉजिटरी में मिल सकती हैं।
लॉन्ग-कॉन्टेक्स्ट विंडो मॉडल्स के आने के बावजूद, RAG कभी अप्रासंगिक नहीं होगा। RAG बाहरी संसाधनों से जानकारी प्राप्त करने और मॉडलों को अतिरिक्त संदर्भ देने का एक कुशल और किफायती तरीका बना रहता है।
इसके अलावा, RAG सिस्टम, मॉडल में सीधे विशाल संदर्भ फीड करने की तुलना में स्वाभाविक रूप से अधिक किफायती होते हैं, क्योंकि बाद वाले में महत्वपूर्ण कम्प्यूटेशनल संसाधन चाहिए। यह RAG को कई उपयोग मामलों के लिए व्यावहारिक और स्केलेबल समाधान बनाता है।
Llama 4 के बारे में और जानने के लिए, ये संसाधन देखें:
इन पाठ्यक्रमों के साथ AI सीखें!
कोर्स
कोर्स
लर्निंग पाथ