
Kurs
Llama 3 ile Çalışmak
2 sa
15.7K
Llama 4 Scout, 10 milyon tokenlık devasa bir bağlam penceresine sahip olarak pazarlanıyor, ancak eğitimi maksimum 256 bin token giriş boyutuyla sınırlıydı. Bu da daha büyük girdilerde performansın düşebileceği anlamına geliyor. Bunu önlemek için geri getirim destekli üretim (RAG) hattıyla Llama 4 kullanabiliriz.
Bu eğitimde, LangChain ekosistemini kullanarak adım adım bir RAG hattı kurmayı ve kullanıcıların belgeler yükleyip onlar hakkında sorular sorabileceği bir web uygulaması oluşturmayı açıklayacağım.
Okurlarımızı yapay zekâdaki en son gelişmelerden haberdar etmek için haftanın önemli haberlerini derlediğimiz, ücretsiz Cuma bültenimiz The Median'ı gönderiyoruz. Abone olun; haftada sadece birkaç dakikada güncel kalın:
Llama 4, 10 milyon tokenlık bir bağlam penceresiyle geliyor; yani 100 kitabı besleyip bunlar hakkında bağlamsal yanıtlar alabiliriz. Ancak bu etkileyici özelliğe rağmen, Llama 4'ü RAG ile eşleştirmek için güçlü nedenler var. İşte nedenleri:
Llama 4 büyük bir bağlam penceresini desteklese de, eğitimi en fazla 256 bin tokenlık girişlerle sınırlıydı. Girdiler bu eşiğe yaklaştığında veya aştığında modelin performansı düşebilir. RAG, yalnızca en ilgili bilgileri getirerek bu sorunu hafifletir ve girdinin özlü ve odaklı kalmasını sağlar.
RAG, bir vektör veritabanından yüksek düzeyde ilgili bilgilerin getirilmesini sağlar ve Llama 4'ün daha küçük, daha hedefli girdileri işlemesine imkân verir. Bu yaklaşım hem verimliliği hem de doğruluğu artırır.
Llama 4'ün tam bağlam penceresiyle devasa girdileri işlemek hesaplama açısından maliyetli olabilir. RAG kullanarak yalnızca en ilgili veriler getirilip işlenir; bu da hesaplama yükünü ve ilgili maliyetleri önemli ölçüde düşürür.
Bu eğitimde, bir .docx dosyasını yükleyip içeriği hakkında sorular sormanıza olanak tanıyan basit bir geri getirim destekli üretim hattını adım adım nasıl kuracağımı açıklayacağım.
Önce bir GroqCloud API anahtarı oluşturup bunu bir ortam değişkeni olarak kaydetmemiz gerekiyor. Ardından bağlamı yüklemek, bölmek, vektörleştirmek ve getirmek ile yanıt üretmek için gereken tüm Python paketlerini kuracağız.
%%capture
%pip install langchain
%pip install langchain-community
%pip install langchainhub
%pip install langchain-chroma
%pip install langchain-groq
%pip install langchain-huggingface
%pip install unstructured[docx]Groq API'sini kullanarak model nesnesini model adı ve API anahtarıyla kuracağız. Benzer şekilde, gömme modelini Hugging Face'ten indirip gömme modelimiz olarak yükleyeceğiz.
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=groq_api_key)

embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1").docx dosyasını kök klasörden yükleyip 1000 karakterlik parçalara böleceğiz.
from langchain_community.document_loaders import DirectoryLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter

# Initialize the text splitter
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"]
)

# Load the .docx files
loader = DirectoryLoader("./", glob="*.docx", use_multithreading=True)
documents = loader.load()

# Split the documents into chunks
chunks = text_splitter.split_documents(documents)

# Print the number of chunks
print(len(chunks))29Chroma vektör deposunu başlatın ve metin parçalarını vektör veritabanına sağlayın. Metin, depolanmadan önce gömmelere dönüştürülecektir. Sonrasında vektör depomuzun düzgün biçimde doldurulup doldurulmadığını test etmek için bir benzerlik araması çalıştıracağız.
from langchain_chroma import Chroma

vectorstore = Chroma.from_documents(
    documents=chunks,
    embedding=embed_model,
    persist_directory="./Vectordb",
)

query = "What is this tutorial about?"
docs = vectorstore.similarity_search(query)
print(docs[0].page_content)
Learn how to Fine-tune Stable Diffusion XL with DreamBooth and LoRA on your personal images.
Let's try another prompt:
Prompt:Sonraki adımda, vektör depomuzu bir getiriciye dönüştürecek ve RAG hattı için bir istem şablonu oluşturacağız.
# Create retriever
retriever = vectorstore.as_retriever()

# Import PromptTemplate
from langchain_core.prompts import PromptTemplate

# Define a clearer, more professional prompt template
template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.

Context:
{context}

Question:
{question}

Answer:"""

# Create the PromptTemplate
rag_prompt = PromptTemplate.from_template(template)
Son olarak, RAG istemine hem bağlamı hem soruyu sağlayan RAG zincirini oluşturacağız; bunu Llama 4 modelinden geçirip temiz bir yanıt üreteceğiz.
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
Şimdi RAG zincirine belgeyle ilgili bir soru soracağız.
from IPython.display import display, Markdown

response = rag_chain.invoke("What this tutorial about?")
Markdown(response)
This tutorial is about setting up and using the Janus project, specifically Janus Pro, a multimodal model that can understand images and generate images from text prompts, and building a local solution to use the model privately on a laptop GPU. It covers learning about the Janus Series, setting up the Janus project, building a Docker container to run the model locally, and testing its capabilities with various image and text prompts.Gördüğünüz gibi, yanıt son derece doğru ve bağlama duyarlı. Yukarıdaki kodu çalıştırırken herhangi bir sorunla karşılaşırsanız, lütfen şu DataLab çalışma kitabına bakın: Llama 4 RAG hattı.
Bu bölümde, önceki RAG hattı kodunu Gradio paketini kullanarak işlevsel bir sohbet uygulamasına dönüştüreceğiz. Başlamak için, aşağıdaki pip komutuyla Gradio'yu kurmanız gerekir:
$ pip install gradioUygulama basit ve kullanıcı dostu olacak şekilde tasarlanmıştır; tek bir .docx dosyası, birden çok .docx dosyası veya .docx dosyaları içeren bir .zip arşivi yüklemeyi sağlar. Kullanıcılar, yüklenen tüm dosyaların içeriği hakkında sorular sorabilir; bu da bilgiyi hızlı ve verimli şekilde getirmeyi sağlar.
Uygulamanın özellikleri:
Haydi hepsini bir araya getirelim:
main.py:
# ========== Standard Library ==========
import os
import tempfile
import zipfile
from typing import List, Optional, Tuple, Union
import collections


# ========== Third-Party Libraries ==========
import gradio as gr
from groq import Groq
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import DirectoryLoader, UnstructuredFileLoader
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

# ========== Configs ==========
TITLE = """<h1 align="center">🗨️🦙 Llama 4 Docx Chatter</h1>"""
AVATAR_IMAGES = (
    None,
    "./logo.png",
)

# Acceptable file extensions
TEXT_EXTENSIONS = [".docx", ".zip"]

# ========== Models & Clients ==========
GROQ_API_KEY = os.getenv("GROQ_API_KEY")
client = Groq(api_key=GROQ_API_KEY)
llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=GROQ_API_KEY)
embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1")

# ========== Core Components ==========
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"],
)

rag_template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.
Context:
{context}
Question:
{question}
Answer:"""
rag_prompt = PromptTemplate.from_template(rag_template)


# ========== App State ==========
class AppState:
    vectorstore: Optional[InMemoryVectorStore] = None
    rag_chain = None


state = AppState()

# ========== Utility Functions ==========


def load_documents_from_files(files: List[str]) -> List:
    """Load documents from uploaded files directly without moving."""
    all_documents = []

    # Temporary directory if ZIP needs extraction
    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                # Extract ZIP inside temp_dir
                with zipfile.ZipFile(file_path, "r") as zip_ref:
                    zip_ref.extractall(temp_dir)

                # Load all docx from extracted zip
                loader = DirectoryLoader(
                    path=temp_dir,
                    glob="**/*.docx",
                    use_multithreading=True,
                )
                docs = loader.load()
                all_documents.extend(docs)

            elif ext == ".docx":
                # Load single docx directly
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                all_documents.extend(docs)

    return all_documents


def get_last_user_message(chatbot: List[Union[gr.ChatMessage, dict]]) -> Optional[str]:
    """Get last user prompt."""
    for message in reversed(chatbot):
        content = (
            message.get("content") if isinstance(message, dict) else message.content
        )
        if (
            message.get("role") if isinstance(message, dict) else message.role
        ) == "user":
            return content
    return None


# ========== Main Logic ==========


def upload_files(
    files: Optional[List[str]], chatbot: List[Union[gr.ChatMessage, dict]]
):
    """Handle file upload - .docx or .zip containing docx."""
    if not files:
        return chatbot

    file_summaries = []  # <-- Collect formatted file/folder info
    documents = []

    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            filename = os.path.basename(file_path)
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                file_summaries.append(f"📦 **{filename}** (ZIP file) contains:")
                try:
                    with zipfile.ZipFile(file_path, "r") as zip_ref:
                        zip_ref.extractall(temp_dir)
                        zip_contents = zip_ref.namelist()

                        # Group files by folder
                        folder_map = collections.defaultdict(list)
                        for item in zip_contents:
                            if item.endswith("/"):
                                continue  # skip folder entries themselves
                            folder = os.path.dirname(item)
                            file_name = os.path.basename(item)
                            folder_map[folder].append(file_name)

                        # Format nicely
                        for folder, files_in_folder in folder_map.items():
                            if folder:
                                file_summaries.append(f"📂 {folder}/")
                            else:
                                file_summaries.append(f"📄 (root)")
                            for f in files_in_folder:
                                file_summaries.append(f"   - {f}")

                    # Load docx files extracted from ZIP
                    loader = DirectoryLoader(
                        path=temp_dir,
                        glob="**/*.docx",
                        use_multithreading=True,
                    )
                    docs = loader.load()
                    documents.extend(docs)

                except zipfile.BadZipFile:
                    chatbot.append(
                        gr.ChatMessage(
                            role="assistant",
                            content=f"❌ Failed to open ZIP file: {filename}",
                        )
                    )

            elif ext == ".docx":
                file_summaries.append(f"📄 **{filename}**")
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                documents.extend(docs)

            else:
                file_summaries.append(f"❌ Unsupported file type: {filename}")

    if not documents:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="No valid .docx files found in upload."
            )
        )
        return chatbot

    # Split documents
    chunks = text_splitter.split_documents(documents)
    if not chunks:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="Failed to split documents into chunks."
            )
        )
        return chatbot

    # Create Vectorstore
    state.vectorstore = InMemoryVectorStore.from_documents(
        documents=chunks,
        embedding=embed_model,
    )
    retriever = state.vectorstore.as_retriever()

    # Build RAG Chain
    state.rag_chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | rag_prompt
        | llm
        | StrOutputParser()
    )

    # Final display
    chatbot.append(
        gr.ChatMessage(
            role="assistant",
            content="**Uploaded Files:**\n"
            + "\n".join(file_summaries)
            + "\n\n✅ Ready to chat!",
        )
    )
    return chatbot


def user_message(
    text_prompt: str, chatbot: List[Union[gr.ChatMessage, dict]]
) -> Tuple[str, List[Union[gr.ChatMessage, dict]]]:
    """Add user's text input to conversation."""
    if text_prompt.strip():
        chatbot.append(gr.ChatMessage(role="user", content=text_prompt))
    return "", chatbot


def process_query(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Process user's query through RAG pipeline."""
    prompt = get_last_user_message(chatbot)
    if not prompt:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please type a question first.")
        )
        return chatbot

    if state.rag_chain is None:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please upload documents first.")
        )
        return chatbot

    chatbot.append(gr.ChatMessage(role="assistant", content="Thinking..."))

    try:
        response = state.rag_chain.invoke(prompt)
        chatbot[-1].content = response
    except Exception as e:
        chatbot[-1].content = f"Error: {str(e)}"

    return chatbot


def reset_app(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Reset application state."""
    state.vectorstore = None
    state.rag_chain = None
    return [
        gr.ChatMessage(
            role="assistant", content="App reset! Upload new documents to start."
        )
    ]


# ========== UI Layout ==========

with gr.Blocks(theme=gr.themes.Soft()) as demo:
    gr.HTML(TITLE)
    chatbot = gr.Chatbot(
        label="Llama 4 RAG",
        type="messages",
        bubble_full_width=False,
        avatar_images=AVATAR_IMAGES,
        scale=2,
        height=350,
    )

    with gr.Row(equal_height=True):
        text_prompt = gr.Textbox(
            placeholder="Ask a question...", show_label=False, autofocus=True, scale=28
        )
        send_button = gr.Button(
            value="Send",
            variant="primary",
            scale=1,
            min_width=80,
        )
        upload_button = gr.UploadButton(
            label="Upload",
            file_count="multiple",
            file_types=TEXT_EXTENSIONS,
            scale=1,
            min_width=80,
        )
        reset_button = gr.Button(
            value="Reset",
            variant="stop",
            scale=1,
            min_width=80,
        )

    send_button.click(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    text_prompt.submit(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    upload_button.upload(
        fn=upload_files, inputs=[upload_button, chatbot], outputs=[chatbot], queue=False
    )
    reset_button.click(fn=reset_app, inputs=[chatbot], outputs=[chatbot], queue=False)

demo.queue().launch()Şimdi web uygulamasını çalıştırıp işlevlerini test edeceğiz. Uygulamayı başlatmak için terminalde aşağıdaki komutu çalıştırın:
$ python main.py Web sunucusu çalışmaya başladıktan sonra, web arayüzüne erişmek için şu URL'ye gidin veya tarayıcınıza kopyalayıp yapıştırın: http://127.0.0.1:7860
Sohbet arayüzümüz şöyle görünüyor:
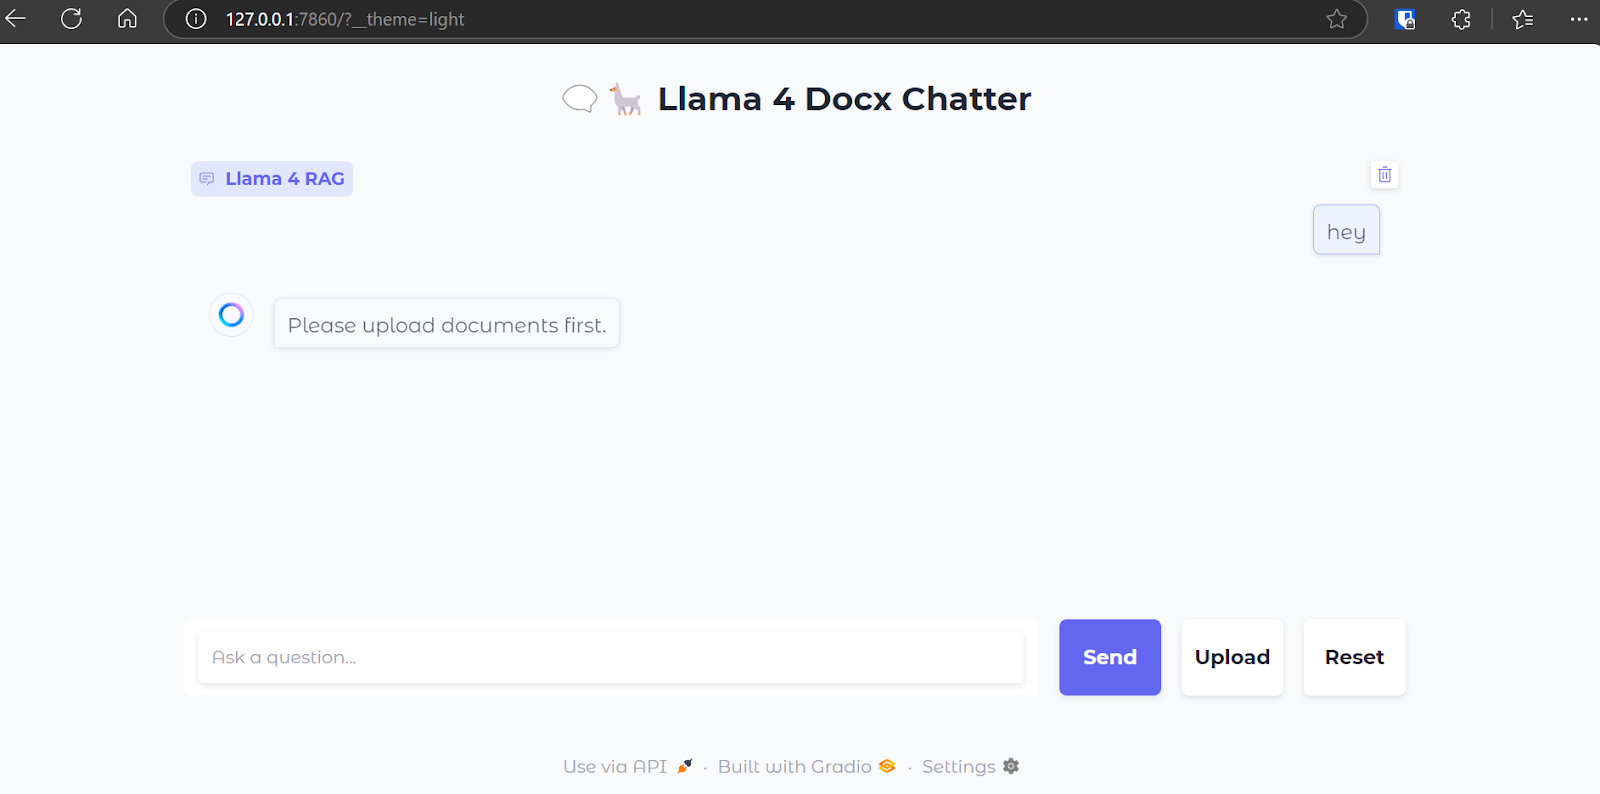
.docx dosyaları içeren bir .zip dosyası yükleyeceğiz ve bunu yaparken zip dosyasının içindeki tüm klasör ve dosyaları göreceksiniz.
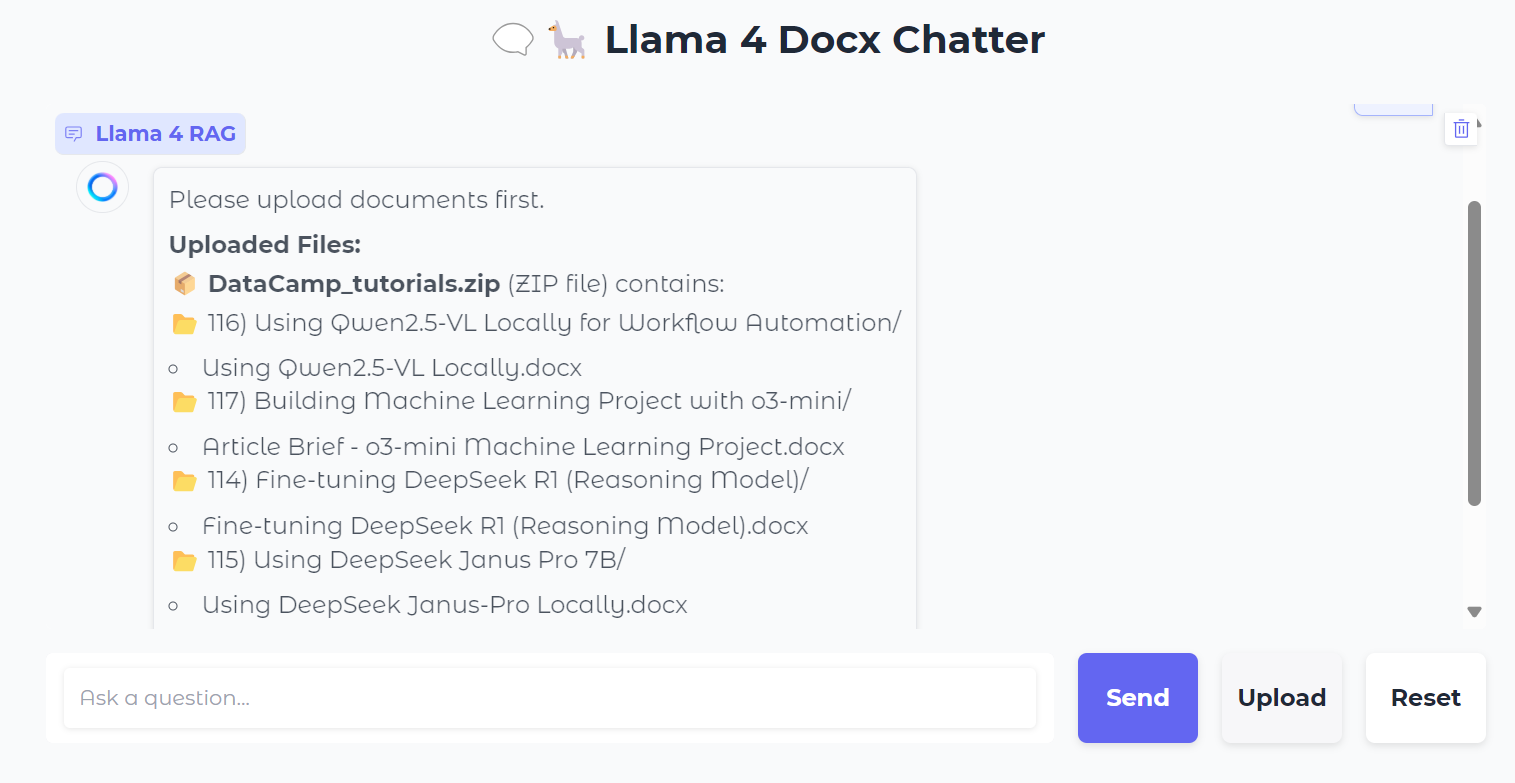
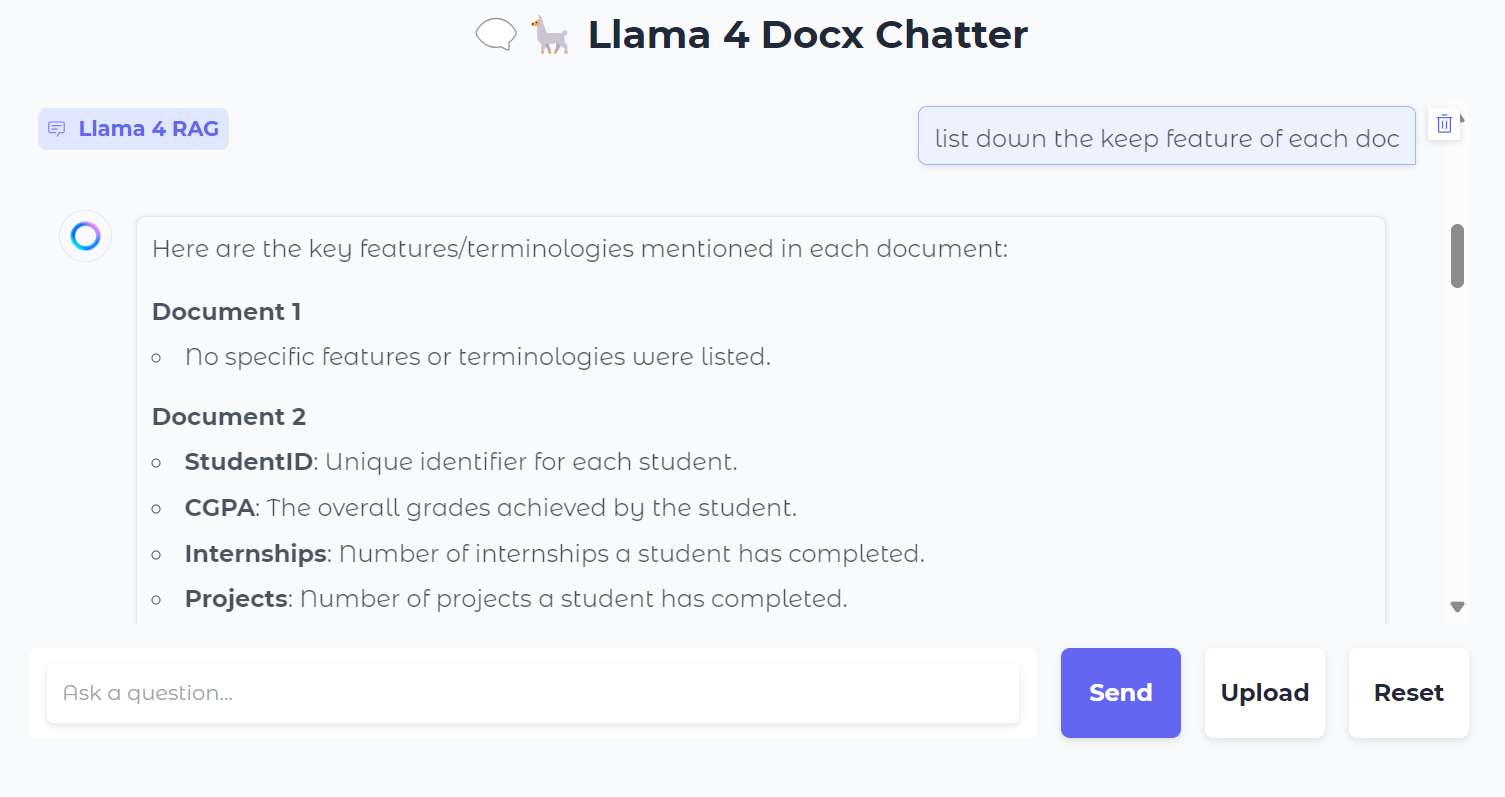
Sonraki adımda, belgeler hakkında spesifik sorular sorabiliriz:
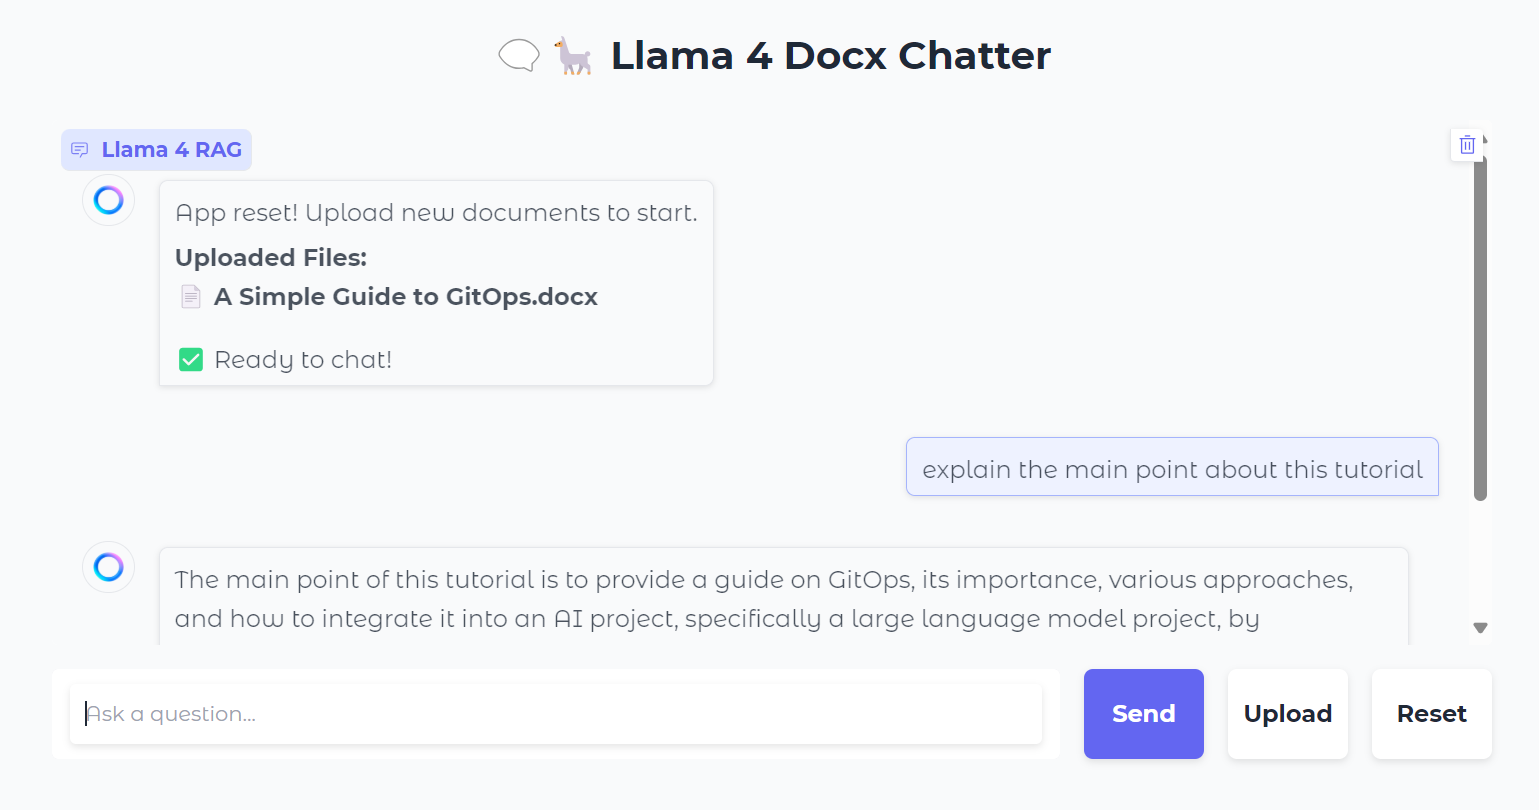
Ayrıca birkaç saniye içinde yeni bir dosya yükleyip onun hakkında sohbet etmek için “Reset” düğmesine basabilirsiniz.
Yerelde test ettikten sonra, web uygulamasını Hugging Face Space üzerinde ücretsiz olarak kolayca dağıtabilirsiniz. Dağıtılan uygulamanın bağlantısı: kingabzpro/Llama-4-RAG
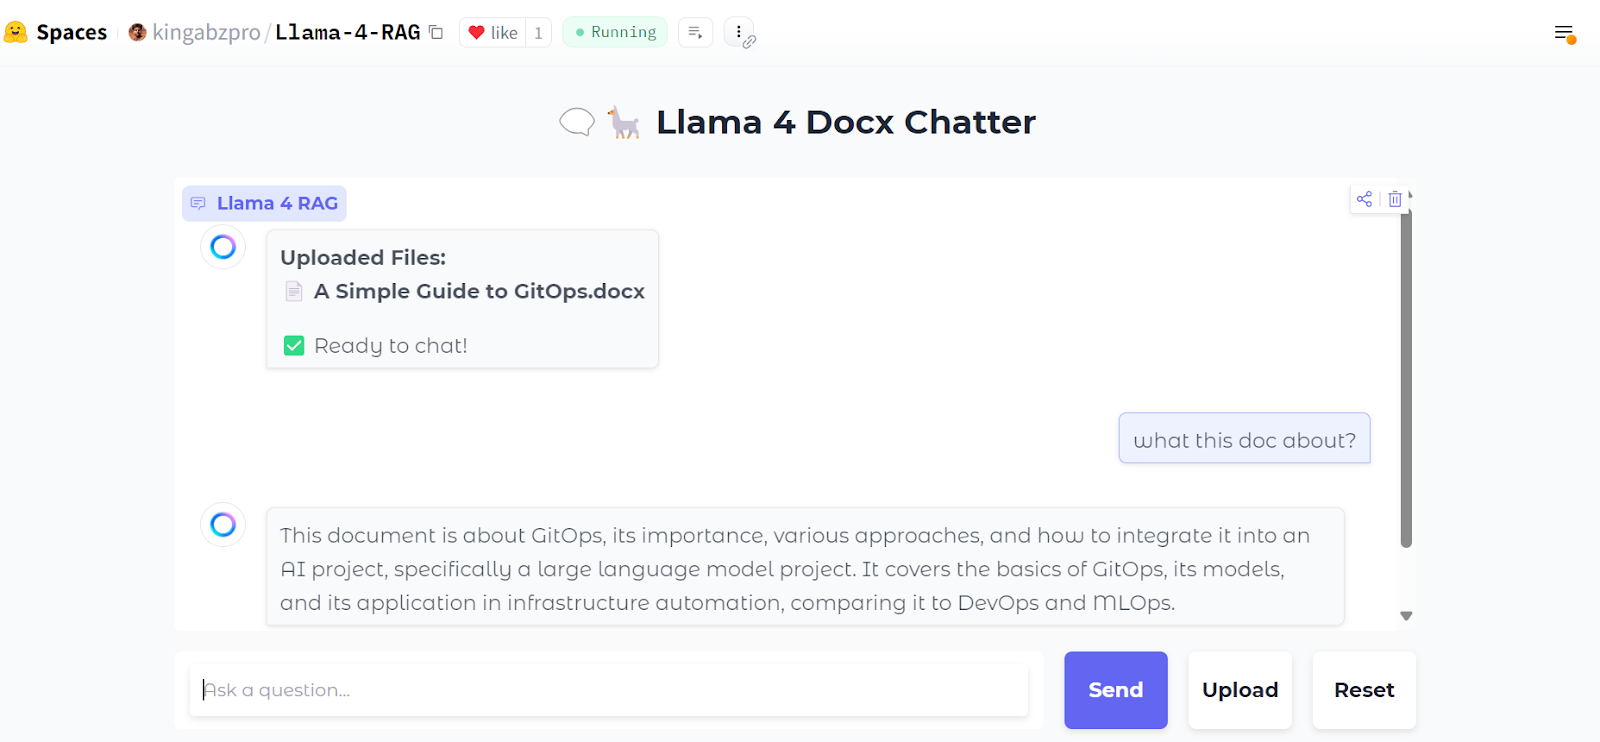
Kaynak: kingabzpro/Llama-4-RAG
Kod kaynağı, not defteri ve yapılandırma dosyaları kingabzpro/Llama-4-RAG deposunda bulunabilir.
Uzun bağlam pencereli modellerin ortaya çıkmasına rağmen RAG asla modası geçmeyecek. RAG, harici kaynaklardan bilgi getirmede verimli ve maliyet-etkin bir yöntem olarak kalır ve modellere ek bağlam sağlar.
Ayrıca, RAG sistemlerini çalıştırmak, modele doğrudan kapsamlı bağlam beslemeye kıyasla doğası gereği daha ekonomiktir; bu da önemli hesaplama kaynakları gerektirir. Bu nedenle RAG, birçok kullanım senaryosu için pratik ve ölçeklenebilir bir çözümdür.
Llama 4 hakkında daha fazla bilgi edinmek için şu kaynaklara göz atın:
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



