

Kursus
Bekerja dengan Llama 3
2 jam
15.7K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleMeta baru saja mengumumkan rangkaian model Llama 4, yang mencakup dua model yang dirilis—Llama 4 Scout dan Llama 4 Maverick—serta satu lagi yang masih dalam pelatihan: Llama 4 Behemoth.
Varian Scout dan Maverick tersedia sekarang, dirilis secara terbuka di bawah lisensi open-weight khas Meta—dengan satu pengecualian penting: jika layanan Anda melebihi 700 juta pengguna aktif bulanan, Anda wajib memperoleh lisensi terpisah dari Meta, yang dapat diberikan atau tidak sepenuhnya atas kebijakannya.
Llama Scout mendukung jendela konteks 10 juta token, yang terbesar dari model apa pun yang dirilis secara publik. Llama Maverick adalah model generalis dan menargetkan GPT-4o, Gemini 2.0 Flash, dan DeepSeek-V3. Llama Behemoth, yang masih dalam pelatihan, berperan sebagai model guru berkapasitas tinggi.
Dalam blog pengantar ini, saya akan memberi Anda gambaran umum tentang rangkaian Llama 4. Tim kami sudah menguji model tersebut, dan saya merekomendasikan tutorial berikut jika Anda ingin memperdalam pembelajaran:
Pembaruan: Setelah kurang lebih satu tahun tanpa kabar, Meta merilis LLM terbarunya. Untuk gambaran umum, lihat panduan kami tentang Muse Spark.
Kami terus memberi pembaca pembaruan terbaru seputar AI melalui The Median, buletin Jumat gratis kami yang merangkum kisah-kisah kunci setiap pekan. Berlangganan dan tetap tajam hanya dalam beberapa menit tiap minggu:
Llama 4 adalah keluarga baru model bahasa besar dari Meta. Rilis ini mencakup dua model yang sudah tersedia—Llama 4 Scout dan Llama 4 Maverick—serta satu lagi, Llama 4 Behemoth, yang masih dalam pelatihan.
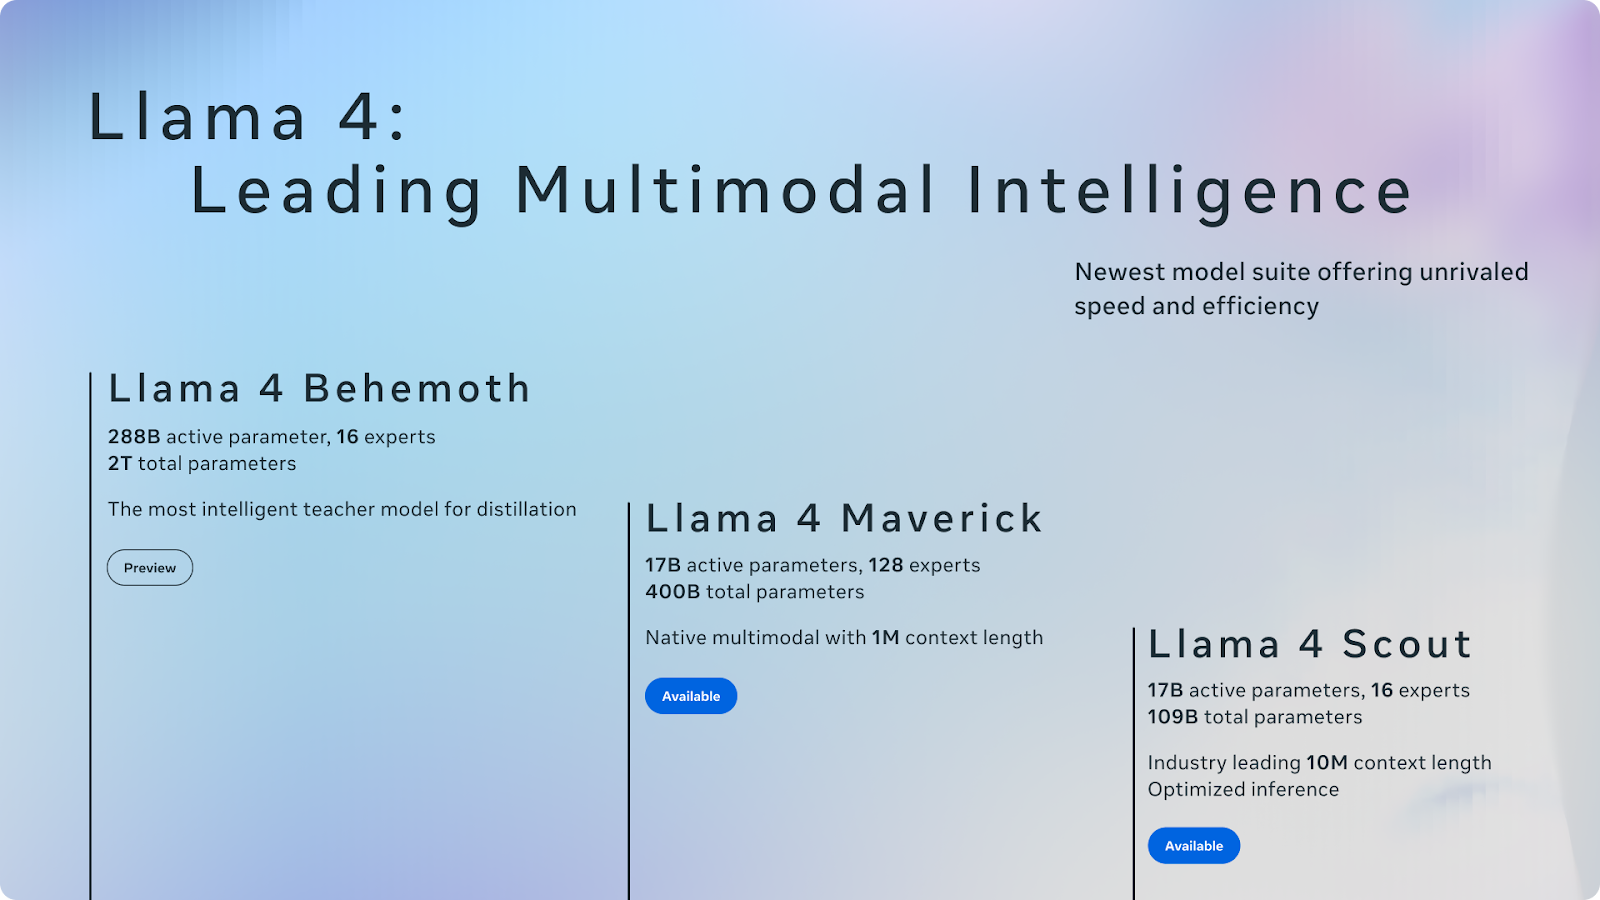
Sumber: Meta AI
Llama 4 menghadirkan peningkatan yang substansial. Khususnya, model ini memasukkan arsitektur mixture-of-experts (MoE), dengan tujuan meningkatkan efisiensi dan performa dengan hanya mengaktifkan komponen yang diperlukan untuk tugas tertentu (lebih lanjut tentang ini di bawah). Desain ini merepresentasikan pergeseran menuju model AI yang lebih dapat diskalakan dan terspesialisasi.
Llama 4 melanjutkan strategi Meta dalam merilis model open-weight—namun dengan catatan. Jika perusahaan Anda mengoperasikan layanan dengan lebih dari 700 juta pengguna aktif bulanan, Anda perlu mendapatkan lisensi terpisah dari Meta, yang mungkin diberikan atau tidak. Terlepas dari pembatasan tersebut, rilis ini tetap terasa seperti peristiwa besar dalam lanskap open-weight, meskipun lanskap itu sendiri berubah cepat dalam beberapa bulan terakhir.
Jika Llama 2 dan 3 dulu mendefinisikan kategorinya, Llama 4 kini memasuki medan yang jauh lebih kompetitif. DeepSeek hadir dengan kemampuan penalaran yang kuat. Seri Qwen dari Alibaba tampil baik di berbagai tolok ukur multibahasa dan pengodean. Model Gemma dari Google juga bergerak di ruang yang sama dengan arsitektur yang lebih kecil dan efisien. Dan baru beberapa hari lalu, OpenAI mengumumkan rencana untuk merilis model open-weight, perubahan yang setahun lalu terasa tidak mungkin.
Mari cari tahu lebih banyak detail tentang masing-masing model.
Llama 4 Scout adalah model yang lebih ringan dalam rangkaian baru ini, tetapi bisa dibilang paling menarik. Model ini berjalan pada satu GPU H100 dan mendukung jendela konteks 10 juta token. Ini menjadikan Scout model open-weight paling rakus konteks yang pernah dirilis hingga saat ini dan berpotensi paling berguna untuk tugas seperti peringkasan multi-dokumen, penalaran kode bentuk panjang, dan penguraian aktivitas.
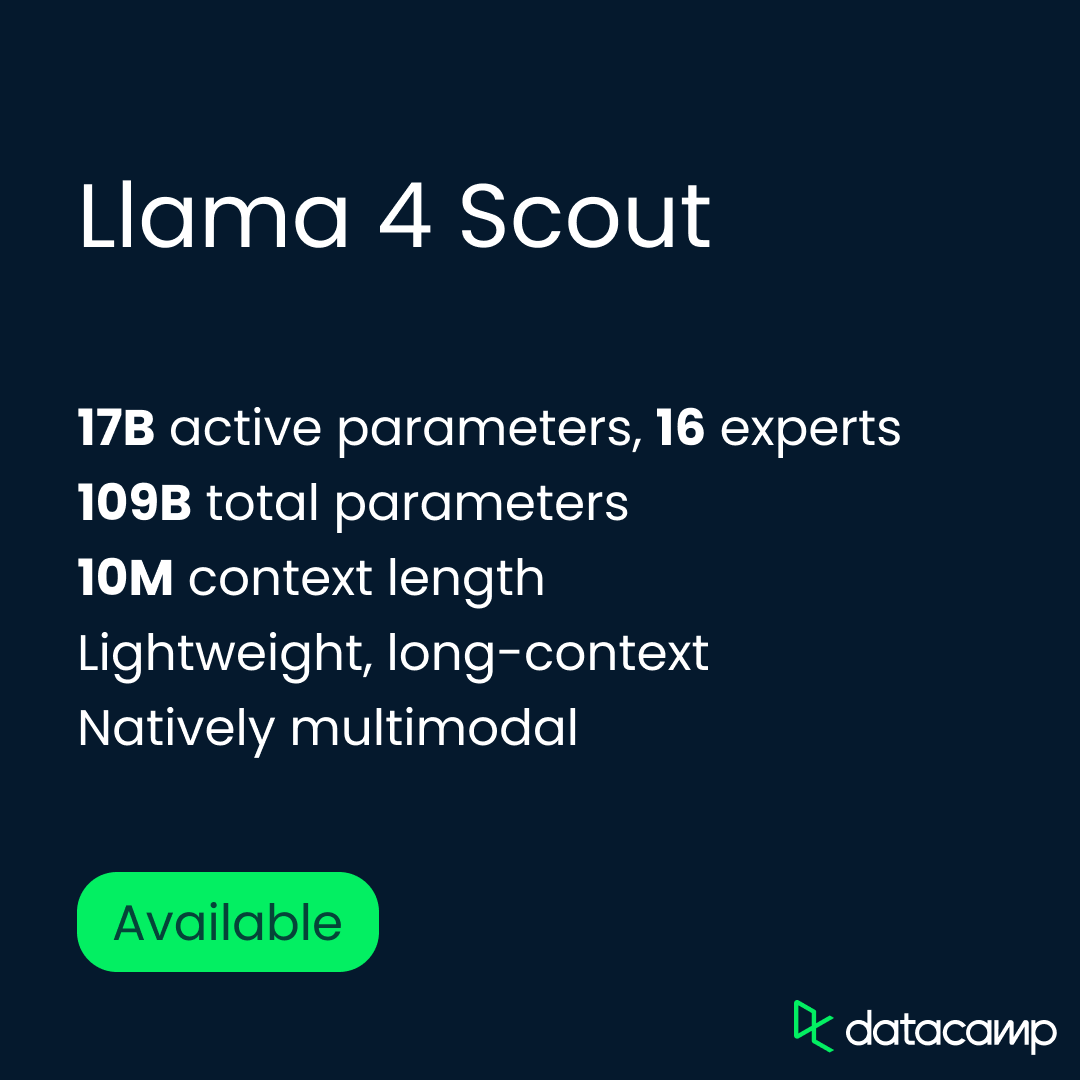
Scout memiliki 17 miliar parameter aktif, diorganisasi melalui 16 expert, dengan total parameter 109 miliar. Model ini dipra-latih dan pasca-latih dengan jendela konteks 256K, tetapi Meta mengatakan model ini melakukan generalisasi dengan baik jauh melampaui itu (klaim ini masih perlu diuji). Dalam praktiknya, ini membuka peluang alur kerja yang melibatkan seluruh basis kode, riwayat sesi, atau dokumen legal—semuanya diproses dalam satu forward pass.
Secara arsitektural, Scout dibangun menggunakan kerangka mixture-of-experts (MoE) milik Meta, di mana hanya sebagian parameter yang diaktifkan per token—berbeda dengan model dense seperti GPT-4o, di mana semua parameter diaktifkan. Artinya, model ini hemat komputasi dan sangat dapat diskalakan.
Di luar arsitektur inti, Meta menekankan kemampuan multimodal Scout. Model ini dipra-latih pada data teks, gambar, dan video menggunakan early fusion, sehingga dapat menangani kombinasi prompt teks dan visual secara native. Pada tugas berat gambar seperti visual grounding dan VQA (visual question answering), Scout berkinerja lebih baik daripada model Llama sebelumnya—dan mampu bersaing dengan sistem yang jauh lebih besar.
Singkatnya, Scout dibangun untuk keluasan dan skala. Ia dirancang untuk berjalan efisien, menangani lebih banyak masukan dibanding model open sebelumnya, dan bekerja baik di tugas teks maupun gambar. Kami akan segera menguji batas konteks 10M itu—dan kami akan melaporkannya kembali.
Llama 4 Maverick adalah generalis dalam jajaran ini—model multimodal skala penuh yang dibangun untuk performa di chat, penalaran, pemahaman gambar, dan kode. Sementara Scout mendorong batas panjang konteks, Maverick berfokus pada keluaran yang seimbang dan berkualitas tinggi di berbagai tugas. Ini adalah jawaban Meta untuk GPT-4o, DeepSeek-V3, dan Gemini 2.0 Flash.
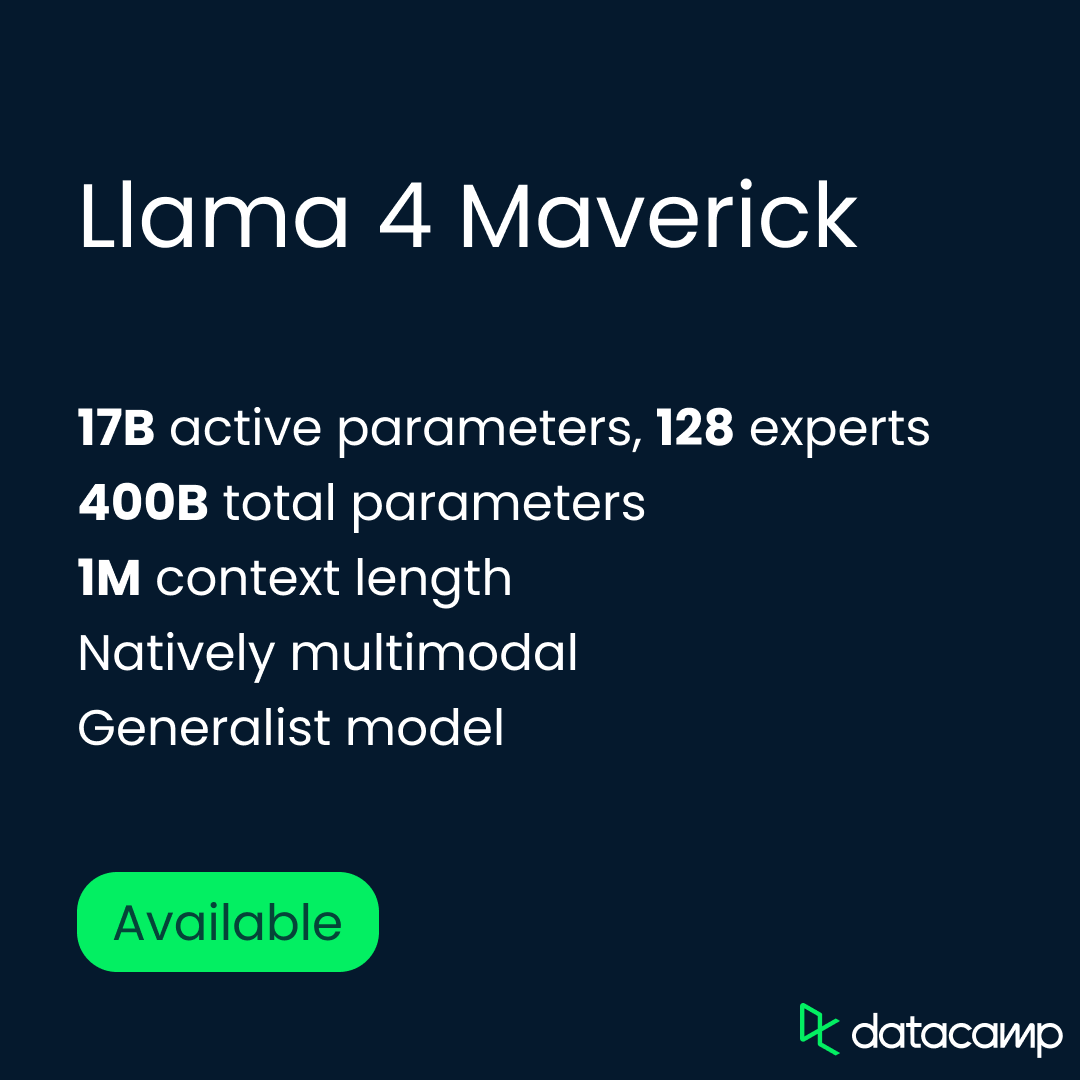
Maverick memiliki jumlah parameter aktif yang sama dengan Scout, yakni 17 miliar, tetapi dengan konfigurasi MoE yang lebih besar: 128 expert dan total sekitar 400 miliar parameter. Seperti Scout, model ini menggunakan arsitektur mixture-of-experts, yang hanya mengaktifkan sebagian model per token—mengurangi biaya inferensi sambil meningkatkan kapasitas. Model ini berjalan pada satu host H100 DGX, tetapi juga dapat dideploy dengan inferensi terdistribusi untuk aplikasi skala lebih besar.
Meta mengambil pendekatan berbeda untuk pasca-pelatihan di sini, menggunakan campuran fine-tuning terawasi yang ringan, reinforcement learning online, dan direct preference optimization. Tujuannya adalah mempertajam performa pada prompt sulit tanpa terlalu membatasi model. Untuk itu, Meta menyaring lebih dari 50% contoh pelatihan yang ditandai “mudah” oleh model Llama sebelumnya dan membangun kurikulum yang menekankan tugas penalaran, pengodean, dan multimodal yang lebih sulit.
Maverick juga didistilasi bersama dari Llama 4 Behemoth, model internal Meta yang jauh lebih besar, yang membantu meningkatkan performa tanpa menambah biaya pelatihan. Menurut Meta, pipeline distilasi ini menghasilkan lonjakan nyata dalam kualitas penalaran dan chat.
Llama 4 Behemoth adalah model terkuat dan terbesar Meta hingga saat ini—tetapi belum tersedia. Masih dalam pelatihan, Behemoth bukan model penalaran dalam arti yang sama seperti DeepSeek-R1 atau o3 dari OpenAI, yang dibangun dan dioptimalkan untuk tugas chain-of-thought multi-langkah.
Berdasarkan yang kami ketahui sejauh ini, model ini juga tampaknya tidak dirancang sebagai produk untuk penggunaan langsung. Sebaliknya, ia bertindak sebagai model guru, digunakan untuk mendistilasi dan membentuk Scout dan Maverick. Setelah dirilis, model ini juga dapat memungkinkan pihak lain mendistilasi model mereka sendiri.
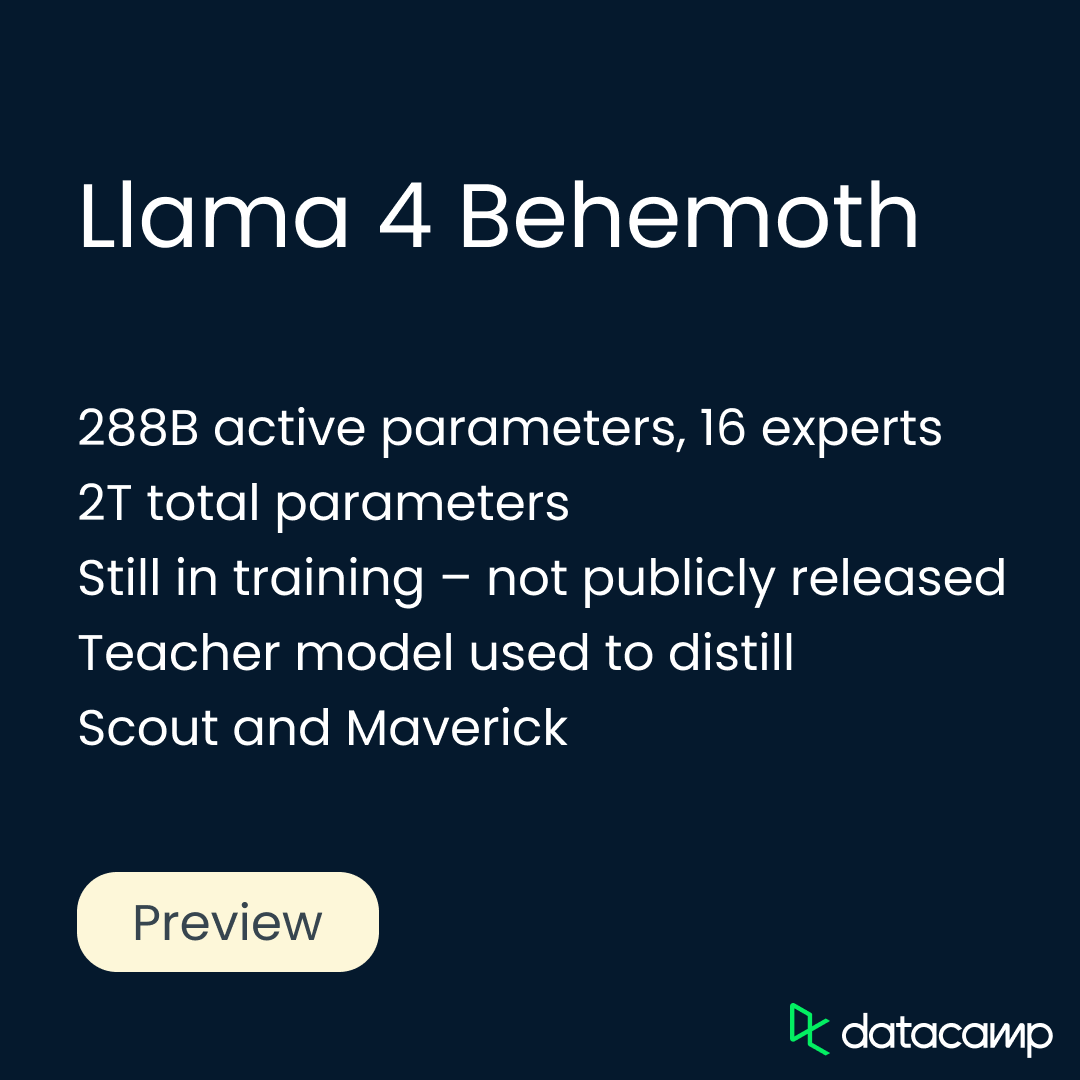
Behemoth memiliki 288 miliar parameter aktif, diorganisasi melalui 16 expert, dengan total parameter mendekati 2 triliun. Meta membangun infrastruktur pelatihan yang sepenuhnya baru untuk mendukung Behemoth pada skala ini. Meta memperkenalkan reinforcement learning asinkron, pengambilan sampel kurikulum berdasarkan tingkat kesulitan prompt, dan fungsi loss distilasi baru yang menyeimbangkan target lunak dan keras secara dinamis.
Pasca-pelatihan Behemoth juga memerlukan resep yang berbeda. Meta membuang lebih dari 95% contoh SFT untuk memfokuskan pada prompt sulit dan memusatkan reinforcement learning pada penalaran kompleks, pengodean, dan skenario multibahasa. Pengambilan sampel dari berbagai instruksi sistem membantu model melakukan generalisasi, sementara penyaringan dinamis menghapus prompt bernilai rendah selama pelatihan RL.
Meta merilis hasil tolok ukur internal untuk masing-masing model Llama 4, membandingkannya dengan varian Llama sebelumnya dan beberapa model open-weight serta frontier yang bersaing.
Di bagian ini, saya akan membahas sorotan tolok ukur untuk Scout, Maverick, dan Behemoth, menggunakan angka dari Meta sendiri. Seperti biasa, saya menganjurkan kehati-hatian dengan tolok ukur yang dilaporkan sendiri—namun skor ini memberikan pandangan awal yang berguna tentang bagaimana masing-masing model tampil di berbagai tugas dan posisi mereka di lanskap saat ini. Mari mulai dengan Scout.
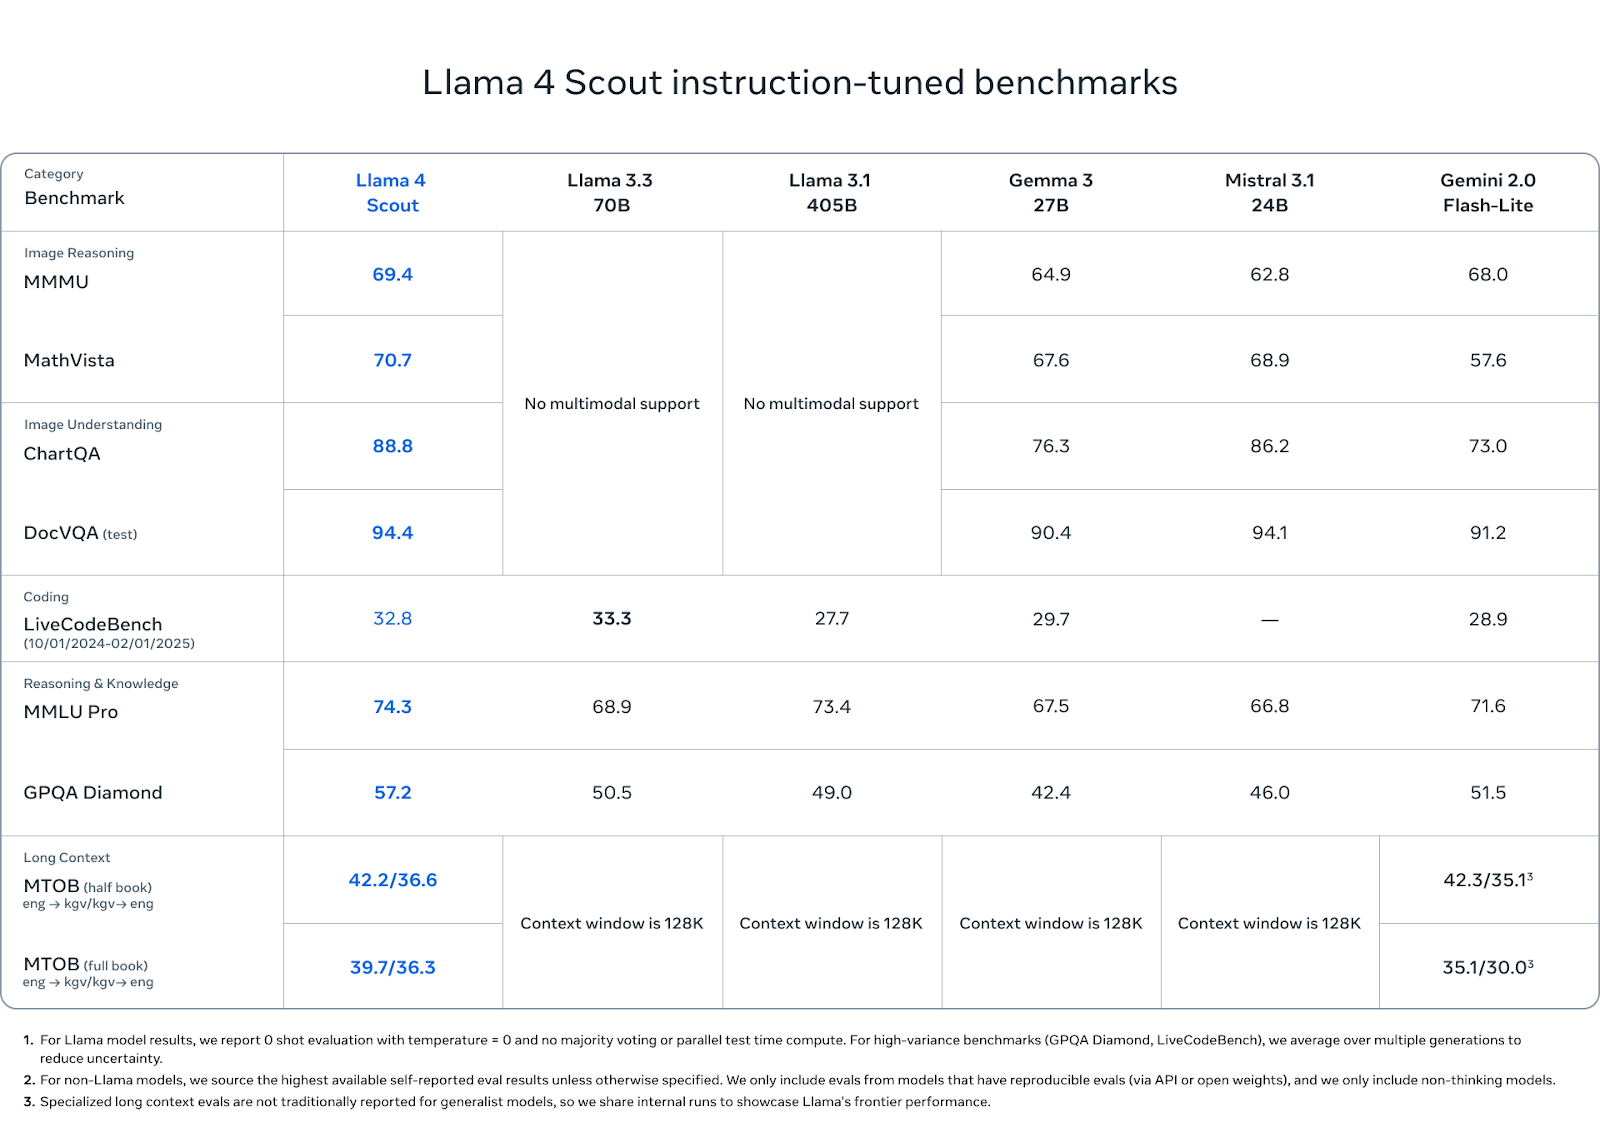
Llama 4 Scout tampil baik di campuran tolok ukur penalaran, pengodean, dan multimodal—terutama mengingat jumlah parameter aktifnya yang lebih kecil dan jejak single-GPU.
Sumber: MetaAI
Pada pemahaman gambar, Scout sedikit unggul dari pesaing: skor 88,8 pada ChartQA dan 94,4 pada DocVQA (uji), melampaui Gemini 2.0 Flash-Lite (masing-masing 73,0 dan 91,2) dan menyamai atau sedikit mengungguli Mistral 3.1 dan Gemma 3 27B.
Pada tolok ukur penalaran gambar seperti MMMU (69,4) dan MathVista (70,7), model ini juga memimpin kelompok open-weight, melampaui Gemma 3 (64,9; 67,6), Mistral 3.1 (62,8; 68,9), dan Gemini Flash-Lite (68,0; 57,6).
Dalam pengodean, Scout mencetak 32,8 pada LiveCodeBench, menempatkannya di atas Gemini Flash-Lite (28,9) dan Gemma 3 27B (29,7), meskipun sedikit di bawah 33,3 milik Llama 3.3. Ini bukan model yang berfokus pada kode, tetapi cukup tangguh.
Pada pengetahuan dan penalaran, Scout meraih 74,3 pada MMLU Pro dan 57,2 pada GPQA Diamond, melampaui setiap model open-weight lain pada keduanya. Tolok ukur ini menyukai penalaran multi-langkah bentuk panjang, sehingga performa kuat Scout di sini patut dicatat, terutama pada skala ini.
Akhirnya, kemampuan long-context Scout menunjukkan potensi dunia nyata. Pada MTOB (Massive Textual Overlap Benchmark), yang menguji kemampuan model untuk menerjemahkan antara bahasa Inggris dan KGV, bahasa dengan sumber daya rendah, model ini mencetak 42,2/36,6 pada uji setengah buku dan 39,7/36,3 pada uji satu buku penuh. Pada uji setengah buku, Gemini 2.0 Flash-Lite sedikit unggul dengan 42,3, tetapi Scout menutup celah pada uji penuh, melampaui 35,1/30,0 milik Gemini.
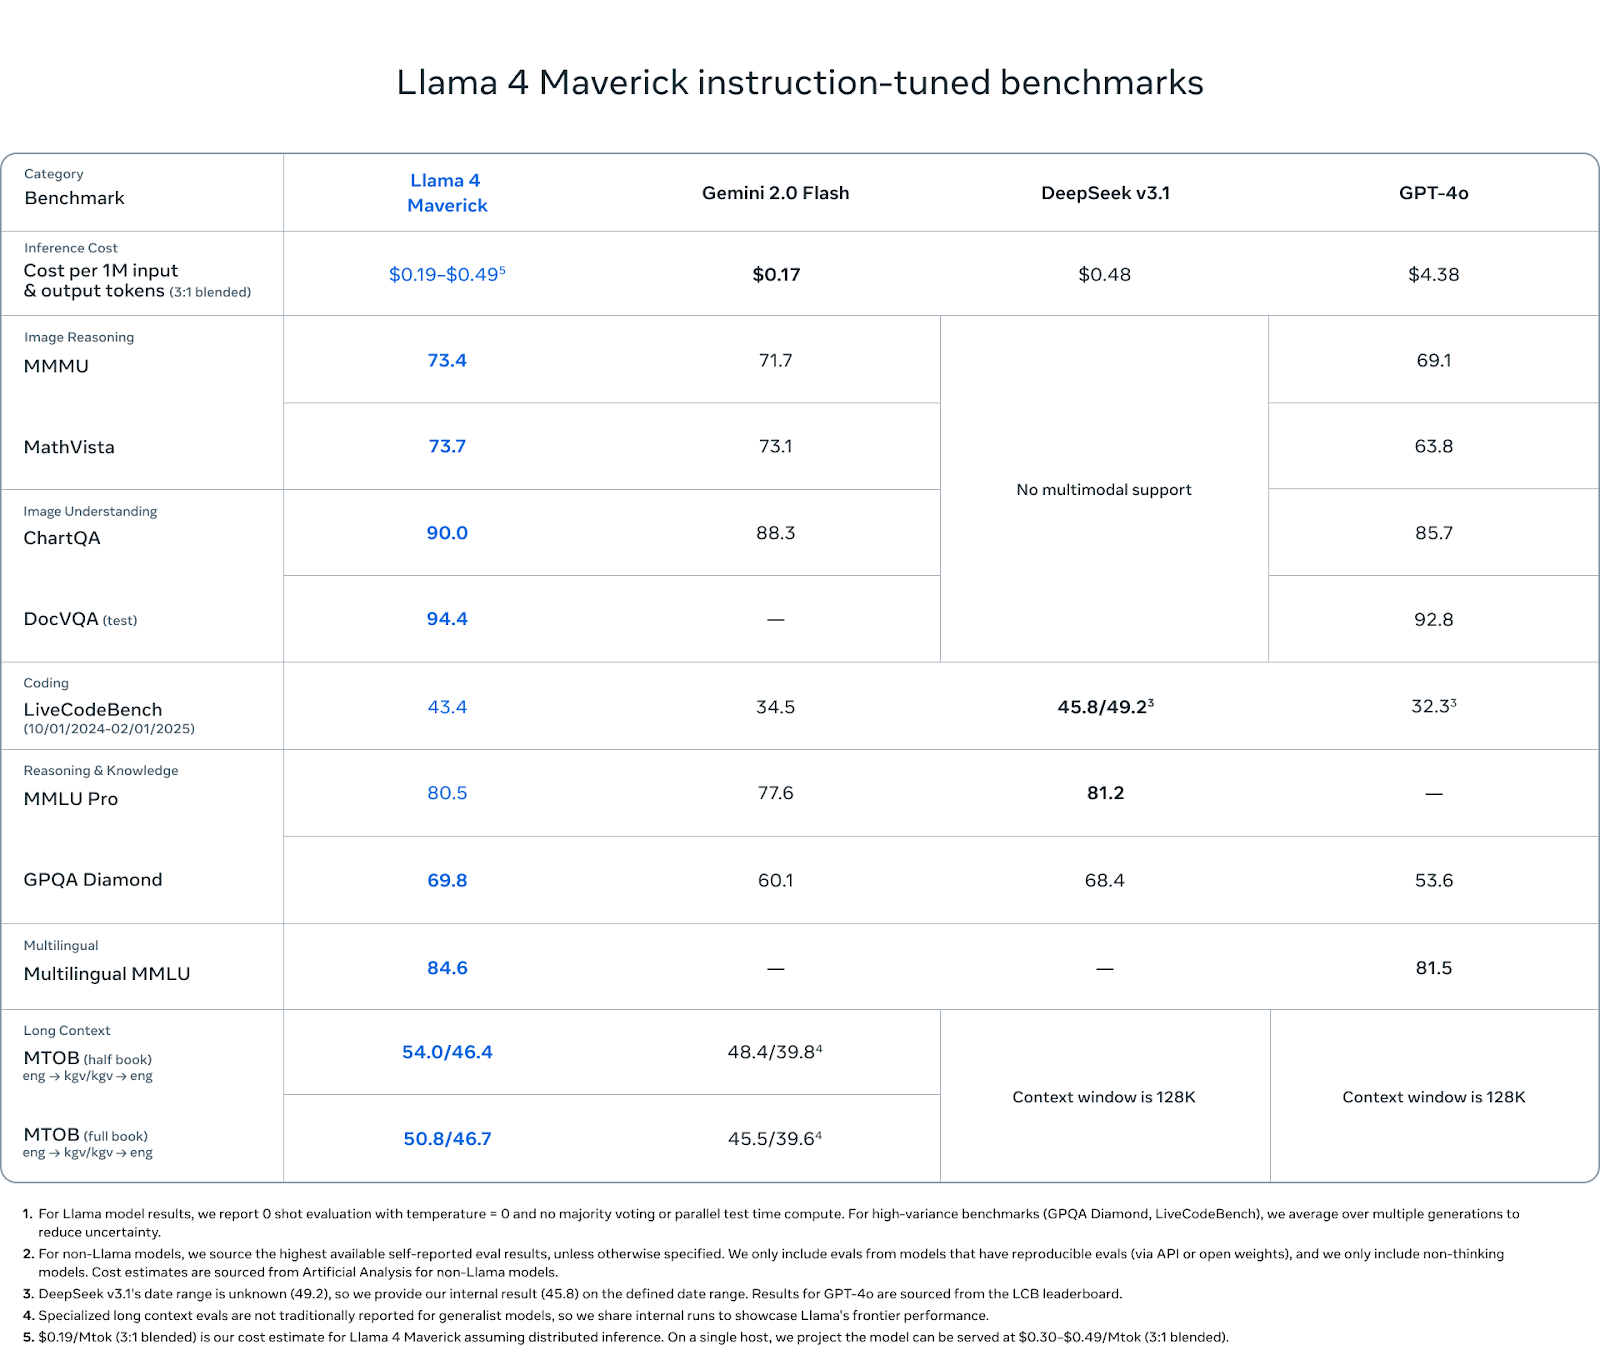
Maverick adalah model paling seimbang dalam jajaran Llama 4—dan hasil tolok ukurnya mencerminkan hal itu. Walau tidak mengejar ekstrem panjang konteks seperti Scout atau skala mentah seperti Behemoth, model ini tampil konsisten di setiap kategori yang penting: penalaran multimodal, pengodean, pemahaman bahasa, dan retensi konteks panjang.
Sumber: MetaAI
Dalam penalaran gambar, Maverick mencetak 73,4 pada MMMU dan 73,7 pada MathVista, melampaui Gemini 2.0 Flash (71,7 dan 73,1) dan GPT-4o (69,1 dan 63,8). Pada ChartQA (pemahaman gambar), model ini mencetak 90,0, sedikit di atas 88,3 milik Gemini dan jauh di atas 85,7 milik GPT-4o. Pada DocVQA, Maverick mencapai 94,4, menyamai Scout dan melampaui 92,8 milik GPT-4o.
Dalam pengodean, Maverick mencetak 43,4 pada LiveCodeBench, menempatkannya di atas GPT-4o (32,3), Gemini Flash (34,5), dan mendekati 45,8 milik DeepSeek v3.1.
Pada penalaran dan pengetahuan, Maverick mencetak 80,5 pada MMLU Pro dan 69,8 pada GPQA Diamond, kembali melampaui Gemini Flash (77,6 dan 60,1) dan GPT-4o (tidak ada MMLU Pro yang dilaporkan, 53,6 pada GPQA). DeepSeek v3.1 unggul tipis 0,7 poin di MMLU Pro.
Maverick juga tampil baik dalam pemahaman multibahasa, mencetak 84,6 pada Multilingual MMLU, sedikit di atas 81,5 milik Gemini. Ini memberi keunggulan bagi developer yang bekerja lintas bahasa atau geografi.
Dalam evaluasi konteks panjang (MTOB), Maverick mencetak 54,0/46,4 pada uji setengah buku dan 50,8/46,7 pada uji satu buku penuh—jauh di depan 48,4/39,8 dan 45,5/39,6 milik Gemini, masing-masing. Skor ini menunjukkan bahwa meskipun Maverick tidak menonjolkan panjang konteksnya seperti Scout, ia tetap mendapat manfaat berarti dari jendela yang diperluas.
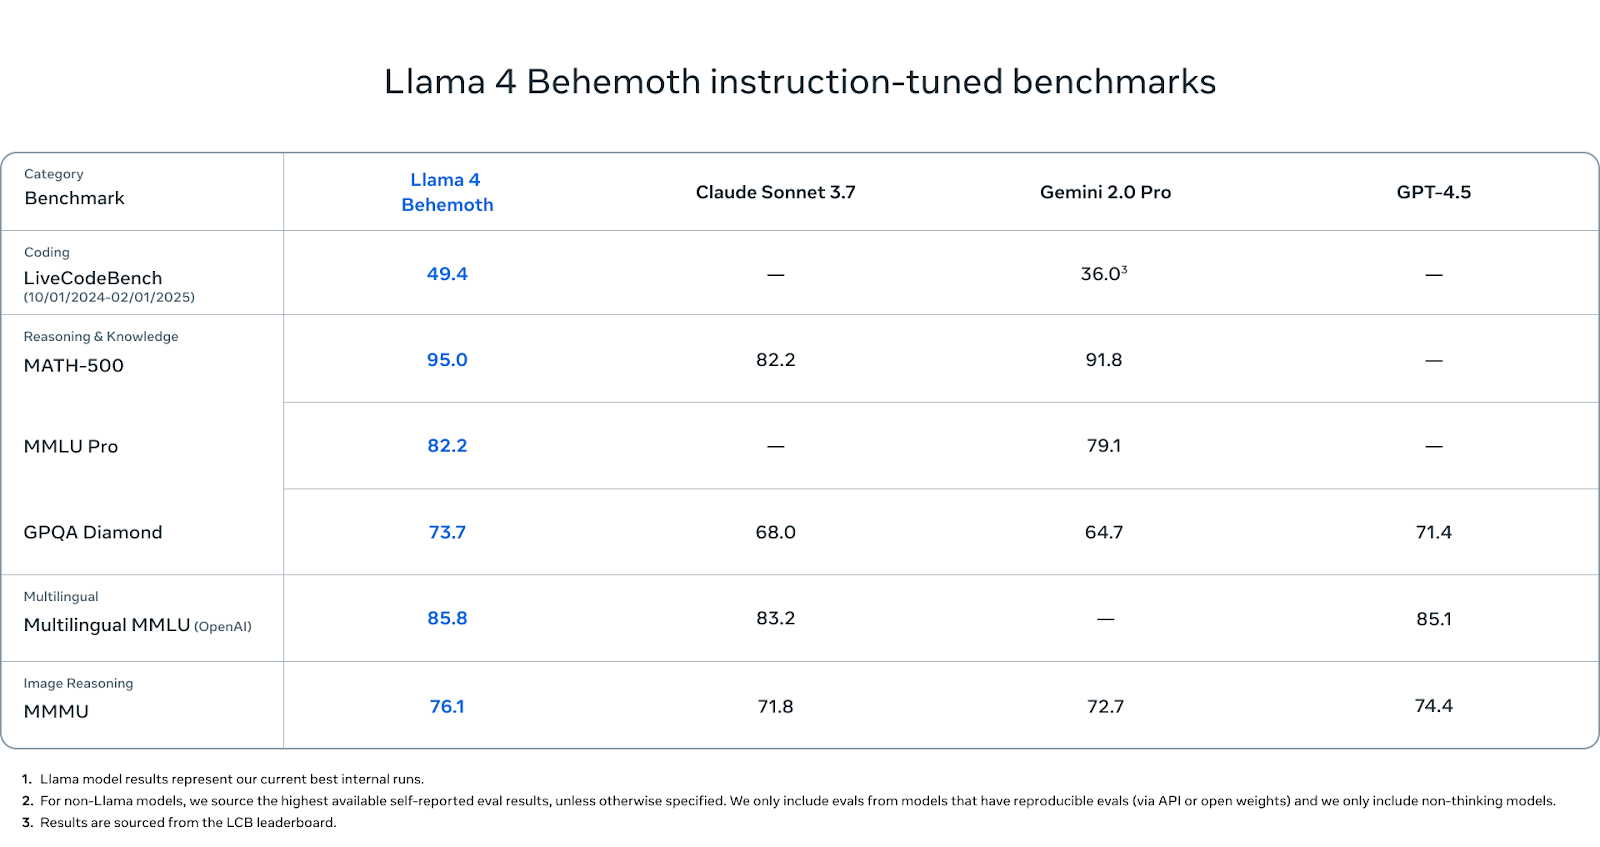
Behemoth belum dirilis, tetapi angka tolok ukurnya patut diperhatikan.
Sumber: MetaAI
Pada tolok ukur yang sarat STEM, Behemoth tampil sangat baik. Skornya 95,0 pada MATH-500—lebih tinggi daripada Gemini 2.0 Pro (91,8) dan secara signifikan di atas Claude Sonnet 3.7 (82,2). Pada MMLU Pro, Behemoth mencetak 82,2, sementara Gemini Pro berada di 79,1 (Claude tidak memiliki skor yang dilaporkan). Dan pada GPQA Diamond, tolok ukur lain yang menghargai kedalaman dan ketelitian faktual, Behemoth mencapai 73,7, di depan Claude (68,0), Gemini (64,7), dan GPT-4.5 (71,4).
Dalam pemahaman multibahasa, Behemoth mencetak 85,8 pada Multilingual MMLU, sedikit melampaui Claude Sonnet (83,2) dan GPT-4.5 (85,1). Skor ini penting bagi developer global yang bekerja di luar bahasa Inggris, dan saat ini Behemoth memimpin kategori ini.
Pada penalaran gambar, Behemoth mencapai 76,1 pada MMMU, mengungguli Gemini (71,8), Claude (72,7), dan GPT-4.5 (74,4). Meski ini bukan fokus utamanya, performanya tetap kompetitif dengan model multimodal terdepan.
Dalam pembuatan kode, Behemoth mencetak 49,4 pada LiveCodeBench. Itu jauh di atas Gemini 2.0 Pro (36,0).
Baik Llama 4 Scout maupun Llama 4 Maverick tersedia sekarang di bawah lisensi open-weight Meta. Anda dapat mengunduhnya langsung dari situs Llama resmi atau melalui Hugging Face.
Untuk mengakses model melalui layanan Meta sendiri, Anda dapat berinteraksi dengan Meta AI di beberapa platform: WhatsApp, Messenger, Instagram, dan Facebook. Akses saat ini memerlukan login dengan akun Meta, dan belum ada endpoint API mandiri untuk Meta AI—setidaknya untuk saat ini.
Jika Anda berencana mengintegrasikan model ke aplikasi atau infrastruktur Anda sendiri, ingat klausul lisensi: jika produk atau layanan Anda memiliki lebih dari 700 juta pengguna aktif bulanan, Anda perlu memperoleh izin terpisah dari Meta. Selain itu, model ini dapat digunakan untuk riset, eksperimen, dan sebagian besar kasus penggunaan komersial.
Scout memperkenalkan panjang konteks yang belum pernah ada pada satu GPU. Maverick mampu bersaing dengan model yang lebih besar di tugas penalaran, kode, dan multimodal. Dan Behemoth, yang masih dilatih, memberi gambaran bagaimana model guru dapat membentuk varian yang lebih efisien dan mudah dideploy.
Ruang open-weight kini lebih kompetitif dari sebelumnya. DeepSeek, Qwen, Gemma, dan sebentar lagi OpenAI, semuanya mendorong kemajuan dengan rilis yang kuat. Llama 4 hadir sebagai kelanjutan upaya Meta untuk menawarkan model yang dapat diskalakan dan tersedia secara terbuka untuk berbagai kasus penggunaan.
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




