
Cursus
Werken met Llama 3
2 uur
15.5K
Llama 4 Scout wordt gepresenteerd met een enorme contextvenster van 10 miljoen tokens, maar de training was beperkt tot een maximale invoergrootte van 256k tokens. Dit betekent dat de prestaties kunnen verslechteren bij grotere input. Om dit te voorkomen, kunnen we Llama 4 gebruiken met een retrieval-augmented generation (RAG)-pipeline.
In deze tutorial leg ik stap voor stap uit hoe je een RAG-pipeline bouwt met het LangChain-ecosysteem en een webapplicatie maakt waarmee gebruikers documenten kunnen uploaden en er vragen over kunnen stellen.
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week uitlegt. Abonneer je en blijf scherp in slechts een paar minuten per week:
Llama 4 heeft een contextvenster van 10 miljoen tokens, wat betekent dat we 100 boeken kunnen voeren en er contextuele antwoorden over kunnen krijgen. Ondanks deze indrukwekkende functie zijn er echter sterke redenen om Llama 4 te combineren met RAG. Dit is waarom:
Hoewel Llama 4 een enorm contextvenster ondersteunt, was de training beperkt tot een maximale invoergrootte van 256k tokens. De prestaties van het model kunnen afnemen wanneer de input deze drempel nadert of overschrijdt. RAG beperkt dit probleem door alleen de meest relevante informatie op te halen, zodat de input beknopt en gefocust blijft.
RAG maakt het mogelijk om zeer relevante informatie op te halen uit een vectordatabase, waardoor Llama 4 kleinere, meer gerichte inputs kan verwerken. Deze aanpak verbetert zowel de efficiëntie als de nauwkeurigheid.
Het verwerken van enorme inputs met het volledige contextvenster van Llama 4 kan veel rekenkracht vergen. Door RAG te gebruiken, wordt alleen de meest relevante data opgehaald en verwerkt, wat de rekenlast en bijbehorende kosten aanzienlijk verlaagt.
In deze tutorial leg ik stap voor stap uit hoe je een eenvoudige retrieval-augmented generation-pipeline bouwt waarmee je een .docx-bestand kunt laden en vragen over de inhoud kunt stellen.
Eerst maken we een GroqCloud API-sleutel en slaan die op als een omgevingsvariabele. Vervolgens installeren we alle benodigde Python-pakketten om de context te laden, te splitsen, te vectoriseren en op te halen, en om antwoorden te genereren.
%%capture
%pip install langchain
%pip install langchain-community
%pip install langchainhub
%pip install langchain-chroma
%pip install langchain-groq
%pip install langchain-huggingface
%pip install unstructured[docx]We zetten het modelobject op met de Groq-API, waarbij we de modelnaam en API-sleutel meegeven. Op dezelfde manier downloaden we het embeddingmodel van Hugging Face en laden we dat als ons embeddingmodel.
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=groq_api_key)

embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1")We laden het .docx-bestand uit de hoofdmap en splitsen het in stukken van 1000 tekens.
from langchain_community.document_loaders import DirectoryLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter

# Initialize the text splitter
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"]
)

# Load the .docx files
loader = DirectoryLoader("./", glob="*.docx", use_multithreading=True)
documents = loader.load()

# Split the documents into chunks
chunks = text_splitter.split_documents(documents)

# Print the number of chunks
print(len(chunks))29Initialiseer de Chroma-vectorstore en geef de tekstfragmenten door aan de vectordatabase. De tekst wordt eerst naar embeddings omgezet en daarna opgeslagen. Vervolgens doen we een similarity search om te testen of onze vectorstore goed gevuld is.
from langchain_chroma import Chroma

vectorstore = Chroma.from_documents(
    documents=chunks,
    embedding=embed_model,
    persist_directory="./Vectordb",
)

query = "What is this tutorial about?"
docs = vectorstore.similarity_search(query)
print(docs[0].page_content)
Learn how to Fine-tune Stable Diffusion XL with DreamBooth and LoRA on your personal images.
Let's try another prompt:
Prompt:Vervolgens zetten we onze vectorstore om in een retriever en maken we een prompttemplate voor de RAG-pipeline.
# Create retriever
retriever = vectorstore.as_retriever()

# Import PromptTemplate
from langchain_core.prompts import PromptTemplate

# Define a clearer, more professional prompt template
template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.

Context:
{context}

Question:
{question}

Answer:"""

# Create the PromptTemplate
rag_prompt = PromptTemplate.from_template(template)
Tot slot maken we de RAG-keten die zowel de context als de vraag in de RAG-prompt meegeeft, deze door het Llama 4-model stuurt en vervolgens een nette respons genereert.
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
We gaan de RAG-keten nu vragen stellen over het document.
from IPython.display import display, Markdown

response = rag_chain.invoke("What this tutorial about?")
Markdown(response)
This tutorial is about setting up and using the Janus project, specifically Janus Pro, a multimodal model that can understand images and generate images from text prompts, and building a local solution to use the model privately on a laptop GPU. It covers learning about the Janus Series, setting up the Janus project, building a Docker container to run the model locally, and testing its capabilities with various image and text prompts.Zoals je ziet is de respons zeer accuraat en contextbewust. Loop je tegen problemen aan met de bovenstaande code, raadpleeg dan deze DataLab-workbook: Llama 4 RAG-pipeline.
In deze sectie zetten we de eerder besproken RAG-pipeline om in een werkende chatapplicatie met het Gradio-pakket. Om te beginnen installeer je Gradio met het volgende pip-commando:
$ pip install gradioDe applicatie is eenvoudig en gebruiksvriendelijk ontworpen: je kunt één .docx-bestand, meerdere .docx-bestanden of een .zip-archief met .docx-bestanden uploaden. Daarna kun je vragen stellen over de inhoud van alle geüploade bestanden, zodat je snel en efficiënt informatie kunt terugvinden.
De applicatie biedt:
Laten we alles samenbrengen:
main.py:
# ========== Standard Library ==========
import os
import tempfile
import zipfile
from typing import List, Optional, Tuple, Union
import collections


# ========== Third-Party Libraries ==========
import gradio as gr
from groq import Groq
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import DirectoryLoader, UnstructuredFileLoader
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_groq import ChatGroq
from langchain_huggingface import HuggingFaceEmbeddings

# ========== Configs ==========
TITLE = """<h1 align="center">🗨️🦙 Llama 4 Docx Chatter</h1>"""
AVATAR_IMAGES = (
    None,
    "./logo.png",
)

# Acceptable file extensions
TEXT_EXTENSIONS = [".docx", ".zip"]

# ========== Models & Clients ==========
GROQ_API_KEY = os.getenv("GROQ_API_KEY")
client = Groq(api_key=GROQ_API_KEY)
llm = ChatGroq(model="meta-llama/llama-4-scout-17b-16e-instruct", api_key=GROQ_API_KEY)
embed_model = HuggingFaceEmbeddings(model_name="mixedbread-ai/mxbai-embed-large-v1")

# ========== Core Components ==========
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=100,
    separators=["\n\n", "\n"],
)

rag_template = """You are an expert assistant tasked with answering questions based on the provided documents.
Use only the given context to generate your answer.
If the answer cannot be found in the context, clearly state that you do not know.
Be detailed and precise in your response, but avoid mentioning or referencing the context itself.
Context:
{context}
Question:
{question}
Answer:"""
rag_prompt = PromptTemplate.from_template(rag_template)


# ========== App State ==========
class AppState:
    vectorstore: Optional[InMemoryVectorStore] = None
    rag_chain = None


state = AppState()

# ========== Utility Functions ==========


def load_documents_from_files(files: List[str]) -> List:
    """Load documents from uploaded files directly without moving."""
    all_documents = []

    # Temporary directory if ZIP needs extraction
    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                # Extract ZIP inside temp_dir
                with zipfile.ZipFile(file_path, "r") as zip_ref:
                    zip_ref.extractall(temp_dir)

                # Load all docx from extracted zip
                loader = DirectoryLoader(
                    path=temp_dir,
                    glob="**/*.docx",
                    use_multithreading=True,
                )
                docs = loader.load()
                all_documents.extend(docs)

            elif ext == ".docx":
                # Load single docx directly
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                all_documents.extend(docs)

    return all_documents


def get_last_user_message(chatbot: List[Union[gr.ChatMessage, dict]]) -> Optional[str]:
    """Get last user prompt."""
    for message in reversed(chatbot):
        content = (
            message.get("content") if isinstance(message, dict) else message.content
        )
        if (
            message.get("role") if isinstance(message, dict) else message.role
        ) == "user":
            return content
    return None


# ========== Main Logic ==========


def upload_files(
    files: Optional[List[str]], chatbot: List[Union[gr.ChatMessage, dict]]
):
    """Handle file upload - .docx or .zip containing docx."""
    if not files:
        return chatbot

    file_summaries = []  # <-- Collect formatted file/folder info
    documents = []

    with tempfile.TemporaryDirectory() as temp_dir:
        for file_path in files:
            filename = os.path.basename(file_path)
            ext = os.path.splitext(file_path)[1].lower()

            if ext == ".zip":
                file_summaries.append(f"📦 **{filename}** (ZIP file) contains:")
                try:
                    with zipfile.ZipFile(file_path, "r") as zip_ref:
                        zip_ref.extractall(temp_dir)
                        zip_contents = zip_ref.namelist()

                        # Group files by folder
                        folder_map = collections.defaultdict(list)
                        for item in zip_contents:
                            if item.endswith("/"):
                                continue  # skip folder entries themselves
                            folder = os.path.dirname(item)
                            file_name = os.path.basename(item)
                            folder_map[folder].append(file_name)

                        # Format nicely
                        for folder, files_in_folder in folder_map.items():
                            if folder:
                                file_summaries.append(f"📂 {folder}/")
                            else:
                                file_summaries.append(f"📄 (root)")
                            for f in files_in_folder:
                                file_summaries.append(f"   - {f}")

                    # Load docx files extracted from ZIP
                    loader = DirectoryLoader(
                        path=temp_dir,
                        glob="**/*.docx",
                        use_multithreading=True,
                    )
                    docs = loader.load()
                    documents.extend(docs)

                except zipfile.BadZipFile:
                    chatbot.append(
                        gr.ChatMessage(
                            role="assistant",
                            content=f"❌ Failed to open ZIP file: {filename}",
                        )
                    )

            elif ext == ".docx":
                file_summaries.append(f"📄 **{filename}**")
                loader = UnstructuredFileLoader(file_path)
                docs = loader.load()
                documents.extend(docs)

            else:
                file_summaries.append(f"❌ Unsupported file type: {filename}")

    if not documents:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="No valid .docx files found in upload."
            )
        )
        return chatbot

    # Split documents
    chunks = text_splitter.split_documents(documents)
    if not chunks:
        chatbot.append(
            gr.ChatMessage(
                role="assistant", content="Failed to split documents into chunks."
            )
        )
        return chatbot

    # Create Vectorstore
    state.vectorstore = InMemoryVectorStore.from_documents(
        documents=chunks,
        embedding=embed_model,
    )
    retriever = state.vectorstore.as_retriever()

    # Build RAG Chain
    state.rag_chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | rag_prompt
        | llm
        | StrOutputParser()
    )

    # Final display
    chatbot.append(
        gr.ChatMessage(
            role="assistant",
            content="**Uploaded Files:**\n"
            + "\n".join(file_summaries)
            + "\n\n✅ Ready to chat!",
        )
    )
    return chatbot


def user_message(
    text_prompt: str, chatbot: List[Union[gr.ChatMessage, dict]]
) -> Tuple[str, List[Union[gr.ChatMessage, dict]]]:
    """Add user's text input to conversation."""
    if text_prompt.strip():
        chatbot.append(gr.ChatMessage(role="user", content=text_prompt))
    return "", chatbot


def process_query(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Process user's query through RAG pipeline."""
    prompt = get_last_user_message(chatbot)
    if not prompt:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please type a question first.")
        )
        return chatbot

    if state.rag_chain is None:
        chatbot.append(
            gr.ChatMessage(role="assistant", content="Please upload documents first.")
        )
        return chatbot

    chatbot.append(gr.ChatMessage(role="assistant", content="Thinking..."))

    try:
        response = state.rag_chain.invoke(prompt)
        chatbot[-1].content = response
    except Exception as e:
        chatbot[-1].content = f"Error: {str(e)}"

    return chatbot


def reset_app(
    chatbot: List[Union[gr.ChatMessage, dict]],
) -> List[Union[gr.ChatMessage, dict]]:
    """Reset application state."""
    state.vectorstore = None
    state.rag_chain = None
    return [
        gr.ChatMessage(
            role="assistant", content="App reset! Upload new documents to start."
        )
    ]


# ========== UI Layout ==========

with gr.Blocks(theme=gr.themes.Soft()) as demo:
    gr.HTML(TITLE)
    chatbot = gr.Chatbot(
        label="Llama 4 RAG",
        type="messages",
        bubble_full_width=False,
        avatar_images=AVATAR_IMAGES,
        scale=2,
        height=350,
    )

    with gr.Row(equal_height=True):
        text_prompt = gr.Textbox(
            placeholder="Ask a question...", show_label=False, autofocus=True, scale=28
        )
        send_button = gr.Button(
            value="Send",
            variant="primary",
            scale=1,
            min_width=80,
        )
        upload_button = gr.UploadButton(
            label="Upload",
            file_count="multiple",
            file_types=TEXT_EXTENSIONS,
            scale=1,
            min_width=80,
        )
        reset_button = gr.Button(
            value="Reset",
            variant="stop",
            scale=1,
            min_width=80,
        )

    send_button.click(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    text_prompt.submit(
        fn=user_message,
        inputs=[text_prompt, chatbot],
        outputs=[text_prompt, chatbot],
        queue=False,
    ).then(fn=process_query, inputs=[chatbot], outputs=[chatbot])

    upload_button.upload(
        fn=upload_files, inputs=[upload_button, chatbot], outputs=[chatbot], queue=False
    )
    reset_button.click(fn=reset_app, inputs=[chatbot], outputs=[chatbot], queue=False)

demo.queue().launch()Nu draaien we de webapplicatie en testen we de functionaliteit. Start de applicatie met het volgende commando in de terminal:
$ python main.py Zodra de webserver draait, ga je naar de volgende URL of kopieer je deze handmatig naar je browser om de webinterface te openen: http://127.0.0.1:7860
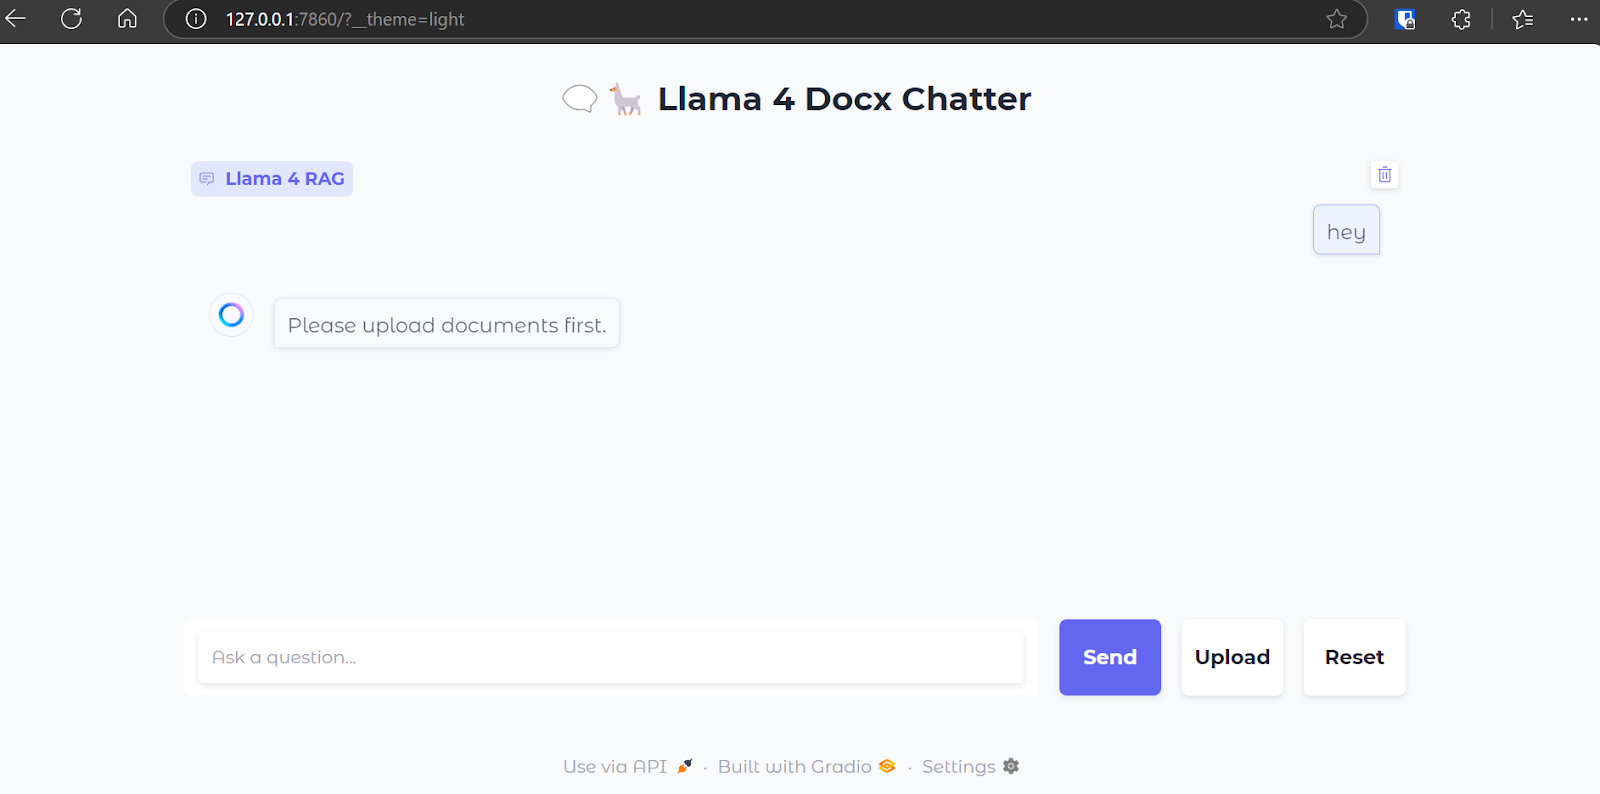
Zo ziet onze chatinterface eruit:
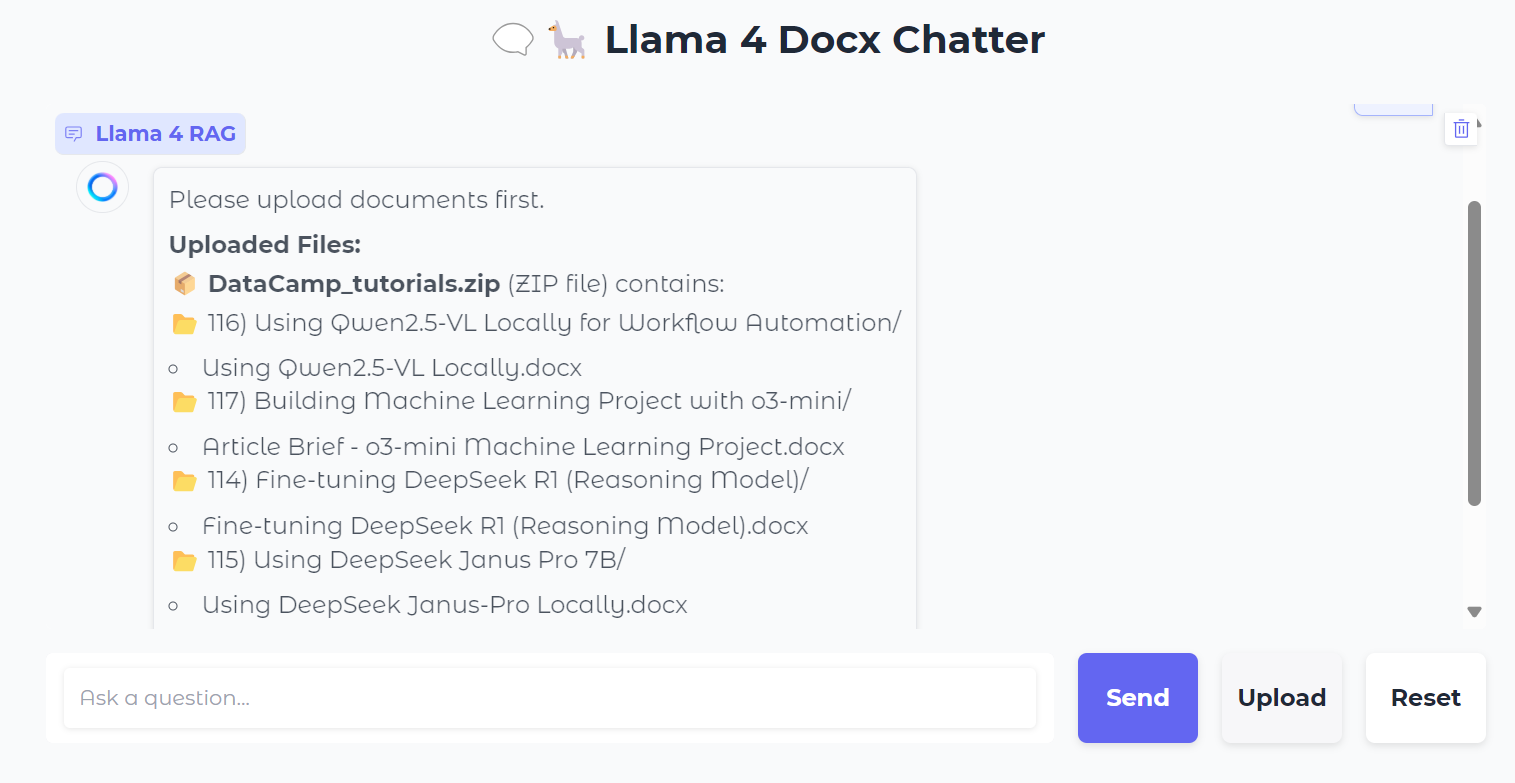
We uploaden een .zip-bestand met .docx-bestanden, en terwijl we dit doen, zie je alle mappen en bestanden binnen het zipbestand.
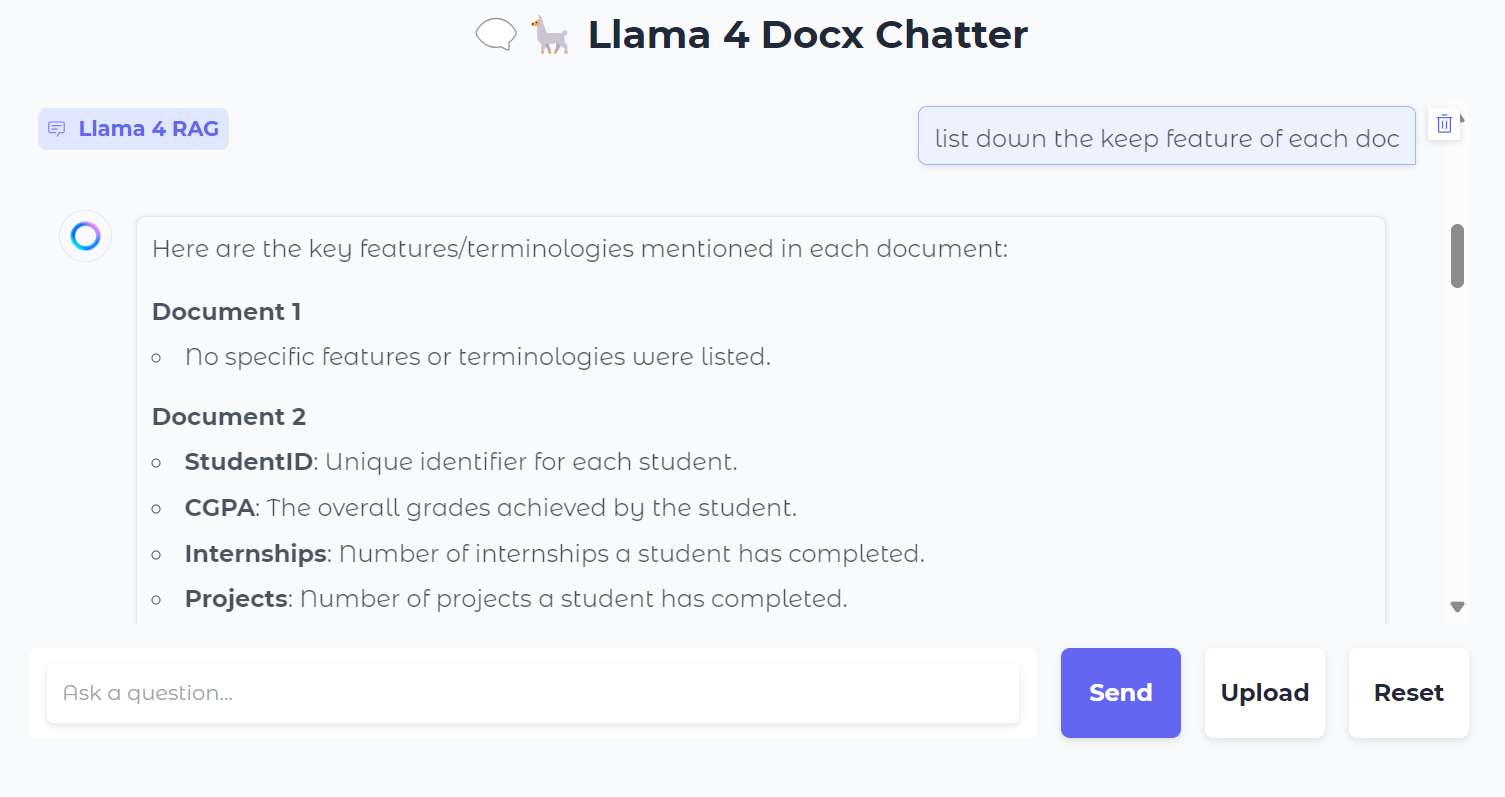
Vervolgens kunnen we gerichte vragen stellen over de documenten:
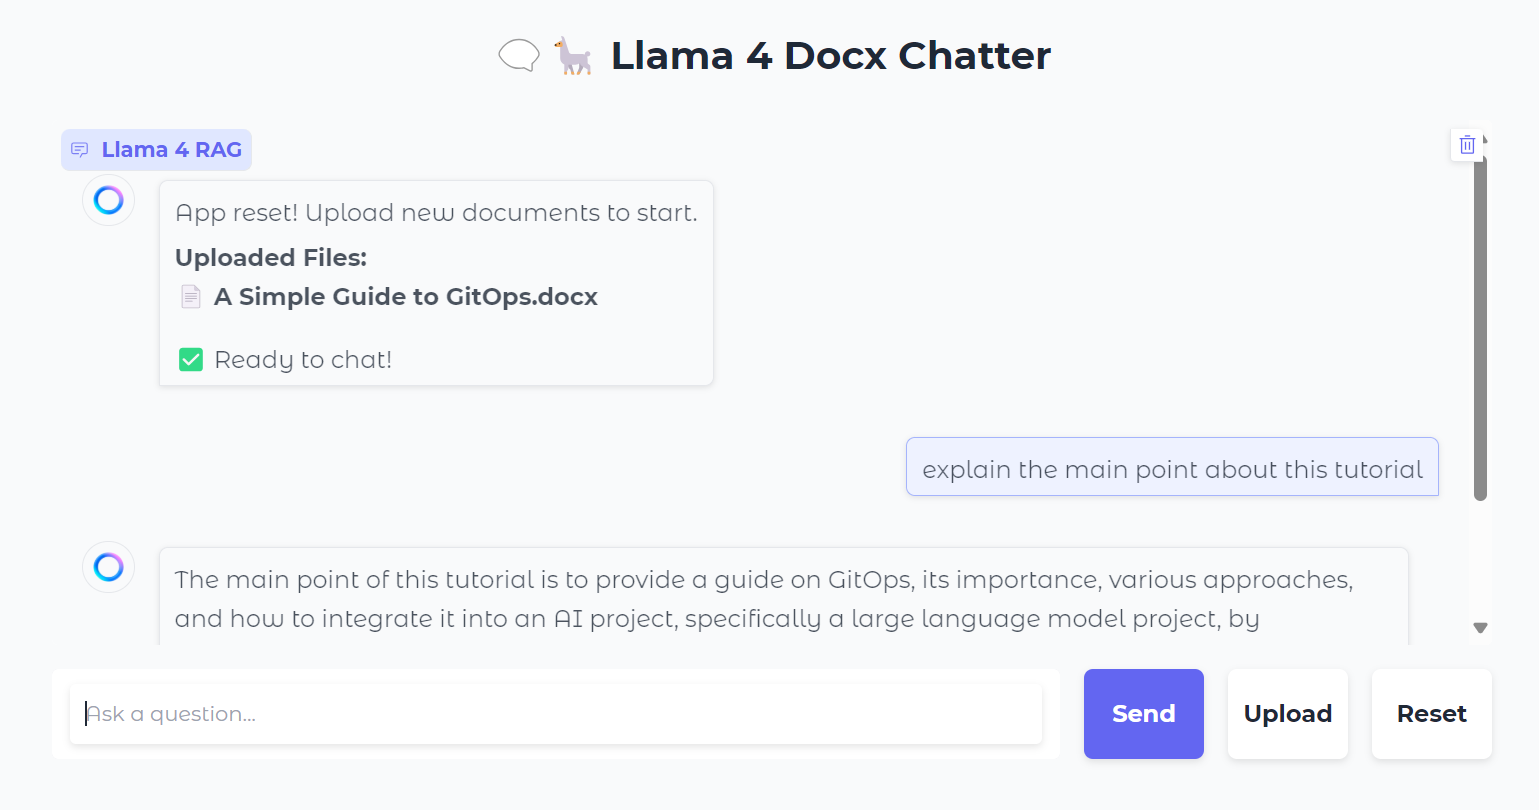
Je kunt ook op de knop “Reset” drukken om een nieuw bestand te uploaden en er binnen enkele seconden over te chatten.
Na lokale tests kun je de webapplicatie eenvoudig gratis deployen op Hugging Face Space. Hier is de link naar de gedeployde app: kingabzpro/Llama-4-RAG
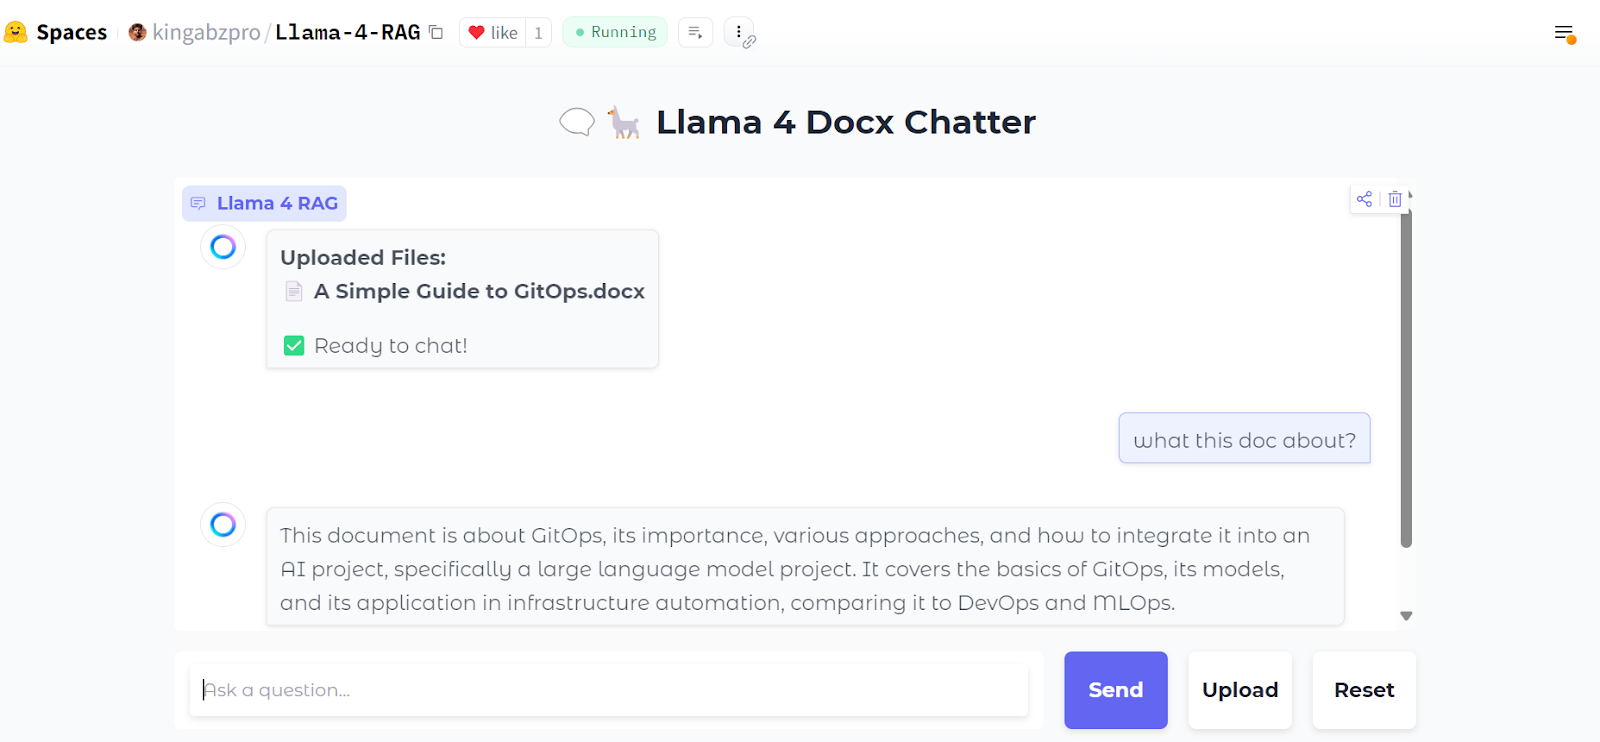
Bron: kingabzpro/Llama-4-RAG
De broncode, notebook en configuratiebestanden vind je in de kingabzpro/Llama-4-RAG-repository.
Zelfs met de opkomst van modellen met lange contextvensters zal RAG nooit overbodig worden. RAG blijft een efficiënte en kosteneffectieve methode om informatie uit externe bronnen op te halen en extra context aan modellen te bieden.
Bovendien zijn RAG-systemen van nature goedkoper in gebruik dan het direct voeren van uitgebreide context aan een model, wat aanzienlijke rekenkracht vereist. Dit maakt RAG in veel gevallen een praktische en schaalbare oplossing.
Wil je meer weten over Llama 4? Bekijk dan deze resources:
Leer AI met deze cursussen!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

