
Last chance! 50% off DataCamp Premium
Sale ends in
Anda menganalisis perilaku pelanggan untuk sebuah platform e-commerce, dan manajer Anda bertanya: "Berapa probabilitas seorang pelanggan churn, terlepas dari alasannya?"
Pertanyaan ini menyasar sesuatu yang lebih spesifik daripada yang Anda kira. Anda tidak sedang menanyakan tentang churn dengan ketentuan kategori produk tertentu, atau churn dikombinasikan dengan metode pembayaran. Anda menanyakan probabilitas dasar dari satu kejadian: churn pelanggan, titik.
Itulah probabilitas marginal, dan ini mendasari sebagian besar perhitungan probabilitas yang akan Anda temui dalam data science.
Seperti yang saya perkenalkan, probabilitas marginal adalah probabilitas terjadinya satu kejadian, tanpa memedulikan variabel atau kejadian lain. Disebut "marginal" karena saat Anda menuliskan probabilitas gabungan dalam sebuah tabel, probabilitas satu kejadian ini muncul di margin (total baris dan kolom).
Notasinya sederhana. Untuk kejadian diskret A, kita tulis P(A). Probabilitas marginal sering muncul dari probabilitas gabungan. Jika B adalah variabel acak diskret dan Anda mengetahui probabilitas gabungan A terjadi dengan tiap nilai B, Anda bisa mendapatkan probabilitas marginal dengan menjumlahkan: P(A) = Σb P(A, B=b), di mana Anda menjumlahkan seluruh nilai b yang mungkin diambil oleh B. Probabilitas marginal adalah sisa yang diperoleh ketika Anda "menjumlahkan" atau "mengintegralkan" semua variabel lain.
Untuk memahami konsep ini sepenuhnya, Anda memerlukan beberapa istilah dasar. Ruang sampel adalah himpunan semua keluaran yang mungkin. Sebuah kejadian adalah subset apa pun dari ruang sampel. Probabilitas gabungan P(A ∩ B) mengukur peluang dua kejadian terjadi bersamaan, sedangkan probabilitas bersyarat P(A|B) mengukur peluang A dengan ketentuan bahwa B telah terjadi.
Saya menyarankan Anda melihat Cheat Sheet Pengantar Aturan Probabilitas kami sebagai rujukan cepat atas hubungan-hubungan ini. Probabilitas marginal berada di pusat ekosistem probabilitas ini. Ia menjadi penyebut dalam perhitungan probabilitas bersyarat dan batu bata penyusun Teorema Bayes.
Mari lihat bagaimana Anda benar-benar menghitung probabilitas marginal dari berbagai struktur data. Pendekatannya tergantung apakah Anda bekerja dengan variabel diskret atau kontinu.
Saat bekerja dengan data kategorikal, probabilitas marginal muncul secara alami dalam tabel kontingensi. Misalkan Anda menganalisis perilaku pembelian pelanggan di berbagai kategori produk (Elektronik, Pakaian, Buku) dan wilayah (Utara, Selatan, Timur, Barat). Tiap sel berisi probabilitas gabungan dari kombinasi kategori-wilayah. Total baris memberi Anda probabilitas marginal untuk tiap kategori produk (P(Elektronik), P(Pakaian), P(Buku)) tanpa memedulikan wilayah. Total kolom memberi Anda probabilitas marginal untuk tiap wilayah.
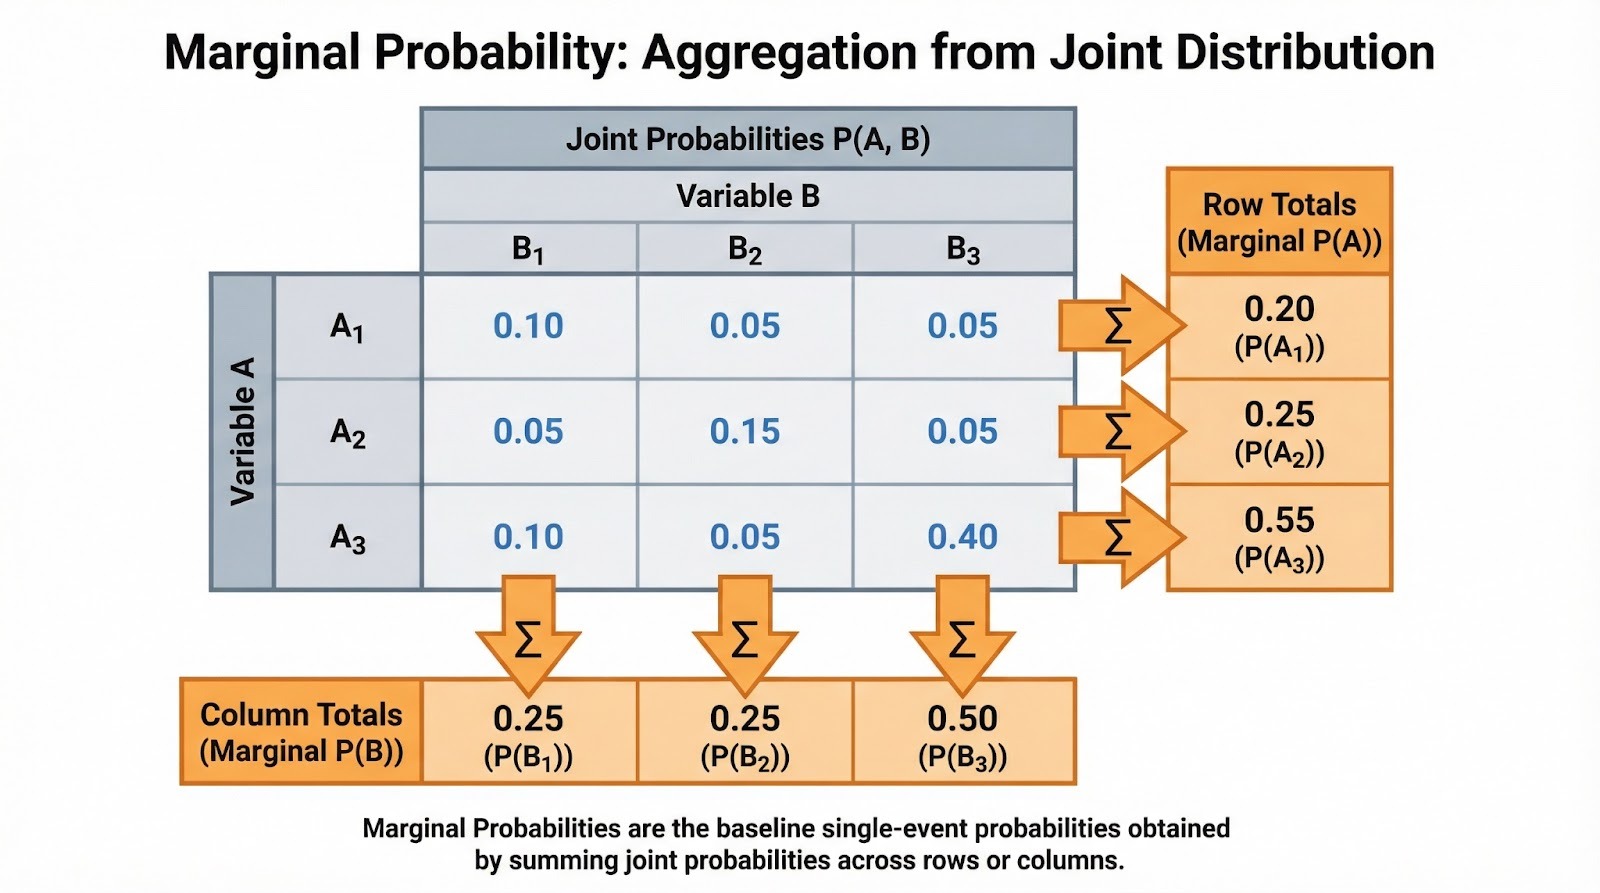
Menjumlahkan probabilitas gabungan untuk menemukan probabilitas marginal. Gambar oleh Penulis.
Anda sering menjumpainya sebagai frekuensi yang dinormalisasi. Jika 500 dari 2.000 pelanggan membeli elektronik, maka probabilitas marginal P(Elektronik) = 500/2.000 = 0,25. Ini adalah laju dasar sebelum mempertimbangkan faktor lain. Saat melakukan eksplorasi data, saya menyarankan menghitung marginal terlebih dahulu. Ini membantu Anda memahami struktur dasar data sebelum menyelami hubungan bersyarat.
Untuk variabel acak kontinu, probabilitas marginal menjadi fungsi kerapatan probabilitas marginal (PDF). Jika Anda memiliki dua variabel kontinu X dan Y dengan PDF gabungan, PDF marginal X diperoleh dengan mengintegralkan atas semua nilai Y.
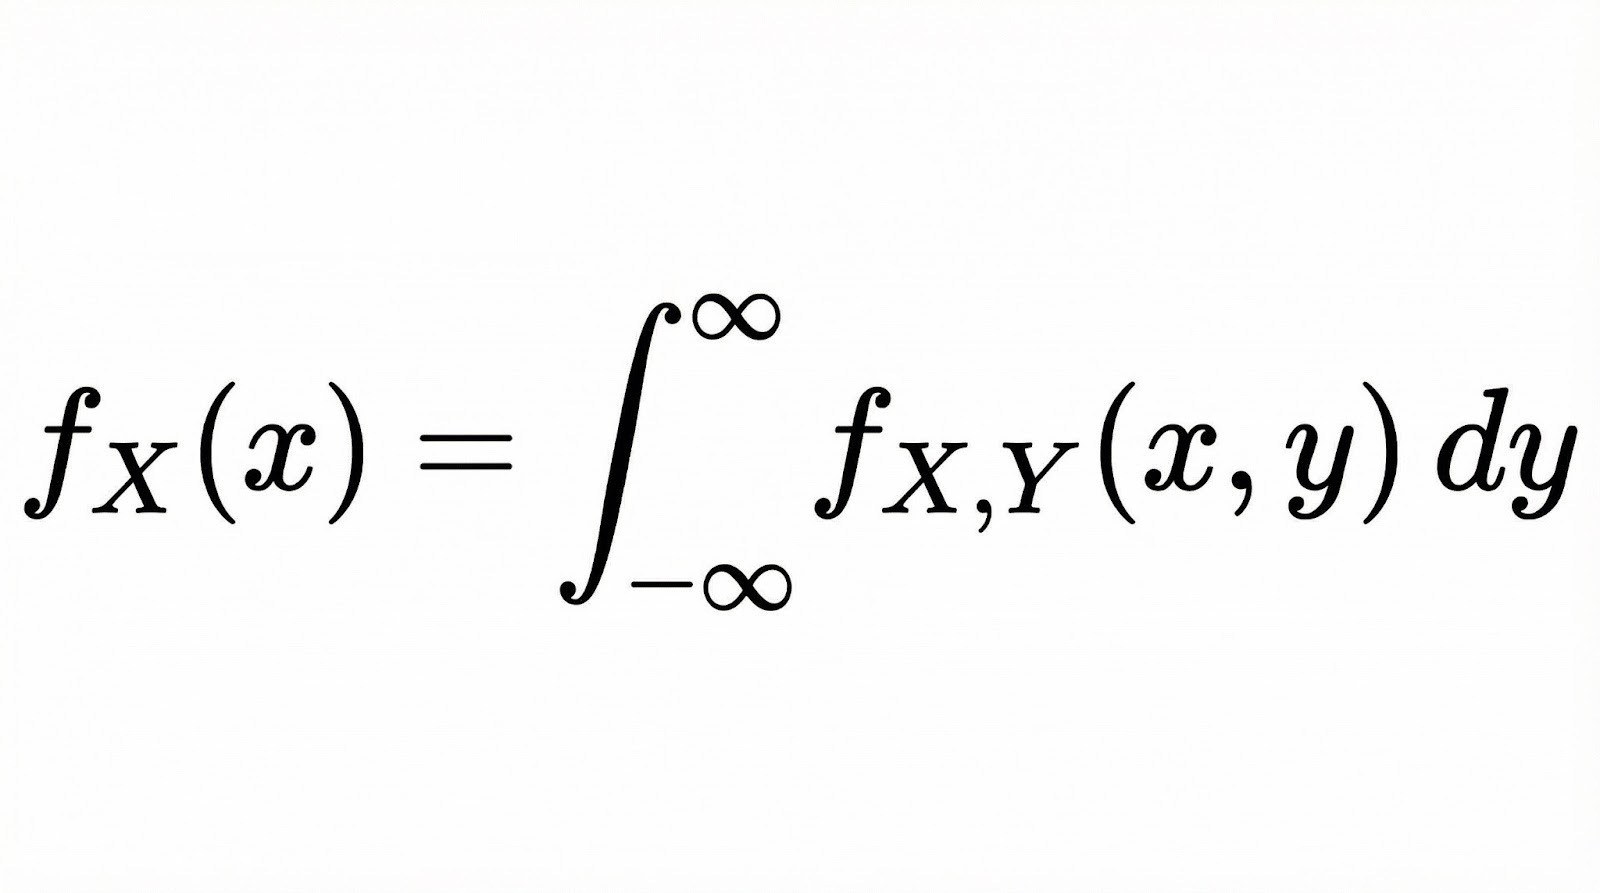
Secara konseptual, integrasi di sini melakukan hal yang sama dengan penjumlahan pada kasus diskret. Ia "meruntuhkan" distribusi gabungan menjadi satu dimensi dengan memperhitungkan semua kemungkinan variabel lainnya.
Bayangkan ini seperti mengiris permukaan 3D (distribusi gabungan) dan melihat luas di bawah kurva sepanjang satu sumbu. Kursus Fundamentals of Bayesian Data Analysis in R kami membahas konsep-konsep ini secara mendalam saat bekerja dengan distribusi kontinu.
Mari kita telusuri bagaimana probabilitas marginal terhubung dengan jenis probabilitas lain yang akan sering Anda gunakan.
Ketiga jenis probabilitas ini membentuk sistem yang saling terkait, dan probabilitas marginal sering menjadi perekat yang menyatukannya. Dari probabilitas gabungan, Anda mendapatkan marginal dengan menjumlahkan atau mengintegralkan. Dari probabilitas gabungan dan marginal, Anda menghitung bersyarat menggunakan P(A|B) = P(A ∩ B) / P(B). Perhatikan bahwa probabilitas marginal P(B) adalah penyebutnya. Ia menormalkan probabilitas gabungan untuk memberi Anda probabilitas bersyarat.
Ini penting dalam praktik karena saat Anda menafsirkan probabilitas bersyarat, Anda memerlukan marginal sebagai konteks. Probabilitas 90% terkena penyakit jika hasil tes positif terdengar mengkhawatirkan, tetapi jika probabilitas marginal penyakit hanya 1%, probabilitas aktual setelah tes positif mungkin jauh lebih rendah dari yang Anda kira.
Hal ini muncul di mana-mana dalam inferensi Bayesian. Prior adalah keyakinan Anda tentang suatu parameter sebelum melihat data. Likelihood marginal (juga disebut evidence), P(Data), adalah istilah normalisasi dalam Teorema Bayes yang mengubah "prior × likelihood" menjadi probabilitas posterior yang semestinya. Kursus Bayesian Data Analysis in Python kami mengeksplorasi keterkaitan ini melalui latihan pemodelan praktis.
Mari kita kerjakan baik masalah probabilitas klasik maupun skenario dunia nyata.
Mari mulai dengan dadu. Jika Anda melempar dua dadu, berapa probabilitas dadu pertama menunjukkan angka 4, tanpa memedulikan nilai dadu kedua?
Ruang sampel memiliki 36 keluaran yang sama kemungkinannya. Enam di antaranya memiliki angka 4 pada dadu pertama: (4,1), (4,2), (4,3), (4,4), (4,5), (4,6). Jadi P(Dadu pertama = 4) = 6/36 = 1/6. Perhatikan kita tidak mensyaratkan apa pun tentang dadu kedua. Kita cukup menghitung semua keluaran di mana dadu pertama bernilai 4.
Berikut contoh klasik lainnya. Mengambil dari setumpuk kartu standar 52 kartu, berapa probabilitas mengambil kartu hati, tanpa memedulikan pangkat? Ada 13 kartu hati dan total 52 kartu, jadi P(Hati) = 13/52 = 1/4. Probabilitas marginal ini mengagregasi di seluruh pangkat (As hingga Raja), memberi Anda probabilitas tak bersyarat dari jenis kartu tersebut.
Skrining medis memberikan penerapan dunia nyata yang menarik. Misalkan Anda menganalisis prevalensi penyakit dalam suatu populasi. Probabilitas marginal P(Penyakit) merepresentasikan tingkat penyakit dasar sebelum mempertimbangkan hasil tes diagnostik apa pun. Jika 2% populasi mengidap penyakit tersebut, P(Penyakit) = 0,02. Probabilitas marginal ini penting untuk menafsirkan akurasi tes. Tes dengan sensitivitas 95% tetap menghasilkan banyak positif palsu saat penyakitnya langka.
Dalam pemasaran digital, Anda mungkin bertanya: Berapa probabilitas seorang pengguna melakukan konversi, tanpa memedulikan sumber trafik? Jika Anda memiliki data konversi dari penelusuran organik, iklan berbayar, media sosial, dan email, probabilitas marginal P(Konversi) menjumlahkan di seluruh sumber. Laju konversi dasar ini membantu Anda menilai apakah sumber trafik tertentu berkinerja di atas atau di bawah rata-rata.
Demikian pula, dalam keuangan, Anda dapat menghitung probabilitas marginal penurunan pasar tanpa memedulikan tingkat suku bunga. Ini memberi Anda risiko tak bersyarat sebelum menambahkan faktor makroekonomi.
Mari telusuri bagaimana probabilitas marginal muncul di seluruh alur kerja data science.
Saat pertama kali menemui sebuah dataset, menghitung probabilitas marginal membantu Anda memahami laju kejadian dasar. Dalam dataset deteksi penipuan, P(Penipuan) memberi tahu Anda keseimbangan kelas sebelum Anda meninjau fitur apa pun. Ini segera mengungkap apakah Anda berurusan dengan masalah yang sangat tidak seimbang di mana penipuan terjadi hanya pada 0,1% transaksi.
Distribusi marginal untuk tiap fitur juga memandu analisis Anda. Jika Anda membangun model untuk memprediksi churn pelanggan, saya sarankan meninjau P(Churn), P(Pelanggan bernilai tinggi), dan P(Aktivitas terbaru) secara terpisah. Ini memberikan konteks sebelum Anda mengeksplorasi hubungan gabungan mereka.
Klasifikator Naive Bayes secara eksplisit mengandalkan probabilitas marginal sebagai prior kelas. Saat mengklasifikasikan sebuah dokumen sebagai spam atau bukan spam, P(Spam) adalah keyakinan awal Anda sebelum melihat kata-kata dalam dokumen. Algoritme kemudian memperbarui probabilitas marginal ini berdasarkan probabilitas fitur bersyarat.
Distribusi marginal fitur juga penting dalam rekayasa fitur dan diagnostik model. Jika distribusi marginal suatu fitur sangat menyimpang, Anda mungkin menerapkan transformasi seperti skala log atau Box-Cox agar lebih simetris.
Perubahan antar dataset sama pentingnya. Misalnya, jika set pelatihan Anda memiliki P(Kelas A)=0,9 tetapi set uji Anda memiliki P(Kelas A)=0,5, probabilitas prediksi dan metrik kinerja Anda bisa banyak berubah, dan Anda mungkin memerlukan ambang keputusan yang berbeda. Ini terjadi karena model belajar di bawah laju dasar tertentu, tetapi dievaluasi di bawah laju dasar yang lain.
Memeriksa distribusi marginal sebelum pelatihan membantu Anda menangkap masalah ini lebih awal dan memutuskan apakah Anda memerlukan resampling, metrik evaluasi berbeda, rekalibrasi, atau model terpisah untuk segmen data yang berbeda.
Perhitungan nilai harapan memerlukan probabilitas marginal. Jika Anda memutuskan apakah akan meluncurkan produk, Anda membutuhkan P(Sukses) sebagai probabilitas marginal keberhasilan di seluruh kemungkinan kondisi pasar. Kalikan ini dengan payoff dari keberhasilan, tambahkan dengan P(Gagal) dikali biaya kegagalan, dan Anda mendapatkan nilai harapan.
Dalam jaringan Bayesian dan model graf, node merepresentasikan variabel dengan distribusi probabilitas bersyarat terkait. Distribusi marginal diperoleh melalui inferensi dengan mempropagasikan probabilitas melalui struktur jaringan atau dengan mengamati bukti dan memperbarui keyakinan. Metode sampling seperti Markov Chain Monte Carlo mendekati marginal saat perhitungan eksak menjadi sulit. Kursus Bayesian Modeling with RJAGS kami menunjukkan metode-metode ini dalam praktik.
Berikut kesalahan yang menjebak bahkan praktisi berpengalaman.
Ini mungkin kesalahan paling umum, dan cukup intuitif terjadi. Bayangkan Anda menjalani tes medis dengan sensitivitas 95% dan spesifisitas 90%. Hasil Anda positif. Kebanyakan orang langsung berpikir: "Tes menangkap 95% kasus, jadi saya mungkin mengidap penyakitnya."
Namun penalaran itu melewatkan informasi penting: seberapa umum penyakit itu sejak awal? Jika hanya 1% orang yang mengidapnya (probabilitas marginal), maka ketika Anda menguji 10.000 orang, Anda akan mendapatkan sekitar 95 positif benar tetapi 990 positif palsu. Artinya, sebagian besar hasil positif adalah alarm palsu. Probabilitas Anda yang sebenarnya setelah hasil positif hanya sekitar 9%, bukan 95%.
Kebingungan terjadi karena orang fokus pada sensitivitas tes (95%) dan melupakan laju dasar (prevalensi 1%). Probabilitas marginal P(Penyakit) = 0,01 dan probabilitas bersyarat P(Penyakit | Tes positif) = 0,09 adalah besaran yang sama sekali berbeda, tetapi intuisi kita ingin memperlakukan keduanya sama.
Bahkan ketika orang membedakan dengan benar antara probabilitas marginal dan bersyarat, mereka sering mengabaikan marginal saat menafsirkan bersyarat. Anda mungkin melihat judul berita: "Studi menemukan 80% pengusaha sukses memulai sebelum usia 30." Itu adalah P(Mulai sebelum 30 | Pengusaha sukses) = 0,8. Namun tanpa mengetahui P(Mulai sebelum 30) untuk semua pengusaha, Anda tidak bisa menilai apakah memulai muda benar-benar memprediksi kesuksesan.
Ini mengarah pada pengambilan keputusan yang cacat. Jika 90% semua pengusaha memulai sebelum 30, maka pengusaha sukses tidak memulai muda pada tingkat yang tidak biasa. Mereka hanya mengikuti pola umum. Probabilitas bersyarat kurang bermakna tanpa tolok ukur marginal untuk perbandingan.
Kekeliruan laju dasar terjadi saat orang melebihbobotkan bukti bersyarat sambil mengabaikan probabilitas marginal (laju dasar).
Berikut contoh umum di data science: Anda membangun klasifikator biner pada dataset yang tidak seimbang. Kelas positif (yang ingin Anda prediksi) hanya muncul pada 5% data Anda. Anda membangun model dan mencapai akurasi 95%. Terdengar hebat, bukan?
Tidak juga. Jika Anda membangun model "naif" yang hanya memprediksi kelas negatif setiap saat, ia juga akan mendapatkan akurasi 95% (karena 95% data adalah negatif). Model canggih Anda sebenarnya tidak jauh lebih baik daripada selalu menebak "tidak."
Kesalahannya adalah melihat angka akurasi 95% secara terpisah tanpa mempertimbangkan laju dasar (5% kelas positif). Saat kelas tidak seimbang, akurasi menjadi metrik yang menyesatkan. Anda perlu memeriksa precision, recall, atau F1-score untuk melihat apakah model Anda benar-benar mempelajari sesuatu yang berguna.
Memahami marginal membantu Anda memilih metrik evaluasi yang tepat untuk masalah tidak seimbang.
Dalam model berdimensi tinggi dengan puluhan atau ratusan variabel, menghitung distribusi marginal secara eksak sering kali tidak mungkin. Jumlah kombinasi yang mungkin tumbuh pesat, dan jumlah atau integral yang diperlukan menjadi tidak terjangkau.
Untuk menanganinya, praktisi menggunakan metode inferensi aproksimasi:
Perangkat modern seperti scipy.stats di Python untuk distribusi probabilitas, pandas untuk tabel kontingensi, serta table() dan dplyr di R untuk marginal empiris membuat perhitungan ini dapat diakses. Untuk data yang tersimpan di basis data, klausa SQL GROUP BY menghitung marginal empiris secara efisien dari dataset besar.
Sebelum Anda dapat memahami hubungan antar variabel, menilai bukti bersyarat, atau membangun model Bayesian, Anda perlu memahami probabilitas tak bersyarat dari kejadian individual. Inilah dasar yang membuat hal lainnya dapat ditafsirkan.
Ketika Anda salah memahami marginal, Anda rentan terhadap kesalahan analitis: menyamakan laju dasar dengan probabilitas bersyarat, terjebak kekeliruan laju dasar, atau membangun model yang tidak melampaui baseline naif. Pahami marginal dengan benar, dan Anda akan mengerti bagaimana probabilitas bersyarat menyempurnakannya, bagaimana Teorema Bayes memperbaruinya dengan bukti, dan bagaimana model machine learning belajar dari pola yang mereka ungkapkan.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt




