Bạn đang phân tích hành vi khách hàng cho một nền tảng thương mại điện tử và quản lý của bạn hỏi: "Xác suất một khách hàng rời bỏ là bao nhiêu, bất kể lý do?"
Câu hỏi này nhắm đến một điều cụ thể hơn bạn tưởng. Bạn không hỏi về rời bỏ với điều kiện một danh mục sản phẩm cụ thể, hay rời bỏ kết hợp với phương thức thanh toán. Bạn đang hỏi về xác suất cơ sở của một sự kiện đơn lẻ: khách hàng rời bỏ, hết.
Đó là xác suất biên, và nó là nền tảng cho hầu hết các phép tính xác suất bạn sẽ gặp trong khoa học dữ liệu.
Xác suất biên là gì?
Như đã giới thiệu, xác suất biên là xác suất xảy ra của một sự kiện đơn lẻ, không phụ thuộc vào các biến hoặc sự kiện khác. Nó được gọi là "biên" vì khi bạn viết các xác suất kết hợp trong một bảng, các xác suất cho sự kiện đơn lẻ xuất hiện ở phần lề (tổng hàng và tổng cột).
Ký hiệu thì đơn giản. Với một sự kiện rời rạc A, ta viết P(A). Xác suất biên thường xuất phát từ xác suất kết hợp. Nếu B là một biến ngẫu nhiên rời rạc và bạn biết xác suất kết hợp của A xảy ra với mỗi giá trị của B, bạn có thể tìm xác suất biên bằng cách cộng: P(A) = Σb P(A, B=b), trong đó bạn cộng trên mọi giá trị b mà B có thể nhận. Xác suất biên là phần còn lại khi bạn "cộng dồn" hoặc "tích phân bỏ" tất cả các biến khác.
Để hiểu đầy đủ khái niệm này, bạn cần một số thuật ngữ nền tảng. Không gian mẫu là tập hợp tất cả các kết quả có thể. Một biến cố là bất kỳ tập con nào của không gian mẫu. Xác suất kết hợp P(A ∩ B) đo khả năng hai biến cố xảy ra cùng nhau, trong khi xác suất có điều kiện P(A|B) đo khả năng A với điều kiện B đã xảy ra.
Tôi khuyên bạn nên xem tài liệu Introduction to Probability Rules Cheat Sheet để trà cứu nhanh các mối quan hệ này. Xác suất biên nằm ở trung tâm của hệ sinh thái xác suất. Nó là mẫu số trong các phép tính xác suất có điều kiện và là viên gạch xây nên Định lý Bayes.
Xác suất biên từ bảng và phân phối
Hãy xem cách bạn thực sự tính xác suất biên từ các cấu trúc dữ liệu khác nhau. Cách làm phụ thuộc vào việc bạn làm việc với biến rời rạc hay liên tục.
Trường hợp rời rạc (bảng chéo/contingency)
Khi làm việc với dữ liệu phân loại, các xác suất biên xuất hiện tự nhiên trong các bảng chéo. Giả sử bạn đang phân tích hành vi mua hàng của khách theo danh mục sản phẩm (Điện tử, Quần áo, Sách) và vùng (Bắc, Nam, Đông, Tây). Mỗi ô chứa xác suất kết hợp của một tổ hợp danh mục-vùng. Tổng theo hàng cho bạn xác suất biên của từng danh mục sản phẩm (P(Electronics), P(Clothing), P(Books)) bất kể vùng. Tổng theo cột cho bạn các xác suất biên theo từng vùng.
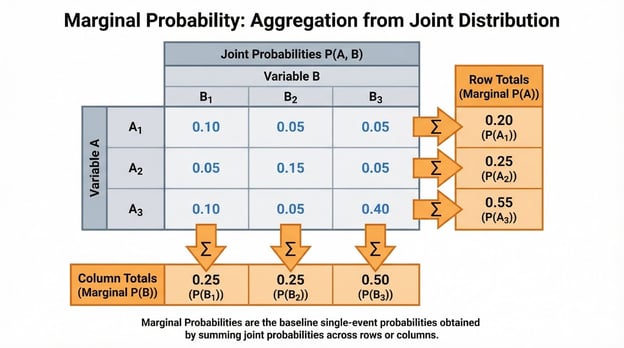
Cộng các xác suất kết hợp để tìm xác suất biên. Hình do Tác giả thực hiện.
Bạn thường sẽ gặp chúng dưới dạng tần suất đã chuẩn hóa. Nếu 500 trong số 2.000 khách hàng mua điện tử, thì xác suất biên P(Electronics) = 500/2.000 = 0,25. Đây là tỷ lệ cơ sở trước khi xét đến bất kỳ yếu tố nào khác. Khi bạn làm phân tích dữ liệu khám phá, tôi khuyên nên tính các xác suất biên này trước. Chúng giúp bạn hiểu cấu trúc cơ bản của dữ liệu trước khi đi vào các mối quan hệ có điều kiện.
Trường hợp liên tục
Với các biến ngẫu nhiên liên tục, xác suất biên trở thành hàm mật độ xác suất biên (PDF). Nếu bạn có hai biến liên tục X và Y với PDF kết hợp, PDF biên của X được tìm bằng cách tích phân trên mọi giá trị của Y.
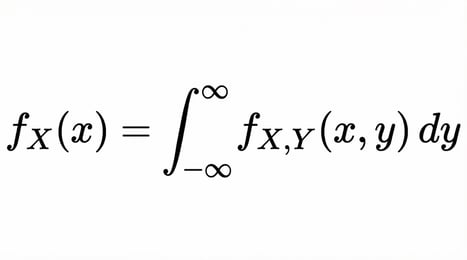
Về khái niệm, phép tích phân ở đây làm điều tương tự như phép cộng trong trường hợp rời rạc. Nó "làm sụp" phân phối kết hợp xuống một chiều bằng cách tính đến mọi khả năng của biến còn lại.
Hãy hình dung như cắt lát qua một bề mặt 3D (phân phối kết hợp) và xem diện tích dưới đường cong dọc theo một trục. Khóa học Fundamentals of Bayesian Data Analysis in R của chúng tôi trình bày sâu các khái niệm này khi làm việc với các phân phối liên tục.
Mối quan hệ giữa xác suất biên, kết hợp và có điều kiện
Hãy xem xác suất biên kết nối với các loại xác suất khác mà bạn thường dùng như thế nào.
Ba loại xác suất này tạo thành một hệ thống liên kết, và xác suất biên thường là chất keo gắn kết chúng. Từ xác suất kết hợp, bạn có các xác suất biên bằng cách cộng hoặc tích phân. Từ xác suất kết hợp và biên, bạn tính xác suất có điều kiện bằng P(A|B) = P(A ∩ B) / P(B). Lưu ý rằng xác suất biên P(B) là mẫu số. Nó chuẩn hóa xác suất kết hợp để cho ra xác suất có điều kiện.
Điều này quan trọng trong thực tiễn vì khi bạn diễn giải xác suất có điều kiện, bạn cần xác suất biên làm ngữ cảnh. Xác suất 90% mắc bệnh khi có kết quả dương tính nghe có vẻ đáng lo, nhưng nếu xác suất biên mắc bệnh chỉ là 1%, thì xác suất thực tế sau khi dương tính có thể thấp hơn nhiều so với bạn kỳ vọng.
Điều này xuất hiện ở khắp nơi trong suy luận Bayes. Prior là niềm tin của bạn về một tham số trước khi thấy dữ liệu. Khả năng biên (còn gọi là evidence), P(Data), là hạng tử chuẩn hóa trong định lý Bayes giúp biến "prior × likelihood" thành một xác suất hậu nghiệm đúng nghĩa. Khóa học Bayesian Data Analysis in Python của chúng tôi khám phá các kết nối này thông qua các bài thực hành mô hình hóa.
Các ví dụ tính toán xác suất biên
Hãy cùng giải qua cả các bài toán xác suất cổ điển và các kịch bản đời thực.
Ví dụ cổ điển
Bắt đầu với xúc xắc. Nếu bạn tung hai con xúc xắc, xác suất con thứ nhất ra 4 là bao nhiêu, bất kể giá trị con thứ hai?
Không gian mẫu có 36 kết quả đồng khả năng. Có 6 kết quả có số 4 ở con thứ nhất: (4,1), (4,2), (4,3), (4,4), (4,5), (4,6). Vậy P(Con thứ nhất = 4) = 6/36 = 1/6. Lưu ý chúng ta không điều kiện hóa trên bất kỳ điều gì về con thứ hai. Ta chỉ đơn giản đếm mọi kết quả mà con thứ nhất là 4.
Đây là một ví dụ kinh điển khác. Bốc từ một bộ bài 52 lá tiêu chuẩn, xác suất bốc được lá cơ là bao nhiêu, bất kể hạng? Có 13 lá cơ và 52 lá tổng cộng, nên P(Cơ) = 13/52 = 1/4. Xác suất biên này tổng hợp qua mọi hạng (Át đến K), cho bạn xác suất vô điều kiện của chất bài.
Ví dụ đời thực
Sàng lọc y tế là một ứng dụng đời thực thuyết phục. Giả sử bạn đang phân tích tỷ lệ hiện mắc của một bệnh trong quần thể. Xác suất biên P(Disease) biểu thị tỷ lệ bệnh cơ sở trước khi xét bất kỳ kết quả xét nghiệm chẩn đoán nào. Nếu 2% dân số mắc bệnh, thì P(Disease) = 0,02. Xác suất biên này rất quan trọng để diễn giải độ chính xác của xét nghiệm. Một xét nghiệm có độ nhạy 95% vẫn tạo ra nhiều dương tính giả khi bệnh hiếm gặp.
Trong tiếp thị số, bạn có thể hỏi: Xác suất một người dùng chuyển đổi là bao nhiêu, bất kể nguồn truy cập? Nếu bạn có dữ liệu về chuyển đổi từ tìm kiếm tự nhiên, quảng cáo trả phí, mạng xã hội và email, thì xác suất biên P(Conversion) cộng gộp qua tất cả nguồn. Tỷ lệ chuyển đổi cơ sở này giúp bạn đánh giá liệu các nguồn truy cập cụ thể hoạt động trên hay dưới mức trung bình.
Tương tự, trong tài chính, bạn có thể tính xác suất biên của việc thị trường giảm bất kể mức lãi suất. Điều này cho bạn rủi ro vô điều kiện trước khi chồng thêm các yếu tố vĩ mô.
Xác suất biên trong Khoa học Dữ liệu và Máy học
Hãy khám phá cách xác suất biên xuất hiện xuyên suốt quy trình khoa học dữ liệu.
Phân tích dữ liệu khám phá (EDA)
Khi bạn lần đầu gặp một bộ dữ liệu, tính các xác suất biên giúp bạn hiểu tỷ lệ sự kiện cơ sở. Trong một bộ dữ liệu phát hiện gian lận, P(Fraud) cho bạn biết cân bằng lớp trước khi xem bất kỳ đặc trưng nào. Điều này ngay lập tức cho thấy liệu bạn đang đối mặt với một bài toán mất cân bằng nghiêm trọng, nơi gian lận chỉ xảy ra trong 0,1% giao dịch.
Các phân phối biên cho từng đặc trưng riêng lẻ cũng định hướng phân tích của bạn. Nếu bạn xây dựng mô hình dự đoán rời bỏ khách hàng, tôi khuyên nên xem xét riêng P(Churn), P(High-value customer) và P(Recent activity). Điều này cung cấp bối cảnh trước khi bạn khám phá các mối quan hệ kết hợp của chúng.
Mô hình dự đoán
Bộ phân loại Naive Bayes dựa tường minh vào các xác suất biên như prior của lớp. Khi phân loại một tài liệu là spam hay không, P(Spam) là niềm tin trước của bạn trước khi thấy bất kỳ từ nào trong tài liệu. Thuật toán sau đó cập nhật xác suất biên này dựa trên các xác suất có điều kiện của đặc trưng.
Các phân phối biên của đặc trưng cũng quan trọng trong kỹ thuật đặc trưng và chẩn đoán mô hình. Nếu phân phối biên của một đặc trưng bị lệch mạnh, bạn có thể áp dụng các biến đổi như log-scaling hoặc Box-Cox để làm nó đối xứng hơn.
Sự khác biệt giữa các bộ dữ liệu cũng quan trọng không kém. Ví dụ, nếu tập huấn luyện có P(Class A)=0,9 nhưng tập kiểm tra có P(Class A)=0,5, thì xác suất dự đoán và thước đo hiệu năng của bạn có thể thay đổi nhiều, và bạn có thể cần một ngưỡng quyết định khác. Điều này xảy ra vì mô hình học dưới một tỷ lệ cơ sở, nhưng lại được đánh giá dưới một tỷ lệ khác.
Kiểm tra các phân phối biên trước khi huấn luyện giúp bạn phát hiện sớm những vấn đề này và quyết định liệu có cần lấy mẫu lại, dùng thước đo đánh giá khác, hiệu chỉnh lại, hay xây dựng các mô hình riêng cho từng phân khúc dữ liệu.
Rủi ro và ra quyết định
Các phép tính giá trị kỳ vọng cần đến xác suất biên. Nếu bạn đang quyết định có ra mắt sản phẩm hay không, bạn cần P(Success) như xác suất biên của thành công trên mọi điều kiện thị trường có thể. Nhân nó với lợi ích khi thành công, cộng với P(Failure) nhân chi phí khi thất bại, bạn có giá trị kỳ vọng.
Mô hình xác suất
Trong mạng Bayes và các mô hình đồ thị, các nút biểu diễn biến với các phân phối xác suất có điều kiện đi kèm. Các phân phối biên được thu được qua suy luận bằng cách lan truyền xác suất qua cấu trúc mạng hoặc bằng cách quan sát bằng chứng và cập nhật niềm tin. Các phương pháp lấy mẫu như Markov Chain Monte Carlo xấp xỉ các phân phối biên khi việc tính toán chính xác trở nên bất khả thi. Khóa học Bayesian Modeling with RJAGS của chúng tôi minh họa các phương pháp này trong thực tế.
Những điều mọi người hay hiểu sai về xác suất biên
Dưới đây là những lỗi khiến ngay cả người có kinh nghiệm cũng vấp phải.
Nhầm lẫn giữa xác suất biên và xác suất có điều kiện
Đây có lẽ là lỗi phổ biến nhất, và rất dễ mắc một cách trực quan. Hãy tưởng tượng bạn làm một xét nghiệm y tế có độ nhạy 95% và độ đặc hiệu 90%. Bạn cho kết quả dương tính. Hầu hết mọi người lập tức nghĩ: "Xét nghiệm bắt được 95% ca bệnh, vậy tôi có lẽ mắc bệnh."
Nhưng cách suy nghĩ đó bỏ qua một mảnh thông tin quan trọng: bệnh phổ biến đến mức nào ngay từ đầu? Nếu chỉ 1% người mắc (xác suất biên), thì khi bạn xét nghiệm 10.000 người, bạn sẽ có khoảng 95 dương tính thật nhưng 990 dương tính giả. Nghĩa là phần lớn kết quả dương tính là báo động giả. Xác suất thực sự sau khi dương tính của bạn chỉ khoảng 9%, không phải 95%.
Sự nhầm lẫn xảy ra vì mọi người tập trung vào độ nhạy của xét nghiệm (95%) và quên tỷ lệ cơ sở (tỷ lệ hiện mắc 1%). Xác suất biên P(Disease) = 0,01 và xác suất có điều kiện P(Disease | Positive test) = 0,09 là hai đại lượng hoàn toàn khác nhau, nhưng trực giác của chúng ta muốn xem chúng như nhau.
Bỏ qua xác suất biên khi diễn giải xác suất có điều kiện
Ngay cả khi mọi người phân biệt đúng xác suất biên với xác suất có điều kiện, họ vẫn thường bỏ qua xác suất biên khi diễn giải xác suất có điều kiện. Bạn có thể thấy một tiêu đề tin tức: "Nghiên cứu phát hiện 80% doanh nhân thành công bắt đầu trước 30 tuổi." Đó là P(Bắt đầu trước 30 | Doanh nhân thành công) = 0,8. Nhưng nếu không biết P(Bắt đầu trước 30) cho tất cả doanh nhân, bạn không thể đánh giá việc khởi nghiệp sớm có thực sự dự báo thành công hay không.
Điều này dẫn đến quyết định sai lầm. Nếu 90% tất cả doanh nhân bắt đầu trước 30, thì doanh nhân thành công không bắt đầu sớm với tỷ lệ bất thường. Họ chỉ đang theo mẫu hình chung. Xác suất có điều kiện không có nhiều ý nghĩa nếu thiếu đường cơ sở biên để so sánh.
Ngụy biện tỷ lệ cơ sở (base rate fallacy)
Ngụy biện tỷ lệ cơ sở xảy ra khi mọi người đánh giá quá cao bằng chứng có điều kiện trong khi bỏ qua các xác suất biên (tỷ lệ cơ sở).
Ví dụ thường gặp trong khoa học dữ liệu: Bạn xây dựng một bộ phân loại nhị phân trên một bộ dữ liệu mất cân bằng. Lớp dương (điều bạn muốn dự đoán) chỉ xuất hiện trong 5% dữ liệu. Bạn xây một mô hình và đạt độ chính xác 95%. Nghe thật tuyệt, phải không?
Không hẳn. Nếu bạn xây một mô hình "ngốc" chỉ dự đoán lớp âm mọi lần, nó cũng đạt 95% độ chính xác (vì 95% dữ liệu là âm). Mô hình xịn của bạn thực ra không tốt hơn mấy so với luôn đoán "không."
Lỗi ở chỗ nhìn con số 95% độ chính xác một cách biệt lập mà không xét tỷ lệ cơ sở (5% lớp dương). Khi các lớp mất cân bằng, độ chính xác trở thành một thước đo gây hiểu lầm. Bạn cần kiểm tra precision, recall, hoặc F1-score để xem mô hình của bạn có thực sự học được điều gì hữu ích không.
Hiểu các xác suất biên giúp bạn chọn thước đo đánh giá phù hợp cho các bài toán mất cân bằng.
Chủ đề nâng cao và mở rộng
Trong các mô hình chiều cao với hàng chục hay hàng trăm biến, việc tính chính xác các phân phối biên thường là không thể. Số lượng kết hợp có thể tăng nhanh chóng và các tổng hay tích phân cần thiết trở nên bất khả thi.
Để xử lý, người thực hành dùng các phương pháp suy luận xấp xỉ:
- Các phương pháp lấy mẫu (như Markov Chain Monte Carlo, MCMC) sinh nhiều mẫu từ phân phối của mô hình. Bạn có thể ước lượng các xác suất biên bằng cách xem tần suất sự kiện xuất hiện trong các mẫu đó.
- Suy luận biến phân (variational inference) đi theo hướng khác: thay thế một phân phối khó tính bằng một phân phối đơn giản hơn và tối ưu nó để càng gần càng tốt, giúp ước lượng biên thường nhanh hơn trong các mô hình lớn.
Các công cụ hiện đại như scipy.stats của Python cho các phân phối xác suất, pandas cho bảng chéo, và table() cùng dplyr của R để tính các xác suất biên thực nghiệm khiến các phép tính này trở nên dễ tiếp cận. Với dữ liệu lưu trong cơ sở dữ liệu, mệnh đề GROUP BY của SQL tính các xác suất biên thực nghiệm hiệu quả từ các tập dữ liệu lớn.
Kết luận
Trước khi bạn có thể hiểu mối quan hệ giữa các biến, đánh giá bằng chứng có điều kiện, hoặc xây dựng các mô hình Bayes, bạn cần nắm được xác suất vô điều kiện của các sự kiện riêng lẻ. Đó là đường cơ sở giúp mọi thứ khác có thể diễn giải được.
Khi bạn hiểu sai các xác suất biên, bạn dễ mắc lỗi phân tích: nhầm lẫn tỷ lệ cơ sở với xác suất có điều kiện, rơi vào ngụy biện tỷ lệ cơ sở, hoặc xây mô hình không vượt trội so với đường cơ sở ngây thơ. Nắm đúng xác suất biên, bạn sẽ hiểu cách xác suất có điều kiện tinh chỉnh chúng, cách Định lý Bayes cập nhật chúng bằng bằng chứng, và cách các mô hình máy học học từ các mẫu hình mà chúng bộc lộ.


Bạn đang phân tích hành vi khách hàng cho một nền tảng thương mại điện tử và quản lý của bạn hỏi: "Xác suất một khách hàng rời bỏ là bao nhiêu, bất kể lý do?"
Câu hỏi này nhắm đến một điều cụ thể hơn bạn tưởng. Bạn không hỏi về rời bỏ với điều kiện một danh mục sản phẩm cụ thể, hay rời bỏ kết hợp với phương thức thanh toán. Bạn đang hỏi về xác suất cơ sở của một sự kiện đơn lẻ: khách hàng rời bỏ, hết.
Đó là xác suất biên, và nó là nền tảng cho hầu hết các phép tính xác suất bạn sẽ gặp trong khoa học dữ liệu.
Xác suất biên là gì?
Như đã giới thiệu, xác suất biên là xác suất xảy ra của một sự kiện đơn lẻ, không phụ thuộc vào các biến hoặc sự kiện khác. Nó được gọi là "biên" vì khi bạn viết các xác suất kết hợp trong một bảng, các xác suất cho sự kiện đơn lẻ xuất hiện ở phần lề (tổng hàng và tổng cột).
Ký hiệu thì đơn giản. Với một sự kiện rời rạc A, ta viết P(A). Xác suất biên thường xuất phát từ xác suất kết hợp. Nếu B là một biến ngẫu nhiên rời rạc và bạn biết xác suất kết hợp của A xảy ra với mỗi giá trị của B, bạn có thể tìm xác suất biên bằng cách cộng: P(A) = Σb P(A, B=b), trong đó bạn cộng trên mọi giá trị b mà B có thể nhận. Xác suất biên là phần còn lại khi bạn "cộng dồn" hoặc "tích phân bỏ" tất cả các biến khác.
Để hiểu đầy đủ khái niệm này, bạn cần một số thuật ngữ nền tảng. Không gian mẫu là tập hợp tất cả các kết quả có thể. Một biến cố là bất kỳ tập con nào của không gian mẫu. Xác suất kết hợp P(A ∩ B) đo khả năng hai biến cố xảy ra cùng nhau, trong khi xác suất có điều kiện P(A|B) đo khả năng A với điều kiện B đã xảy ra.
Tôi khuyên bạn nên xem tài liệu Introduction to Probability Rules Cheat Sheet để trà cứu nhanh các mối quan hệ này. Xác suất biên nằm ở trung tâm của hệ sinh thái xác suất. Nó là mẫu số trong các phép tính xác suất có điều kiện và là viên gạch xây nên Định lý Bayes.
Xác suất biên từ bảng và phân phối
Hãy xem cách bạn thực sự tính xác suất biên từ các cấu trúc dữ liệu khác nhau. Cách làm phụ thuộc vào việc bạn làm việc với biến rời rạc hay liên tục.
Trường hợp rời rạc (bảng chéo/contingency)
Khi làm việc với dữ liệu phân loại, các xác suất biên xuất hiện tự nhiên trong các bảng chéo. Giả sử bạn đang phân tích hành vi mua hàng của khách theo danh mục sản phẩm (Điện tử, Quần áo, Sách) và vùng (Bắc, Nam, Đông, Tây). Mỗi ô chứa xác suất kết hợp của một tổ hợp danh mục-vùng. Tổng theo hàng cho bạn xác suất biên của từng danh mục sản phẩm (P(Electronics), P(Clothing), P(Books)) bất kể vùng. Tổng theo cột cho bạn các xác suất biên theo từng vùng.
Cộng các xác suất kết hợp để tìm xác suất biên. Hình do Tác giả thực hiện.
Bạn thường sẽ gặp chúng dưới dạng tần suất đã chuẩn hóa. Nếu 500 trong số 2.000 khách hàng mua điện tử, thì xác suất biên P(Electronics) = 500/2.000 = 0,25. Đây là tỷ lệ cơ sở trước khi xét đến bất kỳ yếu tố nào khác. Khi bạn làm phân tích dữ liệu khám phá, tôi khuyên nên tính các xác suất biên này trước. Chúng giúp bạn hiểu cấu trúc cơ bản của dữ liệu trước khi đi vào các mối quan hệ có điều kiện.
Trường hợp liên tục
Với các biến ngẫu nhiên liên tục, xác suất biên trở thành hàm mật độ xác suất biên (PDF). Nếu bạn có hai biến liên tục X và Y với PDF kết hợp, PDF biên của X được tìm bằng cách tích phân trên mọi giá trị của Y.
Về khái niệm, phép tích phân ở đây làm điều tương tự như phép cộng trong trường hợp rời rạc. Nó "làm sụp" phân phối kết hợp xuống một chiều bằng cách tính đến mọi khả năng của biến còn lại.
Hãy hình dung như cắt lát qua một bề mặt 3D (phân phối kết hợp) và xem diện tích dưới đường cong dọc theo một trục. Khóa học Fundamentals of Bayesian Data Analysis in R của chúng tôi trình bày sâu các khái niệm này khi làm việc với các phân phối liên tục.
Mối quan hệ giữa xác suất biên, kết hợp và có điều kiện
Hãy xem xác suất biên kết nối với các loại xác suất khác mà bạn thường dùng như thế nào.
Ba loại xác suất này tạo thành một hệ thống liên kết, và xác suất biên thường là chất keo gắn kết chúng. Từ xác suất kết hợp, bạn có các xác suất biên bằng cách cộng hoặc tích phân. Từ xác suất kết hợp và biên, bạn tính xác suất có điều kiện bằng P(A|B) = P(A ∩ B) / P(B). Lưu ý rằng xác suất biên P(B) là mẫu số. Nó chuẩn hóa xác suất kết hợp để cho ra xác suất có điều kiện.
Điều này quan trọng trong thực tiễn vì khi bạn diễn giải xác suất có điều kiện, bạn cần xác suất biên làm ngữ cảnh. Xác suất 90% mắc bệnh khi có kết quả dương tính nghe có vẻ đáng lo, nhưng nếu xác suất biên mắc bệnh chỉ là 1%, thì xác suất thực tế sau khi dương tính có thể thấp hơn nhiều so với bạn kỳ vọng.
Điều này xuất hiện ở khắp nơi trong suy luận Bayes. Prior là niềm tin của bạn về một tham số trước khi thấy dữ liệu. Khả năng biên (còn gọi là evidence), P(Data), là hạng tử chuẩn hóa trong định lý Bayes giúp biến "prior × likelihood" thành một xác suất hậu nghiệm đúng nghĩa. Khóa học Bayesian Data Analysis in Python của chúng tôi khám phá các kết nối này thông qua các bài thực hành mô hình hóa.
Các ví dụ tính toán xác suất biên
Hãy cùng giải qua cả các bài toán xác suất cổ điển và các kịch bản đời thực.
Ví dụ cổ điển
Bắt đầu với xúc xắc. Nếu bạn tung hai con xúc xắc, xác suất con thứ nhất ra 4 là bao nhiêu, bất kể giá trị con thứ hai?
Không gian mẫu có 36 kết quả đồng khả năng. Có 6 kết quả có số 4 ở con thứ nhất: (4,1), (4,2), (4,3), (4,4), (4,5), (4,6). Vậy P(Con thứ nhất = 4) = 6/36 = 1/6. Lưu ý chúng ta không điều kiện hóa trên bất kỳ điều gì về con thứ hai. Ta chỉ đơn giản đếm mọi kết quả mà con thứ nhất là 4.
Đây là một ví dụ kinh điển khác. Bốc từ một bộ bài 52 lá tiêu chuẩn, xác suất bốc được lá cơ là bao nhiêu, bất kể hạng? Có 13 lá cơ và 52 lá tổng cộng, nên P(Cơ) = 13/52 = 1/4. Xác suất biên này tổng hợp qua mọi hạng (Át đến K), cho bạn xác suất vô điều kiện của chất bài.
Ví dụ đời thực
Sàng lọc y tế là một ứng dụng đời thực thuyết phục. Giả sử bạn đang phân tích tỷ lệ hiện mắc của một bệnh trong quần thể. Xác suất biên P(Disease) biểu thị tỷ lệ bệnh cơ sở trước khi xét bất kỳ kết quả xét nghiệm chẩn đoán nào. Nếu 2% dân số mắc bệnh, thì P(Disease) = 0,02. Xác suất biên này rất quan trọng để diễn giải độ chính xác của xét nghiệm. Một xét nghiệm có độ nhạy 95% vẫn tạo ra nhiều dương tính giả khi bệnh hiếm gặp.
Trong tiếp thị số, bạn có thể hỏi: Xác suất một người dùng chuyển đổi là bao nhiêu, bất kể nguồn truy cập? Nếu bạn có dữ liệu về chuyển đổi từ tìm kiếm tự nhiên, quảng cáo trả phí, mạng xã hội và email, thì xác suất biên P(Conversion) cộng gộp qua tất cả nguồn. Tỷ lệ chuyển đổi cơ sở này giúp bạn đánh giá liệu các nguồn truy cập cụ thể hoạt động trên hay dưới mức trung bình.
Tương tự, trong tài chính, bạn có thể tính xác suất biên của việc thị trường giảm bất kể mức lãi suất. Điều này cho bạn rủi ro vô điều kiện trước khi chồng thêm các yếu tố vĩ mô.
Xác suất biên trong Khoa học Dữ liệu và Máy học
Hãy khám phá cách xác suất biên xuất hiện xuyên suốt quy trình khoa học dữ liệu.
Phân tích dữ liệu khám phá (EDA)
Khi bạn lần đầu gặp một bộ dữ liệu, tính các xác suất biên giúp bạn hiểu tỷ lệ sự kiện cơ sở. Trong một bộ dữ liệu phát hiện gian lận, P(Fraud) cho bạn biết cân bằng lớp trước khi xem bất kỳ đặc trưng nào. Điều này ngay lập tức cho thấy liệu bạn đang đối mặt với một bài toán mất cân bằng nghiêm trọng, nơi gian lận chỉ xảy ra trong 0,1% giao dịch.
Các phân phối biên cho từng đặc trưng riêng lẻ cũng định hướng phân tích của bạn. Nếu bạn xây dựng mô hình dự đoán rời bỏ khách hàng, tôi khuyên nên xem xét riêng P(Churn), P(High-value customer) và P(Recent activity). Điều này cung cấp bối cảnh trước khi bạn khám phá các mối quan hệ kết hợp của chúng.
Mô hình dự đoán
Bộ phân loại Naive Bayes dựa tường minh vào các xác suất biên như prior của lớp. Khi phân loại một tài liệu là spam hay không, P(Spam) là niềm tin trước của bạn trước khi thấy bất kỳ từ nào trong tài liệu. Thuật toán sau đó cập nhật xác suất biên này dựa trên các xác suất có điều kiện của đặc trưng.
Các phân phối biên của đặc trưng cũng quan trọng trong kỹ thuật đặc trưng và chẩn đoán mô hình. Nếu phân phối biên của một đặc trưng bị lệch mạnh, bạn có thể áp dụng các biến đổi như log-scaling hoặc Box-Cox để làm nó đối xứng hơn.
Sự khác biệt giữa các bộ dữ liệu cũng quan trọng không kém. Ví dụ, nếu tập huấn luyện có P(Class A)=0,9 nhưng tập kiểm tra có P(Class A)=0,5, thì xác suất dự đoán và thước đo hiệu năng của bạn có thể thay đổi nhiều, và bạn có thể cần một ngưỡng quyết định khác. Điều này xảy ra vì mô hình học dưới một tỷ lệ cơ sở, nhưng lại được đánh giá dưới một tỷ lệ khác.
Kiểm tra các phân phối biên trước khi huấn luyện giúp bạn phát hiện sớm những vấn đề này và quyết định liệu có cần lấy mẫu lại, dùng thước đo đánh giá khác, hiệu chỉnh lại, hay xây dựng các mô hình riêng cho từng phân khúc dữ liệu.
Rủi ro và ra quyết định
Các phép tính giá trị kỳ vọng cần đến xác suất biên. Nếu bạn đang quyết định có ra mắt sản phẩm hay không, bạn cần P(Success) như xác suất biên của thành công trên mọi điều kiện thị trường có thể. Nhân nó với lợi ích khi thành công, cộng với P(Failure) nhân chi phí khi thất bại, bạn có giá trị kỳ vọng.
Mô hình xác suất
Trong mạng Bayes và các mô hình đồ thị, các nút biểu diễn biến với các phân phối xác suất có điều kiện đi kèm. Các phân phối biên được thu được qua suy luận bằng cách lan truyền xác suất qua cấu trúc mạng hoặc bằng cách quan sát bằng chứng và cập nhật niềm tin. Các phương pháp lấy mẫu như Markov Chain Monte Carlo xấp xỉ các phân phối biên khi việc tính toán chính xác trở nên bất khả thi. Khóa học Bayesian Modeling with RJAGS của chúng tôi minh họa các phương pháp này trong thực tế.
Những điều mọi người hay hiểu sai về xác suất biên
Dưới đây là những lỗi khiến ngay cả người có kinh nghiệm cũng vấp phải.
Nhầm lẫn giữa xác suất biên và xác suất có điều kiện
Đây có lẽ là lỗi phổ biến nhất, và rất dễ mắc một cách trực quan. Hãy tưởng tượng bạn làm một xét nghiệm y tế có độ nhạy 95% và độ đặc hiệu 90%. Bạn cho kết quả dương tính. Hầu hết mọi người lập tức nghĩ: "Xét nghiệm bắt được 95% ca bệnh, vậy tôi có lẽ mắc bệnh."
Nhưng cách suy nghĩ đó bỏ qua một mảnh thông tin quan trọng: bệnh phổ biến đến mức nào ngay từ đầu? Nếu chỉ 1% người mắc (xác suất biên), thì khi bạn xét nghiệm 10.000 người, bạn sẽ có khoảng 95 dương tính thật nhưng 990 dương tính giả. Nghĩa là phần lớn kết quả dương tính là báo động giả. Xác suất thực sự sau khi dương tính của bạn chỉ khoảng 9%, không phải 95%.
Sự nhầm lẫn xảy ra vì mọi người tập trung vào độ nhạy của xét nghiệm (95%) và quên tỷ lệ cơ sở (tỷ lệ hiện mắc 1%). Xác suất biên P(Disease) = 0,01 và xác suất có điều kiện P(Disease | Positive test) = 0,09 là hai đại lượng hoàn toàn khác nhau, nhưng trực giác của chúng ta muốn xem chúng như nhau.
Bỏ qua xác suất biên khi diễn giải xác suất có điều kiện
Ngay cả khi mọi người phân biệt đúng xác suất biên với xác suất có điều kiện, họ vẫn thường bỏ qua xác suất biên khi diễn giải xác suất có điều kiện. Bạn có thể thấy một tiêu đề tin tức: "Nghiên cứu phát hiện 80% doanh nhân thành công bắt đầu trước 30 tuổi." Đó là P(Bắt đầu trước 30 | Doanh nhân thành công) = 0,8. Nhưng nếu không biết P(Bắt đầu trước 30) cho tất cả doanh nhân, bạn không thể đánh giá việc khởi nghiệp sớm có thực sự dự báo thành công hay không.
Điều này dẫn đến quyết định sai lầm. Nếu 90% tất cả doanh nhân bắt đầu trước 30, thì doanh nhân thành công không bắt đầu sớm với tỷ lệ bất thường. Họ chỉ đang theo mẫu hình chung. Xác suất có điều kiện không có nhiều ý nghĩa nếu thiếu đường cơ sở biên để so sánh.
Ngụy biện tỷ lệ cơ sở (base rate fallacy)
Ngụy biện tỷ lệ cơ sở xảy ra khi mọi người đánh giá quá cao bằng chứng có điều kiện trong khi bỏ qua các xác suất biên (tỷ lệ cơ sở).
Ví dụ thường gặp trong khoa học dữ liệu: Bạn xây dựng một bộ phân loại nhị phân trên một bộ dữ liệu mất cân bằng. Lớp dương (điều bạn muốn dự đoán) chỉ xuất hiện trong 5% dữ liệu. Bạn xây một mô hình và đạt độ chính xác 95%. Nghe thật tuyệt, phải không?
Không hẳn. Nếu bạn xây một mô hình "ngốc" chỉ dự đoán lớp âm mọi lần, nó cũng đạt 95% độ chính xác (vì 95% dữ liệu là âm). Mô hình xịn của bạn thực ra không tốt hơn mấy so với luôn đoán "không."
Lỗi ở chỗ nhìn con số 95% độ chính xác một cách biệt lập mà không xét tỷ lệ cơ sở (5% lớp dương). Khi các lớp mất cân bằng, độ chính xác trở thành một thước đo gây hiểu lầm. Bạn cần kiểm tra precision, recall, hoặc F1-score để xem mô hình của bạn có thực sự học được điều gì hữu ích không.
Hiểu các xác suất biên giúp bạn chọn thước đo đánh giá phù hợp cho các bài toán mất cân bằng.
Chủ đề nâng cao và mở rộng
Trong các mô hình chiều cao với hàng chục hay hàng trăm biến, việc tính chính xác các phân phối biên thường là không thể. Số lượng kết hợp có thể tăng nhanh chóng và các tổng hay tích phân cần thiết trở nên bất khả thi.
Để xử lý, người thực hành dùng các phương pháp suy luận xấp xỉ:
Các công cụ hiện đại như
scipy.statscủa Python cho các phân phối xác suất,pandascho bảng chéo, vàtable()cùngdplyrcủa R để tính các xác suất biên thực nghiệm khiến các phép tính này trở nên dễ tiếp cận. Với dữ liệu lưu trong cơ sở dữ liệu, mệnh đềGROUP BYcủa SQL tính các xác suất biên thực nghiệm hiệu quả từ các tập dữ liệu lớn.Kết luận
Trước khi bạn có thể hiểu mối quan hệ giữa các biến, đánh giá bằng chứng có điều kiện, hoặc xây dựng các mô hình Bayes, bạn cần nắm được xác suất vô điều kiện của các sự kiện riêng lẻ. Đó là đường cơ sở giúp mọi thứ khác có thể diễn giải được.
Khi bạn hiểu sai các xác suất biên, bạn dễ mắc lỗi phân tích: nhầm lẫn tỷ lệ cơ sở với xác suất có điều kiện, rơi vào ngụy biện tỷ lệ cơ sở, hoặc xây mô hình không vượt trội so với đường cơ sở ngây thơ. Nắm đúng xác suất biên, bạn sẽ hiểu cách xác suất có điều kiện tinh chỉnh chúng, cách Định lý Bayes cập nhật chúng bằng bằng chứng, và cách các mô hình máy học học từ các mẫu hình mà chúng bộc lộ.