
Corso
Fondamenti di probabilità in R
4 ore
42.8K
Stai analizzando il comportamento dei clienti per una piattaforma e-commerce e il tuo manager chiede: "Qual è la probabilità che un cliente abbandoni, a prescindere dal motivo?"
Questa domanda punta a qualcosa di più specifico di quanto potresti pensare. Non stai chiedendo dell’abbandono dato una particolare categoria di prodotto, o dell’abbandono combinato con il metodo di pagamento. Stai chiedendo della probabilità di base di un singolo evento: l’abbandono del cliente, punto.
Questa è la probabilità marginale, ed è fondamentale per la maggior parte dei calcoli probabilistici che incontrerai in data science.
Come anticipato, la probabilità marginale è la probabilità che si verifichi un singolo evento, indipendentemente da altre variabili o eventi. Si chiama "marginale" perché, quando scrivi le probabilità congiunte in una tabella, queste probabilità dei singoli eventi compaiono ai margini (i totali di righe e colonne).
La notazione è semplice. Per un evento discreto A, scriviamo P(A). La probabilità marginale spesso deriva dalla probabilità congiunta. Se B è una variabile aleatoria discreta e conosci la probabilità congiunta che A si verifichi con ciascun valore di B, puoi trovare la probabilità marginale sommando: P(A) = Σb P(A, B=b), dove sommi su tutti i possibili valori b che B può assumere. La probabilità marginale è ciò che rimane quando "sommeggi" o "integri" via tutte le altre variabili.
Per comprendere appieno questo concetto, ti serviranno alcuni termini di base. Lo spazio campionario è l’insieme di tutti i possibili esiti. Un evento è qualsiasi sottoinsieme dello spazio campionario. La probabilità congiunta P(A ∩ B) misura la probabilità che due eventi si verifichino insieme, mentre la probabilità condizionata P(A|B) misura la probabilità di A dato che B si sia verificato.
Ti consiglio di dare un’occhiata al nostro cheat sheet Introduzione alle regole della probabilità per un riferimento rapido su queste relazioni. La probabilità marginale sta al centro di questo ecosistema probabilistico. È il denominatore nei calcoli di probabilità condizionata e il mattone di base per il teorema di Bayes.
Vediamo come calcolare concretamente la probabilità marginale da diverse strutture dati. L’approccio dipende dal fatto che tu stia lavorando con variabili discrete o continue.
Quando lavori con dati categoriali, le probabilità marginali compaiono naturalmente nelle tabelle di contingenza. Supponi di analizzare il comportamento di acquisto dei clienti tra categorie di prodotto (Elettronica, Abbigliamento, Libri) e regioni (Nord, Sud, Est, Ovest). Ogni cella contiene la probabilità congiunta di una combinazione categoria-regione. I totali di riga ti danno la probabilità marginale per ciascuna categoria di prodotto (P(Elettronica), P(Abbigliamento), P(Libri)) indipendentemente dalla regione. I totali di colonna ti danno le probabilità marginali per ciascuna regione.
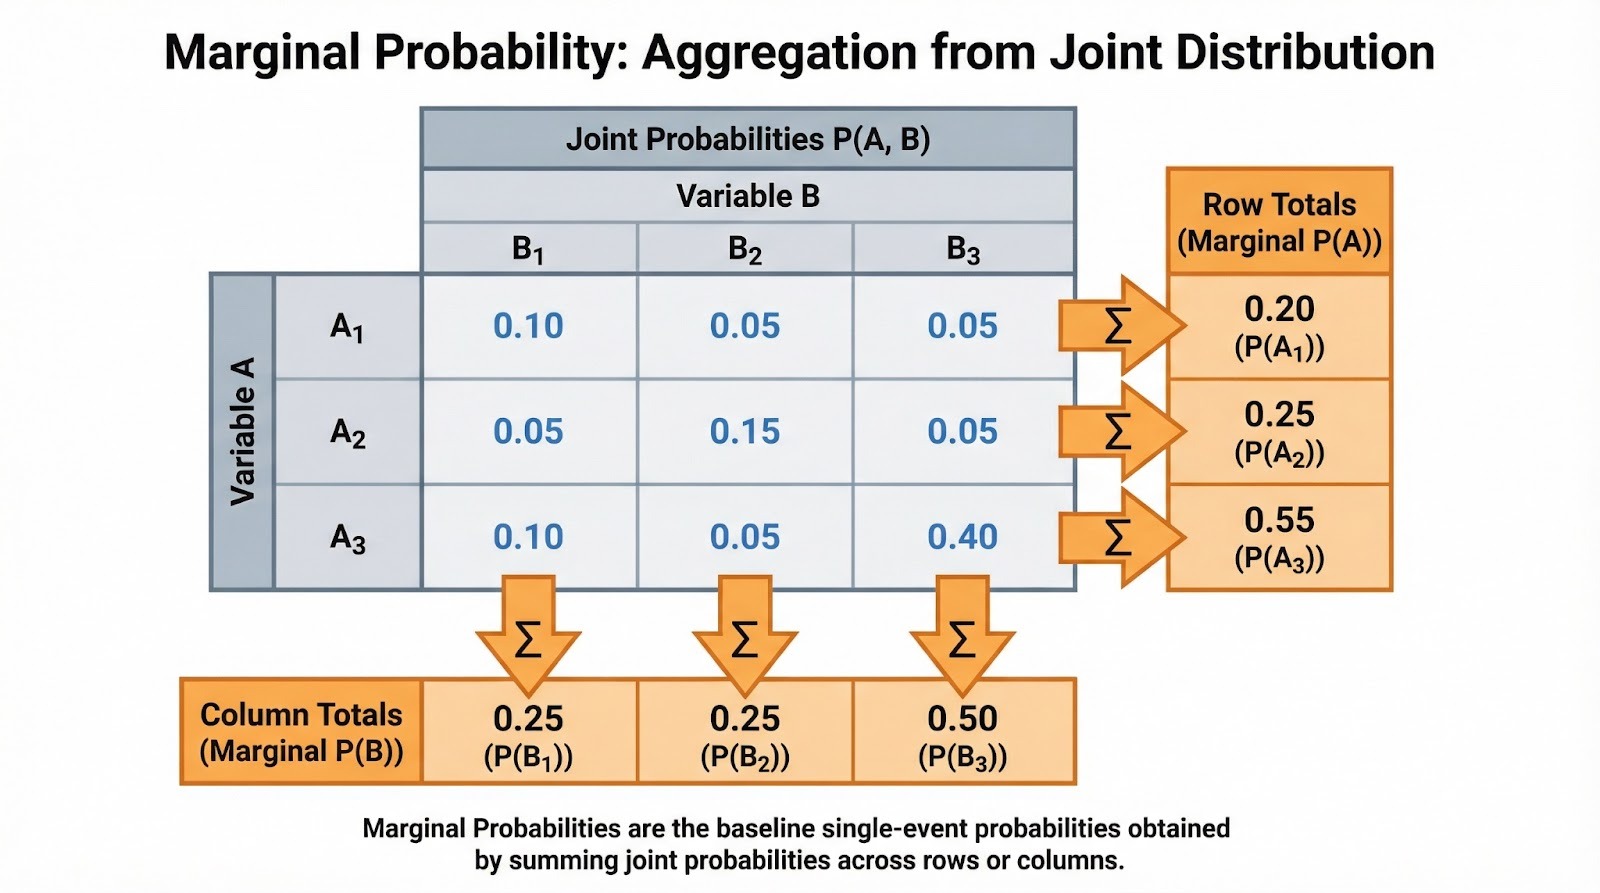
Somma delle probabilità congiunte per trovare le probabilità marginali. Immagine dell’autore.
Spesso le incontrerai come frequenze normalizzate. Se 500 clienti su 2.000 hanno acquistato elettronica, la probabilità marginale P(Elettronica) = 500/2.000 = 0,25. Questo è il tasso di base prima di considerare qualsiasi altro fattore. Durante l’analisi esplorativa dei dati, ti suggerisco di calcolare prima queste marginali. Ti aiutano a capire la struttura di base dei dati prima di approfondire le relazioni condizionate.
Per variabili aleatorie continue, la probabilità marginale diventa una funzione di densità di probabilità marginale (PDF). Se hai due variabili continue X e Y con una PDF congiunta, la PDF marginale di X si trova integrando su tutti i valori di Y.
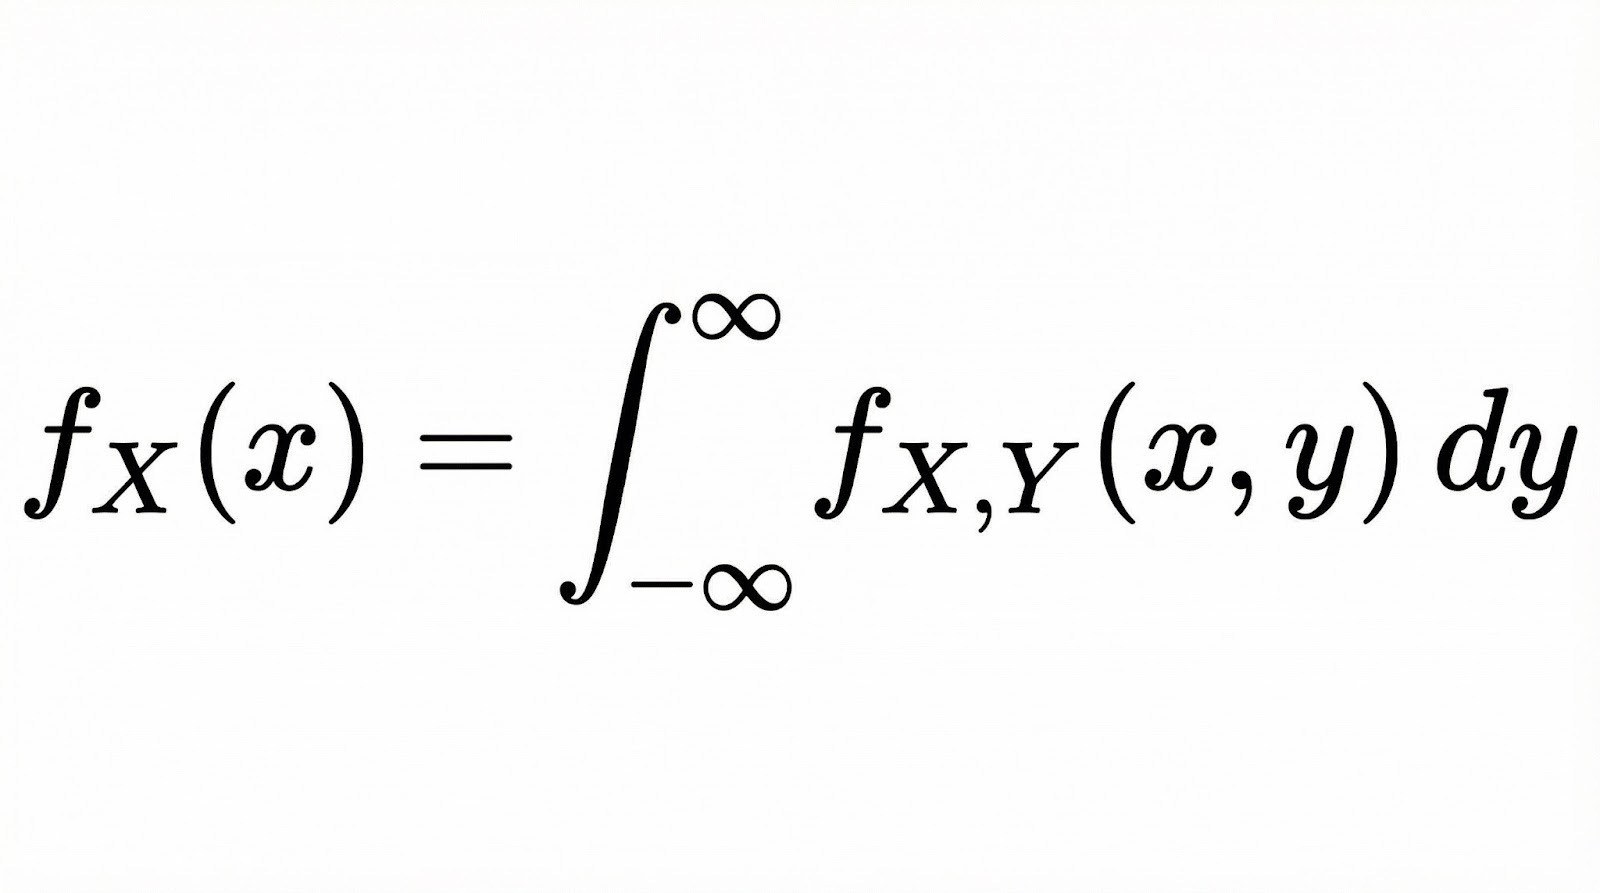
Concettualmente, l’integrazione qui fa la stessa cosa della somma nel caso discreto. "Collassa" la distribuzione congiunta a una singola dimensione tenendo conto di tutte le possibilità dell’altra variabile.
Pensala come un taglio attraverso una superficie 3D (la distribuzione congiunta) e uno sguardo all’area sotto la curva lungo un asse. Il nostro corso Fondamenti di analisi bayesiana dei dati in R approfondisce questi concetti lavorando con distribuzioni continue.
Vediamo come la probabilità marginale si collega agli altri tipi di probabilità con cui lavorerai regolarmente.
Questi tre tipi di probabilità formano un sistema connesso, e la probabilità marginale è spesso la colla che li tiene insieme. Dalla probabilità congiunta, ottieni le marginali sommando o integrando. Dalle probabilità congiunte e marginali, calcoli le condizionate usando P(A|B) = P(A ∩ B) / P(B). Nota che la probabilità marginale P(B) è il denominatore. Normalizza la probabilità congiunta per darti la condizionata.
Questo conta nella pratica perché, quando interpreti le probabilità condizionate, ti serve la marginale come contesto. Una probabilità del 90% di malattia dato un test positivo suona allarmante, ma se la probabilità marginale di malattia è solo dell’1%, la probabilità effettiva dopo un test positivo potrebbe essere molto più bassa di quanto ti aspetti.
Questo emerge ovunque nell’inferenza bayesiana. Una prior è la tua credenza su un parametro prima di vedere qualsiasi dato. La verosimiglianza marginale (chiamata anche evidenza), P(Dati), è il termine di normalizzazione nel teorema di Bayes che trasforma "prior × verosimiglianza" in una corretta probabilità a posteriori. Il nostro corso Analisi bayesiana dei dati in Python esplora queste connessioni attraverso esercizi pratici di modellazione.
Lavoriamo sia su problemi classici di probabilità che su scenari del mondo reale.
Partiamo dai dadi. Se lanci due dadi, qual è la probabilità che il primo dado mostri un 4, indipendentemente dal valore del secondo?
Lo spazio campionario ha 36 esiti equiprobabili. Sei di questi hanno un 4 sul primo dado: (4,1), (4,2), (4,3), (4,4), (4,5), (4,6). Quindi P(Primo dado = 4) = 6/36 = 1/6. Nota che non abbiamo condizionato su nulla riguardo al secondo dado. Abbiamo semplicemente contato tutti gli esiti in cui il primo dado è 4.
Ecco un altro esempio classico. Estraendo da un mazzo standard di 52 carte, qual è la probabilità di pescare un cuori, a prescindere dal valore? Ci sono 13 cuori e 52 carte totali, quindi P(Cuori) = 13/52 = 1/4. Questa probabilità marginale aggrega su tutti i valori (dall’Asso al Re), dandoti la probabilità incondizionata del seme.
Lo screening medico offre un’applicazione reale convincente. Supponi di analizzare la prevalenza di una malattia in una popolazione. La probabilità marginale P(Malattia) rappresenta il tasso di malattia di base prima di considerare qualsiasi risultato diagnostico. Se il 2% della popolazione ha la malattia, P(Malattia) = 0,02. Questa probabilità marginale è essenziale per interpretare l’accuratezza del test. Un test con sensibilità al 95% produce comunque molti falsi positivi quando la malattia è rara.
Nel marketing digitale, potresti chiederti: Qual è la probabilità che un utente converta, indipendentemente dalla fonte di traffico? Se hai dati sulle conversioni da ricerca organica, annunci a pagamento, social media ed email, la probabilità marginale P(Conversione) somma su tutte le fonti. Questo tasso di conversione di base ti aiuta a valutare se specifiche fonti di traffico performano sopra o sotto la media.
Allo stesso modo, in finanza, potresti calcolare la probabilità marginale di un calo del mercato a prescindere dai livelli dei tassi di interesse. Questo ti dà il rischio incondizionato prima di stratificare i fattori macroeconomici.
Esploriamo come la probabilità marginale compare in tutto il workflow di data science.
Quando incontri per la prima volta un dataset, calcolare le probabilità marginali ti aiuta a capire i tassi di evento di base. In un dataset di rilevazione frodi, P(Frode) ti dice il bilanciamento delle classi prima di esaminare qualsiasi feature. Questo rivela subito se stai affrontando un problema fortemente sbilanciato in cui la frode si verifica solo nello 0,1% delle transazioni.
Le distribuzioni marginali delle singole feature guidano anche l’analisi. Se stai costruendo un modello per prevedere il churn dei clienti, ti consiglierei di esaminare separatamente P(Churn), P(Cliente ad alto valore) e P(Attività recente). Questo fornisce contesto prima di esplorare le loro relazioni congiunte.
I classificatori Naive Bayes si basano esplicitamente sulle probabilità marginali come prior di classe. Quando classifichi un documento come spam o non spam, P(Spam) è la tua credenza a priori prima di vedere qualsiasi parola nel documento. L’algoritmo poi aggiorna questa probabilità marginale sulla base delle probabilità condizionate delle feature.
Le distribuzioni marginali delle feature contano anche nell’ingegneria delle feature e nella diagnostica dei modelli. Se la distribuzione marginale di una feature è molto asimmetrica, potresti applicare trasformazioni come il log scaling o Box-Cox per renderla più simmetrica.
Gli shift tra dataset sono altrettanto importanti. Per esempio, se il tuo set di training ha P(Classe A)=0,9 ma il tuo set di test ha P(Classe A)=0,5, le probabilità previste e le metriche di performance possono cambiare molto, e potresti aver bisogno di una soglia decisionale diversa. Questo accade perché il modello ha imparato con un tasso di base, ma viene valutato con un altro.
Controllare le distribuzioni marginali prima di addestrare ti aiuta a individuare presto questi problemi e decidere se servono ri-campionamenti, metriche di valutazione diverse, ricalibrazione o modelli separati per diversi segmenti di dati.
I calcoli del valore atteso richiedono probabilità marginali. Se devi decidere se lanciare un prodotto, ti serve P(Successo) come probabilità marginale di successo su tutte le possibili condizioni di mercato. Moltiplicala per il payoff del successo, aggiungi P(Fallimento) moltiplicata per il costo del fallimento, e ottieni il tuo valore atteso.
Nei network bayesiani e nei modelli grafici, i nodi rappresentano variabili con distribuzioni di probabilità condizionate associate. Le distribuzioni marginali si ottengono tramite inferenza propagando le probabilità attraverso la struttura della rete o osservando evidenza e aggiornando le credenze. Metodi di campionamento come la Markov Chain Monte Carlo approssimano queste marginali quando il calcolo esatto diventa intrattabile. Il nostro corso Bayesian Modeling con RJAGS dimostra questi metodi in pratica.
Ecco gli errori che mettono in difficoltà anche i professionisti esperti.
Probabilmente è l’errore più comune, ed è sorprendentemente intuitivo. Immagina di sottoporti a un test medico con sensibilità al 95% e specificità al 90%. Risulti positivo. La maggior parte delle persone pensa subito: "Il test individua il 95% dei casi, quindi probabilmente ho la malattia."
Ma questo ragionamento salta un’informazione cruciale: quanto è comune la malattia in primo luogo? Se solo l’1% delle persone ce l’ha (la probabilità marginale), allora quando testi 10.000 persone, otterrai circa 95 veri positivi ma 990 falsi positivi. Ciò significa che la maggior parte dei risultati positivi sono falsi allarmi. La tua probabilità effettiva dopo un test positivo è solo circa il 9%, non il 95%.
La confusione avviene perché ci si concentra sulla sensibilità del test (95%) e si dimentica il tasso di base (prevalenza all’1%). La probabilità marginale P(Malattia) = 0,01 e la probabilità condizionata P(Malattia | Test positivo) = 0,09 sono quantità completamente diverse, ma la nostra intuizione vuole trattarle allo stesso modo.
Anche quando si distinguono correttamente probabilità marginali e condizionate, spesso si ignora la marginale quando si interpretano le condizionate. Potresti vedere un titolo: "Uno studio rileva che l’80% degli imprenditori di successo ha iniziato prima dei 30 anni." Questo è P(Iniziato prima dei 30 | Imprenditore di successo) = 0,8. Ma senza conoscere P(Iniziato prima dei 30) per tutti gli imprenditori, non puoi valutare se iniziare giovani predica davvero il successo.
Questo porta a decisioni sbagliate. Se il 90% di tutti gli imprenditori inizia prima dei 30 anni, allora gli imprenditori di successo non iniziano giovani a tassi insoliti. Stanno semplicemente seguendo l’andamento generale. La probabilità condizionata ha poco significato senza il confronto con la base marginale.
La fallacia del tasso di base si verifica quando si sovrastima l’evidenza condizionata ignorando le probabilità marginali (tassi di base).
Ecco un esempio comune in data science: stai costruendo un classificatore binario su un dataset sbilanciato. La classe positiva (quella che stai cercando di prevedere) si verifica solo nel 5% dei tuoi dati. Costruisci un modello e ottieni il 95% di accuratezza. Sembra ottimo, giusto?
Non proprio. Se costruissi un modello "sciocco" che predice sempre la classe negativa, otterrebbe comunque il 95% di accuratezza (perché il 95% dei dati è negativo). Il tuo modello sofisticato in realtà non fa molto meglio che rispondere sempre "no".
L’errore è guardare il 95% di accuratezza da solo senza considerare il tasso di base (5% classe positiva). Quando le classi sono sbilanciate, l’accuratezza diventa una metrica fuorviante. Devi controllare precision, recall o F1-score per vedere se il tuo modello ha davvero imparato qualcosa di utile.
Capire le marginali ti aiuta a scegliere le giuste metriche di valutazione per problemi sbilanciati.
Nei modelli ad alta dimensionalità con dozzine o centinaia di variabili, calcolare esattamente le distribuzioni marginali è spesso impossibile. Il numero di combinazioni possibili cresce rapidamente e le somme o gli integrali richiesti diventano intrattabili.
Per gestire questo, i professionisti usano metodi di inferenza approssimata:
Strumenti moderni come scipy.stats di Python per le distribuzioni di probabilità, pandas per le tabelle di contingenza e table() e dplyr di R per le marginali empiriche rendono accessibili questi calcoli. Per dati su database, la clausola GROUP BY di SQL calcola in modo efficiente le marginali empiriche da grandi dataset.
Prima di poter comprendere la relazione tra variabili, valutare l’evidenza condizionata o costruire modelli bayesiani, devi afferrare la probabilità incondizionata dei singoli eventi. È la base che rende tutto il resto interpretabile.
Quando fraintendi le marginali, sei vulnerabile a errori analitici: confondere tassi di base con probabilità condizionate, cadere nella fallacia del tasso di base o costruire modelli che non superano baseline ingenue. Se capisci bene le marginali, comprenderai come la probabilità condizionata le affina, come il teorema di Bayes le aggiorna con l’evidenza e come i modelli di machine learning apprendono dai pattern che rivelano.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



