您在为一家电商平台分析客户行为,经理问道:“不考虑原因,客户流失的概率是多少?”
这个问题比您想的更具体。您不是在问给定某一产品品类时的流失,或与某种支付方式相结合的流失。您问的是一个单一事件的基线概率:客户流失,仅此而已。
这就是边缘概率,它是您在数据科学中会遇到的大多数概率计算的基石。
什么是边缘概率?
如前所述,边缘概率是不考虑其他变量或事件时,某一单一事件发生的概率。之所以称为“边缘”,是因为当您将联合概率写成表格时,这些单事件的概率出现在表格的边缘(行与列的合计)。
记号很直观。对离散事件 A,我们记为 P(A)。边缘概率常由联合概率导出。若 B 是一个离散随机变量,并且您知道 A 与 B 取各值同时发生的联合概率,则可通过求和得到边缘概率:P(A) = Σb P(A, B=b),其中对 B 可取的所有 b 求和。边缘概率就是当您“对其他变量求和”或“积分消去”时所保留下来的部分。
要完全理解这一概念,您需要一些基础术语。样本空间是所有可能结果的集合。事件是样本空间的任一子集。联合概率 P(A ∩ B) 衡量两个事件同时发生的可能性,而条件概率 P(A|B) 则衡量在 B 已发生的条件下A 发生的可能性。
我建议您查看我们的概率规则入门速查表,以便快速参考这些关系。边缘概率位于这一概率生态系统的中心。它是条件概率计算的分母,也是贝叶斯定理的基石。
从表格与分布计算边缘概率
下面看看如何从不同数据结构实际计算边缘概率。方法取决于您处理的是离散变量还是连续变量。
离散情形(列联表)
处理分类数据时,边缘概率会自然地出现在列联表中。假设您按产品品类(电子产品、服装、图书)与地区(北、南、东、西)分析客户购买行为。每个单元格包含一个品类-地区组合的联合概率。行合计给出各产品品类的边缘概率(P(电子)、P(服装)、P(图书)),不区分地区。列合计给出各地区的边缘概率。
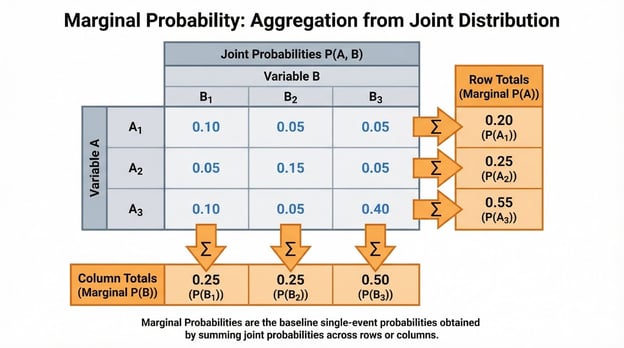
通过对联合概率求和来得到边缘概率。图片由作者提供。
您常会以标准化频数的形式遇到这些数据。若 2,000 名客户中有 500 人购买了电子产品,则边缘概率 P(电子) = 500/2,000 = 0.25。这是在考虑其他因素之前的基线比率。在开展探索性数据分析时,我建议先计算这些边缘概率。它们可帮助您在深入研究条件关系之前,理解数据的基本结构。
连续情形
对于连续型随机变量,边缘概率表现为边缘概率密度函数(PDF)。若您有两个连续变量 X 和 Y 的联合 PDF,则 X 的边缘 PDF 可通过对 Y 的所有取值进行积分得到。
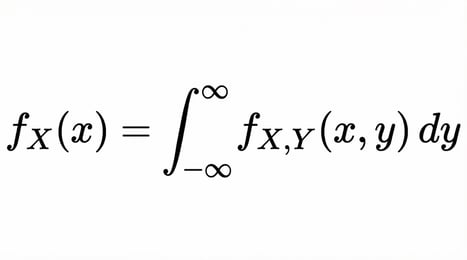
从概念上讲,这里的积分与离散情形中的求和作用相同。它通过考虑另一个变量的所有可能性,把联合分布“折叠”到一维。
可以把它想象为切开一个三维曲面(联合分布),并沿某一轴观察曲线下的面积。我们的R 语言贝叶斯数据分析基础课程在处理连续分布时会深入讲解这些概念。
边缘、联合与条件概率的关系
来看一看边缘概率如何与您经常使用的其他概率类型相联系。
这三类概率构成一个相互关联的体系,而边缘概率常是将它们黏合在一起的“胶水”。从联合概率出发,通过求和或积分得到边缘概率。由联合概率与边缘概率,又可用 P(A|B) = P(A ∩ B) / P(B) 计算条件概率。请注意,边缘概率 P(B) 是分母。它对联合概率进行归一化,从而得到条件概率。
在实践中,这一点非常重要,因为当您解读条件概率时,您需要以边缘概率为背景。给定阳性结果时 90% 的患病概率听起来很可怕,但如果疾病的边缘概率只有 1%,那么阳性后的实际概率可能远低于您的直觉预期。
这在贝叶斯推断中随处可见。先验是您在未见到任何数据前对参数的信念。边缘似然(也称证据)P(Data) 是贝叶斯定理中的归一化项,它把“先验 × 似然”转化为一个合格的后验概率。我们的Python 贝叶斯数据分析课程通过实用建模练习探讨这些联系。
边缘概率的例题演练
我们来同时看看经典概率问题与真实世界情境。
经典示例
从骰子开始。掷两枚骰子,第一枚出现 4 的概率是多少,不考虑第二枚的点数?
样本空间有 36 个等可能结果。其中 6 个结果第一枚为 4:(4,1)、(4,2)、(4,3)、(4,4)、(4,5)、(4,6)。因此 P(第一枚=4) = 6/36 = 1/6。注意我们没有就第二枚任何信息进行条件化。我们只是统计了第一枚为 4 的所有结果。
再看一个经典示例。从一副标准 52 张牌中抽一张,不论点数,抽到红桃的概率是多少?共有 13 张红桃,52 张牌总计,因此 P(红桃) = 13/52 = 1/4。这个边缘概率跨越所有点数(A 至 K)聚合,给出该花色的无条件概率。
真实世界示例
医学筛查提供了一个引人注目的真实应用。假设您在分析某人群中的疾病流行率。边缘概率 P(疾病) 表示在未考虑任何诊断测试结果前的基线患病率。若 2% 的人群患病,则 P(疾病) = 0.02。这个边缘概率对于解读测试准确性至关重要。当疾病很罕见时,即便灵敏度为 95% 的检测也会产生大量假阳性。
在数字营销中,您可能会问:不考虑流量来源,用户转化的概率是多少?如果您拥有来自自然搜索、付费广告、社交媒体和电子邮件的转化数据,则边缘概率 P(转化) 对所有来源求和。这个基线转化率有助于评估特定流量来源的表现是否高于或低于平均水平。
类似地,在金融领域,您可能会计算不考虑利率水平时市场下跌的边缘概率。这给出在叠加宏观经济因素之前的无条件风险。
数据科学与机器学习中的边缘概率
来看边缘概率如何贯穿数据科学工作流。
探索性数据分析(EDA)
首次接触数据集时,计算边缘概率有助于了解基线事件发生率。在欺诈检测数据集中,P(欺诈) 告诉您在查看任何特征之前的类别分布。这能立刻揭示您是否在处理一个严重失衡的问题,例如欺诈仅发生在 0.1% 的交易中。
各个特征的边缘分布也会指导您的分析。若您正在构建预测客户流失的模型,我建议分别查看 P(流失)、P(高价值客户) 与 P(近期活跃)。这在您探索它们的联合关系之前提供了背景。
预测建模
朴素贝叶斯分类器明确依赖于作为类别先验的边缘概率。在将文档分类为垃圾邮件或非垃圾邮件时,P(垃圾) 是您在查看文档中任何词语之前的先验信念。算法随后根据条件特征概率来更新这一边缘概率。
特征的边缘分布在特征工程与模型诊断中同样重要。若某个特征的边缘分布高度偏斜,您可能会采用对数缩放或 Box-Cox 等变换使其更对称。
数据集之间的分布漂移同样重要。比如训练集的 P(A 类)=0.9,但测试集的 P(A 类)=0.5,则您的预测概率与性能指标可能变化很大,您也许需要不同的决策阈值。原因在于模型是在一个基线率下学习的,却在另一个基线率下被评估。
在训练前检查边缘分布有助于您及早发现这些问题,并判断是否需要重采样、采用不同评估指标、重新校准,或针对不同数据分段分别建模。
风险与决策
期望值计算需要边缘概率。若您在决定是否发布一款产品,您需要 P(成功) 作为跨越所有可能市场环境的成功边缘概率。将其与成功收益相乘,再加上 P(失败) 与失败成本的乘积,您就得到了期望值。
概率建模
在贝叶斯网络与图模型中,节点代表具有相应条件概率分布的变量。通过在网络结构中传播概率,或观测证据并更新信念,可进行推断以获得边缘分布。当精确计算变得不可行时,马尔可夫链蒙特卡罗等采样方法可近似这些边缘分布。我们的使用 RJAGS 的贝叶斯建模课程展示了这些方法的实践应用。
人们对边缘概率的常见误解
以下是即便是经验丰富的从业者也会踩坑的地方。
将边缘概率与条件概率混淆
这大概是最常见的错误,而且很容易被直觉误导。想象一下,您做了一项灵敏度 95%、特异度 90% 的医学检测,结果为阳性。大多数人会立即想:“检测能抓住 95% 的病例,所以我大概率患病。”
但这种推理跳过了一个关键信息:这种疾病本就有多常见?如果只有 1% 的人患病(边缘概率),那么当您检测 10,000 人时,大约会有 95 个真阳性,但会有 990 个假阳性。这意味着大多数阳性结果都是虚惊。您在阳性后的实际概率只有约 9%,而不是 95%。
之所以混淆,是因为人们关注检测的灵敏度(95%),而忽视了基线比率(1% 的流行率)。边缘概率 P(疾病)=0.01 与条件概率 P(疾病 | 阳性)=0.09 是完全不同的量,但我们的直觉却倾向于把它们当作一回事。
解读条件概率时忽视边缘概率
即使能正确区分边缘与条件概率,人们在解读条件概率时也常忽视边缘概率。您可能会看到这样的新闻标题:“研究发现 80% 的成功企业家在 30 岁前就开始创业。”这是 P(30 岁前开始 | 成功企业家)=0.8。但若不知道所有企业家的 P(30 岁前开始),您就无法判断年轻开始是否真的预测成功。
这会导致错误决策。若所有企业家中有 90% 在 30 岁前开始,那么成功企业家并没有以异常的比例更早开始。他们只是遵循总体模式。没有边缘基线作比较,条件概率的意义就很有限。
基线率谬误
基线率谬误指在解读条件证据时,过度加权而忽略边缘概率(基线率)。
这是一个常见的数据科学示例:您在一个失衡数据集上构建二分类器。正类(您想要预测的类)仅占数据的 5%。您训练了一个模型,达到了 95% 的准确率。听起来很棒,对吧?
并不见得。如果您构建一个“愚蠢”的模型,始终预测负类,它也能获得 95% 的准确率(因为 95% 的数据是负类)。您自认为很高级的模型实际上并没有比一直猜“否”好多少。
错误在于孤立地看待 95% 的准确率,而没有考虑基线率(5% 的正类)。当类别失衡时,准确率会成为一个误导性的指标。您需要查看精确率、召回率或 F1 分数,以判断模型是否真正学到了有用的信息。
理解边缘概率有助于您为失衡问题选择合适的评估指标。
进阶主题与扩展
在具有数十甚至数百个变量的高维模型中,精确计算边缘分布往往是不可能的。可能组合数量迅速增长,所需的求和或积分变得不可处理。
为应对这一点,从业者使用近似推断方法:
- 采样方法(如马尔可夫链蒙特卡罗,MCMC)从模型分布中生成大量样本。随后您可以通过样本中事件发生的频率来估计边缘概率。
- 变分推断采用不同思路:用一个更简单的分布替代难以计算的分布,并将其优化到尽可能接近,从而在大型模型中更快地给出边缘估计。
现代工具如 Python 的 scipy.stats(概率分布)、pandas(列联表),以及 R 的 table() 与 dplyr(经验边缘概率)都让这些计算变得易于上手。对于存储在数据库中的数据,SQL 的 GROUP BY 子句可高效地从大型数据集计算经验边缘概率。
结语
在理解变量间关系、评估条件证据或构建贝叶斯模型之前,您需要掌握单个事件的无条件概率。它是让其他一切都可解释的基线。
一旦误解了边缘概率,您就容易犯分析错误:将基线率与条件概率混为一谈、落入基线率谬误,或构建不优于天真基线的模型。把边缘概率搞清楚,您就能理解条件概率如何对其加以细化、贝叶斯定理如何用证据进行更新,以及机器学习模型如何从它们揭示的模式中学习。


您在为一家电商平台分析客户行为,经理问道:“不考虑原因,客户流失的概率是多少?”
这个问题比您想的更具体。您不是在问给定某一产品品类时的流失,或与某种支付方式相结合的流失。您问的是一个单一事件的基线概率:客户流失,仅此而已。
这就是边缘概率,它是您在数据科学中会遇到的大多数概率计算的基石。
什么是边缘概率?
如前所述,边缘概率是不考虑其他变量或事件时,某一单一事件发生的概率。之所以称为“边缘”,是因为当您将联合概率写成表格时,这些单事件的概率出现在表格的边缘(行与列的合计)。
记号很直观。对离散事件 A,我们记为 P(A)。边缘概率常由联合概率导出。若 B 是一个离散随机变量,并且您知道 A 与 B 取各值同时发生的联合概率,则可通过求和得到边缘概率:P(A) = Σb P(A, B=b),其中对 B 可取的所有 b 求和。边缘概率就是当您“对其他变量求和”或“积分消去”时所保留下来的部分。
要完全理解这一概念,您需要一些基础术语。样本空间是所有可能结果的集合。事件是样本空间的任一子集。联合概率 P(A ∩ B) 衡量两个事件同时发生的可能性,而条件概率 P(A|B) 则衡量在 B 已发生的条件下A 发生的可能性。
我建议您查看我们的概率规则入门速查表,以便快速参考这些关系。边缘概率位于这一概率生态系统的中心。它是条件概率计算的分母,也是贝叶斯定理的基石。
从表格与分布计算边缘概率
下面看看如何从不同数据结构实际计算边缘概率。方法取决于您处理的是离散变量还是连续变量。
离散情形(列联表)
处理分类数据时,边缘概率会自然地出现在列联表中。假设您按产品品类(电子产品、服装、图书)与地区(北、南、东、西)分析客户购买行为。每个单元格包含一个品类-地区组合的联合概率。行合计给出各产品品类的边缘概率(P(电子)、P(服装)、P(图书)),不区分地区。列合计给出各地区的边缘概率。
通过对联合概率求和来得到边缘概率。图片由作者提供。
您常会以标准化频数的形式遇到这些数据。若 2,000 名客户中有 500 人购买了电子产品,则边缘概率 P(电子) = 500/2,000 = 0.25。这是在考虑其他因素之前的基线比率。在开展探索性数据分析时,我建议先计算这些边缘概率。它们可帮助您在深入研究条件关系之前,理解数据的基本结构。
连续情形
对于连续型随机变量,边缘概率表现为边缘概率密度函数(PDF)。若您有两个连续变量 X 和 Y 的联合 PDF,则 X 的边缘 PDF 可通过对 Y 的所有取值进行积分得到。
从概念上讲,这里的积分与离散情形中的求和作用相同。它通过考虑另一个变量的所有可能性,把联合分布“折叠”到一维。
可以把它想象为切开一个三维曲面(联合分布),并沿某一轴观察曲线下的面积。我们的R 语言贝叶斯数据分析基础课程在处理连续分布时会深入讲解这些概念。
边缘、联合与条件概率的关系
来看一看边缘概率如何与您经常使用的其他概率类型相联系。
这三类概率构成一个相互关联的体系,而边缘概率常是将它们黏合在一起的“胶水”。从联合概率出发,通过求和或积分得到边缘概率。由联合概率与边缘概率,又可用 P(A|B) = P(A ∩ B) / P(B) 计算条件概率。请注意,边缘概率 P(B) 是分母。它对联合概率进行归一化,从而得到条件概率。
在实践中,这一点非常重要,因为当您解读条件概率时,您需要以边缘概率为背景。给定阳性结果时 90% 的患病概率听起来很可怕,但如果疾病的边缘概率只有 1%,那么阳性后的实际概率可能远低于您的直觉预期。
这在贝叶斯推断中随处可见。先验是您在未见到任何数据前对参数的信念。边缘似然(也称证据)P(Data) 是贝叶斯定理中的归一化项,它把“先验 × 似然”转化为一个合格的后验概率。我们的Python 贝叶斯数据分析课程通过实用建模练习探讨这些联系。
边缘概率的例题演练
我们来同时看看经典概率问题与真实世界情境。
经典示例
从骰子开始。掷两枚骰子,第一枚出现 4 的概率是多少,不考虑第二枚的点数?
样本空间有 36 个等可能结果。其中 6 个结果第一枚为 4:(4,1)、(4,2)、(4,3)、(4,4)、(4,5)、(4,6)。因此 P(第一枚=4) = 6/36 = 1/6。注意我们没有就第二枚任何信息进行条件化。我们只是统计了第一枚为 4 的所有结果。
再看一个经典示例。从一副标准 52 张牌中抽一张,不论点数,抽到红桃的概率是多少?共有 13 张红桃,52 张牌总计,因此 P(红桃) = 13/52 = 1/4。这个边缘概率跨越所有点数(A 至 K)聚合,给出该花色的无条件概率。
真实世界示例
医学筛查提供了一个引人注目的真实应用。假设您在分析某人群中的疾病流行率。边缘概率 P(疾病) 表示在未考虑任何诊断测试结果前的基线患病率。若 2% 的人群患病,则 P(疾病) = 0.02。这个边缘概率对于解读测试准确性至关重要。当疾病很罕见时,即便灵敏度为 95% 的检测也会产生大量假阳性。
在数字营销中,您可能会问:不考虑流量来源,用户转化的概率是多少?如果您拥有来自自然搜索、付费广告、社交媒体和电子邮件的转化数据,则边缘概率 P(转化) 对所有来源求和。这个基线转化率有助于评估特定流量来源的表现是否高于或低于平均水平。
类似地,在金融领域,您可能会计算不考虑利率水平时市场下跌的边缘概率。这给出在叠加宏观经济因素之前的无条件风险。
数据科学与机器学习中的边缘概率
来看边缘概率如何贯穿数据科学工作流。
探索性数据分析(EDA)
首次接触数据集时,计算边缘概率有助于了解基线事件发生率。在欺诈检测数据集中,P(欺诈) 告诉您在查看任何特征之前的类别分布。这能立刻揭示您是否在处理一个严重失衡的问题,例如欺诈仅发生在 0.1% 的交易中。
各个特征的边缘分布也会指导您的分析。若您正在构建预测客户流失的模型,我建议分别查看 P(流失)、P(高价值客户) 与 P(近期活跃)。这在您探索它们的联合关系之前提供了背景。
预测建模
朴素贝叶斯分类器明确依赖于作为类别先验的边缘概率。在将文档分类为垃圾邮件或非垃圾邮件时,P(垃圾) 是您在查看文档中任何词语之前的先验信念。算法随后根据条件特征概率来更新这一边缘概率。
特征的边缘分布在特征工程与模型诊断中同样重要。若某个特征的边缘分布高度偏斜,您可能会采用对数缩放或 Box-Cox 等变换使其更对称。
数据集之间的分布漂移同样重要。比如训练集的 P(A 类)=0.9,但测试集的 P(A 类)=0.5,则您的预测概率与性能指标可能变化很大,您也许需要不同的决策阈值。原因在于模型是在一个基线率下学习的,却在另一个基线率下被评估。
在训练前检查边缘分布有助于您及早发现这些问题,并判断是否需要重采样、采用不同评估指标、重新校准,或针对不同数据分段分别建模。
风险与决策
期望值计算需要边缘概率。若您在决定是否发布一款产品,您需要 P(成功) 作为跨越所有可能市场环境的成功边缘概率。将其与成功收益相乘,再加上 P(失败) 与失败成本的乘积,您就得到了期望值。
概率建模
在贝叶斯网络与图模型中,节点代表具有相应条件概率分布的变量。通过在网络结构中传播概率,或观测证据并更新信念,可进行推断以获得边缘分布。当精确计算变得不可行时,马尔可夫链蒙特卡罗等采样方法可近似这些边缘分布。我们的使用 RJAGS 的贝叶斯建模课程展示了这些方法的实践应用。
人们对边缘概率的常见误解
以下是即便是经验丰富的从业者也会踩坑的地方。
将边缘概率与条件概率混淆
这大概是最常见的错误,而且很容易被直觉误导。想象一下,您做了一项灵敏度 95%、特异度 90% 的医学检测,结果为阳性。大多数人会立即想:“检测能抓住 95% 的病例,所以我大概率患病。”
但这种推理跳过了一个关键信息:这种疾病本就有多常见?如果只有 1% 的人患病(边缘概率),那么当您检测 10,000 人时,大约会有 95 个真阳性,但会有 990 个假阳性。这意味着大多数阳性结果都是虚惊。您在阳性后的实际概率只有约 9%,而不是 95%。
之所以混淆,是因为人们关注检测的灵敏度(95%),而忽视了基线比率(1% 的流行率)。边缘概率 P(疾病)=0.01 与条件概率 P(疾病 | 阳性)=0.09 是完全不同的量,但我们的直觉却倾向于把它们当作一回事。
解读条件概率时忽视边缘概率
即使能正确区分边缘与条件概率,人们在解读条件概率时也常忽视边缘概率。您可能会看到这样的新闻标题:“研究发现 80% 的成功企业家在 30 岁前就开始创业。”这是 P(30 岁前开始 | 成功企业家)=0.8。但若不知道所有企业家的 P(30 岁前开始),您就无法判断年轻开始是否真的预测成功。
这会导致错误决策。若所有企业家中有 90% 在 30 岁前开始,那么成功企业家并没有以异常的比例更早开始。他们只是遵循总体模式。没有边缘基线作比较,条件概率的意义就很有限。
基线率谬误
基线率谬误指在解读条件证据时,过度加权而忽略边缘概率(基线率)。
这是一个常见的数据科学示例:您在一个失衡数据集上构建二分类器。正类(您想要预测的类)仅占数据的 5%。您训练了一个模型,达到了 95% 的准确率。听起来很棒,对吧?
并不见得。如果您构建一个“愚蠢”的模型,始终预测负类,它也能获得 95% 的准确率(因为 95% 的数据是负类)。您自认为很高级的模型实际上并没有比一直猜“否”好多少。
错误在于孤立地看待 95% 的准确率,而没有考虑基线率(5% 的正类)。当类别失衡时,准确率会成为一个误导性的指标。您需要查看精确率、召回率或 F1 分数,以判断模型是否真正学到了有用的信息。
理解边缘概率有助于您为失衡问题选择合适的评估指标。
进阶主题与扩展
在具有数十甚至数百个变量的高维模型中,精确计算边缘分布往往是不可能的。可能组合数量迅速增长,所需的求和或积分变得不可处理。
为应对这一点,从业者使用近似推断方法:
现代工具如 Python 的
scipy.stats(概率分布)、pandas(列联表),以及 R 的table()与dplyr(经验边缘概率)都让这些计算变得易于上手。对于存储在数据库中的数据,SQL 的GROUP BY子句可高效地从大型数据集计算经验边缘概率。结语
在理解变量间关系、评估条件证据或构建贝叶斯模型之前,您需要掌握单个事件的无条件概率。它是让其他一切都可解释的基线。
一旦误解了边缘概率,您就容易犯分析错误:将基线率与条件概率混为一谈、落入基线率谬误,或构建不优于天真基线的模型。把边缘概率搞清楚,您就能理解条件概率如何对其加以细化、贝叶斯定理如何用证据进行更新,以及机器学习模型如何从它们揭示的模式中学习。