
Cursus
Basis van kansrekening in R
4 uur
42.8K
Je analyseert klantgedrag voor een e-commerceplatform en je manager vraagt: "Wat is de kans dat een klant afhaakt, ongeacht de reden?"
Die vraag is specifieker dan je denkt. Je vraagt niet naar churn gegeven een bepaalde productcategorie, of churn in combinatie met betaalmethode. Je vraagt naar de basiskans van één gebeurtenis: klantchurn, punt.
Dat is marginale kans, en het is de basis van de meeste kansberekeningen die je in data science tegenkomt.
Zoals hierboven geïntroduceerd, is marginale kans de kans dat één gebeurtenis plaatsvindt, los van andere variabelen of gebeurtenissen. Het heet "marginaal" omdat, wanneer je gezamenlijke kansen in een tabel uitschrijft, deze enkelvoudige kansen in de marges verschijnen (de rij- en kolomsommen).
De notatie is eenvoudig. Voor een discrete gebeurtenis A schrijven we P(A). Marginale kans komt vaak voort uit gezamenlijke kans. Als B een discrete toevalsvariabele is en je kent de gezamenlijke kans dat A optreedt met elke waarde van B, dan vind je de marginale kans door op te tellen: P(A) = Σb P(A, B=b), waarbij je somt over alle mogelijke waarden b die B kan aannemen. Marginale kans is wat overblijft wanneer je alle andere variabelen "wegsomt" of "weg-integreert".
Om dit volledig te begrijpen, heb je een paar basisbegrippen nodig. De steekproefruimte is de verzameling van alle mogelijke uitkomsten. Een gebeurtenis is elke deelverzameling van de steekproefruimte. Gezamenlijke kans P(A ∩ B) meet de waarschijnlijkheid dat twee gebeurtenissen samen optreden, terwijl voorwaardelijke kans P(A|B) de waarschijnlijkheid van A meet gegeven dat B is opgetreden.
Ik raad je aan onze Cheat Sheet Inleiding tot Kansrekenen te bekijken als een snelle referentie voor deze relaties. Marginale kans staat centraal in dit kans-ecosysteem. Het is de noemer in berekeningen van voorwaardelijke kansen en de bouwsteen voor de stelling van Bayes.
Laten we kijken hoe je marginale kans daadwerkelijk berekent vanuit verschillende datastructuren. De aanpak hangt af van of je met discrete of continue variabelen werkt.
Bij categorische data komen marginale kansen vanzelf naar voren in contingentietabellen. Stel dat je het koopgedrag van klanten analyseert over productcategorieën (Elektronica, Kleding, Boeken) en regio's (Noord, Zuid, Oost, West). Elke cel bevat de gezamenlijke kans van een categorie-regio-combinatie. De rijsommen geven je de marginale kans voor elke productcategorie (P(Elektronica), P(Kleding), P(Boeken)) ongeacht de regio. Kolomsommen geven je marginale kansen voor elke regio.
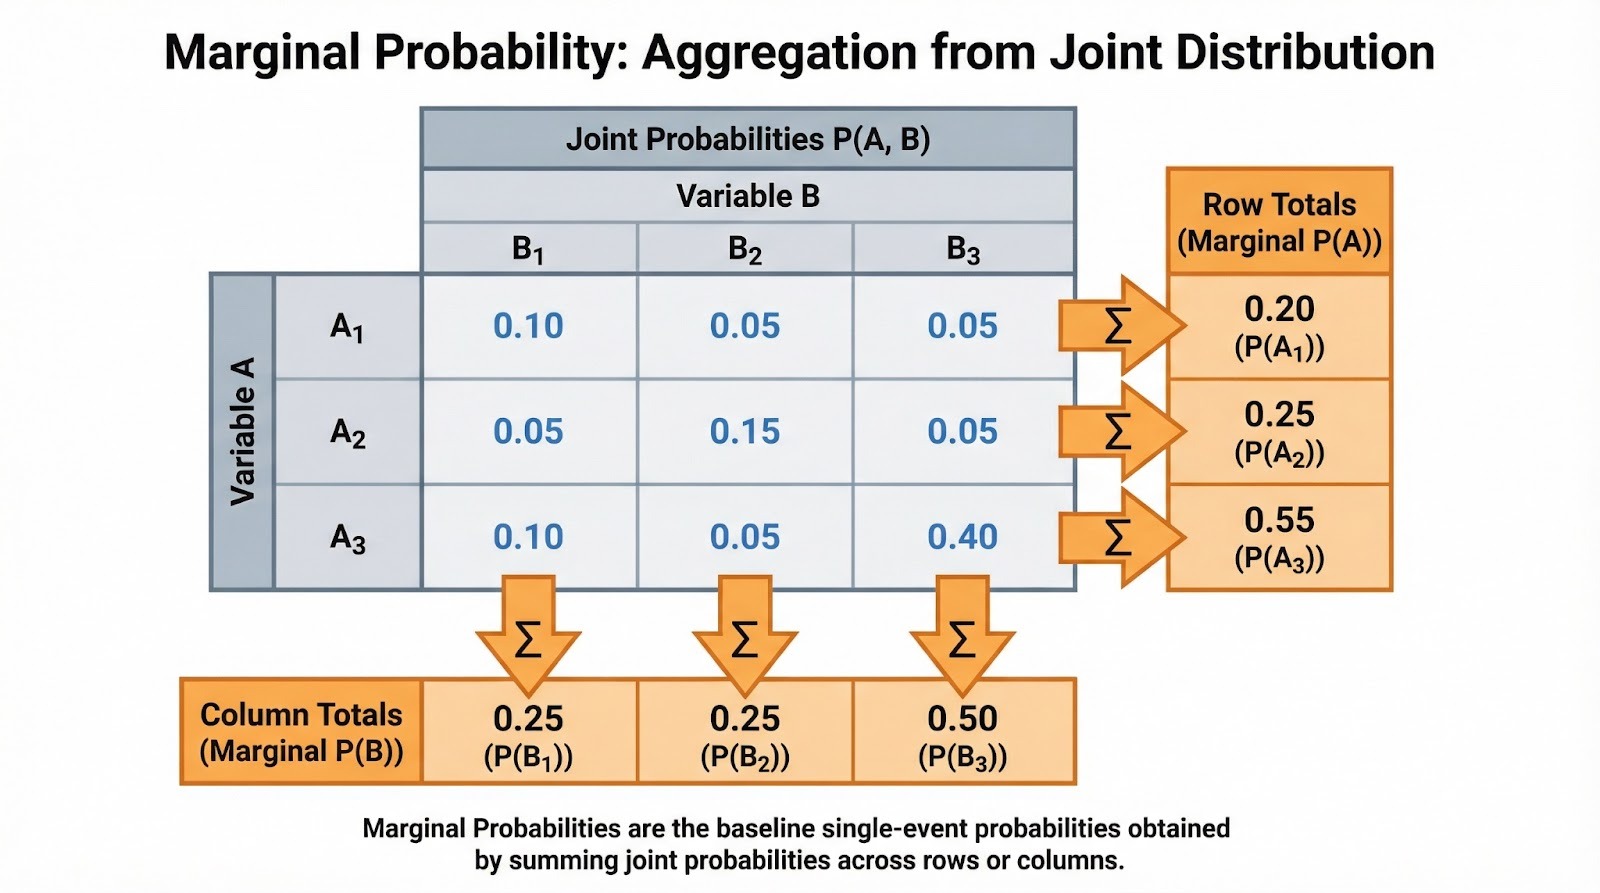
Gezamenlijke kansen sommeren om marginale kansen te vinden. Afbeelding door de auteur.
Je komt dit vaak tegen als genormaliseerde frequenties. Als 500 van de 2.000 klanten elektronica kochten, dan is de marginale kans P(Elektronica) = 500/2.000 = 0,25. Dit is het basispercentage voordat je andere factoren meeneemt. Bij verkennende data-analyse zou ik aanraden om deze marginals eerst te berekenen. Ze helpen je de basisstructuur van je data te begrijpen voordat je in voorwaardelijke relaties duikt.
Voor continue toevalsvariabelen wordt marginale kans een marginale kansdichtheidsfunctie (PDF). Als je twee continue variabelen X en Y hebt met een gezamenlijke PDF, vind je de marginale PDF van X door te integreren over alle waarden van Y.
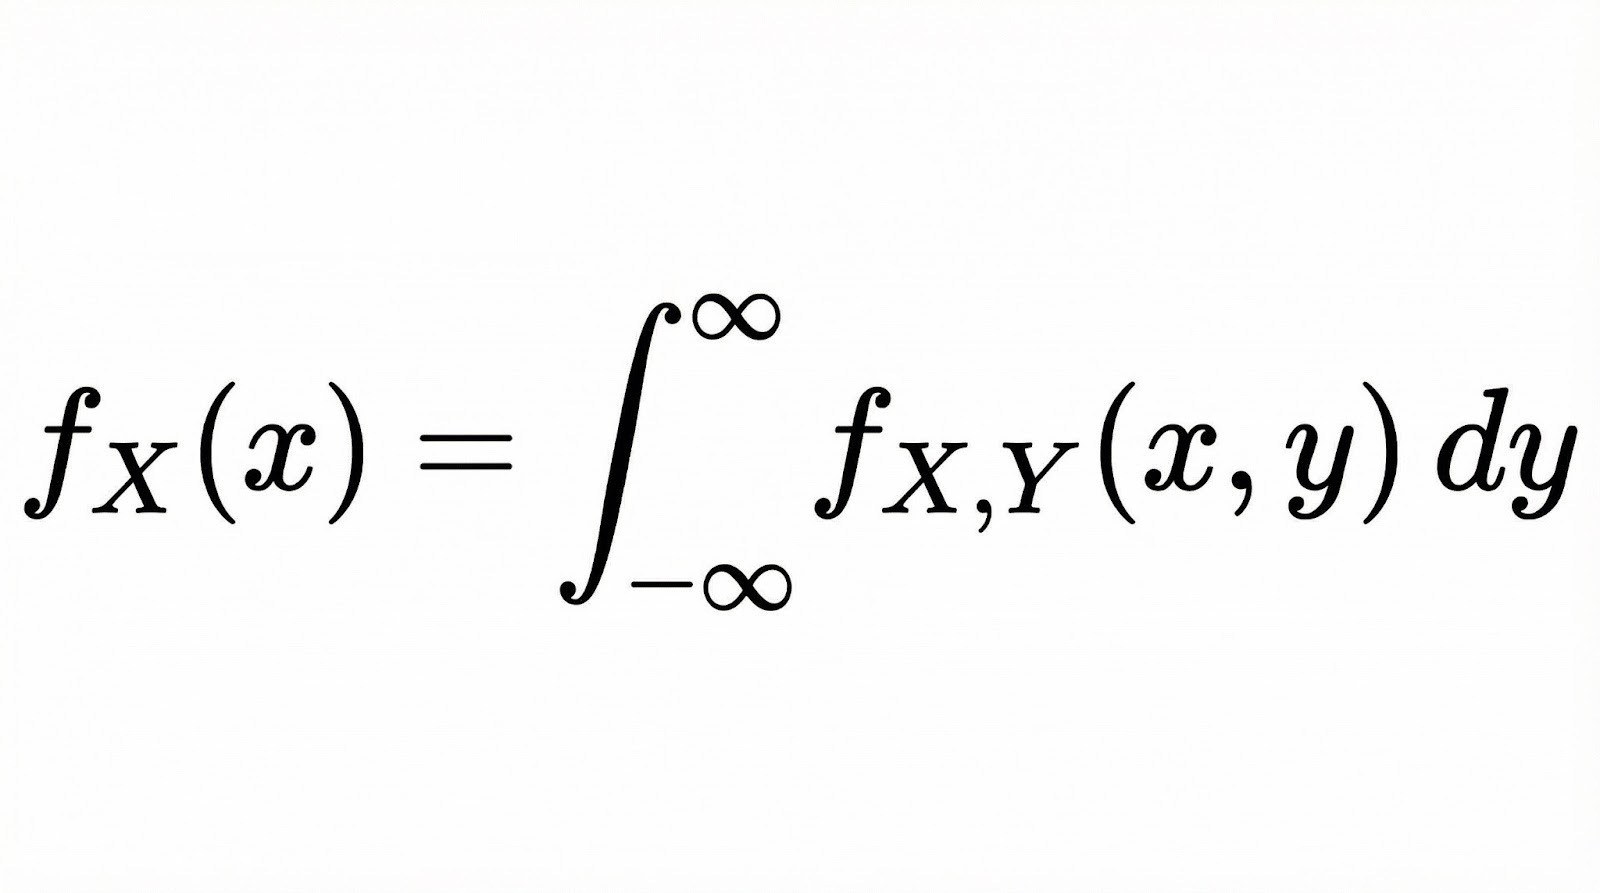
Conceptueel doet integratie hier hetzelfde als sommatie in het discrete geval. Het "klapt" de gezamenlijke verdeling terug naar één dimensie door alle mogelijkheden van de andere variabele mee te nemen.
Zie het als een doorsnede door een 3D-oppervlak (de gezamenlijke verdeling) en kijken naar de oppervlakte onder de kromme langs één as. Onze Fundamentals of Bayesian Data Analysis in R-cursus behandelt deze concepten uitgebreid voor continue verdelingen.
Laten we bekijken hoe marginale kans samenhangt met de andere kanssoorten waar je regelmatig mee werkt.
Deze drie soorten kansen vormen een samenhangend systeem, en marginale kans is vaak de lijm die ze bij elkaar houdt. Vanuit gezamenlijke kans krijg je marginals door te sommeren of te integreren. Uit gezamenlijke en marginale kansen bereken je voorwaardelijke kansen met P(A|B) = P(A ∩ B) / P(B). Let op dat de marginale kans P(B) de noemer is. Die normaliseert de gezamenlijke kans om je de voorwaardelijke te geven.
Dit is in de praktijk belangrijk, want bij het interpreteren van voorwaardelijke kansen heb je de marginale als context nodig. Een kans van 90% op ziekte gegeven een positieve test klinkt alarmerend, maar als de marginale kans op ziekte slechts 1% is, kan de werkelijke kans na een positieve test veel lager zijn dan je verwacht.
Dit zie je overal in Bayesiaanse inferentie. Een prior is je overtuiging over een parameter voordat je data ziet. De marginale likelihood (ook wel het bewijs), P(Data), is de normalisatieterm in de stelling van Bayes die "prior × likelihood" omzet in een geldige posterior-kans. Onze Bayesian Data Analysis in Python-cursus verkent deze verbanden via praktische modelleeropdrachten.
Laten we zowel klassieke kansproblemen als realistische scenario's doorlopen.
Beginnen we met dobbelstenen. Als je twee dobbelstenen gooit, wat is dan de kans dat de eerste dobbelsteen een 4 toont, ongeacht de waarde van de tweede dobbelsteen?
De steekproefruimte heeft 36 even waarschijnlijke uitkomsten. Zes daarvan hebben een 4 op de eerste dobbelsteen: (4,1), (4,2), (4,3), (4,4), (4,5), (4,6). Dus P(Eerste dobbelsteen = 4) = 6/36 = 1/6. Merk op dat we niets hebben geconditioneerd op de tweede dobbelsteen. We hebben simpelweg alle uitkomsten geteld waar de eerste dobbelsteen 4 is.
Nog een klassiek voorbeeld. Uit een standaard kaartspel van 52 kaarten: wat is de kans om een harten te trekken, ongeacht de rang? Er zijn 13 harten en 52 kaarten in totaal, dus P(Harten) = 13/52 = 1/4. Deze marginale kans aggregeert over alle rangen (Aas tot en met Koning) en geeft je de onvoorwaardelijke kans van de soort.
Medische screening is een overtuigende toepassing uit de praktijk. Stel dat je de prevalentie van een ziekte in een populatie analyseert. De marginale kans P(Ziekte) vertegenwoordigt het basisziektepercentage voordat je enige testresultaten meeneemt. Als 2% van de populatie de ziekte heeft, is P(Ziekte) = 0,02. Deze marginale kans is essentieel voor het interpreteren van testnauwkeurigheid. Een test met 95% sensitiviteit levert nog steeds veel valspositieven op wanneer de ziekte zeldzaam is.
In digitale marketing kun je vragen: Wat is de kans dat een gebruiker converteert, ongeacht de verkeersbron? Als je gegevens hebt over conversies uit organisch zoeken, betaalde advertenties, social media en e-mail, dan somt de marginale kans P(Conversie) over alle bronnen. Dit basisconversiepercentage helpt je beoordelen of specifieke verkeersbronnen boven of onder het gemiddelde presteren.
Vergelijkbaar kun je in de financiële sector de marginale kans op een marktcorrectie berekenen, ongeacht het renteniveau. Dit geeft je het onvoorwaardelijke risico voordat je macro-economische factoren meeneemt.
Laten we verkennen hoe marginale kans in de hele data science-workflow terugkomt.
Wanneer je een dataset voor het eerst bekijkt, helpen marginale kansen je om basispercentages van gebeurtenissen te begrijpen. In een fraudedetectiedataset vertelt P(Fraude) je de class balance voordat je functies onderzoekt. Dit onthult direct of je te maken hebt met een sterk scheef probleem waarbij fraude slechts in 0,1% van de transacties voorkomt.
Marginale verdelingen voor individuele features sturen je analyse ook. Als je een model bouwt om klantchurn te voorspellen, zou ik aanbevelen P(Churn), P(Klant met hoge waarde) en P(Recente activiteit) afzonderlijk te bekijken. Dit biedt context voordat je hun gezamenlijke relaties onderzoekt.
Naive Bayes-classificatoren leunen expliciet op marginale kansen als klasse-priors. Bij het classificeren van een document als spam of geen spam is P(Spam) je voorafgaande overtuiging voordat je ook maar één woord in het document ziet. Het algoritme werkt deze marginale kans vervolgens bij op basis van voorwaardelijke feature-kansen.
Marginale featureverdelingen zijn ook belangrijk bij feature engineering en modeldiagnostiek. Als de marginale verdeling van een feature sterk scheef is, kun je transformaties zoals log-scaling of Box-Cox toepassen om haar symmetrischer te maken.
Verschuivingen tussen datasets zijn even belangrijk. Als je trainingsset bijvoorbeeld P(Klasse A)=0,9 heeft maar je testset P(Klasse A)=0,5, dan kunnen je voorspelde kansen en prestatiemetrics sterk veranderen, en heb je mogelijk een andere beslissingsdrempel nodig. Dit gebeurt omdat het model onder één basispercentage heeft geleerd, maar wordt geëvalueerd onder een ander.
Het controleren van marginale verdelingen vóór het trainen helpt je deze problemen vroeg te ontdekken en te beslissen of je hersteekproeven, andere evaluatiemetrics, herkalibratie of aparte modellen voor verschillende datasegmenten nodig hebt.
Verwachtingswaarde-berekeningen vereisen marginale kansen. Als je beslist of je een product lanceert, heb je P(Succes) nodig als de marginale kans op succes over alle mogelijke marktomstandigheden. Vermenigvuldig dit met de opbrengst bij succes, tel daarbij P(Falen) maal de kosten van falen op, en je hebt je verwachtingswaarde.
In Bayesiaanse netwerken en grafische modellen vertegenwoordigen knopen variabelen met bijbehorende voorwaardelijke kansverdelingen. Marginale verdelingen worden verkregen via inferentie door kansen door de netwerkstructuur te propaganderen of door bewijs te observeren en overtuigingen bij te werken. Steekproefmethoden zoals Markov Chain Monte Carlo benaderen deze marginals wanneer exacte berekening onhaalbaar wordt. Onze Bayesian Modeling with RJAGS-cursus demonstreert deze methoden in de praktijk.
Dit zijn de valkuilen waar zelfs ervaren professionals over struikelen.
Dit is waarschijnlijk de meest voorkomende fout, en verrassend intuïtief om te maken. Stel, je doet een medische test met 95% sensitiviteit en 90% specificiteit. Je test positief. De meeste mensen denken meteen: "De test vangt 95% van de gevallen, dus ik heb het waarschijnlijk."
Maar die redenering slaat een cruciaal stuk informatie over: hoe vaak komt de ziekte überhaupt voor? Als slechts 1% van de mensen het heeft (de marginale kans), dan krijg je bij het testen van 10.000 mensen ongeveer 95 echte positieven maar 990 valse positieven. Dat betekent dat de meeste positieve resultaten loos alarm zijn. Je werkelijke kans na een positieve test is slechts zo'n 9%, niet 95%.
De verwarring ontstaat omdat mensen zich focussen op de sensitiviteit van de test (95%) en het basispercentage (1% prevalentie) vergeten. De marginale kans P(Ziekte) = 0,01 en de voorwaardelijke kans P(Ziekte | Positieve test) = 0,09 zijn totaal verschillende grootheden, maar onze intuïtie wil ze hetzelfde behandelen.
Zelfs wanneer mensen marges en voorwaardelijke kansen goed onderscheiden, negeren ze vaak de marge bij het interpreteren van conditionals. Je ziet misschien een krantenkop: "Onderzoek vindt dat 80% van de succesvolle ondernemers vóór hun 30e begon." Dat is P(Begonnen voor 30 | Succesvolle ondernemer) = 0,8. Maar zonder P(Begonnen voor 30) voor alle ondernemers kun je niet beoordelen of jong beginnen succes daadwerkelijk voorspelt.
Dit leidt tot gebrekkige besluitvorming. Als 90% van alle ondernemers vóór hun 30e begint, dan beginnen succesvolle ondernemers niet op ongebruikelijke leeftijd. Ze volgen gewoon het algemene patroon. De voorwaardelijke kans zegt weinig zonder de marginale basislijn ter vergelijking.
De base rate fallacy treedt op wanneer mensen voorwaardelijk bewijs te zwaar laten wegen terwijl ze marginale kansen (basispercentages) negeren.
Een veelvoorkomend data science-voorbeeld: je bouwt een binaire classifier op een ongebalanceerde dataset. De positieve klasse (wat je probeert te voorspellen) komt slechts in 5% van je data voor. Je bouwt een model en behaalt 95% nauwkeurigheid. Klinkt goed, toch?
Niet echt. Als je een "dom" model bouwt dat elke keer de negatieve klasse voorspelt, haalt het ook 95% nauwkeurigheid (omdat 95% van de data negatief is). Je geavanceerde model doet het dan niet veel beter dan altijd "nee" raden.
De fout is dat je het getal van 95% nauwkeurigheid geïsoleerd bekijkt zonder het basispercentage (5% positieve klasse) mee te nemen. Bij ongebalanceerde klassen wordt nauwkeurigheid een misleidende maatstaf. Je moet precision, recall of F1-score bekijken om te zien of je model daadwerkelijk iets nuttigs heeft geleerd.
Inzicht in marges helpt je de juiste evaluatiemetrics te kiezen voor ongebalanceerde problemen.
In hoog-dimensionale modellen met tientallen of honderden variabelen is het vaak onmogelijk om marginale verdelingen exact te berekenen. Het aantal mogelijke combinaties groeit snel, en de benodigde sommen of integralen worden onuitvoerbaar.
Om dit aan te pakken, gebruiken praktijkmensen benaderende-inferentiemethoden:
Moderne tools zoals Python's scipy.stats voor kansverdelingen, pandas voor contingentietabellen en R's table() en dplyr voor empirische marges maken deze berekeningen toegankelijk. Voor data die in een database staat, berekent de SQL-clausule GROUP BY empirische marges efficiënt uit grote datasets.
Voordat je de relatie tussen variabelen kunt begrijpen, voorwaardelijk bewijs kunt beoordelen of Bayesiaanse modellen kunt bouwen, moet je de onvoorwaardelijke kans van individuele gebeurtenissen beheersen. Het is de basislijn die alles anders interpreteerbaar maakt.
Wanneer je marges verkeerd begrijpt, ben je vatbaar voor analytische fouten: basispercentages verwarren met voorwaardelijke kansen, ten prooi vallen aan de base rate fallacy, of modellen bouwen die niet beter presteren dan naïeve baselines. Als je marges goed begrijpt, zie je hoe voorwaardelijke kans ze verfijnt, hoe de stelling van Bayes ze met bewijs bijwerkt en hoe machine learning-modellen leren van de patronen die ze onthullen.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

