Bir e-ticaret platformunda müşteri davranışını analiz ediyorsunuz ve yöneticiniz soruyor: "Sebebi ne olursa olsun, bir müşterinin ayrılma olasılığı nedir?"
Bu soru, düşündüğünüzden daha spesifik bir şeye işaret eder. Belirli bir ürün kategorisine bağlı olarak ayrılmayı ya da ödeme yöntemiyle birlikte ayrılmayı sormuyorsunuz. Tek bir olayın temel (koşulsuz) olasılığını soruyorsunuz: müşteri ayrılması, nokta.
İşte bu marjinal olasılıktır ve veri biliminde karşılaşacağınız çoğu olasılık hesabının temelini oluşturur.
Marjinal Olasılık Nedir?
Girişte belirttiğim gibi, marjinal olasılık, diğer değişkenler veya olaylardan bağımsız olarak tek bir olayın gerçekleşme olasılığıdır. "Marjinal" olarak adlandırılır çünkü ortak olasılıkları bir tabloda yazdığınızda, bu tek olay olasılıkları kenarlarda (satır ve sütun toplamlarında) görünür.
Gösterim basittir. Ayrık bir A olayı için P(A) yazarız. Marjinal olasılık genellikle ortak olasılıktan türetilir. B ayrık bir rastgele değişken olsun ve A'nın B'nin her bir değeriyle birlikte gerçekleşme ortak olasılığını biliyor olun; marjinal olasılığı toplayarak bulabilirsiniz: P(A) = Σb P(A, B=b); burada B'nin alabileceği tüm olası b değerleri üzerinden toplarsınız. Marjinal olasılık, diğer tüm değişkenleri "topladığınızda" veya "integral aldığınızda" geriye kalandır.
Bu kavramı tam olarak anlamak için bazı temel terimlere ihtiyacınız olacak. Örnek uzayı, tüm olası sonuçların kümesidir. Bir olay, örnek uzayın herhangi bir alt kümesidir. Ortak olasılık P(A ∩ B), iki olayın birlikte gerçekleşme olasılığını ölçerken, koşullu olasılık P(A|B), B'nin gerçekleştiği verildiğinde A'nın olasılığını ölçer.
Bu ilişkiler için hızlı bir başvuru olarak r Olasılık Kurallarına Giriş Hızlı Başvuru Kağıdı'mıza göz atmanızı öneririm. Marjinal olasılık, bu olasılık ekosisteminin merkezinde yer alır. Koşullu olasılık hesaplamalarında paydadır ve Bayes Teoremi'nin yapı taşıdır.
Tablolardan ve Dağılımlardan Marjinal Olasılık
Farklı veri yapılarından marjinal olasılığı gerçekte nasıl hesapladığınıza bakalım. Yaklaşım, ayrık veya sürekli değişkenlerle çalışmanıza bağlıdır.
Ayrık durum (kontenjans tabloları)
Kategorik verilerle çalışırken, marjinal olasılıklar kendiliğinden kontenjans tablolarında ortaya çıkar. Ürün kategorileri (Elektronik, Giyim, Kitaplar) ve bölgeler (Kuzey, Güney, Doğu, Batı) bazında müşteri satın alma davranışını analiz ettiğinizi varsayın. Her hücre bir kategori-bölge kombinasyonunun ortak olasılığını içerir. Satır toplamları, her ürün kategorisi için (P(Elektronik), P(Giyim), P(Kitaplar)) bölgeden bağımsız marjinal olasılığı verir. Sütun toplamları her bölge için marjinal olasılıkları verir.
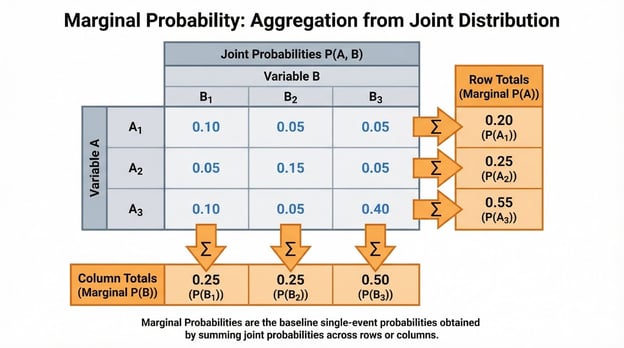
Marjinal olasılıkları bulmak için ortak olasılıkların toplanması. Görsel: Yazar.
Bunları çoğu zaman normalize edilmiş frekanslar olarak görürsünüz. 2.000 müşterinin 500'ü elektronik satın aldıysa, marjinal olasılık P(Elektronik) = 500/2.000 = 0,25'tir. Bu, diğer faktörler dikkate alınmadan önceki temel orandır. Keşifsel veri analizi yaparken, önce bu marjinalleri hesaplamanızı öneririm. Koşullu ilişkilere dalmadan önce verinizin temel yapısını anlamanıza yardımcı olurlar.
Sürekli durum
Sürekli rastgele değişkenler için marjinal olasılık, marjinal olasılık yoğunluk fonksiyonuna (PDF) dönüşür. X ve Y olmak üzere iki sürekli değişkenin ortak PDF'si varsa, X'in marjinal PDF'si Y'nin tüm değerleri üzerindeki integralle bulunur.
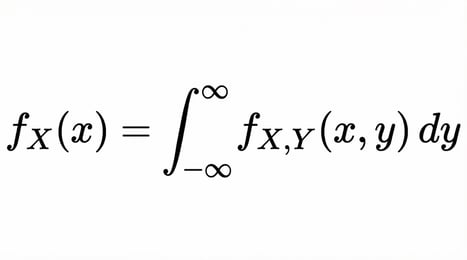
Kavramsal olarak, burada integral alma, ayrık durumda toplamaya denk işi yapar. Ortak dağılımı, diğer değişkenin tüm olasılıklarını hesaba katarak tek bir boyuta "sıkıştırır".
Bunu, 3B bir yüzeyin (ortak dağılımın) içinden bir dilim almak ve bir eksen boyunca eğrinin altındaki alana bakmak gibi düşünün. R ile Bayesçi Veri Analizinin Temelleri kursumuz, sürekli dağılımlarla çalışırken bu kavramları derinlemesine ele alır.
Marjinal, Ortak ve Koşullu Olasılık Arasındaki İlişki
Marjinal olasılığın düzenli olarak çalışacağınız diğer olasılık türleriyle nasıl bağlandığını inceleyelim.
Bu üç olasılık türü bağlantılı bir sistem oluşturur ve marjinal olasılık çoğu zaman onları bir arada tutan yapıştırıcıdır. Ortak olasılıktan, toplayarak veya integral alarak marjinalleri elde edersiniz. Ortak ve marjinal olasılıklardan ise koşulluları P(A|B) = P(A ∩ B) / P(B) kullanarak hesaplarsınız. Dikkat edin, marjinal olasılık P(B) paydadır. Ortak olasılığı normalize ederek size koşullu olasılığı verir.
Bu, uygulamada önemlidir çünkü koşullu olasılıkları yorumlarken, bağlam olarak marjinale ihtiyacınız vardır. Pozitif test sonucuna verilen %90 hastalık olasılığı ürkütücü gelebilir, ancak hastalığın marjinal olasılığı yalnızca %1 ise, pozitif testten sonraki gerçek olasılık beklediğinizden çok daha düşük olabilir.
Bu durum Bayesçi çıkarımın her yerinde karşımıza çıkar. Önsel, herhangi bir veri görmeden önce bir parametre hakkındaki inancınızdır. Marjinal olabilirlik (kanıt olarak da adlandırılır), P(Veri), Bayes teoremindeki, “önsel × olabilirlik” ifadesini uygun bir art al (posterior) olasılığına dönüştüren normalize etme terimidir. Python ile Bayesçi Veri Analizi kursumuz bu bağlantıları pratik modelleme egzersizleriyle inceler.
Marjinal Olasılığa İlişkin Çözümlü Örnekler
Hem klasik olasılık problemlerini hem de gerçek dünya senaryolarını birlikte ele alalım.
Klasik örnekler
Zarlarla başlayalım. İki zar attığınızda, ilk zarın değeri, ikinci zarın değerinden bağımsız olarak 4 gelme olasılığı nedir?
Örnek uzayında eş olasılıklı 36 sonuç vardır. Bunlardan altısında ilk zar 4'tür: (4,1), (4,2), (4,3), (4,4), (4,5), (4,6). Dolayısıyla P(İlk zar = 4) = 6/36 = 1/6. İkinci zarla ilgili hiçbir şarta başvurmadığımıza dikkat edin. Sadece ilk zarın 4 olduğu tüm sonuçları saydık.
Bir başka klasik örnek: Standart 52 kartlık bir desteden, rütbeden bağımsız olarak kupa çekme olasılığı nedir? 13 kupa ve toplam 52 kart vardır, bu nedenle P(Kupa) = 13/52 = 1/4. Bu marjinal olasılık, tüm rütbeler (As'tan Papaz'a) üzerinden toplanarak, size renğin koşulsuz olasılığını verir.
Gerçek dünya örnekleri
Tıbbi tarama çarpıcı bir gerçek dünya uygulaması sunar. Bir popülasyonda hastalık prevalansını analiz ettiğinizi varsayın. Marjinal olasılık P(Hastalık), herhangi bir tanı testi sonucunu dikkate almadan önceki temel hastalık oranını temsil eder. Nüfusun %2'sinde hastalık varsa, P(Hastalık) = 0,02. Bu marjinal olasılık, test doğruluğunu yorumlamak için esastır. Duyarlılığı %95 olan bir test, hastalık nadir olduğunda yine de çok sayıda yanlış pozitif üretir.
Dijital pazarlamada, şu soruyu sorabilirsiniz: Trafik kaynağından bağımsız olarak bir kullanıcının dönüşüm yapma olasılığı nedir? Organik arama, ücretli reklamlar, sosyal medya ve e-postadan gelen dönüşümler hakkında veriniz varsa, marjinal olasılık P(Dönüşüm) tüm kaynaklar üzerinden toplanır. Bu temel dönüşüm oranı, belirli trafik kaynaklarının ortalamanın üzerinde mi yoksa altında mı performans gösterdiğini değerlendirmenize yardımcı olur.
Benzer şekilde, finansta, faiz oranı seviyelerinden bağımsız olarak piyasa gerilemesi marjinal olasılığını hesaplayabilirsiniz. Bu, makroekonomik faktörleri eklemeden önce koşulsuz riski verir.
Veri Bilimi ve Makine Öğreniminde Marjinal Olasılık
Marjinal olasılığın veri bilimi iş akışının her yerinde nasıl karşımıza çıktığını inceleyelim.
Keşifsel veri analizi (EDA)
Bir veri kümesiyle ilk karşılaştığınızda, marjinal olasılıkları hesaplamak temel olay oranlarını anlamanıza yardımcı olur. Bir sahtekârlık tespit veri kümesinde, P(Dolandırıcılık), herhangi bir özelliği incelemeden önce sınıf dengesini gösterir. Bu, işlemlerin yalnızca %0,1'inde dolandırıcılık olduğu ciddi şekilde dengesiz bir problemle uğraşıp uğraşmadığınızı hemen ortaya koyar.
Tekil özellikler için marjinal dağılımlar da analizinizde yol gösterir. Müşteri ayrılmasını tahmin eden bir model oluşturuyorsanız, P(Ayrılma), P(Yüksek değerli müşteri) ve P(Yakın zamanda etkinlik) dağılımlarını ayrı ayrı incelemenizi öneririm. Bu, ortak ilişkilerini keşfetmeden önce bağlam sağlar.
Öngörücü modelleme
Naive Bayes sınıflandırıcıları, sınıf önselleri olarak açıkça marjinal olasılıklara dayanır. Bir belgeyi spam ya da spam değil olarak sınıflandırırken, P(Spam), belgede herhangi bir kelime görmeden önceki önsel inancınızdır. Algoritma daha sonra bu marjinal olasılığı koşullu özellik olasılıklarına göre günceller.
Özellik mühendisliği ve model tanılamada özelliklerin marjinal dağılımları da önemlidir. Bir özelliğin marjinal dağılımı aşırı çarpıksa, daha simetrik hale getirmek için log ölçekleme veya Box-Cox gibi dönüşümler uygulayabilirsiniz.
Veri kümeleri arasındaki kaymalar da aynı derecede önemlidir. Örneğin, eğitim kümenizde P(Sınıf A)=0,9 iken test kümenizde P(Sınıf A)=0,5 ise, tahmin edilen olasılıklarınız ve performans metrikleriniz büyük ölçüde değişebilir ve farklı bir karar eşiğine ihtiyaç duyabilirsiniz. Bunun nedeni, modelin bir temel oranda öğrenip başka bir oranda değerlendiriliyor olmasıdır.
Eğitimden önce marjinal dağılımları kontrol etmek, bu sorunları erken fark etmenize ve yeniden örnekleme, farklı değerlendirme metrikleri, yeniden kalibrasyon veya farklı veri segmentleri için ayrı modeller gerekip gerekmediğine karar vermenize yardımcı olur.
Risk ve karar verme
Beklenen değer hesaplamaları marjinal olasılıkları gerektirir. Bir ürünü piyasaya sürüp sürmeme kararı veriyorsanız, tüm olası piyasa koşulları geneline göre başarının marjinal olasılığı olan P(Başarı)'ya ihtiyacınız vardır. Bunu başarının getirisiyle çarpın, P(Başarısızlık) ile başarısızlığın maliyeti çarpımını ekleyin ve beklenen değeri elde edin.
Olasılıksal modelleme
Bayesçi ağlar ve grafiksel modellerde düğümler, koşullu olasılık dağılımlarına sahip değişkenleri temsil eder. Marjinal dağılımlar, ağ yapısı boyunca olasılıkları yayarak ya da kanıt gözleyip inançları güncelleyerek çıkarım yoluyla elde edilir. Markov Zinciri Monte Carlo gibi örnekleme yöntemleri, tam hesaplama olanaksız hale geldiğinde bu marjinalleri yaklaşıklamak için kullanılır. RJAGS ile Bayesçi Modelle me kursumuz bu yöntemleri uygulamalı olarak gösterir.
Marjinal Olasılık Hakkında Yanlış Bilinenler
İşte deneyimli uygulayıcıların bile tökezlediği hatalar.
Marjinal ile koşullu olasılığın karıştırılması
Muhtemelen en yaygın hatadır ve şaşırtıcı derecede sezgiseldir. %95 duyarlılık ve %90 özgüllüğe sahip bir tıbbi test yaptığınızı hayal edin. Sonucunuz pozitif. Çoğu insan hemen şöyle düşünür: "Test vakaların %95'ini yakalıyor, o halde muhtemelen hastayım."
Ancak bu akıl yürütme kritik bir bilgiyi atlar: Hastalık başta ne kadar yaygın? Eğer insanların sadece %1'inde varsa (marjinal olasılık), 10.000 kişiyi test ettiğinizde yaklaşık 95 gerçek pozitif ama 990 yanlış pozitif elde edersiniz. Bu da pozitif sonuçların çoğunun yanlış alarm olduğu anlamına gelir. Pozitif çıktıktan sonraki gerçek olasılığınız yaklaşık %9'dur, %95 değil.
Kafa karışıklığı, insanlar testin duyarlılığına (%95) odaklanıp temel oranı (%1 yaygınlık) unutunca oluşur. Marjinal olasılık P(Hastalık) = 0,01 ile koşullu olasılık P(Hastalık | Pozitif test) = 0,09 tamamen farklı niceliklerdir, ancak sezgimiz bunları aynıymış gibi ele almak ister.
Koşulluları yorumlarken marjinalleri yok saymak
İnsanlar marjinal ile koşullu olasılığı doğru şekilde ayırdıklarında bile, koşulluları yorumlarken marjinali göz ardı ederler. Şöyle bir haber başlığı görebilirsiniz: "Araştırma, başarılı girişimcilerin %80'inin 30 yaşından önce başladığını buldu." Bu, P(Başarılı girişimci | 30'dan önce başladı) = 0,8 değil; tam tersi P(30'dan önce başladı | Başarılı girişimci) = 0,8'dir. Ancak tüm girişimciler için P(30'dan önce başladı) bilinmeden, genç başlamanın başarıyı gerçekten öngörüp öngörmediğini değerlendiremezsiniz.
Bu, hatalı karar vermeye yol açar. Tüm girişimcilerin %90'ı 30'dan önce başlıyorsa, başarılı girişimciler olağan dışı bir oranda genç başlamıyor demektir. Sadece genel deseni takip ediyorlar. Marjinal temel oranla karşılaştırma olmadan koşullu olasılığın anlamı azdır.
Temel oran yanılgısı
Temel oran yanılgısı, insanların koşullu kanıtlara aşırı ağırlık verip marjinal olasılıkları (temel oranları) görmezden geldiğinde ortaya çıkar.
Yaygın bir veri bilimi örneği: Dengesiz bir veri kümesinde ikili bir sınıflandırıcı oluşturuyorsunuz. Pozitif sınıf (tahmin etmeye çalıştığınız şey) verinizin sadece %5'inde görülüyor. Bir model kuruyorsunuz ve %95 doğruluk elde ediyorsunuz. Kulağa harika geliyor, değil mi?
Pek değil. Her seferinde sadece negatif sınıfı tahmin eden "aptal" bir model de %95 doğruluk alır (çünkü verinin %95'i negatiftir). Süslü modeliniz, her zaman "hayır" demekten pek de iyi değildir.
Hata, %95 doğruluk sayısına, temel oranı (%5 pozitif sınıf) dikkate almadan bakmaktır. Sınıflar dengesiz olduğunda doğruluk yanıltıcı bir metriktir. Modelinizin gerçekten faydalı bir şey öğrenip öğrenmediğini görmek için kesinlik, duyarlılık veya F1-skorunu kontrol etmeniz gerekir.
Marjinalleri anlamak, dengesiz problemler için doğru değerlendirme metriklerini seçmenize yardımcı olur.
İleri Konular ve Uzantılar
Düzinelerce veya yüzlerce değişkenli yüksek boyutlu modellerde, marjinal dağılımları tam olarak hesaplamak çoğu zaman imkânsızdır. Olası kombinasyonların sayısı hızla artar ve gerekli toplamlar veya integraller hesaplanamaz hâle gelir.
Bunu aşmak için uygulayıcılar yaklaşık çıkarım yöntemleri kullanır:
- Örnekleme yöntemleri (Markov Zinciri Monte Carlo, MCMC gibi) modelin dağılımından çok sayıda örnek üretir. Daha sonra bu örneklerde olayların ne sıklıkta meydana geldiğine bakarak marjinal olasılıkları tahmin edebilirsiniz.
- Varyasyonel çıkarım farklı bir yaklaşım benimser: Hesaplanması zor bir dağılımı daha basit biriyle değiştirir ve onu mümkün olduğunca yakın olacak şekilde optimize eder; bu da büyük modellerde marjinal tahminleri sıklıkla daha hızlı kılar.
Python'da olasılık dağılımları için scipy.stats, kontenjans tabloları için pandas ve R'da ampirik marjinaller için table() ile dplyr gibi modern araçlar bu hesaplamaları erişilebilir kılar. Veritabanında saklanan veriler için SQL'in GROUP BY ifadesi, büyük veri kümelerinden ampirik marjinalleri verimli şekilde hesaplar.
Sonuç
Değişkenler arasındaki ilişkiyi anlamadan, koşullu kanıtı değerlendirmeden veya Bayesçi modeller kurmadan önce, tekil olayların koşulsuz olasılığını kavramalısınız. Her şeyi yorumlanabilir kılan temel budur.
Marjinalleri yanlış anladığınızda, analitik hatalara açık hâle gelirsiniz: temel oranları koşullu olasılıklarla karıştırmak, temel oran yanılgısına düşmek veya naif temel oranları aşmayan modeller kurmak gibi. Marjinalleri doğru anlayın; o zaman koşullu olasılığın onları nasıl rafine ettiğini, Bayes Teoremi'nin kanıtla nasıl güncellediğini ve makine öğrenimi modellerinin ortaya çıkardıkları desenlerden nasıl öğrendiğini kavrarsınız.






Bir e-ticaret platformunda müşteri davranışını analiz ediyorsunuz ve yöneticiniz soruyor: "Sebebi ne olursa olsun, bir müşterinin ayrılma olasılığı nedir?"
Bu soru, düşündüğünüzden daha spesifik bir şeye işaret eder. Belirli bir ürün kategorisine bağlı olarak ayrılmayı ya da ödeme yöntemiyle birlikte ayrılmayı sormuyorsunuz. Tek bir olayın temel (koşulsuz) olasılığını soruyorsunuz: müşteri ayrılması, nokta.
İşte bu marjinal olasılıktır ve veri biliminde karşılaşacağınız çoğu olasılık hesabının temelini oluşturur.
Marjinal Olasılık Nedir?
Girişte belirttiğim gibi, marjinal olasılık, diğer değişkenler veya olaylardan bağımsız olarak tek bir olayın gerçekleşme olasılığıdır. "Marjinal" olarak adlandırılır çünkü ortak olasılıkları bir tabloda yazdığınızda, bu tek olay olasılıkları kenarlarda (satır ve sütun toplamlarında) görünür.
Gösterim basittir. Ayrık bir A olayı için P(A) yazarız. Marjinal olasılık genellikle ortak olasılıktan türetilir. B ayrık bir rastgele değişken olsun ve A'nın B'nin her bir değeriyle birlikte gerçekleşme ortak olasılığını biliyor olun; marjinal olasılığı toplayarak bulabilirsiniz: P(A) = Σb P(A, B=b); burada B'nin alabileceği tüm olası b değerleri üzerinden toplarsınız. Marjinal olasılık, diğer tüm değişkenleri "topladığınızda" veya "integral aldığınızda" geriye kalandır.
Bu kavramı tam olarak anlamak için bazı temel terimlere ihtiyacınız olacak. Örnek uzayı, tüm olası sonuçların kümesidir. Bir olay, örnek uzayın herhangi bir alt kümesidir. Ortak olasılık P(A ∩ B), iki olayın birlikte gerçekleşme olasılığını ölçerken, koşullu olasılık P(A|B), B'nin gerçekleştiği verildiğinde A'nın olasılığını ölçer.
Bu ilişkiler için hızlı bir başvuru olarak r Olasılık Kurallarına Giriş Hızlı Başvuru Kağıdı'mıza göz atmanızı öneririm. Marjinal olasılık, bu olasılık ekosisteminin merkezinde yer alır. Koşullu olasılık hesaplamalarında paydadır ve Bayes Teoremi'nin yapı taşıdır.
Tablolardan ve Dağılımlardan Marjinal Olasılık
Farklı veri yapılarından marjinal olasılığı gerçekte nasıl hesapladığınıza bakalım. Yaklaşım, ayrık veya sürekli değişkenlerle çalışmanıza bağlıdır.
Ayrık durum (kontenjans tabloları)
Kategorik verilerle çalışırken, marjinal olasılıklar kendiliğinden kontenjans tablolarında ortaya çıkar. Ürün kategorileri (Elektronik, Giyim, Kitaplar) ve bölgeler (Kuzey, Güney, Doğu, Batı) bazında müşteri satın alma davranışını analiz ettiğinizi varsayın. Her hücre bir kategori-bölge kombinasyonunun ortak olasılığını içerir. Satır toplamları, her ürün kategorisi için (P(Elektronik), P(Giyim), P(Kitaplar)) bölgeden bağımsız marjinal olasılığı verir. Sütun toplamları her bölge için marjinal olasılıkları verir.
Marjinal olasılıkları bulmak için ortak olasılıkların toplanması. Görsel: Yazar.
Bunları çoğu zaman normalize edilmiş frekanslar olarak görürsünüz. 2.000 müşterinin 500'ü elektronik satın aldıysa, marjinal olasılık P(Elektronik) = 500/2.000 = 0,25'tir. Bu, diğer faktörler dikkate alınmadan önceki temel orandır. Keşifsel veri analizi yaparken, önce bu marjinalleri hesaplamanızı öneririm. Koşullu ilişkilere dalmadan önce verinizin temel yapısını anlamanıza yardımcı olurlar.
Sürekli durum
Sürekli rastgele değişkenler için marjinal olasılık, marjinal olasılık yoğunluk fonksiyonuna (PDF) dönüşür. X ve Y olmak üzere iki sürekli değişkenin ortak PDF'si varsa, X'in marjinal PDF'si Y'nin tüm değerleri üzerindeki integralle bulunur.
Kavramsal olarak, burada integral alma, ayrık durumda toplamaya denk işi yapar. Ortak dağılımı, diğer değişkenin tüm olasılıklarını hesaba katarak tek bir boyuta "sıkıştırır".
Bunu, 3B bir yüzeyin (ortak dağılımın) içinden bir dilim almak ve bir eksen boyunca eğrinin altındaki alana bakmak gibi düşünün. R ile Bayesçi Veri Analizinin Temelleri kursumuz, sürekli dağılımlarla çalışırken bu kavramları derinlemesine ele alır.
Marjinal, Ortak ve Koşullu Olasılık Arasındaki İlişki
Marjinal olasılığın düzenli olarak çalışacağınız diğer olasılık türleriyle nasıl bağlandığını inceleyelim.
Bu üç olasılık türü bağlantılı bir sistem oluşturur ve marjinal olasılık çoğu zaman onları bir arada tutan yapıştırıcıdır. Ortak olasılıktan, toplayarak veya integral alarak marjinalleri elde edersiniz. Ortak ve marjinal olasılıklardan ise koşulluları P(A|B) = P(A ∩ B) / P(B) kullanarak hesaplarsınız. Dikkat edin, marjinal olasılık P(B) paydadır. Ortak olasılığı normalize ederek size koşullu olasılığı verir.
Bu, uygulamada önemlidir çünkü koşullu olasılıkları yorumlarken, bağlam olarak marjinale ihtiyacınız vardır. Pozitif test sonucuna verilen %90 hastalık olasılığı ürkütücü gelebilir, ancak hastalığın marjinal olasılığı yalnızca %1 ise, pozitif testten sonraki gerçek olasılık beklediğinizden çok daha düşük olabilir.
Bu durum Bayesçi çıkarımın her yerinde karşımıza çıkar. Önsel, herhangi bir veri görmeden önce bir parametre hakkındaki inancınızdır. Marjinal olabilirlik (kanıt olarak da adlandırılır), P(Veri), Bayes teoremindeki, “önsel × olabilirlik” ifadesini uygun bir art al (posterior) olasılığına dönüştüren normalize etme terimidir. Python ile Bayesçi Veri Analizi kursumuz bu bağlantıları pratik modelleme egzersizleriyle inceler.
Marjinal Olasılığa İlişkin Çözümlü Örnekler
Hem klasik olasılık problemlerini hem de gerçek dünya senaryolarını birlikte ele alalım.
Klasik örnekler
Zarlarla başlayalım. İki zar attığınızda, ilk zarın değeri, ikinci zarın değerinden bağımsız olarak 4 gelme olasılığı nedir?
Örnek uzayında eş olasılıklı 36 sonuç vardır. Bunlardan altısında ilk zar 4'tür: (4,1), (4,2), (4,3), (4,4), (4,5), (4,6). Dolayısıyla P(İlk zar = 4) = 6/36 = 1/6. İkinci zarla ilgili hiçbir şarta başvurmadığımıza dikkat edin. Sadece ilk zarın 4 olduğu tüm sonuçları saydık.
Bir başka klasik örnek: Standart 52 kartlık bir desteden, rütbeden bağımsız olarak kupa çekme olasılığı nedir? 13 kupa ve toplam 52 kart vardır, bu nedenle P(Kupa) = 13/52 = 1/4. Bu marjinal olasılık, tüm rütbeler (As'tan Papaz'a) üzerinden toplanarak, size renğin koşulsuz olasılığını verir.
Gerçek dünya örnekleri
Tıbbi tarama çarpıcı bir gerçek dünya uygulaması sunar. Bir popülasyonda hastalık prevalansını analiz ettiğinizi varsayın. Marjinal olasılık P(Hastalık), herhangi bir tanı testi sonucunu dikkate almadan önceki temel hastalık oranını temsil eder. Nüfusun %2'sinde hastalık varsa, P(Hastalık) = 0,02. Bu marjinal olasılık, test doğruluğunu yorumlamak için esastır. Duyarlılığı %95 olan bir test, hastalık nadir olduğunda yine de çok sayıda yanlış pozitif üretir.
Dijital pazarlamada, şu soruyu sorabilirsiniz: Trafik kaynağından bağımsız olarak bir kullanıcının dönüşüm yapma olasılığı nedir? Organik arama, ücretli reklamlar, sosyal medya ve e-postadan gelen dönüşümler hakkında veriniz varsa, marjinal olasılık P(Dönüşüm) tüm kaynaklar üzerinden toplanır. Bu temel dönüşüm oranı, belirli trafik kaynaklarının ortalamanın üzerinde mi yoksa altında mı performans gösterdiğini değerlendirmenize yardımcı olur.
Benzer şekilde, finansta, faiz oranı seviyelerinden bağımsız olarak piyasa gerilemesi marjinal olasılığını hesaplayabilirsiniz. Bu, makroekonomik faktörleri eklemeden önce koşulsuz riski verir.
Veri Bilimi ve Makine Öğreniminde Marjinal Olasılık
Marjinal olasılığın veri bilimi iş akışının her yerinde nasıl karşımıza çıktığını inceleyelim.
Keşifsel veri analizi (EDA)
Bir veri kümesiyle ilk karşılaştığınızda, marjinal olasılıkları hesaplamak temel olay oranlarını anlamanıza yardımcı olur. Bir sahtekârlık tespit veri kümesinde, P(Dolandırıcılık), herhangi bir özelliği incelemeden önce sınıf dengesini gösterir. Bu, işlemlerin yalnızca %0,1'inde dolandırıcılık olduğu ciddi şekilde dengesiz bir problemle uğraşıp uğraşmadığınızı hemen ortaya koyar.
Tekil özellikler için marjinal dağılımlar da analizinizde yol gösterir. Müşteri ayrılmasını tahmin eden bir model oluşturuyorsanız, P(Ayrılma), P(Yüksek değerli müşteri) ve P(Yakın zamanda etkinlik) dağılımlarını ayrı ayrı incelemenizi öneririm. Bu, ortak ilişkilerini keşfetmeden önce bağlam sağlar.
Öngörücü modelleme
Naive Bayes sınıflandırıcıları, sınıf önselleri olarak açıkça marjinal olasılıklara dayanır. Bir belgeyi spam ya da spam değil olarak sınıflandırırken, P(Spam), belgede herhangi bir kelime görmeden önceki önsel inancınızdır. Algoritma daha sonra bu marjinal olasılığı koşullu özellik olasılıklarına göre günceller.
Özellik mühendisliği ve model tanılamada özelliklerin marjinal dağılımları da önemlidir. Bir özelliğin marjinal dağılımı aşırı çarpıksa, daha simetrik hale getirmek için log ölçekleme veya Box-Cox gibi dönüşümler uygulayabilirsiniz.
Veri kümeleri arasındaki kaymalar da aynı derecede önemlidir. Örneğin, eğitim kümenizde P(Sınıf A)=0,9 iken test kümenizde P(Sınıf A)=0,5 ise, tahmin edilen olasılıklarınız ve performans metrikleriniz büyük ölçüde değişebilir ve farklı bir karar eşiğine ihtiyaç duyabilirsiniz. Bunun nedeni, modelin bir temel oranda öğrenip başka bir oranda değerlendiriliyor olmasıdır.
Eğitimden önce marjinal dağılımları kontrol etmek, bu sorunları erken fark etmenize ve yeniden örnekleme, farklı değerlendirme metrikleri, yeniden kalibrasyon veya farklı veri segmentleri için ayrı modeller gerekip gerekmediğine karar vermenize yardımcı olur.
Risk ve karar verme
Beklenen değer hesaplamaları marjinal olasılıkları gerektirir. Bir ürünü piyasaya sürüp sürmeme kararı veriyorsanız, tüm olası piyasa koşulları geneline göre başarının marjinal olasılığı olan P(Başarı)'ya ihtiyacınız vardır. Bunu başarının getirisiyle çarpın, P(Başarısızlık) ile başarısızlığın maliyeti çarpımını ekleyin ve beklenen değeri elde edin.
Olasılıksal modelleme
Bayesçi ağlar ve grafiksel modellerde düğümler, koşullu olasılık dağılımlarına sahip değişkenleri temsil eder. Marjinal dağılımlar, ağ yapısı boyunca olasılıkları yayarak ya da kanıt gözleyip inançları güncelleyerek çıkarım yoluyla elde edilir. Markov Zinciri Monte Carlo gibi örnekleme yöntemleri, tam hesaplama olanaksız hale geldiğinde bu marjinalleri yaklaşıklamak için kullanılır. RJAGS ile Bayesçi Modelle me kursumuz bu yöntemleri uygulamalı olarak gösterir.
Marjinal Olasılık Hakkında Yanlış Bilinenler
İşte deneyimli uygulayıcıların bile tökezlediği hatalar.
Marjinal ile koşullu olasılığın karıştırılması
Muhtemelen en yaygın hatadır ve şaşırtıcı derecede sezgiseldir. %95 duyarlılık ve %90 özgüllüğe sahip bir tıbbi test yaptığınızı hayal edin. Sonucunuz pozitif. Çoğu insan hemen şöyle düşünür: "Test vakaların %95'ini yakalıyor, o halde muhtemelen hastayım."
Ancak bu akıl yürütme kritik bir bilgiyi atlar: Hastalık başta ne kadar yaygın? Eğer insanların sadece %1'inde varsa (marjinal olasılık), 10.000 kişiyi test ettiğinizde yaklaşık 95 gerçek pozitif ama 990 yanlış pozitif elde edersiniz. Bu da pozitif sonuçların çoğunun yanlış alarm olduğu anlamına gelir. Pozitif çıktıktan sonraki gerçek olasılığınız yaklaşık %9'dur, %95 değil.
Kafa karışıklığı, insanlar testin duyarlılığına (%95) odaklanıp temel oranı (%1 yaygınlık) unutunca oluşur. Marjinal olasılık P(Hastalık) = 0,01 ile koşullu olasılık P(Hastalık | Pozitif test) = 0,09 tamamen farklı niceliklerdir, ancak sezgimiz bunları aynıymış gibi ele almak ister.
Koşulluları yorumlarken marjinalleri yok saymak
İnsanlar marjinal ile koşullu olasılığı doğru şekilde ayırdıklarında bile, koşulluları yorumlarken marjinali göz ardı ederler. Şöyle bir haber başlığı görebilirsiniz: "Araştırma, başarılı girişimcilerin %80'inin 30 yaşından önce başladığını buldu." Bu, P(Başarılı girişimci | 30'dan önce başladı) = 0,8 değil; tam tersi P(30'dan önce başladı | Başarılı girişimci) = 0,8'dir. Ancak tüm girişimciler için P(30'dan önce başladı) bilinmeden, genç başlamanın başarıyı gerçekten öngörüp öngörmediğini değerlendiremezsiniz.
Bu, hatalı karar vermeye yol açar. Tüm girişimcilerin %90'ı 30'dan önce başlıyorsa, başarılı girişimciler olağan dışı bir oranda genç başlamıyor demektir. Sadece genel deseni takip ediyorlar. Marjinal temel oranla karşılaştırma olmadan koşullu olasılığın anlamı azdır.
Temel oran yanılgısı
Temel oran yanılgısı, insanların koşullu kanıtlara aşırı ağırlık verip marjinal olasılıkları (temel oranları) görmezden geldiğinde ortaya çıkar.
Yaygın bir veri bilimi örneği: Dengesiz bir veri kümesinde ikili bir sınıflandırıcı oluşturuyorsunuz. Pozitif sınıf (tahmin etmeye çalıştığınız şey) verinizin sadece %5'inde görülüyor. Bir model kuruyorsunuz ve %95 doğruluk elde ediyorsunuz. Kulağa harika geliyor, değil mi?
Pek değil. Her seferinde sadece negatif sınıfı tahmin eden "aptal" bir model de %95 doğruluk alır (çünkü verinin %95'i negatiftir). Süslü modeliniz, her zaman "hayır" demekten pek de iyi değildir.
Hata, %95 doğruluk sayısına, temel oranı (%5 pozitif sınıf) dikkate almadan bakmaktır. Sınıflar dengesiz olduğunda doğruluk yanıltıcı bir metriktir. Modelinizin gerçekten faydalı bir şey öğrenip öğrenmediğini görmek için kesinlik, duyarlılık veya F1-skorunu kontrol etmeniz gerekir.
Marjinalleri anlamak, dengesiz problemler için doğru değerlendirme metriklerini seçmenize yardımcı olur.
İleri Konular ve Uzantılar
Düzinelerce veya yüzlerce değişkenli yüksek boyutlu modellerde, marjinal dağılımları tam olarak hesaplamak çoğu zaman imkânsızdır. Olası kombinasyonların sayısı hızla artar ve gerekli toplamlar veya integraller hesaplanamaz hâle gelir.
Bunu aşmak için uygulayıcılar yaklaşık çıkarım yöntemleri kullanır:
Python'da olasılık dağılımları için
scipy.stats, kontenjans tabloları içinpandasve R'da ampirik marjinaller içintable()iledplyrgibi modern araçlar bu hesaplamaları erişilebilir kılar. Veritabanında saklanan veriler için SQL'inGROUP BYifadesi, büyük veri kümelerinden ampirik marjinalleri verimli şekilde hesaplar.Sonuç
Değişkenler arasındaki ilişkiyi anlamadan, koşullu kanıtı değerlendirmeden veya Bayesçi modeller kurmadan önce, tekil olayların koşulsuz olasılığını kavramalısınız. Her şeyi yorumlanabilir kılan temel budur.
Marjinalleri yanlış anladığınızda, analitik hatalara açık hâle gelirsiniz: temel oranları koşullu olasılıklarla karıştırmak, temel oran yanılgısına düşmek veya naif temel oranları aşmayan modeller kurmak gibi. Marjinalleri doğru anlayın; o zaman koşullu olasılığın onları nasıl rafine ettiğini, Bayes Teoremi'nin kanıtla nasıl güncellediğini ve makine öğrenimi modellerinin ortaya çıkardıkları desenlerden nasıl öğrendiğini kavrarsınız.