
कोर्स
Foundations of Probability in R
4 घंटा
42.8K
आप एक ई-कॉमर्स प्लेटफ़ॉर्म के लिए ग्राहक व्यवहार का विश्लेषण कर रहे हैं, और आपका प्रबंधक पूछता है: "किसी भी कारण की परवाह किए बिना, ग्राहक के चर्न करने की प्रायिकता क्या है?"
यह प्रश्न जितना लगता है उससे अधिक विशिष्ट है। आप किसी विशेष उत्पाद श्रेणी के दिए जाने पर चर्न के बारे में नहीं पूछ रहे, या भुगतान विधि के साथ संयोजन में चर्न के बारे में नहीं। आप एक एकल घटना की बुनियादी प्रायिकता पूछ रहे हैं: ग्राहक चर्न—बस।
यही मार्जिनल प्रायिकता है, और यह डेटा साइंस में मिलने वाली अधिकांश प्रायिकता गणनाओं की नींव है।
जैसा कि मैंने बताया, मार्जिनल प्रायिकता किसी एक घटना के घटित होने की प्रायिकता है, अन्य चर या घटनाओं से स्वतंत्र। इसे "मार्जिनल" इसलिए कहते हैं क्योंकि जब आप संयुक्त प्रायिकताओं को किसी तालिका में लिखते हैं, तो इन एकल-घटना प्रायिकताओं को मार्जिन (पंक्ति और स्तंभ योग) में दिखाया जाता है।
प्रतीक लेखन सीधा है। किसी विविक्त घटना A के लिए, हम P(A) लिखते हैं। मार्जिनल प्रायिकता प्राय: संयुक्त प्रायिकता से निकलती है। यदि B एक विविक्त यादृच्छिक चर है और आपको A के B के प्रत्येक मान के साथ घटित होने की संयुक्त प्रायिकता पता है, तो आप योग करके मार्जिनल प्रायिकता निकाल सकते हैं: P(A) = Σb P(A, B=b), जहाँ आप B के सभी संभव मान b पर योग करते हैं। मार्जिनल प्रायिकता वह है जो तब बचती है जब आप अन्य सभी चरों को "सम-अप" या "इंटीग्रेट-आउट" कर देते हैं।
इस अवधारणा को पूरी तरह समझने के लिए, कुछ आधारभूत शब्दावली चाहिए। सैंपल स्पेस सभी संभावित परिणामों का समूह है। घटना सैंपल स्पेस का कोई भी उपसमुच्चय होती है। संयुक्त प्रायिकता P(A ∩ B) दो घटनाओं के साथ-साथ घटित होने की संभावना मापती है, जबकि सशर्त प्रायिकता P(A|B) A की वह संभावना मापती है जबकि B घटित हो चुका हो।
मैं सुझाव दूंगा कि आप हमारे Introduction to Probability Rules Cheat Sheet को इन संबंधों के लिए एक त्वरित संदर्भ के रूप में देखें। मार्जिनल प्रायिकता इस प्रायिकता पारिस्थितिकी तंत्र के केंद्र में होती है। यह सशर्त प्रायिकता गणनाओं में हर (denominator) है और बेयेस प्रमेय के लिए बिल्डिंग ब्लॉक।
आइए देखें कि अलग-अलग डेटा संरचनाओं से वास्तव में मार्जिनल प्रायिकता कैसे निकालते हैं। तरीका इस बात पर निर्भर करता है कि आप विविक्त या सतत चरों के साथ काम कर रहे हैं।
श्रेणीय (categorical) डेटा के साथ काम करते समय, मार्जिनल प्रायिकताएँ स्वाभाविक रूप से कॉन्टिन्जेंसी टेबल में दिखती हैं। मान लें आप उत्पाद श्रेणियों (इलेक्ट्रॉनिक्स, कपड़े, किताबें) और क्षेत्रों (उत्तर, दक्षिण, पूर्व, पश्चिम) में ग्राहक खरीद व्यवहार का विश्लेषण कर रहे हैं। प्रत्येक सेल में श्रेणी-क्षेत्र संयोजन की संयुक्त प्रायिकता है। पंक्ति योग आपको प्रत्येक उत्पाद श्रेणी की मार्जिनल प्रायिकता (P(Electronics), P(Clothing), P(Books)) देता है, क्षेत्र की परवाह किए बिना। स्तंभ योग प्रत्येक क्षेत्र के लिए मार्जिनल प्रायिकताएँ देते हैं।
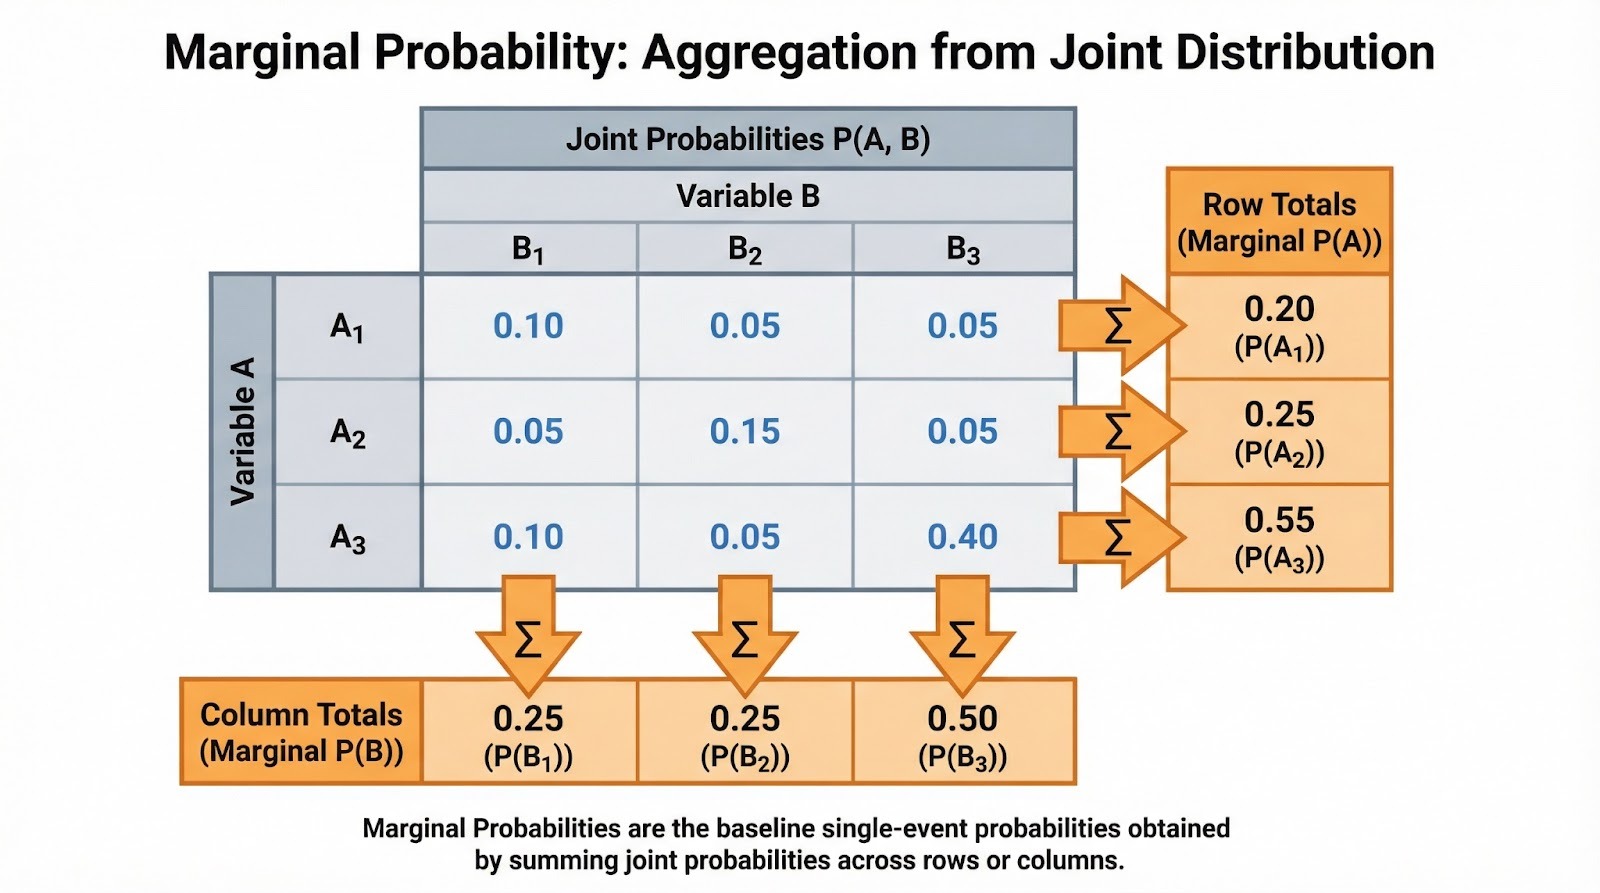
मार्जिनल प्रायिकताएँ पाने के लिए संयुक्त प्रायिकताओं का योग। छवि: लेखक द्वारा।
आप इन्हें अक्सर सामान्यीकृत आवृत्तियों के रूप में पाएंगे। यदि 2,000 में से 500 ग्राहकों ने इलेक्ट्रॉनिक्स खरीदे, तो मार्जिनल प्रायिकता P(Electronics) = 500/2,000 = 0.25। यह किसी अन्य कारक पर विचार करने से पहले की बुनियादी दर है। अन्वेषणात्मक डेटा विश्लेषण करते समय, मैं पहले इन मार्जिनल्स की गणना करने की सलाह दूंगा। ये आपको सशर्त संबंधों में जाने से पहले आपके डेटा की मूल संरचना समझने में मदद करते हैं।
सतत यादृच्छिक चरों के लिए, मार्जिनल प्रायिकता मार्जिनल प्रायिकता घनत्व फलन (PDF) बन जाती है। यदि आपके पास दो सतत चर X और Y का संयुक्त PDF है, तो X का मार्जिनल PDF Y के सभी मानों पर इंटीग्रेशन करके निकाला जाता है।
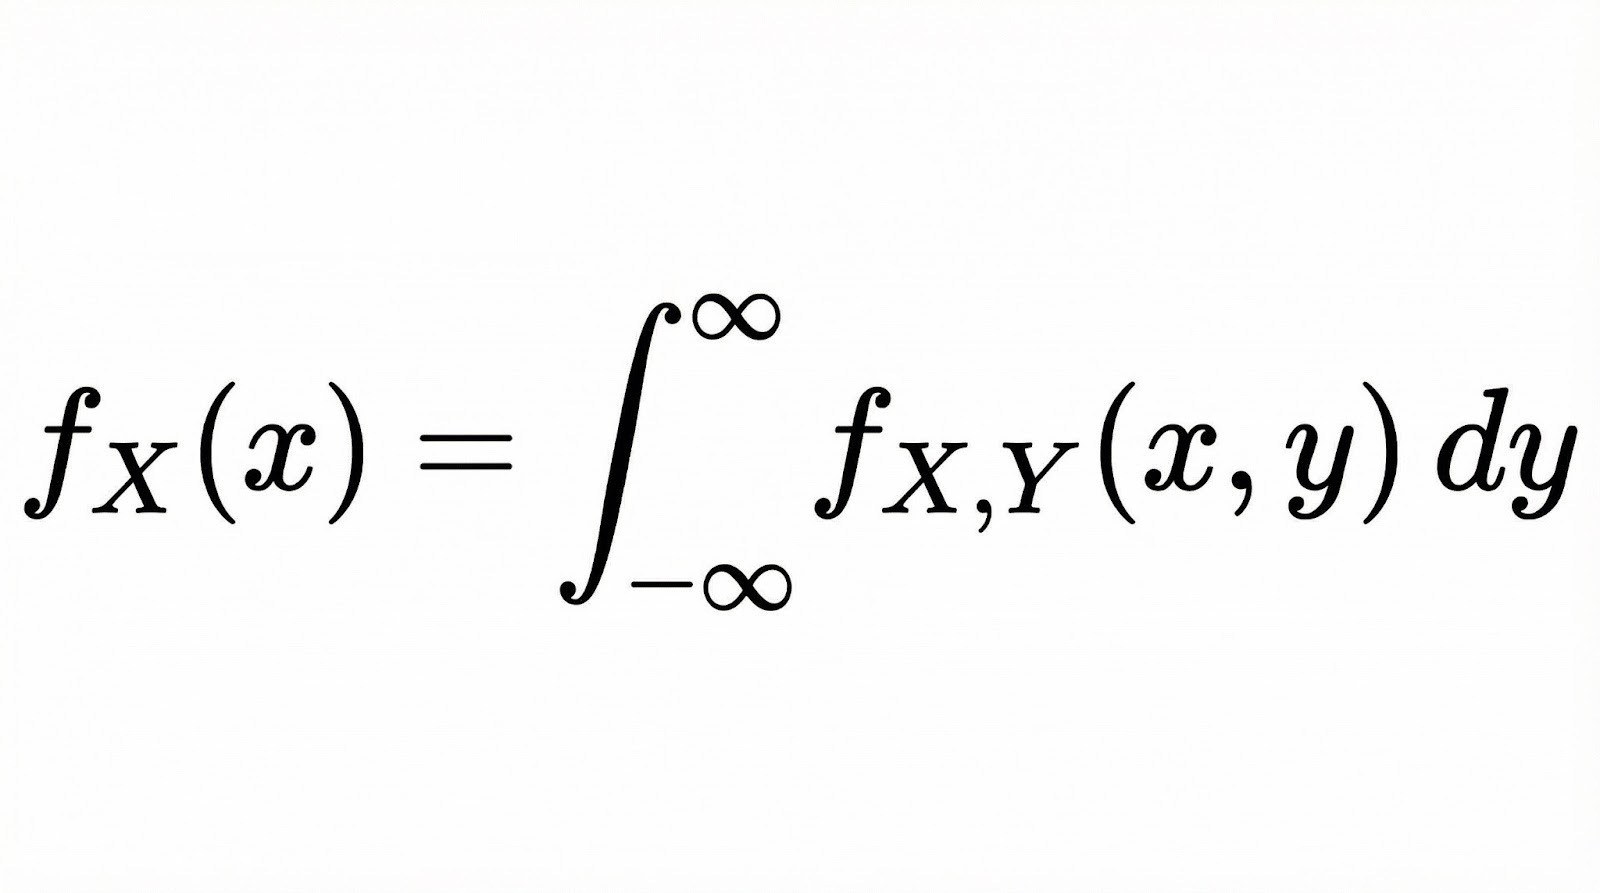
सैद्धांतिक रूप से, यहाँ इंटीग्रेशन वही करता है जो विविक्त केस में समेशन करता है। यह संयुक्त वितरण को दूसरे चर की सभी संभावनाओं का हिसाब रखते हुए एक आयाम में "समेट" देता है।
इसे ऐसे समझें कि आप 3D सतह (संयुक्त वितरण) को काटकर एक अक्ष के साथ वक्र के नीचे का क्षेत्र देख रहे हैं। हमारा Fundamentals of Bayesian Data Analysis in R कोर्स इन अवधारणाओं को सतत वितरणों के साथ काम करते समय विस्तार से कवर करता है।
आइए देखें कि मार्जिनल प्रायिकता उन अन्य प्रायिकता प्रकारों से कैसे जुड़ती है जिनके साथ आप नियमित रूप से काम करेंगे।
ये तीनों प्रकार एक जुड़े हुए तंत्र का निर्माण करते हैं, और मार्जिनल प्रायिकता अक्सर उन्हें जोड़े रखने वाला गोंद होती है। संयुक्त प्रायिकता से, आप योग या इंटीग्रेशन करके मार्जिनल्स पाते हैं। संयुक्त और मार्जिनल प्रायिकताओं से, आप P(A|B) = P(A ∩ B) / P(B) का उपयोग करके सशर्त प्रायिकताएँ निकालते हैं। ध्यान दें कि मार्जिनल प्रायिकता P(B) हर (denominator) है। यह संयुक्त प्रायिकता को सामान्यीकृत करके सशर्त देता है।
यह व्यवहार में इसलिए महत्वपूर्ण है क्योंकि जब आप सशर्त प्रायिकताओं की व्याख्या करते हैं, तो आपको संदर्भ के रूप में मार्जिनल चाहिए। सकारात्मक टेस्ट परिणामों पर 90% रोग प्रायिकता डरावनी लगती है, लेकिन यदि रोग की मार्जिनल प्रायिकता केवल 1% है, तो सकारात्मक टेस्ट के बाद वास्तविक प्रायिकता आपकी अपेक्षा से बहुत कम हो सकती है।
यह बेयेसियन इनफरेंस में हर जगह दिखता है। प्रायर वह विश्वास है जो आप किसी पैरामीटर के बारे में डेटा देखने से पहले रखते हैं। मार्जिनल लाइकलिहुड (जिसे एविडेंस भी कहते हैं), P(Data), बेयेस प्रमेय में सामान्यीकरण पद है जो "prior × likelihood" को एक ठीकठाक पोस्टीरियर प्रायिकता में बदलता है। हमारा Bayesian Data Analysis in Python कोर्स इन संबंधों को व्यावहारिक मॉडलिंग अभ्यासों के माध्यम से खोजता है।
आइए शास्त्रीय प्रायिकता समस्याओं और वास्तविक दुनिया के परिदृश्यों—दोनों—से गुजरते हैं।
पासों से शुरू करें। यदि आप दो पासे फेंकते हैं, तो पहले पासे पर 4 आने की प्रायिकता क्या है, दूसरे पासे के मान की परवाह किए बिना?
नमूना स्थान में 36 समान रूप से संभावित परिणाम हैं। इनमें से छह में पहले पासे पर 4 आता है: (4,1), (4,2), (4,3), (4,4), (4,5), (4,6)। अत: P(पहला पासा = 4) = 6/36 = 1/6। ध्यान दें कि हमने दूसरे पासे के बारे में किसी भी चीज़ पर सशर्त नहीं किया। हमने बस उन सभी परिणामों की गिनती की जहाँ पहला पासा 4 है।
एक और क्लासिक उदाहरण। 52 पत्तों की मानक ताश की गड्डी से निकालते समय, रैंक की परवाह किए बिना दिल (Heart) आने की प्रायिकता क्या है? 13 दिल और कुल 52 पत्ते हैं, तो P(Heart) = 13/52 = 1/4। यह मार्जिनल प्रायिकता सभी रैंक्स (Ace से King) पर समेकित करती है और आपको सूट की अनकंडीशंड प्रायिकता देती है।
चिकित्सीय स्क्रीनिंग एक प्रभावशाली वास्तविक-जीवन अनुप्रयोग देती है। मान लें आप किसी आबादी में रोग प्रसार का विश्लेषण कर रहे हैं। मार्जिनल प्रायिकता P(Disease) निदान परीक्षण परिणामों पर विचार करने से पहले की बुनियादी रोग दर दर्शाती है। यदि 2% आबादी को रोग है, तो P(Disease) = 0.02। यह मार्जिनल प्रायिकता टेस्ट की सटीकता की व्याख्या के लिए आवश्यक है। 95% सेंसिटिविटी वाला टेस्ट भी तब बहुत से फॉल्स पॉज़िटिव देता है जब रोग दुर्लभ हो।
डिजिटल मार्केटिंग में, आप पूछ सकते हैं: ट्रैफिक स्रोत की परवाह किए बिना उपयोगकर्ता के कन्वर्ट होने की प्रायिकता क्या है? यदि आपके पास ऑर्गेनिक सर्च, पेड ऐड्स, सोशल मीडिया, और ईमेल से हुए कन्वर्ज़न का डेटा है, तो मार्जिनल प्रायिकता P(Conversion) सभी स्रोतों पर योग करती है। यह बुनियादी कन्वर्ज़न दर आपको आँकने में मदद करती है कि विशिष्ट ट्रैफिक स्रोत औसत से ऊपर या नीचे प्रदर्शन कर रहे हैं या नहीं।
इसी तरह, वित्त में, आप ब्याज दर स्तरों की परवाह किए बिना बाज़ार में गिरावट की मार्जिनल प्रायिकता की गणना कर सकते हैं। यह व्यापक आर्थिक कारकों की परतें जोड़ने से पहले का अनकंडीशंड जोखिम देता है।
आइए देखें कि डेटा साइंस वर्कफ़्लो में मार्जिनल प्रायिकता कैसे दिखाई देती है।
जब आप किसी डेटासेट से पहली बार मिलते हैं, तो मार्जिनल प्रायिकताओं की गणना बुनियादी घटना दरों को समझने में मदद करती है। किसी फ्रॉड डिटेक्शन डेटासेट में, P(Fraud) आपको किसी भी फीचर को देखने से पहले क्लास बैलेंस बताती है। इससे तुरंत पता चलता है कि क्या आप एक अत्यधिक असंतुलित समस्या से निपट रहे हैं जहाँ धोखाधड़ी केवल 0.1% लेनदेन में होती है।
व्यक्तिगत फीचर्स के मार्जिनल वितरण भी आपके विश्लेषण का मार्गदर्शन करते हैं। यदि आप ग्राहक चर्न की भविष्यवाणी करने का मॉडल बना रहे हैं, तो मैं अलग-अलग P(Churn), P(High-value customer), और P(Recent activity) देखने की सलाह दूंगा। यह उनके संयुक्त संबंधों की खोज से पहले संदर्भ देता है।
Naive Bayes वर्गीकारक स्पष्ट रूप से मार्जिनल प्रायिकताओं पर क्लास प्रायर के रूप में निर्भर करते हैं। किसी दस्तावेज़ को स्पैम या नॉन-स्पैम के रूप में वर्गीकृत करते समय, P(Spam) आपका प्रायर विश्वास है—दस्तावेज़ के किसी भी शब्द को देखने से पहले। एल्गोरिद्म तब इस मार्जिनल प्रायिकता को सशर्त फीचर प्रायिकताओं के आधार पर अपडेट करता है।
फीचर इंजीनियरिंग और मॉडल डायग्नोस्टिक्स में भी फीचर्स के मार्जिनल वितरण मायने रखते हैं। यदि किसी फीचर का मार्जिनल वितरण बहुत तिरछा (skewed) है, तो आप उसे अधिक सममित बनाने के लिए लॉग स्केलिंग या Box-Cox जैसी ट्रांसफ़ॉर्मेशन लगा सकते हैं।
डेटासेट्स के बीच शिफ्ट्स भी उतने ही महत्वपूर्ण हैं। उदाहरण के लिए, यदि आपके प्रशिक्षण सेट में P(Class A)=0.9 है लेकिन टेस्ट सेट में P(Class A)=0.5, तो आपकी संभाव्यता भविष्यवाणियाँ और प्रदर्शन मेट्रिक्स काफी बदल सकते हैं, और आपको अलग निर्णय थ्रेशोल्ड चाहिए हो सकता है। ऐसा इसलिए होता है क्योंकि मॉडल एक बेस रेट पर सीखा, लेकिन उसका मूल्यांकन दूसरे पर हो रहा है।
प्रशिक्षण से पहले मार्जिनल वितरण जाँचना आपको ये समस्याएँ जल्दी पकड़ने में मदद करता है और यह तय करने में भी कि आपको रिसैम्पलिंग, अलग मूल्यांकन मेट्रिक्स, रीकैलिब्रेशन, या अलग डेटा सेगमेंट्स के लिए अलग मॉडल्स की ज़रूरत है या नहीं।
अपेक्षित मान (expected value) की गणनाएँ मार्जिनल प्रायिकताओं की माँग करती हैं। यदि आप किसी उत्पाद को लॉन्च करने पर निर्णय ले रहे हैं, तो आपको P(Success) चाहिए—सभी संभावित बाज़ार स्थितियों पर सफलता की मार्जिनल प्रायिकता। इसे सफलता के पेऑफ़ से गुणा करें, P(Failure) को विफलता की लागत से गुणा करें और जोड़ें—यही आपका अपेक्षित मान है।
बेयेसियन नेटवर्क्स और ग्राफ़िकल मॉडल्स में, नोड्स चरों का प्रतिनिधित्व करते हैं जिनके साथ संबद्ध सशर्त प्रायिकता वितरण होते हैं। मार्जिनल वितरण इंफरेंस के माध्यम से प्राप्त किए जाते हैं—नेटवर्क संरचना में प्रायिकताओं का प्रसार करके या एविडेंस ऑब्ज़र्व करके और विश्वासों को अपडेट करके। Markov Chain Monte Carlo जैसे सैम्पलिंग तरीक़े तब इन मार्जिनल्स का सन्निकटन करते हैं जब सटीक गणना अव्यवहार्य हो जाती है। हमारा Bayesian Modeling with RJAGS कोर्स इन तरीकों का व्यवहार में प्रदर्शन करता है।
यहाँ वे गलतियाँ हैं जो अनुभवी प्रैक्टिशनर्स को भी उलझा देती हैं।
यह शायद सबसे आम गलती है, और आश्चर्यजनक रूप से सहज लगती है। मान लें आपने 95% सेंसिटिविटी और 90% स्पेसिफ़िसिटी वाला चिकित्सीय परीक्षण कराया। आपका परिणाम पॉज़िटिव आता है। अधिकांश लोग तुरंत सोचते हैं: "टेस्ट 95% मामलों को पकड़ता है, तो संभवतः मुझे रोग है।"
लेकिन यह तर्क एक अहम जानकारी छोड़ देता है: रोग सामान्यतः कितना प्रचलित है? यदि केवल 1% लोगों को यह है (मार्जिनल प्रायिकता), तो 10,000 लोगों की जाँच पर लगभग 95 सच्चे पॉज़िटिव मिलेंगे, लेकिन 990 फॉल्स पॉज़िटिव भी। इसका अर्थ है कि अधिकांश पॉज़िटिव परिणाम गलत अलार्म होंगे। पॉज़िटिव आने के बाद आपकी वास्तविक प्रायिकता लगभग 9% होगी, 95% नहीं।
भ्रम इसलिए होता है क्योंकि लोग टेस्ट की सेंसिटिविटी (95%) पर ध्यान देते हैं और बेसलाइन दर (1% प्रेवलेंस) भूल जाते हैं। मार्जिनल प्रायिकता P(Disease) = 0.01 और सशर्त प्रायिकता P(Disease | Positive test) = 0.09 पूरी तरह अलग मात्राएँ हैं, लेकिन हमारी अंत:प्रेरणा उन्हें एक जैसा मान लेती है।
भले ही लोग मार्जिनल और सशर्त प्रायिकताओं के बीच सही भेद कर लें, वे अक्सर सशर्त की व्याख्या करते समय मार्जिनल को नज़रअंदाज़ कर देते हैं। आप कोई समाचार सुर्खी देख सकते हैं: "अध्ययन में पाया गया कि 80% सफल उद्यमियों ने 30 की उम्र से पहले शुरुआत की।" यह है P(Started before 30 | Successful entrepreneur) = 0.8। लेकिन सभी उद्यमियों के लिए P(Started before 30) जाने बिना, आप नहीं आँक सकते कि जल्दी शुरुआत वास्तव में सफलता की भविष्यवाणी करती है या नहीं।
यह त्रुटिपूर्ण निर्णय-निर्धारण की ओर ले जाता है। यदि 90% सभी उद्यमी 30 से पहले शुरुआत करते हैं, तो सफल उद्यमी असामान्य दर पर जल्दी शुरुआत नहीं कर रहे—वे बस सामान्य पैटर्न का अनुसरण कर रहे हैं। मार्जिनल बेसलाइन के बिना सशर्त प्रायिकता का अर्थ सीमित है।
बेस रेट फैलेसी तब होती है जब लोग सशर्त साक्ष्य को अधिक वज़न देते हैं और मार्जिनल प्रायिकताओं (बेस रेट) की उपेक्षा करते हैं।
एक सामान्य डेटा साइंस उदाहरण: आप असंतुलित डेटासेट पर बाइनरी क्लासिफ़ायर बना रहे हैं। पॉज़िटिव क्लास (जिसकी आप भविष्यवाणी करना चाहते हैं) आपके डेटा का केवल 5% है। आप मॉडल बनाते हैं और 95% एक्युरेसी पाते हैं। यह अच्छा लगता है, है न?
वास्तव में नहीं। यदि आप एक "साधारण" मॉडल बनाते जो हर बार नकारात्मक क्लास ही भविष्यवाणी करता, तो उसे भी 95% एक्युरेसी मिलती (क्योंकि 95% डेटा नकारात्मक है)। आपका बढ़िया मॉडल "हमेशा नहीं" कहने से बहुत बेहतर नहीं कर रहा।
गलती 95% एक्युरेसी संख्या को बेस रेट (5% पॉज़िटिव क्लास) पर विचार किए बिना देखना है। जब क्लास असंतुलित हों, तो एक्युरेसी भ्रामक मेट्रिक बन जाती है। आपको यह देखने के लिए precision, recall, या F1-score जाँचना चाहिए कि आपका मॉडल वास्तव में कुछ उपयोगी सीख पाया है या नहीं।
मार्जिनल्स को समझना आपको असंतुलित समस्याओं के लिए सही मूल्यांकन मेट्रिक्स चुनने में मदद करता है।
दर्जनों या सैकड़ों चरों वाले उच्च-आयामी मॉडलों में, मार्जिनल वितरणों की सटीक गणना अक्सर असंभव होती है। संभावित संयोजनों की संख्या तेज़ी से बढ़ती है, और आवश्यक योग या इंटीग्रल अव्यवहार्य हो जाते हैं।
इसे संभालने के लिए, प्रैक्टिशनर्स अनुमानित (approximate) इंफरेंस तरीकों का उपयोग करते हैं:
आधुनिक टूल्स जैसे Python का scipy.stats प्रायिकता वितरणों के लिए, pandas कॉन्टिन्जेंसी टेबल्स के लिए, और R के table() तथा dplyr अनुभवजन्य मार्जिनल्स के लिए इन गणनाओं को सुलभ बनाते हैं। डेटाबेस में संग्रहित डेटा के लिए, SQL का GROUP BY क्लॉज़ बड़े डेटासेट्स से अनुभवजन्य मार्जिनल्स कुशलता से गणना करता है।
चरों के बीच संबंध समझने, सशर्त साक्ष्य का आकलन करने, या बेयेसियन मॉडल बनाने से पहले, आपको व्यक्तिगत घटनाओं की अनकंडीशंड प्रायिकता समझनी चाहिए। यही वह बेसलाइन है जो बाकी सबको व्याख्येय बनाती है।
जब आप मार्जिनल्स को गलत समझते हैं, तो आप विश्लेषणात्मक त्रुटियों के प्रति संवेदनशील हो जाते हैं: बेसलाइन दरों को सशर्त प्रायिकताओं से गड़बड़ा देना, बेस रेट फैलेसी का शिकार होना, या ऐसे मॉडल बनाना जो साधारण बेसलाइनों से बेहतर प्रदर्शन न करें। मार्जिनल्स सही समझें, और आप जान पाएँगे कि सशर्त प्रायिकता उन्हें कैसे परिष्कृत करती है, बेयेस प्रमेय साक्ष्य से उन्हें कैसे अपडेट करता है, और मशीन लर्निंग मॉडल उनके खुलासे किए पैटर्न्स से कैसे सीखते हैं।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स