Kursus
Memahami Machine Learning
2 jam
310.9K
Model machine learning memiliki hyperparameter yang secara signifikan memengaruhi performanya. Parameter-parameter ini bisa diibaratkan seperti suhu yang tepat untuk memanggang kue atau sudut yang pas untuk membalik panekuk. Dalam reinforcement learning, hyperparameter memengaruhi pendekatan kebijakan (policy) dan penghampiran reward, dan dengan penyetelan yang lebih baik, optimasi hyperparameter dapat meningkatkan hasil secara drastis.
Artikel ini akan membahas Optuna, kerangka kerja open-source yang kuat untuk mengoptimalkan hyperparameter. Jika Anda baru dalam topik ini, pertimbangkan untuk memulai dengan Understanding Machine Learning, yang menawarkan pengantar tanpa kode. Untuk berlatih menggunakan Python, coba kursus Machine Learning Fundamentals with Python, yang menggunakan scikit-learn. Selanjutnya, MLOps Concepts akan membantu Anda memahami cara memindahkan model machine learning dari notebook lokal ke lingkungan produksi. Terakhir, coba Preprocessing for Machine Learning in Python, kursus yang sangat relevan dengan artikel ini karena mengajarkan Anda cara membersihkan dan menyiapkan data untuk model machine learning.
Optuna adalah alat open-source untuk kerangka kerja optimasi hyperparameter yang mengotomatiskan pencarian hyperparameter. Alat ini dapat digunakan dengan kerangka kerja machine learning atau deep learning apa pun. Beberapa kemampuan utama Optuna mencakup:
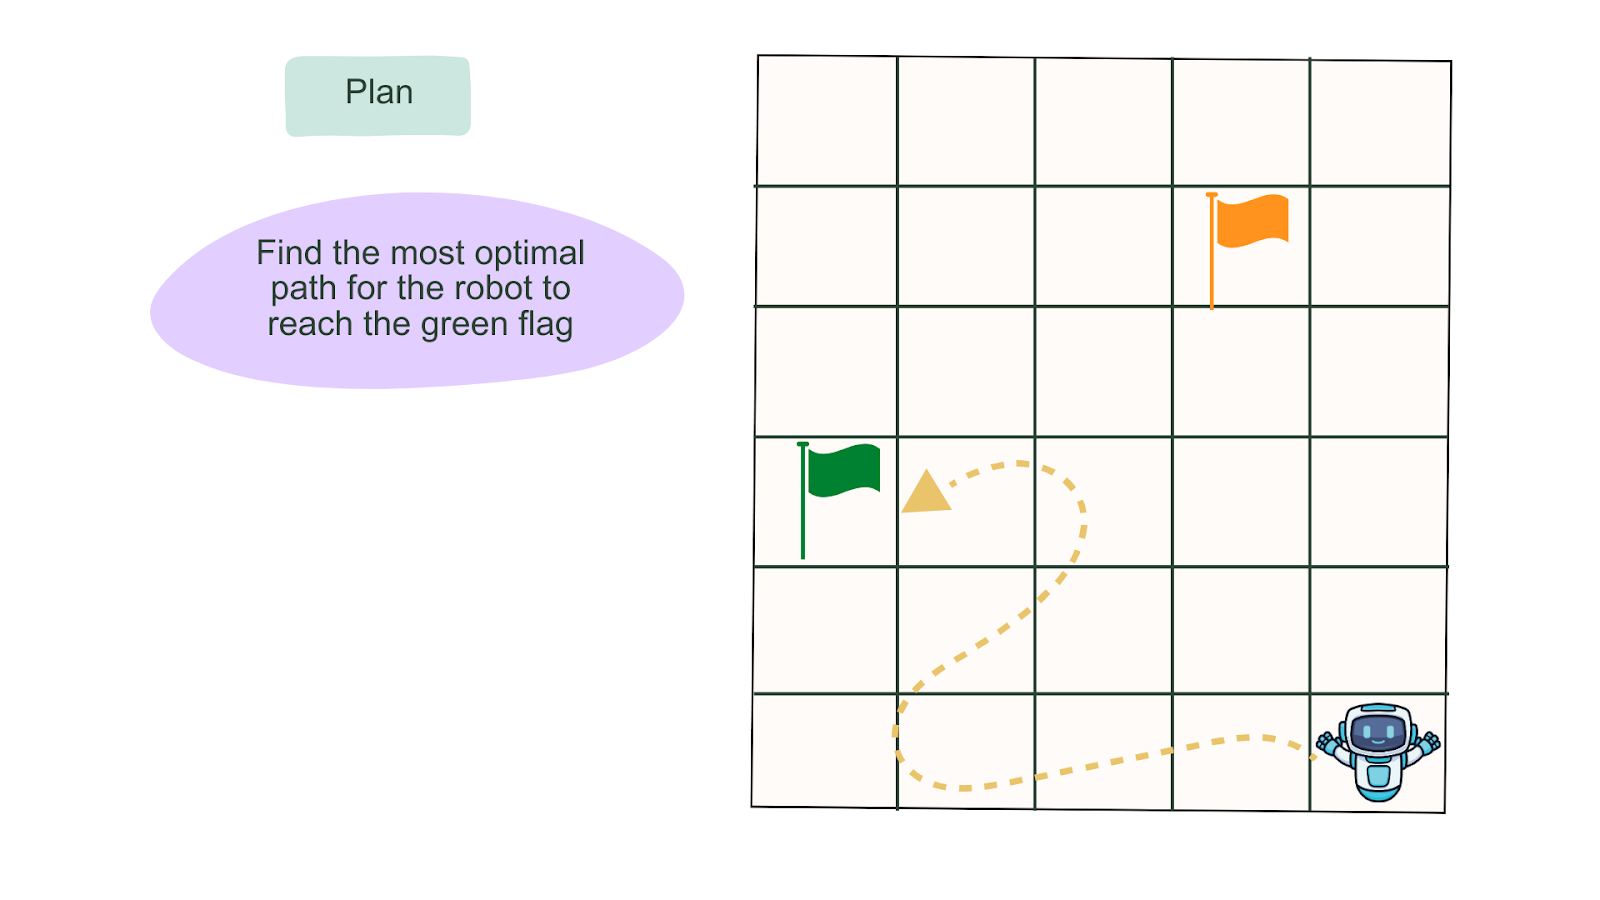
Menemukan jalur optimal. Sumber: Gambar oleh Penulis
Reinforcement learning (RL) menggabungkan machine learning dan optimal control. Bidang ini mempelajari bagaimana agen cerdas harus bertindak dalam lingkungan dinamis untuk memaksimalkan reward kumulatif. Secara sederhana, reinforcement learning adalah tentang mengajarkan agen cerdas mengambil keputusan paling optimal yang memaksimalkan reward di dalam suatu lingkungan. Reward untuk setiap langkah yang diambil bisa positif atau negatif saat ia mendekati tujuan yang diinginkan.
Berbeda dari machine learning, algoritme reinforcement learning membuat keputusan untuk mencapai hasil paling optimal, mirip dengan proses belajar coba-coba yang kita gunakan untuk mencapai target. Deep reinforcement learning berbeda dari reinforcement learning karena menggunakan deep neural network untuk menghampiri fungsi yang kompleks. Kita juga bisa mengatakan bahwa reinforcement learning biasa berfokus pada pendekatan yang lebih deterministik, sementara deep reinforcement learning menggunakan pendekatan stokastik.
Dalam suatu lingkungan, bisa ada banyak rute untuk mencapai tujuan. Dibandingkan dengan supervised learning, deep reinforcement learning jauh lebih sensitif terhadap pemilihan hyperparameter seperti learning rate, gamma, jumlah langkah, dan sebagainya.
Pilihan hyperparameter yang buruk dapat menyebabkan konvergensi yang buruk/tidak stabil. Tantangan ini diperparah oleh variasi performa lintas random seed (yang digunakan untuk menginisialisasi bobot jaringan dan lingkungan).
Pada bagian ini, kita akan membahas proses menyiapkan Optuna dan dependensi terkait, mendefinisikan ruang pencarian, serta menjalankan optimasi untuk algoritme MountainCarContinuous-v0. Algoritme MountainCarContinuous-v0 adalah salah satu algoritme RL di RL-Zoo, sebuah kerangka pelatihan yang menyediakan skrip untuk mengevaluasi agen dan memplot hasil. Algoritme MountainCarContinuous-v0 memodelkan lingkungan di mana agen (sebuah mobil) berusaha mencapai tujuannya (mencapai bendera).
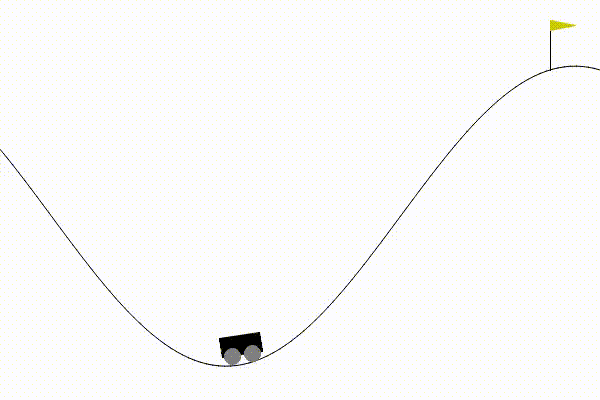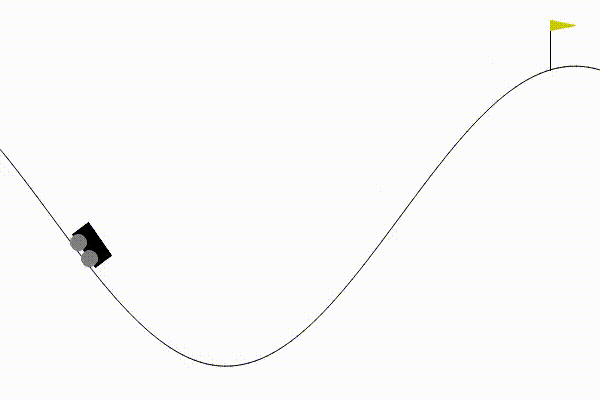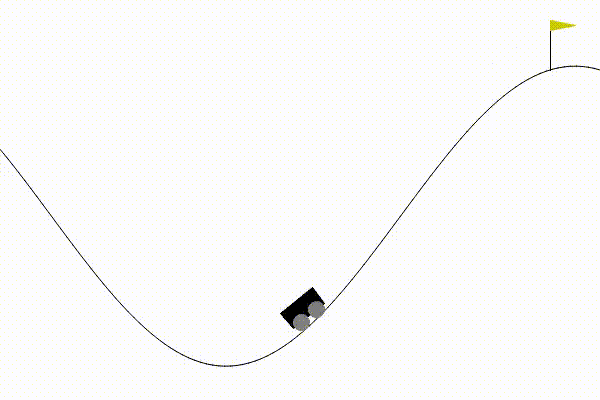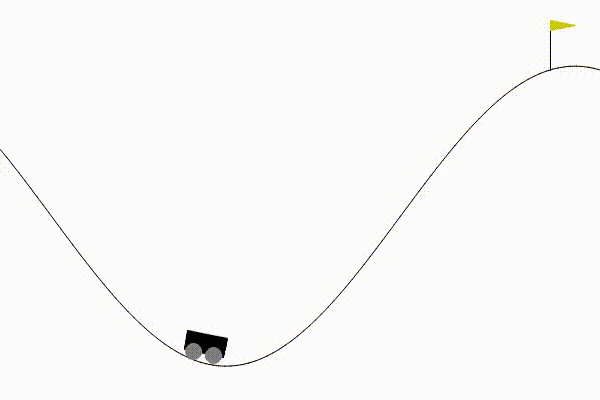
Representasi algoritme MountainCarContinuous-v0 yang telah disetel. Gambar oleh Penulis.
Untuk memulai, Anda perlu:
Setelah membuat virtual environment baru, kita menginstal paket yang diperlukan. Perlu dicatat, Optuna mendukung Python 3.7 atau yang lebih baru. Jika Anda ingin meninjau cara menyiapkan virtual environment, baca tutorial Virtual Environment in Python kami.
pip install optunapip install stable-baselines3pip install sb3-contribKita akan menggunakan paket gym untuk membuat lingkungan tempat agen melakukan aksi.
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)Proyek ini akan menggunakan algoritme MountainCarContinuous-v0 dari Advantage Actor-Critic (A2C). Advantage Actor-Critic (A2C) — salah satu algoritme Actor-Critic, adalah arsitektur hibrida yang menggabungkan metode berbasis nilai (mengukur reward untuk aksi yang diambil) dan berbasis kebijakan (mengendalikan aksi agen) yang membantu menstabilkan pelatihan dengan mengurangi varians.
Mari tetapkan konfigurasi yang akan digunakan dalam tugas ini.
N_TRIALS = 100 # Maximum number of trialsN_JOBS = 1 # Number of jobs to run in parallelN_STARTUP_TRIALS = 5 # Stop random sampling after N_STARTUP_TRIALSN_EVALUATIONS = 2 # Number of evaluations during the trainingN_TIMESTEPS = 100000 # Training budgetEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutesENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}Kita akan menyarankan rentang nilai untuk hyperparameter.
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Sample A2C hyperparameters for Optuna trial.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }Fungsi CallBack TrialEvalCallback() didefinisikan karena kita ingin mengembalikan hasil evaluasi berkala dari tugas optimasi. Lihat notebook Google Colab untuk implementasi callback.
def objective(trial: optuna.Trial) -> float: """ This will be used by Optuna to evaluate one set of hyperparameters at a time.Given a trial object, it will sample hyperparameters, evaluate it and report the result. :param trial: Optuna trial object :return: Mean episodic reward after training """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Sample hyperparameters and update the keyword arguments kwargs.update(a2c_hyper_params(trial)) # 2. Create the RL model model = A2C(**kwargs) # 3. Create envs used for evaluation using make_vec_env, ENV_ID and N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Create the TrialEvalCallback callback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Train the model model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Sometimes, random hyperparams can generate NaN print(e) nan_encountered = True finally: # Free memory model.env.close() eval_envs.close() # Tell the optimizer that the trial failed if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardPruning merujuk pada pemangkasan parameter atau wilayah ruang pencarian yang kecil kemungkinannya menghasilkan hasil optimal, dan dalam kasus ini, melakukan pruning setelah anggaran tertentu. Dalam Optuna, pruning menghapus uji coba yang performanya buruk pada tahap awal pelatihan. Ini memangkas himpunan parameter dan waktu untuk mencapai ruang pencarian optimal. Optuna memiliki beberapa pruner, termasuk Median Pruner, yang menggunakan aturan penghentian median. Anda dapat membaca lebih lanjut tentang Pruner Optuna di dokumentasi Optuna.
Algoritme Median Pruner melakukan pruning jika hasil terbaik saat ini lebih buruk daripada median hasil sebelumnya. Pembagian dengan tiga digunakan karena kita hanya ingin melakukan pruning setelah 1/3 dari anggaran maksimal digunakan.
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)Pilih sampler, bisa acak, TPESampler, CMAES, dll.
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)Kita sekarang siap membuat studi Optuna.
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")Mari lihat beberapa fitur lanjutan Optuna.
Optuna menyediakan dasbor yang memungkinkan kita memvisualisasikan, melacak, dan menganalisis run sebelumnya dan saat ini. Dulu, Anda mungkin perlu menghubungkan alat pelacakan seperti MLFlow untuk mengelola hasil.
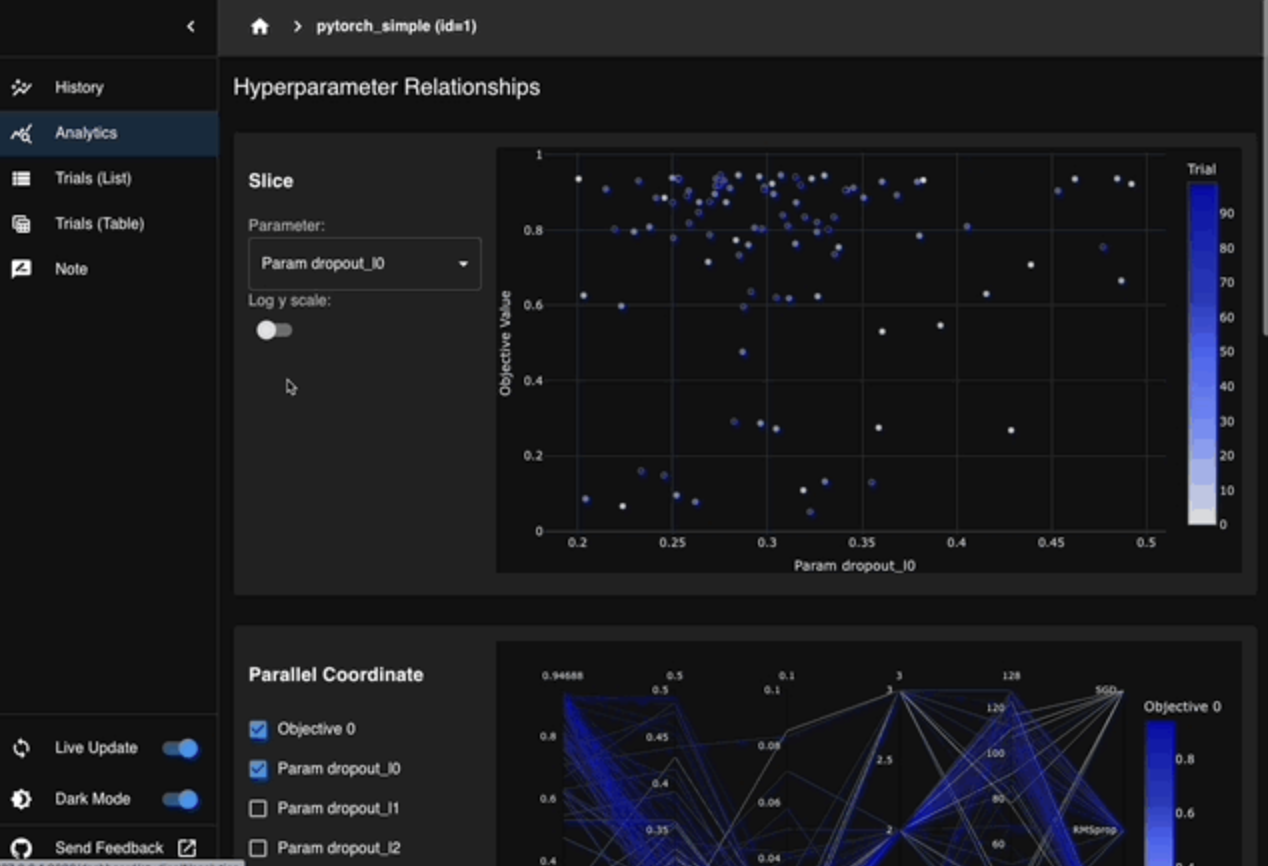
Optuna Dashboard. Sumber: Optuna
Dukungan Optuna untuk pelatihan terdistribusi memungkinkan Anda menghubungkan backend terdistribusi, seperti Kubernetes atau Dask, untuk memanfaatkan lebih banyak sumber daya komputasi bagi eksperimen skala besar. Anda juga dapat menghubungkan backend penyimpanan untuk menyimpan dan mengelola hasil sesi Anda. Anda dapat menggunakan penyimpanan cloud seperti penyimpanan Dask atau SQLite untuk run lokal.
Berikut beberapa tips untuk menghindari jebakan umum dalam penyetelan hyperparameter:
Pelajari Machine Learning dengan DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



