Khóa học
Tìm hiểu Machine Learning
2 giờ
314.1K
Các mô hình học máy có những siêu tham số ảnh hưởng đáng kể đến hiệu năng. Bạn có thể hình dung chúng như nhiệt độ nướng bánh phù hợp hay góc lật bánh kếp đúng chuẩn. Trong học tăng cường, siêu tham số tác động đến xấp xỉ chính sách và phần thưởng; khi được tinh chỉnh tốt, tối ưu siêu tham số có thể cải thiện kết quả một cách rõ rệt.
Bài viết này sẽ khám phá Optuna, một khung làm việc mã nguồn mở mạnh mẽ để tối ưu siêu tham số. Nếu bạn mới bắt đầu, hãy tham khảo Understanding Machine Learning, khóa học giới thiệu không cần viết mã. Để thực hành với Python, thử khóa Machine Learning Fundamentals with Python sử dụng scikit-learn. Sau đó, MLOps Concepts sẽ giúp bạn hiểu cách chuyển mô hình học máy từ notebook cục bộ sang môi trường sản xuất. Cuối cùng, hãy học Preprocessing for Machine Learning in Python, một khóa học rất liên quan vì dạy bạn làm sạch và chuẩn bị dữ liệu cho các mô hình học máy.
Optuna là công cụ mã nguồn mở cho khung tối ưu siêu tham số nhằm tự động hóa việc tìm kiếm siêu tham số. Nó có thể dùng với bất kỳ khung học máy hoặc học sâu nào. Một số khả năng chính của Optuna gồm:
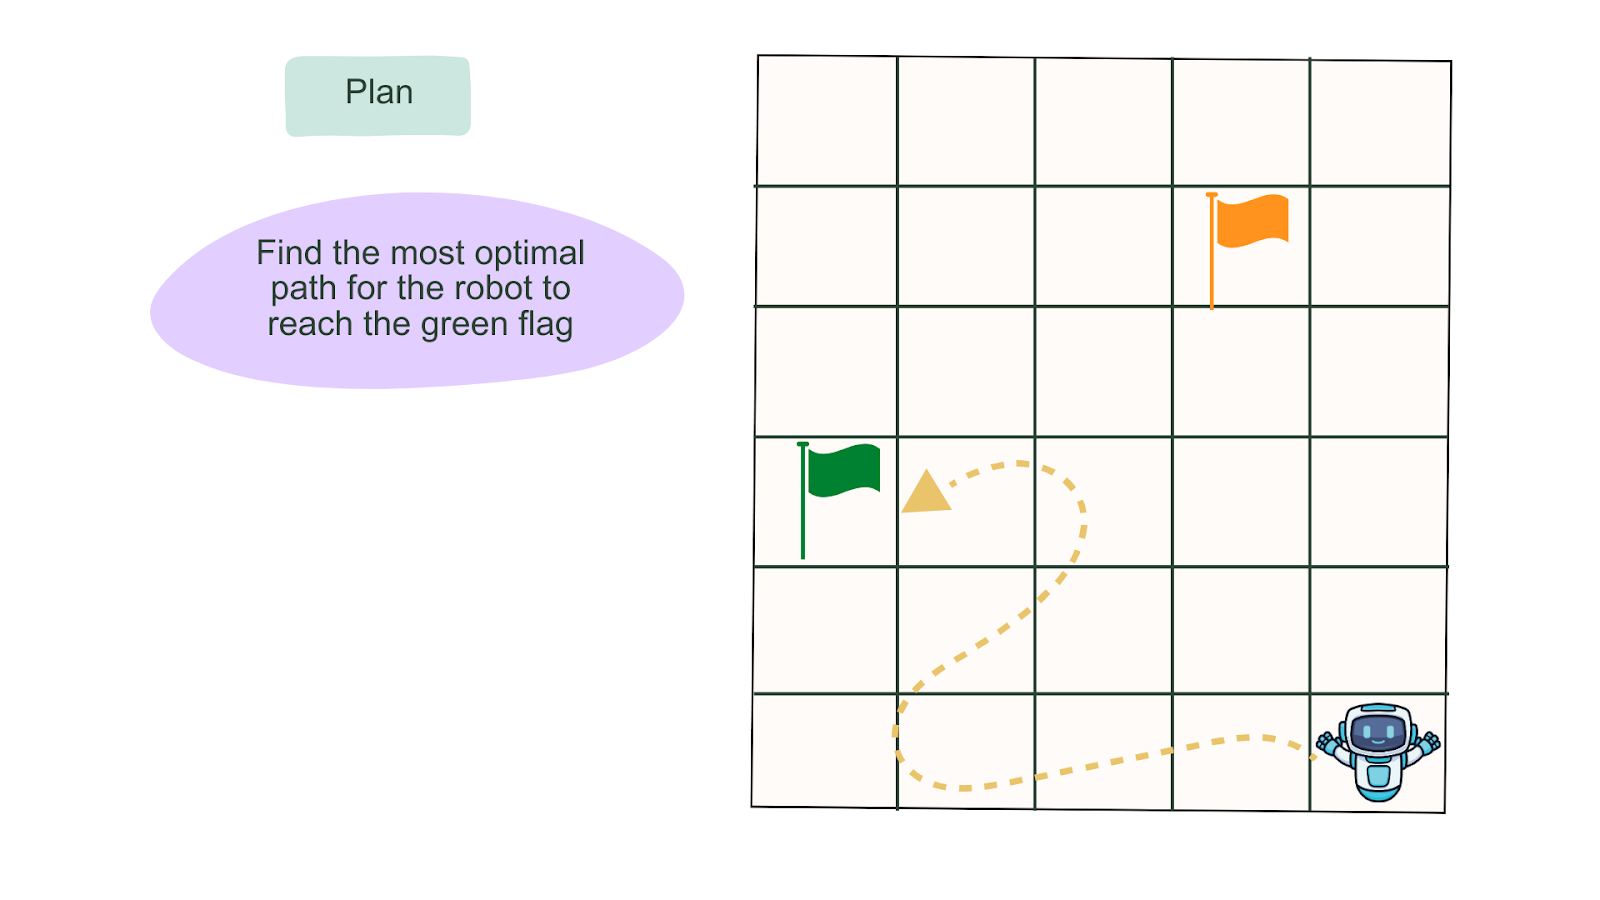
Tìm đường đi tối ưu. Nguồn: Hình do tác giả thực hiện
Học tăng cường (RL) kết hợp học máy và điều khiển tối ưu. Nó nghiên cứu cách một tác tử thông minh nên hành động trong môi trường động để tối đa hóa tổng phần thưởng tích lũy. Nói đơn giản, học tăng cường là dạy một tác tử thông minh đưa ra các quyết định tối ưu nhất nhằm tối đa hóa phần thưởng trong môi trường. Phần thưởng cho mỗi bước có thể dương hoặc âm khi nó tiến gần tới đích mong muốn.
Không giống học máy giám sát, thuật toán học tăng cường đưa ra quyết định để đạt kết quả tối ưu nhất, tương tự quá trình học thử–sai mà chúng ta dùng để đạt mục tiêu. Học tăng cường sâu khác với học tăng cường ở chỗ nó dùng mạng nơ-ron sâu để xấp xỉ các hàm phức tạp. Cũng có thể nói học tăng cường thông thường thiên về cách tiếp cận quyết định tất định hơn, trong khi học tăng cường sâu sử dụng các cách tiếp cận ngẫu nhiên.
Trong một môi trường, có thể có nhiều lộ trình để đến đích. So với học có giám sát, học tăng cường sâu nhạy cảm hơn nhiều với lựa chọn siêu tham số như learning rate, gamma, số bước, v.v.
Lựa chọn siêu tham số kém có thể dẫn đến hội tụ kém/không ổn định. Thách thức này còn tăng do biến thiên trong hiệu năng giữa các hạt giống ngẫu nhiên (dùng để khởi tạo trọng số mạng và môi trường).
Trong phần này, chúng ta sẽ đi qua quy trình thiết lập Optuna và các phụ thuộc liên quan, định nghĩa không gian tìm kiếm, và chạy tối ưu cho thuật toán MountainCarContinuous-v0. MountainCarContinuous-v0 là một trong các thuật toán RL trong RL-Zoo, một khung huấn luyện cung cấp script để đánh giá tác tử và vẽ kết quả. Thuật toán MountainCarContinous-v0 mô phỏng môi trường nơi tác tử (chiếc xe) cố gắng đạt mục tiêu (chạm lá cờ).
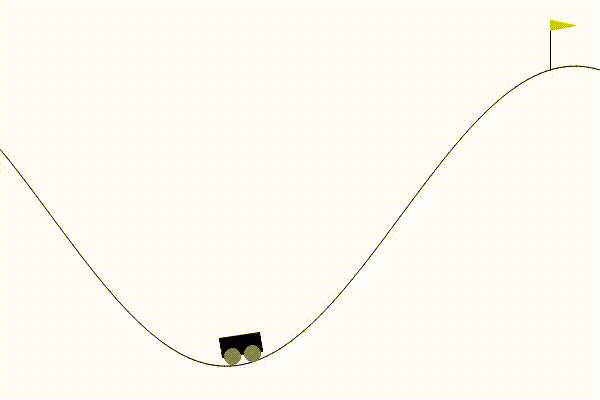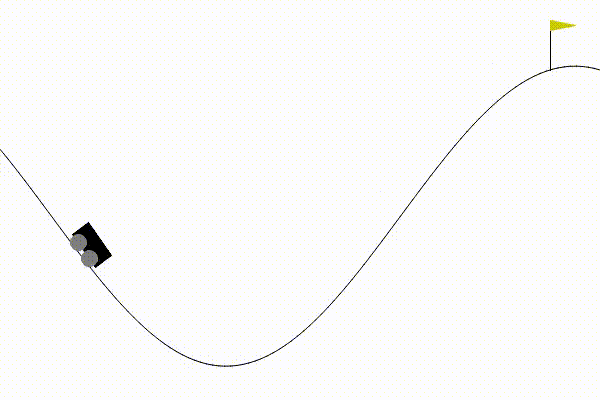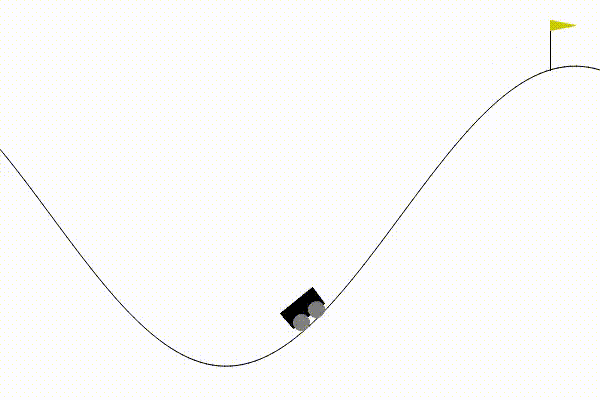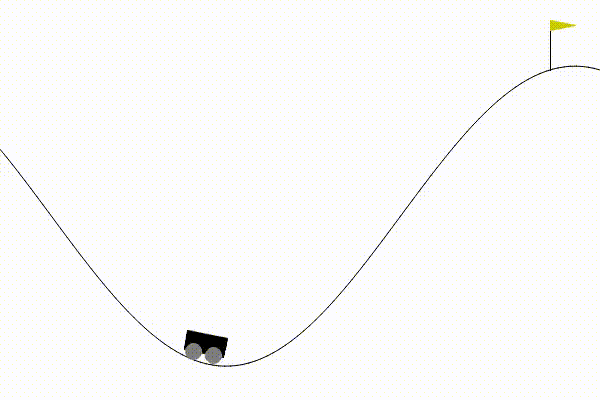
Minh họa thuật toán MountainCarContinuous-v0 đã tinh chỉnh. Hình do tác giả thực hiện.
Để bắt đầu, bạn cần:
Sau khi tạo môi trường ảo mới, chúng ta cài đặt các gói. Lưu ý, Optuna hỗ trợ Python 3.7 trở lên. Nếu bạn muốn xem lại cách thiết lập môi trường ảo, đọc hướng dẫn Virtual Environment in Python.
pip install optunapip install stable-baselines3pip install sb3-contribChúng ta sẽ dùng gói gym để tạo môi trường nơi tác tử sẽ thực hiện hành động.
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)Dự án này sẽ dùng thuật toán MountainCarContinuous-v0 với Advantage Actor-Critic (A2C). Advantage Actor-Critic (A2C) — một trong các thuật toán Actor-Critic — là kiến trúc lai kết hợp phương pháp dựa trên giá trị (đo phần thưởng cho hành động đã thực hiện) và dựa trên chính sách (kiểm soát hành động của tác tử), giúp ổn định quá trình huấn luyện bằng cách giảm phương sai.
Hãy thiết lập cấu hình dùng cho bài toán này.
N_TRIALS = 100 # Maximum number of trialsN_JOBS = 1 # Number of jobs to run in parallelN_STARTUP_TRIALS = 5 # Stop random sampling after N_STARTUP_TRIALSN_EVALUATIONS = 2 # Number of evaluations during the trainingN_TIMESTEPS = 100000 # Training budgetEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutesENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}Chúng ta sẽ đề xuất phạm vi giá trị cho các siêu tham số.
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Sample A2C hyperparameters for Optuna trial.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }Một hàm CallBack TrialEvalCallback() được định nghĩa vì chúng ta muốn trả về kết quả đánh giá định kỳ của các tác vụ tối ưu. Xem sổ tay Google Colab để xem cài đặt callback.
def objective(trial: optuna.Trial) -> float: """ This will be used by Optuna to evaluate one set of hyperparameters at a time.Given a trial object, it will sample hyperparameters, evaluate it and report the result. :param trial: Optuna trial object :return: Mean episodic reward after training """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Sample hyperparameters and update the keyword arguments kwargs.update(a2c_hyper_params(trial)) # 2. Create the RL model model = A2C(**kwargs) # 3. Create envs used for evaluation using make_vec_env, ENV_ID and N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Create the TrialEvalCallback callback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Train the model model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Sometimes, random hyperparams can generate NaN print(e) nan_encountered = True finally: # Free memory model.env.close() eval_envs.close() # Tell the optimizer that the trial failed if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardCắt tỉa (pruning) ám chỉ việc loại bỏ các tham số hoặc vùng trong không gian tìm kiếm ít có khả năng cho kết quả tối ưu, và trong trường hợp này là cắt tỉa sau một ngân sách nhất định. Trong Optuna, pruning loại bỏ các lần thử (trial) có hiệu năng kém ở giai đoạn đầu huấn luyện. Điều này rút gọn tập tham số và thời gian để đạt tới không gian tìm kiếm tối ưu. Optuna có vài pruner, bao gồm Median Pruner, sử dụng quy tắc dừng theo trung vị. Bạn có thể đọc thêm về Optuna Pruners trong tài liệu Optuna.
Thuật toán Median Pruner sẽ cắt tỉa nếu kết quả tốt nhất hiện tại kém hơn trung vị của các kết quả trước đó. Việc chia cho ba được dùng vì chúng ta chỉ muốn cắt tỉa sau khi dùng 1/3 ngân sách tối đa.
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)Chọn bộ lấy mẫu (sampler), có thể là random, TPESampler, CMAES, v.v.
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)Chúng ta đã sẵn sàng tạo một study của Optuna.
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")Hãy xem một số tính năng nâng cao hơn của Optuna.
Optuna cung cấp một bảng điều khiển cho phép chúng ta trực quan hóa, theo dõi và phân tích các lần chạy trước và hiện tại. Trước đây, bạn có thể phải kết nối công cụ theo dõi như MLFlow để quản lý kết quả.
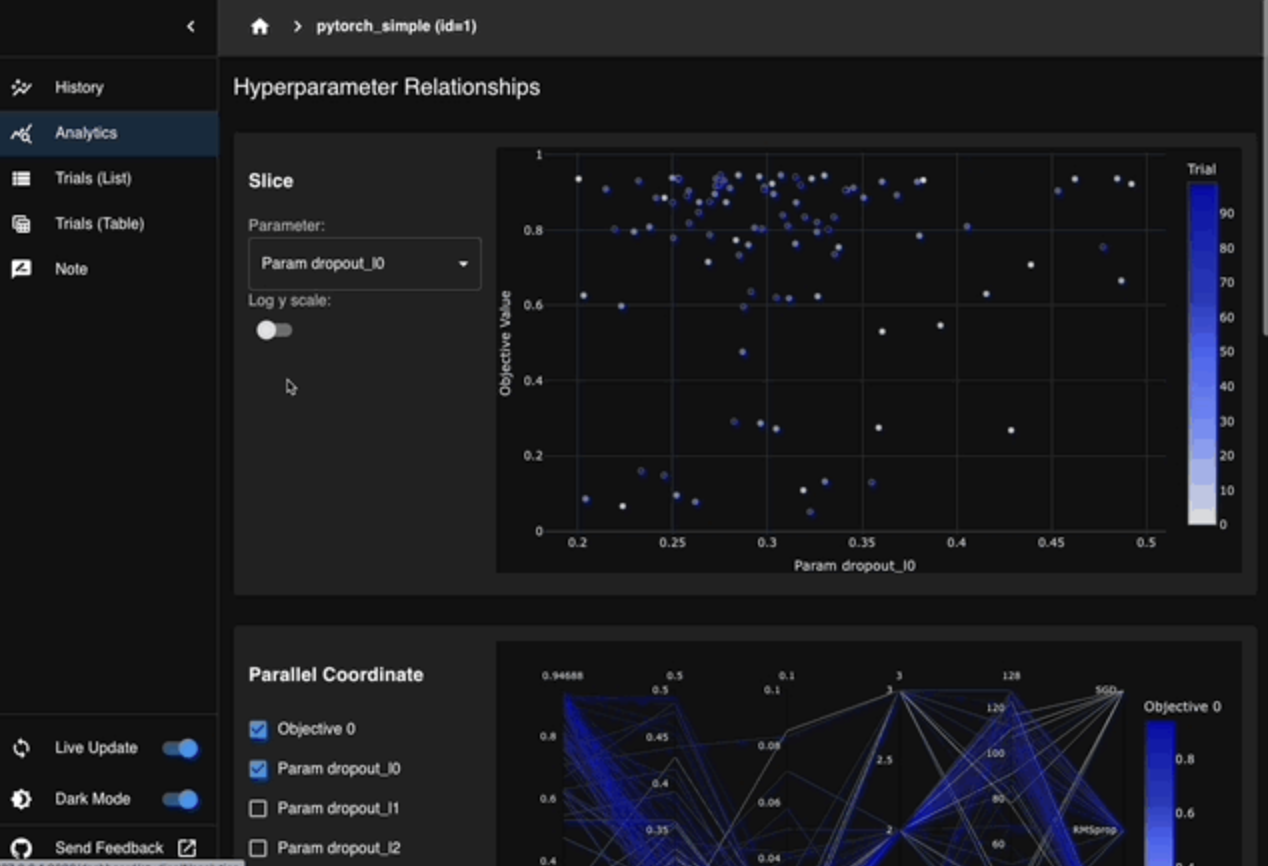
Optuna Dashboard. Nguồn: Optuna
Hỗ trợ huấn luyện phân tán của Optuna cho phép bạn kết nối backend phân tán như Kubernetes hoặc Dask để tận dụng thêm tài nguyên tính toán cho các thí nghiệm quy mô lớn. Bạn cũng có thể kết nối backend lưu trữ để lưu và quản lý kết quả phiên làm việc. Có thể dùng lưu trữ đám mây như Dask storage hoặc SQLite cho các lần chạy cục bộ.
Dưới đây là một số mẹo để tránh sai lầm phổ biến khi tinh chỉnh siêu tham số:
Học Machine Learning với DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
