Corso
Capire il Machine Learning
2 ore
311.4K
I modelli di machine learning hanno iperparametri che influiscono in modo significativo sulle loro prestazioni. Possiamo paragonarli alla temperatura giusta per cuocere una torta o all'angolazione corretta per girare un pancake. Nel reinforcement learning, gli iperparametri incidono sulle approssimazioni della policy e della ricompensa e, con una taratura migliore, l'ottimizzazione degli iperparametri può migliorare drasticamente i risultati.
In questo articolo esploreremo Optuna, un potente framework open-source per l'ottimizzazione degli iperparametri. Se sei alle prime armi, valuta di iniziare con Understanding Machine Learning, che offre un'introduzione no-code. Per fare pratica in Python, prova il corso Machine Learning Fundamentals with Python, che utilizza scikit-learn. Poi, MLOps Concepts ti aiuterà a capire come portare i modelli di machine learning dai notebook locali agli ambienti di produzione. Infine, prova Preprocessing for Machine Learning in Python, un corso molto pertinente a questo articolo perché insegna a pulire e preparare i dati per i modelli di machine learning.
Optuna è uno strumento open-source per l'ottimizzazione degli iperparametri che automatizza la ricerca degli iperparametri. Può essere usato con qualsiasi framework di machine learning o deep learning. Alcune delle principali funzionalità di Optuna includono:
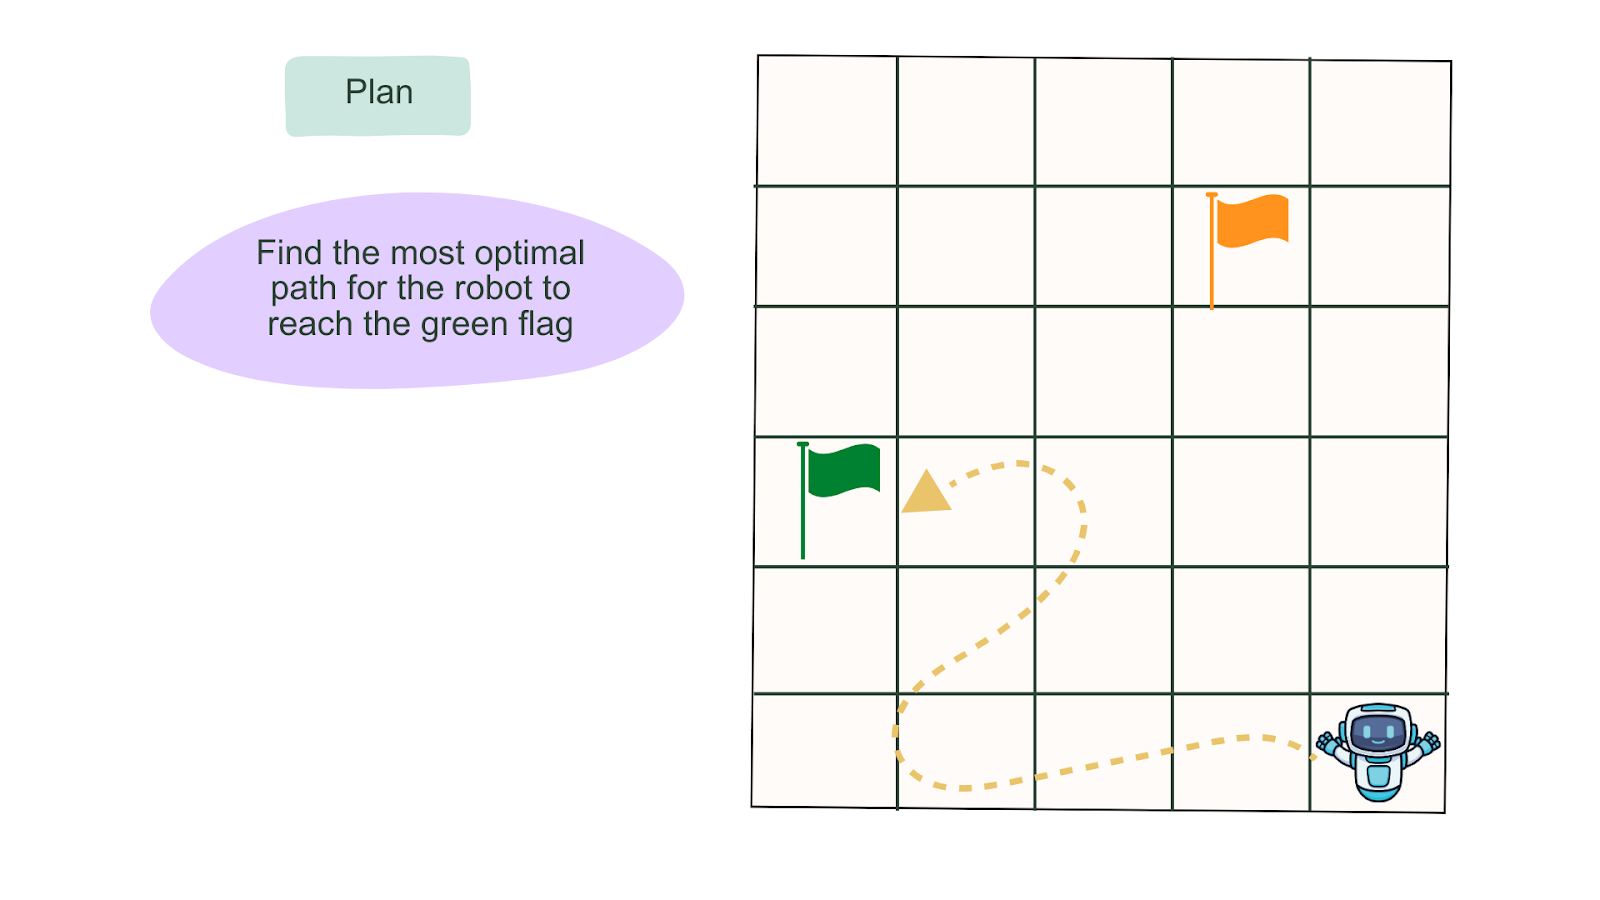
Trovare il percorso ottimale. Fonte: Immagine dell'autore
Il reinforcement learning (RL) combina machine learning e controllo ottimo. Si occupa di come un agente intelligente dovrebbe agire in un ambiente dinamico per massimizzare la sua ricompensa cumulativa. In parole semplici, il reinforcement learning riguarda l'insegnare a un agente intelligente a prendere le decisioni più ottimali che massimizzano le sue ricompense in un ambiente. La ricompensa per ogni passo può essere positiva o negativa man mano che si avvicina alla destinazione desiderata.
A differenza del machine learning, gli algoritmi di reinforcement learning prendono decisioni per ottenere risultati il più possibile ottimali, in modo simile al processo di apprendimento per tentativi ed errori che utilizziamo per raggiungere i nostri obiettivi. Il deep reinforcement learning si differenzia dal reinforcement learning perché utilizza reti neurali profonde per approssimare funzioni complesse. Si potrebbe anche dire che il reinforcement learning "classico" si concentra su approcci più deterministici, mentre il deep reinforcement learning utilizza approcci stocastici.
In un ambiente possono esistere molte strade per raggiungere la destinazione. Rispetto al supervised learning, il deep reinforcement learning è molto più sensibile alla scelta di iperparametri come learning rate, gamma, numero di step e così via.
Una cattiva scelta di iperparametri può portare a convergenza scarsa/instabile. Questa sfida è aggravata dalla variabilità delle prestazioni al variare dei semi casuali (usati per inizializzare i pesi della rete e l'ambiente).
In questa sezione vedremo come configurare Optuna e le dipendenze correlate, definire lo spazio di ricerca ed eseguire l'ottimizzazione per l'algoritmo MountainCarContinuous-v0. MountainCarContinuous-v0 è uno degli algoritmi di RL in RL-Zoo, un framework di training che fornisce script per valutare gli agenti e tracciare i risultati. L'algoritmo MountainCarContinuous-v0 modella un ambiente in cui l'agente (un'auto) cerca di raggiungere il suo obiettivo (raggiungere la bandierina).
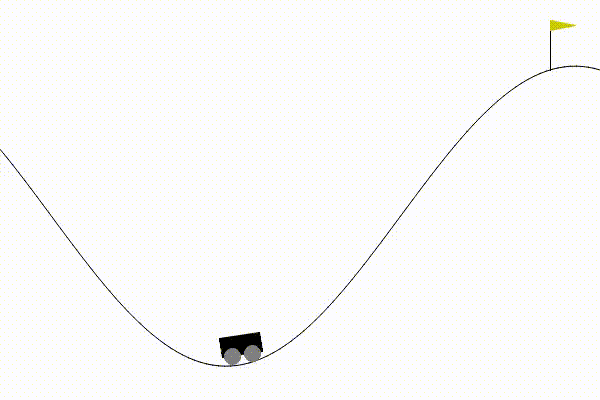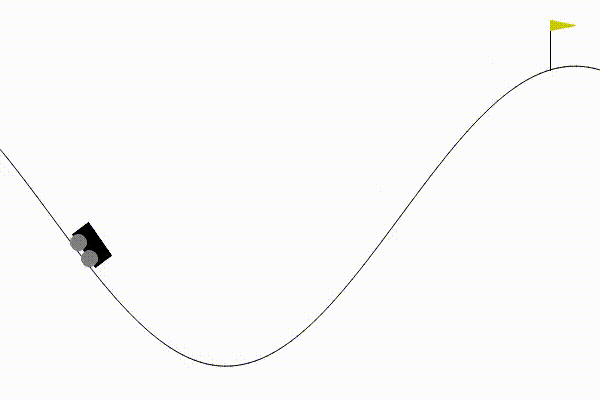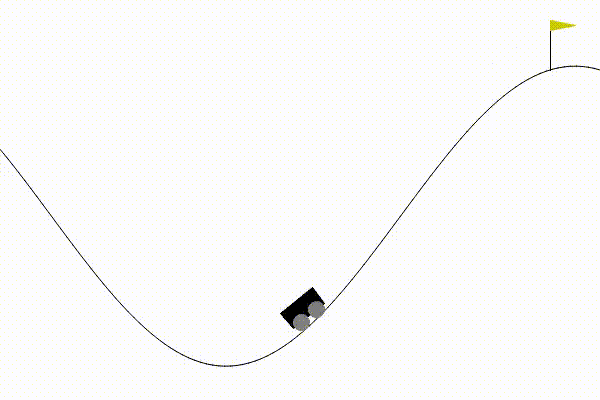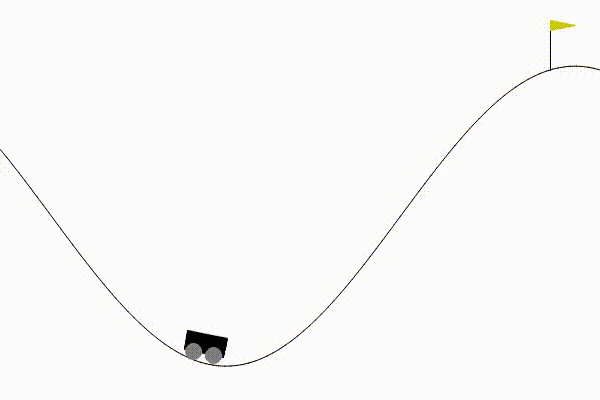
Rappresentazione dell'algoritmo MountainCarContinuous-v0 ottimizzato. Immagine dell'autore.
Per iniziare, devi:
Dopo aver creato un nuovo ambiente virtuale, installiamo i pacchetti. Nota: Optuna supporta Python 3.7 o versioni successive. Se vuoi ripassare come creare un ambiente virtuale, leggi il nostro tutorial Virtual Environment in Python.
pip install optunapip install stable-baselines3pip install sb3-contribUseremo il pacchetto gym per creare l'ambiente in cui l'agente eseguirà le azioni.
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)Questo progetto utilizzerà l'algoritmo MountainCarContinuous-v0 basato su Advantage Actor-Critic (A2C). Advantage Actor-Critic (A2C) — uno degli algoritmi Actor-Critic — è un'architettura ibrida che combina metodi value-based (misurano la ricompensa per un'azione eseguita) e policy-based (controllano le azioni dell'agente) e aiuta a stabilizzare l'addestramento riducendo la varianza.
Impostiamo le configurazioni da utilizzare in questo task.
N_TRIALS = 100 # Maximum number of trialsN_JOBS = 1 # Number of jobs to run in parallelN_STARTUP_TRIALS = 5 # Stop random sampling after N_STARTUP_TRIALSN_EVALUATIONS = 2 # Number of evaluations during the trainingN_TIMESTEPS = 100000 # Training budgetEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutesENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}Suggeriremo un intervallo di valori per gli iperparametri.
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Sample A2C hyperparameters for Optuna trial.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }È stata definita una funzione CallBack, TrialEvalCallback(), perché vogliamo restituire i risultati di valutazione periodici dei task di ottimizzazione. Controlla il notebook Google Colab per l'implementazione del callback.
def objective(trial: optuna.Trial) -> float: """ This will be used by Optuna to evaluate one set of hyperparameters at a time.Given a trial object, it will sample hyperparameters, evaluate it and report the result. :param trial: Optuna trial object :return: Mean episodic reward after training """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Sample hyperparameters and update the keyword arguments kwargs.update(a2c_hyper_params(trial)) # 2. Create the RL model model = A2C(**kwargs) # 3. Create envs used for evaluation using make_vec_env, ENV_ID and N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Create the TrialEvalCallback callback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Train the model model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Sometimes, random hyperparams can generate NaN print(e) nan_encountered = True finally: # Free memory model.env.close() eval_envs.close() # Tell the optimizer that the trial failed if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardPer pruning si intende ridurre i parametri o le regioni dello spazio di ricerca meno probabili a fornire un risultato ottimale, e in questo caso potare dopo un budget specifico. In Optuna, il pruning rimuove i trial che hanno prestazioni peggiori nelle fasi iniziali dell'addestramento. Questo riduce l'insieme di parametri e il tempo necessario per raggiungere lo spazio di ricerca ottimale. Optuna offre diversi pruner, incluso il Median Pruner, che usa la regola dello stop mediano. Puoi leggere di più sui Pruner di Optuna nella documentazione di Optuna.
L'algoritmo Median Pruner effettua pruning se l'attuale miglior risultato è peggiore della mediana dei risultati precedenti. La divisione per tre è usata perché vogliamo potare solo dopo che è stato utilizzato 1/3 del budget massimo.
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)Seleziona il sampler, che può essere casuale, TPESampler, CMAES, ecc.
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)Ora siamo pronti a creare uno studio Optuna.
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")Diamo un'occhiata ad alcune delle funzionalità più avanzate di Optuna.
Optuna fornisce una dashboard che ci permette di visualizzare, tracciare e analizzare esecuzioni passate e in corso. In passato, potevi dover collegare uno strumento di tracciamento, come MLflow, per gestire i risultati.
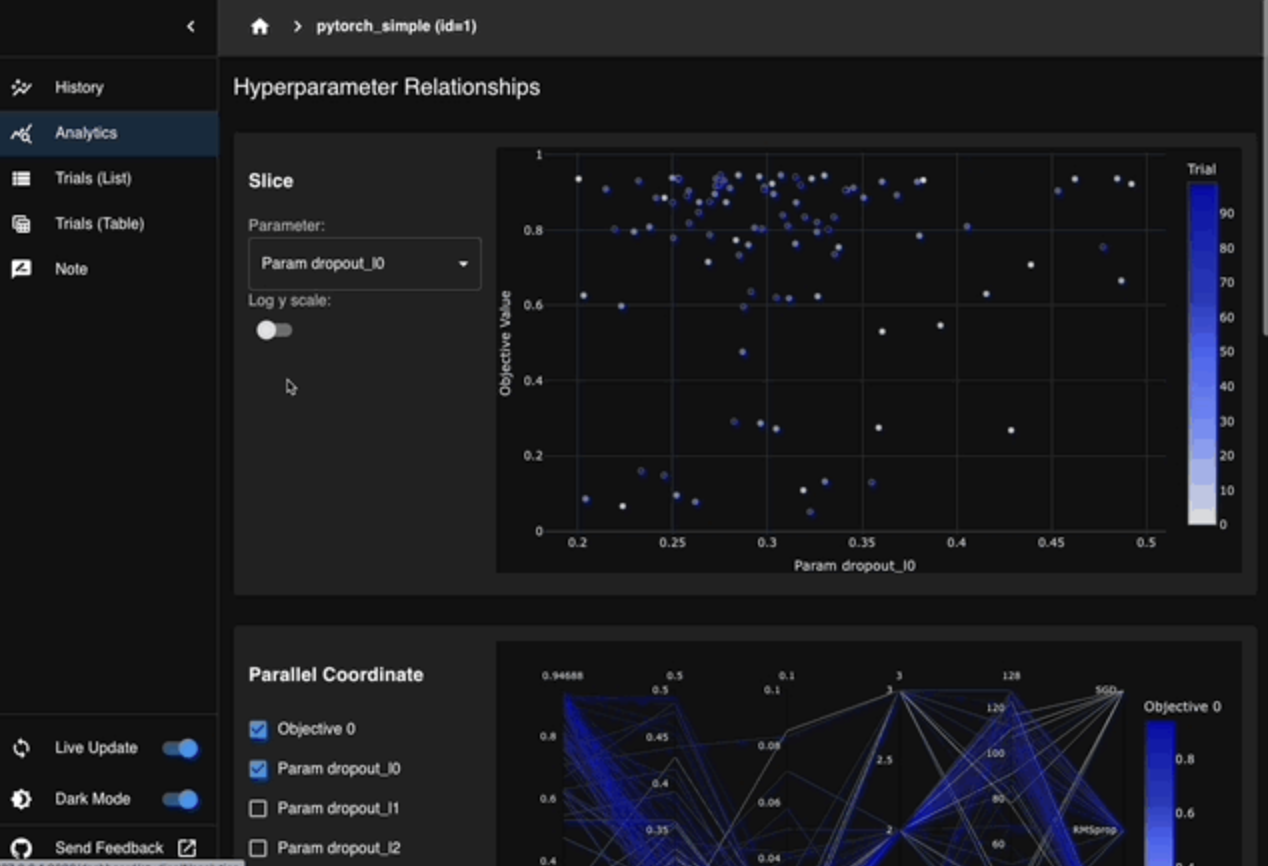
Optuna Dashboard. Fonte: Optuna
Il supporto di Optuna per il training distribuito ti permette di collegare il tuo backend distribuito, come Kubernetes o Dask, per sfruttare più risorse di calcolo negli esperimenti su larga scala. Puoi anche collegare un backend di storage per archiviare e gestire i risultati della sessione. Puoi usare storage cloud come Dask storage o SQLite per le esecuzioni locali.
Ecco alcuni consigli per evitare errori comuni nel tuning degli iperparametri:
Impara il Machine Learning con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



