
कोर्स
Understanding Machine Learning
2 घंटा
313.2K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंमशीन लर्निंग मॉडलों में ऐसे हाइपरपैरामीटर्स होते हैं जो उनके प्रदर्शन पर गहरा असर डालते हैं। इन पैरामीटर्स की तुलना केक बेक करने के सही तापमान या पैनकेक पलटने के सही कोण से की जा सकती है। रिइनफोर्समेंट लर्निंग में, हाइपरपैरामीटर्स पॉलिसी और रिवार्ड एप्रॉक्सिमेशन को प्रभावित करते हैं, और बेहतर-ट्यून किए गए परिणामों के साथ, हाइपरपैरामीटर ऑप्टिमाइज़ेशन नतीजों में बड़ा सुधार ला सकता है।
यह लेख Optuna का अन्वेषण करेगा, जो हाइपरपैरामीटर्स को ऑप्टिमाइज़ करने के लिए एक शक्तिशाली ओपन-सोर्स फ़्रेमवर्क है। यदि आप इस विषय में नए हैं, तो Understanding Machine Learning से शुरुआत करें, जो बिना कोडिंग के परिचय देता है। Python के साथ अभ्यास करने के लिए हमारा Machine Learning Fundamentals with Python कोर्स आज़माएँ, जो scikit-learn का उपयोग करता है। इसके बाद, MLOps Concepts आपको समझने में मदद करेगा कि लोकल नोटबुक्स से प्रोडक्शन एन्वायरनमेंट्स तक मशीन लर्निंग मॉडलों को कैसे ट्रांज़िशन किया जाए। अंत में, Preprocessing for Machine Learning in Python करें—यह लेख के लिए अत्यंत प्रासंगिक है क्योंकि यह आपको मशीन लर्निंग मॉडलों के लिए अपने डेटा को साफ़ करने और तैयार करने की शिक्षा देता है।
Optuna हाइपरपैरामीटर सर्च को स्वचालित करने के लिए एक ओपन-सोर्स हाइपरपैरामीटर ऑप्टिमाइज़ेशन फ़्रेमवर्क है। इसे किसी भी मशीन लर्निंग या डीप लर्निंग फ़्रेमवर्क के साथ उपयोग किया जा सकता है। Optuna की कुछ प्रमुख क्षमताएँ:
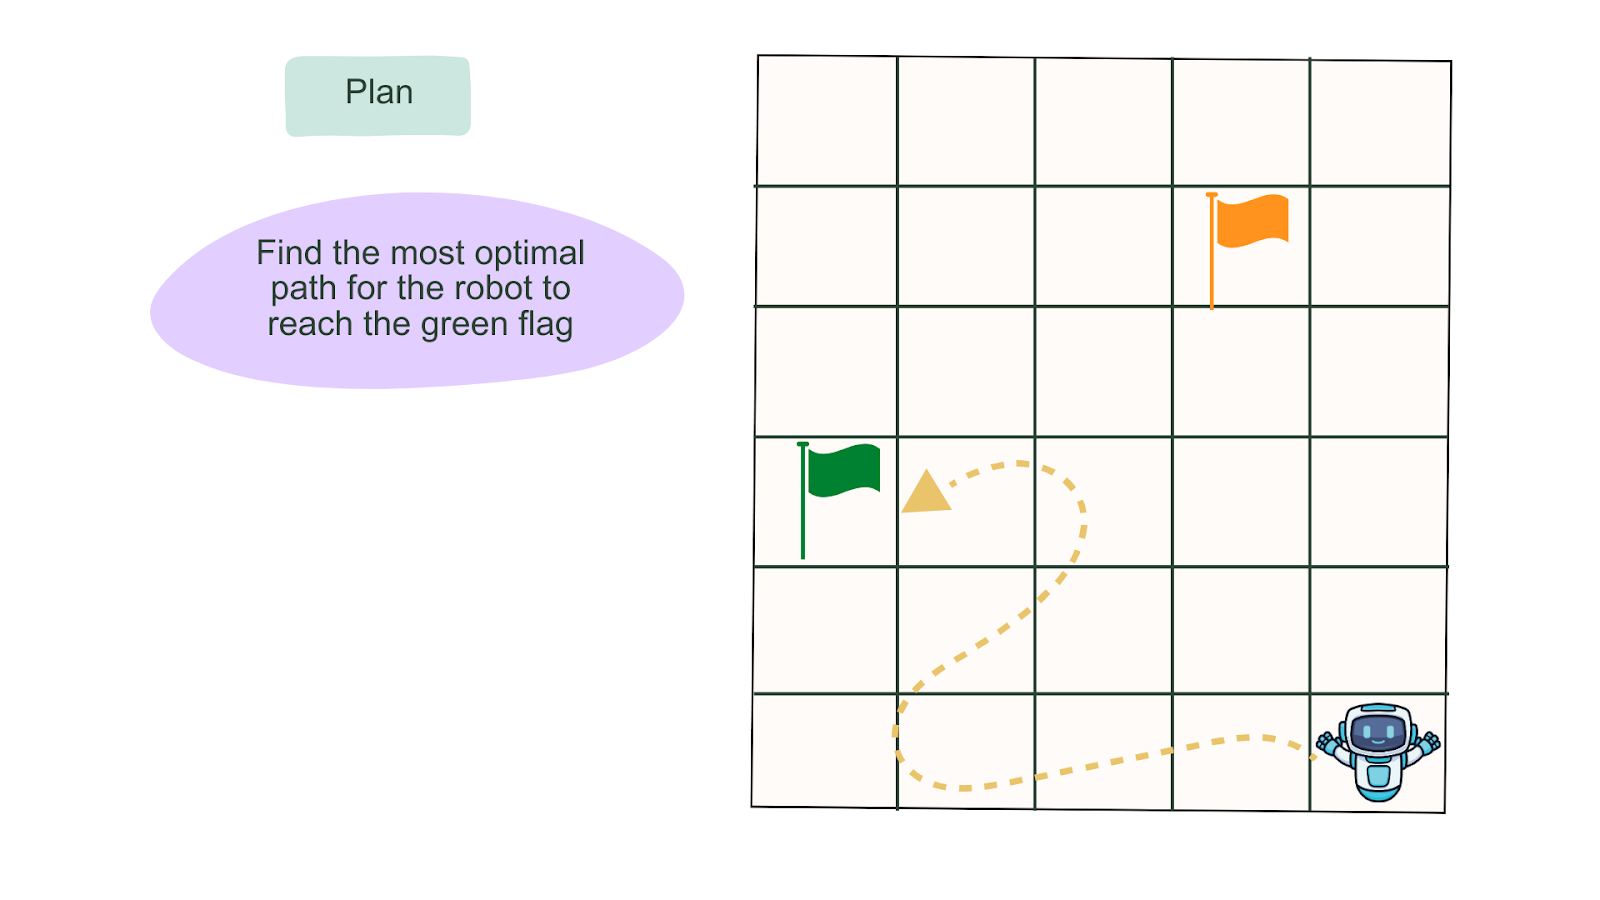
सर्वोत्तम मार्ग खोजना। स्रोत: लेखक द्वारा बनाया गया चित्र
रिइनफोर्समेंट लर्निंग (RL) मशीन लर्निंग और ऑप्टिमल कंट्रोल का समन्वय है। यह इस बात से संबंधित है कि एक बुद्धिमान एजेंट को गतिशील वातावरण में अपनी संचयी रिवार्ड को अधिकतम करने के लिए कैसे कार्य करना चाहिए। सरल शब्दों में, रिइनफोर्समेंट लर्निंग का उद्देश्य किसी वातावरण में ऐसे सर्वाधिक उपयुक्त निर्णय सिखाना है जो एजेंट के रिवार्ड्स को अधिकतम करें। एजेंट द्वारा उठाए गए किसी भी कदम का रिवार्ड, लक्ष्य के निकट जाने पर, सकारात्मक या नकारात्मक हो सकता है।
मशीन लर्निंग के विपरीत, रिइनफोर्समेंट लर्निंग एल्गोरिदम सबसे उपयुक्त परिणाम पाने के लिए निर्णय लेते हैं—कुछ-कुछ वैसा ही जैसा हम अपने लक्ष्यों को पाने के लिए ट्रायल-एंड-एरर से सीखते हैं। डीप रिइनफोर्समेंट लर्निंग, रिइनफोर्समेंट लर्निंग से इस मायने में अलग है कि यह जटिल फ़ंक्शंस को एप्रॉक्सिमेट करने के लिए डीप न्यूरल नेटवर्क्स का उपयोग करता है। यह भी कहा जा सकता है कि पारंपरिक रिइनफोर्समेंट लर्निंग अधिक निर्धारक (deterministic) तरीकों पर केंद्रित होती है, जबकि डीप रिइनफोर्समेंट लर्निंग प्रायिक (stochastic) तरीकों का उपयोग करती है।
किसी वातावरण में गंतव्य तक पहुँचने के कई रास्ते हो सकते हैं। निगरानी-आधारित (supervised) लर्निंग की तुलना में, डीप रिइनफोर्समेंट लर्निंग, लर्निंग रेट, गामा, स्टेप्स की संख्या आदि जैसे हाइपरपैरामीटर्स के चयन के प्रति कहीं अधिक संवेदनशील है।
हाइपरपैरामीटर्स का खराब चयन कमजोर/अस्थिर कन्वर्जेंस का कारण बन सकता है। यह चुनौती रैंडम सीड्स (जो नेटवर्क वेट्स और वातावरण को इनिशियलाइज़ करने के लिए उपयोग होते हैं) के कारण प्रदर्शन में परिवर्तनशीलता से और बढ़ जाती है।
इस खंड में, हम Optuna और संबंधित डिपेंडेंसीज़ सेट अप करने, सर्च स्पेस परिभाषित करने, और MountainCarContinuous-v0 एल्गोरिदम के लिए ऑप्टिमाइज़ेशन चलाने की प्रक्रिया से गुजरेंगे। MountainCarContinuous-v0 एल्गोरिदम RL-Zoo का एक RL एल्गोरिदम है—जो एजेंटों के मूल्यांकन और परिणामों की प्लॉटिंग के लिए स्क्रिप्ट्स प्रदान करने वाला प्रशिक्षण फ़्रेमवर्क है। MountainCarContinuous-v0 एल्गोरिदम ऐसे वातावरण का मॉडल करता है जिसमें एजेंट (एक कार) अपने लक्ष्य (झंडे तक पहुँचना) को हासिल करने की कोशिश करता है।
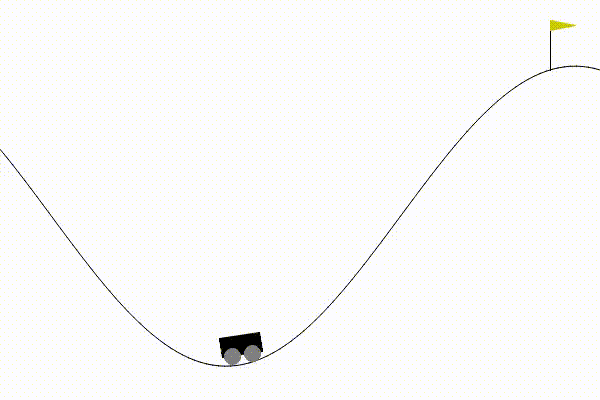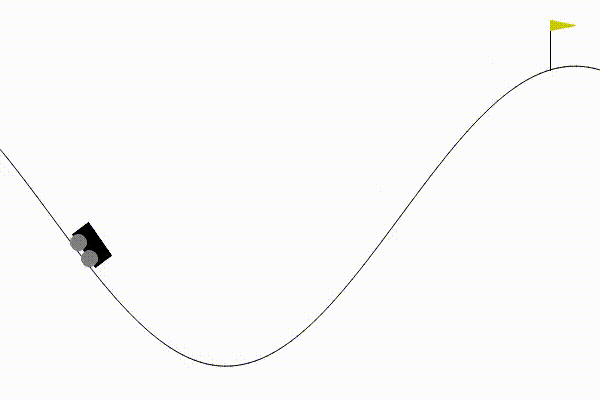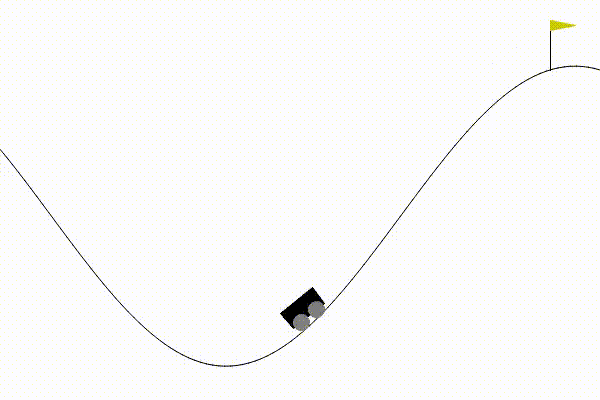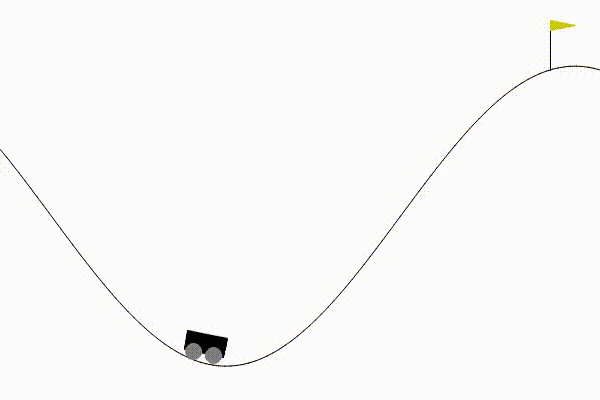
ट्यून किए गए MountainCarContinuous-v0 एल्गोरिदम का प्रतिनिधित्व। चित्र: लेखक द्वारा।
शुरू करने के लिए, आपको ये करना होगा:
नया वर्चुअल एन्वायरनमेंट बनाने के बाद, हम अपने पैकेज इंस्टॉल करेंगे। ध्यान दें, Optuna Python 3.7 या नए संस्करणों को सपोर्ट करता है। यदि आप वर्चुअल एन्वायरनमेंट सेट करने की समीक्षा करना चाहते हैं, तो हमारा Virtual Environment in Python ट्यूटोरियल पढ़ें।
pip install optunapip install stable-baselines3pip install sb3-contribहम एजेंट के एक्शन करने के लिए वातावरण बनाने हेतु gym पैकेज का उपयोग करेंगे।
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)यह प्रोजेक्ट Advantage Actor-Critic (A2C) से MountainCarContinuous-v0 एल्गोरिदम का उपयोग करेगा। Advantage Actor-Critic (A2C)—Actor-Critic एल्गोरिदम्स में से एक—एक हाइब्रिड आर्किटेक्चर है जो वैल्यू-आधारित (लिए गए एक्शन के रिवार्ड को मापना) और पॉलिसी-आधारित (एजेंट के एक्शंस को नियंत्रित करना) तरीकों को जोड़ता है, जो वैरिएंस को घटाकर प्रशिक्षण को स्थिर करने में मदद करता है।
आइए इस कार्य में उपयोग होने वाली कॉन्फ़िगरेशन सेट करें।
N_TRIALS = 100 # Maximum number of trialsN_JOBS = 1 # Number of jobs to run in parallelN_STARTUP_TRIALS = 5 # Stop random sampling after N_STARTUP_TRIALSN_EVALUATIONS = 2 # Number of evaluations during the trainingN_TIMESTEPS = 100000 # Training budgetEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutesENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}हम हाइपरपैरामीटर्स के लिए मानों की एक रेंज सुझाएँगे।
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Sample A2C hyperparameters for Optuna trial.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }हमने एक CallBack फ़ंक्शन TrialEvalCallback() परिभाषित किया है क्योंकि हम ऑप्टिमाइज़ेशन कार्यों के आवधिक मूल्यांकन परिणाम लौटाना चाहते हैं। कॉलबैक इम्प्लीमेंटेशन के लिए Google Colab नोटबुक देखें।
def objective(trial: optuna.Trial) -> float: """ This will be used by Optuna to evaluate one set of hyperparameters at a time.Given a trial object, it will sample hyperparameters, evaluate it and report the result. :param trial: Optuna trial object :return: Mean episodic reward after training """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Sample hyperparameters and update the keyword arguments kwargs.update(a2c_hyper_params(trial)) # 2. Create the RL model model = A2C(**kwargs) # 3. Create envs used for evaluation using make_vec_env, ENV_ID and N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Create the TrialEvalCallback callback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Train the model model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Sometimes, random hyperparams can generate NaN print(e) nan_encountered = True finally: # Free memory model.env.close() eval_envs.close() # Tell the optimizer that the trial failed if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardप्रूनिंग का तात्पर्य सर्च स्पेस के उन पैरामीटर्स या क्षेत्रों को कम करना है जिनसे सर्वोत्तम परिणाम मिलने की संभावना कम है—और यहाँ, एक विशिष्ट बजट के बाद प्रूनिंग करना। Optuna में, प्रूनिंग उन ट्रायल्स को हटाती है जो प्रशिक्षण के शुरुआती चरणों में ही खराब प्रदर्शन करते हैं। इससे पैरामीटर्स का सेट और सर्वोत्तम सर्च स्पेस तक पहुँचने का समय दोनों घटता है। Optuna में कुछ प्रूनर्स होते हैं, जैसे Median Pruner, जो मीडियन स्टॉपिंग रूल का उपयोग करता है। Optuna प्रूनर्स के बारे में अधिक पढ़ने के लिए Optuna प्रलेखन देखें।
Median Pruner एल्गोरिदम तब प्रून करता है जब वर्तमान सर्वोत्तम परिणाम, पिछले परिणामों के मीडियन से भी खराब हो। तीन से भाग इसलिए लिया गया है क्योंकि हम अधिकतम बजट के केवल 1/3 उपयोग के बाद ही प्रून करना चाहते हैं।
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)सैंपलर चुनें—यह random, TPESampler, CMAES आदि हो सकता है।
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)अब हम Optuna स्टडी बनाने के लिए तैयार हैं।
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")आइए Optuna की कुछ उन्नत विशेषताओं पर नज़र डालें।
Optuna एक डैशबोर्ड प्रदान करता है जो हमें पिछले और वर्तमान रन को विज़ुअलाइज़, ट्रैक और विश्लेषित करने देता है। पहले, आपको नतीजों को मैनेज करने के लिए अपने ट्रैकिंग टूल, जैसे MLFlow, को कनेक्ट करना पड़ सकता था।
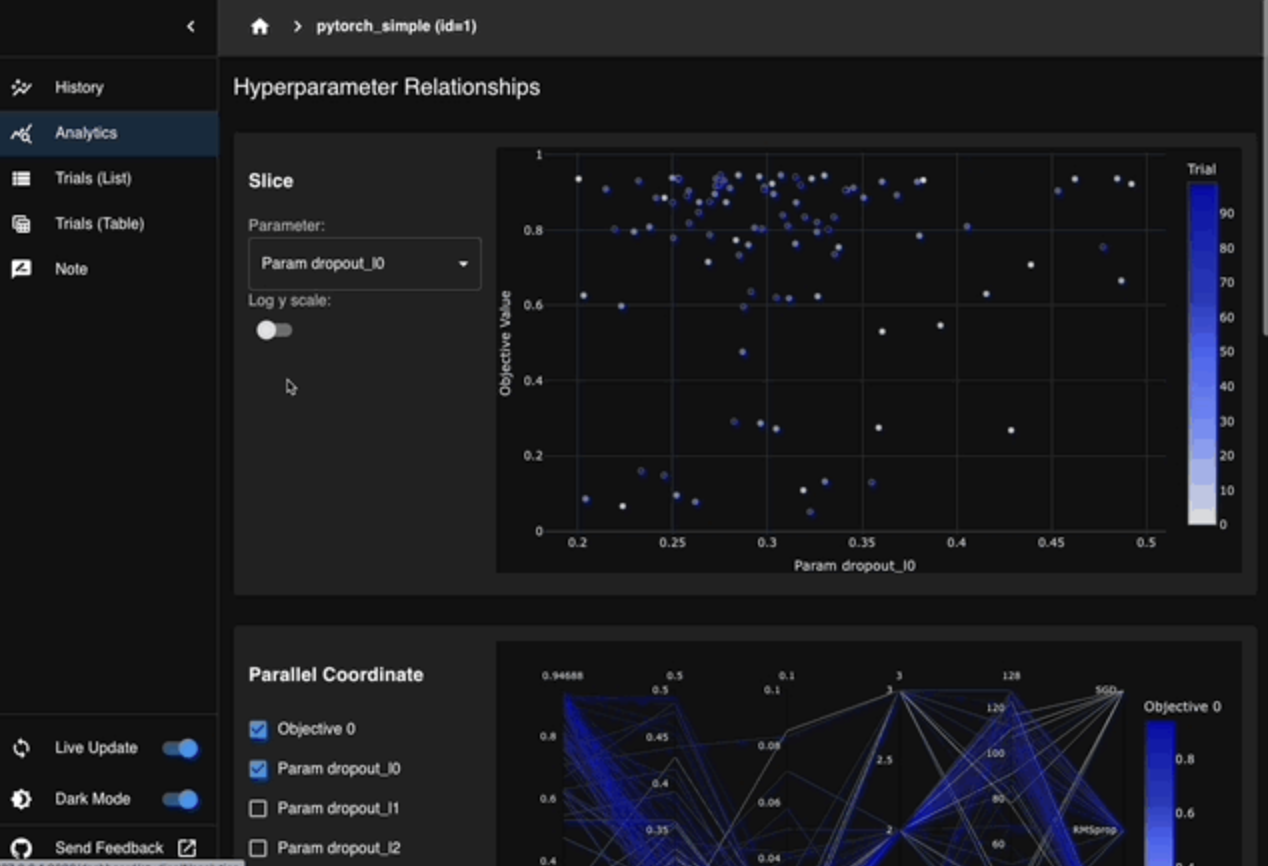
Optuna डैशबोर्ड। स्रोत: Optuna
Optuna का वितरित प्रशिक्षण समर्थन आपको Kubernetes या Dask जैसे वितरित बैकएंड से कनेक्ट होने देता है, ताकि बड़े पैमाने के प्रयोगों के लिए अधिक कम्प्यूट संसाधनों का लाभ उठाया जा सके। आप अपने स्टोरेज बैकएंड को भी कनेक्ट कर सकते हैं ताकि सेशन के नतीजों को स्टोर और मैनेज किया जा सके। आप क्लाउड स्टोरेज जैसे Dask स्टोरेज या लोकल रन के लिए SQLite का उपयोग कर सकते हैं।
हाइपरपैरामीटर ट्यूनिंग में आम गलतियों से बचने के लिए कुछ सुझाव:
DataCamp के साथ मशीन लर्निंग सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें