Cursus
Inzicht in Machine Learning
2 uur
310.9K
Machine learning-modellen hebben hyperparameters die hun prestaties sterk beïnvloeden. Je kunt deze parameters vergelijken met de juiste oventemperatuur voor een cake of de juiste hoek om een pannenkoek te keren. In reinforcement learning beïnvloeden hyperparameters de policy- en reward-benaderingen, en met beter afgestemde waarden kan hyperparameteroptimalisatie de resultaten drastisch verbeteren.
In dit artikel verkennen we Optuna, een krachtig open-source framework voor het optimaliseren van hyperparameters. Als dit nieuw voor je is, begin dan met Understanding Machine Learning, een no-code introductie. Wil je oefenen met Python, probeer dan onze cursus Machine Learning Fundamentals with Python, die scikit-learn gebruikt. Vervolgens helpt MLOps Concepts je te begrijpen hoe je machine learning-modellen van lokale notebooks naar productieomgevingen brengt. Tot slot is Preprocessing for Machine Learning in Python een zeer relevante cursus voor dit artikel, omdat je daarin leert je data op te schonen en voor te bereiden voor machine learning-modellen.
Optuna is een open-source tool voor hyperparameteroptimalisatie om de hyperparameterzoektocht te automatiseren. Het kan met elk machine learning- of deep learning-framework worden gebruikt. Enkele belangrijke mogelijkheden van Optuna zijn:
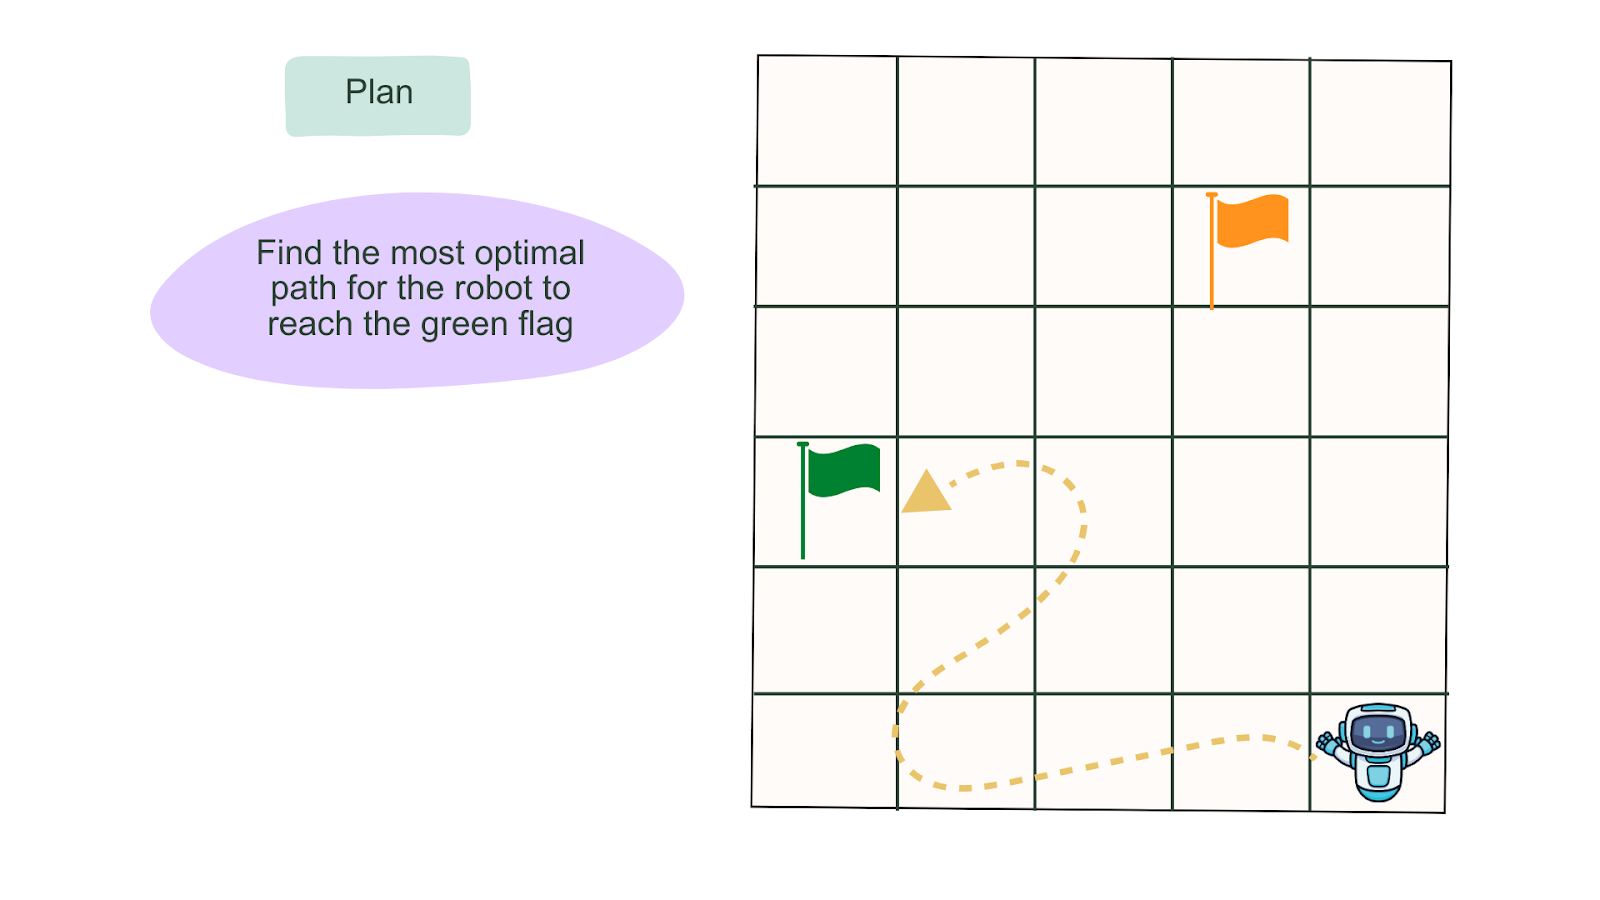
De optimale route vinden. Bron: afbeelding door de auteur
Reinforcement learning (RL) combineert machine learning en optimale regeling. Het gaat erom hoe een intelligente agent zich in een dynamische omgeving moet gedragen om zijn cumulatieve beloning te maximaliseren. Simpel gezegd draait reinforcement learning om het aanleren van de meest optimale beslissingen aan een intelligente agent, zodat die zijn beloningen in een omgeving maximaliseert. De beloning voor elke stap kan positief of negatief zijn, naarmate de agent de gewenste bestemming nadert.
In tegenstelling tot machine learning nemen reinforcement learning-algoritmen beslissingen om de meest optimale resultaten te behalen, vergelijkbaar met het trial-and-error leerproces dat wij gebruiken om doelen te bereiken. Deep reinforcement learning verschilt van reinforcement learning doordat het diepe neurale netwerken gebruikt om complexe functies te benaderen. Je zou ook kunnen zeggen dat regulier reinforcement learning meer op deterministische benaderingen focust, terwijl deep reinforcement learning stochastische benaderingen gebruikt.
In een omgeving kunnen er veel routes naar de bestemming zijn. Vergeleken met supervised learning is deep reinforcement learning veel gevoeliger voor de keuze van hyperparameters, zoals learning rate, gamma, aantal stappen, enzovoort.
Een slechte keuze van hyperparameters kan leiden tot slechte of onstabiele convergentie. Deze uitdaging wordt nog groter door de variabiliteit in prestaties over random seeds (gebruikt om de netwerkgewichten en de omgeving te initialiseren).
In deze sectie lopen we het proces door van het instellen van Optuna en bijbehorende afhankelijkheden, het definiëren van de zoekruimte en het uitvoeren van de optimalisatie voor het MountainCarContinuous-v0-algoritme. Het MountainCarContinuous-v0-algoritme is een van de RL-algoritmen in RL-Zoo, een trainingsframework dat scripts biedt voor het evalueren van agents en het plotten van resultaten. Het MountainCarContinous-v0-algoritme modelleert een omgeving waarin de agent (een auto) probeert zijn doel (de vlag bereiken) te behalen.
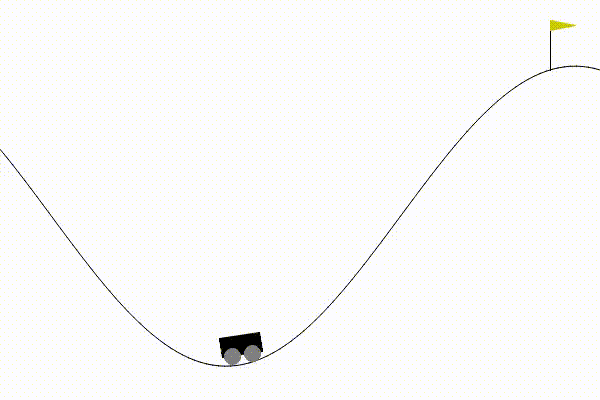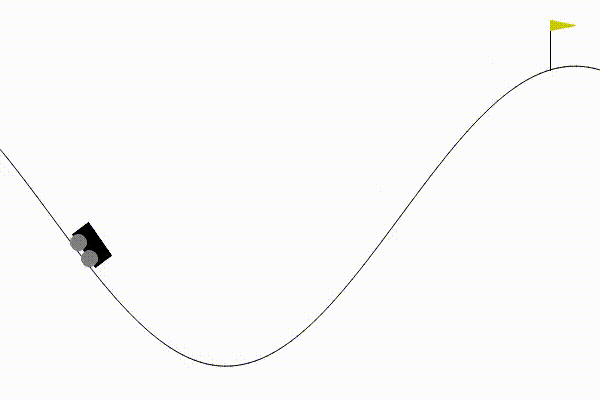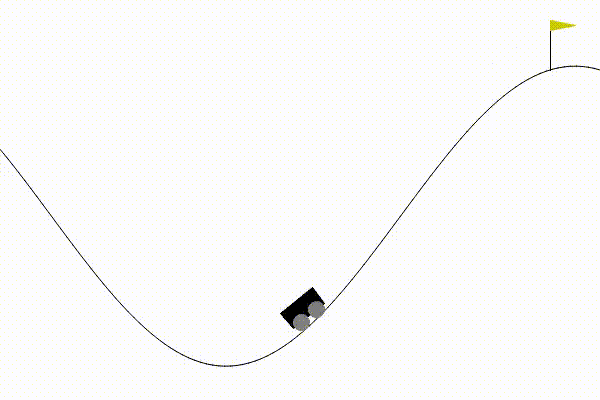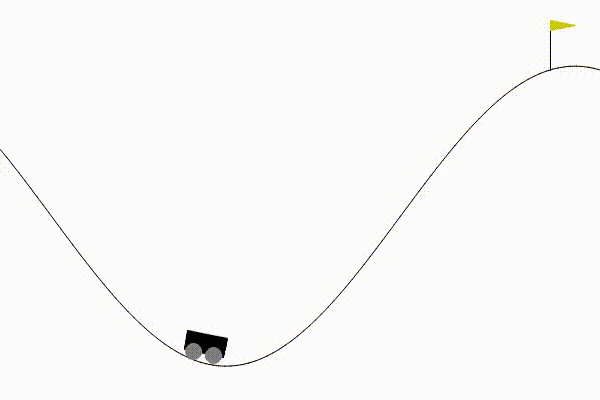
Weergave van het getunede MountainCarContinuous-v0-algoritme. Afbeelding door de auteur.
Om te beginnen moet je het volgende doen:
Na het aanmaken van een nieuwe virtuele omgeving installeren we onze pakketten. Let op: Optuna ondersteunt Python 3.7 of nieuwer. Wil je nog even opfrissen hoe je een virtuele omgeving opzet, lees dan onze tutorial Virtual Environment in Python.
pip install optunapip install stable-baselines3pip install sb3-contribWe gebruiken het gym-pakket om de omgeving te creëren waarin de agent acties zal uitvoeren.
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)Dit project gebruikt het MountainCarContinuous-v0-algoritme met Advantage Actor-Critic (A2C). Advantage Actor-Critic (A2C) — een van de Actor-Critic-algoritmen — is een hybride architectuur die value-based (meet de beloning voor een genomen actie) en policy-based (stuurt de acties van de agent) methoden combineert om de training te stabiliseren door de variantie te verminderen.
Laten we de configuraties instellen die we in deze taak gebruiken.
N_TRIALS = 100 # Maximum number of trialsN_JOBS = 1 # Number of jobs to run in parallelN_STARTUP_TRIALS = 5 # Stop random sampling after N_STARTUP_TRIALSN_EVALUATIONS = 2 # Number of evaluations during the trainingN_TIMESTEPS = 100000 # Training budgetEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutesENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}We stellen een bereik aan waarden voor de hyperparameters voor.
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Sample A2C hyperparameters for Optuna trial.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }Er is een CallBack-functie TrialEvalCallback() gedefinieerd omdat we de periodieke evaluatieresultaten van de optimalisatietaken willen teruggeven. Bekijk het Google Colab-notebook voor de callback-implementatie.
def objective(trial: optuna.Trial) -> float: """ This will be used by Optuna to evaluate one set of hyperparameters at a time.Given a trial object, it will sample hyperparameters, evaluate it and report the result. :param trial: Optuna trial object :return: Mean episodic reward after training """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Sample hyperparameters and update the keyword arguments kwargs.update(a2c_hyper_params(trial)) # 2. Create the RL model model = A2C(**kwargs) # 3. Create envs used for evaluation using make_vec_env, ENV_ID and N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Create the TrialEvalCallback callback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Train the model model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Sometimes, random hyperparams can generate NaN print(e) nan_encountered = True finally: # Free memory model.env.close() eval_envs.close() # Tell the optimizer that the trial failed if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardPruning betekent het terugbrengen van parameters of regio’s in de zoekruimte die minder kans hebben op een optimaal resultaat, in dit geval na een specifiek budget. In Optuna verwijdert pruning de trials die in de vroege stadia van de training slechter presteren. Dit verkleint de parameterruimte en de tijd om de optimale zoekruimte te bereiken. Optuna heeft een aantal pruners, waaronder de Median Pruner, die de mediane stopregel gebruikt. Je kunt meer lezen over Optuna Pruners in de Optuna-documentatie.
Het Median Pruner-algoritme pruned wanneer het huidige beste resultaat slechter is dan de mediaan van eerdere resultaten. De deling door drie wordt gebruikt omdat we pas willen prunen nadat 1/3 van het maximale budget is verbruikt.
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)Kies de sampler, die random kan zijn, TPESampler, CMAES, enz.
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)We zijn nu klaar om een Optuna-studie aan te maken.
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")Laten we eens kijken naar enkele van Optuna’s meer geavanceerde features.
Optuna biedt een dashboard waarmee we eerdere en huidige runs kunnen visualiseren, volgen en analyseren. Voorheen moest je misschien je trackingtool, zoals MLFlow, koppelen om de resultaten te beheren.
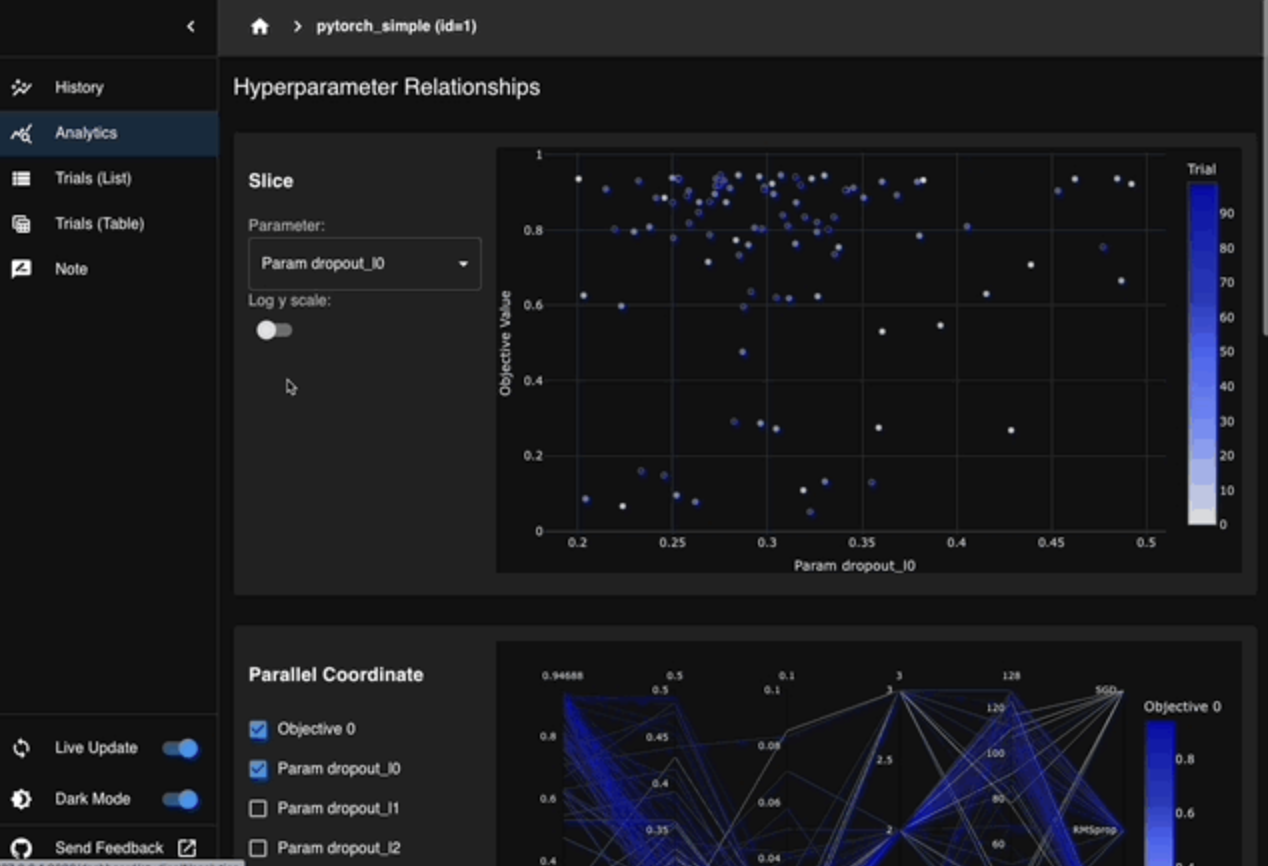
Optuna Dashboard. Bron: Optuna
Dankzij Optuna’s ondersteuning voor gedistribueerde training kun je je gedistribueerde backend, zoals Kubernetes of Dask, koppelen om meer rekenkracht te benutten voor grootschalige experimenten. Je kunt ook je storage-backend koppelen om de resultaten van je sessies op te slaan en te beheren. Je kunt cloudopslag zoals Dask storage gebruiken of SQLite voor lokale runs.
Hier zijn wat tips om veelvoorkomende valkuilen bij hyperparameter-tuning te vermijden:
Leer Machine Learning met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

