Kurs
Machine Learning'i Anlamak
2 sa
314.1K
Makine öğrenimi modellerinin performansını önemli ölçüde etkileyen hiperparametreleri vardır. Bu parametreler, bir keki pişirmek için doğru sıcaklık veya bir krebi çevirmek için doğru açı olarak düşünülebilir. Pekiştirmeli öğrenmede hiperparametreler, politika ve ödül yaklaşımlarını etkiler ve daha iyi ayarlamalarla hiperparametre optimizasyonu sonuçları dramatik biçimde iyileştirebilir.
Bu yazıda, hiperparametreleri optimize etmek için güçlü bir açık kaynak çerçevesi olan Optuna'yı inceleyeceğiz. Konuya yeniyseniz, kod yazmadan bir giriş sunan Makine Öğrenimini Anlamak ile başlamayı düşünebilirsiniz. Python kullanarak pratik yapmak için scikit-learn kullanan Python ile Makine Öğreniminin Temelleri kursumuzu deneyin. Ardından, MLOps Kavramları yerel not defterlerinden üretim ortamlarına geçişi nasıl yapacağınızı anlamanıza yardımcı olacaktır. Son olarak, bu makale için oldukça ilgili olan Python'da Makine Öğrenimi için Ön İşleme kursunu deneyin; çünkü bu kurs, verinizi makine öğrenimi modelleri için temizlemeyi ve hazırlamayı öğretir.
Optuna, hiperparametre aramasını otomatikleştirmek için bir hiperparametre optimizasyon çerçevesi sunan açık kaynaklı bir araçtır. Her türlü makine öğrenimi veya derin öğrenme çerçevesiyle kullanılabilir. Optuna’nın bazı temel yetenekleri şunlardır:
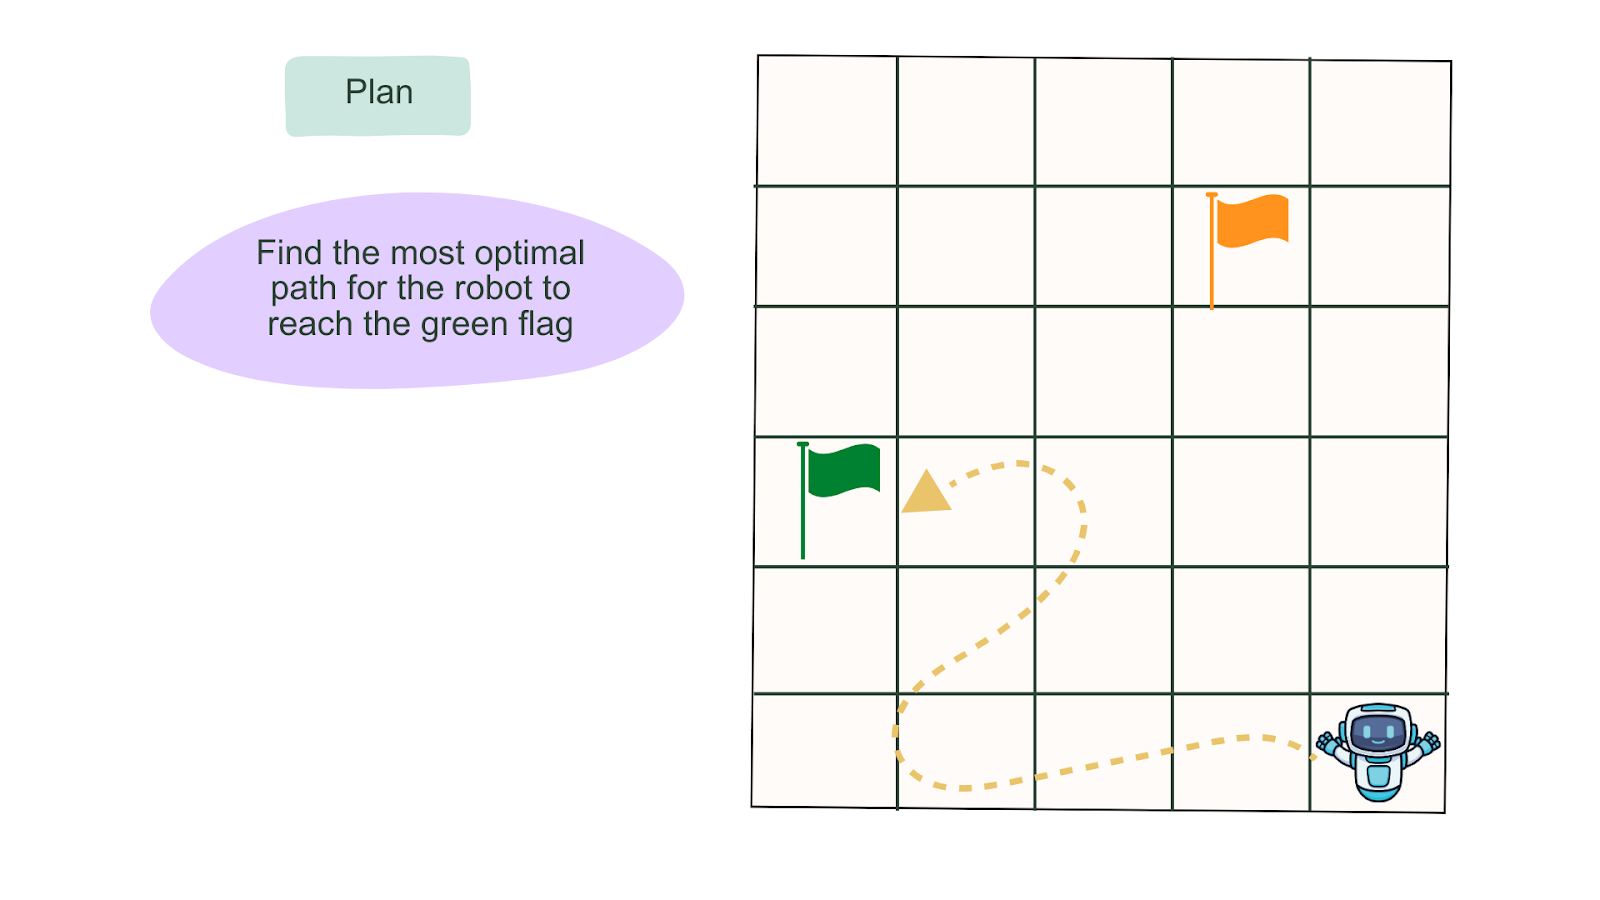
En uygun yolu bulmak. Kaynak: Yazarın görseli
Pekiştirmeli öğrenme (RL), makine öğrenimi ile optimal kontrolü birleştirir. Akıllı bir ajanın dinamik bir ortamda kümülatif ödülünü en üst düzeye çıkarmak için nasıl hareket etmesi gerektiğiyle ilgilenir. Basitçe söylemek gerekirse, pekiştirmeli öğrenme bir ajana, bir ortamda ödüllerini maksimize eden en optimal kararları almayı öğretmekle ilgilidir. Ajanın attığı her adım için ödül, hedefe yaklaştıkça pozitif veya negatif olabilir.
Makine öğreniminden farklı olarak, pekiştirmeli öğrenme algoritmaları hedeflerimize ulaşmak için kullandığımız deneme-yanılma öğrenme sürecine benzer şekilde, en optimal sonuçları elde etmek için kararlar verir. Derin pekiştirmeli öğrenme ise karmaşık fonksiyonları yaklaştırmak için derin sinir ağlarını kullanmasıyla ayrışır. Ayrıca, klasik pekiştirmeli öğrenmenin daha belirleyici (deterministik) yaklaşımlara odaklandığını, derin pekiştirmeli öğrenmenin ise stokastik yaklaşımlar kullandığını söyleyebiliriz.
Bir ortamda hedefe ulaşmak için birçok rota olabilir. Gözetimli öğrenmeyle karşılaştırıldığında, derin pekiştirmeli öğrenmenin öğrenme oranı, gamma, adım sayısı gibi hiperparametrelerin seçimine çok daha duyarlı olduğunu unutmayın.
Kötü hiperparametre seçimleri zayıf/kararsız yakınsamaya yol açabilir. Bu zorluk, ağ ağırlıklarını ve ortamı başlatmak için kullanılan rastgele tohumlar arasındaki performans değişkenliğiyle daha da artar.
Bu bölümde, Optuna ve ilgili bağımlılıkların kurulumu, arama uzayının tanımlanması ve MountainCarContinuous-v0 algoritması için optimizasyonun çalıştırılması sürecini adım adım inceleyeceğiz. MountainCarContinuous-v0, ajanları değerlendirmek ve sonuçları çizmek için betikler sunan bir eğitim çerçevesi olan RL-Zoo içindeki RL algoritmalarından biridir. MountainCarContinous-v0 algoritması, ajanın (bir araba) hedefine (bayrağa ulaşmak) çalıştığı bir ortamı modeller.
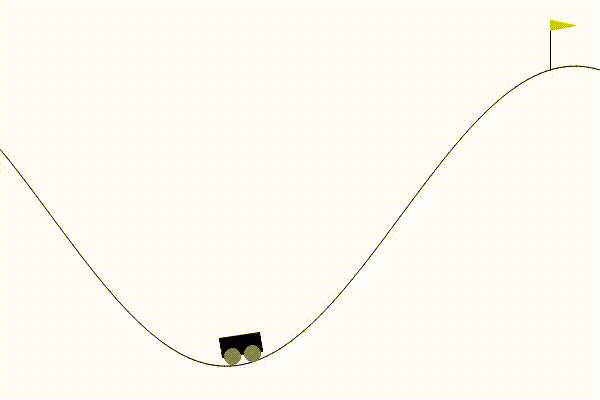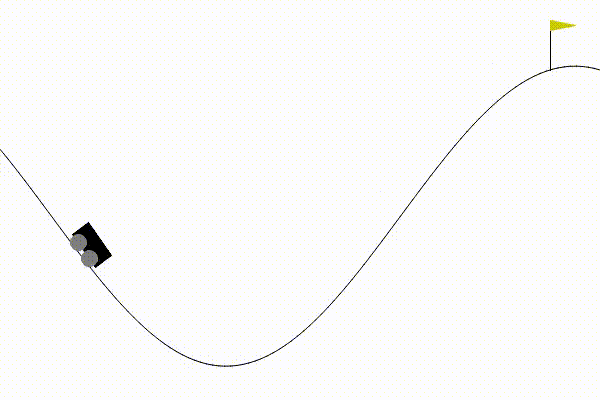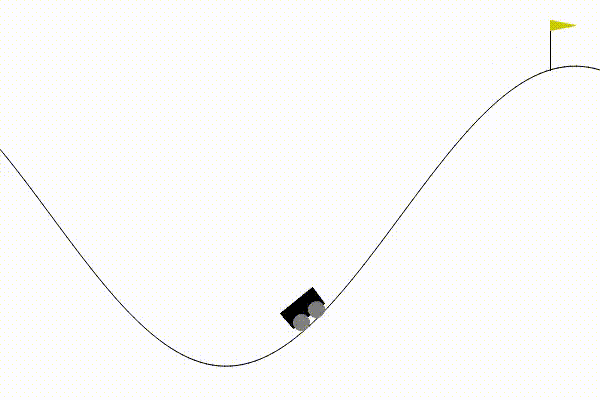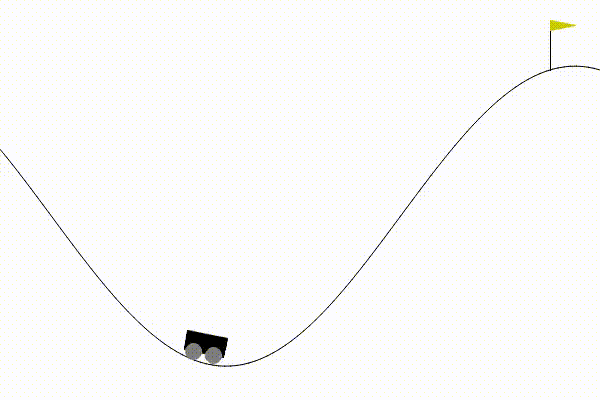
Ayarlanmış MountainCarContinuous-v0 algoritmasının temsili. Yazarın görseli.
Başlamak için şunlara ihtiyacınız var:
Yeni bir sanal ortam oluşturduktan sonra paketlerimizi kuruyoruz. Not olarak, Optuna Python 3.7 veya daha yenisini destekler. Bir sanal ortam kurulumunu gözden geçirmek isterseniz, Python'da Sanal Ortam eğitimimizi okuyun.
pip install optunapip install stable-baselines3pip install sb3-contribAjanın eylemleri gerçekleştireceği ortamı oluşturmak için gym paketini kullanacağız.
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)Bu projede Advantage Actor-Critic (A2C) içinden MountainCarContinuous-v0 algoritmasını kullanacağız. Advantage Actor-Critic (A2C) — Aktör-Kritik algoritmalarından biri — değer tabanlı (alınan bir eylemin ödülünü ölçen) ve politika tabanlı (ajanın eylemlerini kontrol eden) yöntemleri birleştiren hibrit bir mimaridir ve varyansı azaltarak eğitimi stabilize etmeye yardımcı olur.
Bu görevde kullanılacak yapılandırmaları belirleyelim.
N_TRIALS = 100 # Maximum number of trialsN_JOBS = 1 # Number of jobs to run in parallelN_STARTUP_TRIALS = 5 # Stop random sampling after N_STARTUP_TRIALSN_EVALUATIONS = 2 # Number of evaluations during the trainingN_TIMESTEPS = 100000 # Training budgetEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutesENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}Hiperparametreler için bir değer aralığı önereceğiz.
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Sample A2C hyperparameters for Optuna trial.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }Optimizasyon görevlerinin periyodik değerlendirme sonuçlarını döndürmek istediğimiz için bir CallBack fonksiyonu olan TrialEvalCallback() tanımlanmıştır. Geri çağırma (callback) uygulaması için Google Colab not defterine bakın.
def objective(trial: optuna.Trial) -> float: """ This will be used by Optuna to evaluate one set of hyperparameters at a time.Given a trial object, it will sample hyperparameters, evaluate it and report the result. :param trial: Optuna trial object :return: Mean episodic reward after training """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Sample hyperparameters and update the keyword arguments kwargs.update(a2c_hyper_params(trial)) # 2. Create the RL model model = A2C(**kwargs) # 3. Create envs used for evaluation using make_vec_env, ENV_ID and N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Create the TrialEvalCallback callback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Train the model model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Sometimes, random hyperparams can generate NaN print(e) nan_encountered = True finally: # Free memory model.env.close() eval_envs.close() # Tell the optimizer that the trial failed if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardBudama, optimal sonuç verme olasılığı düşük olan parametreleri veya arama uzayındaki bölgeleri kısmak anlamına gelir; burada belirli bir bütçeden sonra budama yapılır. Optuna’da, eğitimlerin erken aşamalarında daha kötü performans gösteren denemeler budanır. Bu, parametre kümesini ve optimal arama uzayına ulaşma süresini azaltır. Optuna’nın, medyan durdurma kuralını kullanan Median Pruner da dahil olmak üzere birkaç budayıcısı vardır. Optuna Budayıcıları hakkında daha fazlasını Optuna dokümantasyonundan okuyabilirsiniz.
Median Pruner algoritması, mevcut en iyi sonucun önceki sonuçların medyanından daha kötü olması durumunda budar. Üçte bire bölme, yalnızca maksimum bütçenin 1/3’ü kullanıldıktan sonra budama yapmak istediğimiz için kullanılır.
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)Örnekleyiciyi seçin; rastgele, TPESampler, CMAES vb. olabilir.
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)Artık bir Optuna çalışması oluşturmaya hazırız.
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")Optuna’nın daha gelişmiş özelliklerinden bazılarına bakalım.
Optuna, geçmiş ve mevcut çalışmaları görselleştirmenize, takip etmenize ve analiz etmenize olanak tanıyan bir gösterge paneli sunar. Geçmişte, sonuçları yönetmek için MLFlow gibi bir takip aracınızı bağlamanız gerekebilirdi.
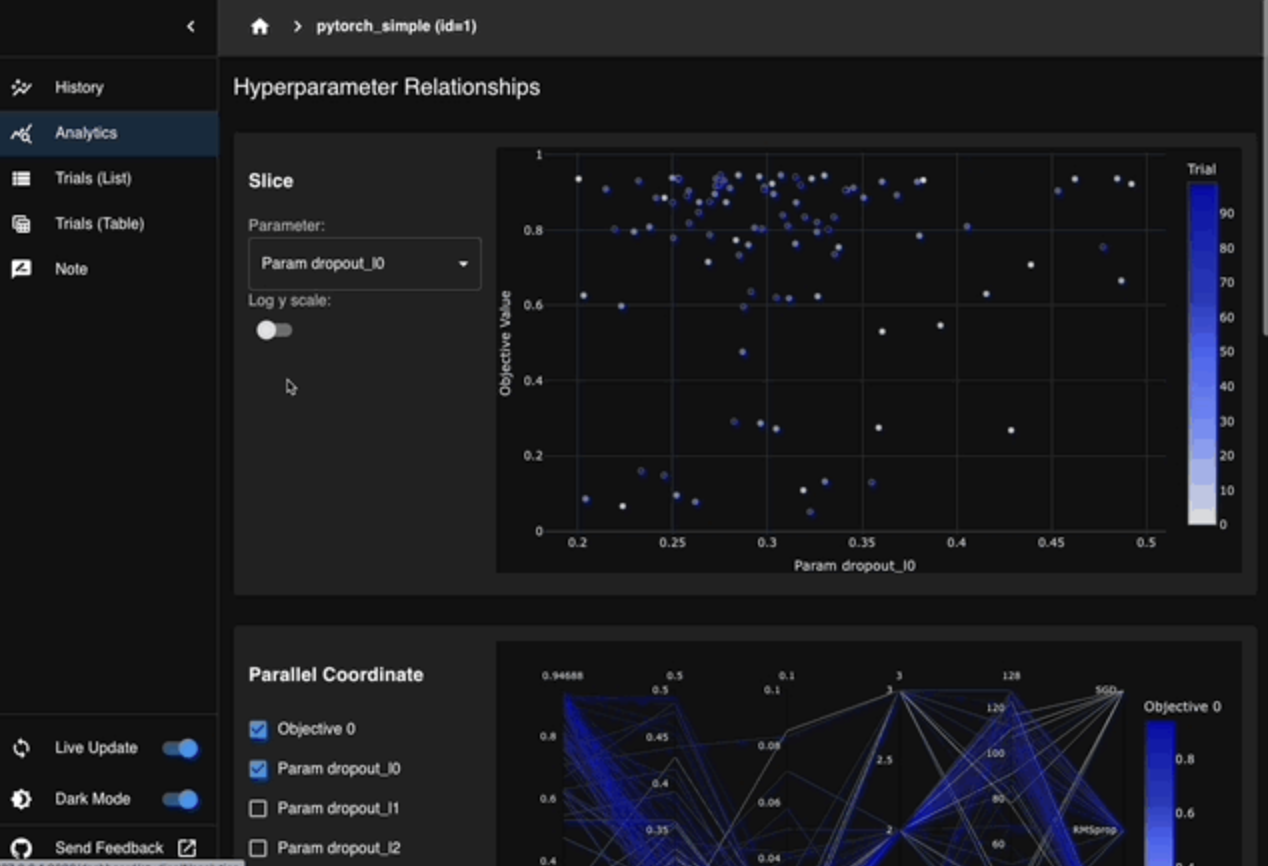
Optuna Dashboard. Kaynak: Optuna
Optuna’nın dağıtık eğitim desteği, Kubernetes veya Dask gibi dağıtık arka uçlara bağlanarak büyük ölçekli deneyler için daha fazla hesaplama kaynağından yararlanmanıza olanak tanır. Ayrıca oturum sonuçlarınızı depolamak ve yönetmek için depolama arka ucunuzu bağlayabilirsiniz. Bulut depolama (ör. Dask storage) kullanabilir veya yerel çalıştırmalar için SQLite tercih edebilirsiniz.
Hiperparametre ayarlamadaki yaygın tuzaklardan kaçınmak için bazı ipuçları:
DataCamp ile Makine Öğrenimi öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




