Statistik t menunjukkan apakah perbedaan yang diamati bermakna atau kemungkinan besar disebabkan oleh variasi acak.
Perbedaan muncul di hampir setiap dataset. Pertanyaan utamanya adalah apakah hasil tersebut mencerminkan efek nyata. Statistik t menjawabnya dengan membandingkan besar perbedaan terhadap ketidakpastian dalam data.
Inilah mengapa statistik t banyak digunakan dalam pengujian hipotesis dan regresi. Statistik ini membantu Anda menilai apakah suatu hasil signifikan secara statistik dan layak diperhatikan.
Dalam panduan ini, Anda akan mempelajari arti statistik t, cara menghitungnya, cara menafsirkannya, dan cara menerapkannya dalam skenario pengujian yang umum.
Apa itu statistik t dalam Statistika?
Statistik t mengukur seberapa jauh suatu hasil dari nilai acuan setelah menyesuaikan dengan variabilitas dalam data.
Secara sederhana, ini adalah perbedaan yang diskalakan oleh ketidakpastian. Hal ini mengubah selisih mentah menjadi nilai baku yang dapat Anda evaluasi.
Pertimbangkan sebuah kelas dengan nilai rata-rata 78 dibandingkan tolok ukur 75. Selisihnya 3 poin. Angka itu saja tidak banyak memberi tahu. Jika nilai-nilainya berkelompok rapat, selisih tersebut mungkin bermakna. Jika nilainya sangat bervariasi, selisih yang sama mungkin tidak berarti.
Statistik t menggabungkan kedua aspek tersebut menjadi satu nilai. Ini menunjukkan apakah perbedaan yang diamati besar relatif terhadap variasi dalam data.
Hal ini penting karena perbedaan yang sama dapat menghasilkan kesimpulan berbeda bergantung pada seberapa stabil data. Statistik t menempatkan hasil dalam konteks sehingga Anda dapat menilai signifikansinya.
Anda akan melihatnya digunakan dalam skenario umum berikut:
- Uji t satu sampel memeriksa apakah rata-rata sampel berbeda dari nilai yang diketahui
- Uji t dua sampel membandingkan rata-rata dua kelompok
- Uji t berpasangan membandingkan kelompok yang sama sebelum dan sesudah perubahan
- Analisis regresi menguji apakah suatu koefisien berbeda dari nol
Dalam semua kasus ini, logikanya tetap sama: ukur jarak dari titik acuan, sesuaikan dengan variabilitas, dan evaluasi apakah hasilnya bermakna.
Rumus Statistik t dan Cara Menghitungnya
Statistik t mengikuti struktur sederhana. Ini membandingkan apa yang Anda amati dengan apa yang Anda harapkan, lalu menskalakan perbedaan itu dengan ketidakpastian.
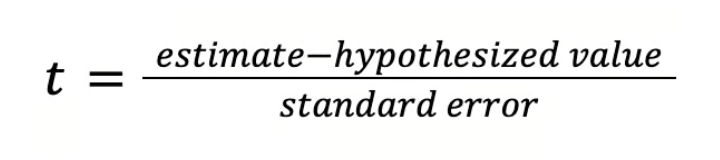
Dalam rumus ini:
-
estimate adalah hasil sampel Anda
-
hypothesized value adalah nilai acuan yang Anda uji
-
standard error mengukur seberapa besar estimasi Anda dapat bervariasi karena keacakan
Jadi statistik t memberi tahu Anda berapa banyak simpangan baku kesalahan jarak hasil Anda dari nilai yang diuji.
Statistik t satu sampel
Gunakan ini saat Anda membandingkan satu rata-rata sampel dengan nilai yang diketahui.
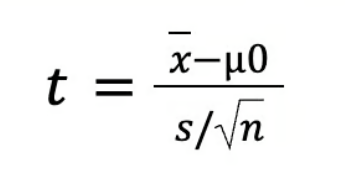
Berikut ini:
-
x adalah rata-rata sampel
-
μ0 adalah nilai hipotesis
-
s adalah simpangan baku sampel
-
n adalah ukuran sampel
Penyebut s/n adalah galat baku dari mean.
Statistik t dua sampel (sampel independen)
Uji ini membandingkan rata-rata dua kelompok terpisah. Strukturnya tetap konsisten:
- Pembilang: selisih antara dua rata-rata sampel
- Penyebut: galat baku dari selisih tersebut
Namun ada sedikit perubahan: Saat menghitung galat baku, Anda perlu memutuskan bagaimana memperlakukan variabilitas di kedua kelompok.
Ada dua pendekatan umum.
1. Varians tidak sama
Gunakan ini ketika kelompok memiliki tingkat sebaran yang berbeda, yang umum pada data nyata:
- Setiap kelompok mempertahankan variansnya masing-masing
- Kedua varians digabung saat menghitung galat baku
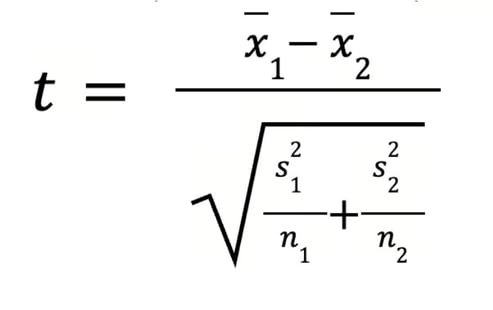
2. Varians sama
Gunakan ini ketika kedua kelompok menunjukkan variabilitas yang serupa:
- Varians digabung menjadi satu estimasi gabungan (pooled)
- Perhitungannya menjadi lebih sederhana
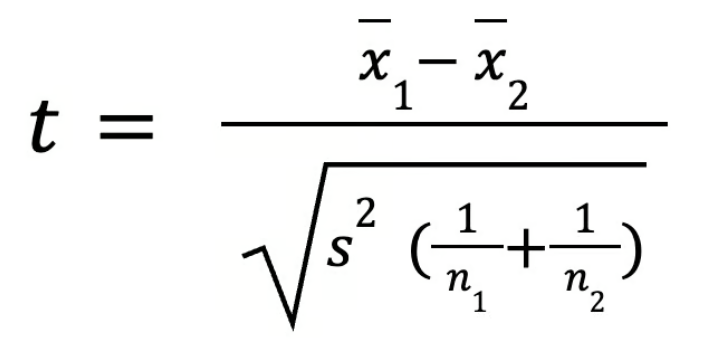
Statistik t koefisien regresi
Dalam regresi, setiap koefisien memiliki statistik t sendiri.
- Pembilang: koefisien yang diestimasi
- Penyebut: galat baku dari koefisien tersebut
Ini menunjukkan apakah suatu prediktor memiliki hubungan yang bermakna dengan variabel keluaran.
Contoh numerik cepat
Pertimbangkan kasus satu sampel:
- Rata-rata sampel = 78
- Nilai hipotesis = 75
- Simpangan baku sampel = 10
- Ukuran sampel = 25
Langkah 1: Hitung galat baku
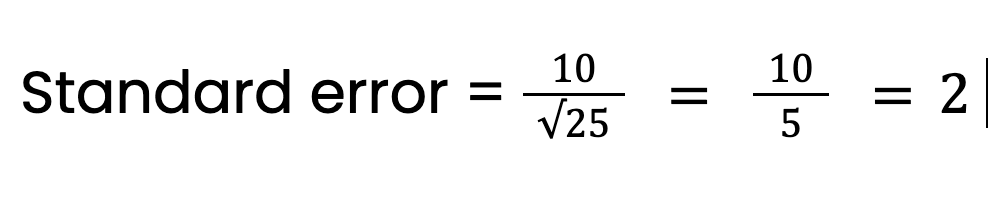
Langkah 2: Temukan selisihnya
Selisih = 78 − 75 = 3
Langkah 3: Hitung statistik t
T = 3/2 = 1,5
Rata-rata sampel berada 1,5 galat baku di atas nilai acuan. Nilai ini digunakan pada langkah berikut untuk menilai signifikansi statistik.
Distribusi t dan Derajat Kebebasan
Statistik t baru menjadi berguna saat Anda membandingkannya dengan distribusi acuan. Acuan tersebut adalah distribusi t.
Distribusi ini menunjukkan seperti apa nilai t ketika tidak ada efek nyata. Setelah Anda menghitung nilai t, Anda memeriksa di mana posisinya pada distribusi ini. Nilai yang jauh dari pusat kecil kemungkinannya terjadi secara kebetulan. Nilai yang dekat pusat lebih konsisten dengan variasi acak.
Apa arti derajat kebebasan
Derajat kebebasan mengendalikan bentuk distribusi t. Ini mencerminkan seberapa banyak informasi andal yang diberikan data Anda: semakin banyak data menghasilkan estimasi yang lebih stabil dan semakin sedikit data meningkatkan ketidakpastian.
Beberapa rumus umumnya adalah:
- Uji t satu sampel: derajat kebebasan = n − 1
- Uji t dua sampel: derajat kebebasan = n₁ + n₂ − 2
- Regresi: derajat kebebasan = n − k − 1, di mana k adalah jumlah prediktor
Bagaimana ukuran sampel memengaruhi distribusi
Dengan sampel kecil, variabilitas lebih sulit diestimasi. Ini membuat nilai t ekstrem lebih mungkin terjadi, sehingga distribusi t menjadi lebih lebar.
Hal ini menghasilkan dua konsekuensi:
- Diperlukan nilai t yang lebih besar untuk menunjukkan signifikansi
- Hasil lebih sulit diklasifikasikan sebagai bermakna
Saat ukuran sampel meningkat, estimasi menjadi lebih stabil. Distribusi t menyempit dan mulai menyerupai distribusi normal. Dengan sampel besar, perbedaan keduanya minimal.
Cara Menafsirkan Statistik t
Statistik t yang lebih besar berarti bukti lebih kuat terhadap hipotesis nol. Statistik t yang lebih kecil berarti hasil tersebut mungkin karena variasi acak.
Itulah gagasan utamanya. Sekarang mari kita buat ini lebih praktis.
Apa yang dikatakan ukuran t kepada Anda
Fokus pada seberapa jauh nilainya dari 0.
- t mendekati 0 > sedikit atau tidak ada perbedaan
- t lebih besar > perbedaan lebih kuat
- t sangat besar > bukti kuat terhadap hipotesis nol
Tanda hanya menunjukkan arah.
- positif > di atas nilai yang diharapkan
- negatif > di bawah nilai yang diharapkan
Untuk interpretasi, besarnya lebih penting daripada tandanya.
Cara mendapatkan p-value
Setelah menghitung statistik t, bandingkan dengan distribusi t. Ini memberikan nilai p, yang menunjukkan seberapa mungkin hasil Anda terjadi di bawah hipotesis nol.
- p kecil > hasil tidak mungkin terjadi di bawah nol, bukti lebih kuat menentangnya
- p besar > hasil mungkin terjadi di bawah nol, bukti lemah
Statistik t memberikan jarak. Nilai p menunjukkan seberapa tidak biasanya jarak tersebut.
Uji satu ekor vs. dua ekor
Pilihan bergantung pada hipotesis Anda:
- Uji dua ekor memeriksa setiap perbedaan, lebih tinggi atau lebih rendah
- Uji satu ekor memeriksa perbedaan dalam arah tertentu
Uji dua ekor lebih umum. Uji satu ekor digunakan hanya ketika arah sudah ditentukan sebelum analisis.
Signifikansi statistik vs. pentingnya praktis
Suatu hasil bisa signifikan secara statistik namun tetap tidak berguna. Ini sering terjadi pada dataset besar.
- Dengan sampel besar, bahkan perbedaan kecil pun dapat tampak signifikan secara statistik
- Dengan sampel kecil, perbedaan bermakna mungkin tidak tampak signifikan
Jadi jangan hanya mengandalkan nilai p. Lihat besarnya efek dan tanyakan apakah itu berarti dalam pengambilan keputusan nyata.
Statistik t dalam Pengujian Hipotesis
Statistik t digunakan untuk menguji apakah suatu hasil berbeda secara bermakna dari nilai acuan, sering kali nol. Nilai acuan itu merepresentasikan tidak ada efek atau tidak ada perbedaan.
Statistik t menjawab satu pertanyaan: apakah hasil yang diamati cukup besar untuk dianggap nyata, bukan variasi acak.
Menguji rata-rata populasi
Gunakan ini saat membandingkan rata-rata sampel dengan nilai yang diketahui atau diasumsikan.
Misalkan waktu rata-rata pada sebuah halaman diharapkan 5 menit dan sampel Anda menunjukkan 6 menit. Statistik t mengevaluasi apakah selisih 1 menit ini bermakna.
- nilai t kecil berarti perbedaan kemungkinan karena kebetulan
- nilai t besar berarti perbedaan kemungkinan nyata
Ini menjadi dasar untuk menolak atau tidak menolak hipotesis nol.
Membandingkan dua rata-rata
Gunakan ini untuk membandingkan dua kelompok independen.
Ambil contoh tingkat konversi untuk dua halaman arahan:
- Kelompok A: desain lama
- Kelompok B: desain baru
Rata-rata yang lebih tinggi pada satu kelompok saja tidak cukup. Statistik t memeriksa apakah selisih antara dua rata-rata tersebut signifikan secara statistik.
Nilai t absolut yang lebih besar berarti bukti lebih kuat bahwa perbedaannya nyata.
Pengujian sampel berpasangan
Gunakan ini ketika kelompok yang sama diukur dua kali.
Misalkan Anda memiliki keterlibatan pengguna sebelum dan sesudah pembaruan fitur. Setiap pengamatan saling berpasangan. Anda bekerja dengan selisih dalam setiap pasangan, bukan membandingkan kelompok terpisah.
Statistik t menguji apakah perubahan rata-rata di seluruh pasangan berbeda dari nol. Ini menunjukkan apakah perubahan tersebut memiliki efek yang bermakna.
Menguji koefisien regresi
Dalam regresi, setiap koefisien memiliki statistik t sendiri. Setiap koefisien merepresentasikan hubungan antara prediktor dan keluaran.
Misalkan sebuah koefisien merepresentasikan efek frekuensi email terhadap konversi. Statistik t menguji apakah koefisien tersebut berbeda dari nol.
- nilai mendekati nol berarti sedikit atau tidak ada efek
- nilai jauh dari nol berarti kemungkinan efek bermakna
Ini membantu mengidentifikasi variabel mana yang berkontribusi pada model.
Tabel Statistik t
Tabel t membantu Anda memutuskan apakah hasil Anda signifikan secara statistik. Tabel ini memberikan nilai kritis berdasarkan:
- derajat kebebasan
- tingkat signifikansi yang dipilih (seperti 0,05)
Cara menggunakan tabel t
Ikuti langkah-langkah berikut:
- Hitung statistik t Anda
- Temukan derajat kebebasan Anda
- Pilih tingkat signifikansi Anda
- Lihat nilai kritis di tabel
Sekarang bandingkan hasil Anda dengan nilai kritis:
- Jika nilai t Anda lebih besar dari nilai tabel, artinya signifikan secara statistik
- Jika lebih kecil, maka tidak signifikan secara statistik
|
Derajat Kebebasan (df)
|
0.10
|
0.05
|
0.01
|
|
1
|
6.314
|
12.706
|
63.657
|
|
2
|
2.92
|
4.303
|
9.925
|
|
5
|
2.015
|
2.571
|
4.032
|
|
10
|
1.812
|
2.228
|
3.169
|
|
20
|
1.725
|
2.086
|
2.845
|
|
30
|
1.697
|
2.04
|
2.75
|
|
∞ (sampel sangat besar)
|
1.64
|
1.96
|
2.58
|
Berikut cara membaca tabel ini.
Misalkan:
- Statistik t Anda = 2,3
- Derajat kebebasan = 10
- Tingkat signifikansi = 0,05
Dari tabel:
Sekarang bandingkan:
- t Anda = 2,3
- Nilai tabel = 2,23
Karena 2,3 lebih besar dari 2,23, hasilnya signifikan secara statistik.
Statistik t vs. Statistik z: Apa Bedanya?
Perbedaan utamanya sederhana:
- Gunakan statistik t saat simpangan baku populasi tidak diketahui
- Gunakan statistik z saat simpangan baku populasi diketahui
Pelajari lebih lanjut tentang perbedaan antara statistik t dan statistik z dalam panduan kami.
Kapan menggunakan statistik t
Gunakan statistik t saat bekerja dengan data sampel dan Anda tidak mengetahui simpangan baku populasi.
Ini adalah kasus yang umum. Anda mengestimasi variabilitas menggunakan simpangan baku sampel, yang menimbulkan ketidakpastian. Statistik t menyesuaikan ketidakpastian tersebut, sehingga cocok untuk dataset yang lebih kecil.
Misalkan Anda mengumpulkan data dari 25 pengguna untuk mengestimasi waktu sesi rata-rata. Karena variabilitas populasi yang sebenarnya tidak diketahui, Anda menggunakan statistik t.
Kapan menggunakan statistik z
Gunakan statistik z saat simpangan baku populasi diketahui.
Ini lebih jarang, tetapi dapat diterapkan di lingkungan terkontrol atau ketika Anda memiliki data historis yang stabil. Statistik z juga digunakan pada sampel yang sangat besar, di mana simpangan baku sampel sangat mendekati nilai populasi.
Jika sebuah perusahaan memiliki data jangka panjang dan mengetahui simpangan baku suatu metrik secara tepat, mereka dapat menggunakan statistik z untuk pengujian.
Mengapa ukuran sampel penting
Ukuran sampel memengaruhi seberapa besar ketidakpastian dalam estimasi Anda.
- sampel kecil: ketidakpastian lebih tinggi sehingga statistik t lebih tepat
- sampel besar: ketidakpastian lebih rendah sehingga statistik z menjadi masuk akal
Distribusi t memperhitungkan ini dengan menjadi lebih lebar untuk sampel kecil, yang menghasilkan hasil yang lebih konservatif.
Bagaimana t dan z menjadi serupa
Seiring bertambahnya ukuran sampel, perbedaan antara kedua metode menjadi minimal. Dengan dataset besar, kedua pendekatan menghasilkan hasil yang hampir identik. Inilah sebabnya statistik z sering digunakan sebagai pendekatan perkiraan dalam analisis skala besar.
Statistik t vs. Uji t: Apa Bedanya?
Statistik t adalah satu nilai, dan uji t adalah keseluruhan proses pengambilan keputusan. Mari pahami keduanya:
Apa itu statistik t?
Kita sudah banyak membahas ini, tetapi saya tekankan lagi: Statistik t dihitung dari data sampel Anda. Ini menunjukkan seberapa jauh hasil Anda dari nilai hipotesis nol, biasanya nol.
Ini memberi Anda ukuran perbedaan relatif terhadap variabilitas dalam data. Sendirian, ini tidak memberi tahu apakah hasilnya signifikan.
Apa itu uji t?
Uji t adalah cara spesifik melakukan uji hipotesis.
Ini mencakup:
- mendefinisikan hipotesis nol dan alternatif
- menghitung statistik t (di atas)
- menemukan nilai p atau nilai kritis
- membuat keputusan berdasarkan hasil
Proses ini menentukan apakah perbedaan yang diamati signifikan secara statistik.
Bagaimana keduanya bekerja bersama
Statistik t adalah salah satu langkah dalam uji t.
Anda menghitung nilai t terlebih dahulu. Lalu Anda menggunakannya untuk mendapatkan nilai p atau membandingkannya dengan nilai kritis. Langkah terakhir itulah yang memungkinkan Anda memutuskan apakah akan menolak hipotesis nol.
Kesalahan Umum Saat Menggunakan Statistik t
Kebanyakan kesalahan berasal dari interpretasi, bukan perhitungan. Statistik t mudah dihitung namun mudah disalahgunakan jika detail penting diabaikan.
Menilai nilai t tanpa konteks
Nilai t yang besar sendirian tidak banyak memberi tahu. Maknanya bergantung pada ukuran sampel dan variabilitas.
Apa yang harus dilakukan:
- menafsirkan nilai t bersama nilai p
- mempertimbangkan ukuran sampel
- memeriksa seberapa besar variasi dalam data
Mengabaikan asumsi kunci
Statistik t bergantung pada beberapa kondisi. Jika tidak terpenuhi, hasilnya bisa tidak andal. Asumsi utamanya adalah:
- data kira-kira berdistribusi normal, terutama untuk sampel kecil
- pengamatan saling independen
Apa yang harus dilakukan:
- periksa distribusi data
- gunakan plot atau statistik ringkasan untuk mengidentifikasi masalah
- gunakan metode alternatif jika asumsi dilanggar
Tertukar antara uji satu ekor dan dua ekor
Memilih uji yang salah mengubah kesimpulan. Uji satu ekor memeriksa satu arah dan uji dua ekor memeriksa kedua arah
Apa yang harus dilakukan:
- tentukan jenis uji sebelum analisis
- gunakan uji dua ekor sebagai default kecuali diperlukan arah spesifik
Menjalankan banyak uji t alih-alih ANOVA
Membandingkan lebih dari dua kelompok dengan banyak uji t meningkatkan risiko positif palsu.
Berikut yang harus dilakukan: Gunakan ANOVA untuk tiga kelompok atau lebih. Lalu, lakukan uji post hoc jika diperlukan
Hanya mengandalkan nilai p
Nilai p yang kecil menunjukkan signifikansi statistik, bukan pentingnya praktis. Pastikan Anda memeriksa ukuran efek dan menilai apakah hasilnya penting dalam keputusan nyata.
Kesimpulan
Perbedaan muncul di semua dataset. Tantangannya adalah mengetahui apakah perbedaan tersebut mencerminkan efek nyata atau variasi acak. Statistik t mengatasinya dengan menskalakan perbedaan berdasarkan ketidakpastian.
Tanpa statistik t, Anda hanya melihat perbedaan. Dengannya, Anda dapat mengevaluasi apakah perbedaan tersebut layak ditindaklanjuti.




Statistik t menunjukkan apakah perbedaan yang diamati bermakna atau kemungkinan besar disebabkan oleh variasi acak.
Perbedaan muncul di hampir setiap dataset. Pertanyaan utamanya adalah apakah hasil tersebut mencerminkan efek nyata. Statistik t menjawabnya dengan membandingkan besar perbedaan terhadap ketidakpastian dalam data.
Inilah mengapa statistik t banyak digunakan dalam pengujian hipotesis dan regresi. Statistik ini membantu Anda menilai apakah suatu hasil signifikan secara statistik dan layak diperhatikan.
Dalam panduan ini, Anda akan mempelajari arti statistik t, cara menghitungnya, cara menafsirkannya, dan cara menerapkannya dalam skenario pengujian yang umum.
Apa itu statistik t dalam Statistika?
Statistik t mengukur seberapa jauh suatu hasil dari nilai acuan setelah menyesuaikan dengan variabilitas dalam data.
Secara sederhana, ini adalah perbedaan yang diskalakan oleh ketidakpastian. Hal ini mengubah selisih mentah menjadi nilai baku yang dapat Anda evaluasi.
Pertimbangkan sebuah kelas dengan nilai rata-rata 78 dibandingkan tolok ukur 75. Selisihnya 3 poin. Angka itu saja tidak banyak memberi tahu. Jika nilai-nilainya berkelompok rapat, selisih tersebut mungkin bermakna. Jika nilainya sangat bervariasi, selisih yang sama mungkin tidak berarti.
Statistik t menggabungkan kedua aspek tersebut menjadi satu nilai. Ini menunjukkan apakah perbedaan yang diamati besar relatif terhadap variasi dalam data.
Hal ini penting karena perbedaan yang sama dapat menghasilkan kesimpulan berbeda bergantung pada seberapa stabil data. Statistik t menempatkan hasil dalam konteks sehingga Anda dapat menilai signifikansinya.
Anda akan melihatnya digunakan dalam skenario umum berikut:
Dalam semua kasus ini, logikanya tetap sama: ukur jarak dari titik acuan, sesuaikan dengan variabilitas, dan evaluasi apakah hasilnya bermakna.
Rumus Statistik t dan Cara Menghitungnya
Statistik t mengikuti struktur sederhana. Ini membandingkan apa yang Anda amati dengan apa yang Anda harapkan, lalu menskalakan perbedaan itu dengan ketidakpastian.
Dalam rumus ini:
estimateadalah hasil sampel Andahypothesized valueadalah nilai acuan yang Anda ujistandard errormengukur seberapa besar estimasi Anda dapat bervariasi karena keacakanJadi statistik t memberi tahu Anda berapa banyak simpangan baku kesalahan jarak hasil Anda dari nilai yang diuji.
Statistik t satu sampel
Gunakan ini saat Anda membandingkan satu rata-rata sampel dengan nilai yang diketahui.
Berikut ini:
xadalah rata-rata sampelμ0adalah nilai hipotesissadalah simpangan baku sampelnadalah ukuran sampelPenyebut s/n adalah galat baku dari mean.
Statistik t dua sampel (sampel independen)
Uji ini membandingkan rata-rata dua kelompok terpisah. Strukturnya tetap konsisten:
Namun ada sedikit perubahan: Saat menghitung galat baku, Anda perlu memutuskan bagaimana memperlakukan variabilitas di kedua kelompok.
Ada dua pendekatan umum.
1. Varians tidak sama
Gunakan ini ketika kelompok memiliki tingkat sebaran yang berbeda, yang umum pada data nyata:
2. Varians sama
Gunakan ini ketika kedua kelompok menunjukkan variabilitas yang serupa:
Statistik t koefisien regresi
Dalam regresi, setiap koefisien memiliki statistik t sendiri.
Ini menunjukkan apakah suatu prediktor memiliki hubungan yang bermakna dengan variabel keluaran.
Contoh numerik cepat
Pertimbangkan kasus satu sampel:
Langkah 1: Hitung galat baku
Langkah 2: Temukan selisihnya
Selisih = 78 − 75 = 3
Langkah 3: Hitung statistik t
T = 3/2 = 1,5
Rata-rata sampel berada 1,5 galat baku di atas nilai acuan. Nilai ini digunakan pada langkah berikut untuk menilai signifikansi statistik.
Distribusi t dan Derajat Kebebasan
Statistik t baru menjadi berguna saat Anda membandingkannya dengan distribusi acuan. Acuan tersebut adalah distribusi t.
Distribusi ini menunjukkan seperti apa nilai t ketika tidak ada efek nyata. Setelah Anda menghitung nilai t, Anda memeriksa di mana posisinya pada distribusi ini. Nilai yang jauh dari pusat kecil kemungkinannya terjadi secara kebetulan. Nilai yang dekat pusat lebih konsisten dengan variasi acak.
Apa arti derajat kebebasan
Derajat kebebasan mengendalikan bentuk distribusi t. Ini mencerminkan seberapa banyak informasi andal yang diberikan data Anda: semakin banyak data menghasilkan estimasi yang lebih stabil dan semakin sedikit data meningkatkan ketidakpastian.
Beberapa rumus umumnya adalah:
Bagaimana ukuran sampel memengaruhi distribusi
Dengan sampel kecil, variabilitas lebih sulit diestimasi. Ini membuat nilai t ekstrem lebih mungkin terjadi, sehingga distribusi t menjadi lebih lebar.
Hal ini menghasilkan dua konsekuensi:
Saat ukuran sampel meningkat, estimasi menjadi lebih stabil. Distribusi t menyempit dan mulai menyerupai distribusi normal. Dengan sampel besar, perbedaan keduanya minimal.
Cara Menafsirkan Statistik t
Statistik t yang lebih besar berarti bukti lebih kuat terhadap hipotesis nol. Statistik t yang lebih kecil berarti hasil tersebut mungkin karena variasi acak.
Itulah gagasan utamanya. Sekarang mari kita buat ini lebih praktis.
Apa yang dikatakan ukuran t kepada Anda
Fokus pada seberapa jauh nilainya dari 0.
Tanda hanya menunjukkan arah.
Untuk interpretasi, besarnya lebih penting daripada tandanya.
Cara mendapatkan p-value
Setelah menghitung statistik t, bandingkan dengan distribusi t. Ini memberikan nilai p, yang menunjukkan seberapa mungkin hasil Anda terjadi di bawah hipotesis nol.
Statistik t memberikan jarak. Nilai p menunjukkan seberapa tidak biasanya jarak tersebut.
Uji satu ekor vs. dua ekor
Pilihan bergantung pada hipotesis Anda:
Uji dua ekor lebih umum. Uji satu ekor digunakan hanya ketika arah sudah ditentukan sebelum analisis.
Signifikansi statistik vs. pentingnya praktis
Suatu hasil bisa signifikan secara statistik namun tetap tidak berguna. Ini sering terjadi pada dataset besar.
Jadi jangan hanya mengandalkan nilai p. Lihat besarnya efek dan tanyakan apakah itu berarti dalam pengambilan keputusan nyata.
Statistik t dalam Pengujian Hipotesis
Statistik t digunakan untuk menguji apakah suatu hasil berbeda secara bermakna dari nilai acuan, sering kali nol. Nilai acuan itu merepresentasikan tidak ada efek atau tidak ada perbedaan.
Statistik t menjawab satu pertanyaan: apakah hasil yang diamati cukup besar untuk dianggap nyata, bukan variasi acak.
Menguji rata-rata populasi
Gunakan ini saat membandingkan rata-rata sampel dengan nilai yang diketahui atau diasumsikan.
Misalkan waktu rata-rata pada sebuah halaman diharapkan 5 menit dan sampel Anda menunjukkan 6 menit. Statistik t mengevaluasi apakah selisih 1 menit ini bermakna.
Ini menjadi dasar untuk menolak atau tidak menolak hipotesis nol.
Membandingkan dua rata-rata
Gunakan ini untuk membandingkan dua kelompok independen.
Ambil contoh tingkat konversi untuk dua halaman arahan:
Rata-rata yang lebih tinggi pada satu kelompok saja tidak cukup. Statistik t memeriksa apakah selisih antara dua rata-rata tersebut signifikan secara statistik.
Nilai t absolut yang lebih besar berarti bukti lebih kuat bahwa perbedaannya nyata.
Pengujian sampel berpasangan
Gunakan ini ketika kelompok yang sama diukur dua kali.
Misalkan Anda memiliki keterlibatan pengguna sebelum dan sesudah pembaruan fitur. Setiap pengamatan saling berpasangan. Anda bekerja dengan selisih dalam setiap pasangan, bukan membandingkan kelompok terpisah.
Statistik t menguji apakah perubahan rata-rata di seluruh pasangan berbeda dari nol. Ini menunjukkan apakah perubahan tersebut memiliki efek yang bermakna.
Menguji koefisien regresi
Dalam regresi, setiap koefisien memiliki statistik t sendiri. Setiap koefisien merepresentasikan hubungan antara prediktor dan keluaran.
Misalkan sebuah koefisien merepresentasikan efek frekuensi email terhadap konversi. Statistik t menguji apakah koefisien tersebut berbeda dari nol.
Ini membantu mengidentifikasi variabel mana yang berkontribusi pada model.
Tabel Statistik t
Tabel t membantu Anda memutuskan apakah hasil Anda signifikan secara statistik. Tabel ini memberikan nilai kritis berdasarkan:
Cara menggunakan tabel t
Ikuti langkah-langkah berikut:
Sekarang bandingkan hasil Anda dengan nilai kritis:
Derajat Kebebasan (df)
0.10
0.05
0.01
1
6.314
12.706
63.657
2
2.92
4.303
9.925
5
2.015
2.571
4.032
10
1.812
2.228
3.169
20
1.725
2.086
2.845
30
1.697
2.04
2.75
∞ (sampel sangat besar)
1.64
1.96
2.58
Berikut cara membaca tabel ini.
Misalkan:
Dari tabel:
Sekarang bandingkan:
Karena 2,3 lebih besar dari 2,23, hasilnya signifikan secara statistik.
Statistik t vs. Statistik z: Apa Bedanya?
Perbedaan utamanya sederhana:
Pelajari lebih lanjut tentang perbedaan antara statistik t dan statistik z dalam panduan kami.
Kapan menggunakan statistik t
Gunakan statistik t saat bekerja dengan data sampel dan Anda tidak mengetahui simpangan baku populasi.
Ini adalah kasus yang umum. Anda mengestimasi variabilitas menggunakan simpangan baku sampel, yang menimbulkan ketidakpastian. Statistik t menyesuaikan ketidakpastian tersebut, sehingga cocok untuk dataset yang lebih kecil.
Misalkan Anda mengumpulkan data dari 25 pengguna untuk mengestimasi waktu sesi rata-rata. Karena variabilitas populasi yang sebenarnya tidak diketahui, Anda menggunakan statistik t.
Kapan menggunakan statistik z
Gunakan statistik z saat simpangan baku populasi diketahui.
Ini lebih jarang, tetapi dapat diterapkan di lingkungan terkontrol atau ketika Anda memiliki data historis yang stabil. Statistik z juga digunakan pada sampel yang sangat besar, di mana simpangan baku sampel sangat mendekati nilai populasi.
Jika sebuah perusahaan memiliki data jangka panjang dan mengetahui simpangan baku suatu metrik secara tepat, mereka dapat menggunakan statistik z untuk pengujian.
Mengapa ukuran sampel penting
Ukuran sampel memengaruhi seberapa besar ketidakpastian dalam estimasi Anda.
Distribusi t memperhitungkan ini dengan menjadi lebih lebar untuk sampel kecil, yang menghasilkan hasil yang lebih konservatif.
Bagaimana t dan z menjadi serupa
Seiring bertambahnya ukuran sampel, perbedaan antara kedua metode menjadi minimal. Dengan dataset besar, kedua pendekatan menghasilkan hasil yang hampir identik. Inilah sebabnya statistik z sering digunakan sebagai pendekatan perkiraan dalam analisis skala besar.
Statistik t vs. Uji t: Apa Bedanya?
Statistik t adalah satu nilai, dan uji t adalah keseluruhan proses pengambilan keputusan. Mari pahami keduanya:
Apa itu statistik t?
Kita sudah banyak membahas ini, tetapi saya tekankan lagi: Statistik t dihitung dari data sampel Anda. Ini menunjukkan seberapa jauh hasil Anda dari nilai hipotesis nol, biasanya nol.
Ini memberi Anda ukuran perbedaan relatif terhadap variabilitas dalam data. Sendirian, ini tidak memberi tahu apakah hasilnya signifikan.
Apa itu uji t?
Uji t adalah cara spesifik melakukan uji hipotesis.
Ini mencakup:
Proses ini menentukan apakah perbedaan yang diamati signifikan secara statistik.
Bagaimana keduanya bekerja bersama
Statistik t adalah salah satu langkah dalam uji t.
Anda menghitung nilai t terlebih dahulu. Lalu Anda menggunakannya untuk mendapatkan nilai p atau membandingkannya dengan nilai kritis. Langkah terakhir itulah yang memungkinkan Anda memutuskan apakah akan menolak hipotesis nol.
Kesalahan Umum Saat Menggunakan Statistik t
Kebanyakan kesalahan berasal dari interpretasi, bukan perhitungan. Statistik t mudah dihitung namun mudah disalahgunakan jika detail penting diabaikan.
Menilai nilai t tanpa konteks
Nilai t yang besar sendirian tidak banyak memberi tahu. Maknanya bergantung pada ukuran sampel dan variabilitas.
Apa yang harus dilakukan:
Mengabaikan asumsi kunci
Statistik t bergantung pada beberapa kondisi. Jika tidak terpenuhi, hasilnya bisa tidak andal. Asumsi utamanya adalah:
Apa yang harus dilakukan:
Tertukar antara uji satu ekor dan dua ekor
Memilih uji yang salah mengubah kesimpulan. Uji satu ekor memeriksa satu arah dan uji dua ekor memeriksa kedua arah
Apa yang harus dilakukan:
Menjalankan banyak uji t alih-alih ANOVA
Membandingkan lebih dari dua kelompok dengan banyak uji t meningkatkan risiko positif palsu.
Berikut yang harus dilakukan: Gunakan ANOVA untuk tiga kelompok atau lebih. Lalu, lakukan uji post hoc jika diperlukan
Hanya mengandalkan nilai p
Nilai p yang kecil menunjukkan signifikansi statistik, bukan pentingnya praktis. Pastikan Anda memeriksa ukuran efek dan menilai apakah hasilnya penting dalam keputusan nyata.
Kesimpulan
Perbedaan muncul di semua dataset. Tantangannya adalah mengetahui apakah perbedaan tersebut mencerminkan efek nyata atau variasi acak. Statistik t mengatasinya dengan menskalakan perbedaan berdasarkan ketidakpastian.
Tanpa statistik t, Anda hanya melihat perbedaan. Dengannya, Anda dapat mengevaluasi apakah perbedaan tersebut layak ditindaklanjuti.