¡Última oportunidad! 50 % de descuento en todo
La oferta termina dentro de
El estadístico t indica si una diferencia observada es relevante o probablemente se debe al azar.
Las diferencias aparecen en casi cualquier conjunto de datos. La gran pregunta es si el resultado refleja un efecto real. El estadístico t responde comparando el tamaño de la diferencia con la incertidumbre de los datos.
Por eso se usa ampliamente en contrastes de hipótesis y regresión. Te ayuda a juzgar si un resultado es estadísticamente significativo y merece atención.
En esta guía aprenderás qué significa el estadístico t, cómo se calcula, cómo interpretarlo y cómo aplicarlo en escenarios de prueba habituales.
El estadístico t mide cuán lejos está un resultado de un valor de referencia tras ajustar por la variabilidad de los datos.
En pocas palabras, es la diferencia escalada por la incertidumbre. Así conviertes una brecha en bruto en un valor estandarizado que puedes evaluar.
Imagina una clase con una media de 78 frente a un valor de referencia de 75. La diferencia es de 3 puntos. Ese número por sí solo dice poco. Si las notas están muy agrupadas, la brecha puede ser significativa. Si varían mucho, esa misma brecha podría no importar.
El estadístico t combina ambas piezas en un único valor. Muestra si la diferencia observada es grande en relación con la variación de los datos.
Esto es clave porque la misma diferencia puede llevar a conclusiones distintas según lo estables que sean los datos. El estadístico t pone el resultado en contexto para que puedas juzgar su relevancia.
Lo verás en escenarios comunes:
En todos estos casos, la lógica es la misma: medir la distancia a un punto de referencia, ajustar por variabilidad y evaluar si el resultado es relevante.
El estadístico t sigue una estructura sencilla. Compara lo observado con lo esperado y escala esa diferencia por la incertidumbre.
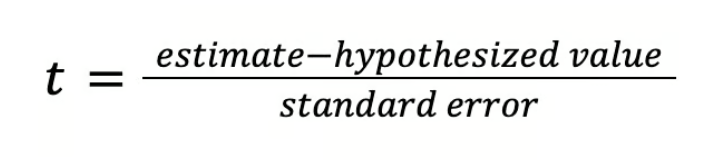
En esta fórmula:
La estimate es tu resultado muestral
El hypothesized value es el valor frente al que contrastas
standard error mide cuánto puede variar tu estimación por azar
Así, el estadístico t te dice a cuántos errores estándar está tu resultado del valor que contrastas.
Úsalo cuando comparas una media muestral con un valor conocido.
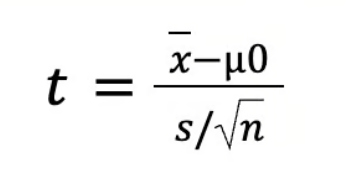
Aquí:
x es la media muestral
μ0 es el valor hipotetizado
s es la desviación estándar muestral
n es el tamaño muestral
El denominador s/n es el error estándar de la media.
Esta prueba compara las medias de dos grupos distintos. La estructura se mantiene:
Pero hay un matiz: al calcular el error estándar debes decidir cómo tratar la variabilidad de ambos grupos.
Hay dos enfoques comunes.
Úsalo cuando los grupos tienen distinta dispersión, algo habitual en datos reales:
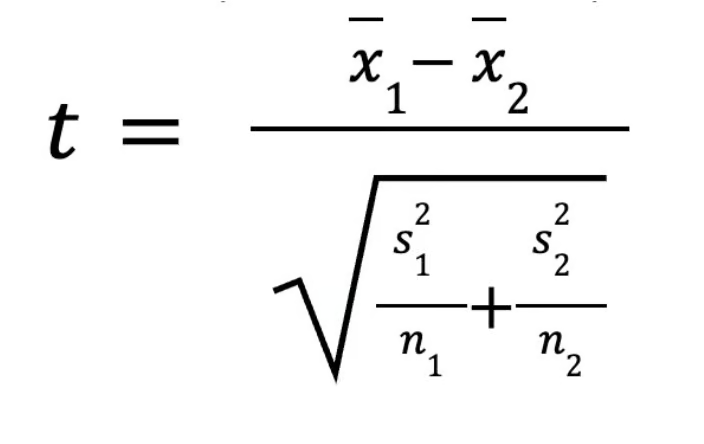
Úsalo cuando ambos grupos muestran una variabilidad similar:
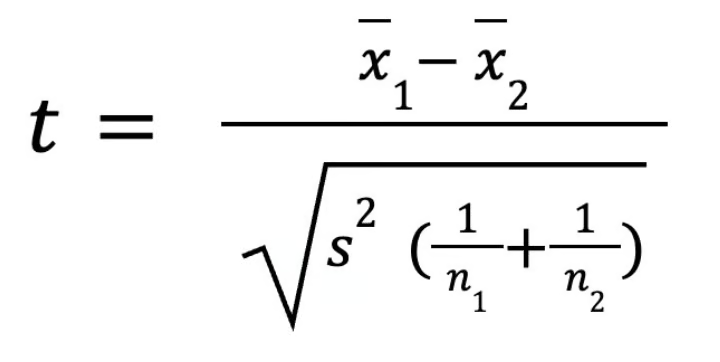
En regresión, cada coeficiente tiene su propio estadístico t.
Esto muestra si un predictor guarda una relación significativa con la variable de salida.
Considera un caso de una muestra:
Paso 1: calcula el error estándar
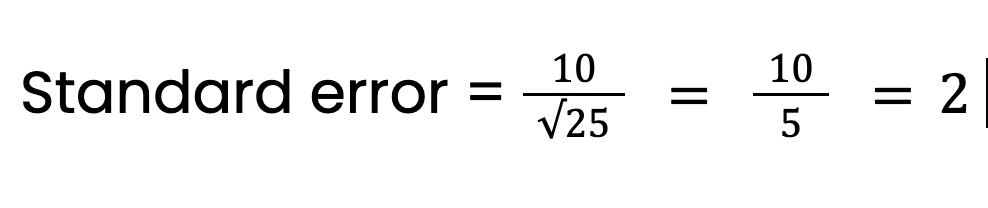
Paso 2: calcula la diferencia
Diferencia = 78 − 75 = 3
Paso 3: calcula el estadístico t
t = 3/2 = 1,5
La media muestral está a 1,5 errores estándar por encima del valor de referencia. Este valor se usa en el siguiente paso para evaluar la significación estadística.
El estadístico t solo es útil al compararlo con una distribución de referencia: la distribución t.
Muestra cómo son los valores t cuando no hay efecto real. Una vez calculas un t, compruebas dónde cae en esta distribución. Los valores alejados del centro son menos probables por azar. Los cercanos al centro son más consistentes con la variación aleatoria.
Los grados de libertad controlan la forma de la distribución t. Reflejan cuánta información fiable aportan tus datos: más datos dan estimaciones más estables y menos datos aumentan la incertidumbre.
Algunas fórmulas comunes son:
Con muestras pequeñas es más difícil estimar la variabilidad. Esto hace más probables los valores t extremos, por lo que la distribución t es más ancha.
Esto implica dos consecuencias:
A medida que aumenta el tamaño muestral, las estimaciones se estabilizan. La distribución t se estrecha y se aproxima a la normal. Con muestras grandes, la diferencia entre ambas es mínima.
Un estadístico t mayor implica evidencias más sólidas contra la hipótesis nula. Un t pequeño sugiere que el resultado puede deberse al azar.
Esa es la idea central. Ahora vamos a lo práctico.
Fíjate en cuán lejos está el valor de 0.
El signo solo indica la dirección.
Para interpretar, importa más la magnitud que el signo.
Tras calcular el estadístico t, compáralo con la distribución t. Así obtienes el p-valor, que indica cuán probable es tu resultado bajo la hipótesis nula.
El estadístico t da la distancia. El p-valor muestra cuán inusual es esa distancia.
La elección depende de tu hipótesis:
Las pruebas bilaterales son más comunes. Las unilaterales se usan solo si la dirección se define antes del análisis.
Un resultado puede ser estadísticamente significativo y aun así no ser útil. Esto ocurre a menudo con conjuntos de datos grandes.
Así que no te quedes solo con el p-valor. Mira el tamaño del efecto y valora si importa para tomar decisiones reales.
El estadístico t se usa para comprobar si un resultado difiere de forma relevante de un valor de referencia, a menudo cero. Ese valor representa ausencia de efecto o de diferencia.
Responde a una sola pregunta: si el resultado observado es lo bastante grande como para tratarlo como real y no como variación aleatoria.
Úsalo al comparar una media muestral con un valor conocido o asumido.
Supón que el tiempo medio en una página se espera que sea de 5 minutos y tu muestra muestra 6. El estadístico t evalúa si esa brecha de 1 minuto es relevante.
Esto sienta las bases para rechazar o no rechazar la hipótesis nula.
Úsalo para comparar dos grupos independientes.
Por ejemplo, tasas de conversión de dos landing pages:
Una media más alta en un grupo no basta. El estadístico t comprueba si la brecha entre las dos medias es estadísticamente significativa.
Un valor absoluto de t mayor implica evidencias más fuertes de que la diferencia es real.
Úsalo cuando el mismo grupo se mide dos veces.
Supón que mides la interacción de usuarios antes y después de una actualización. Cada observación está emparejada. Trabajas con las diferencias dentro de cada par en lugar de comparar grupos separados.
El estadístico t contrasta si el cambio medio entre pares difiere de cero. Así ves si el cambio tuvo un efecto relevante.
En regresión, cada coeficiente tiene su propio t. Cada coeficiente representa la relación entre un predictor y el resultado.
Por ejemplo, un coeficiente puede representar el efecto de la frecuencia de emails en las conversiones. El estadístico t comprueba si ese coeficiente difiere de cero.
Esto ayuda a identificar qué variables aportan al modelo.
Una tabla t te ayuda a decidir si tu resultado es estadísticamente significativo. Proporciona valores críticos según:
Sigue estos pasos:
Ahora compara tu resultado con el valor crítico:
|
Grados de libertad (gl) |
0,10 |
0,05 |
0,01 |
|
1 |
6,314 |
12,706 |
63,657 |
|
2 |
2,92 |
4,303 |
9,925 |
|
5 |
2,015 |
2,571 |
4,032 |
|
10 |
1,812 |
2,228 |
3,169 |
|
20 |
1,725 |
2,086 |
2,845 |
|
30 |
1,697 |
2,04 |
2,75 |
|
∞ (muestra muy grande) |
1,64 |
1,96 |
2,58 |
Así es como leer esta tabla.
Supón que:
De la tabla:
Ahora compara:
Como 2,3 es mayor que 2,23, el resultado es estadísticamente significativo.
La diferencia clave es sencilla:
Más información sobre la diferencia entre estadísticos t y z en nuestra guía.
Úsalo cuando trabajes con datos muestrales y no conozcas la desviación estándar poblacional.
Es lo habitual. Estimas la variabilidad con la desviación estándar muestral, lo que introduce incertidumbre. El estadístico t ajusta por esa incertidumbre, por eso es adecuado para conjuntos de datos más pequeños.
Por ejemplo, recoges datos de 25 usuarios para estimar el tiempo medio de sesión. Como la variabilidad poblacional real es desconocida, usas el estadístico t.
Úsalo cuando la desviación estándar poblacional es conocida.
Es menos común, pero puede aplicarse en entornos controlados o con datos históricos estables. También se usa con muestras muy grandes, donde la desviación estándar muestral se aproxima a la poblacional.
Si una empresa tiene datos a largo plazo y conoce exactamente la desviación estándar de una métrica, puede usar el estadístico z para contrastar.
El tamaño muestral afecta a cuánta incertidumbre hay en tus estimaciones.
La distribución t tiene esto en cuenta ensanchándose para muestras pequeñas, lo que conduce a resultados más conservadores.
A medida que aumenta el tamaño muestral, la diferencia entre ambos métodos se hace mínima. Con datos grandes, los dos enfoques producen resultados casi idénticos. Por eso el estadístico z se usa a menudo como aproximación en análisis a gran escala.
El estadístico t es un valor; el t test es el proceso completo de decisión. Veamos ambos:
Ya lo hemos visto, pero lo repito: el estadístico t se calcula a partir de tus datos muestrales. Muestra cuán lejos está tu resultado del valor bajo la hipótesis nula, normalmente cero.
Te da el tamaño de la diferencia en relación con la variabilidad de los datos. Por sí solo, no te dice si el resultado es significativo.
El t test es una forma concreta de realizar un contraste de hipótesis.
Incluye:
Este proceso determina si la diferencia observada es estadísticamente significativa.
El estadístico t es un paso dentro del t test.
Primero calculas el valor t. Luego lo usas para obtener un p-valor o compararlo con un valor crítico. Ese paso final te permite decidir si rechazas la hipótesis nula.
La mayoría de errores vienen de la interpretación, no del cálculo. El estadístico t es fácil de computar pero fácil de malinterpretar si ignoras detalles clave.
Un valor t grande por sí solo dice poco. Su significado depende del tamaño muestral y la variabilidad.
Qué hacer:
El estadístico t depende de algunas condiciones. Si no se cumplen, los resultados pueden ser poco fiables. Los supuestos principales son:
Qué hacer:
Elegir mal la prueba cambia la conclusión. La unilateral comprueba una dirección y la bilateral, ambas direcciones.
Qué hacer:
Comparar más de dos grupos con múltiples t aumenta el riesgo de falsos positivos.
Qué hacer: usa ANOVA para tres o más grupos. Después, completa con pruebas post hoc si es necesario
Un p-valor pequeño muestra significación estadística, no importancia práctica. Asegúrate de revisar el tamaño del efecto y valorar si el resultado importa en decisiones reales.
Las diferencias aparecen en todos los conjuntos de datos. El reto es saber si reflejan un efecto real o variación aleatoria. El estadístico t aborda esto escalando la diferencia según la incertidumbre.
Sin el estadístico t, solo ves diferencias. Con él, puedes evaluar si esas diferencias merecen la pena.
Aprende con DataCamp
Curso
Curso
Curso
blog
Arun Nanda
15 min
blog
Matt Crabtree
10 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Arunn Thevapalan
9 min
Tutorial
Arunn Thevapalan
10 min
Tutorial
Avinash Navlani
10 min