t 统计量用于判断观测到的差异是否有意义,还是更可能由随机波动造成。
几乎每个数据集中都会出现差异。关键问题在于,这个结果是否反映了真实效应。t 统计量通过比较差异大小与数据不确定性来回答这个问题。
因此,它在假设检验和回归分析中被广泛使用。它帮助您判断一个结果是否具有统计显著性,是否值得认真对待。
在本指南中,您将了解 t 统计量的含义、如何计算、如何解读,以及如何在常见检验场景中应用。
统计学中的 t 统计量是什么?
t 统计量衡量在考虑数据变异性后,一个结果与参考值之间相差多远。
通俗地说,它是“按不确定性缩放后的差异”。这会将原始差距转换为一个标准化的数值,便于评估。
设想某班级的平均分为 78,基准为 75。差异是 3 分。这个数字本身信息有限。如果分数分布很集中,这个差距可能有意义;如果分散很大,同样的差距可能无足轻重。
t 统计量将这两部分信息合并为一个值,显示观测差异相对于数据变异性而言是否足够大。
这很重要,因为相同的差异在数据稳定性不同的情况下可能得出不同结论。t 统计量提供上下文,让您判断其显著性。
它常见的应用场景包括:
- 单样本 t 检验:检验样本均值是否不同于已知值
- 双样本 t 检验:比较两个组的均值
- 配对 t 检验:比较同一组在变化前后的差异
- 回归分析:检验系数是否不同于 0
在所有这些情况下,逻辑一致:测量与参考点的距离,按变异性调整,并评估结果是否有意义。
t 统计量的公式与计算方法
t 统计量结构很简单:比较观测与期望的差异,再用不确定性进行缩放。
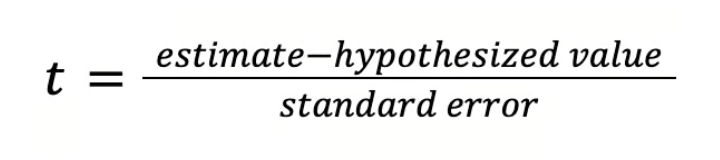
在该公式中:
因此,t 统计量告诉您:您的结果距离被检验的参考值有多少个标准误。
单样本 t 统计量
当您将一个样本的平均值与已知值进行比较时使用。
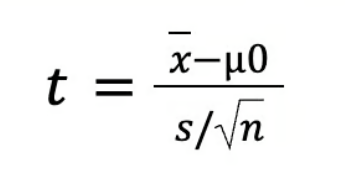
这里:
-
x 为样本均值
-
μ0 为所假设的参考值
-
s 为样本标准差
-
n 为样本量
分母 s/n 是均值的标准误。
双样本 t 统计量(独立样本)
该检验比较两个独立组的均值。结构保持一致:
但这里有个细微变化:计算标准误时,需要决定如何处理两个组的变异性。
常见有两种方法。
1. 方差不等
当两组的离散程度不同(真实数据中很常见)时使用:
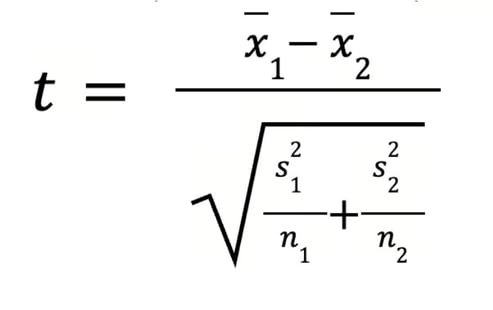
2. 方差相等
当两组的变异性相近时使用:
- 将两组方差合并为一个统一的“合并方差”估计
- 计算更为简化
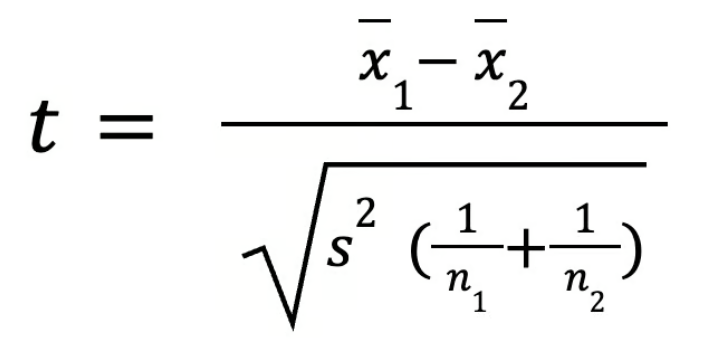
回归系数的 t 统计量
在回归中,每个系数都有自己的 t 统计量。
这用于判断某个自变量与因变量之间是否存在有意义的关系。
一个快速数值示例
考虑单样本情况:
- 样本均值 = 78
- 假设值 = 75
- 样本标准差 = 10
- 样本量 = 25
步骤 1:计算标准误
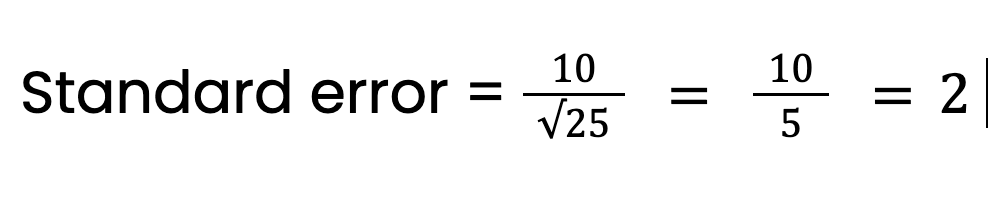
步骤 2:计算差值
差值 = 78 − 75 = 3
步骤 3:计算 t 统计量
T = 3/2 = 1.5
样本均值比参考值高出 1.5 个标准误。下一步将用该值评估统计显著性。
t 分布与自由度
只有将 t 统计量与一个参考分布比较时,它才有用。该参考即为 t 分布。
它展示在“无真实效应”时 t 值的分布形态。计算出 t 值后,查看它在该分布中的位置。离中心越远的值越不可能由偶然产生;靠近中心的值更符合随机波动。
自由度的含义
自由度决定 t 分布的形状。它反映数据提供的可靠信息量:数据越多,估计越稳定;数据越少,不确定性越大。
常见计算公式包括:
- 单样本 t 检验:自由度 = n − 1
- 双样本 t 检验:自由度 = n₁ + n₂ − 2
- 回归:自由度 = n − k − 1,其中 k 为自变量个数
样本量如何影响分布
样本量较小时,变异性更难估计。极端 t 值出现的概率更高,因此 t 分布更宽。
这带来两点结果:
- 需要更大的 t 值才能显示显著性
- 更难将结果判定为有意义
随着样本量增加,估计更稳定。t 分布变窄并趋近正态分布。样本很大时,两者差异极小。
如何解读 t 统计量
t 值越大,反对原假设的证据越强;t 值越小,结果越可能由随机波动造成。
这是核心思想。下面将其落地。
t 的大小说明了什么
关注数值离 0 有多远。
- t 接近 0 > 差异很小或几乎没有差异
- t 越大 > 差异越明显
- t 非常大 > 反对原假设的强有力证据
符号仅表示方向。
在解读中,幅度比符号更重要。
如何得到 p 值
计算出 t 统计量后,与 t 分布比较。这将得到 p 值,表示在原假设成立时您的结果出现的可能性。
- p 值小 > 在原假设下不太可能出现,反对原假设的证据更强
- p 值大 > 在原假设下更可能出现,证据较弱
t 统计量给出“距离”,p 值反映该距离有多不寻常。
单尾检验 vs. 双尾检验
选择取决于您的假设:
- 双尾检验关注任意方向的差异:更高或更低
- 单尾检验只检验特定方向的差异
双尾更常见。仅当在分析前已明确方向时才使用单尾检验。
统计显著性 vs. 实用重要性
一个结果可能具有统计显著性,但并不实用。这在大数据集上很常见。
- 样本很大时,即便很小的差异也可能呈现统计显著
- 样本很小时,即便差异有意义也可能未达显著
因此不要只看 p 值。关注效应量,并思考它在实际决策中是否重要。
假设检验中的 t 统计量
t 统计量用于检验结果是否与参考值(通常为 0)存在有意义差异。该参考代表“无效应/无差异”。
它回答一个问题:观测到的结果是否足够大,值得视为真实效应而非随机波动。
检验总体均值
当将样本均值与已知或假定值比较时使用。
例如,预期页面平均停留时间为 5 分钟,而您的样本显示为 6 分钟。t 统计量用于评估这 1 分钟的差距是否有意义。
- t 值小意味着差异可能由偶然导致
- t 值大意味着差异更可能为真实效应
这构成是否拒绝原假设的依据。
比较两个均值
用于比较两个独立组。
以两个落地页的转化率为例:
某组平均值更高本身并不足够。t 统计量用来检验两组均值差距是否具有统计显著性。
|t| 值越大,差异为真实效应的证据越强。
配对样本检验
用于同一组被测两次的情况。
例如,功能更新前后用户参与度。每个观测成对关联。您处理的是每对内部的差值,而非比较独立组。
t 统计量检验所有配对的平均变化是否不同于 0,从而判断变化是否产生了有意义影响。
检验回归系数
在回归中,每个系数都有自己的 t 统计量。每个系数代表某个自变量与结果之间的关系。
例如,某个系数可能表示邮件发送频率对转化的影响。t 统计量检验该系数是否不同于 0。
- 值接近 0 表示影响很小或几乎没有影响
- 值远离 0 表示可能存在有意义影响
这有助于识别哪些变量对模型有贡献。
t 统计量表
t 表帮助您判断结果是否具有统计显著性。它基于以下因素提供临界值:
如何使用 t 表
按以下步骤进行:
- 计算您的 t 统计量
- 确定自由度
- 选择显著性水平
- 在表中查找临界值
然后将您的结果与临界值比较:
- 若您的 t 值大于 表中数值,则表示统计显著
- 若小于,则不具有统计显著性
|
自由度(df)
|
0.10
|
0.05
|
0.01
|
|
1
|
6.314
|
12.706
|
63.657
|
|
2
|
2.92
|
4.303
|
9.925
|
|
5
|
2.015
|
2.571
|
4.032
|
|
10
|
1.812
|
2.228
|
3.169
|
|
20
|
1.725
|
2.086
|
2.845
|
|
30
|
1.697
|
2.04
|
2.75
|
|
∞(超大样本)
|
1.64
|
1.96
|
2.58
|
以下是如何阅读该表。
假设:
- 您的 t 统计量 = 2.3
- 自由度 = 10
- 显著性水平 = 0.05
从表中查得:
现在比较:
由于 2.3 大于 2.23,结果具有统计显著性。
t 统计量 vs. z 统计量:有何不同?
关键区别很简单:
- 当总体标准差未知时使用 t 统计量
- 当总体标准差已知时使用 z 统计量
在我们的指南中进一步了解t 统计量与 z 统计量的区别。
何时使用 t 统计量
当处理样本数据且未知总体标准差时,使用 t 统计量。
这最为常见。您用样本标准差估计变异性,会引入不确定性。t 统计量对此进行调整,适用于较小数据集。
例如,您收集 25 名用户的数据以估计平均会话时长。由于总体变异性未知,使用 t 统计量。
何时使用 z 统计量
当总体标准差已知时,使用 z 统计量。
这较少见,但可用于受控环境或具备稳定历史数据的场景。在超大样本下也常用,因为样本标准差会非常接近总体值。
如果公司拥有长期数据并知道某指标的精确标准差,则可使用 z 统计量进行检验。
为何样本量重要
样本量影响估计中的不确定性大小。
- 小样本:不确定性高,更适合用 t 统计量
- 大样本:不确定性低,z 统计量更合理
t 分布通过在小样本时更“宽”来反映这一点,从而得出更保守的结果。
t 与 z 如何趋同
随着样本量增大,两种方法的差异趋于最小。大数据集下,两者结果几乎一致。这也是在大规模分析中常用 z 统计量作为近似的原因。
t 统计量 vs. t 检验:有何不同?
t 统计量是一个单一数值,t 检验是一整套决策流程。如下所示:
什么是 t 统计量?
前文已多次提及,但再强调一次:t 统计量由样本数据计算,表示您的结果相对原假设值(通常为 0)相差多远。
它给出相对于数据变异性的差异大小。仅凭它本身,无法判断结果是否显著。
什么是 t 检验?
t 检验是一种具体的假设检验方法。
它包括:
- 定义原假设与备择假设
- 计算 t 统计量(如上)
- 计算 p 值或查找临界值
- 基于结果做出决策
该流程决定观测差异是否具有统计显著性。
二者如何协同
t 统计量是 t 检验中的一个步骤。
您先计算 t 值,再用它得到 p 值或与临界值比较。最后一步帮助决定是否拒绝原假设。
使用 t 统计量的常见错误
多数错误来自解读而非计算。t 统计量易算,但若忽视关键细节也易误用。
脱离上下文评判 t 值
单看一个很大的 t 值并无太多意义。其含义取决于样本量和变异性。
建议:
- 结合 p 值解读 t 值
- 考虑样本量
- 检查数据的变异程度
忽视关键前提假设
t 统计量依赖若干条件。若不满足,结果可能不可靠。主要假设包括:
- 数据大致服从正态分布(尤其在小样本时)
- 观测值彼此独立
建议:
- 检查数据分布
- 使用图形或汇总统计识别问题
- 若假设被严重违背,采用替代方法
混淆单尾与双尾检验
选择错误的检验会改变结论。单尾只检一侧方向,双尾检两侧方向。
建议:
- 在分析前确定检验类型
- 默认使用双尾,除非明确需要特定方向
用多次 t 检验代替 ANOVA
比较两个以上的组时,进行多次 t 检验会增大假阳性的风险。
建议如下:对于三个或以上的组,使用ANOVA。如有需要,再进行事后检验。
只看 p 值
小的 p 值表示统计显著性,而非实用重要性。务必查看效应量,并评估该结果在实际决策中的意义。
结论
所有数据集中都会出现差异。挑战在于判断其是反映真实效应,还是随机波动。t 统计量通过按不确定性缩放差异来解决这一问题。
没有 t 统计量,您只能看到差异;有了它,您可以评估这些差异是否值得付诸行动。


t 统计量用于判断观测到的差异是否有意义,还是更可能由随机波动造成。
几乎每个数据集中都会出现差异。关键问题在于,这个结果是否反映了真实效应。t 统计量通过比较差异大小与数据不确定性来回答这个问题。
因此,它在假设检验和回归分析中被广泛使用。它帮助您判断一个结果是否具有统计显著性,是否值得认真对待。
在本指南中,您将了解 t 统计量的含义、如何计算、如何解读,以及如何在常见检验场景中应用。
统计学中的 t 统计量是什么?
t 统计量衡量在考虑数据变异性后,一个结果与参考值之间相差多远。
通俗地说,它是“按不确定性缩放后的差异”。这会将原始差距转换为一个标准化的数值,便于评估。
设想某班级的平均分为 78,基准为 75。差异是 3 分。这个数字本身信息有限。如果分数分布很集中,这个差距可能有意义;如果分散很大,同样的差距可能无足轻重。
t 统计量将这两部分信息合并为一个值,显示观测差异相对于数据变异性而言是否足够大。
这很重要,因为相同的差异在数据稳定性不同的情况下可能得出不同结论。t 统计量提供上下文,让您判断其显著性。
它常见的应用场景包括:
在所有这些情况下,逻辑一致:测量与参考点的距离,按变异性调整,并评估结果是否有意义。
t 统计量的公式与计算方法
t 统计量结构很简单:比较观测与期望的差异,再用不确定性进行缩放。
在该公式中:
“
estimate”是您的样本结果“
hypothesized value”是您用来检验的参考值standard error(标准误)衡量由于随机性导致估计值可能波动的程度因此,t 统计量告诉您:您的结果距离被检验的参考值有多少个标准误。
单样本 t 统计量
当您将一个样本的平均值与已知值进行比较时使用。
这里:
x为样本均值μ0为所假设的参考值s为样本标准差n为样本量分母 s/n 是均值的标准误。
双样本 t 统计量(独立样本)
该检验比较两个独立组的均值。结构保持一致:
但这里有个细微变化:计算标准误时,需要决定如何处理两个组的变异性。
常见有两种方法。
1. 方差不等
当两组的离散程度不同(真实数据中很常见)时使用:
2. 方差相等
当两组的变异性相近时使用:
回归系数的 t 统计量
在回归中,每个系数都有自己的 t 统计量。
这用于判断某个自变量与因变量之间是否存在有意义的关系。
一个快速数值示例
考虑单样本情况:
步骤 1:计算标准误
步骤 2:计算差值
差值 = 78 − 75 = 3
步骤 3:计算 t 统计量
T = 3/2 = 1.5
样本均值比参考值高出 1.5 个标准误。下一步将用该值评估统计显著性。
t 分布与自由度
只有将 t 统计量与一个参考分布比较时,它才有用。该参考即为 t 分布。
它展示在“无真实效应”时 t 值的分布形态。计算出 t 值后,查看它在该分布中的位置。离中心越远的值越不可能由偶然产生;靠近中心的值更符合随机波动。
自由度的含义
自由度决定 t 分布的形状。它反映数据提供的可靠信息量:数据越多,估计越稳定;数据越少,不确定性越大。
常见计算公式包括:
样本量如何影响分布
样本量较小时,变异性更难估计。极端 t 值出现的概率更高,因此 t 分布更宽。
这带来两点结果:
随着样本量增加,估计更稳定。t 分布变窄并趋近正态分布。样本很大时,两者差异极小。
如何解读 t 统计量
t 值越大,反对原假设的证据越强;t 值越小,结果越可能由随机波动造成。
这是核心思想。下面将其落地。
t 的大小说明了什么
关注数值离 0 有多远。
符号仅表示方向。
在解读中,幅度比符号更重要。
如何得到 p 值
计算出 t 统计量后,与 t 分布比较。这将得到 p 值,表示在原假设成立时您的结果出现的可能性。
t 统计量给出“距离”,p 值反映该距离有多不寻常。
单尾检验 vs. 双尾检验
选择取决于您的假设:
双尾更常见。仅当在分析前已明确方向时才使用单尾检验。
统计显著性 vs. 实用重要性
一个结果可能具有统计显著性,但并不实用。这在大数据集上很常见。
因此不要只看 p 值。关注效应量,并思考它在实际决策中是否重要。
假设检验中的 t 统计量
t 统计量用于检验结果是否与参考值(通常为 0)存在有意义差异。该参考代表“无效应/无差异”。
它回答一个问题:观测到的结果是否足够大,值得视为真实效应而非随机波动。
检验总体均值
当将样本均值与已知或假定值比较时使用。
例如,预期页面平均停留时间为 5 分钟,而您的样本显示为 6 分钟。t 统计量用于评估这 1 分钟的差距是否有意义。
这构成是否拒绝原假设的依据。
比较两个均值
用于比较两个独立组。
以两个落地页的转化率为例:
某组平均值更高本身并不足够。t 统计量用来检验两组均值差距是否具有统计显著性。
|t| 值越大,差异为真实效应的证据越强。
配对样本检验
用于同一组被测两次的情况。
例如,功能更新前后用户参与度。每个观测成对关联。您处理的是每对内部的差值,而非比较独立组。
t 统计量检验所有配对的平均变化是否不同于 0,从而判断变化是否产生了有意义影响。
检验回归系数
在回归中,每个系数都有自己的 t 统计量。每个系数代表某个自变量与结果之间的关系。
例如,某个系数可能表示邮件发送频率对转化的影响。t 统计量检验该系数是否不同于 0。
这有助于识别哪些变量对模型有贡献。
t 统计量表
t 表帮助您判断结果是否具有统计显著性。它基于以下因素提供临界值:
如何使用 t 表
按以下步骤进行:
然后将您的结果与临界值比较:
自由度(df)
0.10
0.05
0.01
1
6.314
12.706
63.657
2
2.92
4.303
9.925
5
2.015
2.571
4.032
10
1.812
2.228
3.169
20
1.725
2.086
2.845
30
1.697
2.04
2.75
∞(超大样本)
1.64
1.96
2.58
以下是如何阅读该表。
假设:
从表中查得:
现在比较:
由于 2.3 大于 2.23,结果具有统计显著性。
t 统计量 vs. z 统计量:有何不同?
关键区别很简单:
在我们的指南中进一步了解t 统计量与 z 统计量的区别。
何时使用 t 统计量
当处理样本数据且未知总体标准差时,使用 t 统计量。
这最为常见。您用样本标准差估计变异性,会引入不确定性。t 统计量对此进行调整,适用于较小数据集。
例如,您收集 25 名用户的数据以估计平均会话时长。由于总体变异性未知,使用 t 统计量。
何时使用 z 统计量
当总体标准差已知时,使用 z 统计量。
这较少见,但可用于受控环境或具备稳定历史数据的场景。在超大样本下也常用,因为样本标准差会非常接近总体值。
如果公司拥有长期数据并知道某指标的精确标准差,则可使用 z 统计量进行检验。
为何样本量重要
样本量影响估计中的不确定性大小。
t 分布通过在小样本时更“宽”来反映这一点,从而得出更保守的结果。
t 与 z 如何趋同
随着样本量增大,两种方法的差异趋于最小。大数据集下,两者结果几乎一致。这也是在大规模分析中常用 z 统计量作为近似的原因。
t 统计量 vs. t 检验:有何不同?
t 统计量是一个单一数值,t 检验是一整套决策流程。如下所示:
什么是 t 统计量?
前文已多次提及,但再强调一次:t 统计量由样本数据计算,表示您的结果相对原假设值(通常为 0)相差多远。
它给出相对于数据变异性的差异大小。仅凭它本身,无法判断结果是否显著。
什么是 t 检验?
t 检验是一种具体的假设检验方法。
它包括:
该流程决定观测差异是否具有统计显著性。
二者如何协同
t 统计量是 t 检验中的一个步骤。
您先计算 t 值,再用它得到 p 值或与临界值比较。最后一步帮助决定是否拒绝原假设。
使用 t 统计量的常见错误
多数错误来自解读而非计算。t 统计量易算,但若忽视关键细节也易误用。
脱离上下文评判 t 值
单看一个很大的 t 值并无太多意义。其含义取决于样本量和变异性。
建议:
忽视关键前提假设
t 统计量依赖若干条件。若不满足,结果可能不可靠。主要假设包括:
建议:
混淆单尾与双尾检验
选择错误的检验会改变结论。单尾只检一侧方向,双尾检两侧方向。
建议:
用多次 t 检验代替 ANOVA
比较两个以上的组时,进行多次 t 检验会增大假阳性的风险。
建议如下:对于三个或以上的组,使用ANOVA。如有需要,再进行事后检验。
只看 p 值
小的 p 值表示统计显著性,而非实用重要性。务必查看效应量,并评估该结果在实际决策中的意义。
结论
所有数据集中都会出现差异。挑战在于判断其是反映真实效应,还是随机波动。t 统计量通过按不确定性缩放差异来解决这一问题。
没有 t 统计量,您只能看到差异;有了它,您可以评估这些差异是否值得付诸行动。