La statistique t indique si une différence observée est significative ou probablement due au hasard.
Des écarts apparaissent dans presque tous les jeux de données. La question clé est de savoir si le résultat reflète un effet réel. La statistique t y répond en comparant l’ampleur de la différence à l’incertitude dans les données.
C’est pourquoi elle est largement utilisée en test d’hypothèses et en régression. Elle vous aide à juger si un résultat est statistiquement significatif et mérite votre attention.
Dans ce guide, vous allez voir ce que signifie la statistique t, comment la calculer, l’interpréter et l’appliquer dans des scénarios de test courants.
Qu’est-ce que la statistique t en statistiques ?
La statistique t mesure à quelle distance un résultat se situe d’une valeur de référence après ajustement de la variabilité des données.
En termes simples, c’est une différence rapportée à l’incertitude. Cela transforme un écart brut en une valeur standardisée que vous pouvez évaluer.
Imaginez une classe avec une moyenne de 78 comparée à un seuil de 75. L’écart est de 3 points. Ce chiffre seul ne dit pas grand-chose. Si les notes sont resserrées, l’écart peut être significatif. Si elles varient fortement, le même écart peut être négligeable.
La statistique t combine ces deux éléments en une seule valeur. Elle montre si la différence observée est importante au regard de la variation des données.
C’est important, car une même différence peut conduire à des conclusions différentes selon la stabilité des données. La statistique t remet le résultat en contexte pour en juger la portée.
On l’utilise dans des cas fréquents :
- Test t à un échantillon : vérifie si la moyenne d’un échantillon diffère d’une valeur connue
- Test t à deux échantillons : compare les moyennes de deux groupes
- Test t apparié : compare le même groupe avant et après un changement
- Analyse de régression : teste si un coefficient diffère de zéro
Dans tous ces cas, la logique reste la même : mesurer l’écart à une référence, ajuster la variabilité et évaluer la pertinence du résultat.
La statistique t suit une structure simple. Elle compare ce que vous observez à ce que vous attendez, puis rapporte cette différence à l’incertitude.
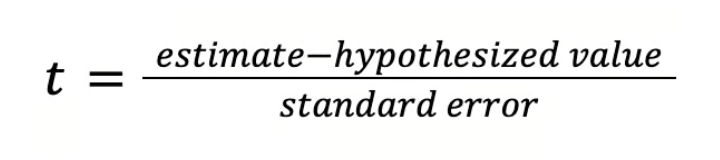
Dans cette formule :
-
L’estimate est votre résultat d’échantillon
-
La hypothesized value est la valeur de référence testée
-
standard error mesure à quel point votre estimation peut varier par hasard
Ainsi, la statistique t indique de combien d’erreurs standards votre résultat s’écarte de la valeur testée.
Test t à un échantillon
À utiliser lorsque vous comparez la moyenne d’un échantillon à une valeur connue.
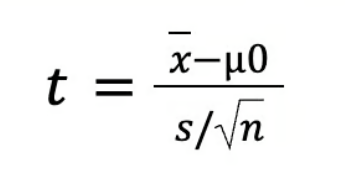
Ici :
-
x est la moyenne de l’échantillon
-
μ0 est la valeur hypothétique
-
s est l’écart type de l’échantillon
-
n est la taille de l’échantillon
Le dénominateur
Test t à deux échantillons (indépendants)
Ce test compare les moyennes de deux groupes distincts. La structure reste la même :
- Numérateur : différence entre les deux moyennes d’échantillon
- Dénominateur : erreur standard de cette différence
Mais un léger changement apparaît : pour calculer l’erreur standard, vous devez décider comment traiter la variabilité des deux groupes.
Deux approches sont courantes.
1. Variances inégales
À utiliser lorsque les groupes n’ont pas la même dispersion, ce qui est fréquent dans les données réelles :
- Chaque groupe conserve sa propre variance
- Les deux variances sont combinées pour calculer l’erreur standard
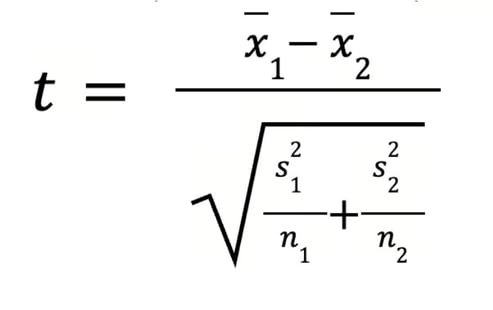
2. Variances égales
À utiliser lorsque les deux groupes présentent une variabilité similaire :
- Les variances sont combinées en une estimation groupée unique (pooled)
- Le calcul s’en trouve simplifié
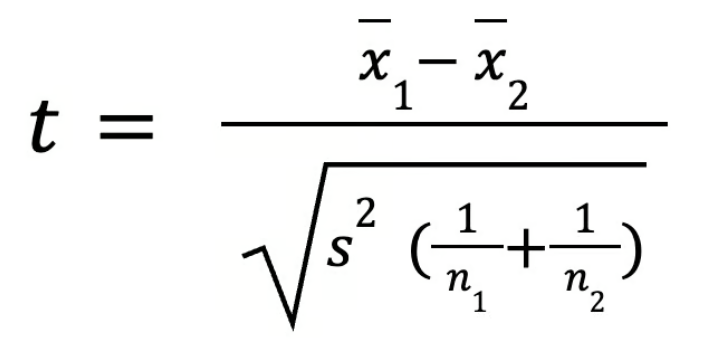
Statistique t des coefficients de régression
En régression, chaque coefficient possède sa propre statistique t.
- Numérateur : coefficient estimé
- Dénominateur : erreur standard de ce coefficient
Elle indique si un prédicteur entretient une relation significative avec la variable cible.
Un exemple numérique rapide
Cas à un échantillon :
- Moyenne d’échantillon = 78
- Valeur hypothétique = 75
- Écart type de l’échantillon = 10
- Taille de l’échantillon = 25
Étape 1 : calculer l’erreur standard
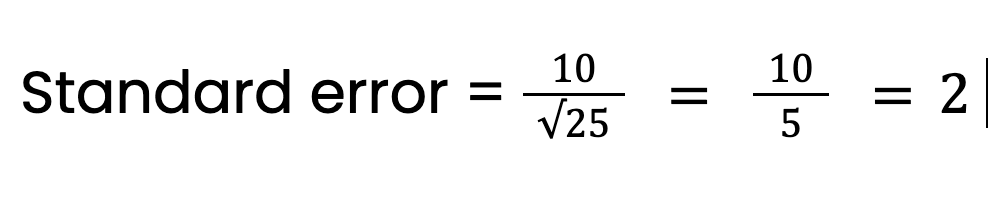
Étape 2 : trouver la différence
Différence = 78 − 75 = 3
Étape 3 : calculer la statistique t
t = 3/2 = 1,5
La moyenne d’échantillon est à 1,5 erreur standard au-dessus de la valeur de référence. Cette valeur sert ensuite à évaluer la significativité statistique.
La loi t et les degrés de liberté
La statistique t n’est utile qu’en la comparant à une distribution de référence : la loi t (Student).
Elle décrit les valeurs de t attendues en l’absence d’effet réel. Une fois votre t calculé, vous regardez où il tombe dans cette distribution. Les valeurs éloignées du centre sont moins probables par hasard. Les valeurs proches du centre sont cohérentes avec la variabilité aléatoire.
Ce que signifient les degrés de liberté
Les degrés de liberté déterminent la forme de la loi t. Ils reflètent la quantité d’information fiable fournie par vos données : plus de données donnent des estimations plus stables, moins de données augmentent l’incertitude.
Parmi les formules courantes :
- Test t à un échantillon : degrés de liberté = n − 1
- Test t à deux échantillons : degrés de liberté = n₁ + n₂ − 2
- Régression : degrés de liberté = n − k − 1, où k est le nombre de prédicteurs
Impact de la taille d’échantillon sur la distribution
Avec de petits échantillons, la variabilité est plus difficile à estimer. Les valeurs extrêmes de t sont alors plus probables, rendant la loi t plus étalée.
Deux conséquences :
- il faut des valeurs de t plus grandes pour montrer une significativité
- les résultats sont plus difficiles à juger comme pertinents
À mesure que la taille d’échantillon augmente, les estimations deviennent plus stables. La loi t se resserre et se rapproche de la loi normale. Avec de grands échantillons, la différence entre les deux est minime.
Plus la statistique t est grande, plus l’évidence contre l’hypothèse nulle est forte. Une statistique t faible suggère un résultat compatible avec le hasard.
C’est l’idée centrale. Passons à la pratique.
Ce que la taille de t indique
Concentrez-vous sur l’éloignement par rapport à 0.
- t proche de 0 > peu ou pas de différence
- t plus grand > différence plus marquée
- t très grand > forte évidence contre l’hypothèse nulle
Le signe indique seulement la direction.
- positif > au-dessus de la valeur attendue
- négatif > en dessous de la valeur attendue
Pour l’interprétation, l’ampleur compte davantage que le signe.
Après avoir calculé la statistique t, comparez-la à la loi t. Vous obtenez ainsi la p-valeur, qui indique la probabilité d’observer votre résultat sous l’hypothèse nulle.
- petite p-valeur > résultat peu probable sous la nulle, évidence plus forte contre elle
- grande p-valeur > résultat plausible sous la nulle, faible évidence
La statistique t donne la distance. La p-valeur indique à quel point cette distance est inhabituelle.
Tests unilatéraux vs bilatéraux
Le choix dépend de votre hypothèse :
- Le test bilatéral recherche toute différence, à la hausse comme à la baisse
- Le test unilatéral recherche une différence dans une direction précise
Les tests bilatéraux sont les plus courants. Les unilatéraux ne s’emploient que si la direction est définie avant l’analyse.
Significativité statistique vs importance pratique
Un résultat peut être statistiquement significatif sans être utile. Cela arrive souvent avec de grands jeux de données.
- Avec de grands échantillons, de petites différences peuvent paraître statistiquement significatives
- Avec de petits échantillons, des différences pertinentes peuvent ne pas paraître significatives
Ne vous fiez donc pas uniquement à la p-valeur. Regardez l’ampleur de l’effet et demandez-vous s’il compte dans les décisions réelles.
La statistique t en test d’hypothèses
La statistique t sert à tester si un résultat diffère de manière significative d’une valeur de référence, souvent zéro. Cette référence représente l’absence d’effet ou de différence.
Elle répond à une question : l’écart observé est-il suffisamment grand pour être jugé réel plutôt que dû au hasard ?
Tester une moyenne de population
À utiliser pour comparer une moyenne d’échantillon à une valeur connue ou supposée.
Supposons que le temps moyen passé sur une page soit attendu à 5 minutes et que votre échantillon affiche 6 minutes. La statistique t évalue si cet écart d’1 minute est significatif.
- t faible : différence probablement due au hasard
- t élevé : différence probablement réelle
C’est la base pour rejeter ou non l’hypothèse nulle.
Comparer deux moyennes
À utiliser pour comparer deux groupes indépendants.
Prenons l’exemple des taux de conversion de deux pages d’atterrissage :
- Groupe A : ancien design
- Groupe B : nouveau design
Une moyenne plus élevée dans un groupe ne suffit pas en soi. La statistique t vérifie si l’écart entre les deux moyennes est statistiquement significatif.
Plus la valeur absolue de t est grande, plus l’évidence d’une différence réelle est forte.
Tests sur échantillons appariés
À utiliser lorsque le même groupe est mesuré deux fois.
Supposons mesurer l’engagement des utilisateurs avant et après une mise à jour. Chaque observation est liée. Vous travaillez donc sur les différences au sein de chaque paire plutôt qu’entre groupes distincts.
La statistique t teste si la variation moyenne sur l’ensemble des paires diffère de zéro. Elle indique si le changement a eu un effet notable.
Tester des coefficients de régression
En régression, chaque coefficient a sa statistique t. Chaque coefficient représente la relation entre un prédicteur et la variable cible.
Par exemple, un coefficient peut représenter l’effet de la fréquence des emails sur les conversions. La statistique t teste si ce coefficient diffère de zéro.
- valeur proche de zéro : peu ou pas d’effet
- valeur éloignée de zéro : effet probablement significatif
Cela aide à identifier les variables qui contribuent au modèle.
Table de la statistique t
Une table t vous aide à décider si votre résultat est statistiquement significatif. Elle fournit des valeurs critiques en fonction :
- des degrés de liberté
- du seuil de significativité choisi (par exemple 0,05)
Procédez ainsi :
- Calculez votre statistique t
- Déterminez vos degrés de liberté
- Choisissez votre seuil de significativité
- Recherchez la valeur critique dans la table
Comparez ensuite votre résultat à la valeur critique :
- Si votre t est supérieur à la valeur de la table, le résultat est statistiquement significatif
- S’il est inférieur, il n’est pas statistiquement significatif
|
Degrés de liberté (df)
|
0,10
|
0,05
|
0,01
|
|
1
|
6,314
|
12,706
|
63,657
|
|
2
|
2,92
|
4,303
|
9,925
|
|
5
|
2,015
|
2,571
|
4,032
|
|
10
|
1,812
|
2,228
|
3,169
|
|
20
|
1,725
|
2,086
|
2,845
|
|
30
|
1,697
|
2,04
|
2,75
|
|
∞ (très grand échantillon)
|
1,64
|
1,96
|
2,58
|
Voici comment lire cette table.
Supposons :
- Votre statistique t = 2,3
- Degrés de liberté = 10
- Seuil de significativité = 0,05
D’après la table :
Comparez maintenant :
- Votre t = 2,3
- Valeur de table = 2,23
Comme 2,3 est supérieur à 2,23, le résultat est statistiquement significatif.
Statistique t vs statistique z : quelle différence ?
La différence clé est simple :
- Utilisez la statistique t lorsque l’écart type de la population est inconnu
- Utilisez la statistique z lorsqu’il est connu
En savoir plus sur la différence entre statistiques t et z dans notre guide.
Quand utiliser la statistique t
Employez la statistique t avec des données d’échantillon lorsque l’écart type de la population est inconnu.
C’est le cas le plus courant. Vous estimez la variabilité via l’écart type d’échantillon, ce qui introduit de l’incertitude. La statistique t en tient compte, ce qui la rend adaptée aux petits jeux de données.
Par exemple, vous recueillez des données auprès de 25 utilisateurs pour estimer le temps de session moyen. Comme la variabilité populationnelle réelle est inconnue, vous utilisez la statistique t.
Quand utiliser la statistique z
Utilisez la statistique z lorsque l’écart type de la population est connu.
C’est plus rare, mais possible en environnement maîtrisé ou avec un historique stable. Elle s’emploie aussi avec de très grands échantillons, où l’écart type d’échantillon est proche de la valeur populationnelle.
Si une entreprise dispose de longues séries et connaît l’écart type exact d’un indicateur, elle peut utiliser la statistique z pour ses tests.
Pourquoi la taille d’échantillon compte
La taille d’échantillon conditionne l’incertitude de vos estimations.
- petits échantillons : incertitude plus élevée, la statistique t est plus appropriée
- grands échantillons : incertitude plus faible, la statistique z devient pertinente
La loi t en tient compte en étant plus large pour les petits échantillons, ce qui conduit à des conclusions plus conservatrices.
À mesure que la taille d’échantillon augmente, la différence entre les deux méthodes devient minime. Sur de grands jeux de données, les deux approches donnent des résultats quasi identiques. C’est pourquoi la statistique z est souvent utilisée comme approximation dans les analyses à grande échelle.
Statistique t vs test t : quelle différence ?
La statistique t est une valeur unique, le test t est le processus de décision complet. Précisons :
Qu’est-ce que la statistique t ?
Nous l’avons déjà beaucoup évoquée, mais rappelons-le : la statistique t est calculée à partir de vos données d’échantillon. Elle montre l’éloignement de votre résultat par rapport à la valeur sous l’hypothèse nulle, généralement zéro.
Elle donne la taille de la différence relativement à la variabilité des données. Isolément, elle ne dit pas si le résultat est significatif.
Qu’est-ce que le test t ?
Le test t est une manière spécifique de mener un test d’hypothèses.
Il comprend :
- la définition des hypothèses nulle et alternative
- le calcul de la statistique t (ci-dessus)
- la recherche de la p-valeur ou de la valeur critique
- la décision à partir du résultat
Ce processus permet de déterminer si la différence observée est statistiquement significative.
La statistique t est une étape du test t.
Vous calculez d’abord t. Puis vous l’utilisez pour obtenir une p-valeur ou le comparer à une valeur critique. Cette étape finale permet de décider de rejeter ou non l’hypothèse nulle.
Erreurs fréquentes avec la statistique t
La plupart des erreurs viennent de l’interprétation, pas du calcul. La statistique t est facile à calculer mais facile à mal utiliser si l’on ignore des détails clés.
Juger la valeur de t sans contexte
Une grande valeur de t ne signifie pas grand-chose isolément. Sa signification dépend de la taille d’échantillon et de la variabilité.
Bon réflexe :
- interprétez t avec la p-valeur
- tenez compte de la taille d’échantillon
- évaluez la variabilité des données
Ignorer des hypothèses clés
La statistique t repose sur quelques conditions. Si elles ne sont pas respectées, les résultats peuvent être peu fiables. Les principales hypothèses sont :
- données approximativement normales, surtout pour de petits échantillons
- observations indépendantes
Bon réflexe :
- examiner la distribution des données
- utiliser des graphiques ou statistiques descriptives pour détecter des problèmes
- recourir à des méthodes alternatives si les hypothèses sont violées
Confondre tests unilatéraux et bilatéraux
Choisir le mauvais test change la conclusion. Le test unilatéral examine une direction, le bilatéral examine les deux.
Bon réflexe :
- décider du type de test avant l’analyse
- utiliser par défaut un test bilatéral sauf direction spécifique requise
Multiplier les tests t au lieu d’une ANOVA
Comparer plus de deux groupes via plusieurs tests t augmente le risque de faux positifs.
Que faire ? Utilisez l’ANOVA pour trois groupes ou plus, puis réalisez des tests post hoc si nécessaire
Se fier uniquement aux p-valeurs
Une petite p-valeur montre une significativité statistique, pas l’importance pratique. Pensez à examiner la taille d’effet et à évaluer la portée du résultat pour les décisions réelles.
Conclusion
Des différences apparaissent dans tous les jeux de données. L’enjeu est de savoir si elles traduisent un effet réel ou le hasard. La statistique t y répond en ajustant la différence en fonction de l’incertitude.
Sans la statistique t, vous ne voyez que des écarts. Avec elle, vous pouvez juger si ces écarts méritent d’agir.





La statistique t indique si une différence observée est significative ou probablement due au hasard.
Des écarts apparaissent dans presque tous les jeux de données. La question clé est de savoir si le résultat reflète un effet réel. La statistique t y répond en comparant l’ampleur de la différence à l’incertitude dans les données.
C’est pourquoi elle est largement utilisée en test d’hypothèses et en régression. Elle vous aide à juger si un résultat est statistiquement significatif et mérite votre attention.
Dans ce guide, vous allez voir ce que signifie la statistique t, comment la calculer, l’interpréter et l’appliquer dans des scénarios de test courants.
Qu’est-ce que la statistique t en statistiques ?
La statistique t mesure à quelle distance un résultat se situe d’une valeur de référence après ajustement de la variabilité des données.
En termes simples, c’est une différence rapportée à l’incertitude. Cela transforme un écart brut en une valeur standardisée que vous pouvez évaluer.
Imaginez une classe avec une moyenne de 78 comparée à un seuil de 75. L’écart est de 3 points. Ce chiffre seul ne dit pas grand-chose. Si les notes sont resserrées, l’écart peut être significatif. Si elles varient fortement, le même écart peut être négligeable.
La statistique t combine ces deux éléments en une seule valeur. Elle montre si la différence observée est importante au regard de la variation des données.
C’est important, car une même différence peut conduire à des conclusions différentes selon la stabilité des données. La statistique t remet le résultat en contexte pour en juger la portée.
On l’utilise dans des cas fréquents :
Dans tous ces cas, la logique reste la même : mesurer l’écart à une référence, ajuster la variabilité et évaluer la pertinence du résultat.
Formule de la statistique t et calcul
La statistique t suit une structure simple. Elle compare ce que vous observez à ce que vous attendez, puis rapporte cette différence à l’incertitude.
Dans cette formule :
L’
estimateest votre résultat d’échantillonLa
hypothesized valueest la valeur de référence testéestandard errormesure à quel point votre estimation peut varier par hasardAinsi, la statistique t indique de combien d’erreurs standards votre résultat s’écarte de la valeur testée.
Test t à un échantillon
À utiliser lorsque vous comparez la moyenne d’un échantillon à une valeur connue.
Ici :
xest la moyenne de l’échantillonμ0est la valeur hypothétiquesest l’écart type de l’échantillonnest la taille de l’échantillonLe dénominateur
s/n est l’erreur standard de la moyenne.Test t à deux échantillons (indépendants)
Ce test compare les moyennes de deux groupes distincts. La structure reste la même :
Mais un léger changement apparaît : pour calculer l’erreur standard, vous devez décider comment traiter la variabilité des deux groupes.
Deux approches sont courantes.
1. Variances inégales
À utiliser lorsque les groupes n’ont pas la même dispersion, ce qui est fréquent dans les données réelles :
2. Variances égales
À utiliser lorsque les deux groupes présentent une variabilité similaire :
Statistique t des coefficients de régression
En régression, chaque coefficient possède sa propre statistique t.
Elle indique si un prédicteur entretient une relation significative avec la variable cible.
Un exemple numérique rapide
Cas à un échantillon :
Étape 1 : calculer l’erreur standard
Étape 2 : trouver la différence
Différence = 78 − 75 = 3
Étape 3 : calculer la statistique t
t = 3/2 = 1,5
La moyenne d’échantillon est à 1,5 erreur standard au-dessus de la valeur de référence. Cette valeur sert ensuite à évaluer la significativité statistique.
La loi t et les degrés de liberté
La statistique t n’est utile qu’en la comparant à une distribution de référence : la loi t (Student).
Elle décrit les valeurs de t attendues en l’absence d’effet réel. Une fois votre t calculé, vous regardez où il tombe dans cette distribution. Les valeurs éloignées du centre sont moins probables par hasard. Les valeurs proches du centre sont cohérentes avec la variabilité aléatoire.
Ce que signifient les degrés de liberté
Les degrés de liberté déterminent la forme de la loi t. Ils reflètent la quantité d’information fiable fournie par vos données : plus de données donnent des estimations plus stables, moins de données augmentent l’incertitude.
Parmi les formules courantes :
Impact de la taille d’échantillon sur la distribution
Avec de petits échantillons, la variabilité est plus difficile à estimer. Les valeurs extrêmes de t sont alors plus probables, rendant la loi t plus étalée.
Deux conséquences :
À mesure que la taille d’échantillon augmente, les estimations deviennent plus stables. La loi t se resserre et se rapproche de la loi normale. Avec de grands échantillons, la différence entre les deux est minime.
Comment interpréter la statistique t
Plus la statistique t est grande, plus l’évidence contre l’hypothèse nulle est forte. Une statistique t faible suggère un résultat compatible avec le hasard.
C’est l’idée centrale. Passons à la pratique.
Ce que la taille de t indique
Concentrez-vous sur l’éloignement par rapport à 0.
Le signe indique seulement la direction.
Pour l’interprétation, l’ampleur compte davantage que le signe.
Comment obtenir la p-valeur
Après avoir calculé la statistique t, comparez-la à la loi t. Vous obtenez ainsi la p-valeur, qui indique la probabilité d’observer votre résultat sous l’hypothèse nulle.
La statistique t donne la distance. La p-valeur indique à quel point cette distance est inhabituelle.
Tests unilatéraux vs bilatéraux
Le choix dépend de votre hypothèse :
Les tests bilatéraux sont les plus courants. Les unilatéraux ne s’emploient que si la direction est définie avant l’analyse.
Significativité statistique vs importance pratique
Un résultat peut être statistiquement significatif sans être utile. Cela arrive souvent avec de grands jeux de données.
Ne vous fiez donc pas uniquement à la p-valeur. Regardez l’ampleur de l’effet et demandez-vous s’il compte dans les décisions réelles.
La statistique t en test d’hypothèses
La statistique t sert à tester si un résultat diffère de manière significative d’une valeur de référence, souvent zéro. Cette référence représente l’absence d’effet ou de différence.
Elle répond à une question : l’écart observé est-il suffisamment grand pour être jugé réel plutôt que dû au hasard ?
Tester une moyenne de population
À utiliser pour comparer une moyenne d’échantillon à une valeur connue ou supposée.
Supposons que le temps moyen passé sur une page soit attendu à 5 minutes et que votre échantillon affiche 6 minutes. La statistique t évalue si cet écart d’1 minute est significatif.
C’est la base pour rejeter ou non l’hypothèse nulle.
Comparer deux moyennes
À utiliser pour comparer deux groupes indépendants.
Prenons l’exemple des taux de conversion de deux pages d’atterrissage :
Une moyenne plus élevée dans un groupe ne suffit pas en soi. La statistique t vérifie si l’écart entre les deux moyennes est statistiquement significatif.
Plus la valeur absolue de t est grande, plus l’évidence d’une différence réelle est forte.
Tests sur échantillons appariés
À utiliser lorsque le même groupe est mesuré deux fois.
Supposons mesurer l’engagement des utilisateurs avant et après une mise à jour. Chaque observation est liée. Vous travaillez donc sur les différences au sein de chaque paire plutôt qu’entre groupes distincts.
La statistique t teste si la variation moyenne sur l’ensemble des paires diffère de zéro. Elle indique si le changement a eu un effet notable.
Tester des coefficients de régression
En régression, chaque coefficient a sa statistique t. Chaque coefficient représente la relation entre un prédicteur et la variable cible.
Par exemple, un coefficient peut représenter l’effet de la fréquence des emails sur les conversions. La statistique t teste si ce coefficient diffère de zéro.
Cela aide à identifier les variables qui contribuent au modèle.
Table de la statistique t
Une table t vous aide à décider si votre résultat est statistiquement significatif. Elle fournit des valeurs critiques en fonction :
Comment utiliser la table t
Procédez ainsi :
Comparez ensuite votre résultat à la valeur critique :
Degrés de liberté (df)
0,10
0,05
0,01
1
6,314
12,706
63,657
2
2,92
4,303
9,925
5
2,015
2,571
4,032
10
1,812
2,228
3,169
20
1,725
2,086
2,845
30
1,697
2,04
2,75
∞ (très grand échantillon)
1,64
1,96
2,58
Voici comment lire cette table.
Supposons :
D’après la table :
Comparez maintenant :
Comme 2,3 est supérieur à 2,23, le résultat est statistiquement significatif.
Statistique t vs statistique z : quelle différence ?
La différence clé est simple :
En savoir plus sur la différence entre statistiques t et z dans notre guide.
Quand utiliser la statistique t
Employez la statistique t avec des données d’échantillon lorsque l’écart type de la population est inconnu.
C’est le cas le plus courant. Vous estimez la variabilité via l’écart type d’échantillon, ce qui introduit de l’incertitude. La statistique t en tient compte, ce qui la rend adaptée aux petits jeux de données.
Par exemple, vous recueillez des données auprès de 25 utilisateurs pour estimer le temps de session moyen. Comme la variabilité populationnelle réelle est inconnue, vous utilisez la statistique t.
Quand utiliser la statistique z
Utilisez la statistique z lorsque l’écart type de la population est connu.
C’est plus rare, mais possible en environnement maîtrisé ou avec un historique stable. Elle s’emploie aussi avec de très grands échantillons, où l’écart type d’échantillon est proche de la valeur populationnelle.
Si une entreprise dispose de longues séries et connaît l’écart type exact d’un indicateur, elle peut utiliser la statistique z pour ses tests.
Pourquoi la taille d’échantillon compte
La taille d’échantillon conditionne l’incertitude de vos estimations.
La loi t en tient compte en étant plus large pour les petits échantillons, ce qui conduit à des conclusions plus conservatrices.
Comment t et z se rapprochent
À mesure que la taille d’échantillon augmente, la différence entre les deux méthodes devient minime. Sur de grands jeux de données, les deux approches donnent des résultats quasi identiques. C’est pourquoi la statistique z est souvent utilisée comme approximation dans les analyses à grande échelle.
Statistique t vs test t : quelle différence ?
La statistique t est une valeur unique, le test t est le processus de décision complet. Précisons :
Qu’est-ce que la statistique t ?
Nous l’avons déjà beaucoup évoquée, mais rappelons-le : la statistique t est calculée à partir de vos données d’échantillon. Elle montre l’éloignement de votre résultat par rapport à la valeur sous l’hypothèse nulle, généralement zéro.
Elle donne la taille de la différence relativement à la variabilité des données. Isolément, elle ne dit pas si le résultat est significatif.
Qu’est-ce que le test t ?
Le test t est une manière spécifique de mener un test d’hypothèses.
Il comprend :
Ce processus permet de déterminer si la différence observée est statistiquement significative.
Comment elles interagissent
La statistique t est une étape du test t.
Vous calculez d’abord t. Puis vous l’utilisez pour obtenir une p-valeur ou le comparer à une valeur critique. Cette étape finale permet de décider de rejeter ou non l’hypothèse nulle.
Erreurs fréquentes avec la statistique t
La plupart des erreurs viennent de l’interprétation, pas du calcul. La statistique t est facile à calculer mais facile à mal utiliser si l’on ignore des détails clés.
Juger la valeur de t sans contexte
Une grande valeur de t ne signifie pas grand-chose isolément. Sa signification dépend de la taille d’échantillon et de la variabilité.
Bon réflexe :
Ignorer des hypothèses clés
La statistique t repose sur quelques conditions. Si elles ne sont pas respectées, les résultats peuvent être peu fiables. Les principales hypothèses sont :
Bon réflexe :
Confondre tests unilatéraux et bilatéraux
Choisir le mauvais test change la conclusion. Le test unilatéral examine une direction, le bilatéral examine les deux.
Bon réflexe :
Multiplier les tests t au lieu d’une ANOVA
Comparer plus de deux groupes via plusieurs tests t augmente le risque de faux positifs.
Que faire ? Utilisez l’ANOVA pour trois groupes ou plus, puis réalisez des tests post hoc si nécessaire
Se fier uniquement aux p-valeurs
Une petite p-valeur montre une significativité statistique, pas l’importance pratique. Pensez à examiner la taille d’effet et à évaluer la portée du résultat pour les décisions réelles.
Conclusion
Des différences apparaissent dans tous les jeux de données. L’enjeu est de savoir si elles traduisent un effet réel ou le hasard. La statistique t y répond en ajustant la différence en fonction de l’incertitude.
Sans la statistique t, vous ne voyez que des écarts. Avec elle, vous pouvez juger si ces écarts méritent d’agir.