Última chance! Formação ilimitada com 50% de desconto
A promoção termina em
A estatística t mostra se uma diferença observada é relevante ou provavelmente fruto do acaso.
Diferenças aparecem em praticamente qualquer conjunto de dados. A pergunta-chave é se o resultado reflete um efeito real. A estatística t responde a isso ao comparar o tamanho da diferença com a incerteza nos dados.
Por isso, ela é amplamente usada em testes de hipótese e regressão. Ajuda você a avaliar se um resultado é estatisticamente significativo e merece atenção.
Neste guia, você vai entender o que a estatística t significa, como calculá-la, como interpretá-la e como aplicá-la em cenários comuns de teste.
A estatística t mede quão longe um resultado está de um valor de referência após ajustar pela variabilidade nos dados.
Em termos simples, é a diferença escalada pela incerteza. Isso transforma um desvio bruto em um valor padronizado que você pode avaliar.
Considere uma turma com média 78 comparada a um benchmark de 75. A diferença é de 3 pontos. Esse número, sozinho, não diz muita coisa. Se as notas forem bem concentradas, a diferença pode ser relevante. Se variarem muito, a mesma diferença pode não significar nada.
A estatística t combina esses dois aspectos em um único valor. Ela mostra se a diferença observada é grande em relação à variação dos dados.
Isso é importante porque a mesma diferença pode levar a conclusões diferentes dependendo da estabilidade dos dados. A estatística t coloca o resultado em contexto para você julgar sua relevância.
Você vai vê-la em cenários comuns:
Em todos esses casos, a lógica é a mesma: medir a distância de um ponto de referência, ajustar pela variabilidade e avaliar se o resultado é relevante.
A estatística t segue uma estrutura simples. Ela compara o que você observou com o que esperava e escala essa diferença pela incerteza.
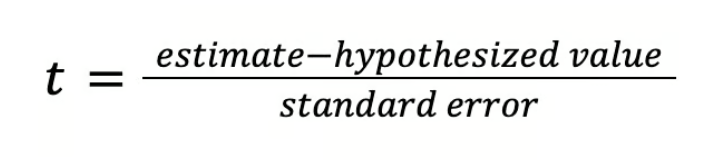
Nesta fórmula:
A estimate é o seu resultado amostral
O hypothesized value é o valor de referência do teste
standard error mede quanto sua estimativa pode variar por acaso
Assim, a estatística t indica a quantos erros-padrão seu resultado está do valor testado.
Use quando você compara a média de uma amostra a um valor conhecido.
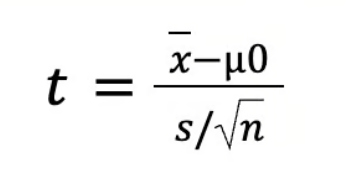
Aqui:
x é a média amostral
μ0 é o valor hipotético
s é o desvio-padrão amostral
n é o tamanho da amostra
O denominador s/√n é o erro-padrão da média.
Este teste compara as médias de dois grupos distintos. A estrutura se mantém:
Mas há um detalhe: ao calcular o erro-padrão, você precisa decidir como tratar a variabilidade dos dois grupos.
Existem duas abordagens comuns.
Use quando os grupos têm níveis de dispersão diferentes, algo comum em dados reais:
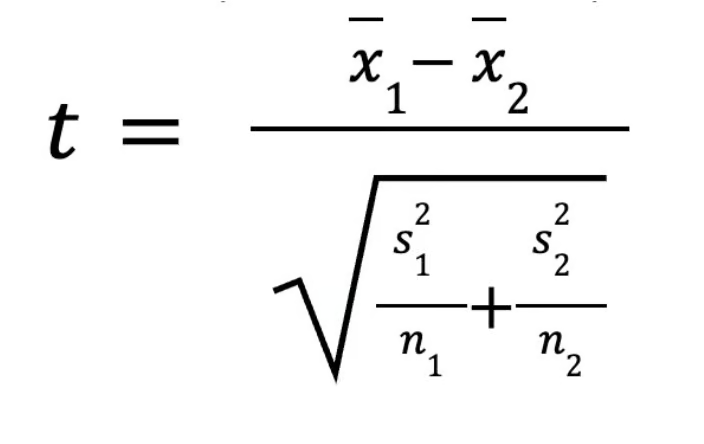
Use quando ambos os grupos apresentam variabilidade semelhante:
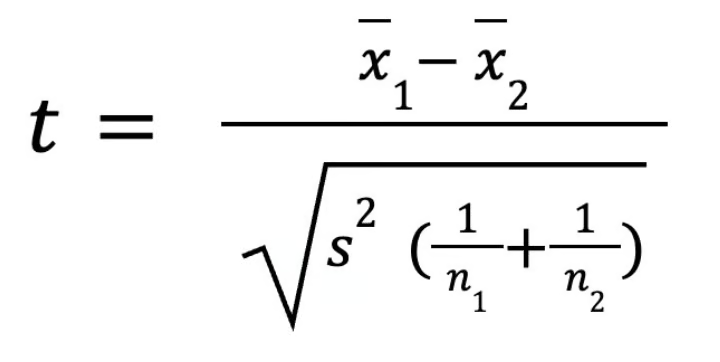
Em regressão, cada coeficiente tem sua própria estatística t.
Isso mostra se um preditor tem relação relevante com a variável de saída.
Considere o caso de uma amostra:
Passo 1: calcular o erro-padrão
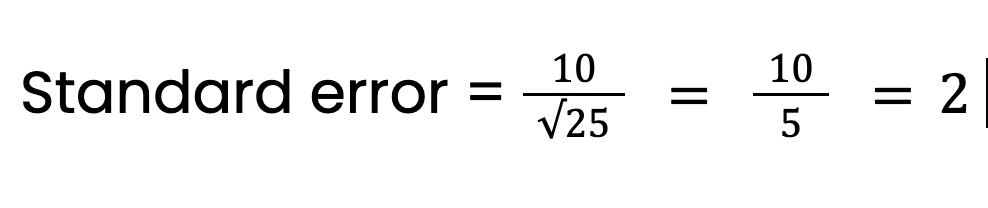
Passo 2: encontrar a diferença
Diferença = 78 − 75 = 3
Passo 3: calcular a estatística t
t = 3/2 = 1,5
A média amostral está 1,5 erros-padrão acima do valor de referência. Esse valor é usado no próximo passo para avaliar a significância estatística.
A estatística t só se torna útil quando comparada a uma distribuição de referência: a distribuição t.
Ela mostra como seriam os valores de t quando não há efeito real. Depois de calcular um valor t, você verifica onde ele cai nessa distribuição. Valores distantes do centro são menos prováveis ao acaso. Valores próximos do centro são mais compatíveis com variação aleatória.
Graus de liberdade controlam o formato da distribuição t. Eles refletem quanta informação confiável seus dados oferecem: mais dados levam a estimativas mais estáveis; menos dados aumentam a incerteza.
Algumas fórmulas comuns são:
Com amostras pequenas, é mais difícil estimar a variabilidade. Isso torna valores extremos de t mais prováveis, então a distribuição t fica mais larga.
Isso gera dois efeitos:
À medida que o tamanho da amostra cresce, as estimativas ficam mais estáveis. A distribuição t se estreita e passa a se aproximar da normal. Com amostras grandes, a diferença entre as duas é mínima.
Uma estatística t maior indica evidência mais forte contra a hipótese nula. Uma estatística t menor sugere que o resultado pode ser devido à variação aleatória.
Essa é a ideia central. Agora vamos colocar em prática.
Observe quão distante o valor está de 0.
O sinal apenas indica direção.
Para interpretar, a magnitude importa mais do que o sinal.
Depois de calcular a estatística t, compare-a com a distribuição t. Isso gera o p-valor, que indica quão provável é seu resultado sob a hipótese nula.
A estatística t dá a distância. O p-valor mostra quão incomum é essa distância.
A escolha depende da sua hipótese:
Testes bicaudais são mais comuns. Testes unicaudais só são usados quando a direção é definida antes da análise.
Um resultado pode ser estatisticamente significativo e ainda assim pouco útil. Isso acontece com frequência em bases muito grandes.
Então não dependa apenas do p-valor. Observe o tamanho do efeito e avalie se faz diferença nas decisões reais.
A estatística t é usada para testar se um resultado é significativamente diferente de um valor de referência, muitas vezes zero. Esse valor representa ausência de efeito ou de diferença.
Ela responde a uma pergunta: a diferença observada é grande o suficiente para ser tratada como real e não como acaso?
Use ao comparar a média de uma amostra com um valor conhecido ou assumido.
Suponha que o tempo médio em uma página esperado seja 5 minutos e sua amostra mostre 6 minutos. A estatística t avalia se esse 1 minuto de diferença é relevante.
Isso embasa a decisão de rejeitar ou não a hipótese nula.
Use para comparar dois grupos independentes.
Exemplo com taxas de conversão de duas landing pages:
Uma média maior em um grupo, sozinha, não basta. A estatística t verifica se a diferença entre as médias é estatisticamente significativa.
Um valor absoluto de t mais alto indica evidência mais forte de que a diferença é real.
Use quando o mesmo grupo é medido duas vezes.
Suponha que você tenha engajamento de usuários antes e depois de uma atualização de recurso. Cada observação é pareada. Você trabalha com as diferenças dentro de cada par, em vez de comparar grupos separados.
A estatística t testa se a mudança média entre os pares difere de zero. Isso mostra se a alteração teve efeito relevante.
Em regressão, cada coeficiente tem sua própria estatística t. Cada coeficiente representa a relação entre um preditor e o resultado.
Suponha que um coeficiente represente o efeito da frequência de e-mails nas conversões. A estatística t testa se esse coeficiente difere de zero.
Isso ajuda a identificar quais variáveis contribuem para o modelo.
Uma tabela t ajuda a decidir se seu resultado é estatisticamente significativo. Ela traz valores críticos com base em:
Siga estes passos:
Agora compare seu resultado com o valor crítico:
|
Graus de liberdade (gl) |
0,10 |
0,05 |
0,01 |
|
1 |
6,314 |
12,706 |
63,657 |
|
2 |
2,92 |
4,303 |
9,925 |
|
5 |
2,015 |
2,571 |
4,032 |
|
10 |
1,812 |
2,228 |
3,169 |
|
20 |
1,725 |
2,086 |
2,845 |
|
30 |
1,697 |
2,04 |
2,75 |
|
∞ (amostra muito grande) |
1,64 |
1,96 |
2,58 |
Veja como ler esta tabela.
Suponha:
Na tabela:
Agora compare:
Como 2,3 é maior que 2,23, o resultado é estatisticamente significativo.
A diferença principal é simples:
Saiba mais sobre a diferença entre estatísticas t e z no nosso guia.
Use a estatística t ao trabalhar com dados amostrais e quando você não conhece o desvio-padrão populacional.
Esse é o caso mais comum. Você estima a variabilidade usando o desvio-padrão amostral, o que traz incerteza. A estatística t ajusta essa incerteza, sendo adequada para bases menores.
Por exemplo, você coleta dados de 25 usuários para estimar o tempo médio de sessão. Como a variabilidade populacional verdadeira é desconhecida, usa-se a estatística t.
Use a estatística z quando o desvio-padrão populacional é conhecido.
Isso é menos comum, mas pode ocorrer em ambientes controlados ou quando você tem dados históricos estáveis. Também é usada com amostras muito grandes, quando o desvio-padrão amostral se aproxima do valor populacional.
Se uma empresa tem dados de longo prazo e conhece exatamente o desvio-padrão de uma métrica, pode usar a estatística z nos testes.
O tamanho da amostra afeta quanta incerteza existe nas suas estimativas.
A distribuição t leva isso em conta sendo mais larga para amostras pequenas, o que torna os resultados mais conservadores.
Com o aumento do tamanho da amostra, a diferença entre os dois métodos se torna mínima. Em bases grandes, ambos produzem resultados quase idênticos. Por isso a estatística z é frequentemente usada como aproximação em análises em larga escala.
A estatística t é um valor único; o teste t é o processo completo de decisão. Vamos entender:
Já falamos bastante, mas reforçando: a estatística t é calculada a partir dos seus dados amostrais. Ela mostra quão distante seu resultado está do valor da hipótese nula, geralmente zero.
Ela dá o tamanho da diferença em relação à variabilidade dos dados. Sozinha, não diz se o resultado é significativo.
O teste t é uma forma específica de fazer um teste de hipótese.
Ele inclui:
Esse processo determina se a diferença observada é estatisticamente significativa.
A estatística t é uma etapa dentro do teste t.
Você calcula o valor t primeiro. Depois, usa-o para obter o p-valor ou compará-lo ao valor crítico. Esse passo final permite decidir se deve rejeitar a hipótese nula.
A maioria dos erros vem da interpretação, não do cálculo. A estatística t é fácil de computar, mas pode ser mal utilizada se detalhes essenciais forem ignorados.
Um t alto, por si só, não diz muita coisa. Seu significado depende do tamanho da amostra e da variabilidade.
O que fazer:
A estatística t depende de algumas condições. Se não forem atendidas, os resultados podem ser pouco confiáveis. Os principais pressupostos são:
O que fazer:
Escolher o teste errado muda a conclusão. O teste unicaudal verifica uma direção; o bicaudal, ambas.
O que fazer:
Comparar mais de dois grupos com vários testes t aumenta o risco de falsos positivos.
O que fazer: use ANOVA para três ou mais grupos e, se necessário, faça testes post hoc
Um p-valor pequeno indica significância estatística, não importância prática. Certifique-se de verificar o tamanho do efeito e avaliar se o resultado importa para decisões reais.
Diferenças aparecem em todos os conjuntos de dados. O desafio é saber se refletem um efeito real ou variação aleatória. A estatística t lida com isso ao escalar a diferença pela incerteza.
Sem a estatística t, você só enxerga diferenças. Com ela, você avalia se essas diferenças merecem ação.
Aprenda com a DataCamp
Curso
Curso
Curso
blog
Arun Nanda
15 min
blog
Matt Crabtree
10 min
blog
Matt Crabtree
15 min
blog
Kurtis Pykes
13 min
Tutorial
Abid Ali Awan
10 min
Tutorial