
Cursus
Inleiding tot statistiek
4 uur
162.1K
De t-statistiek laat zien of een geobserveerd verschil betekenisvol is of waarschijnlijk het gevolg van willekeurige variatie.
Verschillen komen voor in bijna elke dataset. De kernvraag is of het resultaat een echt effect weerspiegelt. De t-statistiek beantwoordt dat door de grootte van het verschil te vergelijken met de onzekerheid in de data.
Daarom wordt hij veel gebruikt bij hypothesetoetsen en regressie. Hij helpt je beoordelen of een resultaat statistisch significant is en serieus genomen moet worden.
In deze gids leer je wat de t-statistiek betekent, hoe je hem berekent, hoe je hem interpreteert en hoe je hem toepast in veelvoorkomende testsituaties.
De t-statistiek meet hoe ver een resultaat van een referentiewaarde afligt, gecorrigeerd voor variabiliteit in de data.
Simpel gezegd: het is het verschil geschaald door de onzekerheid. Zo wordt een ruwe kloof omgezet in een gestandaardiseerde waarde die je kunt beoordelen.
Neem een klas met een gemiddelde score van 78 vergeleken met een benchmark van 75. Het verschil is 3 punten. Dat getal op zich zegt niet zoveel. Als de scores dicht bij elkaar liggen, kan de kloof betekenisvol zijn. Als de scores sterk variëren, kan dezelfde kloof weinig betekenen.
De t-statistiek voegt beide elementen samen in één waarde. Die laat zien of het waargenomen verschil groot is ten opzichte van de variatie in de data.
Dit is belangrijk omdat hetzelfde verschil tot andere conclusies kan leiden, afhankelijk van hoe stabiel de data is. De t-statistiek plaatst het resultaat in context zodat je de significantie kunt beoordelen.
Je ziet hem in veelvoorkomende scenario’s:
In al deze gevallen blijft de logica hetzelfde: meet de afstand tot een referentiepunt, corrigeer voor variabiliteit en beoordeel of het resultaat betekenisvol is.
De t-statistiek volgt een eenvoudige structuur. Hij vergelijkt wat je observeerde met wat je verwachtte en schaalt dat verschil vervolgens met de onzekerheid.
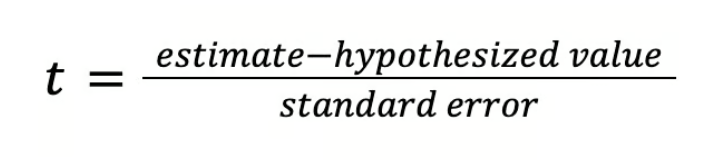
In deze formule:
De estimate is je steekproefresultaat
De hypothesized value is waartegen je test
standard error meet hoeveel je schatting kan variëren door toeval
Dus de t-statistiek vertelt je hoeveel standaardfouten je resultaat verwijderd is van de waarde waartegen je test.
Die gebruik je wanneer je één steekproefgemiddelde vergelijkt met een bekende waarde.
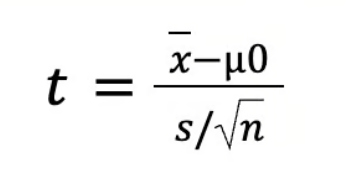
Hier:
x is het steekproefgemiddelde
μ0 is de veronderstelde waarde
s is de steekproefstandaarddeviatie
n is de steekproefgrootte
De noemer s/n is de standaardfout van het gemiddelde.
Deze toets vergelijkt de gemiddelden van twee aparte groepen. De structuur blijft consistent:
Maar hier is een kleine verandering: bij het berekenen van de standaardfout moet je beslissen hoe je de variabiliteit in beide groepen behandelt.
Er zijn twee gangbare benaderingen.
Gebruik dit wanneer de groepen verschillende spreiding hebben, wat vaak voorkomt in echte data:
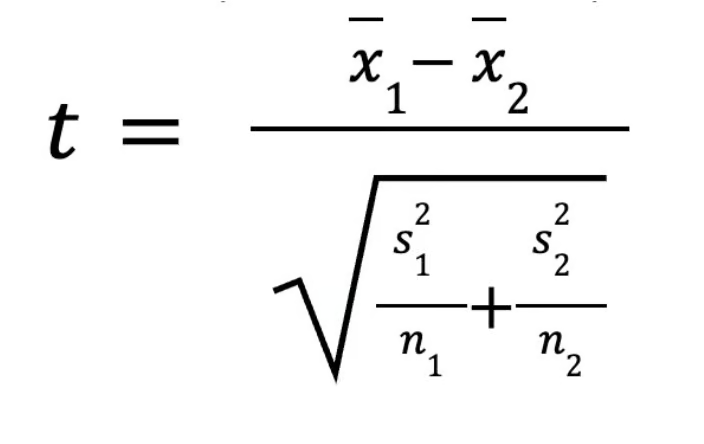
Gebruik dit wanneer beide groepen vergelijkbare variabiliteit vertonen:
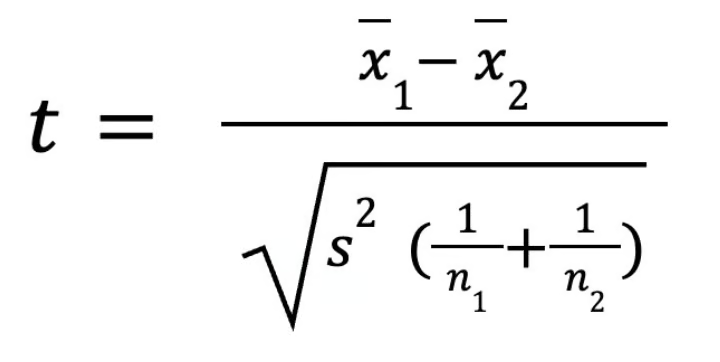
Bij regressie heeft elke coëfficiënt zijn eigen t-statistiek.
Dit toont of een predictor een betekenisvolle relatie heeft met de uitkomstvariabele.
Beschouw een één-steekproefgeval:
Stap 1: Bereken de standaardfout
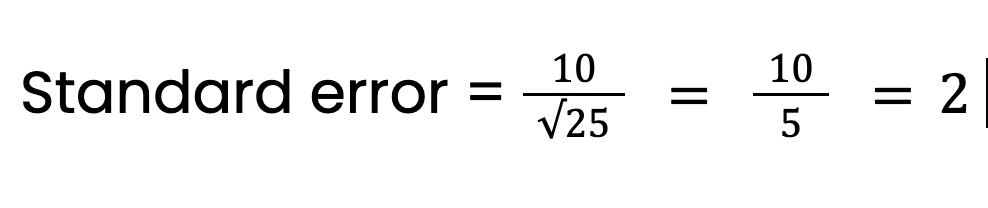
Stap 2: Vind het verschil
Verschil = 78 − 75 = 3
Stap 3: Bereken de t-statistiek
T = 3/2 = 1,5
Het steekproefgemiddelde ligt 1,5 standaardfouten boven de referentiewaarde. Deze waarde gebruik je in de volgende stap om de statistische significantie te beoordelen.
De t-statistiek wordt pas nuttig wanneer je die vergelijkt met een referentieverdeling. Die referentie is de t-verdeling.
Die laat zien hoe t-waarden eruitzien wanneer er geen echt effect is. Zodra je een t-waarde berekent, kijk je waar die op deze verdeling valt. Waarden ver van het midden komen minder waarschijnlijk door toeval voor. Waarden dicht bij het midden passen beter bij willekeurige variatie.
Vrijheidsgraden bepalen de vorm van de t-verdeling. Ze weerspiegelen hoeveel betrouwbare informatie je data biedt: meer data leidt tot stabielere schattingen en minder data vergroot de onzekerheid.
Enkele veelgebruikte formules zijn:
Met kleine steekproeven is variabiliteit lastiger te schatten. Daardoor komen extreme t-waarden vaker voor en is de t-verdeling wijder.
Dit leidt tot twee gevolgen:
Als de steekproefgrootte toeneemt, worden schattingen stabieler. De t-verdeling wordt smaller en gaat lijken op de normale verdeling. Bij grote steekproeven is het verschil tussen beide minimaal.
Een grotere t-statistiek betekent sterker bewijs tegen de nulhypothese. Een kleinere t-statistiek betekent dat het resultaat door willekeurige variatie kan komen.
Dat is het kernidee. Laten we het nu praktisch maken.
Let op hoe ver de waarde van 0 ligt.
Het teken geeft alleen de richting aan.
Voor de interpretatie is de grootte belangrijker dan het teken.
Vergelijk na het berekenen van de t-statistiek deze met de t-verdeling. Dit geeft de p-waarde, die aangeeft hoe waarschijnlijk je resultaat is onder de nulhypothese.
De t-statistiek geeft de afstand. De p-waarde laat zien hoe ongewoon die afstand is.
De keuze hangt af van je hypothese:
Tweezijdige toetsen komen vaker voor. Eenzijdige toetsen gebruik je alleen als de richting vóór de analyse is vastgelegd.
Een resultaat kan statistisch significant zijn en toch niet nuttig. Dat gebeurt vaak bij grote datasets.
Vertrouw dus niet alleen op de p-waarde. Kijk naar de effectgrootte en vraag je af of het uitmaakt voor echte beslissingen.
De t-statistiek wordt gebruikt om te testen of een resultaat betekenisvol afwijkt van een referentiewaarde, vaak nul. Die referentie staat voor geen effect of geen verschil.
Ze beantwoordt één vraag: is het waargenomen resultaat groot genoeg om als echt te beschouwen in plaats van als willekeurige variatie.
Gebruik dit bij het vergelijken van een steekproefgemiddelde met een bekende of veronderstelde waarde.
Stel dat de gemiddelde tijd op een pagina 5 minuten wordt verwacht en jouw steekproef 6 minuten laat zien. De t-statistiek beoordeelt of deze kloof van 1 minuut betekenisvol is.
Dit vormt de basis om de nulhypothese te verwerpen of niet te verwerpen.
Gebruik dit om twee onafhankelijke groepen te vergelijken.
Neem conversieratio’s voor twee landingspagina’s als voorbeeld:
Een hoger gemiddelde in één groep is op zichzelf niet genoeg. De t-statistiek controleert of de kloof tussen de twee gemiddelden statistisch significant is.
Een grotere absolute t-waarde betekent sterker bewijs dat het verschil echt is.
Gebruik dit wanneer dezelfde groep tweemaal wordt gemeten.
Stel dat je gebruikersbetrokkenheid vóór en na een feature-update hebt. Elke observatie is gekoppeld. Je werkt met de verschillen binnen elk paar in plaats van aparte groepen te vergelijken.
De t-statistiek test of de gemiddelde verandering over alle paren verschilt van nul. Dit laat zien of de wijziging een betekenisvol effect had.
Bij regressie heeft elke coëfficiënt zijn eigen t-statistiek. Elke coëfficiënt vertegenwoordigt de relatie tussen een predictor en de uitkomst.
Stel dat een coëfficiënt het effect van e-mailfrequentie op conversies weergeeft. De t-statistiek test of die coëfficiënt afwijkt van nul.
Dit helpt bepalen welke variabelen bijdragen aan het model.
Een t-tabel helpt je beslissen of je resultaat statistisch significant is. Hij geeft kritieke waarden op basis van:
Volg deze stappen:
Vergelijk nu je resultaat met de kritieke waarde:
|
Vrijheidsgraden (df) |
0,10 |
0,05 |
0,01 |
|
1 |
6,314 |
12,706 |
63,657 |
|
2 |
2,92 |
4,303 |
9,925 |
|
5 |
2,015 |
2,571 |
4,032 |
|
10 |
1,812 |
2,228 |
3,169 |
|
20 |
1,725 |
2,086 |
2,845 |
|
30 |
1,697 |
2,04 |
2,75 |
|
∞ (zeer grote steekproef) |
1,64 |
1,96 |
2,58 |
Zo lees je deze tabel.
Stel:
Uit de tabel:
Vergelijk nu:
Omdat 2,3 groter is dan 2,23, is het resultaat statistisch significant.
Het belangrijkste verschil is simpel:
Lees meer over het verschil tussen t-statistieken en z-statistieken in onze gids.
Gebruik de t-statistiek wanneer je met steekproefdata werkt en je de populatiestandaarddeviatie niet kent.
Dit is de gebruikelijke situatie. Je schat de variabiliteit met de steekproefstandaarddeviatie, wat onzekerheid introduceert. De t-statistiek corrigeert voor die onzekerheid en is daardoor geschikt voor kleinere datasets.
Stel dat je data van 25 gebruikers verzamelt om de gemiddelde sessietijd te schatten. Omdat de echte populatievariabiliteit onbekend is, gebruik je de t-statistiek.
Gebruik de z-statistiek wanneer de populatiestandaarddeviatie bekend is.
Dit komt minder vaak voor, maar kan gelden in gecontroleerde omgevingen of wanneer je stabiele historische data hebt. Hij wordt ook gebruikt bij zeer grote steekproeven, waar de steekproefstandaarddeviatie dicht bij de populatiewaarde ligt.
Als een bedrijf langetermijndata heeft en de exacte standaarddeviatie van een metric kent, kan het de z-statistiek gebruiken voor toetsen.
De steekproefgrootte beïnvloedt hoeveel onzekerheid er in je schattingen zit.
De t-verdeling houdt hier rekening mee door breder te zijn bij kleine steekproeven, wat tot conservatievere resultaten leidt.
Naarmate de steekproefgrootte toeneemt, wordt het verschil tussen beide methoden minimaal. Bij grote datasets leveren beide benaderingen vrijwel identieke resultaten op. Daarom wordt de z-statistiek vaak als benadering gebruikt bij grootschalige analyses.
De t-statistiek is één enkele waarde en de t-toets is het volledige beslissingsproces. Laten we beide begrijpen:
Dit hebben we al vaak behandeld, maar ik herhaal het: de t-statistiek wordt berekend op basis van je steekproefdata. Hij laat zien hoe ver je resultaat van de nulhypothesewaarde ligt, meestal nul.
Hij geeft de grootte van het verschil weer ten opzichte van de variabiliteit in de data. Op zichzelf vertelt hij niet of het resultaat significant is.
De t-toets is een specifieke manier om een hypothesetoets uit te voeren.
Die omvat:
Dit proces bepaalt of het waargenomen verschil statistisch significant is.
De t-statistiek is één stap binnen de t-toets.
Je berekent eerst de t-waarde. Vervolgens gebruik je die om een p-waarde te krijgen of te vergelijken met een kritieke waarde. Die laatste stap stelt je in staat te beslissen of je de nulhypothese verwerpt.
De meeste fouten komen voort uit interpretatie, niet uit berekening. De t-statistiek is makkelijk te berekenen maar eenvoudig verkeerd te gebruiken als je cruciale details negeert.
Een grote t-waarde op zichzelf zegt niet veel. De betekenis hangt af van steekproefgrootte en variabiliteit.
Wat te doen:
De t-statistiek berust op enkele voorwaarden. Als die niet worden vervuld, kunnen resultaten onbetrouwbaar zijn. Belangrijkste aannames zijn:
Wat te doen:
De verkeerde toets kiezen verandert de conclusie. Een eenzijdige toets kijkt naar één richting en een tweezijdige toets kijkt naar beide richtingen
Wat te doen:
Het vergelijken van meer dan twee groepen met meerdere t-toetsen verhoogt het risico op valse positieven.
Dit moet je doen: Gebruik ANOVA voor drie of meer groepen. Voer daarna indien nodig post-hoc-toetsen uit
Een kleine p-waarde toont statistische significantie, geen praktische belangrijkheid. Zorg dat je de effectgrootte bekijkt en beoordeelt of het resultaat ertoe doet in echte beslissingen.
Verschillen komen voor in alle datasets. De uitdaging is weten of ze een echt effect weerspiegelen of willekeurige variatie. De t-statistiek pakt dit aan door het verschil te schalen op basis van onzekerheid.
Zonder de t-statistiek zie je alleen verschillen. Met de t-statistiek kun je beoordelen of die verschillen het waard zijn om op te handelen.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

