
Corso
Introduzione alla statistica
4 ore
161.7K
La statistica t indica se una differenza osservata è significativa o probabilmente dovuta alla variabilità casuale.
Le differenze compaiono in quasi tutti i dataset. La domanda chiave è se il risultato rifletta un effetto reale. La statistica t risponde confrontando l’ampiezza della differenza con l’incertezza nei dati.
Per questo è ampiamente usata nei test d’ipotesi e nella regressione. Ti aiuta a valutare se un risultato è statisticamente significativo e vale la pena prenderlo sul serio.
In questa guida imparerai cosa significa la statistica t, come calcolarla, come interpretarla e come applicarla negli scenari di test più comuni.
La statistica t misura quanto un risultato si discosta da un valore di riferimento dopo aver tenuto conto della variabilità nei dati.
In parole semplici, è la differenza scalata per l’incertezza. Questo trasforma un divario grezzo in un valore standardizzato che puoi valutare.
Considera una classe con una media di 78 rispetto a un benchmark di 75. La differenza è di 3 punti. Quel numero da solo non dice molto. Se i punteggi sono molto concentrati, il divario può essere significativo. Se i punteggi variano molto, lo stesso divario può non contare.
La statistica t combina entrambi gli elementi in un unico valore. Mostra se la differenza osservata è grande rispetto alla variazione nei dati.
Questo è importante perché la stessa differenza può portare a conclusioni diverse a seconda di quanto siano stabili i dati. La statistica t contestualizza il risultato così puoi giudicarne la significatività.
La vedrai usata in scenari comuni:
In tutti questi casi, la logica resta la stessa: misura la distanza da un punto di riferimento, aggiusta per la variabilità e valuta se il risultato è significativo.
La t-statistic segue una struttura semplice. Confronta ciò che hai osservato con ciò che ti aspettavi e poi scala quella differenza in base all’incertezza.
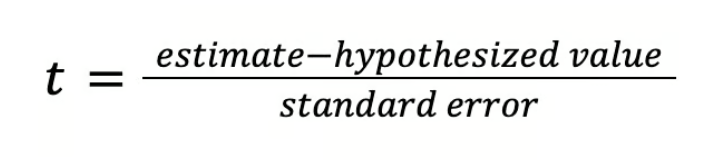
In questa formula:
La estimate è il risultato campionario
Il hypothesized value è il valore rispetto a cui stai testando
standard error misura quanto la tua stima può variare per effetto del caso
Quindi la t-statistic ti dice di quante errori standard il tuo risultato si discosta dal valore che stai testando.
Si usa quando confronti una media campionaria con un valore noto.
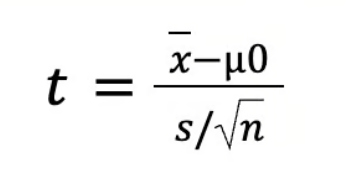
Qui:
x è la media campionaria
μ0 è il valore ipotizzato
s è la deviazione standard campionaria
n è la dimensione del campione
Il denominatore s/n è l’errore standard della media.
Questo test confronta le medie di due gruppi separati. La struttura resta coerente:
C’è però una piccola variazione: quando calcoli l’errore standard, devi decidere come trattare la variabilità in entrambi i gruppi.
Ci sono due approcci comuni.
Usalo quando i gruppi hanno livelli di dispersione diversi, cosa comune nei dati reali:
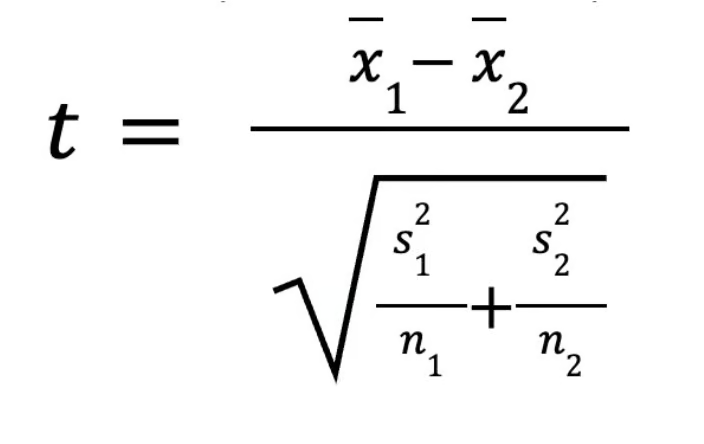
Usalo quando entrambi i gruppi mostrano variabilità simile:
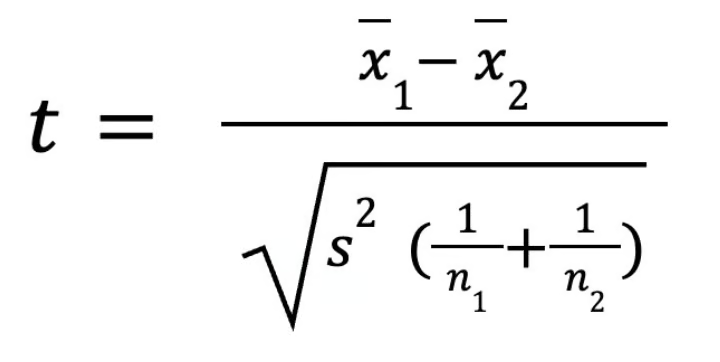
Nella regressione, ogni coefficiente ha la propria statistica t.
Questo mostra se un predittore ha una relazione significativa con la variabile di output.
Considera un caso a un campione:
Passo 1: Calcola l’errore standard
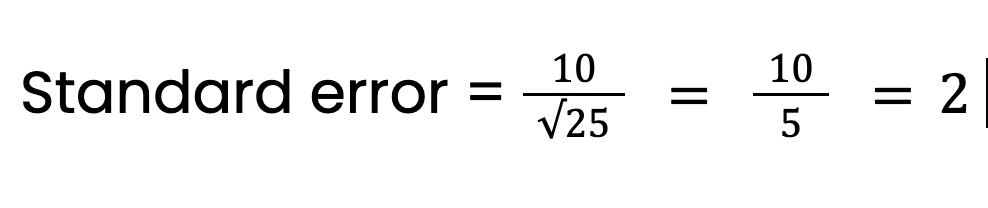
Passo 2: Trova la differenza
Differenza = 78 − 75 = 3
Passo 3: Calcola la statistica t
T = 3/2 = 1,5
La media campionaria è 1,5 errori standard sopra il valore di riferimento. Questo valore è usato nel passo successivo per valutare la significatività statistica.
La statistica t diventa utile solo quando la confronti con una distribuzione di riferimento. Questa è la distribuzione t.
Mostra come appaiono i valori di t quando non c’è un effetto reale. Una volta calcolato un valore di t, verifichi dove cade su questa distribuzione. Valori lontani dal centro sono meno probabili per caso. Valori vicini al centro sono più coerenti con la variazione casuale.
I gradi di libertà controllano la forma della distribuzione t. Riflettono quante informazioni affidabili forniscono i tuoi dati: più dati portano a stime più stabili, meno dati aumentano l’incertezza.
Alcune formule comuni sono:
Con campioni piccoli, è più difficile stimare la variabilità. Questo rende più probabili valori di t estremi, quindi la distribuzione t è più larga.
Questo porta a due conseguenze:
All’aumentare della dimensione del campione, le stime diventano più stabili. La distribuzione t si restringe e inizia ad assomigliare a quella normale. Con campioni grandi, la differenza tra le due è minima.
Una t-statistic più grande significa prove più forti contro l’ipotesi nulla. Una t-statistic più piccola significa che il risultato può essere dovuto alla variazione casuale.
Questa è l’idea di base. Ora rendiamola pratica.
Concentrati su quanto il valore è distante da 0.
Il segno indica solo la direzione.
Per l’interpretazione, conta più la magnitudine che il segno.
Dopo aver calcolato la statistica t, confrontala con la distribuzione t. Questo dà il p-value, che indica quanto è probabile il tuo risultato sotto l’ipotesi nulla.
La statistica t dà la distanza. Il p-value mostra quanto è inusuale quella distanza.
La scelta dipende dalla tua ipotesi:
I test a due code sono più comuni. Quelli a una coda si usano solo quando la direzione è definita prima dell’analisi.
Un risultato può essere statisticamente significativo e comunque poco utile. Succede spesso con dataset molto grandi.
Quindi non affidarti solo al p-value. Guarda la dimensione dell’effetto e chiediti se conta nelle decisioni reali.
La statistica t è usata per verificare se un risultato è significativamente diverso da un valore di riferimento, spesso zero. Quel riferimento rappresenta assenza di effetto o di differenza.
Risponde a una sola domanda: il risultato osservato è abbastanza grande da essere considerato reale e non variazione casuale?
Usalo quando confronti una media campionaria con un valore noto o assunto.
Supponi che il tempo medio su una pagina sia atteso di 5 minuti e il tuo campione mostri 6 minuti. La statistica t valuta se questo divario di 1 minuto è significativo.
Questo è alla base della decisione di rifiutare o non rifiutare l’ipotesi nulla.
Usalo per confrontare due gruppi indipendenti.
Prendi come esempio i tassi di conversione di due landing page:
Una media più alta in un gruppo da sola non basta. La statistica t verifica se il divario tra le due medie è statisticamente significativo.
Un valore assoluto di t più grande indica evidenze più forti che la differenza sia reale.
Usalo quando lo stesso gruppo è misurato due volte.
Supponi di avere il coinvolgimento degli utenti prima e dopo un aggiornamento di una funzionalità. Ogni osservazione è collegata. Lavori con le differenze all’interno di ciascuna coppia invece di confrontare gruppi separati.
La statistica t verifica se il cambiamento medio tra tutte le coppie differisce da zero. Questo mostra se il cambiamento ha avuto un effetto significativo.
Nella regressione, ogni coefficiente ha la propria statistica t. Ogni coefficiente rappresenta la relazione tra un predittore e l’output.
Supponi che un coefficiente rappresenti l’effetto della frequenza delle email sulle conversioni. La statistica t verifica se quel coefficiente differisce da zero.
Questo aiuta a identificare quali variabili contribuiscono al modello.
Una tabella t ti aiuta a decidere se il tuo risultato è statisticamente significativo. Fornisce valori critici in base a:
Segui questi passaggi:
Ora confronta il tuo risultato con il valore critico:
|
Gradi di libertà (df) |
0,10 |
0,05 |
0,01 |
|
1 |
6,314 |
12,706 |
63,657 |
|
2 |
2,92 |
4,303 |
9,925 |
|
5 |
2,015 |
2,571 |
4,032 |
|
10 |
1,812 |
2,228 |
3,169 |
|
20 |
1,725 |
2,086 |
2,845 |
|
30 |
1,697 |
2,04 |
2,75 |
|
∞ (campione molto grande) |
1,64 |
1,96 |
2,58 |
Ecco come leggere questa tabella.
Poniamo che:
Dalla tabella:
Ora confronta:
Poiché 2,3 è maggiore di 2,23, il risultato è statisticamente significativo.
La differenza chiave è semplice:
Scopri di più sulla differenza tra statistiche t e z nella nostra guida.
Usa la statistica t quando lavori con dati campionari e non conosci la deviazione standard della popolazione.
Questo è il caso più comune. Stim i la variabilità usando la deviazione standard del campione, che introduce incertezza. La statistica t corregge per tale incertezza, rendendola adatta a dataset più piccoli.
Poniamo che raccogli dati da 25 utenti per stimare il tempo medio di sessione. Poiché la variabilità reale della popolazione è sconosciuta, usi la statistica t.
Usa la statistica z quando la deviazione standard della popolazione è nota.
È meno comune ma può applicarsi in ambienti controllati o quando disponi di dati storici stabili. Si usa anche con campioni molto grandi, dove la deviazione standard del campione coincide strettamente con il valore di popolazione.
Se un’azienda ha dati di lungo periodo e conosce l’esatta deviazione standard di una metrica, può usare la statistica z per i test.
La dimensione del campione influisce su quanta incertezza esiste nelle stime.
La distribuzione t tiene conto di ciò ampliandosi per campioni piccoli, il che porta a risultati più conservativi.
All’aumentare della dimensione del campione, la differenza tra i due metodi diventa minima. Con dataset grandi, entrambi gli approcci producono risultati quasi identici. Per questo la statistica z è spesso usata come approssimazione nelle analisi su larga scala.
La statistica t è un singolo valore, mentre il t test è l’intero processo decisionale. Capiremo entrambi:
Lo abbiamo già visto molto, ma ribadiamo: la statistica t è calcolata dai tuoi dati campionari. Mostra quanto il tuo risultato si discosta dal valore dell’ipotesi nulla, di solito zero.
Ti dà l’ampiezza della differenza rispetto alla variabilità nei dati. Da sola, non ti dice se il risultato è significativo.
Il t-test è un modo specifico di fare un test d’ipotesi.
Comprende:
Questo processo determina se la differenza osservata è statisticamente significativa.
La statistica t è un passaggio all’interno del t test.
Prima calcoli il valore di t. Poi lo usi per ottenere un p-value o confrontarlo con un valore critico. Quel passaggio finale ti consente di decidere se rifiutare l’ipotesi nulla.
La maggior parte degli errori riguarda l’interpretazione, non il calcolo. La statistica t è facile da calcolare ma facile da usare male se si ignorano dettagli chiave.
Un valore di t grande da solo non dice molto. Il suo significato dipende da dimensione del campione e variabilità.
Cosa fare:
La statistica t si basa su alcune condizioni. Se non sono soddisfatte, i risultati possono essere inaffidabili. Le ipotesi principali sono:
Cosa fare:
Scegliere il test sbagliato cambia la conclusione. Il test a una coda verifica una direzione, quello a due code verifica entrambe le direzioni
Cosa fare:
Confrontare più di due gruppi con t test multipli aumenta il rischio di falsi positivi.
Ecco cosa fare: usa ANOVA per tre o più gruppi. Poi, prosegui con test post hoc se necessario
Un p-value piccolo indica significatività statistica, non importanza pratica. Assicurati di verificare la dimensione dell’effetto e valutare se il risultato conta nelle decisioni reali.
Le differenze compaiono in tutti i dataset. La sfida è capire se riflettono un effetto reale o la variazione casuale. La statistica t affronta questo aspetto scalando la differenza in base all’incertezza.
Senza la statistica t, vedi solo differenze. Con essa, puoi valutare se quelle differenze meritano di essere considerate nelle azioni.
Impara con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



