Die t-Statistik zeigt, ob ein beobachteter Unterschied aussagekräftig ist oder eher auf zufällige Schwankungen zurückgeht.
Unterschiede finden sich in fast jedem Datensatz. Die Kernfrage ist, ob das Ergebnis einen echten Effekt widerspiegelt. Die t-Statistik beantwortet das, indem sie die Größe des Unterschieds mit der Unsicherheit in den Daten vergleicht.
Deshalb wird sie häufig in Hypothesentests und in der Regression eingesetzt. Sie hilft dir einzuschätzen, ob ein Ergebnis statistisch signifikant ist und ernst genommen werden sollte.
In diesem Leitfaden erfährst du, was die t-Statistik bedeutet, wie du sie berechnest, wie du sie interpretierst und wie du sie in typischen Testszenarien anwendest.
Was ist die t-Statistik in der Statistik?
Die t-Statistik misst, wie weit ein Ergebnis nach Berücksichtigung der Datenvariabilität von einem Referenzwert entfernt ist.
Einfach gesagt: Es ist der Unterschied, skaliert nach Unsicherheit. So wird aus einer rohen Differenz ein standardisierter Wert, den du bewerten kannst.
Stell dir eine Klasse mit einem Durchschnitt von 78 gegenüber einem Benchmark von 75 vor. Die Differenz beträgt 3 Punkte. Diese Zahl allein sagt wenig aus. Wenn die Ergebnisse eng beieinanderliegen, kann die Lücke bedeutsam sein. Streuen die Werte stark, kann dieselbe Lücke unwichtig sein.
Die t-Statistik fasst beides in einem Wert zusammen. Sie zeigt, ob der beobachtete Unterschied groß ist im Verhältnis zur Streuung in den Daten.
Das ist wichtig, weil dieselbe Differenz zu unterschiedlichen Schlussfolgerungen führen kann, je nachdem, wie stabil die Daten sind. Die t-Statistik setzt das Ergebnis in Kontext, damit du seine Bedeutung beurteilen kannst.
Du triffst sie in typischen Fällen an:
- Ein-Stichproben-t-Test prüft, ob ein Stichprobenmittelwert von einem bekannten Wert abweicht
- Zwei-Stichproben-t-Test vergleicht die Mittelwerte zweier Gruppen
- Gepaarter t-Test vergleicht dieselbe Gruppe vor und nach einer Änderung
- Regressionsanalyse testet, ob ein Koeffizient von null abweicht
In all diesen Fällen bleibt die Logik gleich: Distanz zum Referenzpunkt messen, für Variabilität anpassen und bewerten, ob das Ergebnis aussagekräftig ist.
Die t-Statistik folgt einer einfachen Struktur. Sie vergleicht Beobachtung und Erwartung und skaliert diesen Unterschied mit der Unsicherheit.
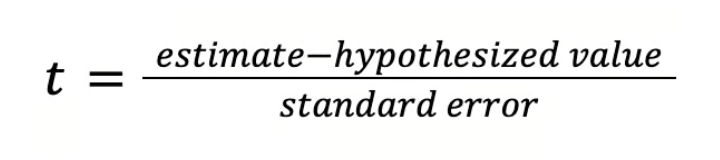
In dieser Formel gilt:
-
Der estimate ist dein Stichprobenergebnis
-
Der hypothesized value ist der Vergleichswert im Test
-
standard error misst, wie stark dein Schätzwert durch Zufall variieren kann
Die t-Statistik zeigt also, wie viele Standardfehler dein Ergebnis vom Testwert entfernt ist.
Ein-Stichproben-t-Statistik
Verwende sie, wenn du einen Stichprobenmittelwert mit einem bekannten Wert vergleichst.
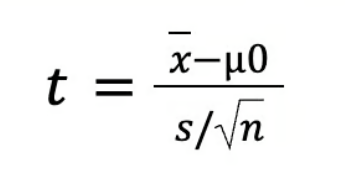
Dabei gilt:
-
x ist der Stichprobenmittelwert
-
μ0 ist der hypothetische Vergleichswert
-
s ist die Stichproben-Standardabweichung
-
n ist der Stichprobenumfang
Der Nenner
Zwei-Stichproben-t-Statistik (unabhängige Stichproben)
Dieser Test vergleicht die Mittelwerte zweier getrennter Gruppen. Die Struktur bleibt gleich:
- Zähler: Differenz der beiden Stichprobenmittelwerte
- Nenner: Standardfehler dieser Differenz
Es gibt jedoch eine kleine Änderung: Bei der Berechnung des Standardfehlers musst du entscheiden, wie du die Variabilität in beiden Gruppen behandelst.
Dafür gibt es zwei gängige Ansätze.
1. Ungleiche Varianzen
Verwende dies, wenn die Gruppen unterschiedlich stark streuen – das ist in realen Daten häufig:
- Jede Gruppe behält ihre eigene Varianz
- Beide Varianzen werden zur Berechnung des Standardfehlers kombiniert
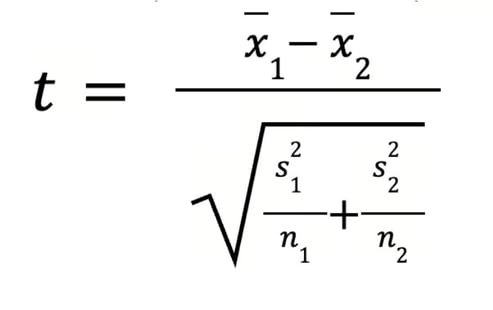
2. Gleiche Varianzen
Verwende dies, wenn beide Gruppen eine ähnliche Streuung zeigen:
- Varianzen werden zu einer gepoolten Schätzung zusammengeführt
- Die Berechnung wird einfacher
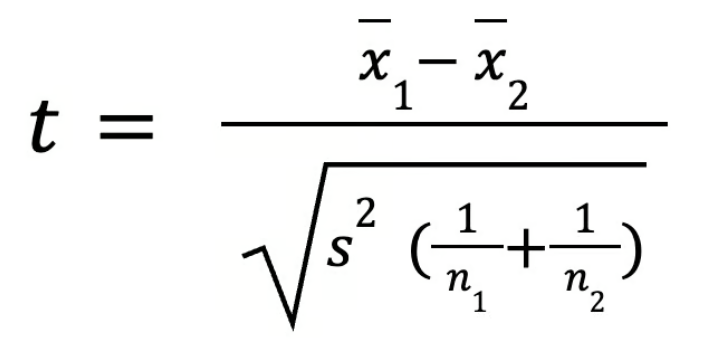
t-Statistik für Regressionskoeffizienten
In der Regression hat jeder Koeffizient seine eigene t-Statistik.
- Zähler: geschätzter Koeffizient
- Nenner: Standardfehler dieses Koeffizienten
So erkennst du, ob ein Prädiktor in sinnvoller Weise mit der Zielvariable zusammenhängt.
Ein kurzes Zahlenbeispiel
Betrachten wir den Ein-Stichproben-Fall:
- Stichprobenmittelwert = 78
- Hypothetischer Wert = 75
- Stichproben-Standardabweichung = 10
- Stichprobenumfang = 25
Schritt 1: Standardfehler berechnen
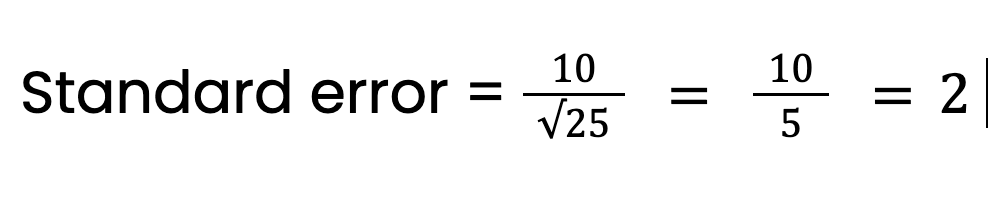
Schritt 2: Differenz bestimmen
Differenz = 78 − 75 = 3
Schritt 3: t-Statistik berechnen
T = 3/2 = 1,5
Der Stichprobenmittelwert liegt 1,5 Standardfehler über dem Referenzwert. Dieser Wert wird im nächsten Schritt verwendet, um die statistische Signifikanz zu beurteilen.
Die t-Verteilung und Freiheitsgrade
Nützlich wird die t-Statistik erst, wenn du sie mit einer Referenzverteilung vergleichst. Diese Referenz ist die t-Verteilung.
Sie zeigt, wie t-Werte aussehen, wenn es keinen echten Effekt gibt. Sobald du einen t-Wert berechnet hast, prüfst du, wo er in dieser Verteilung liegt. Werte weit vom Zentrum treten seltener zufällig auf. Werte nahe am Zentrum sind eher mit Zufallsschwankungen vereinbar.
Was Freiheitsgrade bedeuten
Freiheitsgrade steuern die Form der t-Verteilung. Sie spiegeln wider, wie viel verlässliche Information deine Daten liefern: Mehr Daten führen zu stabileren Schätzungen, weniger Daten erhöhen die Unsicherheit.
Gängige Formeln sind:
- Ein-Stichproben-t-Test: Freiheitsgrade = n − 1
- Zwei-Stichproben-t-Test: Freiheitsgrade = n₁ + n₂ − 2
- Regression: Freiheitsgrade = n − k − 1, wobei k die Anzahl der Prädiktoren ist
Wie der Stichprobenumfang die Verteilung beeinflusst
Bei kleinen Stichproben ist die Variabilität schwerer zu schätzen. Extreme t-Werte treten dadurch häufiger auf, die t-Verteilung ist breiter.
Das hat zwei Folgen:
- Größere t-Werte sind nötig, um Signifikanz zu zeigen
- Ergebnisse sind schwerer als bedeutsam einzustufen
Mit wachsendem Stichprobenumfang werden Schätzungen stabiler. Die t-Verteilung wird schmaler und nähert sich der Normalverteilung an. Bei großen Stichproben sind die Unterschiede minimal.
Wie man die t-Statistik interpretiert
Eine größere t-Statistik bedeutet stärkere Evidenz gegen die Nullhypothese. Eine kleinere t-Statistik deutet darauf hin, dass das Ergebnis zufällig sein könnte.
Das ist die Kernidee. Machen wir es jetzt praktisch.
Was die Größe von t aussagt
Achte darauf, wie weit der Wert von 0 entfernt ist.
- t nahe 0 > kaum oder kein Unterschied
- größeres t > stärkerer Unterschied
- sehr großes t > starke Evidenz gegen die Nullhypothese
Das Vorzeichen zeigt nur die Richtung.
- positiv > über dem Erwartungswert
- negativ > unter dem Erwartungswert
Für die Interpretation ist die Größe wichtiger als das Vorzeichen.
So erhältst du den p-Wert
Nach der Berechnung der t-Statistik vergleichst du sie mit der t-Verteilung. Daraus ergibt sich der p-Wert, der zeigt, wie wahrscheinlich dein Ergebnis unter der Nullhypothese ist.
- kleiner p-Wert > Ergebnis unter der Null unwahrscheinlich, stärkere Evidenz dagegen
- großer p-Wert > Ergebnis unter der Null wahrscheinlich, schwache Evidenz
Die t-Statistik liefert die Distanz. Der p-Wert zeigt, wie ungewöhnlich diese Distanz ist.
Einseitige vs. zweiseitige Tests
Die Wahl hängt von deiner Hypothese ab:
- Zweiseitiger Test prüft auf jeden Unterschied, höher oder niedriger
- Einseitiger Test prüft auf einen Unterschied in einer festgelegten Richtung
Zweiseitige Tests sind häufiger. Einseitige werden nur verwendet, wenn die Richtung vor der Analyse festgelegt wurde.
Statistische Signifikanz vs. praktische Relevanz
Ein Ergebnis kann statistisch signifikant und dennoch nicht nützlich sein. Das passiert oft bei großen Datensätzen.
- Bei großen Stichproben können selbst kleine Unterschiede statistisch signifikant wirken
- Bei kleinen Stichproben erscheinen bedeutsame Unterschiede ggf. nicht signifikant
Verlass dich daher nicht nur auf den p-Wert. Sieh dir die Effektgröße an und frage, ob sie in Entscheidungen wirklich relevant ist.
t-Statistik in Hypothesentests
Die t-Statistik prüft, ob ein Ergebnis sinnvoll von einem Referenzwert abweicht, oft null. Dieser Referenzwert steht für keinen Effekt oder keinen Unterschied.
Sie beantwortet eine Frage: Ist das beobachtete Ergebnis groß genug, um es als real statt als zufällige Schwankung zu behandeln?
Testen eines Populationsmittelwerts
Verwende dies, wenn du einen Stichprobenmittelwert mit einem bekannten oder angenommenen Wert vergleichst.
Angenommen, die durchschnittliche Verweildauer auf einer Seite wird mit 5 Minuten erwartet und deine Stichprobe zeigt 6 Minuten. Die t-Statistik bewertet, ob diese 1 Minute Differenz bedeutsam ist.
- kleiner t-Wert bedeutet, die Differenz ist wahrscheinlich zufällig
- großer t-Wert bedeutet, die Differenz ist wahrscheinlich real
Darauf basiert die Entscheidung, die Nullhypothese zu verwerfen oder nicht.
Vergleich zweier Mittelwerte
Nutze dies zum Vergleich zweier unabhängiger Gruppen.
Beispiel: Conversion-Raten für zwei Landingpages:
- Gruppe A: altes Design
- Gruppe B: neues Design
Ein höherer Durchschnitt in einer Gruppe reicht allein nicht. Die t-Statistik prüft, ob die Lücke zwischen den beiden Mittelwerten statistisch signifikant ist.
Ein größerer absoluter t-Wert bedeutet stärkere Evidenz, dass der Unterschied real ist.
Gepaarte Stichproben testen
Nutze dies, wenn dieselbe Gruppe zweimal gemessen wird.
Angenommen, du hast Nutzungsdaten vor und nach einem Feature-Update. Jede Beobachtung ist gepaart. Du arbeitest mit den Differenzen innerhalb jedes Paares statt mit separaten Gruppen.
Die t-Statistik prüft, ob die durchschnittliche Veränderung über alle Paare ungleich null ist. So erkennst du, ob die Änderung einen messbaren Effekt hatte.
Regressionskoeffizienten testen
In der Regression hat jeder Koeffizient seine eigene t-Statistik. Jeder Koeffizient beschreibt die Beziehung zwischen einem Prädiktor und dem Ergebnis.
Ein Koeffizient kann etwa den Effekt der E-Mail-Frequenz auf Conversions darstellen. Die t-Statistik prüft, ob dieser Koeffizient von null abweicht.
- Wert nahe null bedeutet geringer oder kein Effekt
- Wert weit von null bedeutet wahrscheinlich bedeutsamer Effekt
So lässt sich erkennen, welche Variablen zum Modell beitragen.
t-Tabelle
Eine t-Tabelle hilft dir zu entscheiden, ob dein Ergebnis statistisch signifikant ist. Sie liefert kritische Werte basierend auf:
- Freiheitsgraden
- gewähltem Signifikanzniveau (z. B. 0,05)
So nutzt du die t-Tabelle
Gehe so vor:
- Berechne deine t-Statistik
- Bestimme deine Freiheitsgrade
- Wähle dein Signifikanzniveau
- Schlage den kritischen Wert in der Tabelle nach
Vergleiche nun dein Ergebnis mit dem kritischen Wert:
- Wenn dein t-Wert größer als der Tabellenwert ist, ist das Ergebnis statistisch signifikant
- Ist er kleiner, ist es nicht statistisch signifikant
|
Freiheitsgrade (df)
|
0,10
|
0,05
|
0,01
|
|
1
|
6,314
|
12,706
|
63,657
|
|
2
|
2,92
|
4,303
|
9,925
|
|
5
|
2,015
|
2,571
|
4,032
|
|
10
|
1,812
|
2,228
|
3,169
|
|
20
|
1,725
|
2,086
|
2,845
|
|
30
|
1,697
|
2,04
|
2,75
|
|
∞ (sehr große Stichprobe)
|
1,64
|
1,96
|
2,58
|
So liest du diese Tabelle.
Angenommen:
- Deine t-Statistik = 2,3
- Freiheitsgrade = 10
- Signifikanzniveau = 0,05
Aus der Tabelle:
Jetzt der Vergleich:
- Dein t = 2,3
- Tabellenwert = 2,23
Da 2,3 größer als 2,23 ist, ist das Ergebnis statistisch signifikant.
t-Statistik vs. z-Statistik: Wo liegt der Unterschied?
Der wesentliche Unterschied ist einfach:
- Verwende die t-Statistik, wenn die Populations-Standardabweichung unbekannt ist
- Verwende die z-Statistik, wenn sie bekannt ist
Erfahre mehr über den Unterschied zwischen t- und z-Statistiken in unserem Leitfaden.
Wann du die t-Statistik verwendest
Nutze die t-Statistik, wenn du mit Stichprobendaten arbeitest und die Populations-Standardabweichung nicht kennst.
Das ist der Regelfall. Du schätzt die Variabilität über die Stichproben-Standardabweichung, was zusätzliche Unsicherheit einbringt. Die t-Statistik passt dafür an und eignet sich besonders für kleinere Datensätze.
Wenn du z. B. Daten von 25 Nutzern sammelst, um die durchschnittliche Sitzungsdauer zu schätzen, ist die wahre Populationsstreuung unbekannt – du verwendest die t-Statistik.
Wann du die z-Statistik verwendest
Nutze die z-Statistik, wenn die Populations-Standardabweichung bekannt ist.
Das ist seltener, kommt aber in kontrollierten Umgebungen oder bei stabilen historischen Daten vor. Sie wird auch bei sehr großen Stichproben genutzt, wenn die Stichproben-Standardabweichung dem Populationswert nahekommt.
Wenn ein Unternehmen Langzeitdaten hat und die genaue Standardabweichung einer Kennzahl kennt, kann es die z-Statistik für Tests verwenden.
Warum der Stichprobenumfang zählt
Der Stichprobenumfang beeinflusst, wie viel Unsicherheit in deinen Schätzungen steckt.
- kleine Stichproben: höhere Unsicherheit, daher ist die t-Statistik geeigneter
- große Stichproben: geringere Unsicherheit, die z-Statistik wird sinnvoll
Die t-Verteilung trägt dem Rechnung, indem sie bei kleinen Stichproben breiter ist – die Ergebnisse sind konservativer.
Wie sich t und z annähern
Mit wachsendem Stichprobenumfang werden die Unterschiede der beiden Verfahren minimal. Bei großen Datensätzen liefern beide nahezu identische Resultate. Deshalb wird die z-Statistik in groß angelegten Analysen oft als Annäherung genutzt.
t-Statistik vs. t-Test: Wo liegt der Unterschied?
Die t-Statistik ist ein einzelner Wert, der t-Test ist der vollständige Entscheidungsprozess. Schauen wir uns beides an:
Was ist die t-Statistik?
Das haben wir bereits ausführlich behandelt, aber zur Wiederholung: Die t-Statistik wird aus deinen Stichprobendaten berechnet. Sie zeigt, wie weit dein Ergebnis vom Nullhypothesenwert, meist null, entfernt ist.
Sie gibt die Größe des Unterschieds relativ zur Variabilität in den Daten an. Für sich genommen sagt sie nicht, ob das Ergebnis signifikant ist.
Was ist der t-Test?
Der t-Test ist eine spezifische Form des Hypothesentests.
Er umfasst:
- Formulierung von Null- und Alternativhypothese
- Berechnung der t-Statistik (siehe oben)
- Ermittlung des p-Werts oder eines kritischen Werts
- Entscheidung auf Basis des Ergebnisses
Dieser Prozess bestimmt, ob der beobachtete Unterschied statistisch signifikant ist.
Wie beides zusammenspielt
Die t-Statistik ist ein Schritt innerhalb des t-Tests.
Zuerst berechnest du den t-Wert. Dann nutzt du ihn, um einen p-Wert zu erhalten oder ihn mit einem kritischen Wert zu vergleichen. Dieser letzte Schritt ermöglicht die Entscheidung, ob die Nullhypothese verworfen wird.
Häufige Fehler bei der Verwendung der t-Statistik
Die meisten Fehler entstehen bei der Interpretation, nicht bei der Berechnung. Die t-Statistik ist leicht zu berechnen, aber leicht falsch zu nutzen, wenn wichtige Details ignoriert werden.
Bewertung des t-Werts ohne Kontext
Ein großer t-Wert sagt für sich genommen wenig aus. Seine Bedeutung hängt von Stichprobenumfang und Variabilität ab.
Was du tun solltest:
- t-Wert mit dem p-Wert interpretieren
- Stichprobenumfang berücksichtigen
- Streuung in den Daten prüfen
Wichtige Annahmen ignorieren
Die t-Statistik beruht auf einigen Bedingungen. Wenn sie nicht erfüllt sind, können die Ergebnisse unzuverlässig sein. Wichtige Annahmen sind:
- Daten sind ungefähr normalverteilt, insbesondere bei kleinen Stichproben
- Beobachtungen sind unabhängig
Was du tun solltest:
- Datenverteilung prüfen
- Mit Grafiken oder Kennzahlen Probleme identifizieren
- Alternative Methoden nutzen, wenn Annahmen verletzt sind
Verwechslung von einseitigen und zweiseitigen Tests
Die falsche Testwahl verändert das Fazit. Einseitige Tests prüfen in eine Richtung, zweiseitige in beide Richtungen.
Was du tun solltest:
- Testart vor der Analyse festlegen
- Standardmäßig zweiseitige Tests verwenden, außer eine Richtung ist zwingend
Mehrere t-Tests statt ANOVA durchführen
Der Vergleich von mehr als zwei Gruppen mit mehreren t-Tests erhöht das Risiko für Fehlalarme.
So gehst du vor: Nutze ANOVA für drei oder mehr Gruppen und führe bei Bedarf Post-hoc-Tests durch
Sich nur auf p-Werte verlassen
Ein kleiner p-Wert zeigt statistische Signifikanz, keine praktische Relevanz. Achte darauf, die Effektgröße zu prüfen und zu bewerten, ob das Ergebnis in Entscheidungen zählt.
Fazit
Unterschiede finden sich in allen Datensätzen. Die Herausforderung ist zu erkennen, ob sie einen echten Effekt widerspiegeln oder Zufall sind. Die t-Statistik löst das, indem sie die Differenz an der Unsicherheit misst.
Ohne t-Statistik siehst du nur Unterschiede. Mit ihr kannst du einschätzen, ob sich ein Handeln darauf lohnt.







Die t-Statistik zeigt, ob ein beobachteter Unterschied aussagekräftig ist oder eher auf zufällige Schwankungen zurückgeht.
Unterschiede finden sich in fast jedem Datensatz. Die Kernfrage ist, ob das Ergebnis einen echten Effekt widerspiegelt. Die t-Statistik beantwortet das, indem sie die Größe des Unterschieds mit der Unsicherheit in den Daten vergleicht.
Deshalb wird sie häufig in Hypothesentests und in der Regression eingesetzt. Sie hilft dir einzuschätzen, ob ein Ergebnis statistisch signifikant ist und ernst genommen werden sollte.
In diesem Leitfaden erfährst du, was die t-Statistik bedeutet, wie du sie berechnest, wie du sie interpretierst und wie du sie in typischen Testszenarien anwendest.
Was ist die t-Statistik in der Statistik?
Die t-Statistik misst, wie weit ein Ergebnis nach Berücksichtigung der Datenvariabilität von einem Referenzwert entfernt ist.
Einfach gesagt: Es ist der Unterschied, skaliert nach Unsicherheit. So wird aus einer rohen Differenz ein standardisierter Wert, den du bewerten kannst.
Stell dir eine Klasse mit einem Durchschnitt von 78 gegenüber einem Benchmark von 75 vor. Die Differenz beträgt 3 Punkte. Diese Zahl allein sagt wenig aus. Wenn die Ergebnisse eng beieinanderliegen, kann die Lücke bedeutsam sein. Streuen die Werte stark, kann dieselbe Lücke unwichtig sein.
Die t-Statistik fasst beides in einem Wert zusammen. Sie zeigt, ob der beobachtete Unterschied groß ist im Verhältnis zur Streuung in den Daten.
Das ist wichtig, weil dieselbe Differenz zu unterschiedlichen Schlussfolgerungen führen kann, je nachdem, wie stabil die Daten sind. Die t-Statistik setzt das Ergebnis in Kontext, damit du seine Bedeutung beurteilen kannst.
Du triffst sie in typischen Fällen an:
In all diesen Fällen bleibt die Logik gleich: Distanz zum Referenzpunkt messen, für Variabilität anpassen und bewerten, ob das Ergebnis aussagekräftig ist.
t-Statistik: Formel und Berechnung
Die t-Statistik folgt einer einfachen Struktur. Sie vergleicht Beobachtung und Erwartung und skaliert diesen Unterschied mit der Unsicherheit.
In dieser Formel gilt:
Der
estimateist dein StichprobenergebnisDer
hypothesized valueist der Vergleichswert im Teststandard errormisst, wie stark dein Schätzwert durch Zufall variieren kannDie t-Statistik zeigt also, wie viele Standardfehler dein Ergebnis vom Testwert entfernt ist.
Ein-Stichproben-t-Statistik
Verwende sie, wenn du einen Stichprobenmittelwert mit einem bekannten Wert vergleichst.
Dabei gilt:
xist der Stichprobenmittelwertμ0ist der hypothetische Vergleichswertsist die Stichproben-Standardabweichungnist der StichprobenumfangDer Nenner
s/n ist der Standardfehler des Mittelwerts.Zwei-Stichproben-t-Statistik (unabhängige Stichproben)
Dieser Test vergleicht die Mittelwerte zweier getrennter Gruppen. Die Struktur bleibt gleich:
Es gibt jedoch eine kleine Änderung: Bei der Berechnung des Standardfehlers musst du entscheiden, wie du die Variabilität in beiden Gruppen behandelst.
Dafür gibt es zwei gängige Ansätze.
1. Ungleiche Varianzen
Verwende dies, wenn die Gruppen unterschiedlich stark streuen – das ist in realen Daten häufig:
2. Gleiche Varianzen
Verwende dies, wenn beide Gruppen eine ähnliche Streuung zeigen:
t-Statistik für Regressionskoeffizienten
In der Regression hat jeder Koeffizient seine eigene t-Statistik.
So erkennst du, ob ein Prädiktor in sinnvoller Weise mit der Zielvariable zusammenhängt.
Ein kurzes Zahlenbeispiel
Betrachten wir den Ein-Stichproben-Fall:
Schritt 1: Standardfehler berechnen
Schritt 2: Differenz bestimmen
Differenz = 78 − 75 = 3
Schritt 3: t-Statistik berechnen
T = 3/2 = 1,5
Der Stichprobenmittelwert liegt 1,5 Standardfehler über dem Referenzwert. Dieser Wert wird im nächsten Schritt verwendet, um die statistische Signifikanz zu beurteilen.
Die t-Verteilung und Freiheitsgrade
Nützlich wird die t-Statistik erst, wenn du sie mit einer Referenzverteilung vergleichst. Diese Referenz ist die t-Verteilung.
Sie zeigt, wie t-Werte aussehen, wenn es keinen echten Effekt gibt. Sobald du einen t-Wert berechnet hast, prüfst du, wo er in dieser Verteilung liegt. Werte weit vom Zentrum treten seltener zufällig auf. Werte nahe am Zentrum sind eher mit Zufallsschwankungen vereinbar.
Was Freiheitsgrade bedeuten
Freiheitsgrade steuern die Form der t-Verteilung. Sie spiegeln wider, wie viel verlässliche Information deine Daten liefern: Mehr Daten führen zu stabileren Schätzungen, weniger Daten erhöhen die Unsicherheit.
Gängige Formeln sind:
Wie der Stichprobenumfang die Verteilung beeinflusst
Bei kleinen Stichproben ist die Variabilität schwerer zu schätzen. Extreme t-Werte treten dadurch häufiger auf, die t-Verteilung ist breiter.
Das hat zwei Folgen:
Mit wachsendem Stichprobenumfang werden Schätzungen stabiler. Die t-Verteilung wird schmaler und nähert sich der Normalverteilung an. Bei großen Stichproben sind die Unterschiede minimal.
Wie man die t-Statistik interpretiert
Eine größere t-Statistik bedeutet stärkere Evidenz gegen die Nullhypothese. Eine kleinere t-Statistik deutet darauf hin, dass das Ergebnis zufällig sein könnte.
Das ist die Kernidee. Machen wir es jetzt praktisch.
Was die Größe von t aussagt
Achte darauf, wie weit der Wert von 0 entfernt ist.
Das Vorzeichen zeigt nur die Richtung.
Für die Interpretation ist die Größe wichtiger als das Vorzeichen.
So erhältst du den p-Wert
Nach der Berechnung der t-Statistik vergleichst du sie mit der t-Verteilung. Daraus ergibt sich der p-Wert, der zeigt, wie wahrscheinlich dein Ergebnis unter der Nullhypothese ist.
Die t-Statistik liefert die Distanz. Der p-Wert zeigt, wie ungewöhnlich diese Distanz ist.
Einseitige vs. zweiseitige Tests
Die Wahl hängt von deiner Hypothese ab:
Zweiseitige Tests sind häufiger. Einseitige werden nur verwendet, wenn die Richtung vor der Analyse festgelegt wurde.
Statistische Signifikanz vs. praktische Relevanz
Ein Ergebnis kann statistisch signifikant und dennoch nicht nützlich sein. Das passiert oft bei großen Datensätzen.
Verlass dich daher nicht nur auf den p-Wert. Sieh dir die Effektgröße an und frage, ob sie in Entscheidungen wirklich relevant ist.
t-Statistik in Hypothesentests
Die t-Statistik prüft, ob ein Ergebnis sinnvoll von einem Referenzwert abweicht, oft null. Dieser Referenzwert steht für keinen Effekt oder keinen Unterschied.
Sie beantwortet eine Frage: Ist das beobachtete Ergebnis groß genug, um es als real statt als zufällige Schwankung zu behandeln?
Testen eines Populationsmittelwerts
Verwende dies, wenn du einen Stichprobenmittelwert mit einem bekannten oder angenommenen Wert vergleichst.
Angenommen, die durchschnittliche Verweildauer auf einer Seite wird mit 5 Minuten erwartet und deine Stichprobe zeigt 6 Minuten. Die t-Statistik bewertet, ob diese 1 Minute Differenz bedeutsam ist.
Darauf basiert die Entscheidung, die Nullhypothese zu verwerfen oder nicht.
Vergleich zweier Mittelwerte
Nutze dies zum Vergleich zweier unabhängiger Gruppen.
Beispiel: Conversion-Raten für zwei Landingpages:
Ein höherer Durchschnitt in einer Gruppe reicht allein nicht. Die t-Statistik prüft, ob die Lücke zwischen den beiden Mittelwerten statistisch signifikant ist.
Ein größerer absoluter t-Wert bedeutet stärkere Evidenz, dass der Unterschied real ist.
Gepaarte Stichproben testen
Nutze dies, wenn dieselbe Gruppe zweimal gemessen wird.
Angenommen, du hast Nutzungsdaten vor und nach einem Feature-Update. Jede Beobachtung ist gepaart. Du arbeitest mit den Differenzen innerhalb jedes Paares statt mit separaten Gruppen.
Die t-Statistik prüft, ob die durchschnittliche Veränderung über alle Paare ungleich null ist. So erkennst du, ob die Änderung einen messbaren Effekt hatte.
Regressionskoeffizienten testen
In der Regression hat jeder Koeffizient seine eigene t-Statistik. Jeder Koeffizient beschreibt die Beziehung zwischen einem Prädiktor und dem Ergebnis.
Ein Koeffizient kann etwa den Effekt der E-Mail-Frequenz auf Conversions darstellen. Die t-Statistik prüft, ob dieser Koeffizient von null abweicht.
So lässt sich erkennen, welche Variablen zum Modell beitragen.
t-Tabelle
Eine t-Tabelle hilft dir zu entscheiden, ob dein Ergebnis statistisch signifikant ist. Sie liefert kritische Werte basierend auf:
So nutzt du die t-Tabelle
Gehe so vor:
Vergleiche nun dein Ergebnis mit dem kritischen Wert:
Freiheitsgrade (df)
0,10
0,05
0,01
1
6,314
12,706
63,657
2
2,92
4,303
9,925
5
2,015
2,571
4,032
10
1,812
2,228
3,169
20
1,725
2,086
2,845
30
1,697
2,04
2,75
∞ (sehr große Stichprobe)
1,64
1,96
2,58
So liest du diese Tabelle.
Angenommen:
Aus der Tabelle:
Jetzt der Vergleich:
Da 2,3 größer als 2,23 ist, ist das Ergebnis statistisch signifikant.
t-Statistik vs. z-Statistik: Wo liegt der Unterschied?
Der wesentliche Unterschied ist einfach:
Erfahre mehr über den Unterschied zwischen t- und z-Statistiken in unserem Leitfaden.
Wann du die t-Statistik verwendest
Nutze die t-Statistik, wenn du mit Stichprobendaten arbeitest und die Populations-Standardabweichung nicht kennst.
Das ist der Regelfall. Du schätzt die Variabilität über die Stichproben-Standardabweichung, was zusätzliche Unsicherheit einbringt. Die t-Statistik passt dafür an und eignet sich besonders für kleinere Datensätze.
Wenn du z. B. Daten von 25 Nutzern sammelst, um die durchschnittliche Sitzungsdauer zu schätzen, ist die wahre Populationsstreuung unbekannt – du verwendest die t-Statistik.
Wann du die z-Statistik verwendest
Nutze die z-Statistik, wenn die Populations-Standardabweichung bekannt ist.
Das ist seltener, kommt aber in kontrollierten Umgebungen oder bei stabilen historischen Daten vor. Sie wird auch bei sehr großen Stichproben genutzt, wenn die Stichproben-Standardabweichung dem Populationswert nahekommt.
Wenn ein Unternehmen Langzeitdaten hat und die genaue Standardabweichung einer Kennzahl kennt, kann es die z-Statistik für Tests verwenden.
Warum der Stichprobenumfang zählt
Der Stichprobenumfang beeinflusst, wie viel Unsicherheit in deinen Schätzungen steckt.
Die t-Verteilung trägt dem Rechnung, indem sie bei kleinen Stichproben breiter ist – die Ergebnisse sind konservativer.
Wie sich t und z annähern
Mit wachsendem Stichprobenumfang werden die Unterschiede der beiden Verfahren minimal. Bei großen Datensätzen liefern beide nahezu identische Resultate. Deshalb wird die z-Statistik in groß angelegten Analysen oft als Annäherung genutzt.
t-Statistik vs. t-Test: Wo liegt der Unterschied?
Die t-Statistik ist ein einzelner Wert, der t-Test ist der vollständige Entscheidungsprozess. Schauen wir uns beides an:
Was ist die t-Statistik?
Das haben wir bereits ausführlich behandelt, aber zur Wiederholung: Die t-Statistik wird aus deinen Stichprobendaten berechnet. Sie zeigt, wie weit dein Ergebnis vom Nullhypothesenwert, meist null, entfernt ist.
Sie gibt die Größe des Unterschieds relativ zur Variabilität in den Daten an. Für sich genommen sagt sie nicht, ob das Ergebnis signifikant ist.
Was ist der t-Test?
Der t-Test ist eine spezifische Form des Hypothesentests.
Er umfasst:
Dieser Prozess bestimmt, ob der beobachtete Unterschied statistisch signifikant ist.
Wie beides zusammenspielt
Die t-Statistik ist ein Schritt innerhalb des t-Tests.
Zuerst berechnest du den t-Wert. Dann nutzt du ihn, um einen p-Wert zu erhalten oder ihn mit einem kritischen Wert zu vergleichen. Dieser letzte Schritt ermöglicht die Entscheidung, ob die Nullhypothese verworfen wird.
Häufige Fehler bei der Verwendung der t-Statistik
Die meisten Fehler entstehen bei der Interpretation, nicht bei der Berechnung. Die t-Statistik ist leicht zu berechnen, aber leicht falsch zu nutzen, wenn wichtige Details ignoriert werden.
Bewertung des t-Werts ohne Kontext
Ein großer t-Wert sagt für sich genommen wenig aus. Seine Bedeutung hängt von Stichprobenumfang und Variabilität ab.
Was du tun solltest:
Wichtige Annahmen ignorieren
Die t-Statistik beruht auf einigen Bedingungen. Wenn sie nicht erfüllt sind, können die Ergebnisse unzuverlässig sein. Wichtige Annahmen sind:
Was du tun solltest:
Verwechslung von einseitigen und zweiseitigen Tests
Die falsche Testwahl verändert das Fazit. Einseitige Tests prüfen in eine Richtung, zweiseitige in beide Richtungen.
Was du tun solltest:
Mehrere t-Tests statt ANOVA durchführen
Der Vergleich von mehr als zwei Gruppen mit mehreren t-Tests erhöht das Risiko für Fehlalarme.
So gehst du vor: Nutze ANOVA für drei oder mehr Gruppen und führe bei Bedarf Post-hoc-Tests durch
Sich nur auf p-Werte verlassen
Ein kleiner p-Wert zeigt statistische Signifikanz, keine praktische Relevanz. Achte darauf, die Effektgröße zu prüfen und zu bewerten, ob das Ergebnis in Entscheidungen zählt.
Fazit
Unterschiede finden sich in allen Datensätzen. Die Herausforderung ist zu erkennen, ob sie einen echten Effekt widerspiegeln oder Zufall sind. Die t-Statistik löst das, indem sie die Differenz an der Unsicherheit misst.
Ohne t-Statistik siehst du nur Unterschiede. Mit ihr kannst du einschätzen, ob sich ein Handeln darauf lohnt.