
कोर्स
Statistics परिचय
4 घंटा
162.5K
t सांख्यिकीय मान दिखाता है कि देखा गया अंतर सार्थक है या सिर्फ यादृच्छिक परिवर्तन के कारण है।
लगभग हर डेटासेट में अंतर दिखते हैं। प्रमुख प्रश्न यह होता है कि क्या परिणाम वास्तविक प्रभाव को दर्शाता है। t सांख्यिकीय मान अंतर के आकार की तुलना डेटा में अनिश्चितता से करके इसका उत्तर देता है।
इसीलिए यह परिकल्पना परीक्षण और प्रतिगमन में व्यापक रूप से उपयोग होता है। यह आपको आकलन करने में मदद करता है कि कोई परिणाम सांख्यिकीय रूप से महत्वपूर्ण है और गंभीरता से लेने लायक है या नहीं।
इस गाइड में, आप सीखेंगे कि t सांख्यिकीय मान का अर्थ क्या है, इसे कैसे गणना करें, इसकी व्याख्या कैसे करें, और सामान्य परीक्षण परिदृश्यों में इसे कैसे लागू करें।
t सांख्यिकीय मान मापता है कि डेटा में परिवर्तनशीलता के लिए समायोजन करने के बाद कोई परिणाम संदर्भ मान से कितना दूर है।
सरल शब्दों में, यह अनिश्चितता से मापा गया अंतर है। यह कच्चे अंतर को एक मानकीकृत मान में बदल देता है जिसे आप आकलन कर सकते हैं।
मान लीजिए किसी कक्षा का औसत स्कोर 78 है और मानक 75 है। अंतर 3 अंकों का है। अकेले यह संख्या बहुत कुछ नहीं बताती। अगर स्कोर पास-पास हैं, तो यह अंतर सार्थक हो सकता है। अगर स्कोर में बहुत भिन्नता है, तो यही अंतर मायने नहीं रख सकता।
t सांख्यिकीय मान इन दोनों पहलुओं को एक ही मान में समेटता है। यह दिखाता है कि देखा गया अंतर डेटा की भिन्नता के सापेक्ष कितना बड़ा है।
यह इसलिए महत्वपूर्ण है क्योंकि एक जैसा अंतर डेटा की स्थिरता पर निर्भर करते हुए अलग-अलग निष्कर्ष दे सकता है। t सांख्यिकीय मान संदर्भ देता है ताकि आप उसकी महत्ता का निर्णय कर सकें।
आप इसे इन सामान्य स्थितियों में देखेंगे:
इन सभी मामलों में तर्क एक जैसा रहता है: संदर्भ बिंदु से दूरी मापें, परिवर्तनशीलता के लिए समायोजित करें, और आकलन करें कि परिणाम सार्थक है या नहीं।
t-सांख्यिकीय मान की संरचना सरल है। यह आपके अवलोकन की आपके अपेक्षित मान से तुलना करता है और फिर उस अंतर को अनिश्चितता से स्केल करता है।
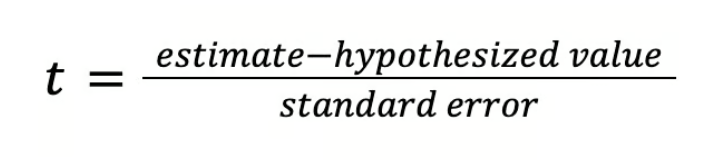
इस सूत्र में:
यहां estimate आपका नमूना परिणाम है
यहां hypothesized value वह मान है जिसके विरुद्ध आप परीक्षण कर रहे हैं
standard error मापता है कि यादृच्छिकता के कारण आपका आकलन कितना बदल सकता है
इसलिए t-सांख्यिकीय मान बताता है कि आपका परिणाम उस मान से कितने मानक त्रुटियों की दूरी पर है जिसे आप परख रहे हैं।
इसे तब उपयोग करें जब आप एक नमूने के औसत की तुलना किसी ज्ञात मान से कर रहे हों।
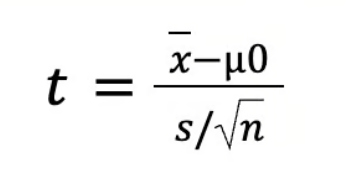
यहां:
x नमूना औसत है
μ0 परिकल्पित मान है
s नमूना मानक विचलन है
n नमूना आकार है
हरसंख्य s/n औसत का मानक त्रुटि है।
यह परीक्षण दो अलग-अलग समूहों के औसत की तुलना करता है। संरचना समान रहती है:
लेकिन यहां एक छोटा बदलाव है: जब आप मानक त्रुटि की गणना करते हैं, तो आपको दोनों समूहों की परिवर्तनशीलता का आकलन कैसे करना है, यह तय करना होता है।
इसके दो सामान्य तरीके हैं।
इसे तब उपयोग करें जब समूहों में फैलाव के स्तर अलग हों, जो वास्तविक डेटा में आम है:
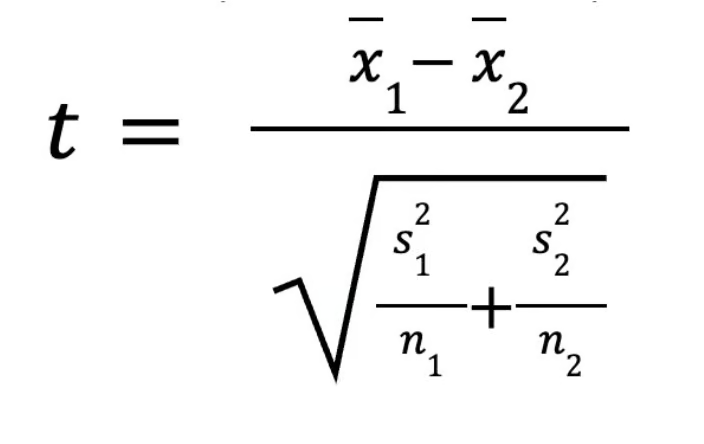
इसे तब उपयोग करें जब दोनों समूह समान परिवर्तनशीलता दिखाते हों:
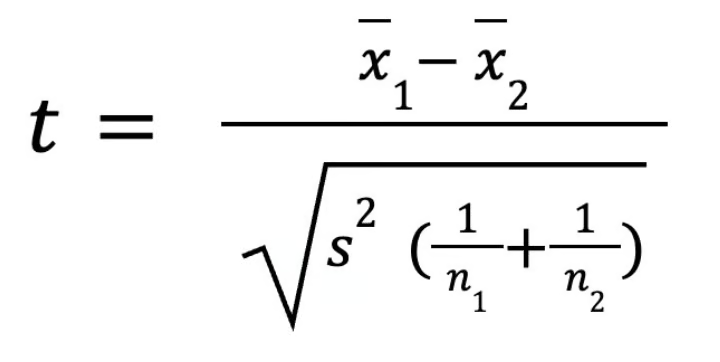
प्रतिगमन में, प्रत्येक गुणांक का अपना t सांख्यिकीय मान होता है।
यह दिखाता है कि कोई प्रेडिक्टर निर्गत चर के साथ सार्थक संबंध रखता है या नहीं।
एक वन-सैंपल स्थिति पर विचार करें:
चरण 1: मानक त्रुटि की गणना करें
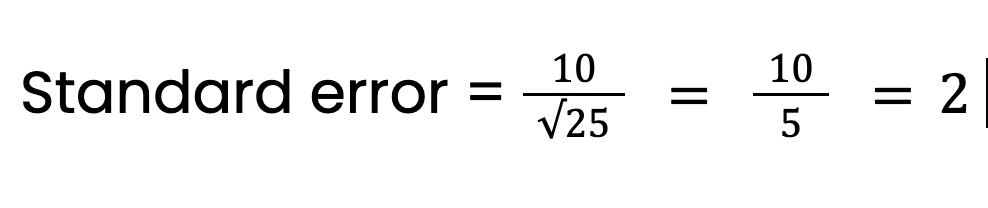
चरण 2: अंतर निकालें
अंतर = 78 − 75 = 3
चरण 3: t सांख्यिकीय मान की गणना करें
T = 3/2 = 1.5
नमूना औसत संदर्भ मान से 1.5 मानक त्रुटियां ऊपर है। सांख्यिकीय महत्ता का आकलन करने के लिए अगले चरण में इसी मान का उपयोग होता है।
t सांख्यिकीय मान तभी उपयोगी होता है जब आप इसकी तुलना किसी संदर्भ वितरण से करें। वह संदर्भ t वितरण है।
यह दिखाता है कि जब वास्तविक प्रभाव नहीं होता तो t-मूल्य कैसे दिखते हैं। एक बार t मान निकाल लेने पर, आप देखते हैं कि वह इस वितरण पर कहां आता है। केंद्र से दूर मान संयोग से होने की संभावना कम रखते हैं। केंद्र के पास के मान यादृच्छिक भिन्नता के साथ अधिक संगत होते हैं।
स्वतंत्रता की डिग्रियां t वितरण का आकार नियंत्रित करती हैं। ये दर्शाती हैं कि आपका डेटा कितना भरोसेमंद सूचना देता है: अधिक डेटा से अनुमान अधिक स्थिर होते हैं और कम डेटा से अनिश्चितता बढ़ती है।
इसके कुछ सामान्य सूत्र हैं:
छोटे नमूनों में परिवर्तनशीलता का अनुमान लगाना कठिन होता है। इससे चरम t-मूल्य अधिक संभावित हो जाते हैं, इसलिए t वितरण चौड़ा होता है।
इससे दो परिणाम निकलते हैं:
जैसे-जैसे नमूना आकार बढ़ता है, अनुमान अधिक स्थिर हो जाते हैं। t वितरण संकरा होता है और सामान्य वितरण से मेल खाने लगता है। बड़े नमूनों में दोनों के बीच अंतर न्यूनतम होता है।
बड़ा t-सांख्यिकीय मान शून्य परिकल्पना के विरुद्ध अधिक सशक्त साक्ष्य दर्शाता है। छोटा t-सांख्यिकीय मान बताता है कि परिणाम यादृच्छिक भिन्नता के कारण हो सकता है।
यही मूल विचार है। अब इसे व्यावहारिक बनाते हैं।
ध्यान दें कि मान 0 से कितनी दूर है।
चिह्न केवल दिशा दिखाता है।
व्याख्या के लिए परिमाण चिह्न से अधिक महत्वपूर्ण है।
t सांख्यिकीय मान निकालने के बाद, इसे t वितरण से तुलना करें। इससे p-मूल्य मिलता है, जो दिखाता है कि शून्य परिकल्पना के तहत आपका परिणाम कितना संभावित है।
t सांख्यिकीय मान दूरी देता है। p-मूल्य दिखाता है कि वह दूरी कितनी असामान्य है।
चयन आपकी परिकल्पना पर निर्भर करता है:
दो-छोर परीक्षण अधिक सामान्य हैं। एक-छोर परीक्षण तभी उपयोग करें जब दिशा विश्लेषण से पहले तय हो।
कोई परिणाम सांख्यिकीय रूप से महत्वपूर्ण हो सकता है पर उपयोगी नहीं। यह बड़े डेटासेट में अक्सर होता है।
इसलिए केवल p-मूल्य पर निर्भर न रहें। प्रभाव के आकार को देखें और पूछें कि क्या यह वास्तविक निर्णयों में मायने रखता है।
t सांख्यिकीय मान का उपयोग यह जांचने के लिए होता है कि कोई परिणाम संदर्भ मान, प्रायः शून्य, से सार्थक रूप से भिन्न है या नहीं। वह संदर्भ बिना प्रभाव या बिना अंतर का प्रतिनिधित्व करता है।
यह एक ही प्रश्न का उत्तर देता है: क्या देखा गया परिणाम इतना बड़ा है कि उसे यादृच्छिक भिन्नता के बजाय वास्तविक माना जाए।
इसे तब उपयोग करें जब नमूना औसत की तुलना किसी ज्ञात या माने गए मान से कर रहे हों।
मान लीजिए पेज पर औसत समय 5 मिनट अपेक्षित है और आपका नमूना 6 मिनट दिखाता है। t सांख्यिकीय मान आकलन करता है कि यह 1 मिनट का अंतर सार्थक है या नहीं।
इसी के आधार पर शून्य परिकल्पना को अस्वीकार या अस्वीकार न करने का निर्णय होता है।
इसे दो स्वतंत्र समूहों की तुलना के लिए उपयोग करें।
उदाहरण के लिए दो लैंडिंग पेजों की रूपांतरण दरें लें:
किसी एक समूह में उच्च औसत अपने आप में पर्याप्त नहीं है। t सांख्यिकीय मान जांचता है कि दोनों औसतों के बीच का अंतर सांख्यिकीय रूप से महत्वपूर्ण है या नहीं।
बड़े परिमाण का t मान दर्शाता है कि अंतर वास्तविक होने के अधिक साक्ष्य हैं।
इसे तब उपयोग करें जब एक ही समूह को दो बार मापा जाए।
मान लीजिए किसी फीचर अपडेट से पहले और बाद में उपयोगकर्ता एंगेजमेंट है। प्रत्येक अवलोकन जुड़ा हुआ है। आप अलग-अलग समूहों की तुलना करने के बजाय प्रत्येक युग्म के भीतर के अंतरों के साथ काम करते हैं।
t सांख्यिकीय मान परखता है कि सभी युग्मों में औसत परिवर्तन शून्य से भिन्न है या नहीं। यह दिखाता है कि परिवर्तन का सार्थक प्रभाव पड़ा या नहीं।
प्रतिगमन में, प्रत्येक गुणांक का अपना t सांख्यिकीय मान होता है। प्रत्येक गुणांक किसी प्रेडिक्टर और निर्गत के बीच संबंध का प्रतिनिधित्व करता है।
मान लीजिए कोई गुणांक ईमेल आवृत्ति का रूपांतरणों पर प्रभाव दर्शाता है। t सांख्यिकीय मान परखता है कि वह गुणांक शून्य से भिन्न है या नहीं।
यह बताने में मदद करता है कि कौन-से चर मॉडल में योगदान करते हैं।
t तालिका आपको यह निर्णय लेने में मदद करती है कि आपका परिणाम सांख्यिकीय रूप से महत्वपूर्ण है या नहीं। यह निम्न के आधार पर क्रिटिकल मान देती है:
इन चरणों का पालन करें:
अब अपने परिणाम की तुलना क्रिटिकल मान से करें:
|
स्वतंत्रता की डिग्रियां (df) |
0.10 |
0.05 |
0.01 |
|
1 |
6.314 |
12.706 |
63.657 |
|
2 |
2.92 |
4.303 |
9.925 |
|
5 |
2.015 |
2.571 |
4.032 |
|
10 |
1.812 |
2.228 |
3.169 |
|
20 |
1.725 |
2.086 |
2.845 |
|
30 |
1.697 |
2.04 |
2.75 |
|
∞ (बहुत बड़ा नमूना) |
1.64 |
1.96 |
2.58 |
यहां बताया गया है कि इस तालिका को कैसे पढ़ें।
मान लीजिए:
तालिका से:
अब तुलना करें:
क्योंकि 2.3, 2.23 से बड़ा है, परिणाम सांख्यिकीय रूप से महत्वपूर्ण है।
मुख्य अंतर सरल है:
हमारे गाइड में t सांख्यिकीय और z सांख्यिकीय के बीच का अंतर के बारे में अधिक जानें।
t सांख्यिकीय का उपयोग तब करें जब आप नमूना डेटा के साथ काम कर रहे हों और जनसंख्या मानक विचलन ज्ञात न हो।
यह सामान्य स्थिति है। आप परिवर्तनशीलता का अनुमान नमूना मानक विचलन से लगाते हैं, जो अनिश्चितता लाता है। t सांख्यिकीय उस अनिश्चितता के लिए समायोजन करता है, जिससे यह छोटे डेटासेट के लिए उपयुक्त बनता है।
मान लीजिए आप औसत सत्र समय का अनुमान लगाने के लिए 25 उपयोगकर्ताओं से डेटा एकत्र करते हैं। क्योंकि वास्तविक जनसंख्या परिवर्तनशीलता अज्ञात है, आप t सांख्यिकीय का उपयोग करेंगे।
z सांख्यिकीय का उपयोग तब करें जब जनसंख्या मानक विचलन ज्ञात हो।
यह कम सामान्य है, पर नियंत्रित वातावरण में या जब आपके पास स्थिर ऐतिहासिक डेटा हो, तब लागू हो सकता है। बहुत बड़े नमूनों में भी इसका उपयोग होता है, जहां नमूना मानक विचलन जनसंख्या मान से काफ़ी मेल खाता है।
यदि किसी कंपनी के पास दीर्घकालिक डेटा है और किसी मीट्रिक का सटीक मानक विचलन ज्ञात है, तो वह परीक्षण के लिए z सांख्यिकीय का उपयोग कर सकती है।
नमूना आकार आपके अनुमानों में मौजूद अनिश्चितता को प्रभावित करता है।
t वितरण इसका हिसाब छोटे नमूनों के लिए अधिक चौड़ा होकर रखता है, जिससे परिणाम अधिक सावधानीपूर्ण होते हैं।
जैसे-जैसे नमूना आकार बढ़ता है, दोनों तरीकों के बीच का अंतर न्यूनतम हो जाता है। बड़े डेटासेट में दोनों लगभग समान परिणाम देते हैं। यही कारण है कि बड़े पैमाने के विश्लेषण में z सांख्यिकीय को अक्सर एक आसन्न मान के रूप में उपयोग किया जाता है।
t सांख्यिकीय एक एकल मान है, और t परीक्षण पूरा निर्णय-प्रक्रिया है। दोनों को समझते हैं:
हमने अब तक इसे बहुत कवर किया है, पर दोहरा दूं: t सांख्यिकीय आपके नमूना डेटा से गणना किया जाता है। यह दिखाता है कि आपका परिणाम शून्य परिकल्पना के मान, प्रायः शून्य, से कितना दूर है।
यह डेटा में परिवर्तनशीलता के सापेक्ष अंतर का आकार देता है। अपने आप में यह नहीं बताता कि परिणाम महत्वपूर्ण है या नहीं।
t-परीक्षण परिकल्पना परीक्षण का एक विशिष्ट तरीका है।
इसमें शामिल है:
यह प्रक्रिया निर्धारित करती है कि देखा गया अंतर सांख्यिकीय रूप से महत्वपूर्ण है या नहीं।
t सांख्यिकीय, t परीक्षण के भीतर का एक चरण है।
आप पहले t मान की गणना करते हैं। फिर इसका उपयोग p-मूल्य पाने या क्रिटिकल मान से तुलना करने के लिए करते हैं। वही अंतिम चरण आपको शून्य परिकल्पना अस्वीकार करने या न करने का निर्णय लेने देता है।
अधिकांश त्रुटियां गणना से नहीं, व्याख्या से आती हैं। t सांख्यिकीय निकालना आसान है पर यदि प्रमुख बातों को अनदेखा किया जाए तो इसका गलत उपयोग भी उतना ही आसान है।
अपने आप में बड़ा t मान बहुत कुछ नहीं बताता। इसका अर्थ नमूना आकार और परिवर्तनशीलता पर निर्भर करता है।
क्या करें:
t सांख्यिकीय कुछ शर्तों पर निर्भर करता है। यदि वे पूरी नहीं होतीं, तो परिणाम अविश्वसनीय हो सकते हैं। मुख्य मान्यताएं हैं:
क्या करें:
गलत परीक्षण चुनने से निष्कर्ष बदल सकते हैं। वन-टेल परीक्षण एक दिशा देखता है और टू-टेल परीक्षण दोनों दिशाएं।
क्या करें:
दो से अधिक समूहों की तुलना कई t परीक्षणों से करने पर गलत-सकारात्मक का जोखिम बढ़ता है।
क्या करें: तीन या अधिक समूहों के लिए ANOVA का उपयोग करें। फिर, आवश्यक होने पर पोस्ट-हॉक परीक्षण करें
छोटा p-मूल्य सांख्यिकीय महत्त्व दर्शाता है, व्यावहारिक महत्ता नहीं। सुनिश्चित करें कि आप प्रभाव के आकार की जांच करें और आकलन करें कि परिणाम वास्तविक निर्णयों में मायने रखता है या नहीं।
हर डेटासेट में अंतर दिखते हैं। चुनौती यह जानना है कि क्या वे वास्तविक प्रभाव को दर्शाते हैं या यादृच्छिक भिन्नता को। t सांख्यिकीय मान इसको अनिश्चितता के आधार पर अंतर को स्केल करके संबोधित करता है।
t सांख्यिकीय के बिना, आपको सिर्फ अंतर दिखेंगे। इसके साथ, आप आकलन कर सकते हैं कि वे अंतर कार्रवाई लायक हैं या नहीं।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स