

Sumber Data: FiveThirtyEight dan Federal Election Commission
Data yang digunakan untuk prediksi kita berasal dari FiveThirtyEight, yang mengumpulkan data jajak pendapat dari berbagai pollster. Data tersedia melalui GitHub mereka untuk semua siklus pemilu sejak 1968.
Kita akan menggunakan model polling mereka, yang menetapkan rata-rata persentase jajak pendapat untuk tiap kandidat di tiap negara bagian untuk (hampir) tiap tanggal dalam delapan bulan menjelang pemilu.
Kita mulai dengan mengimpor data polling 2024, 2020, dan historis dari file CSV. Data 2024 difilter hanya untuk jajak pendapat dari siklus saat ini, dan data historis hingga 2016 digabungkan dengan data 2020. Pada dua DataFrame yang dihasilkan, polls_24 dan polls_until_20, kolom tanggal diubah ke format datetime untuk konsistensi, dan kolom relevan seperti siklus, negara bagian, nama kandidat, dan estimasi polling dipertahankan.
import pandas as pd
# Reading CSV files
polls_24 = pd.read_csv('presidential_general_averages.csv')
polls_20 = pd.read_csv('presidential_poll_averages_2020.csv')
polls_until_16 = pd.read_csv('pres_pollaverages_1968-2016.csv')
# Filtering and concatenating DataFrames
polls_24 = polls_24[polls_24['cycle'] == 2024]
polls_until_20 = pd.concat([polls_20, polls_until_16], ignore_index=True)
# Making sure dates are in datetime format
polls_24['date'] = pd.to_datetime(polls_24['date'], format='%Y-%m-%d')
polls_until_20['modeldate'] = pd.to_datetime(polls_until_20['modeldate'])
# Keeping only the columns of interest
polls_until_20 = polls_until_20[['cycle', 'state', 'modeldate', 'candidate_name', 'pct_estimate', 'pct_trend_adjusted']]Untuk hasil pemungutan suara sebenarnya per negara bagian, saya mengambil data langsung dari Federal Election Commission of the USA. Demi kesederhanaan, sebelumnya saya meringkasnya menjadi satu file CSV.
Satu observasi merepresentasikan kombinasi siklus pemilu, negara bagian, dan partai, dilengkapi dengan nama kandidat masing-masing dan tentu saja persentase perolehan suara yang diraih kandidat tersebut.
# Importing result data
results_until_20 = pd.read_csv('results.csv', sep=';')
results_until_20 = results_until_20[['cycle', 'state', 'party', 'candidate', 'vote_share']]Untuk memastikan kita bekerja dengan data yang relevan dan berkualitas tinggi, saya menerapkan dua pembatasan utama:
- Saya akan fokus pada enam siklus pemilu terakhir (2000 dan seterusnya) karena ketersediaan dan akurasi data meningkat signifikan pada periode ini.
- Saya akan mempersempit analisis pada swing states—negara bagian dengan persaingan paling ketat—berdasarkan negara bagian di mana kandidat unggulan memiliki keunggulan kurang dari lima persen, menurut prakiraan pemilu FiveThirtyEight. Swing state yang dipilih adalah Pennsylvania, Wisconsin, Michigan, Georgia, North Carolina, Arizona, dan Nevada. Kita mengasumsikan negara bagian lain akan memilih sesuai ekspektasi, mendefinisikan daftar
swing_states,blue_states, danred_statessesuai, serta membuat subset data untuk swing states.
# Implementing cycle restriction
start_cycle = 2000
polls_until_20 = polls_until_20[polls_until_20['cycle'] >= start_cycle]
# Defining state lists
swing_states = [
'Pennsylvania', 'Wisconsin', 'Michigan', 'Georgia',
'North Carolina', 'Arizona', 'Nevada'
]
blue_states = [
'District of Columbia', 'Vermont', 'Massachusetts', 'Maryland',
'Hawaii', 'California', 'ME-1', 'Connecticut', 'Washington',
'Delaware', 'Rhode Island', 'New York', 'Illinois', 'New Jersey',
'Oregon', 'Colorado', 'Maine', 'New Mexico', 'Virginia',
'New Hampshire', 'NE-2', 'Minnesota'
]
red_states = [
'Wyoming', 'West Virginia', 'Oklahoma', 'North Dakota',
'Idaho', 'South Dakota', 'Arkansas', 'Kentucky', 'NE-3',
'Alabama', 'Tennessee', 'Utah', 'Louisiana', 'Nebraska',
'Mississippi', 'Montana', 'NE-1', 'Indiana', 'Kansas',
'Missouri', 'South Carolina', 'Alaska', 'Ohio', 'Iowa',
'Texas', 'ME-2', 'Florida'
]
# Defining swing state subset of the poll data
swing_until_20 = polls_until_20[polls_until_20['state'].isin(swing_states)]
swing_24 = polls_24[polls_24['state'].isin(swing_states)]Exploratory Data Analysis dan Pembersihan Data
Untuk mendapatkan gambaran atas data kita, kita melakukan beberapa analisis data eksploratori (EDA). Pertama, kita menggunakan kombinasi metode .isnull() dan .sum() untuk melihat kolom apa saja yang ada di tiap DataFrame dan di mana data mungkin hilang.
# Checking for missing values in swing_24 and swing_until_20
print(swing_24.isnull().sum())
print(swing_until_20.isnull().sum())candidate 0
date 0
pct_trend_adjusted 4394
state 0
cycle 0
party 0
pct_estimate 0
hi 0
lo 0
dtype: int64
cycle 0
state 0
modeldate 0
candidate_name 0
pct_estimate 0
pct_trend_adjusted 0
dtype: int64Seperti terlihat, nama kolom berbeda antara kedua DataFrame, dan kolom party tampaknya tidak ada di swing_until_20. Selain itu, tampak ada dua jenis persentase yang diukur: persentase estimasi dan satu lagi yang disesuaikan tren. Namun, persentase yang disesuaikan tren tampaknya tidak tersedia untuk data 2024. Kita akan menelaah ini nanti.
Berikutnya, mari periksa nilai berbeda dari setiap variabel kategorikal kita:
print('2024 data:')
print(swing_24['date'].min()) # earliest polling date
print(swing_24['date'].max()) # latest polling date
print(swing_24['state'].unique().tolist()) # distinct states
print(swing_24['party'].unique().tolist()) # distinct parties
print(swing_24['candidate'].unique().tolist()) # distinct candidates
print('Historical data:')
print(swing_until_20['modeldate'].min())
print(swing_until_20['modeldate'].max())
print(swing_until_20['state'].unique().tolist())
print(swing_until_20['candidate_name'].unique().tolist())2024 data:
2024-03-01 00:00:00
2024-10-29 00:00:00
['Arizona', 'Georgia', 'Michigan', 'Nevada', 'North Carolina', 'Pennsylvania', 'Wisconsin']
['REP', 'DEM', 'IND']
['Trump', 'Harris', 'Kennedy', 'Biden']
Historical data:
2000-03-02 00:00:00
2020-11-03 00:00:00
['Wisconsin', 'Pennsylvania', 'North Carolina', 'Nevada', 'Michigan', 'Georgia', 'Arizona']
['Joseph R. Biden Jr.', 'Donald Trump', 'Convention Bounce for Joseph R. Biden Jr.', 'Convention Bounce for Donald Trump', 'Hillary Rodham Clinton', 'Gary Johnson', 'Barack Obama', 'Mitt Romney', 'John McCain', 'George W. Bush', 'John Kerry', 'Al Gore', 'Ralph Nader']Meski data tampak baik untuk negara bagian dan tanggal, ada beberapa hal terkait kolom kandidat. Data historis (khususnya siklus 2020) mencakup tidak hanya persentase dua kandidat, tetapi juga convention bounces, yaitu peningkatan dukungan setelah konvensi nasional. Selain itu, nama depan tampaknya tidak ada di swing_24.
Untuk penyelidikan kita tentang jenis persentase yang berbeda, penting untuk segera menghapus observasi convention bounce:
# Only keep rows where candidate_name does not start with 'Convention Bounce'
swing_until_20 = swing_until_20[~swing_until_20['candidate_name'].str.startswith('Convention Bounce')]Persentase estimasi vs. penyesuaian tren
Agar konsisten, jenis persentase harus sama untuk semua data pelatihan dan pengujian. Seperti yang kita temukan, hanya data hingga siklus 2020 yang memuat persentase estimasi dan yang disesuaikan tren, sementara untuk 2024 hanya ada yang estimasi. Ini menyisakan dua opsi:
- Menggunakan persentase estimasi untuk semua siklus
- Menghitung sendiri persentase penyesuaian tren untuk 2024
Cara persentase penyesuaian tren dihitung untuk data historis tidak jelas. Karena itu, kita harus menelaah hubungan antara persentase estimasi dan yang disesuaikan tren sebelum melanjutkan pembersihan data, karena pilihan basis data krusial untuk prediksi kita. Pertama, kita periksa korelasi dan perbedaan rata-rata dalam data historis.
# Checking the correlation between the percentages
adj_corr_swing = swing_until_20['pct_estimate'].corr(swing_until_20['pct_trend_adjusted'])
print('Correlation between estimated and trend-adjusted percentage in swing states: ' + str(adj_corr_swing))
# Calculate the mean difference between pct_estimate and pct_trend_adjusted, grouping by date, state, and party
mean_diff = (swing_until_20['pct_estimate'] - swing_until_20['pct_trend_adjusted']).mean()
print('Mean difference between estimated and trend-adjusted percentage in swing states: ' + str(mean_diff))Correlation between estimated and trend-adjusted percentage in swing states: 0.9953626583357665
Mean difference between estimated and trend-adjusted percentage in swing states: 0.24980898513865013Kita lihat bahwa korelasi keduanya sangat tinggi (99,5%), seperti yang diperkirakan. Rata-rata selisih sekitar 0,25 poin persentase terlihat kecil, tetapi bisa berdampak pada persaingan yang sangat ketat, seperti yang diperkirakan di Nevada atau Michigan.
Karena semua electoral vote di tiap negara bagian diberikan kepada pemenang, urutan antar kandidat lebih penting daripada angka persentase yang presisi. Hal yang ingin kita hindari adalah perbedaan kepemimpinan mendekati hari pemilu. Maka, kita lihat banyaknya observasi di mana kandidat unggulan antara dua persentase berbeda pada siklus 2020 dan tanggal terakhir terjadinya hal tersebut.
# Finding out how often pct_estimate and pct_trend_adjusted saw different candidates in the lead in the 2020 race
swing_20 = swing_until_20[swing_until_20['cycle'] == 2020]
# Create a new column to indicate if the ranking is different between pct_estimate and pct_trend_adjusted
swing_20['rank_estimate'] = swing_20.groupby(['state', 'modeldate'])['pct_estimate'].rank(ascending=False)
swing_20['rank_trend_adjusted'] = swing_20.groupby(['state', 'modeldate'])['pct_trend_adjusted'].rank(ascending=False)
# Rows where the rankings are different in swing states
different_rankings_swing = swing_20[swing_20['rank_estimate'] != swing_20['rank_trend_adjusted']]
print('Number of observations with differing leader: ' + str(different_rankings_swing.shape[0] / 2))
print('Last occurrence: ' + str(different_rankings_swing['modeldate'].max()))Number of observations with differing leader: 34.0
Last occurrence: 2020-06-24 00:00:00Ternyata, kepemimpinan berbeda hanya pada 34 kasus, rata-rata sekitar 5 hari per swing state. Karena kejadian terakhir pada akhir Juni, semua kasus tampaknya berada pada fase awal kampanye.
Mempertimbangkan semuanya, kejadian perubahan pemimpin yang jarang kemungkinan kecil mempengaruhi akurasi keseluruhan model, apalagi kita memiliki dataset yang cukup besar lintas beberapa siklus. Karena itu, saya memilih opsi pertama dan hanya menggunakan persentase estimasi di semua siklus pemilu. Ini memastikan konsistensi data, yang penting dalam machine learning untuk mencegah model mempelajari bias akibat perbedaan metode pemrosesan data.
Menambahkan kolom partai dan data hasil historis
Untuk menambahkan kolom partai politik, kita terlebih dahulu mendapatkan daftar semua kandidat dalam dataset historis. Lalu, kita membuat dictionary dengan kandidat sebagai kunci dan partai masing-masing sebagai nilai—ChatGPT sangat membantu untuk menghemat waktu riset! Terakhir, kita gabungkan keduanya dalam sebuah DataFrame, dan merge ke swing_until_20.
# Get unique candidate names
candidate_names = swing_until_20['candidate_name'].unique().tolist()
# Create a dictionary of candidates and their political party
party_map = {
'Joseph R. Biden Jr.': 'DEM',
'Donald Trump': 'REP',
'Hillary Rodham Clinton': 'DEM',
'Gary Johnson': 'LIB',
'Barack Obama': 'DEM',
'Mitt Romney': 'REP',
'John McCain': 'REP',
'Ralph Nader': 'IND',
'George W. Bush': 'REP',
'John Kerry': 'DEM',
'Al Gore': 'DEM'
}
# Create a DataFrame with candidates and their respective parties
candidate_df = pd.DataFrame(candidate_names, columns=['candidate_name'])
candidate_df['party'] = candidate_df['candidate_name'].map(party_map)
# Merge the candidate_df with swing_until_20 on 'candidate' column
swing_until_20 = swing_until_20.merge(candidate_df[['candidate_name', 'party']], on='candidate_name', how='left')Setelah menambahkan kolom partai ke DataFrame swing_until_20, kita dapat menggabungkan hasil pemilu historis ke dalamnya pada kolom baru bernama vote_share. Karena file CSV vote_share memiliki format berbeda, kita perlu menyesuaikannya ke format yang sama seperti kolom pct_estimate.
# Merging results_until_20 to swing_until_20
swing_until_20 = pd.merge(swing_until_20, results_until_20, how='left', left_on=['cycle', 'state', 'party', 'candidate_name'], right_on=['cycle', 'state', 'party', 'candidate'])
swing_until_20['vote_share'] = swing_until_20['vote_share'].str.replace(',', '.')
swing_until_20['vote_share'] = pd.to_numeric(swing_until_20['vote_share'])Menyelaraskan kolom dan nama kolom
Terakhir, kita ganti nama kolom modeldate menjadi date, menghapus semua kolom yang tidak perlu, dan menyesuaikan format candidate pada data 2024 agar juga mencakup nama depan.
# Renaming columns in swing_until_20
swing_until_20.rename(columns={'modeldate': 'date'}, inplace=True)
# Keeping only relevant columns
swing_24 = swing_24[['cycle', 'date', 'state', 'party', 'candidate', 'pct_estimate']]
swing_until_20 = swing_until_20[['cycle', 'date', 'state', 'party', 'candidate', 'pct_estimate', 'vote_share']]
# Update candidate names in swing_24 dataframe
swing_24['candidate'] = swing_24['candidate'].replace({
'Trump': 'Donald Trump',
'Biden': 'Joseph R. Biden Jr.',
'Harris': 'Kamala Harris',
'Kennedy': 'Robert F. Kennedy'})Gambaran kampanye 2024
Mari melihat gambaran jalannya kampanye pemilu 2024 sejauh ini. Kita gunakan seaborn dan matplotlib untuk membuat grafik garis yang menampilkan perkembangan rata-rata polling di seluruh swing states yang dipilih. Garis merah, biru, dan hitam menunjukkan persentase polling Partai Republik, Demokrat, dan kandidat independen. Garis vertikal menandai peristiwa penting selama kampanye.
import matplotlib.pyplot as plt
import seaborn as sns
# Ensure the date column is in datetime format
swing_24['date'] = pd.to_datetime(swing_24['date'])
# Group by date and party, then average the pct_estimate
swing_24_grouped = swing_24.groupby(['date', 'party'])['pct_estimate'].mean().reset_index()
# Create the line chart
plt.figure(figsize=(14, 8))
sns.lineplot(data=swing_24_grouped, x='date', y='pct_estimate', hue='party', marker='o',
palette={'REP': 'red', 'DEM': 'blue', 'IND': 'black'})
# Add vertical lines for significant events
plt.axvline(pd.to_datetime('2024-07-13'), color='red', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-08-05'), color='blue', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-07-23'), color='blue', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-09-05'), color='black', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-10-01'), color='black', linestyle='--', alpha=0.25)
# Add text annotations for significant events
plt.text(pd.to_datetime('2024-07-13'), plt.ylim()[1] * 0.6, 'Trump Assassination Attempt', color='red', ha='right')
plt.text(pd.to_datetime('2024-07-23'), plt.ylim()[1] * 0.5, 'First Harris Rally', color='blue', ha='right')
plt.text(pd.to_datetime('2024-08-05'), plt.ylim()[1] * 0.4, 'Official Nomination of Harris', color='blue', ha='right')
plt.text(pd.to_datetime('2024-09-05'), plt.ylim()[1] * 0.3, 'Presidential Debate', color='black', ha='right')
plt.text(pd.to_datetime('2024-10-01'), plt.ylim()[1] * 0.2, 'Vice Presidential Debate', color='black', ha='right')
# Add horizontal gridlines at values divisible by 5
plt.yticks(range(0, 51, 5))
plt.grid(axis='y', linestyle='--', alpha=0.7)
# Limit the y-axis range to 50
plt.ylim(0, 50)
# Adjust the legend
plt.legend(title='Party')
# Set titles and labels
plt.title('Average Polling Percentage per Party Over Time in Swing States')
plt.xlabel('Date')
plt.ylabel('Average Polling Percentage')
plt.show()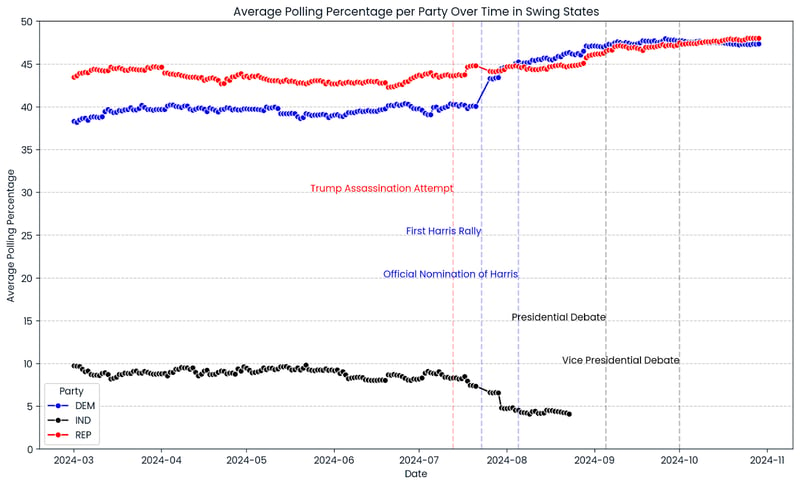
Sekilas perkembangan polling 2024 menunjukkan persaingan yang sangat tipis di seluruh swing states. Tingkat persetujuan Donald Trump relatif konstan sepanjang kampanye dengan kenaikan kecil baru-baru ini. Persentase Partai Demokrat meningkat setelah Kamala Harris resmi dinominasikan sebagai kandidat presiden pada 5 Agustus 2024, secara signifikan melampaui polling kandidat sebelumnya sekaligus Presiden AS, Joe Biden. Apa pun itu, grafik menunjukkan banyak laga yang terlalu ketat untuk diprediksi.
Feature Engineering untuk Memprediksi Pemilu AS 2024
Kita akan mengeksplorasi empat kategori fitur: terkait lawan, terkait waktu, terkait kandidat, dan terkait partai.
Fitur terkait lawan
Salah satu fitur menarik kampanye tahun ini adalah peran Robert F. Kennedy, yang persentase pollingnya menunjukkan dukungan yang tidak biasa tingginya untuk kandidat independen. Ia menghentikan kampanyenya pada 23 Agustus 2024, yang memicu kenaikan persetujuan untuk Kamala Harris dan Donald Trump.
Karena kita ingin mencegah model mempelajari hal yang keliru dan memprediksi total perolehan suara melebihi 100%, kita sertakan persentase pihak ketiga sebagai sebuah fitur.
# Adding the percentage of 3rd party candidates
swing_24['pct_3rd_party'] = swing_24.groupby(['cycle', 'date', 'state'])['pct_estimate'].transform(
lambda x: x[~swing_24['party'].isin(['DEM', 'REP'])].sum()
)
swing_until_20['pct_3rd_party'] = swing_until_20.groupby(['cycle', 'date', 'state'])['pct_estimate'].transform(
lambda x: x[~swing_until_20['party'].isin(['DEM', 'REP'])].sum()
)Setelah memasukkan dukungan pihak ketiga ke dalam fitur, kita dapat mengakui bahwa secara realistis, hanya ada dua partai yang kandidatnya berpeluang menang. Karena itu, kita hapus semua kandidat dari partai selain Partai Demokrat dan Republik pada kedua DataFrame.
# Removing observations of candidates who are not Democrats and Republicans
swing_24 = swing_24[swing_24['party'].isin(['DEM', 'REP'])]
swing_until_20 = swing_until_20[swing_until_20['party'].isin(['DEM', 'REP'])]Dua informasi lain yang menarik bagi kita adalah persentase lawan pada tanggal tertentu di suatu negara bagian, serta keunggulan (atau ketertinggalan) persetujuan dibanding lawan. Kita tambahkan kedua fitur menggunakan fungsi lambda.
# Adding the percentage of the opponent
swing_24['pct_opponent'] = swing_24.apply(
lambda row: swing_24[
(swing_24['date'] == row['date']) &
(swing_24['state'] == row['state']) &
(swing_24['party'] != row['party'])
]['pct_estimate'].sum(),
axis=1
)
swing_until_20['pct_opponent'] = swing_until_20.apply(
lambda row: swing_until_20[
(swing_until_20['date'] == row['date']) &
(swing_until_20['state'] == row['state']) &
(swing_until_20['party'] != row['party'])
]['pct_estimate'].sum(),
axis=1
)
# Adding the lead against the opponent
swing_24['lead'] = swing_24['pct_estimate'] - swing_24['pct_opponent']
swing_until_20['lead'] = swing_until_20['pct_estimate'] - swing_until_20['pct_opponent']Fitur terkait waktu
Dalam proses feature engineering, saya memilih untuk memasukkan jumlah hari menuju pemilu, rata-rata bergulir persentase polling per partai, dan indikator momentum per kandidat. Pendekatan ini memungkinkan kita menangkap tren dukungan partai yang stabil dan pergeseran cepat pada popularitas kandidat individual.
# Days until election
election_dates = {
2000: pd.to_datetime('2000-11-07'),
2004: pd.to_datetime('2004-11-02'),
2008: pd.to_datetime('2008-11-04'),
2012: pd.to_datetime('2012-11-06'),
2016: pd.to_datetime('2016-11-08'),
2020: pd.to_datetime('2020-11-03')
}
swing_until_20['election_date'] = swing_until_20['cycle'].map(election_dates)
swing_24['election_date'] = pd.to_datetime('2024-11-05')
swing_24['days_until_election'] = (swing_24['election_date'] - swing_24['date']).dt.days
swing_until_20['days_until_election'] = (swing_until_20['election_date'] - swing_until_20['date']).dt.days
# Party 7 days rolling average
swing_24 = swing_24.sort_values(by='date')
swing_24['rolling_avg_7d'] = swing_24.groupby(['state', 'party'])['pct_estimate'].transform(
lambda x: x.rolling(window=7, min_periods=1).mean()
)
swing_until_20 = swing_until_20.sort_values(by='date')
swing_until_20['rolling_avg_7d'] = swing_until_20.groupby(['cycle', 'state', 'party'])['pct_estimate'].transform(
lambda x: x.rolling(window=7, min_periods=1).mean()
)Menggunakan hari menuju pemilu sebagai fitur memungkinkan kita secara langsung memodelkan efek waktu pada preferensi pemilih, dengan menyadari bahwa jajak pendapat yang dilakukan semakin dekat Hari Pemilu sering kali memiliki nilai prediktif lebih tinggi karena keterlibatan pemilih yang meningkat dan opini yang lebih mapan. Dengan mengelompokkan rata-rata bergulir per partai, kita meredam fluktuasi jangka pendek dan menonjolkan tren mendasar afiliasi partai, memberikan metrik dukungan partai yang stabil dan andal.
Sementara itu, pengelompokan indikator momentum per kandidat menangkap perubahan cepat dalam persetujuan kandidat, mencerminkan bagaimana kandidat individual bisa cepat mendapatkan atau kehilangan dukungan karena faktor seperti peristiwa kampanye atau pemberitaan. Pembedaan ini sangat relevan mengingat pergantian calon di tengah kampanye Partai Demokrat, yang berdampak besar pada dinamika polling. Kita tertarik terutama pada perbedaan momentum kedua kandidat.
# Calculate the daily change (momentum) for each candidate
swing_24['momentum_candidate'] = swing_24.groupby(['state', 'party'])['pct_estimate'].diff()
swing_until_20['momentum_candidate'] = swing_until_20.groupby(['state', 'party'])['pct_estimate'].diff()
# Calculate the daily change (momentum) for each opponent
swing_24['momentum_opponent'] = swing_24.groupby(['state', 'party'])['pct_opponent'].diff()
swing_until_20['momentum_opponent'] = swing_until_20.groupby(['state', 'party'])['pct_opponent'].diff()
# Calculate the difference between the candidate's momentum and the opponent's momentum
swing_24['momentum'] = swing_24['momentum_candidate'] - swing_24['momentum_opponent']
swing_until_20['momentum'] = swing_until_20['momentum_candidate'] - swing_until_20['momentum_opponent']Fitur terkait kandidat
Terkait kandidat, pertama kita membuat dua fitur biner tentang apakah kandidat adalah Presiden petahana atau Wakil Presiden petahana. Dengan cara ini, kita memungkinkan model memperhitungkan efek rekam jejak kandidat sebagai presiden.
Kita lakukan dengan menerapkan fungsi lambda pada kedua DataFrame, yang membandingkan nama kandidat dan siklus pemilu dengan dictionary incumbent_presidents dan incumbent_vice_presidents yang kita buat untuk tujuan ini.
incumbent_presidents = {
2000: 'Bill Clinton',
2004: 'George W. Bush',
2008: 'George W. Bush',
2012: 'Barack Obama',
2016: 'Barack Obama',
2020: 'Donald Trump',
2024: 'Joseph R. Biden Jr.'
}
incumbent_vice_presidents = {
2000: 'Al Gore',
2004: 'Richard Cheney',
2008: 'Richard Cheney',
2012: 'Joseph R. Biden Jr.',
2016: 'Joseph R. Biden Jr.',
2020: 'Mike Pence',
2024: 'Kamala Harris'
}
# Adding is_incumbent_president column
swing_until_20['is_incumbent_president'] = swing_until_20.apply(
lambda row: row['candidate'] == incumbent_presidents.get(row['cycle'], ''), axis=1
)
swing_24['is_incumbent_president'] = swing_24.apply(
lambda row: row['candidate'] == incumbent_presidents.get(row['cycle'], ''), axis=1
)
# Adding is_incumbent_vice_president column
swing_until_20['is_incumbent_vice_president'] = swing_until_20.apply(
lambda row: row['candidate'] == incumbent_vice_presidents.get(row['cycle'], ''), axis=1
)
swing_24['is_incumbent_vice_president'] = swing_24.apply(
lambda row: row['candidate'] == incumbent_vice_presidents.get(row['cycle'], ''), axis=1
)Secara metodologis, tidak masuk akal menggunakan fitur dummy untuk kandidat mana pun yang tidak (atau belum pernah) maju pada 2024 atau yang baru pertama kali dinominasikan pada 2024. Karena itu, kita hanya akan membuat fitur semacam ini untuk Donald Trump dan Biden karena ada data keduanya dari pemilu 2016 dan 2020, masing-masing.
# Create a feature for candidates from 2024 who were candidates in earlier cycles
swing_24['candidate_Donald Trump'] = swing_24['candidate'] == 'Donald Trump'
swing_until_20['candidate_Donald Trump'] = swing_until_20['candidate'] == 'Donald Trump'
swing_24['candidate_Joseph R. Biden Jr.'] = swing_24['candidate'] == 'Joseph R. Biden Jr.'
swing_until_20['candidate_Joseph R. Biden Jr.'] = swing_until_20['candidate'] == 'Joseph R. Biden Jr.'Fitur terkait partai
Serupa dengan petahana kandidat, kita sertakan fitur untuk petahana partai. Ini bisa meningkatkan kemampuan model memprediksi share suara dengan lebih akurat dengan mengenali tren historis dan sentimen pemilih yang terkait dengan partai yang sedang berkuasa.
# Define incumbent party for each election
incumbent_party = {
2000: 'DEM',
2004: 'REP',
2008: 'REP',
2012: 'DEM',
2016: 'DEM',
2020: 'REP',
2024: 'DEM'
}
# Define is_incumbent_party
swing_until_20['is_incumbent_party'] = swing_until_20.apply(
lambda row: row['party'] == incumbent_party.get(row['cycle'], ''), axis=1
)
swing_24['is_incumbent_party'] = swing_24.apply(
lambda row: row['party'] == incumbent_party.get(row['cycle'], ''), axis=1
)Terkait partai itu sendiri, ada dua opsi untuk mempertimbangkannya: kita bisa membuat satu model per negara bagian dan partai, atau satu model per negara bagian dan melakukan one-hot encoding pada partai menjadi dua fitur party_DEM dan party_REP.
Opsi kedua menawarkan beberapa keuntungan dibanding membangun model terpisah untuk tiap negara bagian dan partai. Ini menggunakan lebih banyak data untuk pelatihan, meningkatkan ketangguhan model, menyederhanakan proses pengembangan, dan memberikan fleksibilitas untuk menangkap pola bersama maupun spesifik partai dalam data.
# Create duplicate party column for one-hot encoding
swing_24['party_dummy'] = swing_24['party']
swing_until_20['party_dummy'] = swing_until_20['party']
# One-hot encode the duplicate party column in swing_24 and swing_until_20
swing_24 = pd.get_dummies(swing_24, columns=['party_dummy'], prefix='party')
swing_until_20 = pd.get_dummies(swing_until_20, columns=['party_dummy'], prefix='party')Satu hal yang perlu diingat adalah kita membutuhkan kolom partai dalam format aslinya untuk mengelompokkan hasil prediksi. Itulah mengapa kita menduplikasinya dan melakukan one-hot encoding pada kolom duplikat.
Tentu, ada banyak fitur lain yang mungkin untuk disertakan. Misalnya, kita bisa menggunakan indikator demografis atau ekonomi untuk masing-masing negara bagian, namun memperluas set fitur lebih jauh dengan dataset berbeda akan melampaui cakupan artikel ini.
Persiapan Akhir untuk Model Machine Learning Kita
Pada bagian ini, kita pastikan data bersih dan siap untuk model machine learning, dengan fokus pada penanganan nilai hilang dan memahami distribusi variabel kunci kita.
Memeriksa nilai hilang
Ada beberapa hal tersisa untuk memverifikasi bahwa data memiliki struktur yang tepat untuk melatih model. Pertama, kita teliti apakah ada kolom pada kedua dataset yang memiliki nilai hilang.
# Calculate the number of missing values in each column of swing_until_20
missing_values_until_20 = swing_until_20.isnull().sum()
missing_values_24 = swing_24.isnull().sum()
# Filter out columns that have no missing values
missing_values_until_20 = missing_values_until_20[missing_values_until_20 > 0]
missing_values_24 = missing_values_24[missing_values_24 > 0]
# Display the columns with at least 1 missing value and their respective counts for both dataframes
print(missing_values_until_20, missing_values_24)momentum 84 dtype: int64
momentum 21 dtype: int64Momentum kandidat adalah satu-satunya kolom dengan nilai hilang. Ini masuk akal karena dihitung sebagai selisih harian nilai polling untuk tiap kandidat, sehingga observasi pertama mereka wajar tidak memiliki kolom momentum. Kita bisa cukup menghapus nilai hilang tersebut.
# Dropping missing values
swing_24 = swing_24.dropna()
swing_until_20 = swing_until_20.dropna()Menganalisis distribusi
Melihat distribusi kolom numerik akan memberi gambaran apakah ada outlier tersembunyi atau apakah data secara keseluruhan masuk akal.
Selain itu, kita dapat membandingkan polling siklus 2024 terhadap rata-rata siklus sebelumnya. Kita bisa mengabaikan beberapa fitur seperti pct_opponent dan rolling_avg_7d karena pada dasarnya keduanya berasal dari kolom pct_estimate dan akan menyerupai distribusi yang sama.
# Getting description of distributions in both DataFrames
swing_until_20[['pct_estimate', 'lead', 'pct_3rd_party', 'momentum', 'vote_share']].describe()
print(swing_24[['pct_estimate', 'lead', 'pct_3rd_party','momentum']].describe())|
pct_estimate |
lead |
pct_3rd_party |
momentum |
vote_share | |
|
count |
20504 |
20504 |
20504 |
20504 |
20504 |
|
mean |
44.73 |
0.00 |
1.25 |
0.00 |
48.85 |
|
min |
32.65 |
-18.01 |
0.00 |
-8.45 |
40.96 |
|
25% |
42.07 |
-4.94 |
0.00 |
-0.01 |
46.17 |
|
50% |
44.99 |
0.00 |
0.00 |
0.00 |
48.67 |
|
75% |
47.43 |
4.94 |
0.00 |
0.01 |
50.77 |
|
max |
56.47 |
18.01 |
12.67 |
8.45 |
57.97 |
|
std |
3.89 |
6.58 |
2.66 |
0.47 |
3.59 |
|
pct_estimate |
lead |
pct_3rd_party |
momentum | |
|
count |
3228 |
3228 |
3228 |
3228 |
|
mean |
43.53 |
0.00 |
5.87 |
0.00 |
|
min |
35.39 |
-8.77 |
0.00 |
-6.28 |
|
25% |
41.06 |
-2.07 |
0.00 |
-0.12 |
|
50% |
43.76 |
0.00 |
8.01 |
0.00 |
|
75% |
46.56 |
2.07 |
8.91 |
0.12 |
|
max |
48.89 |
8.77 |
12.17 |
6.28 |
|
std |
3.22 |
3.63 |
4.05 |
0.45 |
Distribusi fitur pada kedua dataset swing_until_20 dan swing_24 tampak masuk akal dan selaras dengan ekspektasi untuk data polling di swing states.
Nilai pct_estimate berkisar antara sekitar 33% hingga 56% secara historis dan 35% hingga 49% pada 2024, yang wajar untuk pemilu kompetitif di mana tidak ada kandidat yang mendominasi. vote_share di dataset historis memiliki mean 48,85%, yang masuk akal mengingat swing states sering mendekati pembagian 50-50.
Seperti yang diharapkan, variabel lead dan momentum berpusat di sekitar mean 0 pada kedua dataset, menunjukkan bahwa keunggulan, ketertinggalan, kenaikan, dan penurunan antar kandidat saling menyeimbangkan seiring waktu. Variabel lead tampak nyaris terdistribusi normal sempurna, sementara momentum setidaknya simetris namun dengan sebagian besar nilai mendekati mean.
Secara historis, pct_estimate mengikuti distribusi yang cukup normal dengan sedikit kemiringan ke kiri, karena mean setidaknya sangat dekat dengan median, dan sebarannya menangkap rentang nilai yang wajar.
Pada data 2024, persentase polling lebih terpusat di sekitar mean. Variabel lead memiliki deviasi standar lebih rendah pada 2024 (3,63) dibanding data historis (6,58), dan rentang nilainya bahkan kurang dari setengah historis. Ini semua mengindikasikan margin antar kandidat lebih dekat pada 2024, menyiratkan persaingan yang lebih ketat.
Pada sebagian besar siklus, tidak ada kandidat pihak ketiga yang meraih dukungan signifikan, terlihat dari fakta bahwa lebih dari 75% observasi memiliki nilai pct_3rd_party sebesar 0, dengan rata-rata 1,25%. Angka tinggi pada 2024 (median 8,01%) mencerminkan kuatnya dukungan untuk kandidat independen Robert F. Kennedy hingga akhir kampanyenya pada Agustus 2024.
Strategi Prediksi untuk Pemilu AS 2024
Strategi prediksi kita akan mempertimbangkan bahwa jajak pendapat bukanlah hasil pemilu yang definitif melainkan indikator sentimen publik pada momen tertentu. Karena itu, kita akan menghindari mengandalkan prediksi deret waktu sederhana yang memperlakukan data polling sebagai prakiraan langsung atas hasil. Sebagai gantinya, kita akan menggunakan pendekatan regresi yang memprediksi hasil pemilu untuk tiap observasi polling secara individual, alih-alih memprakirakan lini masa data polling.
Menyadari bahwa tiap negara bagian memiliki lanskap politiknya sendiri, kita akan membangun model terpisah untuk tiap swing state. Untuk mencegah kebocoran data dan menghormati alur waktu, kita pastikan model hanya diuji pada data yang belum pernah dilihat—khususnya, siklus pemilu yang terjadi setelah siklus-siklus yang digunakan untuk melatih model. Pendekatan ini membantu mengevaluasi kemampuan model menggeneralisasi ke pemilu mendatang secara akurat.
Saya memilih dua kriteria saat mengevaluasi model prediktif untuk share suara pemilu. Karena pemenang “mengambil semuanya” di tiap negara bagian, jumlah pemenang yang diprediksi dengan benar di seluruh siklus pengujian adalah ukuran terpenting untuk dipertimbangkan.
Mean Absolute Error (MAE) adalah kriteria evaluasi sekunder. Ini mengukur rata-rata besaran kesalahan antara nilai prediksi dan aktual dalam satuan yang sama dengan variabel target—dalam hal ini, poin persentase share suara. Ini membuatnya sangat mudah ditafsirkan dan relevan secara langsung dalam konteks kita, karena memberitahu, rata-rata, berapa poin persentase prediksi kita menyimpang dari hasil aktual.
Terakhir, kita akan melatih model terbaik tiap negara bagian pada semua siklus hingga 2020 dan menerapkannya untuk memprediksi hasil pemilu 2024. Kita akan menggunakan pembobotan berbasis waktu dengan fungsi peluruhan eksponensial untuk mengubah prediksi individual menjadi satu nilai prediksi per negara bagian, dengan memberikan bobot lebih besar pada jajak pendapat terbaru.
Memilih Model Machine Learning
Pertama-tama, kita impor paket yang dibutuhkan nanti. Ini mencakup semua model yang akan kita evaluasi, NumPy, serta mean_absolute_error.
# Importing models
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression, Ridge, ElasticNet
from sklearn.neighbors import KNeighborsRegressor
from sklearn.neural_network import MLPRegressor
from sklearn.svm import SVR
import catboost
import xgboost as xgb
# Importing other necessary libraries
from sklearn.metrics import mean_absolute_error
import numpy as npMelatih model
Mari kita buat alur kerja untuk melatih dan mengevaluasi model dasar! Kita akan melalui prosesnya selangkah demi selangkah lalu menerapkannya ke tiap negara bagian untuk tiap siklus uji, dimulai dari 2004.
Untuk menyesuaikan model dengan karakteristik unik tiap negara bagian, kita mulai dengan memfilter dataset agar hanya mencakup data yang relevan dengan negara bagian yang dianalisis. Ini memastikan model menangkap pola pemungutan suara dan data polling spesifik negara bagian.
# Filter data for the state you're analyzing
data_state = swing_until_20[swing_until_20['state'] == state].copy()Kemudian kita mendefinisikan fungsi bobot untuk memberikan bobot lebih besar pada jajak pendapat yang dilakukan lebih dekat ke tanggal pemilu. Fungsi peluruhan eksponensial ini menurunkan bobot jajak pendapat seiring jaraknya dari hari pemilu, menekankan relevansi data polling terbaru.
# Define the weight function (using a typical starting k value)
def compute_weight(days_until_election, k):
return np.exp(-k * days_until_election)
# Add weights to the data
data_state['weight'] = compute_weight(data_state['days_until_election'], k=0.1)Berikutnya, kita membagi data menjadi set pelatihan dan pengujian berdasarkan siklus pemilu, memastikan kita melatih pada pemilu masa lalu dan menguji pada pemilu masa depan untuk mencegah kebocoran data. Kita akan mendefinisikan train_cycles dan test_cycle nanti saat membungkus loop melalui siklus pemilu. Kita juga mendefinisikan fitur yang akan digunakan untuk prediksi dan mengekstrak variabel target, yaitu share suara aktual.
# Split data into training and testing sets based on election cycles
train_data = data_state[data_state['cycle'].isin(train_cycles)]
test_data = data_state[data_state['cycle'] == test_cycle]
# Define features and target variable
features = ['pct_estimate', 'pct_opponent', 'pct_3rd_party', 'lead', 'rolling_avg_7d',
'days_until_election', 'momentum_candidate', 'momentum_opponent', 'momentum',
'is_incumbent_president', 'is_incumbent_vice_president', 'is_incumbent_party',
'candidate_Donald Trump',
'party_DEM', 'party_REP']
X_train = train_data[features]
y_train = train_data['vote_share']
X_test = test_data[features]
y_test = test_data['vote_share']Kita mendefinisikan beragam model machine learning untuk dievaluasi, termasuk regresi linear, metode ensemble, support vector machines, dan neural network. Set yang beragam ini memungkinkan kita membandingkan algoritme dan memilih model dengan kinerja terbaik untuk tiap negara bagian.
# Models to evaluate
models = {
'LinearRegression': LinearRegression(),
'XGBoost': xgb.XGBRegressor(objective='reg:absoluteerror', n_estimators=100, random_state=42),
'CatBoost': catboost.CatBoostRegressor(loss_function='MAE', iterations=100, random_seed=42, verbose=0),
'RandomForest': RandomForestRegressor(n_estimators=100, random_state=42),
'SVR': SVR(kernel='rbf', C=1.0, epsilon=0.1),
'KNeighbors': KNeighborsRegressor(n_neighbors=5),
'MLPRegressor': MLPRegressor(hidden_layer_sizes=(100,), max_iter=500, random_state=42),
'ElasticNet': ElasticNet(alpha=1.0, l1_ratio=0.5, random_state=42),
}Selanjutnya, kita akan melakukan loop melalui dictionary models. Untuk tiap model, kita latih menggunakan dataset pelatihan khusus negara bagian saat ini lalu membuat prediksi pada dataset pengujiannya. Proses ini diulang untuk setiap model guna menilai kinerjanya secara komparatif.
for model_name, model in models.items():
# Train the model
model.fit(X_train, y_train)
# Predict on test data
test_data[f'predicted_{model_name}'] = model.predict(X_test)Di dalam loop model, kita mengagregasikan prediksi individual untuk tiap partai menggunakan fungsi lambda yang menerapkan bobot yang sebelumnya dihitung. Ini menghasilkan satu prediksi share suara per partai, yang kemudian kita bandingkan dengan share suara aktual untuk menilai akurasi model.
# Aggregate predictions using weights
aggregated_predictions = test_data.groupby('party').apply(
lambda df: np.average(df[f'predicted_{model_name}'], weights=df['weight'])
).reset_index(name='aggregated_prediction')
# Get actual vote shares for comparison
actual_vote_shares = test_data.groupby('party')['vote_share'].mean().reset_index()
comparison = pd.merge(aggregated_predictions, actual_vote_shares, on='party')
comparison.rename(columns={'vote_share': 'actual_vote_share'}, inplace=True)Untuk menutup loop model, kita menghitung Mean Absolute Error (MAE) antara prediksi teragregasi dan share suara aktual untuk mengukur kinerja model. Kita juga menentukan apakah model memprediksi partai pemenang di negara bagian tersebut dengan benar dan menyimpan hasilnya untuk analisis selanjutnya.
# Calculate Mean Absolute Error
mae = mean_absolute_error(comparison['actual_vote_share'], comparison['aggregated_prediction'])
# Check if the predicted winner matches the actual winner
predicted_winner = comparison.loc[comparison['aggregated_prediction'].idxmax(), 'party']
actual_winner = comparison.loc[comparison['actual_vote_share'].idxmax(), 'party']
correct_winner = int(predicted_winner == actual_winner)
# Store the results
results_list.append({
'state': state,
'model_name': model_name,
'test_cycle': test_cycle,
'MAE': mae,
'correct_winner': correct_winner
})Seluruh proses ini dibungkus dalam dua loop: loop luar mengiterasi tiap siklus pemilu (kecuali yang pertama, karena belum ada data sebelumnya untuk melatih), dan loop dalam mengiterasi tiap swing state. Dengan begitu, kita memastikan model dilatih dan diuji secara tepat untuk tiap negara bagian dan siklus pemilu, menghormati urutan kronologis pemilu untuk mencegah kebocoran data.
Pendahuluan kode di atas tampak seperti ini:
# Initialize a list to store results
results_list = []
# Define the election cycles
cycles = [2000, 2004, 2008, 2012, 2016, 2020]
for i in range(1, len(cycles)): # The loop starts at index 1, so with the 2nd cycle (2004)
test_cycle = cycles[i]
train_cycles = cycles[:i] # train_cycles = all cycles before the test_cycle
for state in swing_states:
# Filter data for the state you're analyzing, etc. …Secara keseluruhan, strategi ini memungkinkan kita mengevaluasi banyak model lintas negara bagian dan siklus pemilu, pada akhirnya memilih model berkinerja terbaik untuk tiap negara bagian berdasarkan akurasi prediktif dan kemampuan memprediksi pemenang dengan benar.
Mengevaluasi hasil dan model tiap negara bagian
Setelah melatih dan menguji berbagai model machine learning lintas negara bagian dan siklus pemilu, kita beralih ke evaluasi kinerja untuk mengidentifikasi model terbaik per negara bagian. Evaluasi ini fokus pada dua metrik kunci: jumlah kali tiap model memprediksi partai pemenang dengan benar (correct_winner) dan rata-rata Mean Absolute Error (MAE) dari prediksinya.
Pertama, kita kompilasi semua hasil yang dikumpulkan selama evaluasi model ke dalam satu DataFrame dan mengagregasi metrik kinerja:
# After the loop, create a DataFrame from the results list
results_df = pd.DataFrame(results_list)
# Get the sum of correct_winner and the average MAE for every combination of state and model_name
aggregated_evaluation = results_df.groupby(['state', 'model_name']).agg({
'correct_winner': 'sum',
'MAE': 'mean'
}).reset_index()
# Display the maximum number of correct winner predictions and the minimum MAE for each state
print(aggregated_evaluation.groupby('state')['correct_winner'].max())
print(aggregated_evaluation.groupby('state')['MAE'].min())|
state |
Maximum correct_winner |
Minimum MAE |
|
Arizona |
5 |
1.248966 |
|
Georgia |
5 |
0.770760 |
|
Michigan |
4 |
2.685870 |
|
Nevada |
5 |
2.079582 |
|
North Carolina |
5 |
0.917522 |
|
Pennsylvania |
4 |
2.027426 |
|
Wisconsin |
4 |
2.462907 |
Itu tidak terlihat terlalu buruk! Di semua negara bagian, setidaknya ada satu model yang memprediksi 4 dari 5 pemilu sebelumnya dengan benar. Di 4 negara bagian (Arizona, Georgia, Nevada, dan North Carolina), bahkan ada model yang memprediksi pemenang dengan benar di setiap siklus. Hasil MAE terendah sebagian masih bisa ditingkatkan, dan cukup bervariasi antar negara bagian, rata-rata 1,74 poin persentase dan berkisar dari 0,77 di Georgia hingga 2,69 di Michigan.
Dengan informasi teragregasi ini, kita lanjut memilih model dengan kinerja terbaik untuk tiap negara bagian. Kita mengurutkan model berdasarkan kemampuan memprediksi pemenang terlebih dahulu dan baru kemudian berdasarkan MAE. Model terpilih disimpan dalam dictionary best_models.
# Sort the models for each state by correct_winner (descending) and then by MAE (ascending)
sorted_evaluation = aggregated_evaluation.sort_values(by=['state', 'correct_winner', 'MAE'], ascending=[True, False, True])
# Create a dictionary to store the best model for each state
best_models = {}
# Iterate over each state and get the top model
for state in sorted_evaluation['state'].unique():
top_model = sorted_evaluation[sorted_evaluation['state'] == state].iloc[0]
best_models[state] = top_model['model_name']
best_models{'Arizona': 'RandomForest',
'Georgia': 'ElasticNet',
'Michigan': 'LinearRegression',
'Nevada': 'KNeighbors',
'North Carolina': 'CatBoost',
'Pennsylvania': 'KNeighbors',
'Wisconsin': 'MLPRegressor'}Model teratas untuk tiap negara bagian sangat bervariasi, mencerminkan pola pemungutan suara dan perilaku polling yang unik di setiap wilayah. Mengejutkan, di Michigan hasil terbaik bahkan dicapai dengan menggunakan Regresi Linear, mengindikasikan pendekatan linear yang lebih sederhana mungkin sudah memadai di sana.
Pada titik ini, kita bisa melakukan hyperparameter tuning untuk mengoptimalkan kinerja tiap model machine learning. Karena hal itu akan menimbulkan pertanyaan metodologis lanjutan dan membutuhkan penyesuaian kode yang besar, topik tersebut berada di luar cakupan tutorial yang sudah cukup panjang ini. Hasil model dasar sudah cukup menjanjikan untuk berani memprediksi hasil pemilu 2024.
Memprediksi Swing States pada Pemilu AS 2024
Pada tahap akhir analisis, kita menggunakan model berkinerja terbaik untuk tiap swing state guna memprediksi hasil pemilu 2024. Kita mulai dengan menginisialisasi daftar kosong untuk menyimpan prediksi.
Untuk tiap negara bagian dan model terbaiknya dari evaluasi sebelumnya, kita gunakan alur kerja yang sama seperti sebelumnya. Hanya saja kali ini, kita tidak perlu melakukan loop melalui siklus pemilu, melainkan melatih pada semua data historis dari 2000 hingga 2020 (swing_until_20).
# Initialize a list to store predictions
predictions_list = []
for state, model_name in best_models.items():
# Filter the data for the specific state
state_data_train = swing_until_20[swing_until_20['state'] == state].copy() # Data from 2000 to 2020
state_data_test = swing_24[swing_24['state'] == state].copy() # Data for 2024
# Add weights to the test data
state_data_test['weight'] = compute_weight(state_data_test['days_until_election'], k=0.1)
# Define features
features = [
'pct_estimate',
'pct_opponent',
'pct_3rd_party',
'lead',
'rolling_avg_7d',
'days_until_election',
'momentum_candidate',
'momentum_opponent',
'momentum',
'is_incumbent_president',
'is_incumbent_vice_president',
'is_incumbent_party',
'candidate_Donald Trump',
'party_DEM',
'party_REP'
]
# Split features and target variable
X_train = state_data_train[features]
y_train = state_data_train['vote_share']
X_test = state_data_test[features]
# Train the model on the 2000 to 2020 data
model.fit(X_train, y_train)
# Predict on the 2024 data
state_data_test['predicted_vote_share'] = model.predict(X_test)
# Aggregate predictions using weights
aggregated_predictions = state_data_test.groupby('party').apply(
lambda df: np.average(df['predicted_vote_share'], weights=df['weight'])
).reset_index(name='aggregated_prediction')
# Append predictions to the list
for _, pred_row in aggregated_predictions.iterrows():
predictions_list.append({
'state': state,
'party': pred_row['party'],
'predicted_vote_share': pred_row['aggregated_prediction'],
'model': model_name
})Setelah memprediksi kolom vote_share, mengagregasikan prediksi menggunakan fungsi bobot yang telah kita definisikan, dan menambahkan prediksi ke predictions_list, kita konsolidasikan prediksi akhir ke sebuah DataFrame. Selain itu, kita tambahkan peringkat untuk tiap negara bagian dan pivot prediksi per negara bagian. Berikut prediksi yang dibuat oleh model kita:
# Convert predictions list to DataFrame
predictions_df = pd.DataFrame(predictions_list)
# Add a rank to predictions_df for each state based on the order of predicted_vote_share
predictions_df['rank'] = predictions_df.groupby('state')['predicted_vote_share'].rank(ascending=False)
# Create a pivot table indexed by state
predictions_pivot = predictions_df.pivot(index='state', columns='party', values='predicted_vote_share')
# Display predictions
print("\n2024 Vote Share Predictions:")
predictions_pivot2024 Vote Share Predictions:
state
DEM
REP
Arizona
49.02
50.31
Georgia
48.95
50.08
Michigan
50.34
48.64
Nevada
49.41
48.54
North Carolina
48.95
50.06
Pennsylvania
49.57
49.20
Wisconsin
49.66
49.41Prediksi ini menegaskan perkiraan kita tentang persaingan yang sangat ketat di swing states. Model kita memprediksi empat negara bagian memberikan mayoritas suara untuk Kamala Harris (Michigan, Nevada, Pennsylvania, Wisconsin) dan 3 untuk Donald Trump (Arizona, Georgia, North Carolina). Negara bagian Pennsylvania dan Wisconsin diperkirakan sangat tipis dengan selisih antara kedua share suara yang diprediksi hanya 0,37 dan 0,25 poin persentase.
Prediksi Pemilu AS 2024
Seperti disebut sebelumnya, kita mengasumsikan semua negara bagian lain memilih kandidat yang diharapkan menang, yaitu negara bagian “biru” memilih Kamala Harris, dan negara bagian “merah” memilih Donald Trump. Untuk menilai berapa banyak electoral vote yang diperoleh masing-masing kandidat, kita mendefinisikan dictionary yang menetapkan jumlah suara per negara bagian dan distrik lalu menggabungkan informasinya dalam DataFrame bernama electoral_votes_df.
# Define the number of electoral votes per state for the 2024 US-Presidential elections
electoral_votes = {
'Alabama': 9, 'Alaska': 3, 'Arizona': 11, 'Arkansas': 6, 'California': 54,
'Colorado': 10, 'Connecticut': 7, 'Delaware': 3, 'District of Columbia': 3,
'Florida': 30, 'Georgia': 16, 'Hawaii': 4, 'Idaho': 4, 'Illinois': 19,
'Indiana': 11, 'Iowa': 6, 'Kansas': 6, 'Kentucky': 8, 'Louisiana': 8,
'Maine': 2, 'Maryland': 10, 'Massachusetts': 11, 'Michigan': 15,
'Minnesota': 10, 'Mississippi': 6, 'Missouri': 10, 'Montana': 4,
'Nebraska': 2, 'Nevada': 6, 'New Hampshire': 4, 'New Jersey': 14,
'New Mexico': 5, 'New York': 28, 'North Carolina': 16, 'North Dakota': 3,
'Ohio': 17, 'Oklahoma': 7, 'Oregon': 8, 'Pennsylvania': 19,
'Rhode Island': 4, 'South Carolina': 9, 'South Dakota': 3,
'Tennessee': 11, 'Texas': 40, 'Utah': 6, 'Vermont': 3, 'Virginia': 13,
'Washington': 12, 'West Virginia': 4, 'Wisconsin': 10, 'Wyoming': 3
}
# Create a DataFrame from the dictionary
electoral_votes_df = pd.DataFrame(list(electoral_votes.items()), columns=['State', 'Electoral Votes'])
# Handle states that divide their votes into multiple districts (Maine and Nebraska)
districts = {'ME-1': 1, 'ME-2': 1, 'NE-1': 1, 'NE-2': 1, 'NE-3': 1}
# Add the districts to the DataFrame
districts_df = pd.DataFrame(list(districts.items()), columns=['State', 'Electoral Votes'])
# Combine the two DataFrames
electoral_votes_df = pd.concat([electoral_votes_df, districts_df], ignore_index=True)Berikutnya, kita membuat dua daftar, harris dan trump, yang memuat negara bagian biru dan merah, masing-masing, beserta swing states yang diprediksi dimenangkan oleh tiap kandidat. Pada langkah selanjutnya, kita dapat memfilter electoral_votes_df untuk negara bagian dalam tiap daftar dan menghitung jumlah electoral vote yang diharapkan untuk masing-masing kandidat.
# Extract states from predictions_df where party is DEM and rank is 1
additional_blue_states = predictions_df[
(predictions_df['party'] == 'DEM') & (predictions_df['rank'] == 1)
].state.tolist()
# Extract states from predictions_df where party is REP and rank is 1
additional_red_states = predictions_df[
(predictions_df['party'] == 'REP') & (predictions_df['rank'] == 1)
].state.tolist()
# Combine blue_states and additional_blue_states into a single list
harris = list(set(blue_states + additional_blue_states))
trump = list(set(red_states + additional_red_states))
# Filter the electoral votes for states in each candidate's list
harris_electoral_votes = electoral_votes_df[electoral_votes_df['state'].isin(harris)]
trump_electoral_votes = electoral_votes_df[electoral_votes_df['state'].isin(trump)]
# Sum the electoral votes
sum_harris_electoral_votes = harris_electoral_votes['electoral_votes'].sum()
sum_trump_electoral_votes = trump_electoral_votes['electoral_votes'].sum()
print(
f'According to the predictions made by the machine learning models, '
f'Kamala Harris will win {sum_harris_electoral_votes} electoral votes '
f'and Donald Trump will win {sum_trump_electoral_votes} electoral votes.'
)According to the predictions made by the machine learning models, Kamala Harris will win 276 electoral votes and Donald Trump will win 262 electoral votes.Prediksi menyatakan bahwa Kamala Harris akan meraih 276 electoral vote dan Donald Trump akan meraih 262 electoral vote. Jika asumsi dan prediksi kita terbukti, inilah kira-kira tampilan peta elektoral pada 5 November:
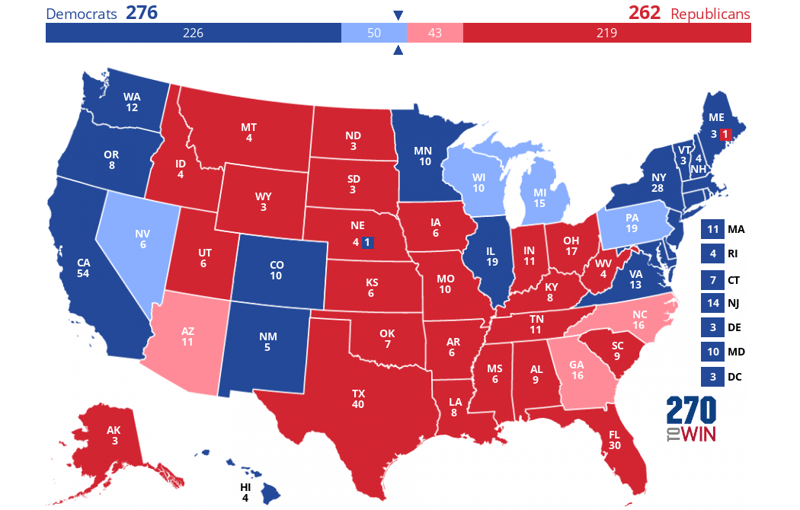
Dibuat menggunakan pembuat peta interaktif ini.
Warna gelap merepresentasikan negara bagian yang kita asumsikan “biru” atau “merah”. Swing states yang kita prediksi menjadi pembeda—diwarnai biru atau merah yang lebih muda.
Kesimpulan
Dalam proyek ini, kita menggunakan data polling historis untuk memprediksi hasil pemilu presiden AS 2024. Seperti yang diharapkan, model kita menunjukkan persaingan ketat antara kandidat utama.
Penting untuk diingat bahwa analisis kita hanya berdasar pada data polling, yang terkadang tidak akurat di masa lalu dan tidak menangkap seluruh nuansa pemilu. Faktor seperti metodologi polling, partisipasi pemilih, dinamika kampanye, kondisi ekonomi dan demografis, serta kejadian tak terduga tidak dipertimbangkan dalam model kita namun dapat berdampak signifikan pada hasil aktual.
Meski begitu, eksplorasi ini menunjukkan potensi analitik prediktif dalam memahami sistem kompleks seperti pemilu. Jika Anda ingin mempelajari lebih lanjut tentang analitik prediktif menggunakan Python, saya merekomendasikan sumber berikut:




Disclaimer: Tutorial ini tidak bersifat politis—pemilu presiden AS yang akan datang hanya digunakan sebagai sarana untuk menulis konten edukatif tentang machine learning. Opini adalah milik saya pribadi dan tidak mewakili pandangan DataCamp.
Setelah berhasil memprediksi hasil EURO 2024 menggunakan machine learning, saya kini beralih ke perhelatan yang taruhannya lebih tinggi lagi: pemilu presiden AS 2024.
Dengan persaingan yang diperkirakan ketat antara Wakil Presiden Kamala Harris dan Mantan Presiden Donald Trump, mari gunakan machine learning untuk memprediksi siapa pemenangnya!
Saya menulis blog ini untuk audiens teknis yang akrab dengan Python dan machine learning. Jika Anda hanya ingin melihat hasil prediksi, lompat ke bagian terakhir berjudul “Prediksi Pemilu AS 2024.”
Jika Anda ingin mencoba kode yang saya gunakan, semuanya tersedia dalam notebook DataLab ini.