

लर्निंग पाथ
पर्यवेक्षित मशीन लर्निंग में Python
25 घंटा
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंहमारी भविष्यवाणी के लिए इस्तेमाल किया गया डेटा FiveThirtyEight से है, जो विभिन्न पोलस्टर्स से पोल डेटा एकत्र करता है। यह डेटा उनके GitHub पर 1968 से अब तक के सभी चुनाव चक्रों के लिए उपलब्ध है।
हम उनके पोल मॉडल का उपयोग करेंगे, जो चुनाव से पहले आठ महीनों के दौरान (लगभग) हर दी गई तारीख पर प्रत्येक राज्य में प्रत्येक उम्मीदवार के लिए औसत पोल प्रतिशत असाइन करता है।
हम CSV फ़ाइलों से 2024, 2020 और ऐतिहासिक पोलिंग डेटा आयात करने से शुरू करते हैं। 2024 का डेटा केवल मौजूदा चक्र के पोल्स पर फ़िल्टर किया जाता है, और 2016 तक का ऐतिहासिक डेटा 2020 के डेटा के साथ संयोजित किया जाता है। परिणामी दो DataFrames, polls_24 और polls_until_20, में तारीख के कॉलम्स को सुसंगतता के लिए datetime प्रारूप में बदला जाता है, और चक्र, राज्य, उम्मीदवार का नाम और पोलिंग आकलन जैसे प्रासंगिक कॉलम्स रखे जाते हैं।
import pandas as pd

# Reading CSV files
polls_24 = pd.read_csv('presidential_general_averages.csv')
polls_20 = pd.read_csv('presidential_poll_averages_2020.csv')
polls_until_16 = pd.read_csv('pres_pollaverages_1968-2016.csv')

# Filtering and concatenating DataFrames
polls_24 = polls_24[polls_24['cycle'] == 2024]
polls_until_20 = pd.concat([polls_20, polls_until_16], ignore_index=True)

# Making sure dates are in datetime format
polls_24['date'] = pd.to_datetime(polls_24['date'], format='%Y-%m-%d')
polls_until_20['modeldate'] = pd.to_datetime(polls_until_20['modeldate'])

# Keeping only the columns of interest
polls_until_20 = polls_until_20[['cycle', 'state', 'modeldate', 'candidate_name', 'pct_estimate', 'pct_trend_adjusted']]
वास्तविक राज्यवार मतदान परिणामों के लिए, मैंने डेटा सीधे यूएसए के Federal Election Commission से लिया। सरलता के लिए, मैंने उन्हें पहले से ही एक CSV फ़ाइल में संक्षेपित कर दिया।
एक ऑब्जर्वेशन चुनाव चक्र, राज्य और पार्टी के संयोजन का प्रतिनिधित्व करता है, जिसमें संबंधित उम्मीदवार का नाम और, निश्चित रूप से, उस उम्मीदवार द्वारा हासिल किया गया वोट शेयर प्रतिशत शामिल है।
# Importing result data
results_until_20 = pd.read_csv('results.csv', sep=';')
results_until_20 = results_until_20[['cycle', 'state', 'party', 'candidate', 'vote_share']]
यह सुनिश्चित करने के लिए कि हम प्रासंगिक और उच्च-गुणवत्ता वाले डेटा के साथ काम कर रहे हैं, मैंने दो प्रमुख प्रतिबंध लगाए हैं:
swing_states, blue_states और red_states की सूचियाँ परिभाषित करते हैं, और स्विंग राज्यों के लिए डेटा के सबसेट बनाते हैं।# Implementing cycle restriction
start_cycle = 2000
polls_until_20 = polls_until_20[polls_until_20['cycle'] >= start_cycle]
# Defining state lists
swing_states = [
'Pennsylvania', 'Wisconsin', 'Michigan', 'Georgia',
'North Carolina', 'Arizona', 'Nevada'
]
blue_states = [
'District of Columbia', 'Vermont', 'Massachusetts', 'Maryland',
'Hawaii', 'California', 'ME-1', 'Connecticut', 'Washington',
'Delaware', 'Rhode Island', 'New York', 'Illinois', 'New Jersey',
'Oregon', 'Colorado', 'Maine', 'New Mexico', 'Virginia',
'New Hampshire', 'NE-2', 'Minnesota'
]
red_states = [
'Wyoming', 'West Virginia', 'Oklahoma', 'North Dakota',
'Idaho', 'South Dakota', 'Arkansas', 'Kentucky', 'NE-3',
'Alabama', 'Tennessee', 'Utah', 'Louisiana', 'Nebraska',
'Mississippi', 'Montana', 'NE-1', 'Indiana', 'Kansas',
'Missouri', 'South Carolina', 'Alaska', 'Ohio', 'Iowa',
'Texas', 'ME-2', 'Florida'
]
# Defining swing state subset of the poll data
swing_until_20 = polls_until_20[polls_until_20['state'].isin(swing_states)]
swing_24 = polls_24[polls_24['state'].isin(swing_states)]अपने डेटा का अवलोकन पाने के लिए, हम कुछ एक्सप्लोरेटरी डेटा एनालिसिस (EDA) करते हैं। सबसे पहले, हम .isnull() और .sum() के संयोजन का उपयोग करते हैं ताकि देखें कि प्रत्येक DataFrame में कौन से कॉलम हैं और कहाँ डेटा गायब हो सकता है।
# Checking for missing values in swing_24 and swing_until_20
print(swing_24.isnull().sum())
print(swing_until_20.isnull().sum())
candidate 0
date 0
pct_trend_adjusted 4394
state 0
cycle 0
party 0
pct_estimate 0
hi 0
lo 0
dtype: int64
cycle 0
state 0
modeldate 0
candidate_name 0
pct_estimate 0
pct_trend_adjusted 0
dtype: int64जैसा कि हम देख सकते हैं, दोनों DataFrames में कॉलम नाम अलग हैं, और party कॉलम swing_until_20 में गायब प्रतीत होता है। इसके अलावा, दो प्रकार के प्रतिशत मापे जाते दिख रहे हैं: एक अनुमानित प्रतिशत और एक ट्रेंड-एडजस्टेड। हालांकि, 2024 के डेटा के लिए ट्रेंड-एडजस्टेड प्रतिशत उपलब्ध नहीं दिखता। हम इसे आगे जाँचेंगे।
अब अगला कदम हमारे श्रेणीबद्ध वेरिएबल्स के भिन्न मानों की जाँच करना है:
print('2024 data:')
print(swing_24['date'].min())			# earliest polling date
print(swing_24['date'].max())			# latest polling date
print(swing_24['state'].unique().tolist())	# distinct states
print(swing_24['party'].unique().tolist())	# distinct parties
print(swing_24['candidate'].unique().tolist())	# distinct candidates
print('Historical data:')
print(swing_until_20['modeldate'].min())
print(swing_until_20['modeldate'].max())
print(swing_until_20['state'].unique().tolist())
print(swing_until_20['candidate_name'].unique().tolist())
2024 data:
2024-03-01 00:00:00
2024-10-29 00:00:00
['Arizona', 'Georgia', 'Michigan', 'Nevada', 'North Carolina', 'Pennsylvania', 'Wisconsin']
['REP', 'DEM', 'IND']
['Trump', 'Harris', 'Kennedy', 'Biden']
Historical data:
2000-03-02 00:00:00
2020-11-03 00:00:00
['Wisconsin', 'Pennsylvania', 'North Carolina', 'Nevada', 'Michigan', 'Georgia', 'Arizona']
['Joseph R. Biden Jr.', 'Donald Trump', 'Convention Bounce for Joseph R. Biden Jr.', 'Convention Bounce for Donald Trump', 'Hillary Rodham Clinton', 'Gary Johnson', 'Barack Obama', 'Mitt Romney', 'John McCain', 'George W. Bush', 'John Kerry', 'Al Gore', 'Ralph Nader']राज्यों और तारीखों के लिए डेटा अच्छा दिख रहा है, लेकिन उम्मीदवार-संबंधित कॉलम्स के बारे में कुछ बातें ध्यान देने योग्य हैं। ऐतिहासिक डेटा (विशेष रूप से 2020 चक्र का) न केवल दोनों उम्मीदवारों के प्रतिशत शामिल करता है, बल्कि कन्वेंशन बाउंस भी—यानी राष्ट्रीय सम्मेलन के बाद समर्थन में वृद्धि। इसके अलावा, swing_24 में प्रथम नाम गायब लगते हैं।
विभिन्न प्रकार के प्रतिशतों की जाँच के लिए, कन्वेंशन बाउंस ऑब्जर्वेशन्स को तुरंत हटाना महत्वपूर्ण है:
# Only keep rows where candidate_name does not start with 'Convention Bounce'
swing_until_20 = swing_until_20[~swing_until_20['candidate_name'].str.startswith('Convention Bounce')]संगतता सुनिश्चित करने के लिए, प्रशिक्षण और परीक्षण डेटा के लिए प्रतिशत का प्रकार समान होना चाहिए। जैसा कि हमने देखा, केवल 2020 के चुनाव चक्र तक के डेटा में अनुमानित और ट्रेंड-एडजस्टेड दोनों प्रतिशत हैं, जबकि 2024 के लिए केवल अनुमानित प्रतिशत हैं। इससे हमारे पास दो विकल्प बचते हैं:
यह स्पष्ट नहीं है कि ऐतिहासिक डेटा के लिए ट्रेंड-एडजस्टेड प्रतिशत कैसे निकाला गया था। इसलिए, डेटा क्लीनिंग पर आगे बढ़ने से पहले हमें अनुमानित और ट्रेंड-एडजस्टेड प्रतिशतों के बीच संबंध की जाँच करनी होगी, क्योंकि डेटा आधार का चुनाव हमारी भविष्यवाणियों के लिए महत्वपूर्ण है। पहले हम ऐतिहासिक डेटा में सहसंबंध और औसत अंतर की जाँच करते हैं।
# Checking the correlation between the percentages
adj_corr_swing = swing_until_20['pct_estimate'].corr(swing_until_20['pct_trend_adjusted'])
print('Correlation between estimated and trend-adjusted percentage in swing states: ' + str(adj_corr_swing))

# Calculate the mean difference between pct_estimate and pct_trend_adjusted, grouping by date, state, and party
mean_diff = (swing_until_20['pct_estimate'] - swing_until_20['pct_trend_adjusted']).mean()
print('Mean difference between estimated and trend-adjusted percentage in swing states: ' + str(mean_diff))
Correlation between estimated and trend-adjusted percentage in swing states: 0.9953626583357665
Mean difference between estimated and trend-adjusted percentage in swing states: 0.24980898513865013हम देख सकते हैं कि दोनों के बीच सहसंबंध अत्यंत उच्च (99.5%) है, जैसा कि अपेक्षित था। लगभग 0.25 प्रतिशत अंक का औसत अंतर पहले तो छोटा लगता है, लेकिन यह बहुत करीबी मुकाबलों में फर्क डाल सकता है, जैसे कि Nevada या Michigan में अपेक्षित हैं।
क्योंकि प्रत्येक राज्य में सभी इलेक्टोरल वोट विजेता को जाते हैं, इसलिए उम्मीदवारों के बीच क्रम किसी सटीक प्रतिशत से अधिक महत्वपूर्ण है। हम जो टालना चाहते हैं वह है चुनाव तिथि के करीब असंगति। इसलिए, हम 2020 के अंतिम चुनाव चक्र में और ऐसी घटना की अंतिम तारीख पर उन ऑब्जर्वेशन्स की संख्या देखते हैं जिनमें दोनों प्रतिशतों के बीच अग्रणी उम्मीदवार अलग था।
# Finding out how often pct_estimate and pct_trend_adjusted saw different candidates in the lead in the 2020 race
swing_20 = swing_until_20[swing_until_20['cycle'] == 2020]

# Create a new column to indicate if the ranking is different between pct_estimate and pct_trend_adjusted
swing_20['rank_estimate'] = swing_20.groupby(['state', 'modeldate'])['pct_estimate'].rank(ascending=False)
swing_20['rank_trend_adjusted'] = swing_20.groupby(['state', 'modeldate'])['pct_trend_adjusted'].rank(ascending=False)

# Rows where the rankings are different in swing states
different_rankings_swing = swing_20[swing_20['rank_estimate'] != swing_20['rank_trend_adjusted']]
print('Number of observations with differing leader: ' + str(different_rankings_swing.shape[0] / 2))
print('Last occurrence: ' + str(different_rankings_swing['modeldate'].max()))
Number of observations with differing leader: 34.0
Last occurrence: 2020-06-24 00:00:00स्पष्टतः, केवल 34 मामलों में बढ़त अलग थी—यानी औसतन प्रति स्विंग राज्य लगभग 5 दिन। चूँकि अंतिम घटना जून के अंत में है, सभी उदाहरण चुनाव अभियान के शुरुआती चरण में ही प्रतीत होते हैं।
इसे ध्यान में रखते हुए, नेतृत्व परिवर्तन की दुर्लभ घटनाएँ संभवतः मॉडल की समग्र सटीकता को प्रभावित नहीं करेंगी, खासकर जब हमारे पास कई चक्रों में फैला बड़ा डेटासेट है। इसलिए, मैंने पहला विकल्प चुना और सभी चुनाव चक्रों में केवल अनुमानित प्रतिशत का ही उपयोग किया। यह डेटा सुसंगतता सुनिश्चित करता है, जो मशीन लर्निंग में अलग-अलग डेटा प्रोसेसिंग विधियों से आने वाले पूर्वाग्रहों को सीखने से मॉडल को बचाने के लिए महत्वपूर्ण है।
राजनीतिक पार्टी के लिए एक कॉलम जोड़ने के लिए, हम पहले ऐतिहासिक डेटासेट में सभी उम्मीदवारों की सूची लेते हैं। फिर, हम उम्मीदवारों को कुंजी और संबंधित पार्टी को मान के रूप में लेकर एक डिक्शनरी बनाते हैं—ChatGPT इसके लिए शोध समय बचाने में बढ़िया है! अंत में, हम दोनों को एक DataFrame में मिलाते हैं और swing_until_20 से मर्ज करते हैं।
# Get unique candidate names
candidate_names = swing_until_20['candidate_name'].unique().tolist()

# Create a dictionary of candidates and their political party
party_map = {
    'Joseph R. Biden Jr.': 'DEM',
    'Donald Trump': 'REP',
    'Hillary Rodham Clinton': 'DEM',
    'Gary Johnson': 'LIB',
    'Barack Obama': 'DEM',
    'Mitt Romney': 'REP',
    'John McCain': 'REP',
    'Ralph Nader': 'IND',
    'George W. Bush': 'REP',
    'John Kerry': 'DEM',
    'Al Gore': 'DEM'
}

# Create a DataFrame with candidates and their respective parties
candidate_df = pd.DataFrame(candidate_names, columns=['candidate_name'])
candidate_df['party'] = candidate_df['candidate_name'].map(party_map)

# Merge the candidate_df with swing_until_20 on 'candidate' column
swing_until_20 = swing_until_20.merge(candidate_df[['candidate_name', 'party']], on='candidate_name', how='left')
अब जब हमने अपने swing_until_20 DataFrame में पार्टी कॉलम जोड़ लिया है, तो हम ऐतिहासिक चुनाव परिणामों को vote_share नामक नए कॉलम के रूप में इसमें मर्ज कर सकते हैं। चूँकि vote_share की CSV फ़ाइल अलग प्रारूप में थी, हमें इसे pct_estimate कॉलम के समान प्रारूप में समायोजित करना होगा।
# Merging results_until_20 to swing_until_20
swing_until_20 = pd.merge(swing_until_20, results_until_20, how='left', left_on=['cycle', 'state', 'party', 'candidate_name'], right_on=['cycle', 'state', 'party', 'candidate'])
swing_until_20['vote_share'] = swing_until_20['vote_share'].str.replace(',', '.')
swing_until_20['vote_share'] = pd.to_numeric(swing_until_20['vote_share'])अंत में, हम modeldate कॉलम का नाम बदलकर date रखते हैं, सभी अनावश्यक कॉलम हटाते हैं, और 2024 के डेटा में candidate के प्रारूप को भी प्रथम नाम शामिल करने के लिए समायोजित करते हैं।
# Renaming columns in swing_until_20
swing_until_20.rename(columns={'modeldate': 'date'}, inplace=True)

# Keeping only relevant columns
swing_24 = swing_24[['cycle', 'date', 'state', 'party', 'candidate', 'pct_estimate']]
swing_until_20 = swing_until_20[['cycle', 'date', 'state', 'party', 'candidate', 'pct_estimate', 'vote_share']]

# Update candidate names in swing_24 dataframe
swing_24['candidate'] = swing_24['candidate'].replace({
    'Trump': 'Donald Trump',
    'Biden': 'Joseph R. Biden Jr.',
    'Harris': 'Kamala Harris',
'Kennedy': 'Robert F. Kennedy'})आइए अब तक 2024 के चुनाव अभियान की रूपरेखा देखें। हम seaborn और matplotlib का उपयोग करके एक लाइन चार्ट बनाते हैं, जो सभी चयनित स्विंग राज्यों में औसत पोलिंग प्रगति दिखाता है। लाल, नीली और काली रेखाएँ क्रमशः रिपब्लिकन, डेमोक्रेटिक और स्वतंत्र उम्मीदवारों के पोलिंग प्रतिशत दर्शाती हैं। लंबवत रेखाएँ अभियान के दौरान महत्वपूर्ण घटनाओं को चिह्नित करती हैं।
import matplotlib.pyplot as plt
import seaborn as sns

# Ensure the date column is in datetime format
swing_24['date'] = pd.to_datetime(swing_24['date'])

# Group by date and party, then average the pct_estimate
swing_24_grouped = swing_24.groupby(['date', 'party'])['pct_estimate'].mean().reset_index()

# Create the line chart
plt.figure(figsize=(14, 8))
sns.lineplot(data=swing_24_grouped, x='date', y='pct_estimate', hue='party', marker='o',
             palette={'REP': 'red', 'DEM': 'blue', 'IND': 'black'})

# Add vertical lines for significant events
plt.axvline(pd.to_datetime('2024-07-13'), color='red', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-08-05'), color='blue', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-07-23'), color='blue', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-09-05'), color='black', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-10-01'), color='black', linestyle='--', alpha=0.25)

# Add text annotations for significant events
plt.text(pd.to_datetime('2024-07-13'), plt.ylim()[1] * 0.6, 'Trump Assassination Attempt', color='red', ha='right')
plt.text(pd.to_datetime('2024-07-23'), plt.ylim()[1] * 0.5, 'First Harris Rally', color='blue', ha='right')
plt.text(pd.to_datetime('2024-08-05'), plt.ylim()[1] * 0.4, 'Official Nomination of Harris', color='blue', ha='right')
plt.text(pd.to_datetime('2024-09-05'), plt.ylim()[1] * 0.3, 'Presidential Debate', color='black', ha='right')
plt.text(pd.to_datetime('2024-10-01'), plt.ylim()[1] * 0.2, 'Vice Presidential Debate', color='black', ha='right')

# Add horizontal gridlines at values divisible by 5
plt.yticks(range(0, 51, 5))
plt.grid(axis='y', linestyle='--', alpha=0.7)

# Limit the y-axis range to 50
plt.ylim(0, 50)

# Adjust the legend
plt.legend(title='Party')

# Set titles and labels
plt.title('Average Polling Percentage per Party Over Time in Swing States')
plt.xlabel('Date')
plt.ylabel('Average Polling Percentage')
plt.show()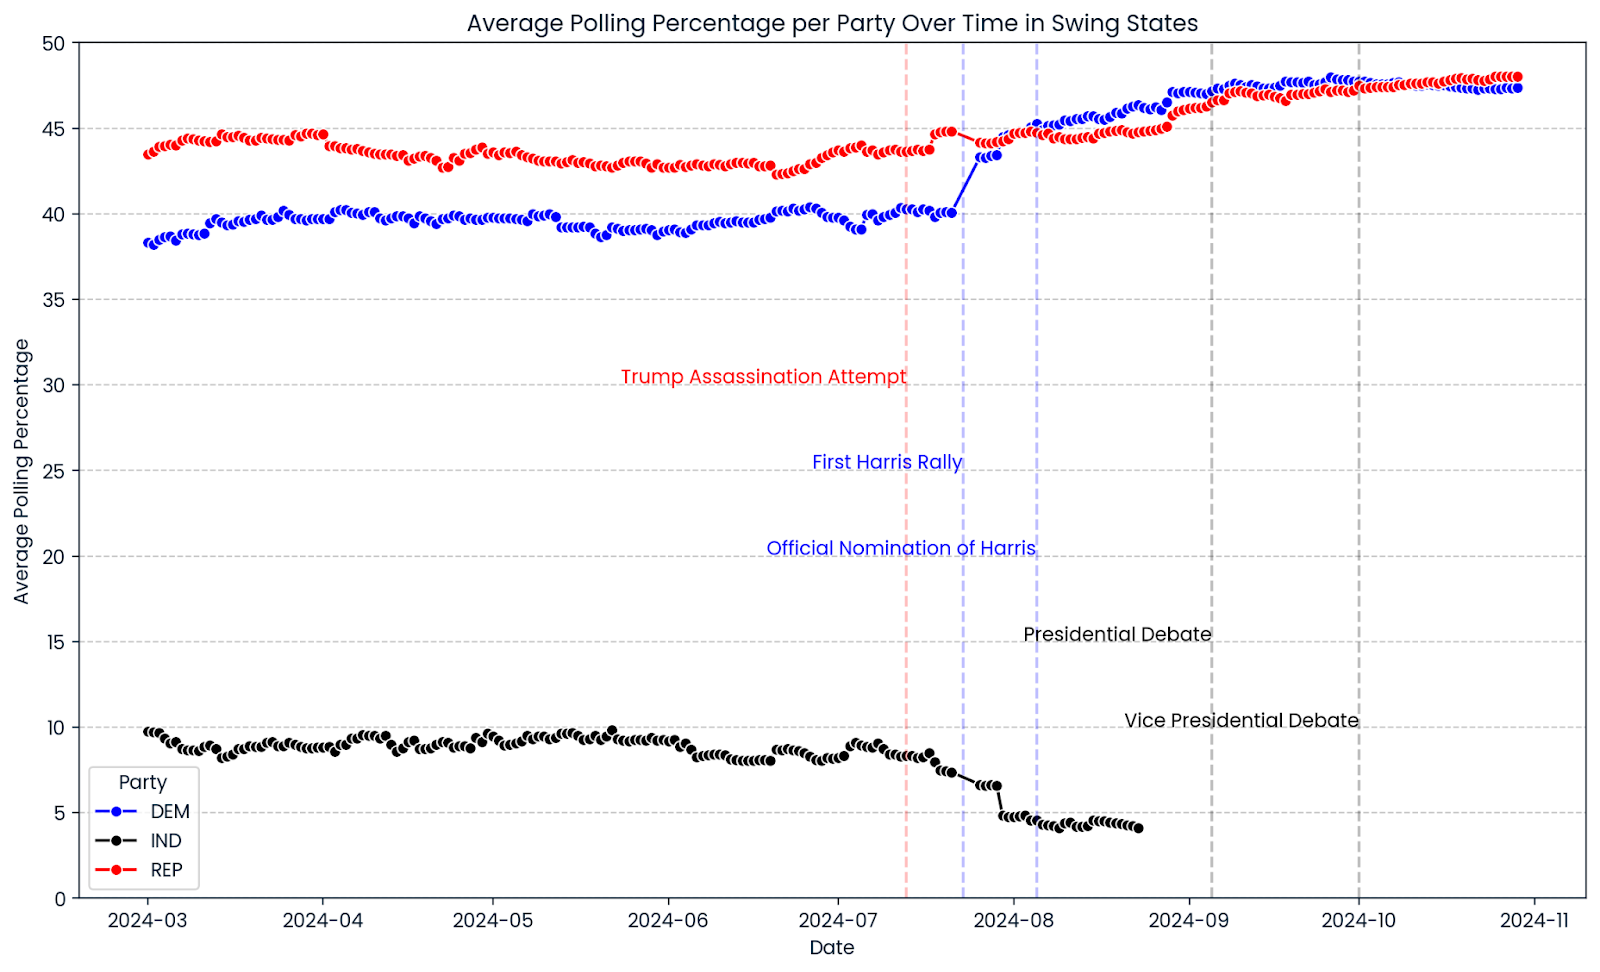
2024 की पोलिंग प्रगति की पहली झलक स्विंग राज्यों में बेहद मामूली अंतर दिखाती है। डोनाल्ड ट्रम्प की स्वीकृति दर पूरे अभियान में अपेक्षाकृत स्थिर रही, हाल में हल्की बढ़त के साथ। डेमोक्रेटिक पार्टी का प्रतिशत 5 अगस्त, 2024 को कमला हैरिस के आधिकारिक रूप से राष्ट्रपति पद की उम्मीदवार घोषित होने के बाद बना रहा, जो पूर्व उम्मीदवार और अमेरिका के राष्ट्रपति जो बाइडेन के पोल्स से काफी आगे निकल गया। किसी भी तरह, ग्राफ़ कई मुकाबलों को दर्शाते हैं जो नतीजा बताने के लिए बहुत ही करीबी हैं।
इस खंड में, हम अपने डेटा को साफ़ और मशीन लर्निंग मॉडलों के लिए तैयार करना सुनिश्चित करेंगे, खास ध्यान मिसिंग वैल्यूज़ को संभालने और प्रमुख वेरिएबल्स के वितरण को समझने पर होगा।
मॉडलों के प्रशिक्षण के लिए डेटा सही संरचना में है, यह सत्यापित करने के लिए कुछ बातें शेष हैं। सबसे पहले, हम जाँचते हैं कि क्या दोनों डेटासेट्स में किसी भी कॉलम में मिसिंग वैल्यूज़ हैं।
# Calculate the number of missing values in each column of swing_until_20
missing_values_until_20 = swing_until_20.isnull().sum()
missing_values_24 = swing_24.isnull().sum()

# Filter out columns that have no missing values
missing_values_until_20 = missing_values_until_20[missing_values_until_20 > 0]
missing_values_24 = missing_values_24[missing_values_24 > 0]

# Display the columns with at least 1 missing value and their respective counts for both dataframes
print(missing_values_until_20, missing_values_24)
momentum 84 dtype: int64
momentum 21 dtype: int64उम्मीदवार मोमेंटम ही एकमात्र कॉलम है जिसमें मिसिंग वैल्यूज़ हैं। यह तार्किक है क्योंकि यह प्रत्येक उम्मीदवार के लिए पोल वैल्यूज़ के दैनिक अंतर के रूप में निकाला जाता है, इसलिए उसकी पहली ऑब्जर्वेशन में मोमेंटम कॉलम न होने की उम्मीद है। हम इन मिसिंग वैल्यूज़ को सरलता से हटा सकते हैं।
# Dropping missing values
swing_24 = swing_24.dropna()
swing_until_20 = swing_until_20.dropna()संख्यात्मक कॉलम्स के वितरणों को देखना हमें यह समझ देता है कि कहीं कोई छिपे हुए आउट्लायर्स हैं या समग्र रूप से डेटा संभाव्य दिखता है या नहीं।
इसके अलावा, हम 2024 के चुनाव चक्र की पोलिंग की तुलना पूर्ववर्ती चक्रों के औसत से कर सकते हैं। हम pct_opponent और rolling_avg_7d जैसे कुछ फीचर्स को छोड़ सकते हैं क्योंकि वे मूलतः pct_estimate कॉलम से ही बनते हैं और लगभग वही वितरण दिखाएँगे।
# Getting description of distributions in both DataFrames
swing_until_20[['pct_estimate', 'lead', 'pct_3rd_party', 'momentum', 'vote_share']].describe()
print(swing_24[['pct_estimate', 'lead', 'pct_3rd_party','momentum']].describe())|
pct_estimate |
lead |
pct_3rd_party |
momentum |
vote_share |
|
|
count |
20504 |
20504 |
20504 |
20504 |
20504 |
|
mean |
44.73 |
0.00 |
1.25 |
0.00 |
48.85 |
|
min |
32.65 |
-18.01 |
0.00 |
-8.45 |
40.96 |
|
25% |
42.07 |
-4.94 |
0.00 |
-0.01 |
46.17 |
|
50% |
44.99 |
0.00 |
0.00 |
0.00 |
48.67 |
|
75% |
47.43 |
4.94 |
0.00 |
0.01 |
50.77 |
|
max |
56.47 |
18.01 |
12.67 |
8.45 |
57.97 |
|
std |
3.89 |
6.58 |
2.66 |
0.47 |
3.59 |
|
pct_estimate |
lead |
pct_3rd_party |
momentum |
|
|
count |
3228 |
3228 |
3228 |
3228 |
|
mean |
43.53 |
0.00 |
5.87 |
0.00 |
|
min |
35.39 |
-8.77 |
0.00 |
-6.28 |
|
25% |
41.06 |
-2.07 |
0.00 |
-0.12 |
|
50% |
43.76 |
0.00 |
8.01 |
0.00 |
|
75% |
46.56 |
2.07 |
8.91 |
0.12 |
|
max |
48.89 |
8.77 |
12.17 |
6.28 |
|
std |
3.22 |
3.63 |
4.05 |
0.45 |
दोनों swing_until_20 और swing_24 डेटासेट्स में फीचर्स के वितरण संभाव्य दिखते हैं और स्विंग राज्यों के पोलिंग डेटा के अनुरूप हैं।
pct_estimate के मान ऐतिहासिक रूप से लगभग 33% से 56% के बीच और 2024 में 35% से 49% के बीच हैं, जो प्रतिस्पर्धी चुनावों के लिए उचित है जहाँ कोई भी उम्मीदवार भारी बढ़त में नहीं होता। ऐतिहासिक डेटासेट में vote_share का औसत 48.85% है, जो संभाव्य है क्योंकि स्विंग राज्यों में अक्सर 50-50 के आसपास विभाजन होता है।
जैसा कि अपेक्षित है, lead और momentum वेरिएबल्स दोनों डेटासेट्स में औसत 0 के आसपास केंद्रित हैं, जो दर्शाता है कि समय के साथ बढ़त, पिछड़ना, लाभ और हानि एक-दूसरे को संतुलित करते हैं। lead वेरिएबल लगभग पूर्णतः सामान्य वितरण का अनुसरण करता दिखता है, जबकि momentum कम से कम सममित है और अधिकतर मान औसत के पास हैं।
ऐतिहासिक pct_estimate एक हल्के बाएँ झुकाव के साथ काफ़ी सामान्य वितरण का अनुसरण करता है, क्योंकि औसत कम से कम माध्यिका के बहुत करीब है, और फैलाव एक यथोचित सीमा के भीतर सामान्य मानों को समेटता है।
2024 के डेटा में, पोल प्रतिशत औसत के अधिक क़रीब केंद्रित हैं। lead वेरिएबल का मानक विचलन 2024 में (3.63) ऐतिहासिक डेटा (6.58) से कम है, और इसके मूल्यों की रेंज भी ऐतिहासिक के आधे से भी कम है। ये सभी संकेत हैं कि 2024 में उम्मीदवारों के बीच मार्जिन और भी क़रीबी हैं, यानी मुकाबले और भी टाइट हैं।
अधिकांश चक्रों में, कोई थर्ड-पार्टी उम्मीदवार सार्थक समर्थन नहीं जुटा पाया, जैसा कि इस तथ्य से दिखता है कि 75% से अधिक ऑब्जर्वेशन्स में pct_3rd_party का मान 0 है, औसत 1.25% के साथ। 2024 में उच्च संख्या (माध्यिका 8.01%) दर्शाती है कि अगस्त 2024 में अपने अभियान के अंत तक स्वतंत्र उम्मीदवार रॉबर्ट एफ. केनेडी को मज़बूत समर्थन मिला।
हमारी भविष्यवाणी रणनीति इस तथ्य का ध्यान रखेगी कि पोल अंतिम चुनाव परिणाम नहीं होते, बल्कि विशिष्ट क्षणों पर जनसेंटिमेंट के संकेतक होते हैं। इसलिए, हम सरल टाइम-सीरीज़ भविष्यवाणियों पर निर्भर रहने से बचेंगे जो पोलिंग डेटा को सीधे परिणामों के पूर्वानुमान की तरह मानती हैं। इसके बजाय, हम एक रिग्रेशन-आधारित दृष्टिकोण अपनाएँगे जो प्रत्येक पोलिंग ऑब्जर्वेशन के लिए अलग से चुनाव परिणाम की भविष्यवाणी करेगा, न कि पोल डेटा की समय-रेखा का पूर्वानुमान।
यह मानते हुए कि हर राज्य का अपना अलग राजनीतिक परिदृश्य है, हम प्रत्येक स्विंग राज्य के लिए अलग मॉडल बनाएँगे। डेटा लीकेज से बचने और समय के प्रवाह का सम्मान करने के लिए, हम सुनिश्चित करेंगे कि हमारे मॉडल केवल अनदेखे डेटा पर—विशेष रूप से उन चुनाव चक्रों पर—परीक्षित हों जो उन चक्रों के बाद आते हैं जिन पर मॉडल प्रशिक्षित किए गए थे। यह दृष्टिकोण हमें मॉडलों की भविष्य के चुनावों पर सामान्यीकरण करने की क्षमता का सटीक मूल्यांकन करने में मदद करेगा।
मैंने चुनावी वोट शेयर की भविष्यवाणी करने वाले मॉडलों का मूल्यांकन करते समय दो मानदंड चुने। चूँकि प्रत्येक राज्य में विजेता “सब कुछ ले जाता है”, परीक्षण चक्रों में सही तरीके से भविष्यवाणी किए गए विजेताओं की संख्या सबसे महत्वपूर्ण माप है।
मीन एब्सोल्यूट एरर (MAE) द्वितीयक मूल्यांकन मानदंड है। यह भविष्यवाणी किए गए और वास्तविक मूल्यों के बीच त्रुटियों की औसत परिमाण को लक्ष्य वेरिएबल की समान इकाइयों में मापता है—इस मामले में वोट शेयर के प्रतिशत अंक। यह इसे अत्यंत व्याख्यायोग्य और हमारे संदर्भ के सीधे प्रासंगिक बनाता है, क्योंकि यह बताता है कि औसतन हमारी भविष्यवाणियाँ वास्तविक परिणामों से कितने प्रतिशत अंक भिन्न हैं।
अंततः, हम प्रत्येक राज्य के सर्वश्रेष्ठ मॉडल को 2020 तक के सभी चुनाव चक्रों पर प्रशिक्षित करेंगे और 2024 के परिणामों का पूर्वानुमान लगाने के लिए लागू करेंगे। हम समय-आधारित वेटिंग के लिए एक एक्सपोनेंशियल डिके फ़ंक्शन का उपयोग करेंगे ताकि व्यक्तिगत भविष्यवाणियों को एक ही प्रेडिक्टिव मान में रूपांतरित किया जा सके, हाल की पोल्स को अधिक महत्व देते हुए।
सबसे पहले, हम वे पैकेज आयात करते हैं जिनकी हमें बाद में आवश्यकता होगी। इसमें वे सभी मॉडल शामिल हैं जिनका हम मूल्यांकन करेंगे, NumPy, और mean_absolute_error भी।
# Importing models
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression, Ridge, ElasticNet
from sklearn.neighbors import KNeighborsRegressor
from sklearn.neural_network import MLPRegressor
from sklearn.svm import SVR
import catboost
import xgboost as xgb

# Importing other necessary libraries
from sklearn.metrics import mean_absolute_error
import numpy as npआइए बेस मॉडलों को प्रशिक्षित और मूल्यांकन करने के लिए एक वर्कफ़्लो बनाएँ! हम प्रक्रिया को चरण-दर-चरण देखते हैं और फिर 2004 से शुरू करते हुए प्रत्येक परीक्षण चक्र के लिए प्रत्येक राज्य पर लागू करते हैं।
हम अपने मॉडलों को प्रत्येक राज्य की विशिष्टताओं के अनुसार ढालने के लिए, सबसे पहले उस राज्य से संबंधित डेटा को फ़िल्टर करते हैं जिसका विश्लेषण किया जा रहा है। यह सुनिश्चित करता है कि मॉडल राज्य-विशिष्ट वोटिंग पैटर्न और पोलिंग डेटा को कैप्चर करे।
# Filter data for the state you're analyzing
data_state = swing_until_20[swing_until_20['state'] == state].copy()
फिर हम वेट फ़ंक्शन परिभाषित करते हैं ताकि चुनाव तिथि के करीब किए गए पोल्स को अधिक महत्व मिल सके। यह एक्सपोनेंशियल डिके फ़ंक्शन चुनाव से जितना दूर पोल होगा, उसका वेट उतना ही कम करेगा, हालिया पोलिंग डेटा की प्रासंगिकता पर जोर देते हुए।
# Define the weight function (using a typical starting k value)
def compute_weight(days_until_election, k):
	return np.exp(-k * days_until_election)

# Add weights to the data
data_state['weight'] = compute_weight(data_state['days_until_election'], k=0.1)
अगला, हम चुनाव चक्रों के आधार पर डेटा को प्रशिक्षण और परीक्षण सेट में बाँटते हैं, यह सुनिश्चित करते हुए कि हम पिछले चुनावों पर प्रशिक्षण लें और भविष्य के चुनावों पर परीक्षण, ताकि डेटा लीकेज से बचा जा सके। train_cycles और test_cycle की परिभाषा पर हम बाद में आएँगे जब हम चुनाव चक्रों के माध्यम से लूप करेंगे। हम भविष्यवाणी के लिए उपयोग की जाने वाली विशेषताओं को भी परिभाषित करते हैं और लक्ष्य वेरिएबल निकालते हैं, जो वास्तविक वोट शेयर है।
# Split data into training and testing sets based on election cycles
train_data = data_state[data_state['cycle'].isin(train_cycles)]
test_data = data_state[data_state['cycle'] == test_cycle]

# Define features and target variable
features = ['pct_estimate', 'pct_opponent', 'pct_3rd_party', 'lead', 'rolling_avg_7d',
                    'days_until_election', 'momentum_candidate', 'momentum_opponent', 'momentum',
                    'is_incumbent_president', 'is_incumbent_vice_president', 'is_incumbent_party',
                    'candidate_Donald Trump',
                    'party_DEM', 'party_REP']
X_train = train_data[features]
y_train = train_data['vote_share']
X_test = test_data[features]
y_test = test_data['vote_share']
हम मूल्यांकन के लिए विभिन्न मशीन लर्निंग मॉडल परिभाषित करते हैं, जिनमें लीनियर रिग्रेशन, एंसेंबल मेथड्स, सपोर्ट वेक्टर मशीन और न्यूरल नेटवर्क शामिल हैं। यह विविध सेट हमें अलग-अलग एल्गोरिद्म्स की तुलना करने और प्रत्येक राज्य के लिए सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडल का चयन करने देता है।
# Models to evaluate
models = {
    'LinearRegression': LinearRegression(),
    'XGBoost': xgb.XGBRegressor(objective='reg:absoluteerror', n_estimators=100, random_state=42),
    'CatBoost': catboost.CatBoostRegressor(loss_function='MAE', iterations=100, random_seed=42, verbose=0),
    'RandomForest': RandomForestRegressor(n_estimators=100, random_state=42),
    'SVR': SVR(kernel='rbf', C=1.0, epsilon=0.1),
    'KNeighbors': KNeighborsRegressor(n_neighbors=5),
    'MLPRegressor': MLPRegressor(hidden_layer_sizes=(100,), max_iter=500, random_state=42),
    'ElasticNet': ElasticNet(alpha=1.0, l1_ratio=0.5, random_state=42),
}
इसके बाद, हम models डिक्शनरी के माध्यम से लूप करेंगे। प्रत्येक मॉडल के लिए, हम उसे वर्तमान राज्य-विशिष्ट प्रशिक्षण डेटासेट से प्रशिक्षित करते हैं और फिर परीक्षण डेटासेट पर भविष्यवाणी करते हैं। यह प्रक्रिया प्रत्येक मॉडल के लिए दोहराई जाती है ताकि उनके प्रदर्शन का तुलनात्मक आकलन किया जा सके।
for model_name, model in models.items():
    # Train the model
    model.fit(X_train, y_train)
    # Predict on test data
    test_data[f'predicted_{model_name}'] = model.predict(X_test)
मॉडल लूप के भीतर, हम पहले से निकाले गए वेट्स का उपयोग करते हुए एक lambda फ़ंक्शन के साथ प्रत्येक पार्टी के लिए व्यक्तिगत भविष्यवाणियों को एग्रीगेट करते हैं। इससे प्रति पार्टी एकल अनुमानित वोट शेयर प्राप्त होता है, जिसे हम वास्तविक वोट शेयर से तुलना करके मॉडल की सटीकता का आकलन करते हैं।
# Aggregate predictions using weights
    aggregated_predictions = test_data.groupby('party').apply(
        lambda df: np.average(df[f'predicted_{model_name}'], weights=df['weight'])
    ).reset_index(name='aggregated_prediction')

# Get actual vote shares for comparison
    actual_vote_shares = test_data.groupby('party')['vote_share'].mean().reset_index()
    comparison = pd.merge(aggregated_predictions, actual_vote_shares, on='party')
    comparison.rename(columns={'vote_share': 'actual_vote_share'}, inplace=True)
मॉडल लूप को समाप्त करने के लिए, हम एग्रीगेटेड भविष्यवाणियों और वास्तविक वोट शेयरों के बीच मीन एब्सोल्यूट एरर (MAE) की गणना करते हैं ताकि मॉडल के प्रदर्शन को मापा जा सके। हम यह भी निर्धारित करते हैं कि क्या मॉडल ने राज्य में विजेता पार्टी की सही भविष्यवाणी की, और इन परिणामों को बाद के विश्लेषण के लिए सहेजते हैं।
# Calculate Mean Absolute Error
mae = mean_absolute_error(comparison['actual_vote_share'], comparison['aggregated_prediction'])

# Check if the predicted winner matches the actual winner
predicted_winner = comparison.loc[comparison['aggregated_prediction'].idxmax(), 'party']
actual_winner = comparison.loc[comparison['actual_vote_share'].idxmax(), 'party']
correct_winner = int(predicted_winner == actual_winner)

# Store the results
results_list.append({
    'state': state,
    'model_name': model_name,
    'test_cycle': test_cycle,
    'MAE': mae,
    'correct_winner': correct_winner
})
पूरी प्रक्रिया दो लूप्स में लिपटी है: बाहरी लूप प्रत्येक चुनाव चक्र पर (पहले को छोड़कर, क्योंकि उस पर प्रशिक्षित करने के लिए कोई पूर्व डेटा नहीं है) और आंतरिक लूप प्रत्येक स्विंग राज्य पर इटरेट करता है। इस तरह, हम सुनिश्चित करते हैं कि मॉडल प्रत्येक राज्य और चुनाव चक्र के लिए उचित तरीके से प्रशिक्षित और परीक्षण किए जाएँ, और डेटा लीकेज से बचने के लिए चुनावों के कालानुक्रमिक क्रम का सम्मान किया जाए।
ऊपर दिए गए कोड की प्रस्तावना कुछ इस तरह दिखती है:
# Initialize a list to store results
results_list = []

# Define the election cycles
cycles = [2000, 2004, 2008, 2012, 2016, 2020]
for i in range(1, len(cycles)):  # The loop starts at index 1, so with the 2nd cycle (2004)
    test_cycle = cycles[i]
    train_cycles = cycles[:i]  # train_cycles = all cycles before the test_cycle
    for state in swing_states:
        # Filter data for the state you're analyzing, etc. …
समग्र रूप से, यह रणनीति हमें विभिन्न राज्यों और चुनाव चक्रों में कई मॉडलों का मूल्यांकन करने देती है, और अंततः भविष्यवाणी की शुद्धता और विजेता की सही भविष्यवाणी करने की क्षमता के आधार पर प्रत्येक राज्य के लिए सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडल का चयन करने देती है।
विभिन्न राज्यों और चुनाव चक्रों में कई मशीन लर्निंग मॉडलों को प्रशिक्षित और परीक्षण करने के बाद, हम उनके प्रदर्शन का मूल्यांकन करते हैं ताकि प्रत्येक राज्य के लिए सर्वश्रेष्ठ मॉडल की पहचान हो सके। यह मूल्यांकन दो प्रमुख मेट्रिक्स पर केंद्रित है: प्रत्येक मॉडल ने कितनी बार विजेता पार्टी की सही भविष्यवाणी की (correct_winner) और उनकी भविष्यवाणियों का औसत मीन एब्सोल्यूट एरर (MAE)।
सबसे पहले, हम मॉडल मूल्यांकन के दौरान एकत्र किए गए सभी परिणामों को एक ही DataFrame में संकलित करते हैं और प्रदर्शन मेट्रिक्स को एग्रीगेट करते हैं:
# After the loop, create a DataFrame from the results list
results_df = pd.DataFrame(results_list)

# Get the sum of correct_winner and the average MAE for every combination of state and model_name
aggregated_evaluation = results_df.groupby(['state', 'model_name']).agg({
    'correct_winner': 'sum',
    'MAE': 'mean'
}).reset_index()

# Display the maximum number of correct winner predictions and the minimum MAE for each state
print(aggregated_evaluation.groupby('state')['correct_winner'].max())
print(aggregated_evaluation.groupby('state')['MAE'].min())|
state |
Maximum correct_winner |
Minimum MAE |
|
Arizona |
5 |
1.248966 |
|
Georgia |
5 |
0.770760 |
|
Michigan |
4 |
2.685870 |
|
Nevada |
5 |
2.079582 |
|
North Carolina |
5 |
0.917522 |
|
Pennsylvania |
4 |
2.027426 |
|
Wisconsin |
4 |
2.462907 |
यह बुरा नहीं दिखता! सभी राज्यों में कम से कम एक मॉडल ने पाँच में से चार पिछले चुनावों की सही भविष्यवाणी की। चार राज्यों (Arizona, Georgia, Nevada, और North Carolina) में तो हमें ऐसे मॉडल मिले जो हर चक्र में सही विजेता की भविष्यवाणी करते हैं। न्यूनतम MAE के परिणामों में कुछ सुधार की गुंजाइश है, और वे राज्यों के बीच काफी अलग हैं—औसतन 1.74 प्रतिशत अंक, Georgia में 0.77 से लेकर Michigan में 2.69 तक की रेंज के साथ।
इस एग्रीगेटेड जानकारी के साथ, हम प्रत्येक राज्य के लिए सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडल का चयन करते हैं। हम मॉडलों को पहले सही विजेता भविष्यवाणी की संख्या के आधार पर छाँटते हैं और उसके बाद ही उनके MAE पर। चुने गए मॉडलों को best_models डिक्शनरी में सहेजा जाता है।
# Sort the models for each state by correct_winner (descending) and then by MAE (ascending)
sorted_evaluation = aggregated_evaluation.sort_values(by=['state', 'correct_winner', 'MAE'], ascending=[True, False, True])

# Create a dictionary to store the best model for each state
best_models = {}

# Iterate over each state and get the top model
for state in sorted_evaluation['state'].unique():
    top_model = sorted_evaluation[sorted_evaluation['state'] == state].iloc[0]
    best_models[state] = top_model['model_name']
best_models
{'Arizona': 'RandomForest',
'Georgia': 'ElasticNet',
'Michigan': 'LinearRegression',
'Nevada': 'KNeighbors',
'North Carolina': 'CatBoost',
'Pennsylvania': 'KNeighbors',
'Wisconsin': 'MLPRegressor'}प्रत्येक राज्य के लिए शीर्ष मॉडल काफ़ी भिन्न हैं, जो प्रत्येक क्षेत्र में अद्वितीय वोटिंग पैटर्न और पोलिंग व्यवहारों को दर्शाते हैं। आश्चर्यजनक रूप से, Michigan में सर्वोत्तम परिणाम लिनियर रिग्रेशन से ही मिलते हैं, जो दर्शाता है कि वहाँ सरल रैखिक दृष्टिकोण काफ़ी हो सकता है।
इस बिंदु पर, हम हाइपरपैरामीटर ट्यूनिंग का उपयोग करके प्रत्येक मशीन लर्निंग मॉडल के प्रदर्शन को अनुकूलित कर सकते थे। चूँकि इससे और विधिवत प्रश्न उठेंगे और कोड में बड़े समायोजन करने होंगे, यह पहले से ही लम्बे इस ट्यूटोरियल के दायरे से बाहर है। बेस मॉडलों के परिणाम काफ़ी आशाजनक दिखते हैं, इसलिए 2024 के चुनाव परिणामों की भविष्यवाणी करने की हिम्मत की जा सकती है।
अपने विश्लेषण के अंतिम चरण में, हम प्रत्येक स्विंग राज्य के लिए सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडलों का उपयोग करके 2024 के चुनाव परिणामों की भविष्यवाणी करते हैं। हम अपनी भविष्यवाणियों को सहेजने के लिए एक खाली सूची से शुरू करते हैं।
प्रत्येक राज्य और उसके संबंधित सर्वश्रेष्ठ मॉडल के लिए, हम पहले जैसा ही वर्कफ़्लो उपयोग करते हैं। फर्क सिर्फ इतना कि इस बार हमें चुनाव चक्रों के माध्यम से लूप करने की ज़रूरत नहीं—हम 2000 से 2020 तक के सभी ऐतिहासिक डेटा (swing_until_20) पर प्रशिक्षण लेते हैं।
# Initialize a list to store predictions
predictions_list = []
for state, model_name in best_models.items():
    # Filter the data for the specific state
    state_data_train = swing_until_20[swing_until_20['state'] == state].copy()  # Data from 2000 to 2020
    state_data_test = swing_24[swing_24['state'] == state].copy()  # Data for 2024

    # Add weights to the test data
    state_data_test['weight'] = compute_weight(state_data_test['days_until_election'], k=0.1)

    # Define features
    features = [
        'pct_estimate',
        'pct_opponent',
        'pct_3rd_party',
        'lead',
        'rolling_avg_7d',
        'days_until_election',
        'momentum_candidate',
        'momentum_opponent',
        'momentum',
        'is_incumbent_president',
        'is_incumbent_vice_president',
        'is_incumbent_party',
        'candidate_Donald Trump',
        'party_DEM',
        'party_REP'
    ]

    # Split features and target variable
    X_train = state_data_train[features]
    y_train = state_data_train['vote_share']
    X_test = state_data_test[features]

    # Train the model on the 2000 to 2020 data
    model.fit(X_train, y_train)

    # Predict on the 2024 data
    state_data_test['predicted_vote_share'] = model.predict(X_test)

    # Aggregate predictions using weights
    aggregated_predictions = state_data_test.groupby('party').apply(
        lambda df: np.average(df['predicted_vote_share'], weights=df['weight'])
    ).reset_index(name='aggregated_prediction')

    # Append predictions to the list
    for _, pred_row in aggregated_predictions.iterrows():
        predictions_list.append({
            'state': state,
            'party': pred_row['party'],
            'predicted_vote_share': pred_row['aggregated_prediction'],
            'model': model_name
        })
vote_share कॉलम की भविष्यवाणी करने, पहले परिभाषित वेट फ़ंक्शन का उपयोग करके भविष्यवाणियों को एग्रीगेट करने, और predictions_list में जोड़ने के बाद, हम अंतिम भविष्यवाणियों को एक DataFrame में समेकित करते हैं। इसके अतिरिक्त, हम प्रत्येक राज्य के लिए रैंकिंग जोड़ते हैं और भविष्यवाणियों को राज्य के अनुसार पिवट करते हैं। हमारे मॉडलों द्वारा की गई भविष्यवाणियाँ इस प्रकार हैं:
# Convert predictions list to DataFrame
predictions_df = pd.DataFrame(predictions_list)

# Add a rank to predictions_df for each state based on the order of predicted_vote_share
predictions_df['rank'] = predictions_df.groupby('state')['predicted_vote_share'].rank(ascending=False)

# Create a pivot table indexed by state
predictions_pivot = predictions_df.pivot(index='state', columns='party', values='predicted_vote_share')

# Display predictions
print("\n2024 Vote Share Predictions:")
predictions_pivot
2024 Vote Share Predictions:
state
DEM
REP
Arizona
49.02
50.31
Georgia
48.95
50.08
Michigan
50.34
48.64
Nevada
49.41
48.54
North Carolina
48.95
50.06
Pennsylvania
49.57
49.20
Wisconsin
49.66
49.41भविष्यवाणियाँ हमारी अत्यंत करीबी मुकाबले की आशंका की पुष्टि करती हैं। हमारे मॉडल चार राज्यों में कमला हैरिस (Michigan, Nevada, Pennsylvania, Wisconsin) और तीन में डोनाल्ड ट्रम्प (Arizona, Georgia, North Carolina) के लिए बहुमत वोट का अनुमान लगाते हैं। Pennsylvania और Wisconsin खासतौर पर बेहद क़रीबी रहने की उम्मीद है, जहाँ दोनों अनुमानित वोट शेयरों के बीच अंतर क्रमशः केवल 0.37 और 0.25 प्रतिशत अंक है।
जैसा कि पहले कहा गया, हम मानते हैं कि अन्य सभी राज्य अपेक्षित विजेता के लिए वोट देंगे, यानी “ब्लू” राज्य कमला हैरिस और “रेड” राज्य डोनाल्ड ट्रम्प को वोट देंगे। यह आकलन करने के लिए कि प्रत्येक उम्मीदवार को कितने इलेक्टोरल वोट मिलते हैं, हम एक डिक्शनरी परिभाषित करते हैं जो प्रत्येक राज्य और डिस्ट्रिक्ट को उनके वोटों की संख्या आवंटित करती है और इसे electoral_votes_df नामक DataFrame में संयोजित करते हैं।
# Define the number of electoral votes per state for the 2024 US-Presidential elections
electoral_votes = {
    'Alabama': 9, 'Alaska': 3, 'Arizona': 11, 'Arkansas': 6, 'California': 54,
    'Colorado': 10, 'Connecticut': 7, 'Delaware': 3, 'District of Columbia': 3,
    'Florida': 30, 'Georgia': 16, 'Hawaii': 4, 'Idaho': 4, 'Illinois': 19,
    'Indiana': 11, 'Iowa': 6, 'Kansas': 6, 'Kentucky': 8, 'Louisiana': 8,
    'Maine': 2, 'Maryland': 10, 'Massachusetts': 11, 'Michigan': 15,
    'Minnesota': 10, 'Mississippi': 6, 'Missouri': 10, 'Montana': 4,
    'Nebraska': 2, 'Nevada': 6, 'New Hampshire': 4, 'New Jersey': 14,
    'New Mexico': 5, 'New York': 28, 'North Carolina': 16, 'North Dakota': 3,
    'Ohio': 17, 'Oklahoma': 7, 'Oregon': 8, 'Pennsylvania': 19,
    'Rhode Island': 4, 'South Carolina': 9, 'South Dakota': 3,
    'Tennessee': 11, 'Texas': 40, 'Utah': 6, 'Vermont': 3, 'Virginia': 13,
    'Washington': 12, 'West Virginia': 4, 'Wisconsin': 10, 'Wyoming': 3
}

# Create a DataFrame from the dictionary
electoral_votes_df = pd.DataFrame(list(electoral_votes.items()), columns=['State', 'Electoral Votes'])

# Handle states that divide their votes into multiple districts (Maine and Nebraska)
districts = {'ME-1': 1, 'ME-2': 1, 'NE-1': 1, 'NE-2': 1, 'NE-3': 1}

# Add the districts to the DataFrame
districts_df = pd.DataFrame(list(districts.items()), columns=['State', 'Electoral Votes'])

# Combine the two DataFrames
electoral_votes_df = pd.concat([electoral_votes_df, districts_df], ignore_index=True)
इसके बाद, हम दो सूचियाँ बनाते हैं, harris और trump, जिनमें क्रमशः ब्लू और रेड राज्य, और साथ ही प्रत्येक उम्मीदवार द्वारा जीते जाने की भविष्यवाणी किए गए स्विंग राज्य शामिल होते हैं। अगले चरण में, हम electoral_votes_df को प्रत्येक सूची के राज्यों के लिए फ़िल्टर कर सकते हैं और प्रत्येक उम्मीदवार के लिए अपेक्षित इलेक्टोरल वोटों का योग निकाल सकते हैं।
# Extract states from predictions_df where party is DEM and rank is 1
additional_blue_states = predictions_df[
    (predictions_df['party'] == 'DEM') & (predictions_df['rank'] == 1)
].state.tolist()

# Extract states from predictions_df where party is REP and rank is 1
additional_red_states = predictions_df[
    (predictions_df['party'] == 'REP') & (predictions_df['rank'] == 1)
].state.tolist()

# Combine blue_states and additional_blue_states into a single list
harris = list(set(blue_states + additional_blue_states))
trump = list(set(red_states + additional_red_states))

# Filter the electoral votes for states in each candidate's list
harris_electoral_votes = electoral_votes_df[electoral_votes_df['state'].isin(harris)]
trump_electoral_votes = electoral_votes_df[electoral_votes_df['state'].isin(trump)]

# Sum the electoral votes
sum_harris_electoral_votes = harris_electoral_votes['electoral_votes'].sum()
sum_trump_electoral_votes = trump_electoral_votes['electoral_votes'].sum()
print(
    f'According to the predictions made by the machine learning models, '
    f'Kamala Harris will win {sum_harris_electoral_votes} electoral votes '
    f'and Donald Trump will win {sum_trump_electoral_votes} electoral votes.'
)
According to the predictions made by the machine learning models, Kamala Harris will win 276 electoral votes and Donald Trump will win 262 electoral votes.भविष्यवाणी यह है कि कमला हैरिस 276 इलेक्टोरल वोट जीतेंगी और डोनाल्ड ट्रम्प 262 इलेक्टोरल वोट जीतेंगे। यदि हमारी धारणाएँ और भविष्यवाणियाँ सही रहीं, तो 5 नवंबर को इलेक्टोरल मैप कुछ इस तरह दिखेगा:
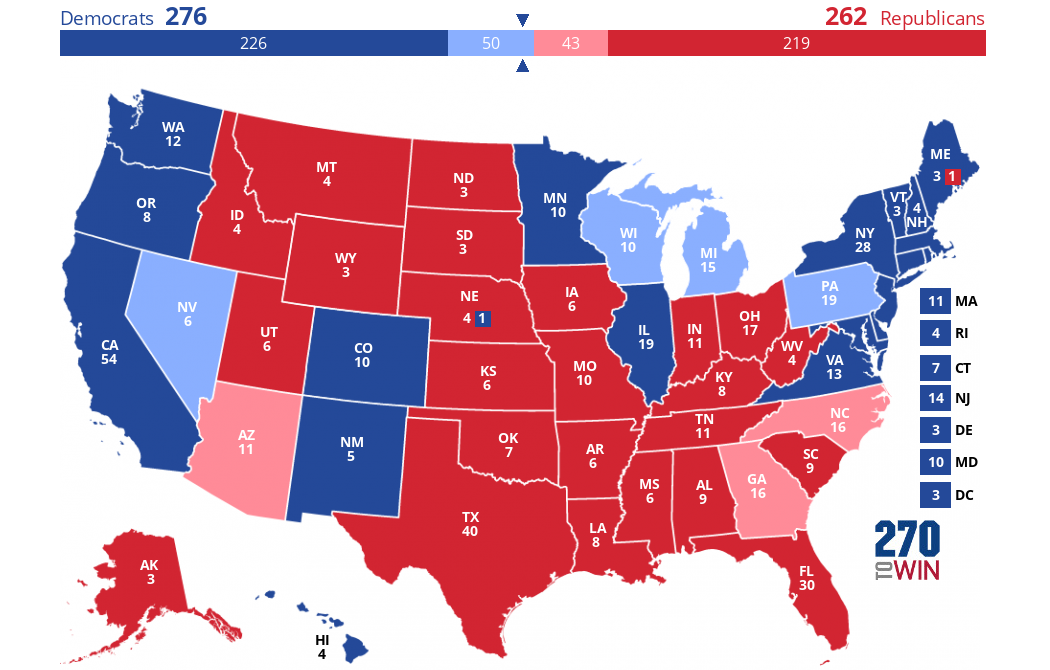
यह इंटरएक्टिव मैप क्रिएटर का उपयोग करके बनाया गया।
गहरे रंग वे राज्य दर्शाते हैं जिन्हें हमने “ब्लू” या “रेड” माना। हमारे द्वारा भविष्यवाणी किए गए स्विंग राज्य फर्क पैदा करते हैं—वे हल्के नीले या लाल रंग में दिखते हैं।
इस प्रोजेक्ट में, हमने 2024 के अमेरिकी राष्ट्रपति चुनाव के परिणामों की भविष्यवाणी करने के लिए ऐतिहासिक पोलिंग डेटा का उपयोग किया। अपेक्षा के अनुसार, हमारे मॉडल अग्रणी उम्मीदवारों के बीच करीबी मुकाबले का संकेत देते हैं।
यह ध्यान में रखना महत्वपूर्ण है कि हमारा विश्लेषण केवल पोलिंग डेटा पर आधारित था, जो अतीत में कभी-कभी गलत रहा है और चुनाव की सभी बारीकियाँ कैप्चर नहीं करता। पोलिंग कार्यप्रणालियाँ, मतदाता उपस्थिति, अभियान की गतिशीलता, आर्थिक और जनसांख्यिकीय परिस्थितियाँ, और अप्रत्याशित घटनाएँ—इन सभी कारकों पर हमारे मॉडलों में विचार नहीं किया गया, जबकि वे वास्तविक परिणामों पर महत्वपूर्ण प्रभाव डाल सकते हैं।
फिर भी, यह अन्वेषण चुनाव जैसे जटिल तंत्रों को समझने में प्रेडिक्टिव एनालिटिक्स की क्षमता दर्शाता है। यदि आप Python का उपयोग करके प्रेडिक्टिव एनालिटिक्स के बारे में अधिक सीखने में रुचि रखते हैं, तो मैं ये संसाधन सुझाता हूँ:
इन पाठ्यक्रमों के साथ मशीन लर्निंग सीखें!
लर्निंग पाथ
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें