
Programma
Apprendimento automatico supervisionato in Python
25 ore
I dati usati per la nostra previsione provengono da FiveThirtyEight, che raccoglie dati di sondaggi da vari istituti. I dati sono disponibili sul loro GitHub per tutti i cicli elettorali dal 1968.
Useremo il loro modello dei sondaggi, che assegna la percentuale media di sondaggi per ciascun candidato in ogni stato per (quasi) ogni data negli otto mesi precedenti le elezioni.
Iniziamo importando i dati dei sondaggi 2024, 2020 e storici da file CSV. I dati 2024 sono filtrati sui sondaggi dell’attuale ciclo, e i dati storici fino al 2016 sono concatenati con quelli del 2020. Nei due DataFrame risultanti, polls_24 e polls_until_20, le colonne data sono convertite in formato datetime per garantire coerenza e si mantengono le colonne rilevanti come ciclo, stato, nome del candidato e stime di sondaggio.
import pandas as pd

# Reading CSV files
polls_24 = pd.read_csv('presidential_general_averages.csv')
polls_20 = pd.read_csv('presidential_poll_averages_2020.csv')
polls_until_16 = pd.read_csv('pres_pollaverages_1968-2016.csv')

# Filtering and concatenating DataFrames
polls_24 = polls_24[polls_24['cycle'] == 2024]
polls_until_20 = pd.concat([polls_20, polls_until_16], ignore_index=True)

# Making sure dates are in datetime format
polls_24['date'] = pd.to_datetime(polls_24['date'], format='%Y-%m-%d')
polls_until_20['modeldate'] = pd.to_datetime(polls_until_20['modeldate'])

# Keeping only the columns of interest
polls_until_20 = polls_until_20[['cycle', 'state', 'modeldate', 'candidate_name', 'pct_estimate', 'pct_trend_adjusted']]
Per i risultati reali di voto per stato, ho preso i dati direttamente dalla Federal Election Commission degli USA. Per semplicità, li ho riassunti in un unico file CSV in precedenza.
Una osservazione rappresenta la combinazione di ciclo elettorale, stato e partito, completata dal nome del rispettivo candidato e, ovviamente, dalla percentuale di voti ottenuta.
# Importing result data
results_until_20 = pd.read_csv('results.csv', sep=';')
results_until_20 = results_until_20[['cycle', 'state', 'party', 'candidate', 'vote_share']]
Per garantire che lavoriamo con dati rilevanti e di qualità, ho applicato due restrizioni chiave:
swing_states, blue_states e red_states di conseguenza e creiamo i sottoinsiemi di dati per gli swing state.# Implementing cycle restriction
start_cycle = 2000
polls_until_20 = polls_until_20[polls_until_20['cycle'] >= start_cycle]
# Defining state lists
swing_states = [
'Pennsylvania', 'Wisconsin', 'Michigan', 'Georgia',
'North Carolina', 'Arizona', 'Nevada'
]
blue_states = [
'District of Columbia', 'Vermont', 'Massachusetts', 'Maryland',
'Hawaii', 'California', 'ME-1', 'Connecticut', 'Washington',
'Delaware', 'Rhode Island', 'New York', 'Illinois', 'New Jersey',
'Oregon', 'Colorado', 'Maine', 'New Mexico', 'Virginia',
'New Hampshire', 'NE-2', 'Minnesota'
]
red_states = [
'Wyoming', 'West Virginia', 'Oklahoma', 'North Dakota',
'Idaho', 'South Dakota', 'Arkansas', 'Kentucky', 'NE-3',
'Alabama', 'Tennessee', 'Utah', 'Louisiana', 'Nebraska',
'Mississippi', 'Montana', 'NE-1', 'Indiana', 'Kansas',
'Missouri', 'South Carolina', 'Alaska', 'Ohio', 'Iowa',
'Texas', 'ME-2', 'Florida'
]
# Defining swing state subset of the poll data
swing_until_20 = polls_until_20[polls_until_20['state'].isin(swing_states)]
swing_24 = polls_24[polls_24['state'].isin(swing_states)]Per farci un’idea dei dati, eseguiamo un po’ di exploratory data analysis (EDA). Per prima cosa, usiamo una combinazione dei metodi .isnull() e .sum() per vedere quali colonne contiene ciascun DataFrame e dove potrebbero mancare dati.
# Checking for missing values in swing_24 and swing_until_20
print(swing_24.isnull().sum())
print(swing_until_20.isnull().sum())
candidate 0
date 0
pct_trend_adjusted 4394
state 0
cycle 0
party 0
pct_estimate 0
hi 0
lo 0
dtype: int64
cycle 0
state 0
modeldate 0
candidate_name 0
pct_estimate 0
pct_trend_adjusted 0
dtype: int64Come si vede, i nomi delle colonne differiscono tra i due DataFrame e la colonna party sembra mancare in swing_until_20. Inoltre, sembrano esserci due tipi diversi di percentuali: una stimata e una aggiustata per il trend. Tuttavia, la percentuale aggiustata per il trend non sembra disponibile per i dati 2024. Lo approfondiremo più avanti.
Controlliamo ora i valori distinti di ciascuna delle nostre variabili categoriali:
print('2024 data:')
print(swing_24['date'].min())			# earliest polling date
print(swing_24['date'].max())			# latest polling date
print(swing_24['state'].unique().tolist())	# distinct states
print(swing_24['party'].unique().tolist())	# distinct parties
print(swing_24['candidate'].unique().tolist())	# distinct candidates
print('Historical data:')
print(swing_until_20['modeldate'].min())
print(swing_until_20['modeldate'].max())
print(swing_until_20['state'].unique().tolist())
print(swing_until_20['candidate_name'].unique().tolist())
2024 data:
2024-03-01 00:00:00
2024-10-29 00:00:00
['Arizona', 'Georgia', 'Michigan', 'Nevada', 'North Carolina', 'Pennsylvania', 'Wisconsin']
['REP', 'DEM', 'IND']
['Trump', 'Harris', 'Kennedy', 'Biden']
Historical data:
2000-03-02 00:00:00
2020-11-03 00:00:00
['Wisconsin', 'Pennsylvania', 'North Carolina', 'Nevada', 'Michigan', 'Georgia', 'Arizona']
['Joseph R. Biden Jr.', 'Donald Trump', 'Convention Bounce for Joseph R. Biden Jr.', 'Convention Bounce for Donald Trump', 'Hillary Rodham Clinton', 'Gary Johnson', 'Barack Obama', 'Mitt Romney', 'John McCain', 'George W. Bush', 'John Kerry', 'Al Gore', 'Ralph Nader']Mentre i dati su stati e date sembrano a posto, ci sono alcune osservazioni sulle colonne legate ai candidati. I dati storici (in particolare del ciclo 2020) includono non solo le percentuali dei due candidati ma anche i “convention bounce”, ossia l’incremento di consenso dopo le convention nazionali. Inoltre, in swing_24 sembrano mancare i nomi propri.
Per indagare i diversi tipi di percentuali, è fondamentale rimuovere subito le osservazioni di “convention bounce”:
# Only keep rows where candidate_name does not start with 'Convention Bounce'
swing_until_20 = swing_until_20[~swing_until_20['candidate_name'].str.startswith('Convention Bounce')]Per coerenza, il tipo di percentuale deve essere lo stesso per tutti i dati di training e test. Come abbiamo visto, solo i dati fino al ciclo 2020 contengono sia le percentuali stimate sia quelle aggiustate per il trend, mentre per il 2024 ci sono solo le stimate. Questo ci lascia due opzioni:
Il modo in cui è stata calcolata la percentuale aggiustata per il trend nei dati storici non è chiaro. Dobbiamo quindi indagare la relazione tra percentuali stimate e aggiustate prima di passare alla pulizia dei dati, poiché la scelta della base dati è cruciale per le nostre previsioni. Per prima cosa, analizziamo correlazione e differenza media nei dati storici.
# Checking the correlation between the percentages
adj_corr_swing = swing_until_20['pct_estimate'].corr(swing_until_20['pct_trend_adjusted'])
print('Correlation between estimated and trend-adjusted percentage in swing states: ' + str(adj_corr_swing))

# Calculate the mean difference between pct_estimate and pct_trend_adjusted, grouping by date, state, and party
mean_diff = (swing_until_20['pct_estimate'] - swing_until_20['pct_trend_adjusted']).mean()
print('Mean difference between estimated and trend-adjusted percentage in swing states: ' + str(mean_diff))
Correlation between estimated and trend-adjusted percentage in swing states: 0.9953626583357665
Mean difference between estimated and trend-adjusted percentage in swing states: 0.24980898513865013La correlazione tra le due è estremamente alta (99,5%), come ci si aspetterebbe. La differenza media di circa 0,25 punti percentuali sembra piccola, ma potrebbe fare la differenza in gare molto ravvicinate, come quelle attese in Nevada o Michigan.
Poiché tutti i grandi elettori di uno stato vanno al vincitore, l’ordine tra i candidati è più importante della precisione assoluta in percentuale. Vogliamo evitare discrepanze a ridosso della data del voto. Possiamo quindi guardare al numero di osservazioni in cui il candidato in testa tra le due percentuali differiva nell’ultimo ciclo (2020) e all’ultima data in cui è accaduto.
# Finding out how often pct_estimate and pct_trend_adjusted saw different candidates in the lead in the 2020 race
swing_20 = swing_until_20[swing_until_20['cycle'] == 2020]

# Create a new column to indicate if the ranking is different between pct_estimate and pct_trend_adjusted
swing_20['rank_estimate'] = swing_20.groupby(['state', 'modeldate'])['pct_estimate'].rank(ascending=False)
swing_20['rank_trend_adjusted'] = swing_20.groupby(['state', 'modeldate'])['pct_trend_adjusted'].rank(ascending=False)

# Rows where the rankings are different in swing states
different_rankings_swing = swing_20[swing_20['rank_estimate'] != swing_20['rank_trend_adjusted']]
print('Number of observations with differing leader: ' + str(different_rankings_swing.shape[0] / 2))
print('Last occurrence: ' + str(different_rankings_swing['modeldate'].max()))
Number of observations with differing leader: 34.0
Last occurrence: 2020-06-24 00:00:00A quanto pare, la leadership differiva solo in 34 casi, circa 5 giorni per swing state in media. Dato che l’ultima occorrenza è a fine giugno, tutte le istanze sembrano collocarsi nella fase iniziale della campagna.
Considerando tutto ciò, è improbabile che i rari cambi di leadership influenzino significativamente l’accuratezza complessiva del modello, specie avendo un dataset ampio che copre più cicli. Ho quindi scelto la prima opzione e ho usato solo la percentuale stimata in tutti i cicli. Questo garantisce la coerenza dei dati, fondamentale nel machine learning per evitare che il modello apprenda bias introdotti da metodi di elaborazione diversi.
Per aggiungere una colonna del partito politico, prima ricaviamo l’elenco di tutti i candidati nel dataset storico. Poi creiamo un dizionario con i candidati come chiavi e il relativo partito come valore—ChatGPT è ottimo per risparmiare tempo di ricerca! Infine, combiniamo il tutto in un DataFrame e facciamo il merge con swing_until_20.
# Get unique candidate names
candidate_names = swing_until_20['candidate_name'].unique().tolist()

# Create a dictionary of candidates and their political party
party_map = {
    'Joseph R. Biden Jr.': 'DEM',
    'Donald Trump': 'REP',
    'Hillary Rodham Clinton': 'DEM',
    'Gary Johnson': 'LIB',
    'Barack Obama': 'DEM',
    'Mitt Romney': 'REP',
    'John McCain': 'REP',
    'Ralph Nader': 'IND',
    'George W. Bush': 'REP',
    'John Kerry': 'DEM',
    'Al Gore': 'DEM'
}

# Create a DataFrame with candidates and their respective parties
candidate_df = pd.DataFrame(candidate_names, columns=['candidate_name'])
candidate_df['party'] = candidate_df['candidate_name'].map(party_map)

# Merge the candidate_df with swing_until_20 on 'candidate' column
swing_until_20 = swing_until_20.merge(candidate_df[['candidate_name', 'party']], on='candidate_name', how='left')
Ora che abbiamo aggiunto la colonna del partito al DataFrame swing_until_20, possiamo unire i risultati storici in una nuova colonna chiamata vote_share. Poiché il CSV di vote_share era in un formato diverso, dobbiamo adeguarlo a quello usato nella colonna pct_estimate.
# Merging results_until_20 to swing_until_20
swing_until_20 = pd.merge(swing_until_20, results_until_20, how='left', left_on=['cycle', 'state', 'party', 'candidate_name'], right_on=['cycle', 'state', 'party', 'candidate'])
swing_until_20['vote_share'] = swing_until_20['vote_share'].str.replace(',', '.')
swing_until_20['vote_share'] = pd.to_numeric(swing_until_20['vote_share'])Infine, rinominiamo la colonna modeldate in date, rimuoviamo le colonne non necessarie e adeguiamo il formato di candidate nei dati 2024 includendo anche i nomi propri.
# Renaming columns in swing_until_20
swing_until_20.rename(columns={'modeldate': 'date'}, inplace=True)

# Keeping only relevant columns
swing_24 = swing_24[['cycle', 'date', 'state', 'party', 'candidate', 'pct_estimate']]
swing_until_20 = swing_until_20[['cycle', 'date', 'state', 'party', 'candidate', 'pct_estimate', 'vote_share']]

# Update candidate names in swing_24 dataframe
swing_24['candidate'] = swing_24['candidate'].replace({
    'Trump': 'Donald Trump',
    'Biden': 'Joseph R. Biden Jr.',
    'Harris': 'Kamala Harris',
'Kennedy': 'Robert F. Kennedy'})Vediamo com’è andato finora l’andamento della campagna 2024. Usiamo seaborn e matplotlib per creare un grafico a linee che mostri la progressione media dei sondaggi nei swing state selezionati. Le linee rossa, blu e nera mostrano le percentuali di sondaggio di Repubblicani, Democratici e candidati indipendenti. Linee verticali segnano eventi significativi durante la campagna.
import matplotlib.pyplot as plt
import seaborn as sns

# Ensure the date column is in datetime format
swing_24['date'] = pd.to_datetime(swing_24['date'])

# Group by date and party, then average the pct_estimate
swing_24_grouped = swing_24.groupby(['date', 'party'])['pct_estimate'].mean().reset_index()

# Create the line chart
plt.figure(figsize=(14, 8))
sns.lineplot(data=swing_24_grouped, x='date', y='pct_estimate', hue='party', marker='o',
             palette={'REP': 'red', 'DEM': 'blue', 'IND': 'black'})

# Add vertical lines for significant events
plt.axvline(pd.to_datetime('2024-07-13'), color='red', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-08-05'), color='blue', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-07-23'), color='blue', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-09-05'), color='black', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-10-01'), color='black', linestyle='--', alpha=0.25)

# Add text annotations for significant events
plt.text(pd.to_datetime('2024-07-13'), plt.ylim()[1] * 0.6, 'Trump Assassination Attempt', color='red', ha='right')
plt.text(pd.to_datetime('2024-07-23'), plt.ylim()[1] * 0.5, 'First Harris Rally', color='blue', ha='right')
plt.text(pd.to_datetime('2024-08-05'), plt.ylim()[1] * 0.4, 'Official Nomination of Harris', color='blue', ha='right')
plt.text(pd.to_datetime('2024-09-05'), plt.ylim()[1] * 0.3, 'Presidential Debate', color='black', ha='right')
plt.text(pd.to_datetime('2024-10-01'), plt.ylim()[1] * 0.2, 'Vice Presidential Debate', color='black', ha='right')

# Add horizontal gridlines at values divisible by 5
plt.yticks(range(0, 51, 5))
plt.grid(axis='y', linestyle='--', alpha=0.7)

# Limit the y-axis range to 50
plt.ylim(0, 50)

# Adjust the legend
plt.legend(title='Party')

# Set titles and labels
plt.title('Average Polling Percentage per Party Over Time in Swing States')
plt.xlabel('Date')
plt.ylabel('Average Polling Percentage')
plt.show()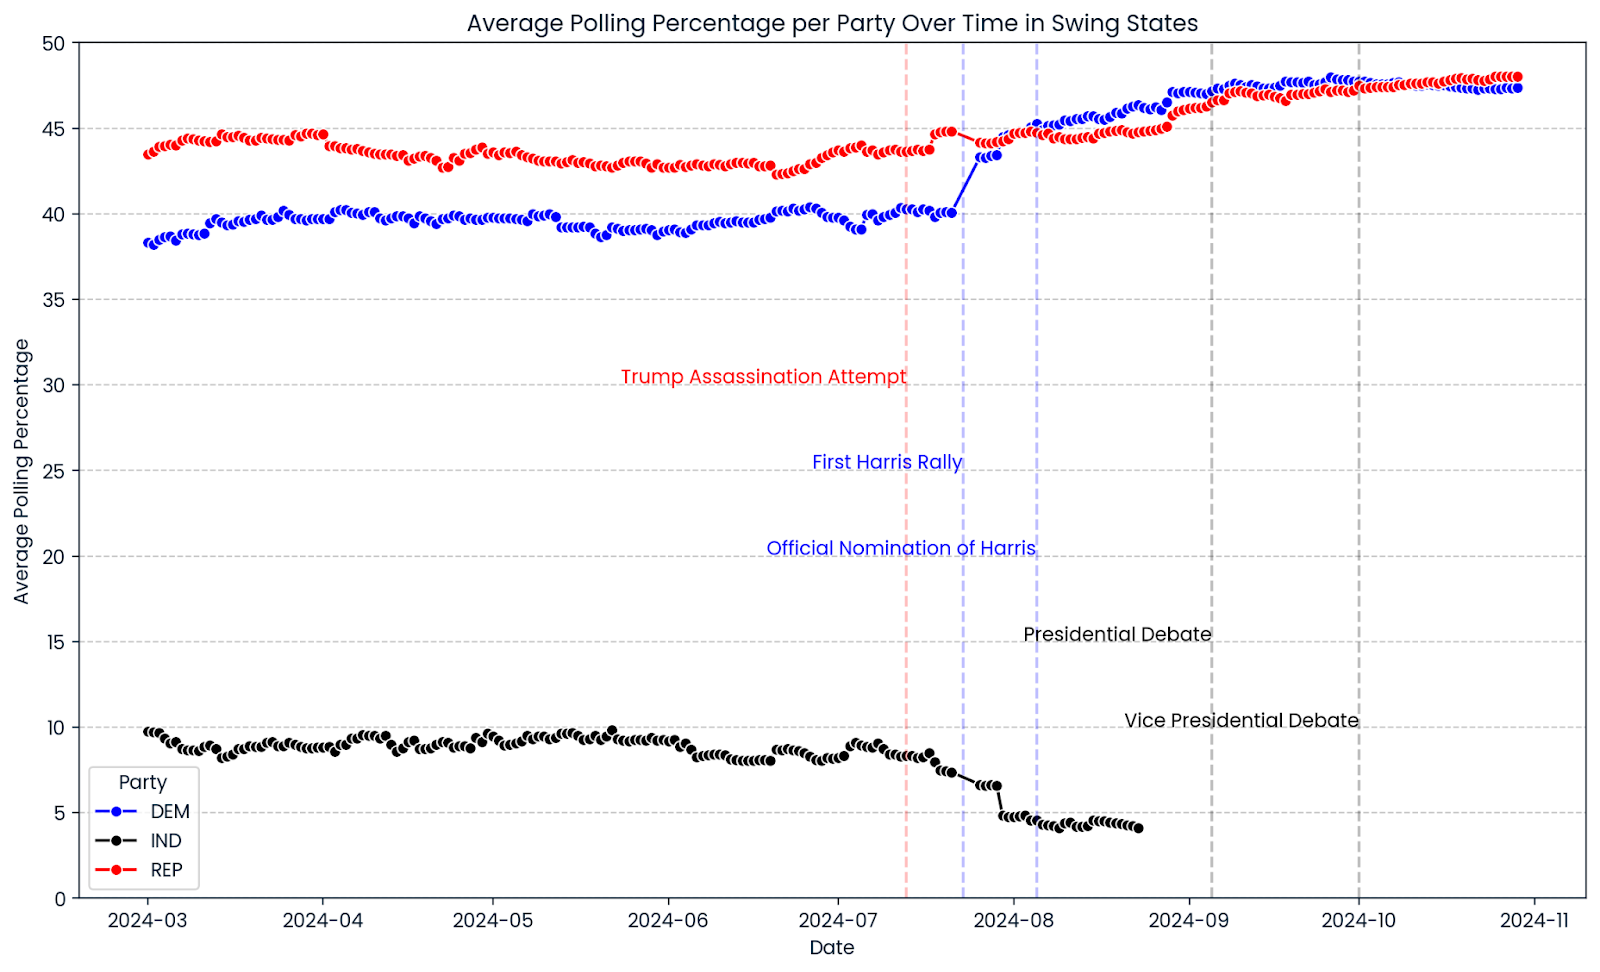
Un primo sguardo all’andamento dei sondaggi 2024 mostra un margine molto ristretto negli swing state. L’approvazione di Donald Trump è stata relativamente costante per tutta la campagna, con un lieve recente incremento. La percentuale del Partito Democratico è risalita dopo la nomina ufficiale di Kamala Harris a candidata presidenziale il 5 agosto 2024, superando nettamente i sondaggi del precedente candidato e Presidente degli Stati Uniti, Joe Biden. In ogni caso, i grafici mostrano molte corse troppo incerte per essere chiamate.
In questa sezione ci assicuriamo che i dati siano puliti e pronti per i modelli di machine learning, concentrandoci sulla gestione dei valori mancanti e sulla comprensione delle distribuzioni delle variabili chiave.
Ci sono alcune ultime verifiche per assicurarci che i dati abbiano la struttura corretta per l’addestramento. Per prima cosa, controlliamo se ci sono colonne con valori mancanti in entrambi i dataset.
# Calculate the number of missing values in each column of swing_until_20
missing_values_until_20 = swing_until_20.isnull().sum()
missing_values_24 = swing_24.isnull().sum()

# Filter out columns that have no missing values
missing_values_until_20 = missing_values_until_20[missing_values_until_20 > 0]
missing_values_24 = missing_values_24[missing_values_24 > 0]

# Display the columns with at least 1 missing value and their respective counts for both dataframes
print(missing_values_until_20, missing_values_24)
momentum 84 dtype: int64
momentum 21 dtype: int64L’unica colonna con valori mancanti è il momentum del candidato. Ha senso, perché è calcolato come differenza giornaliera dei valori di sondaggio per ciascun candidato, quindi ci aspettiamo che la prima osservazione non abbia il valore di momentum. Possiamo semplicemente rimuovere i mancanti.
# Dropping missing values
swing_24 = swing_24.dropna()
swing_until_20 = swing_until_20.dropna()Osservare le distribuzioni delle colonne numeriche ci dà un’idea di eventuali outlier nascosti e della plausibilità generale dei dati.
Inoltre, possiamo confrontare i sondaggi del ciclo 2024 con la media dei cicli precedenti. Possiamo tralasciare alcune feature come pct_opponent e rolling_avg_7d perché derivano sostanzialmente da pct_estimate e ne rispecchieranno la distribuzione.
# Getting description of distributions in both DataFrames
swing_until_20[['pct_estimate', 'lead', 'pct_3rd_party', 'momentum', 'vote_share']].describe()
print(swing_24[['pct_estimate', 'lead', 'pct_3rd_party','momentum']].describe())|
pct_estimate |
lead |
pct_3rd_party |
momentum |
vote_share |
|
|
count |
20504 |
20504 |
20504 |
20504 |
20504 |
|
mean |
44,73 |
0,00 |
1,25 |
0,00 |
48,85 |
|
min |
32,65 |
-18,01 |
0,00 |
-8,45 |
40,96 |
|
25% |
42,07 |
-4,94 |
0,00 |
-0,01 |
46,17 |
|
50% |
44,99 |
0,00 |
0,00 |
0,00 |
48,67 |
|
75% |
47,43 |
4,94 |
0,00 |
0,01 |
50,77 |
|
max |
56,47 |
18,01 |
12,67 |
8,45 |
57,97 |
|
std |
3,89 |
6,58 |
2,66 |
0,47 |
3,59 |
|
pct_estimate |
lead |
pct_3rd_party |
momentum |
|
|
count |
3228 |
3228 |
3228 |
3228 |
|
mean |
43,53 |
0,00 |
5,87 |
0,00 |
|
min |
35,39 |
-8,77 |
0,00 |
-6,28 |
|
25% |
41,06 |
-2,07 |
0,00 |
-0,12 |
|
50% |
43,76 |
0,00 |
8,01 |
0,00 |
|
75% |
46,56 |
2,07 |
8,91 |
0,12 |
|
max |
48,89 |
8,77 |
12,17 |
6,28 |
|
std |
3,22 |
3,63 |
4,05 |
0,45 |
Le distribuzioni delle feature in entrambi i dataset swing_until_20 e swing_24 appaiono plausibili e in linea con quanto atteso per dati di sondaggi negli swing state.
I valori di pct_estimate vanno da circa il 33% al 56% storicamente e dal 35% al 49% nel 2024, ragionevoli per elezioni competitive in cui nessun candidato domina nettamente. La vote_share nel dataset storico ha una media del 48,85%, plausibile dato che gli swing state spesso hanno ripartizioni prossime al 50-50.
Come atteso, le variabili lead e momentum sono centrate attorno a una media di 0 in entrambi i dataset, indicando che vantaggi, svantaggi, guadagni e perdite tra candidati si compensano nel tempo. La variabile lead sembra quasi perfettamente normale, mentre il momentum è almeno simmetrico ma con la maggior parte dei valori vicini alla media.
Storicamente, pct_estimate segue una distribuzione abbastanza normale con una leggera asimmetria a sinistra: la media è molto vicina alla mediana e la dispersione cattura quantità tipiche di valori in un range ragionevole.
Nei dati 2024, le percentuali dei sondaggi sono più centrate attorno alla media. La deviazione standard di lead nel 2024 (3,63) è inferiore rispetto ai dati storici (6,58) e il range dei valori è meno della metà di quello storico. Sono tutti indicatori di margini più stretti nel 2024, suggerendo corse ancora più serrate.
In molti cicli non c’era un candidato terzo con supporto significativo, come si vede dal fatto che oltre il 75% delle osservazioni ha un pct_3rd_party pari a 0, con una media dell’1,25%. I numeri alti nel 2024 (mediana 8,01%) riflettono il forte sostegno avuto dal candidato indipendente Robert F. Kennedy fino alla fine della sua campagna nell’agosto 2024.
La nostra strategia di previsione tiene conto del fatto che i sondaggi non sono risultati definitivi ma solo indicatori del sentimento pubblico in momenti specifici. Eviteremo quindi semplici previsioni time-series che trattano i sondaggi come previsioni dirette dei risultati. Useremo invece un approccio a regressione che prevede l’esito elettorale per ogni singola osservazione di sondaggio, invece di proiettare una serie temporale di sondaggi.
Riconoscendo che ogni stato ha una sua dinamica politica, costruiremo un modello separato per ciascuno swing state. Per evitare leakage e rispettare il passare del tempo, ci assicureremo di testare i modelli solo su dati non visti—nello specifico, cicli elettorali successivi a quelli su cui i modelli sono stati addestrati. Questo approccio ci aiuterà a valutare la capacità dei modelli di generalizzare correttamente a elezioni future.
Ho scelto due criteri di valutazione per i modelli di previsione delle quote di voto. Poiché il vincitore “prende tutto” in ogni stato, il numero di vincitori previsti correttamente nei cicli di test è la misura più importante da considerare.
La Mean Absolute Error (MAE) è il criterio secondario. Misura l’entità media degli errori tra valori previsti e reali nelle stesse unità della variabile target—qui, punti percentuali di quota di voto. È molto interpretabile e direttamente rilevante: indica di quanti punti percentuali, in media, le nostre previsioni si discostano dai risultati effettivi.
Infine, alleneremo il miglior modello di ciascuno stato su tutti i cicli elettorali fino al 2020 e lo applicheremo per prevedere gli esiti del 2024. Useremo una ponderazione temporale con decadimento esponenziale per trasformare le singole previsioni in un unico valore predittivo per stato, dando più peso ai sondaggi recenti.
Per prima cosa importiamo i pacchetti che ci serviranno. Includono tutti i modelli che valuteremo, NumPy e la mean_absolute_error.
# Importing models
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression, Ridge, ElasticNet
from sklearn.neighbors import KNeighborsRegressor
from sklearn.neural_network import MLPRegressor
from sklearn.svm import SVR
import catboost
import xgboost as xgb

# Importing other necessary libraries
from sklearn.metrics import mean_absolute_error
import numpy as npCreiamo un workflow per addestrare e valutare i modelli base! Passeremo il processo passo dopo passo e poi lo applicheremo a ogni stato per ciascun ciclo di test, a partire dal 2004.
Per adattare i modelli alle caratteristiche specifiche dello stato, iniziamo filtrando il dataset per includere solo i dati rilevanti per lo stato analizzato. In questo modo il modello cattura pattern di voto e dati di sondaggio specifici dello stato.
# Filter data for the state you're analyzing
data_state = swing_until_20[swing_until_20['state'] == state].copy()
Definiamo quindi una funzione di pesi per dare più importanza ai sondaggi condotti più vicino alla data del voto. Questa funzione a decadimento esponenziale riduce il peso dei sondaggi man mano che sono più lontani dalle elezioni, enfatizzando la rilevanza dei più recenti.
# Define the weight function (using a typical starting k value)
def compute_weight(days_until_election, k):
	return np.exp(-k * days_until_election)

# Add weights to the data
data_state['weight'] = compute_weight(data_state['days_until_election'], k=0.1)
Successivamente, dividiamo i dati in training e test in base ai cicli elettorali, assicurandoci di addestrare su elezioni passate e testare su quelle future per evitare leakage. La definizione di train_cycles e test_cycle arriverà più avanti, quando gestiremo il loop sui cicli elettorali. Definiamo anche le feature usate per la previsione ed estraiamo la variabile target, ossia la quota di voto effettiva.
# Split data into training and testing sets based on election cycles
train_data = data_state[data_state['cycle'].isin(train_cycles)]
test_data = data_state[data_state['cycle'] == test_cycle]

# Define features and target variable
features = ['pct_estimate', 'pct_opponent', 'pct_3rd_party', 'lead', 'rolling_avg_7d',
                    'days_until_election', 'momentum_candidate', 'momentum_opponent', 'momentum',
                    'is_incumbent_president', 'is_incumbent_vice_president', 'is_incumbent_party',
                    'candidate_Donald Trump',
                    'party_DEM', 'party_REP']
X_train = train_data[features]
y_train = train_data['vote_share']
X_test = test_data[features]
y_test = test_data['vote_share']
Definiamo una varietà di modelli di machine learning da valutare, tra cui regressione lineare, metodi ensemble, SVM e reti neurali. Questo set eterogeneo consente di confrontare algoritmi diversi e selezionare il modello con le migliori performance per ciascuno stato.
# Models to evaluate
models = {
    'LinearRegression': LinearRegression(),
    'XGBoost': xgb.XGBRegressor(objective='reg:absoluteerror', n_estimators=100, random_state=42),
    'CatBoost': catboost.CatBoostRegressor(loss_function='MAE', iterations=100, random_seed=42, verbose=0),
    'RandomForest': RandomForestRegressor(n_estimators=100, random_state=42),
    'SVR': SVR(kernel='rbf', C=1.0, epsilon=0.1),
    'KNeighbors': KNeighborsRegressor(n_neighbors=5),
    'MLPRegressor': MLPRegressor(hidden_layer_sizes=(100,), max_iter=500, random_state=42),
    'ElasticNet': ElasticNet(alpha=1.0, l1_ratio=0.5, random_state=42),
}
Procediamo iterando sul dizionario models. Per ogni modello, lo addestriamo usando il training set specifico dello stato corrente e poi effettuiamo previsioni sul test set. Ripetiamo il processo per ogni modello per confrontarne le performance.
for model_name, model in models.items():
    # Train the model
    model.fit(X_train, y_train)
    # Predict on test data
    test_data[f'predicted_{model_name}'] = model.predict(X_test)
All’interno del loop, aggreghiamo le previsioni individuali per partito usando una lambda che applica i pesi calcolati. Otteniamo così una singola quota di voto prevista per partito, che confrontiamo con la quota reale per valutarne l’accuratezza.
# Aggregate predictions using weights
    aggregated_predictions = test_data.groupby('party').apply(
        lambda df: np.average(df[f'predicted_{model_name}'], weights=df['weight'])
    ).reset_index(name='aggregated_prediction')

# Get actual vote shares for comparison
    actual_vote_shares = test_data.groupby('party')['vote_share'].mean().reset_index()
    comparison = pd.merge(aggregated_predictions, actual_vote_shares, on='party')
    comparison.rename(columns={'vote_share': 'actual_vote_share'}, inplace=True)
Per concludere il loop del modello, calcoliamo la Mean Absolute Error (MAE) tra previsioni aggregate e quote reali per quantificare la performance. Determiniamo anche se il modello ha previsto correttamente il partito vincitore nello stato e salviamo i risultati per analisi successive.
# Calculate Mean Absolute Error
mae = mean_absolute_error(comparison['actual_vote_share'], comparison['aggregated_prediction'])

# Check if the predicted winner matches the actual winner
predicted_winner = comparison.loc[comparison['aggregated_prediction'].idxmax(), 'party']
actual_winner = comparison.loc[comparison['actual_vote_share'].idxmax(), 'party']
correct_winner = int(predicted_winner == actual_winner)

# Store the results
results_list.append({
    'state': state,
    'model_name': model_name,
    'test_cycle': test_cycle,
    'MAE': mae,
    'correct_winner': correct_winner
})
L’intero processo è racchiuso in due loop: quello esterno itera su ciascun ciclo elettorale (escludendo il primo, perché non c’è storico per addestrare), e quello interno itera su ogni swing state. In questo modo garantiamo che i modelli siano addestrati e testati correttamente per ogni stato e ciclo, rispettando l’ordine cronologico per evitare leakage.
Il preambolo del codice sopra è il seguente:
# Initialize a list to store results
results_list = []

# Define the election cycles
cycles = [2000, 2004, 2008, 2012, 2016, 2020]
for i in range(1, len(cycles)):  # The loop starts at index 1, so with the 2nd cycle (2004)
    test_cycle = cycles[i]
    train_cycles = cycles[:i]  # train_cycles = all cycles before the test_cycle
    for state in swing_states:
        # Filter data for the state you're analyzing, etc. …
Nel complesso, questa strategia ci consente di valutare più modelli su stati e cicli diversi, selezionando infine il migliore per ogni stato in base all’accuratezza predittiva e alla capacità di prevedere correttamente il vincitore.
Dopo aver addestrato e testato vari modelli su stati e cicli diversi, passiamo a valutarne le performance per identificare i migliori per ogni stato. Questa valutazione si concentra su due metriche: il numero di volte in cui ciascun modello ha previsto correttamente il partito vincitore (correct_winner) e la Mean Absolute Error (MAE) media delle previsioni.
Innanzitutto, raccogliamo tutti i risultati ottenuti durante le valutazioni in un unico DataFrame e aggreghiamo le metriche di performance:
# After the loop, create a DataFrame from the results list
results_df = pd.DataFrame(results_list)

# Get the sum of correct_winner and the average MAE for every combination of state and model_name
aggregated_evaluation = results_df.groupby(['state', 'model_name']).agg({
    'correct_winner': 'sum',
    'MAE': 'mean'
}).reset_index()

# Display the maximum number of correct winner predictions and the minimum MAE for each state
print(aggregated_evaluation.groupby('state')['correct_winner'].max())
print(aggregated_evaluation.groupby('state')['MAE'].min())|
state |
Maximum correct_winner |
Minimum MAE |
|
Arizona |
5 |
1,248966 |
|
Georgia |
5 |
0,770760 |
|
Michigan |
4 |
2,685870 |
|
Nevada |
5 |
2,079582 |
|
North Carolina |
5 |
0,917522 |
|
Pennsylvania |
4 |
2,027426 |
|
Wisconsin |
4 |
2,462907 |
Non è affatto male! In tutti gli stati c’è stato almeno un modello che ha previsto correttamente 4 delle 5 elezioni precedenti. In 4 stati (Arizona, Georgia, Nevada e North Carolina) alcuni modelli hanno persino azzeccato il vincitore in ogni ciclo. I risultati della MAE più bassa in parte lasciano margine di miglioramento e differiscono notevolmente tra stati, con una media di 1,74 punti percentuali e un range da 0,77 in Georgia a 2,69 in Michigan.
Con queste informazioni aggregate, procediamo a selezionare il modello con le performance migliori per ciascuno stato. Ordiniamo i modelli in base alla capacità di prevedere il vincitore e, solo dopo, in base alla MAE. I modelli scelti sono salvati nel dizionario best_models.
# Sort the models for each state by correct_winner (descending) and then by MAE (ascending)
sorted_evaluation = aggregated_evaluation.sort_values(by=['state', 'correct_winner', 'MAE'], ascending=[True, False, True])

# Create a dictionary to store the best model for each state
best_models = {}

# Iterate over each state and get the top model
for state in sorted_evaluation['state'].unique():
    top_model = sorted_evaluation[sorted_evaluation['state'] == state].iloc[0]
    best_models[state] = top_model['model_name']
best_models
{'Arizona': 'RandomForest',
'Georgia': 'ElasticNet',
'Michigan': 'LinearRegression',
'Nevada': 'KNeighbors',
'North Carolina': 'CatBoost',
'Pennsylvania': 'KNeighbors',
'Wisconsin': 'MLPRegressor'}I modelli top per ogni stato variano molto, riflettendo pattern di voto e comportamenti di sondaggio unici in ciascuna area. Sorprendentemente, in Michigan i risultati migliori si ottengono persino con la regressione lineare, a indicare che lì può bastare un approccio lineare più semplice.
A questo punto si potrebbe procedere con un tuning degli iperparametri per ottimizzare le performance dei modelli. Poiché ciò introdurrebbe ulteriori questioni metodologiche e richiederebbe ampie modifiche al codice, esula dallo scopo di questo tutorial già piuttosto lungo. I risultati dei modelli base sono già abbastanza promettenti per tentare di prevedere i risultati del 2024.
Nella fase finale, utilizziamo i migliori modelli per ciascuno swing state per prevedere gli esiti del 2024. Iniziamo inizializzando una lista vuota per memorizzare le previsioni.
Per ogni stato e per il relativo miglior modello, riutilizziamo lo stesso workflow di prima. Solo che questa volta non cicliamo sui cicli elettorali, ma alleniamo su tutti i dati storici dal 2000 al 2020 (swing_until_20).
# Initialize a list to store predictions
predictions_list = []
for state, model_name in best_models.items():
    # Filter the data for the specific state
    state_data_train = swing_until_20[swing_until_20['state'] == state].copy()  # Data from 2000 to 2020
    state_data_test = swing_24[swing_24['state'] == state].copy()  # Data for 2024

    # Add weights to the test data
    state_data_test['weight'] = compute_weight(state_data_test['days_until_election'], k=0.1)

    # Define features
    features = [
        'pct_estimate',
        'pct_opponent',
        'pct_3rd_party',
        'lead',
        'rolling_avg_7d',
        'days_until_election',
        'momentum_candidate',
        'momentum_opponent',
        'momentum',
        'is_incumbent_president',
        'is_incumbent_vice_president',
        'is_incumbent_party',
        'candidate_Donald Trump',
        'party_DEM',
        'party_REP'
    ]

    # Split features and target variable
    X_train = state_data_train[features]
    y_train = state_data_train['vote_share']
    X_test = state_data_test[features]

    # Train the model on the 2000 to 2020 data
    model.fit(X_train, y_train)

    # Predict on the 2024 data
    state_data_test['predicted_vote_share'] = model.predict(X_test)

    # Aggregate predictions using weights
    aggregated_predictions = state_data_test.groupby('party').apply(
        lambda df: np.average(df['predicted_vote_share'], weights=df['weight'])
    ).reset_index(name='aggregated_prediction')

    # Append predictions to the list
    for _, pred_row in aggregated_predictions.iterrows():
        predictions_list.append({
            'state': state,
            'party': pred_row['party'],
            'predicted_vote_share': pred_row['aggregated_prediction'],
            'model': model_name
        })
Dopo aver previsto la colonna vote_share, aggregato le previsioni usando la funzione di peso definita e aggiunto le previsioni a predictions_list, consolidiamo le previsioni finali in un DataFrame. Inoltre, aggiungiamo un ranking per ciascuno stato e facciamo un pivot per stato. Ecco le previsioni prodotte dai nostri modelli:
# Convert predictions list to DataFrame
predictions_df = pd.DataFrame(predictions_list)

# Add a rank to predictions_df for each state based on the order of predicted_vote_share
predictions_df['rank'] = predictions_df.groupby('state')['predicted_vote_share'].rank(ascending=False)

# Create a pivot table indexed by state
predictions_pivot = predictions_df.pivot(index='state', columns='party', values='predicted_vote_share')

# Display predictions
print("\n2024 Vote Share Predictions:")
predictions_pivot
2024 Vote Share Predictions:
state
DEM
REP
Arizona
49.02
50.31
Georgia
48.95
50.08
Michigan
50.34
48.64
Nevada
49.41
48.54
North Carolina
48.95
50.06
Pennsylvania
49.57
49.20
Wisconsin
49.66
49.41Le previsioni confermano una corsa molto serrata negli swing state. I nostri modelli prevedono quattro stati a maggioranza per Kamala Harris (Michigan, Nevada, Pennsylvania, Wisconsin) e tre per Donald Trump (Arizona, Georgia, North Carolina). Pennsylvania e Wisconsin dovrebbero essere particolarmente tirati, con differenze tra le quote previste di appena 0,37 e 0,25 punti percentuali rispettivamente.
Come detto, assumiamo che tutti gli altri stati votino per il candidato atteso, cioè gli stati “blu” per Kamala Harris e quelli “rossi” per Donald Trump. Per valutare quanti grandi elettori ottiene ciascun candidato, definiamo un dizionario che assegna a ogni stato e distretto il proprio numero di voti e combiniamo le informazioni in un DataFrame chiamato electoral_votes_df.
# Define the number of electoral votes per state for the 2024 US-Presidential elections
electoral_votes = {
    'Alabama': 9, 'Alaska': 3, 'Arizona': 11, 'Arkansas': 6, 'California': 54,
    'Colorado': 10, 'Connecticut': 7, 'Delaware': 3, 'District of Columbia': 3,
    'Florida': 30, 'Georgia': 16, 'Hawaii': 4, 'Idaho': 4, 'Illinois': 19,
    'Indiana': 11, 'Iowa': 6, 'Kansas': 6, 'Kentucky': 8, 'Louisiana': 8,
    'Maine': 2, 'Maryland': 10, 'Massachusetts': 11, 'Michigan': 15,
    'Minnesota': 10, 'Mississippi': 6, 'Missouri': 10, 'Montana': 4,
    'Nebraska': 2, 'Nevada': 6, 'New Hampshire': 4, 'New Jersey': 14,
    'New Mexico': 5, 'New York': 28, 'North Carolina': 16, 'North Dakota': 3,
    'Ohio': 17, 'Oklahoma': 7, 'Oregon': 8, 'Pennsylvania': 19,
    'Rhode Island': 4, 'South Carolina': 9, 'South Dakota': 3,
    'Tennessee': 11, 'Texas': 40, 'Utah': 6, 'Vermont': 3, 'Virginia': 13,
    'Washington': 12, 'West Virginia': 4, 'Wisconsin': 10, 'Wyoming': 3
}

# Create a DataFrame from the dictionary
electoral_votes_df = pd.DataFrame(list(electoral_votes.items()), columns=['State', 'Electoral Votes'])

# Handle states that divide their votes into multiple districts (Maine and Nebraska)
districts = {'ME-1': 1, 'ME-2': 1, 'NE-1': 1, 'NE-2': 1, 'NE-3': 1}

# Add the districts to the DataFrame
districts_df = pd.DataFrame(list(districts.items()), columns=['State', 'Electoral Votes'])

# Combine the two DataFrames
electoral_votes_df = pd.concat([electoral_votes_df, districts_df], ignore_index=True)
Creiamo poi due liste, harris e trump, che contengono rispettivamente gli stati blu e rossi insieme agli swing state previsti a favore di ciascun candidato. Nel passo successivo possiamo filtrare electoral_votes_df per gli stati in ciascuna lista e calcolare la somma dei grandi elettori attesa per ciascun candidato.
# Extract states from predictions_df where party is DEM and rank is 1
additional_blue_states = predictions_df[
    (predictions_df['party'] == 'DEM') & (predictions_df['rank'] == 1)
].state.tolist()

# Extract states from predictions_df where party is REP and rank is 1
additional_red_states = predictions_df[
    (predictions_df['party'] == 'REP') & (predictions_df['rank'] == 1)
].state.tolist()

# Combine blue_states and additional_blue_states into a single list
harris = list(set(blue_states + additional_blue_states))
trump = list(set(red_states + additional_red_states))

# Filter the electoral votes for states in each candidate's list
harris_electoral_votes = electoral_votes_df[electoral_votes_df['state'].isin(harris)]
trump_electoral_votes = electoral_votes_df[electoral_votes_df['state'].isin(trump)]

# Sum the electoral votes
sum_harris_electoral_votes = harris_electoral_votes['electoral_votes'].sum()
sum_trump_electoral_votes = trump_electoral_votes['electoral_votes'].sum()
print(
    f'According to the predictions made by the machine learning models, '
    f'Kamala Harris will win {sum_harris_electoral_votes} electoral votes '
    f'and Donald Trump will win {sum_trump_electoral_votes} electoral votes.'
)
According to the predictions made by the machine learning models, Kamala Harris will win 276 electoral votes and Donald Trump will win 262 electoral votes.La previsione è che Kamala Harris otterrà 276 grandi elettori e Donald Trump 262. Se le nostre assunzioni e previsioni si rivelassero corrette, ecco come apparirebbe la mappa elettorale il 5 novembre:
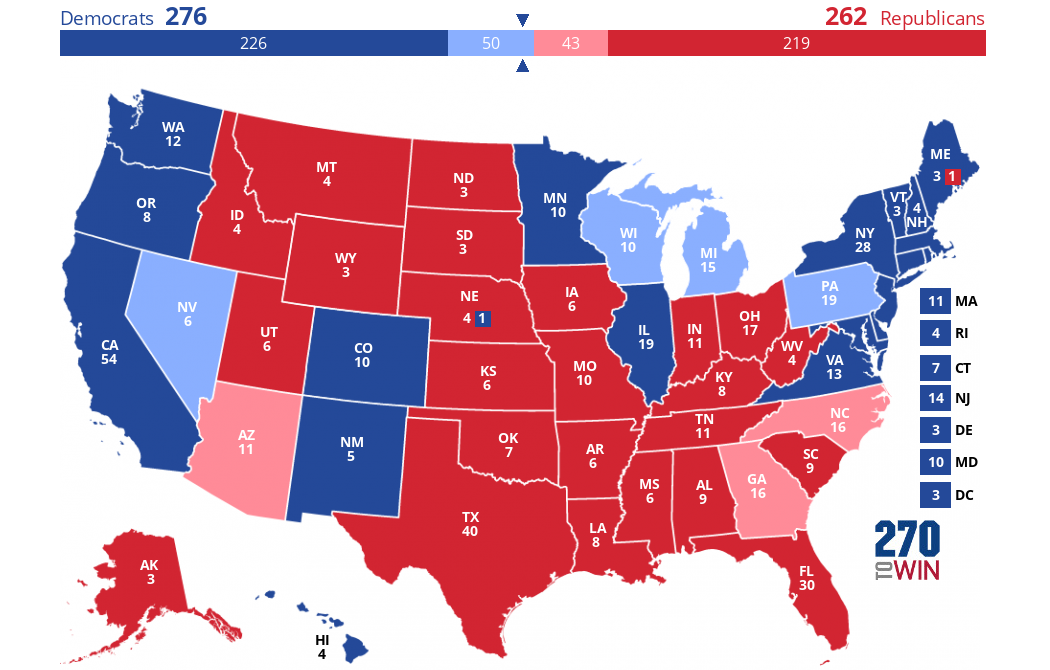
Creata usando questo creatore di mappe interattive.
I colori scuri rappresentano gli stati “blu” o “rossi” assunti. Gli swing state da noi previsti fanno la differenza—sono colorati in blu o rosso più chiaro.
In questo progetto abbiamo usato i sondaggi storici per prevedere l’esito delle elezioni presidenziali USA 2024. Come previsto, i nostri modelli indicano una corsa serrata tra i candidati principali.
È importante ricordare che la nostra analisi si è basata esclusivamente sui sondaggi, che a volte in passato sono stati imprecisi e non colgono tutte le sfumature di un’elezione. Fattori come metodologie di sondaggio, affluenza, dinamiche di campagna, condizioni economiche e demografiche ed eventi imprevisti non sono stati considerati nei nostri modelli ma possono incidere significativamente sui risultati reali.
Ciononostante, questa esplorazione mostra il potenziale dell’analisi predittiva per comprendere sistemi complessi come le elezioni. Se vuoi approfondire l’analisi predittiva con Python, ti consiglio queste risorse:
Impara il machine learning con questi corsi!
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



