

Databronnen: FiveThirtyEight en Federal Election Commission
De data voor onze voorspelling komt van FiveThirtyEight, dat peilingen verzamelt van allerlei verschillende peilbureaus. De data is beschikbaar via hun GitHub voor alle verkiezingscycli sinds 1968.
We gebruiken hun pollmodel, dat het gemiddelde peilingpercentage toekent voor elke kandidaat in elke staat voor (bijna) elke datum in de acht maanden voorafgaand aan de verkiezingen.
We beginnen met het importeren van peilingsdata uit 2024, 2020 en historische data uit CSV-bestanden. De data van 2024 wordt gefilterd op peilingen uit de huidige cyclus, en de historische data tot en met 2016 wordt samengevoegd met de data van 2020. In de resulterende twee DataFrames, polls_24 en polls_until_20, worden de kolommen met datums geconverteerd naar een datetime-formaat voor consistentie, en relevante kolommen zoals cyclus, staat, kandidaatnaam en peilingsschattingen blijven behouden.
import pandas as pd
# Reading CSV files
polls_24 = pd.read_csv('presidential_general_averages.csv')
polls_20 = pd.read_csv('presidential_poll_averages_2020.csv')
polls_until_16 = pd.read_csv('pres_pollaverages_1968-2016.csv')
# Filtering and concatenating DataFrames
polls_24 = polls_24[polls_24['cycle'] == 2024]
polls_until_20 = pd.concat([polls_20, polls_until_16], ignore_index=True)
# Making sure dates are in datetime format
polls_24['date'] = pd.to_datetime(polls_24['date'], format='%Y-%m-%d')
polls_until_20['modeldate'] = pd.to_datetime(polls_until_20['modeldate'])
# Keeping only the columns of interest
polls_until_20 = polls_until_20[['cycle', 'state', 'modeldate', 'candidate_name', 'pct_estimate', 'pct_trend_adjusted']]Voor de daadwerkelijke uitslag per staat haalde ik de data rechtstreeks bij de Federal Election Commission van de VS. Voor de eenvoud heb ik die vooraf samengevat in één CSV-bestand.
Eén observatie vertegenwoordigt de combinatie van verkiezingscyclus, staat en partij, aangevuld met de naam van de betreffende kandidaat en natuurlijk het behaalde stempercentage.
# Importing result data
results_until_20 = pd.read_csv('results.csv', sep=';')
results_until_20 = results_until_20[['cycle', 'state', 'party', 'candidate', 'vote_share']]Om te zorgen dat we met relevante en kwalitatieve data werken, heb ik twee belangrijke restricties toegepast:
- Ik focus op de laatste zes verkiezingscycli (vanaf 2000), omdat beschikbaarheid en nauwkeurigheid van data in die periode sterk zijn verbeterd.
- Ik beperk de analyse tot swing states—de staten met de spannendste races—gebaseerd op staten waar de koploper minder dan vijf procent voorsprong had, volgens FiveThirtyEight’s verkiezingsvoorspelling. De geselecteerde swing states zijn Pennsylvania, Wisconsin, Michigan, Georgia, North Carolina, Arizona en Nevada. We gaan ervan uit dat de andere staten stemmen zoals verwacht, definiëren de lijsten
swing_states,blue_statesenred_statesdienovereenkomstig, en maken subsets van de data voor de swing states.
# Implementing cycle restriction
start_cycle = 2000
polls_until_20 = polls_until_20[polls_until_20['cycle'] >= start_cycle]
# Defining state lists
swing_states = [
'Pennsylvania', 'Wisconsin', 'Michigan', 'Georgia',
'North Carolina', 'Arizona', 'Nevada'
]
blue_states = [
'District of Columbia', 'Vermont', 'Massachusetts', 'Maryland',
'Hawaii', 'California', 'ME-1', 'Connecticut', 'Washington',
'Delaware', 'Rhode Island', 'New York', 'Illinois', 'New Jersey',
'Oregon', 'Colorado', 'Maine', 'New Mexico', 'Virginia',
'New Hampshire', 'NE-2', 'Minnesota'
]
red_states = [
'Wyoming', 'West Virginia', 'Oklahoma', 'North Dakota',
'Idaho', 'South Dakota', 'Arkansas', 'Kentucky', 'NE-3',
'Alabama', 'Tennessee', 'Utah', 'Louisiana', 'Nebraska',
'Mississippi', 'Montana', 'NE-1', 'Indiana', 'Kansas',
'Missouri', 'South Carolina', 'Alaska', 'Ohio', 'Iowa',
'Texas', 'ME-2', 'Florida'
]
# Defining swing state subset of the poll data
swing_until_20 = polls_until_20[polls_until_20['state'].isin(swing_states)]
swing_24 = polls_24[polls_24['state'].isin(swing_states)]Exploratory Data Analysis en datacleaning
Om een overzicht te krijgen van onze data doen we wat exploratory data analysis (EDA). Eerst gebruiken we een combinatie van de methoden .isnull() en .sum() om te zien welke kolommen elk DataFrame bevat en waar data mogelijk ontbreekt.
# Checking for missing values in swing_24 and swing_until_20
print(swing_24.isnull().sum())
print(swing_until_20.isnull().sum())candidate 0
date 0
pct_trend_adjusted 4394
state 0
cycle 0
party 0
pct_estimate 0
hi 0
lo 0
dtype: int64
cycle 0
state 0
modeldate 0
candidate_name 0
pct_estimate 0
pct_trend_adjusted 0
dtype: int64We zien dat de kolomnamen verschillen tussen de twee DataFrames en dat de kolom party lijkt te ontbreken in swing_until_20. Bovendien lijken er twee soorten percentages gemeten te zijn: een geschat percentage en een extra trendgecorrigeerd percentage. Het trendgecorrigeerde percentage lijkt echter niet beschikbaar voor de 2024-data. Dat onderzoeken we later.
Laten we vervolgens de verschillende waarden bekijken van elk van onze categorische variabelen:
print('2024 data:')
print(swing_24['date'].min()) # earliest polling date
print(swing_24['date'].max()) # latest polling date
print(swing_24['state'].unique().tolist()) # distinct states
print(swing_24['party'].unique().tolist()) # distinct parties
print(swing_24['candidate'].unique().tolist()) # distinct candidates
print('Historical data:')
print(swing_until_20['modeldate'].min())
print(swing_until_20['modeldate'].max())
print(swing_until_20['state'].unique().tolist())
print(swing_until_20['candidate_name'].unique().tolist())2024 data:
2024-03-01 00:00:00
2024-10-29 00:00:00
['Arizona', 'Georgia', 'Michigan', 'Nevada', 'North Carolina', 'Pennsylvania', 'Wisconsin']
['REP', 'DEM', 'IND']
['Trump', 'Harris', 'Kennedy', 'Biden']
Historical data:
2000-03-02 00:00:00
2020-11-03 00:00:00
['Wisconsin', 'Pennsylvania', 'North Carolina', 'Nevada', 'Michigan', 'Georgia', 'Arizona']
['Joseph R. Biden Jr.', 'Donald Trump', 'Convention Bounce for Joseph R. Biden Jr.', 'Convention Bounce for Donald Trump', 'Hillary Rodham Clinton', 'Gary Johnson', 'Barack Obama', 'Mitt Romney', 'John McCain', 'George W. Bush', 'John Kerry', 'Al Gore', 'Ralph Nader']Hoewel de data er goed uitziet voor staten en datums, valt er bij de kandidaatgerelateerde kolommen het een en ander op. De historische data (meer specifiek die van de cyclus 2020) bevat niet alleen percentages van de twee kandidaten, maar ook convention bounces, oftewel toename in steun na hun partijconventie. Verder lijken in swing_24 de voornamen te ontbreken.
Voor ons onderzoek naar de verschillende soorten percentages is het cruciaal om de convention-bounce-observaties meteen te verwijderen:
# Only keep rows where candidate_name does not start with 'Convention Bounce'
swing_until_20 = swing_until_20[~swing_until_20['candidate_name'].str.startswith('Convention Bounce')]Geschat versus trendgecorrigeerd percentage
Voor consistentie moet het type percentage hetzelfde zijn voor alle trainings- en testdata. Zoals we zagen bevatten alleen de data tot en met de verkiezingscyclus van 2020 zowel geschatte als trendgecorrigeerde percentages, terwijl er voor 2024 alleen geschatte percentages zijn. Dat laat ons twee opties:
- Het geschatte percentage voor alle cycli gebruiken
- Zelf een trendgecorrigeerd percentage voor 2024 berekenen
De manier waarop het trendgecorrigeerde percentage voor de historische data is berekend, is onduidelijk. Daarom moeten we de relatie tussen het geschatte en het trendgecorrigeerde percentage onderzoeken voordat we doorgaan met datacleaning, omdat de keuze van de databasis cruciaal is voor onze voorspellingen. Eerst bekijken we de correlatie en gemiddelde afwijking in de historische data.
# Checking the correlation between the percentages
adj_corr_swing = swing_until_20['pct_estimate'].corr(swing_until_20['pct_trend_adjusted'])
print('Correlation between estimated and trend-adjusted percentage in swing states: ' + str(adj_corr_swing))
# Calculate the mean difference between pct_estimate and pct_trend_adjusted, grouping by date, state, and party
mean_diff = (swing_until_20['pct_estimate'] - swing_until_20['pct_trend_adjusted']).mean()
print('Mean difference between estimated and trend-adjusted percentage in swing states: ' + str(mean_diff))Correlation between estimated and trend-adjusted percentage in swing states: 0.9953626583357665
Mean difference between estimated and trend-adjusted percentage in swing states: 0.24980898513865013We zien dat de correlatie tussen beide extreem hoog is (99,5%), wat te verwachten valt. Het gemiddelde verschil van ongeveer 0,25 procentpunt lijkt klein, maar kan uitmaken in zeer spannende races, zoals verwacht in Nevada of Michigan.
Omdat alle kiesmannen in een staat naar de winnaar gaan, is de volgorde tussen de kandidaten belangrijker dan een exact percentage. Wat we willen vermijden is een discrepantie vlak voor de verkiezingsdatum. Daarom kijken we naar het aantal observaties waarin de koploper tussen de twee percentages verschilde in de laatste verkiezingscyclus (2020) en de laatste datum waarop dat voorkwam.
# Finding out how often pct_estimate and pct_trend_adjusted saw different candidates in the lead in the 2020 race
swing_20 = swing_until_20[swing_until_20['cycle'] == 2020]
# Create a new column to indicate if the ranking is different between pct_estimate and pct_trend_adjusted
swing_20['rank_estimate'] = swing_20.groupby(['state', 'modeldate'])['pct_estimate'].rank(ascending=False)
swing_20['rank_trend_adjusted'] = swing_20.groupby(['state', 'modeldate'])['pct_trend_adjusted'].rank(ascending=False)
# Rows where the rankings are different in swing states
different_rankings_swing = swing_20[swing_20['rank_estimate'] != swing_20['rank_trend_adjusted']]
print('Number of observations with differing leader: ' + str(different_rankings_swing.shape[0] / 2))
print('Last occurrence: ' + str(different_rankings_swing['modeldate'].max()))Number of observations with differing leader: 34.0
Last occurrence: 2020-06-24 00:00:00Blijkbaar verschilde de koploper slechts in 34 gevallen, gemiddeld zo’n 5 dagen per swing state. Omdat de laatste keer eind juni is, lijken alle gevallen in de vroege fase van de campagne te liggen.
Alles afwegend is het onwaarschijnlijk dat die zeldzame veranderingen in koppositie de algehele nauwkeurigheid van het model beïnvloeden, zeker omdat we een flinke dataset hebben over meerdere cycli. Daarom koos ik voor de eerste optie en gebruikte ik overal het geschatte percentage. Dit waarborgt dataconsistentie, wat cruciaal is in machine learning om te voorkomen dat het model vooroordelen leert door verschillende verwerkingsmethoden.
Partijkolom en historische uitslagen toevoegen
Om een kolom voor de politieke partij toe te voegen, halen we eerst een lijst met alle kandidaten in de historische dataset op. Vervolgens maken we een dictionary met kandidaten als sleutels en de bijbehorende partij als waarde—ChatGPT is hier handig voor om zoektijd te besparen! Tot slot combineren we beide in een DataFrame en mergen dat met swing_until_20.
# Get unique candidate names
candidate_names = swing_until_20['candidate_name'].unique().tolist()
# Create a dictionary of candidates and their political party
party_map = {
'Joseph R. Biden Jr.': 'DEM',
'Donald Trump': 'REP',
'Hillary Rodham Clinton': 'DEM',
'Gary Johnson': 'LIB',
'Barack Obama': 'DEM',
'Mitt Romney': 'REP',
'John McCain': 'REP',
'Ralph Nader': 'IND',
'George W. Bush': 'REP',
'John Kerry': 'DEM',
'Al Gore': 'DEM'
}
# Create a DataFrame with candidates and their respective parties
candidate_df = pd.DataFrame(candidate_names, columns=['candidate_name'])
candidate_df['party'] = candidate_df['candidate_name'].map(party_map)
# Merge the candidate_df with swing_until_20 on 'candidate' column
swing_until_20 = swing_until_20.merge(candidate_df[['candidate_name', 'party']], on='candidate_name', how='left')Nu we de partijkolom hebben toegevoegd aan ons swing_until_20-DataFrame, kunnen we de historische verkiezingsuitslagen ermee mergen in een nieuwe kolom vote_share. Omdat het CSV-bestand met vote_share een ander formaat had, moeten we dat aanpassen naar hetzelfde formaat als in de kolom pct_estimate.
# Merging results_until_20 to swing_until_20
swing_until_20 = pd.merge(swing_until_20, results_until_20, how='left', left_on=['cycle', 'state', 'party', 'candidate_name'], right_on=['cycle', 'state', 'party', 'candidate'])
swing_until_20['vote_share'] = swing_until_20['vote_share'].str.replace(',', '.')
swing_until_20['vote_share'] = pd.to_numeric(swing_until_20['vote_share'])Kolommen en kolomnamen alignen
Tot slot hernoemen we de kolom modeldate naar date, verwijderen we overbodige kolommen en passen we het candidate-formaat in de 2024-data aan zodat ook voornamen worden opgenomen.
# Renaming columns in swing_until_20
swing_until_20.rename(columns={'modeldate': 'date'}, inplace=True)
# Keeping only relevant columns
swing_24 = swing_24[['cycle', 'date', 'state', 'party', 'candidate', 'pct_estimate']]
swing_until_20 = swing_until_20[['cycle', 'date', 'state', 'party', 'candidate', 'pct_estimate', 'vote_share']]
# Update candidate names in swing_24 dataframe
swing_24['candidate'] = swing_24['candidate'].replace({
'Trump': 'Donald Trump',
'Biden': 'Joseph R. Biden Jr.',
'Harris': 'Kamala Harris',
'Kennedy': 'Robert F. Kennedy'})Overzicht van de campagne in 2024
Laten we een overzicht krijgen van het verloop van de verkiezingscampagne van 2024 tot nu toe. We gebruiken seaborn en matplotlib om een lijngrafiek te maken die de gemiddelde peilingontwikkeling laat zien over alle geselecteerde swing states. De rode, blauwe en zwarte lijnen tonen de peilingpercentages van respectievelijk Republikeinen, Democraten en onafhankelijke kandidaten. Verticale lijnen markeren belangrijke gebeurtenissen tijdens de campagne.
import matplotlib.pyplot as plt
import seaborn as sns
# Ensure the date column is in datetime format
swing_24['date'] = pd.to_datetime(swing_24['date'])
# Group by date and party, then average the pct_estimate
swing_24_grouped = swing_24.groupby(['date', 'party'])['pct_estimate'].mean().reset_index()
# Create the line chart
plt.figure(figsize=(14, 8))
sns.lineplot(data=swing_24_grouped, x='date', y='pct_estimate', hue='party', marker='o',
palette={'REP': 'red', 'DEM': 'blue', 'IND': 'black'})
# Add vertical lines for significant events
plt.axvline(pd.to_datetime('2024-07-13'), color='red', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-08-05'), color='blue', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-07-23'), color='blue', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-09-05'), color='black', linestyle='--', alpha=0.25)
plt.axvline(pd.to_datetime('2024-10-01'), color='black', linestyle='--', alpha=0.25)
# Add text annotations for significant events
plt.text(pd.to_datetime('2024-07-13'), plt.ylim()[1] * 0.6, 'Trump Assassination Attempt', color='red', ha='right')
plt.text(pd.to_datetime('2024-07-23'), plt.ylim()[1] * 0.5, 'First Harris Rally', color='blue', ha='right')
plt.text(pd.to_datetime('2024-08-05'), plt.ylim()[1] * 0.4, 'Official Nomination of Harris', color='blue', ha='right')
plt.text(pd.to_datetime('2024-09-05'), plt.ylim()[1] * 0.3, 'Presidential Debate', color='black', ha='right')
plt.text(pd.to_datetime('2024-10-01'), plt.ylim()[1] * 0.2, 'Vice Presidential Debate', color='black', ha='right')
# Add horizontal gridlines at values divisible by 5
plt.yticks(range(0, 51, 5))
plt.grid(axis='y', linestyle='--', alpha=0.7)
# Limit the y-axis range to 50
plt.ylim(0, 50)
# Adjust the legend
plt.legend(title='Party')
# Set titles and labels
plt.title('Average Polling Percentage per Party Over Time in Swing States')
plt.xlabel('Date')
plt.ylabel('Average Polling Percentage')
plt.show()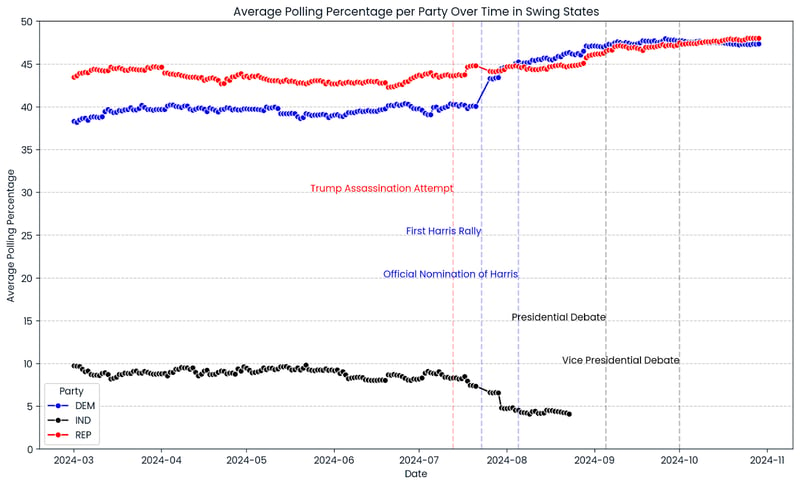
Een eerste blik op het verloop van de peilingen in 2024 laat zien dat het in de swing states heel dicht bij elkaar ligt. De waarderingscijfers van Donald Trump waren gedurende de campagne relatief constant met recent een lichte stijging. Het percentage voor de Democratische Partij trok bij nadat Kamala Harris op 5 augustus 2024 officieel als presidentskandidaat werd genomineerd en lag ruim boven de peilingen van de voormalige kandidaat en president Joe Biden. Hoe dan ook, de grafieken laten veel races zien die te close to call zijn.
Feature engineering voor het voorspellen van de Amerikaanse verkiezingen van 2024
We verkennen vier categorieën features: opponentgerelateerd, tijdbepaald, kandidaatgerelateerd en partijgerelateerd.
Opponentgerelateerde features
Een interessant aspect van deze campagne is de rol van Robert F. Kennedy, wiens peilingspercentages een ongewoon hoge steun voor een onafhankelijke kandidaat suggereren. Hij schortte zijn campagne op 23 augustus 2024 op, wat leidde tot een stijging in de waardering voor zowel Kamala Harris als Donald Trump.
Omdat we willen voorkomen dat onze modellen het verkeerde leren en stempercentages voorspellen die samen meer dan 100% zijn, nemen we het percentage van derden mee als feature.
# Adding the percentage of 3rd party candidates
swing_24['pct_3rd_party'] = swing_24.groupby(['cycle', 'date', 'state'])['pct_estimate'].transform(
lambda x: x[~swing_24['party'].isin(['DEM', 'REP'])].sum()
)
swing_until_20['pct_3rd_party'] = swing_until_20.groupby(['cycle', 'date', 'state'])['pct_estimate'].transform(
lambda x: x[~swing_until_20['party'].isin(['DEM', 'REP'])].sum()
)Nu we de steun voor derde partijen hebben opgenomen, kunnen we recht doen aan het feit dat er realistisch gezien maar twee partijen zijn met een kans op winst. Dienovereenkomstig verwijderen we alle kandidaten van andere partijen dan de Democratische en Republikeinse Partij in beide DataFrames.
# Removing observations of candidates who are not Democrats and Republicans
swing_24 = swing_24[swing_24['party'].isin(['DEM', 'REP'])]
swing_until_20 = swing_until_20[swing_until_20['party'].isin(['DEM', 'REP'])]Twee extra stukjes informatie die ons interesseren zijn het percentage van de opponent op een bepaalde datum in een bepaalde staat, en het verschil (voorsprong of achterstand) ten opzichte van de opponent. We voegen beide features toe met lambda-functies.
# Adding the percentage of the opponent
swing_24['pct_opponent'] = swing_24.apply(
lambda row: swing_24[
(swing_24['date'] == row['date']) &
(swing_24['state'] == row['state']) &
(swing_24['party'] != row['party'])
]['pct_estimate'].sum(),
axis=1
)
swing_until_20['pct_opponent'] = swing_until_20.apply(
lambda row: swing_until_20[
(swing_until_20['date'] == row['date']) &
(swing_until_20['state'] == row['state']) &
(swing_until_20['party'] != row['party'])
]['pct_estimate'].sum(),
axis=1
)
# Adding the lead against the opponent
swing_24['lead'] = swing_24['pct_estimate'] - swing_24['pct_opponent']
swing_until_20['lead'] = swing_until_20['pct_estimate'] - swing_until_20['pct_opponent']Tijdbepaalde features
In het feature-engineeringproces koos ik ervoor om het aantal dagen tot de verkiezing, een voortschrijdend gemiddelde van peilingspercentages gegroepeerd per partij, en momentumindicatoren gegroepeerd per kandidaat op te nemen. Zo vangen we zowel stabiele trends in partijsympathie als snelle verschuivingen in individuele kandidatenpopulariteit.
# Days until election
election_dates = {
2000: pd.to_datetime('2000-11-07'),
2004: pd.to_datetime('2004-11-02'),
2008: pd.to_datetime('2008-11-04'),
2012: pd.to_datetime('2012-11-06'),
2016: pd.to_datetime('2016-11-08'),
2020: pd.to_datetime('2020-11-03')
}
swing_until_20['election_date'] = swing_until_20['cycle'].map(election_dates)
swing_24['election_date'] = pd.to_datetime('2024-11-05')
swing_24['days_until_election'] = (swing_24['election_date'] - swing_24['date']).dt.days
swing_until_20['days_until_election'] = (swing_until_20['election_date'] - swing_until_20['date']).dt.days
# Party 7 days rolling average
swing_24 = swing_24.sort_values(by='date')
swing_24['rolling_avg_7d'] = swing_24.groupby(['state', 'party'])['pct_estimate'].transform(
lambda x: x.rolling(window=7, min_periods=1).mean()
)
swing_until_20 = swing_until_20.sort_values(by='date')
swing_until_20['rolling_avg_7d'] = swing_until_20.groupby(['cycle', 'state', 'party'])['pct_estimate'].transform(
lambda x: x.rolling(window=7, min_periods=1).mean()
)Het aantal dagen tot de verkiezingen als feature opnemen stelt ons in staat het tijdseffect op kiezersvoorkeuren direct te modelleren; peilingen dichter bij verkiezingsdag zijn vaak voorspellender door meer betrokkenheid en vastere meningen. Door het voortschrijdend gemiddelde per partij te groeperen, vlakken we kortetermijnschommelingen af en benadrukken we onderliggende trends.
Tegelijkertijd vangt het groeperen van de momentumindicator per kandidaat de snelle veranderingen in waardering, bijvoorbeeld door campagnemomenten of nieuws. Dit is extra relevant gezien de wissel van Democratische kandidaat halverwege de campagne. We zijn vooral geïnteresseerd in het verschil tussen het momentum van beide kandidaten.
# Calculate the daily change (momentum) for each candidate
swing_24['momentum_candidate'] = swing_24.groupby(['state', 'party'])['pct_estimate'].diff()
swing_until_20['momentum_candidate'] = swing_until_20.groupby(['state', 'party'])['pct_estimate'].diff()
# Calculate the daily change (momentum) for each opponent
swing_24['momentum_opponent'] = swing_24.groupby(['state', 'party'])['pct_opponent'].diff()
swing_until_20['momentum_opponent'] = swing_until_20.groupby(['state', 'party'])['pct_opponent'].diff()
# Calculate the difference between the candidate's momentum and the opponent's momentum
swing_24['momentum'] = swing_24['momentum_candidate'] - swing_24['momentum_opponent']
swing_until_20['momentum'] = swing_until_20['momentum_candidate'] - swing_until_20['momentum_opponent']Kandidaatgerelateerde features
Per kandidaat maken we eerst twee binaire features: of een kandidaat de zittende president is of de zittende vicepresident. Zo kunnen onze modellen rekening houden met effecten van het presidentschap van de kandidaat.
Dit doen we door een lambda-functie toe te passen op beide DataFrames, die de kandidaatnaam en verkiezingscyclus vergelijkt met de dictionaries incumbent_presidents en incumbent_vice_presidents die we hiervoor maken.
incumbent_presidents = {
2000: 'Bill Clinton',
2004: 'George W. Bush',
2008: 'George W. Bush',
2012: 'Barack Obama',
2016: 'Barack Obama',
2020: 'Donald Trump',
2024: 'Joseph R. Biden Jr.'
}
incumbent_vice_presidents = {
2000: 'Al Gore',
2004: 'Richard Cheney',
2008: 'Richard Cheney',
2012: 'Joseph R. Biden Jr.',
2016: 'Joseph R. Biden Jr.',
2020: 'Mike Pence',
2024: 'Kamala Harris'
}
# Adding is_incumbent_president column
swing_until_20['is_incumbent_president'] = swing_until_20.apply(
lambda row: row['candidate'] == incumbent_presidents.get(row['cycle'], ''), axis=1
)
swing_24['is_incumbent_president'] = swing_24.apply(
lambda row: row['candidate'] == incumbent_presidents.get(row['cycle'], ''), axis=1
)
# Adding is_incumbent_vice_president column
swing_until_20['is_incumbent_vice_president'] = swing_until_20.apply(
lambda row: row['candidate'] == incumbent_vice_presidents.get(row['cycle'], ''), axis=1
)
swing_24['is_incumbent_vice_president'] = swing_24.apply(
lambda row: row['candidate'] == incumbent_vice_presidents.get(row['cycle'], ''), axis=1
)Methodologisch heeft het geen zin om dummyfeatures te maken voor kandidaten die in 2024 niet (meer) meedoen of die in 2024 voor het eerst genomineerd zijn. We maken zulke features daarom alleen voor Donald Trump en Biden, omdat er voor beiden data is uit respectievelijk de verkiezingen van 2016 en 2020.
# Create a feature for candidates from 2024 who were candidates in earlier cycles
swing_24['candidate_Donald Trump'] = swing_24['candidate'] == 'Donald Trump'
swing_until_20['candidate_Donald Trump'] = swing_until_20['candidate'] == 'Donald Trump'
swing_24['candidate_Joseph R. Biden Jr.'] = swing_24['candidate'] == 'Joseph R. Biden Jr.'
swing_until_20['candidate_Joseph R. Biden Jr.'] = swing_until_20['candidate'] == 'Joseph R. Biden Jr.'Partijgerelateerde features
Net als bij de zittende kandidaat nemen we een feature op voor de zittende partij. Dat kan de modellen helpen stempercentages nauwkeuriger te voorspellen door historische trends en kiezerssentimenten rond de partij die aan de macht is mee te nemen.
# Define incumbent party for each election
incumbent_party = {
2000: 'DEM',
2004: 'REP',
2008: 'REP',
2012: 'DEM',
2016: 'DEM',
2020: 'REP',
2024: 'DEM'
}
# Define is_incumbent_party
swing_until_20['is_incumbent_party'] = swing_until_20.apply(
lambda row: row['party'] == incumbent_party.get(row['cycle'], ''), axis=1
)
swing_24['is_incumbent_party'] = swing_24.apply(
lambda row: row['party'] == incumbent_party.get(row['cycle'], ''), axis=1
)Wat de partij zelf betreft, zijn er twee opties: ofwel één model per staat en partij, of één model per staat en de partij one-hot encoden in twee features party_DEM en party_REP.
Die laatste optie heeft voordelen boven afzonderlijke modellen per staat en partij. Je gebruikt meer data voor training, verbetert de robuustheid, vereenvoudigt ontwikkeling en hebt flexibiliteit om zowel gedeelde als partijspecifieke patronen te vangen.
# Create duplicate party column for one-hot encoding
swing_24['party_dummy'] = swing_24['party']
swing_until_20['party_dummy'] = swing_until_20['party']
# One-hot encode the duplicate party column in swing_24 and swing_until_20
swing_24 = pd.get_dummies(swing_24, columns=['party_dummy'], prefix='party')
swing_until_20 = pd.get_dummies(swing_until_20, columns=['party_dummy'], prefix='party')Eén ding om in gedachten te houden: we hebben de partijkolom in het oorspronkelijke formaat nodig om de voorspellingen te groeperen. Daarom hebben we die gedupliceerd en one-hot encoding toegepast op de duplicaatkolom.
Natuurlijk zijn er nog veel meer mogelijke features. Zo zouden we demografische of economische indicatoren per staat kunnen gebruiken, maar het uitbreiden van de featureset met andere datasets valt buiten de scope van dit artikel.
Laatste voorbereidingen voor onze machinelearningmodellen
In deze sectie zorgen we dat onze data schoon en klaar is voor de modellen, met focus op het omgaan met missende waarden en het begrijpen van de verdelingen van sleutelvariabelen.
Controleren op missende waarden
Er zijn nog een paar dingen om te verifiëren of de data de juiste structuur heeft voor training. Eerst onderzoeken we of kolommen in beide datasets missende waarden hebben.
# Calculate the number of missing values in each column of swing_until_20
missing_values_until_20 = swing_until_20.isnull().sum()
missing_values_24 = swing_24.isnull().sum()
# Filter out columns that have no missing values
missing_values_until_20 = missing_values_until_20[missing_values_until_20 > 0]
missing_values_24 = missing_values_24[missing_values_24 > 0]
# Display the columns with at least 1 missing value and their respective counts for both dataframes
print(missing_values_until_20, missing_values_24)momentum 84 dtype: int64
momentum 21 dtype: int64Momentum van de kandidaat is de enige kolom met missende waarden. Dat klopt, want die wordt berekend als het dagelijkse verschil tussen peilingen per kandidaat; de eerste observatie zal die kolom dus missen. We kunnen de missende waarden simpelweg verwijderen.
# Dropping missing values
swing_24 = swing_24.dropna()
swing_until_20 = swing_until_20.dropna()Verdelingen analyseren
Door naar de verdelingen van de numerieke kolommen te kijken, krijgen we een beeld of er verborgen uitschieters zijn en of de data plausibel is.
Daarnaast kunnen we de peilingen van de cyclus 2024 vergelijken met het gemiddelde van eerdere cycli. We kunnen sommige features zoals pct_opponent en rolling_avg_7d weglaten, omdat die in essentie afgeleiden zijn van pct_estimate en dus ongeveer dezelfde verdeling hebben.
# Getting description of distributions in both DataFrames
swing_until_20[['pct_estimate', 'lead', 'pct_3rd_party', 'momentum', 'vote_share']].describe()
print(swing_24[['pct_estimate', 'lead', 'pct_3rd_party','momentum']].describe())|
pct_estimate |
lead |
pct_3rd_party |
momentum |
vote_share | |
|
count |
20504 |
20504 |
20504 |
20504 |
20504 |
|
mean |
44.73 |
0.00 |
1.25 |
0.00 |
48.85 |
|
min |
32.65 |
-18.01 |
0.00 |
-8.45 |
40.96 |
|
25% |
42.07 |
-4.94 |
0.00 |
-0.01 |
46.17 |
|
50% |
44.99 |
0.00 |
0.00 |
0.00 |
48.67 |
|
75% |
47.43 |
4.94 |
0.00 |
0.01 |
50.77 |
|
max |
56.47 |
18.01 |
12.67 |
8.45 |
57.97 |
|
std |
3.89 |
6.58 |
2.66 |
0.47 |
3.59 |
|
pct_estimate |
lead |
pct_3rd_party |
momentum | |
|
count |
3228 |
3228 |
3228 |
3228 |
|
mean |
43.53 |
0.00 |
5.87 |
0.00 |
|
min |
35.39 |
-8.77 |
0.00 |
-6.28 |
|
25% |
41.06 |
-2.07 |
0.00 |
-0.12 |
|
50% |
43.76 |
0.00 |
8.01 |
0.00 |
|
75% |
46.56 |
2.07 |
8.91 |
0.12 |
|
max |
48.89 |
8.77 |
12.17 |
6.28 |
|
std |
3.22 |
3.63 |
4.05 |
0.45 |
De verdelingen van de features in zowel swing_until_20 als swing_24 zien er plausibel uit en passen bij peilingsdata in swing states.
De waarden van pct_estimate liggen historisch tussen circa 33% en 56% en in 2024 tussen 35% en 49%, wat logisch is voor competitieve verkiezingen zonder overheersende kandidaat. De vote_share in de historische dataset heeft een gemiddelde van 48,85%, plausibel omdat swing states vaak dicht bij 50-50 zitten.
Zoals verwacht centreren lead en momentum zich rond 0 in beide datasets, wat aangeeft dat voorsprongen, achterstanden, winsten en verliezen elkaar in de tijd uitmiddelen. Lead lijkt bijna perfect normaal verdeeld, terwijl momentum in elk geval symmetrisch is met de meeste waarden dicht bij het gemiddelde.
Historisch volgt pct_estimate een vrij normale verdeling met lichte linksscheefheid: het gemiddelde ligt dicht bij de mediaan en de spreiding is redelijk.
In 2024 liggen de peilingspercentages dichter rond het gemiddelde. De standaarddeviatie van lead is in 2024 (3,63) lager dan historisch (6,58), en het bereik is minder dan de helft van historisch. Dit wijst op nog nauwere marges in 2024.
In de meeste cycli was er geen derde kandidaat met noemenswaardige steun; meer dan 75% van de observaties heeft pct_3rd_party gelijk aan 0 en het gemiddelde is 1,25%. De hoge waarden in 2024 (mediaan 8,01%) weerspiegelen de sterke steun voor de onafhankelijke kandidaat Robert F. Kennedy tot het einde van zijn campagne in augustus 2024.
Voorspellingsstrategie voor de Amerikaanse verkiezingen van 2024
Onze strategie houdt rekening met het feit dat peilingen geen definitieve uitslagen zijn, maar momentopnames van publieke opinie. Daarom vermijden we simpele tijdreeksvoorspellingen die peilingen als directe voorspellingen behandelen. In plaats daarvan gebruiken we regressie die de verkiezingsuitslag per peilingsobservatie voorspelt, niet een tijdlijn van peilingen.
Omdat elke staat zijn eigen politiek landschap heeft, bouwen we een apart model per swing state. Om datalekken te voorkomen en tijdsverloop te respecteren, testen we alleen op onzichtbare data—specifiek: verkiezingscycli na de cycli waarop getraind is. Zo beoordelen we de generaliseerbaarheid naar toekomstige verkiezingen.
Ik koos twee evaluatiecriteria. Omdat de winnaar in elke staat “takes it all”, is het aantal correct voorspelde winnaars over de testcycli de belangrijkste maatstaf.
De Mean Absolute Error (MAE) is het secundaire criterium. Deze meet de gemiddelde foutgrootte tussen voorspelde en werkelijke waarden in dezelfde eenheid als de target—hier: procentpunten stemaandeel. Dat maakt het goed interpreteerbaar en direct relevant.
Tot slot trainen we het beste model per staat op alle cycli tot en met 2020 en passen het toe op 2024. We gebruiken tijdsweging met een exponentiële afnamefunctie om individuele voorspellingen te aggregeren tot één waarde per staat, waarbij recentere peilingen zwaarder tellen.
De keuze van de machinelearningmodellen
Allereerst importeren we de benodigde pakketten. Dit omvat alle modellen die we evalueren, NumPy en de mean_absolute_error.
# Importing models
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression, Ridge, ElasticNet
from sklearn.neighbors import KNeighborsRegressor
from sklearn.neural_network import MLPRegressor
from sklearn.svm import SVR
import catboost
import xgboost as xgb
# Importing other necessary libraries
from sklearn.metrics import mean_absolute_error
import numpy as npDe modellen trainen
Laten we een workflow maken om de basismodellen te trainen en evalueren! We lopen stap voor stap door het proces en passen het dan toe op elke staat voor elke testcyclus, beginnend met 2004.
Om onze modellen af te stemmen op de kenmerken van elke staat, filteren we eerst de dataset zodat alleen data voor de betreffende staat overblijft. Zo vangt het model staatsspecifieke patronen.
# Filter data for the state you're analyzing
data_state = swing_until_20[swing_until_20['state'] == state].copy()Vervolgens definiëren we een wegingsfunctie om meer gewicht toe te kennen aan peilingen dichter bij de verkiezingsdatum. Deze exponentiële afname verlaagt het gewicht van oudere peilingen en benadrukt recentere data.
# Define the weight function (using a typical starting k value)
def compute_weight(days_until_election, k):
return np.exp(-k * days_until_election)
# Add weights to the data
data_state['weight'] = compute_weight(data_state['days_until_election'], k=0.1)Daarna splitsen we de data op in train en test op basis van cycli, zodat we trainen op het verleden en testen op de toekomst en zo datalekken voorkomen. De definitie van train_cycles en test_cycle volgt later als we de loop over de cycli bouwen. We definiëren ook de features en halen de targetvariabele op: het werkelijke stemaandeel.
# Split data into training and testing sets based on election cycles
train_data = data_state[data_state['cycle'].isin(train_cycles)]
test_data = data_state[data_state['cycle'] == test_cycle]
# Define features and target variable
features = ['pct_estimate', 'pct_opponent', 'pct_3rd_party', 'lead', 'rolling_avg_7d',
'days_until_election', 'momentum_candidate', 'momentum_opponent', 'momentum',
'is_incumbent_president', 'is_incumbent_vice_president', 'is_incumbent_party',
'candidate_Donald Trump',
'party_DEM', 'party_REP']
X_train = train_data[features]
y_train = train_data['vote_share']
X_test = test_data[features]
y_test = test_data['vote_share']We definiëren een reeks modellen om te evalueren, waaronder lineaire regressie, ensemblemethoden, support vector machines en neurale netwerken. Door deze variëteit kunnen we vergelijken en het best presterende model per staat kiezen.
# Models to evaluate
models = {
'LinearRegression': LinearRegression(),
'XGBoost': xgb.XGBRegressor(objective='reg:absoluteerror', n_estimators=100, random_state=42),
'CatBoost': catboost.CatBoostRegressor(loss_function='MAE', iterations=100, random_seed=42, verbose=0),
'RandomForest': RandomForestRegressor(n_estimators=100, random_state=42),
'SVR': SVR(kernel='rbf', C=1.0, epsilon=0.1),
'KNeighbors': KNeighborsRegressor(n_neighbors=5),
'MLPRegressor': MLPRegressor(hidden_layer_sizes=(100,), max_iter=500, random_state=42),
'ElasticNet': ElasticNet(alpha=1.0, l1_ratio=0.5, random_state=42),
}Vervolgens loopen we door de dictionary models. Voor elk model trainen we op de trainingsdata van de betreffende staat en voorspellen we op de testdata. Zo kunnen we prestaties vergelijken.
for model_name, model in models.items():
# Train the model
model.fit(X_train, y_train)
# Predict on test data
test_data[f'predicted_{model_name}'] = model.predict(X_test)Binnen de modellus aggregeren we de individuele voorspellingen per partij met de eerder berekende gewichten. Dat levert één voorspeld stemaandeel per partij op, dat we vergelijken met het werkelijke aandeel.
# Aggregate predictions using weights
aggregated_predictions = test_data.groupby('party').apply(
lambda df: np.average(df[f'predicted_{model_name}'], weights=df['weight'])
).reset_index(name='aggregated_prediction')
# Get actual vote shares for comparison
actual_vote_shares = test_data.groupby('party')['vote_share'].mean().reset_index()
comparison = pd.merge(aggregated_predictions, actual_vote_shares, on='party')
comparison.rename(columns={'vote_share': 'actual_vote_share'}, inplace=True)Tot besluit berekenen we de Mean Absolute Error (MAE) tussen de geaggregeerde voorspellingen en de werkelijke aandelen als prestatiemaat. We bepalen ook of het model de winnende partij correct voorspelde en slaan de resultaten op.
# Calculate Mean Absolute Error
mae = mean_absolute_error(comparison['actual_vote_share'], comparison['aggregated_prediction'])
# Check if the predicted winner matches the actual winner
predicted_winner = comparison.loc[comparison['aggregated_prediction'].idxmax(), 'party']
actual_winner = comparison.loc[comparison['actual_vote_share'].idxmax(), 'party']
correct_winner = int(predicted_winner == actual_winner)
# Store the results
results_list.append({
'state': state,
'model_name': model_name,
'test_cycle': test_cycle,
'MAE': mae,
'correct_winner': correct_winner
})Dit proces is verpakt in twee lussen: de buitenste loopt over elke verkiezingscyclus (behalve de eerste, omdat er dan geen trainingsdata is), en de binnenste over elke swing state. Zo trainen en testen we netjes per staat en cyclus en respecteren we de chronologie om datalekken te vermijden.
De inleiding op de code hierboven ziet er zo uit:
# Initialize a list to store results
results_list = []
# Define the election cycles
cycles = [2000, 2004, 2008, 2012, 2016, 2020]
for i in range(1, len(cycles)): # The loop starts at index 1, so with the 2nd cycle (2004)
test_cycle = cycles[i]
train_cycles = cycles[:i] # train_cycles = all cycles before the test_cycle
for state in swing_states:
# Filter data for the state you're analyzing, etc. …Al met al kunnen we zo meerdere modellen over verschillende staten en cycli evalueren en uiteindelijk per staat het best presterende model kiezen op basis van nauwkeurigheid en het correct voorspellen van de winnaar.
Resultaten evalueren en model per staat kiezen
Na het trainen en testen van diverse modellen over staten en cycli evalueren we de prestaties om de beste modellen te vinden. We focussen op twee metrics: het aantal keren dat elk model de winnende partij goed voorspelde (correct_winner) en de gemiddelde Mean Absolute Error (MAE).
Eerst verzamelen we alle resultaten in één DataFrame en aggregeren we de prestatiemetrics:
# After the loop, create a DataFrame from the results list
results_df = pd.DataFrame(results_list)
# Get the sum of correct_winner and the average MAE for every combination of state and model_name
aggregated_evaluation = results_df.groupby(['state', 'model_name']).agg({
'correct_winner': 'sum',
'MAE': 'mean'
}).reset_index()
# Display the maximum number of correct winner predictions and the minimum MAE for each state
print(aggregated_evaluation.groupby('state')['correct_winner'].max())
print(aggregated_evaluation.groupby('state')['MAE'].min())|
state |
Maximum correct_winner |
Minimum MAE |
|
Arizona |
5 |
1.248966 |
|
Georgia |
5 |
0.770760 |
|
Michigan |
4 |
2.685870 |
|
Nevada |
5 |
2.079582 |
|
North Carolina |
5 |
0.917522 |
|
Pennsylvania |
4 |
2.027426 |
|
Wisconsin |
4 |
2.462907 |
Dat ziet er niet slecht uit! In alle staten was er minstens één model dat 4 van de 5 eerdere verkiezingen goed voorspelde. In 4 staten (Arizona, Georgia, Nevada en North Carolina) hadden we zelfs modellen die elke cyclus de winnaar goed voorspelden. De laagste MAE’s laten deels ruimte voor verbetering en verschillen per staat, met gemiddeld 1,74 procentpunt en variërend van 0,77 in Georgia tot 2,69 in Michigan.
Met deze informatie selecteren we vervolgens het best presterende model per staat. We sorteren de modellen eerst op het aantal correcte winnaars en pas daarna op MAE. De gekozen modellen slaan we op in de dictionary best_models.
# Sort the models for each state by correct_winner (descending) and then by MAE (ascending)
sorted_evaluation = aggregated_evaluation.sort_values(by=['state', 'correct_winner', 'MAE'], ascending=[True, False, True])
# Create a dictionary to store the best model for each state
best_models = {}
# Iterate over each state and get the top model
for state in sorted_evaluation['state'].unique():
top_model = sorted_evaluation[sorted_evaluation['state'] == state].iloc[0]
best_models[state] = top_model['model_name']
best_models{'Arizona': 'RandomForest',
'Georgia': 'ElasticNet',
'Michigan': 'LinearRegression',
'Nevada': 'KNeighbors',
'North Carolina': 'CatBoost',
'Pennsylvania': 'KNeighbors',
'Wisconsin': 'MLPRegressor'}De topmodellen verschillen sterk per staat, wat de unieke patronen en peilingsdynamiek weerspiegelt. Verrassend genoeg geeft in Michigan zelfs Linear Regression de beste resultaten, wat suggereert dat een eenvoudiger lineaire aanpak daar volstaat.
Op dit punt zouden we hyperparametertuning kunnen gebruiken om elk model te optimaliseren. Omdat dat extra methodologische vragen oproept en grote codeaanpassingen vergt, valt het buiten de scope van deze toch al lange tutorial. De resultaten van de basismodellen zijn al veelbelovend genoeg om de verkiezingsuitslag van 2024 te durven voorspellen.
Swing states voorspellen in de Amerikaanse verkiezingen van 2024
In de laatste fase gebruiken we de best presterende modellen per swing state om de uitkomst van 2024 te voorspellen. We beginnen met een lege lijst om voorspellingen op te slaan.
Voor elke staat en het bijbehorende beste model herhalen we de workflow van eerder. Alleen loopen we nu niet over cycli, maar trainen we op alle historische data van 2000 t/m 2020 (swing_until_20).
# Initialize a list to store predictions
predictions_list = []
for state, model_name in best_models.items():
# Filter the data for the specific state
state_data_train = swing_until_20[swing_until_20['state'] == state].copy() # Data from 2000 to 2020
state_data_test = swing_24[swing_24['state'] == state].copy() # Data for 2024
# Add weights to the test data
state_data_test['weight'] = compute_weight(state_data_test['days_until_election'], k=0.1)
# Define features
features = [
'pct_estimate',
'pct_opponent',
'pct_3rd_party',
'lead',
'rolling_avg_7d',
'days_until_election',
'momentum_candidate',
'momentum_opponent',
'momentum',
'is_incumbent_president',
'is_incumbent_vice_president',
'is_incumbent_party',
'candidate_Donald Trump',
'party_DEM',
'party_REP'
]
# Split features and target variable
X_train = state_data_train[features]
y_train = state_data_train['vote_share']
X_test = state_data_test[features]
# Train the model on the 2000 to 2020 data
model.fit(X_train, y_train)
# Predict on the 2024 data
state_data_test['predicted_vote_share'] = model.predict(X_test)
# Aggregate predictions using weights
aggregated_predictions = state_data_test.groupby('party').apply(
lambda df: np.average(df['predicted_vote_share'], weights=df['weight'])
).reset_index(name='aggregated_prediction')
# Append predictions to the list
for _, pred_row in aggregated_predictions.iterrows():
predictions_list.append({
'state': state,
'party': pred_row['party'],
'predicted_vote_share': pred_row['aggregated_prediction'],
'model': model_name
})Na het voorspellen van de kolom vote_share, het aggregeren met de wegingsfunctie en het toevoegen aan predictions_list, consolideren we de uiteindelijke voorspellingen in een DataFrame. We voegen ook een ranking per staat toe en pivotten de voorspellingen per staat. Dit zijn de voorspellingen van onze modellen:
# Convert predictions list to DataFrame
predictions_df = pd.DataFrame(predictions_list)
# Add a rank to predictions_df for each state based on the order of predicted_vote_share
predictions_df['rank'] = predictions_df.groupby('state')['predicted_vote_share'].rank(ascending=False)
# Create a pivot table indexed by state
predictions_pivot = predictions_df.pivot(index='state', columns='party', values='predicted_vote_share')
# Display predictions
print("\n2024 Vote Share Predictions:")
predictions_pivot2024 Vote Share Predictions:
state
DEM
REP
Arizona
49.02
50.31
Georgia
48.95
50.08
Michigan
50.34
48.64
Nevada
49.41
48.54
North Carolina
48.95
50.06
Pennsylvania
49.57
49.20
Wisconsin
49.66
49.41De voorspellingen bevestigen dat het een nek-aan-nekrace is in de swing states. Volgens onze modellen winnen vier staten voor Kamala Harris (Michigan, Nevada, Pennsylvania, Wisconsin) en drie voor Donald Trump (Arizona, Georgia, North Carolina). Vooral Pennsylvania en Wisconsin lijken extreem spannend, met verschillen van slechts respectievelijk 0,37 en 0,25 procentpunt tussen de voorspelde aandelen.
US Election 2024 Prediction
Zoals eerder genoemd gaan we ervan uit dat alle andere staten stemmen zoals verwacht; de “blauwe” staten voor Kamala Harris en de “rode” voor Donald Trump. Om te bepalen hoeveel kiesmannen elke kandidaat krijgt, definiëren we een dictionary met per staat en district het aantal kiesmannen en combineren we dat in een DataFrame electoral_votes_df.
# Define the number of electoral votes per state for the 2024 US-Presidential elections
electoral_votes = {
'Alabama': 9, 'Alaska': 3, 'Arizona': 11, 'Arkansas': 6, 'California': 54,
'Colorado': 10, 'Connecticut': 7, 'Delaware': 3, 'District of Columbia': 3,
'Florida': 30, 'Georgia': 16, 'Hawaii': 4, 'Idaho': 4, 'Illinois': 19,
'Indiana': 11, 'Iowa': 6, 'Kansas': 6, 'Kentucky': 8, 'Louisiana': 8,
'Maine': 2, 'Maryland': 10, 'Massachusetts': 11, 'Michigan': 15,
'Minnesota': 10, 'Mississippi': 6, 'Missouri': 10, 'Montana': 4,
'Nebraska': 2, 'Nevada': 6, 'New Hampshire': 4, 'New Jersey': 14,
'New Mexico': 5, 'New York': 28, 'North Carolina': 16, 'North Dakota': 3,
'Ohio': 17, 'Oklahoma': 7, 'Oregon': 8, 'Pennsylvania': 19,
'Rhode Island': 4, 'South Carolina': 9, 'South Dakota': 3,
'Tennessee': 11, 'Texas': 40, 'Utah': 6, 'Vermont': 3, 'Virginia': 13,
'Washington': 12, 'West Virginia': 4, 'Wisconsin': 10, 'Wyoming': 3
}
# Create a DataFrame from the dictionary
electoral_votes_df = pd.DataFrame(list(electoral_votes.items()), columns=['State', 'Electoral Votes'])
# Handle states that divide their votes into multiple districts (Maine and Nebraska)
districts = {'ME-1': 1, 'ME-2': 1, 'NE-1': 1, 'NE-2': 1, 'NE-3': 1}
# Add the districts to the DataFrame
districts_df = pd.DataFrame(list(districts.items()), columns=['State', 'Electoral Votes'])
# Combine the two DataFrames
electoral_votes_df = pd.concat([electoral_votes_df, districts_df], ignore_index=True)Vervolgens maken we twee lijsten, harris en trump, met respectievelijk de blauwe en rode staten, plus de swing states die volgens onze voorspellingen door elke kandidaat worden gewonnen. Daarna filteren we electoral_votes_df op de staten in elke lijst en berekenen we de som van de kiesmannen per kandidaat.
# Extract states from predictions_df where party is DEM and rank is 1
additional_blue_states = predictions_df[
(predictions_df['party'] == 'DEM') & (predictions_df['rank'] == 1)
].state.tolist()
# Extract states from predictions_df where party is REP and rank is 1
additional_red_states = predictions_df[
(predictions_df['party'] == 'REP') & (predictions_df['rank'] == 1)
].state.tolist()
# Combine blue_states and additional_blue_states into a single list
harris = list(set(blue_states + additional_blue_states))
trump = list(set(red_states + additional_red_states))
# Filter the electoral votes for states in each candidate's list
harris_electoral_votes = electoral_votes_df[electoral_votes_df['state'].isin(harris)]
trump_electoral_votes = electoral_votes_df[electoral_votes_df['state'].isin(trump)]
# Sum the electoral votes
sum_harris_electoral_votes = harris_electoral_votes['electoral_votes'].sum()
sum_trump_electoral_votes = trump_electoral_votes['electoral_votes'].sum()
print(
f'According to the predictions made by the machine learning models, '
f'Kamala Harris will win {sum_harris_electoral_votes} electoral votes '
f'and Donald Trump will win {sum_trump_electoral_votes} electoral votes.'
)According to the predictions made by the machine learning models, Kamala Harris will win 276 electoral votes and Donald Trump will win 262 electoral votes.De voorspelling is dat Kamala Harris 276 kiesmannen wint en Donald Trump 262. Als onze aannames en voorspellingen kloppen, ziet de kieskaart er op 5 november zo uit:
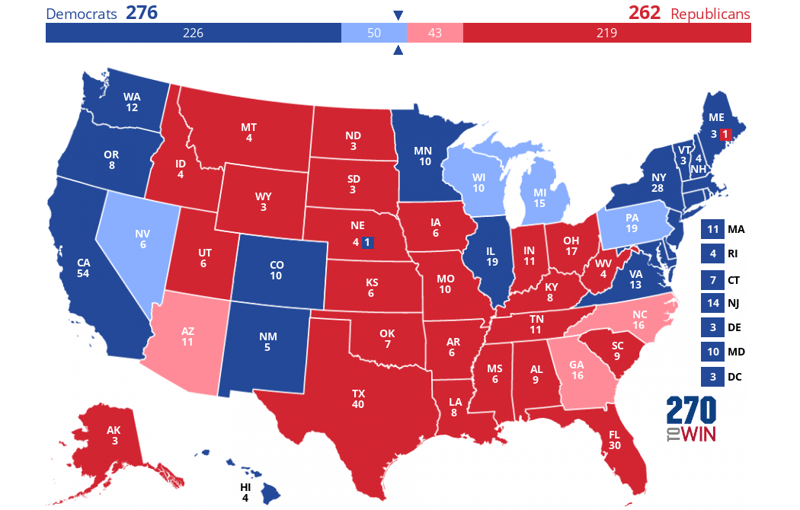
Gemaakt met deze interactieve kaartmaker.
De donkere kleuren staan voor de “blauwe” of “rode” staten zoals aangenomen. De door ons voorspelde swing states maken het verschil—die zijn in lichter blauw of rood weergegeven.
Conclusie
In dit project gebruikten we historische peilingen om de uitslag van de Amerikaanse presidentsverkiezingen van 2024 te voorspellen. Zoals verwacht wijzen onze modellen op een nek-aan-nekrace tussen de koplopers.
Belangrijk: onze analyse is uitsluitend gebaseerd op peilingen, die soms onnauwkeurig zijn en niet alle nuances van een verkiezing vangen. Factoren zoals peilmethoden, opkomst, campagnedynamiek, economische en demografische omstandigheden en onvoorziene gebeurtenissen zijn niet meegenomen, maar kunnen de uitslag sterk beïnvloeden.
Toch laat deze verkenning zien wat predictive analytics kan betekenen voor complexe systemen als verkiezingen. Wil je meer leren over voorspellende analyse met Python? Dan raad ik deze bronnen aan:
Disclaimer: Deze tutorial is niet politiek van aard—de aankomende Amerikaanse presidentsverkiezingen dienen alleen als kapstok voor educatieve content over machine learning. Meningen zijn van mij en vertegenwoordigen niet de standpunten van DataCamp.
Na het succesvol voorspellen van de uitslagen van EURO 2024 met machine learning, heb ik mijn focus verlegd naar een nog spannender evenement: de Amerikaanse presidentsverkiezingen van 2024.
Omdat de race waarschijnlijk nek-aan-nek wordt tussen vicepresident Kamala Harris en voormalig president Donald Trump, laten we met machine learning voorspellen wie er wint!
Ik schreef deze blog voor een technisch publiek dat bekend is met Python en machine learning. Wil je alleen de uitkomst zien? Ga dan direct naar de laatste sectie met de titel “US Election 2024 Prediction.”
Wil je de code zelf proberen? Ik heb alles beschikbaar gemaakt in dit DataLab-notebook.