
Last chance! 50% off DataCamp Premium
Sale ends in
2026 के उत्तरार्ध में फ्रंटियर मॉडल रेस क्षमता से ज्यादा कीमत की होड़ बन गई है। सिर्फ सितंबर में ही हमने देखा कि OpenAI का GPT-6 Astra और Anthropic का Claude Fable 5.1 दोनों 1M इनपुट टोकन पर $10 और 1M आउटपुट टोकन पर $50 पर बैठे हैं, और किसी का भी फ्री टियर में उपलब्ध होना नहीं है।
DeepSeek का जवाब बिल्कुल उलटी दिशा में जाना है।
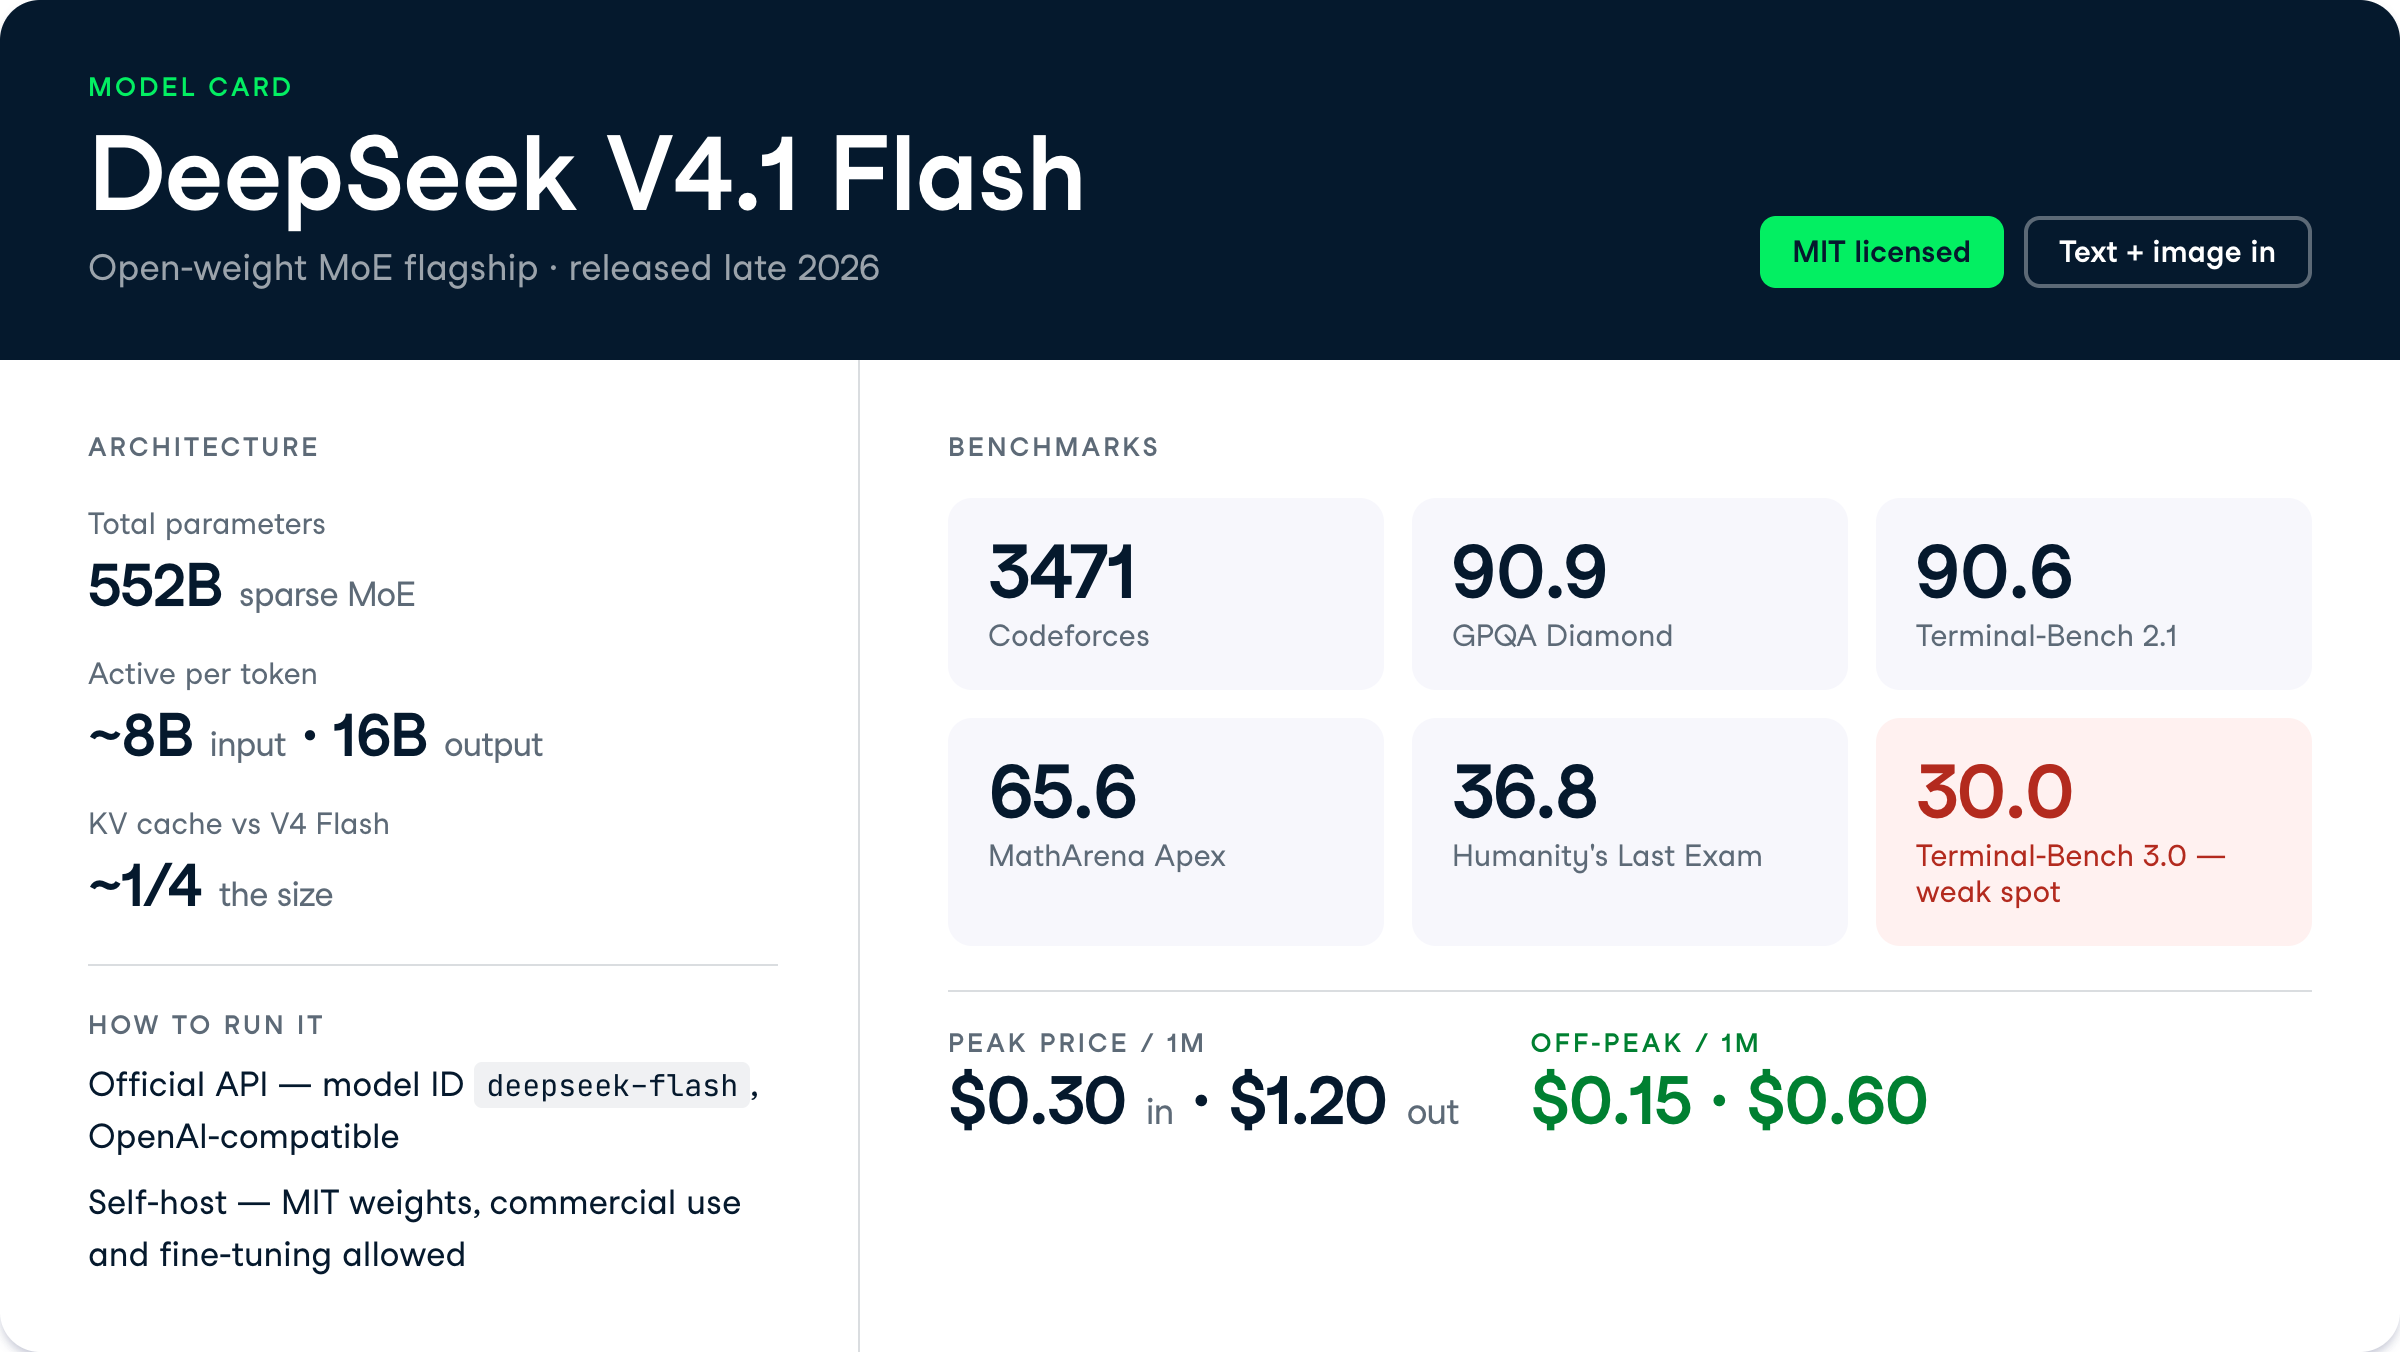
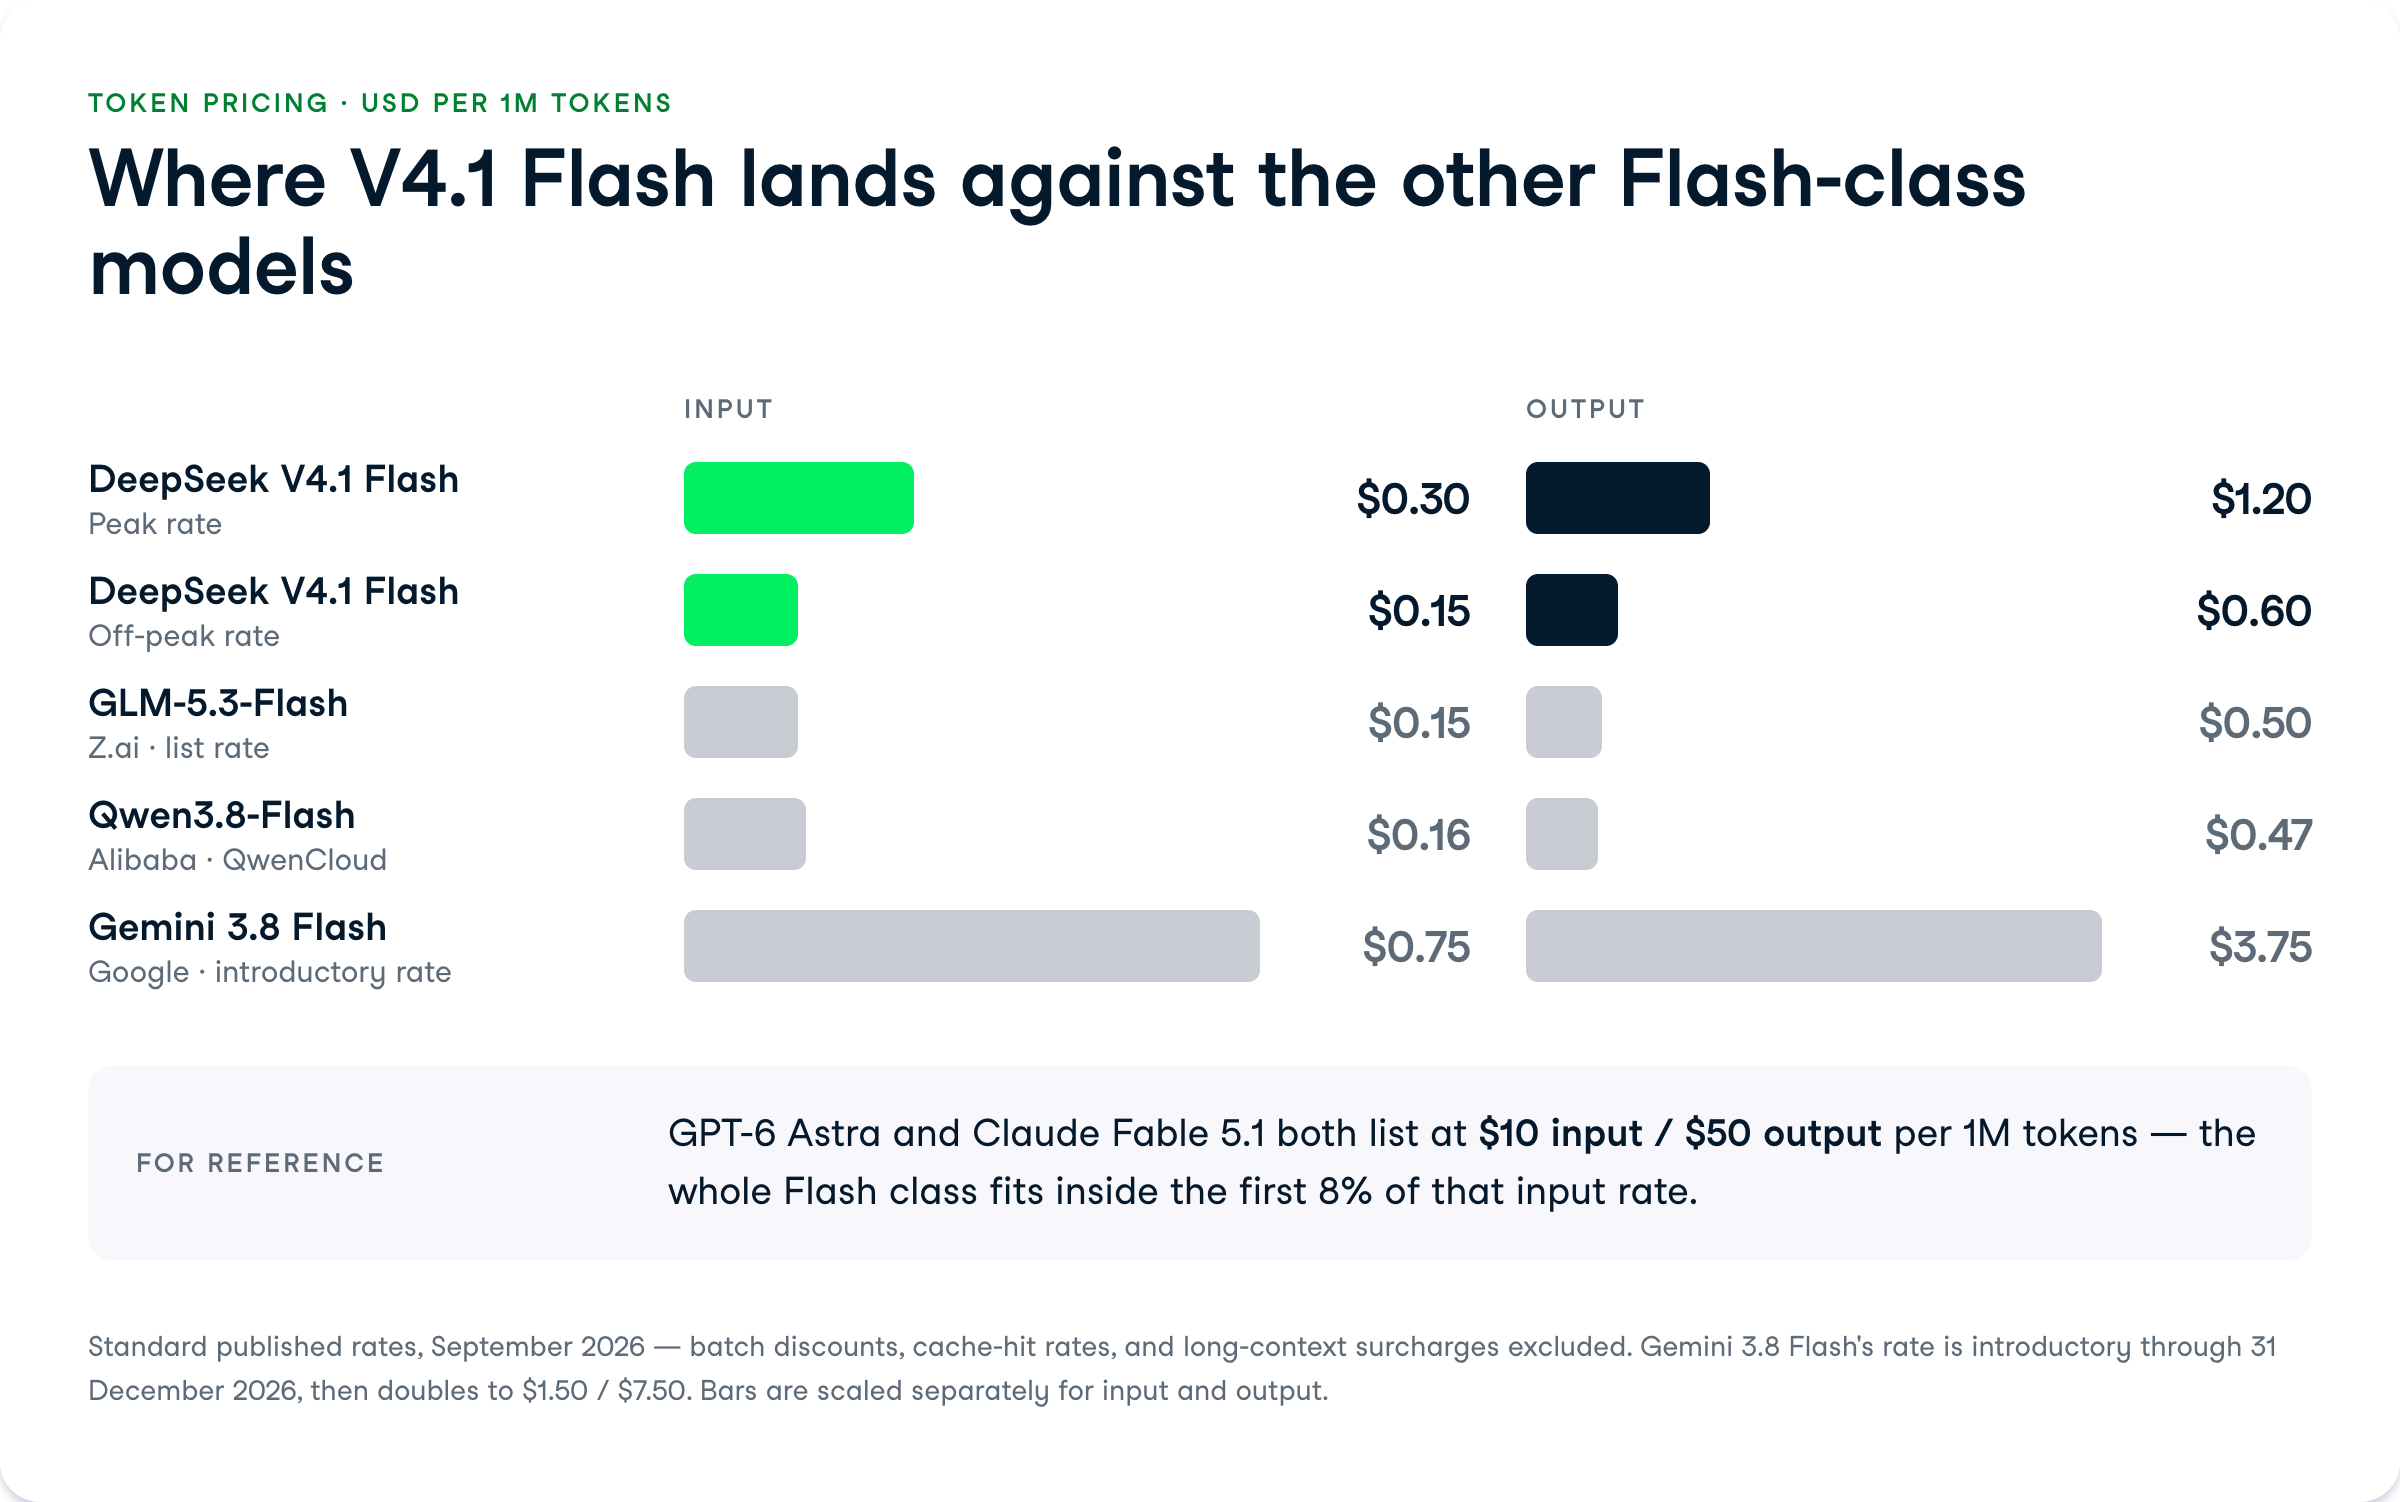
DeepSeek V4.1 Flash एक 552B-पैरामीटर का mixture-of-experts (MoE) मॉडल है, जो इनपुट पर लगभग 8B और आउटपुट पर 16B पैरामीटर सक्रिय करता है, MIT-लाइसेंस्ड ओपन वेट्स के साथ आता है, और पीक पर प्रति 1M टोकन $0.30/$1.20 की कीमत पर उपलब्ध है, जो ऑफ-पीक में घटकर $0.15/$0.60 हो जाती है—अन्य समान फ्लैश मॉडलों जैसे Gemini 3.8 Flash और GLM-5.3-Flash को पछाड़ते हुए।
इस लेख में, मैं DeepSeek V4.1 Flash की नई बातें कवर करूंगा, नए फीचर्स पर नज़र डालूंगा और बेंचमार्क्स को एक्सप्लोर करूंगा। यदि आप मॉडल को एक्शन में देखना चाहते हैं, तो हमारा DeepSeek V4.1 API ट्यूटोरियल पढ़ें।
DeepSeek परिवार के बारे में और जानने के लिए, हमारा गाइड देखें: Unsloth Studio और OpenCode के साथ DeepSeek-V4-Flash-0731 चलाना, और हमारी तुलना DeepSeek v4.1 Flash बनाम Gemini 3.8 Flash।
DeepSeek V4.1 Flash, DeepSeek की फ्लैश लाइन का नवीनतम मॉडल है, जिसे शोध-ग्रेड हेवीवेट की बजाय कुशल, हाई-थ्रूपुट टियर के रूप में रखा गया है।
यह 552B कुल पैरामीटर्स वाला एक स्पार्स mixture-of-experts (MoE) आर्किटेक्चर है, जिसमें प्रति टोकन इनपुट पर केवल लगभग 8B और आउटपुट पर 16B पैरामीटर्स सक्रिय होते हैं। यही स्पार्स एक्टिवेशन सर्विंग लागत को कम रखता है, जबकि कई बेंचमार्क्स पर फ्रंटियर-स्तरीय स्कोर तक पहुंचता है।
पिछली पीढ़ी की तुलना में हेडलाइन बदलाव कुशलता है।
DeepSeek ने KV कैश को पिछले V4 Flash के आकार के लगभग एक-चौथाई तक सिकोड़ दिया है, जिससे मेमोरी फुटप्रिंट घटता है और लंबा कॉन्टेक्स्ट सस्ते में सर्व करना संभव होता है। कंपनी का यह भी कहना है कि V4.1 Flash प्रदर्शन, लागत, गति और कुल समय में पुराने V4 Pro 0813 से आगे निकल जाता है, और परिणामस्वरूप V4 Pro को चरणबद्ध तरीके से हटाया जा रहा है।
बेंचमार्क मोर्चे पर, जो संख्या सबसे अलग दिखती है, वह है Terminal-Bench 2.1 पर 90.6। जब हमने पहले DeepSeek-V4-Flash-0731 का परीक्षण किया था, तो उसने इसी बेंचमार्क पर 82.7 स्कोर किया था, इसलिए V4.1 Flash उसी परिवार के भीतर एजेंटिक टर्मिनल कार्य पर वास्तविक रूप से बेहतर कदम है।
V4.1 Flash का फीचर सेट दो विचारों के इर्द-गिर्द बना है: सस्ता चलना, और ओपन रहना। यहां वे क्षमताएं हैं जो किसी कामकाजी डेटा वैज्ञानिक या ML इंजीनियर के लिए सबसे ज्यादा मायने रखती हैं।
V4.1 Flash MIT-लाइसेंस्ड वेट्स के साथ आता है, जो सबसे उदार आम लाइसेंस है और बिना किसी रेवेन्यू थ्रेशहोल्ड के वाणिज्यिक उपयोग, पुनर्वितरण और फाइन-ट्यूनिंग की अनुमति देता है।
डेटा-प्राइवेसी बाधाओं वाली टीमों के लिए, इसका मतलब है कि आप मॉडल को पूरी तरह अपने हार्डवेयर पर चला सकते हैं, बजाय इसके कि रिक्वेस्ट्स DeepSeek API को भेजें।
ट्रेड-ऑफ यह है कि MIT लाइसेंस सुरक्षा, फाइन-ट्यूनिंग, और इन्फरेंस ऑप्टिमाइज़ेशन की जिम्मेदारी आप पर डाल देता है।
जब हमने पहले V4-Flash-0731 को लोकली चलाया, तो उसे Q8 क्वांटाइजेशन पर तीन NVIDIA A100 80GB GPUs की जरूरत थी, इसलिए सेल्फ-होस्टिंग तभी व्यवहार्य है जब आपके पास वास्तविक GPU मेमोरी उपलब्ध हो।
V4.1 Flash सीधे इमेजेज़ को इनपुट के रूप में स्वीकार करता है, बिना किसी अलग विज़न एडेप्टर या प्रीप्रोसेसिंग स्टेप के। इससे आप स्क्रीनशॉट्स, चार्ट्स, या डॉक्युमेंट स्कैन को टेक्स्ट के साथ एक ही रिक्वेस्ट में भेज सकते हैं, जो डॉक्युमेंट-हेवी पाइपलाइंस और UI-एजेंट वर्कफ़्लोज़ के लिए उपयोगी है।
इस प्राइस पॉइंट पर नैटिव मल्टीमॉडल इनपुट असामान्य है। टूल्स के साथ ZeroBench-main इवैल्युएशन पर, V4.1 Flash 49.0 स्कोर करता है, जो यह मोटा-मोटा संकेत देता है कि यह विज़ुअल इनपुट्स पर रीज़निंग को कैसे हैंडल करता है।
V4.1 Flash में KV कैश पिछले V4 Flash के आकार के लगभग एक-चौथाई है, जो सर्विंग सेशन में लंबे कॉन्टेक्स्ट को होल्ड करने की मेमोरी लागत को घटाता है।
जो कोई भी हमेशा-ऑन इन्फरेंस चलाता है, उसके लिए छोटा KV कैश या तो प्रति GPU अधिक समकालिक सेशन्स या प्रति-रिक्वेस्ट कम मेमोरी ओवरहेड का मतलब है।
इसे कैश-हिट इनपुट की पीक कीमत $0.006 प्रति 1M टोकन के साथ मिलाकर, कॉन्टेक्स्ट रीयूज़ अत्यंत सस्ता हो जाता है। यदि आप बार-बार वही सिस्टम प्रॉम्प्ट या डॉक्युमेंट रिक्वेस्ट्स में भेजते हैं, तो कैश्ड हिस्सा लगभग मुफ्त पड़ता है।
DeepSeek दो-स्तरीय प्राइसिंग स्कीम चलाता है, जिसमें ऑफ-पीक कीमतें पीक के आधे पर सेट होती हैं, जिसका घोषित उद्देश्य बैच और शेड्यूल्ड वर्कलोड्स को ऑफ-पीक विंडोज़ में धकेलना है। यदि आप अपने जॉब्स का समय तय कर सकते हैं, तो यह $0.30/$1.20 को $0.15/$0.60 प्रति 1M टोकन में बदल देता है।
चेतावनी ऑपरेशनल है। हमेशा-ऑन वर्कलोड्स की लागत का अनुमान लगाना कठिन हो जाता है, और छूट पकड़ने के लिए जॉब-शेड्यूलिंग लॉजिक की जरूरत पड़ती है जिसे आपको खुद बनाना और बनाए रखना होगा।
V4.1 Flash की सबसे मजबूत झलक एजेंटिक और रीज़निंग बेंचमार्क्स पर है, जहां यह टोकन लागत के एक अंश पर फ्रंटियर-एडजेसेंट स्कोर तक पहुंचता है।
सबसे कठिन एजेंटिक इवैल्यूएशन्स पर इसके स्कोर तीखे तौर पर गिरते हैं, जिसे लंबे क्षितिज वाले कार्यों पर भेजने से पहले जानना जरूरी है।
V4.1 Flash Terminal-Bench 2.1 पर 90.6 स्कोर करता है, जो यह मापता है कि कोई मॉडल टर्मिनल वातावरण में मल्टी-स्टेप टास्क्स को कितना अच्छी तरह पूरा करता है।
स्केल के लिए, DeepSeek-V4-Flash-0731 ने हमारे परीक्षण में इसी बेंचमार्क पर 82.7 स्कोर किया, और GPT-5.6 Terra ने हमारी Terra बनाम Sonnet 5 तुलना में 87.4 हासिल किया।
कठिनतर एजेंटिक इवैल्यूएशन्स पर तस्वीर बदल जाती है।
V4.1 Flash Terminal-Bench 3.0 पर 30.0 तक गिर जाता है, इसलिए मॉडल मानक टर्मिनल कार्यों को अच्छी तरह संभालता है, लेकिन अधिक मांग वाले एजेंटिक सूट में जूझता है। इसका Codeforces रेटिंग 3471 मजबूत प्रतिस्पर्धी-प्रोग्रामिंग क्षमता का संकेत देती है।
GPQA Diamond पर, जो ग्रेजुएट-लेवल के विज्ञान प्रश्नों का सेट है जिन्हें केवल स्मृति से उत्तर देना कठिन बनाया गया है, V4.1 Flash 90.9 स्कोर करता है।
यह इस प्राइस बैंड के लिए मजबूत परिणाम है और इसे कहीं ज्यादा महंगे फ्रंटियर मॉडलों की बातचीत में ला देता है।
Humanity's Last Exam (HLE), एक जानबूझकर बेहद कठिन विशेषज्ञ-स्तरीय बेंचमार्क, पर V4.1 Flash 36.8 स्कोर करता है, या स्टार्ड कॉन्फ़िगरेशन के साथ 39.1।
तुलना के लिए, एजेंटिक-विज्ञान इवैल्यूएशन्स जैसे Terminal-Bench-Science 0.1 पर Claude Fable 5.1 52.6% दिखाता है, तो V4.1 Flash सबसे कठिन विशेषज्ञ इवैल्स में टॉप पर नहीं है, लेकिन खुद को शर्मिंदा भी नहीं करता।
V4.1 Flash MathArena Apex पर 65.6 स्कोर करता है, जो एक प्रतियोगी-गणित बेंचमार्क है जो मल्टी-स्टेप सांकेतिक रीज़निंग को पुरस्कृत करता है।
यह मॉडल के मजबूत परिणामों में से एक है और संकेत देता है कि यह क्वांटिटेटिव और गणित-प्रधान वर्कलोड्स के लिए उचित विकल्प है।
यहां मिड-60s का स्कोर उन सभी के लिए महत्वपूर्ण है जो ऐसे टूल्स बना रहे हैं जिन्हें विश्वसनीय अंकगणित और बीजीय रीज़निंग की जरूरत है, क्योंकि कई सस्ते मॉडल ठीक इन्हीं कार्यों पर धराशायी हो जाते हैं।
निर्णय यहां मॉडल वेरिएंट्स से कम और इस बात से ज्यादा जुड़ा है कि आप V4.1 Flash को कैसे डिप्लॉय करते हैं, क्योंकि एक ही वेट्स तीन तरीकों से चलते हैं। आपकी पसंद लागत-पूर्वानुमेयता, डेटा प्राइवेसी, और क्या आप जॉब्स शेड्यूल कर सकते हैं, पर निर्भर करती है।
DeepSeek एक माइग्रेशन अवधि भी चला रहा है। 14 सितंबर, 2026 को बीजिंग समय दोपहर 12:00 से लेकर भविष्य में V4.1 Pro के रिलीज़ तक, लेगेसी एंडपॉइंट्स पर आने वाले रिक्वेस्ट्स को रीडायरेक्ट किया जा रहा है, जो मौजूदा उपयोगकर्ताओं को V4.1 परिवार की ओर धकेलता है। यदि आप अभी भी V4 Pro 0813 पर हैं, तो वह मॉडल चरणबद्ध तरीके से हटाया जा रहा है, इसलिए अभी V4.1 Flash पर जाने की योजना बनाएं।
| उपयोग का मामला | सिफारिशित रास्ता | क्यों |
|---|---|---|
| हाई-वॉल्यूम, हमेशा-ऑन कोडिंग एजेंट | ऑफिशियल API, पीक प्राइसिंग | प्रति 1M $0.30/$1.20 पहले ही फ्रंटियर प्रतिद्वंद्वियों से काफी कम है; शेड्यूलिंग ओवरहेड नहीं |
| बड़े बैच रीज़निंग या गणित जॉब्स | ऑफिशियल API, ऑफ-पीक | ऑफ-पीक रेट को आधा कर $0.15/$0.60 प्रति 1M कर देता है, यदि आप रन शेड्यूल कर सकें |
| संवेदनशील या स्वामित्व डेटा | MIT वेट्स को सेल्फ-होस्ट करें | इन्फरेंस को आपके अपने हार्डवेयर पर रखता है; वास्तविक GPU मेमोरी की आवश्यकता |
| भारी कॉन्टेक्स्ट रीयूज़ | प्रॉम्प्ट कैशिंग के साथ API | प्रति 1M $0.006 का कैश-हिट इनपुट दोहराए गए कॉन्टेक्स्ट को लगभग मुफ्त कर देता है |
V4.1 Flash सबसे सस्ते सक्षम मॉडलों में से एक है, खासकर ऑफ-पीक पर। यहां टोकन प्राइसिंग का ब्रेकडाउन है।
| रेट | पीक | ऑफ-पीक |
|---|---|---|
| प्रति 1M टोकन इनपुट | $0.30 | $0.15 |
| प्रति 1M टोकन आउटपुट | $1.20 | $0.60 |
| प्रति 1M टोकन कैश-हिट इनपुट | $0.006 | प्रकाशित नहीं |
ऑफ-पीक कीमतें पीक के आधे पर सेट होती हैं, और यह स्कीम बैच और शेड्यूल्ड वर्कलोड्स को ऑफ-पीक विंडोज़ में धकेलने के लिए डिज़ाइन की गई है।
पीक रेट को संदर्भ में रखने के लिए, GPT-6 Astra और Claude Fable 5.1 दोनों 1M इनपुट पर $10 और 1M आउटपुट पर $50 चार्ज करते हैं, तो V4.1 Flash पीक पर इनपुट में लगभग 30x और आउटपुट में 40x सस्ता है।
जो मॉडल चरणबद्ध तरीके से हटाया जा रहा है, V4 Pro 0813, उसकी कीमत 1M टोकन कॉन्टेक्स्ट के साथ 1M इनपुट पर $0.435 और 1M आउटपुट पर $0.87 है।
क्योंकि DeepSeek का दावा है कि V4.1 Flash प्रदर्शन, लागत और गति में V4 Pro से आगे है, पुराने मॉडल पर रहने का बहुत कम कारण है।
V4.1 Flash आधिकारिक DeepSeek API के जरिए उपलब्ध है, और इसके MIT-लाइसेंस्ड वेट्स सेल्फ-होस्टिंग के लिए प्रकाशित हैं।
14 सितंबर, 2026 से, लेगेसी एंडपॉइंट रिक्वेस्ट्स को V4.1 परिवार की ओर रीडायरेक्ट किया जा रहा है, जब तक कि V4.1 Pro शिप न हो जाए।
V4.1 Flash एक API मॉडल भी है और एक ओपन-वेट रिलीज़ भी, इसलिए आप इसे दो तरीकों से इस्तेमाल कर सकते हैं।
API पर, मॉडल ID आमतौर पर deepseek-flash के रूप में सूचीबद्ध है, और एंडपॉइंट OpenAI-कम्पैटिबल है, जिसका मतलब है कि अधिकांश मौजूदा OpenAI क्लाइंट कोड बेस URL बदलकर काम कर जाते हैं।
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
सेल्फ-होस्ट करने के लिए, MIT-लाइसेंस्ड वेट्स बिना किसी रेवेन्यू थ्रेशहोल्ड के वाणिज्यिक उपयोग, पुनर्वितरण और फाइन-ट्यूनिंग की अनुमति देते हैं।
जब हमने पहले V4-Flash-0731 को Unsloth Studio के साथ लोकली चलाया, तो Q8 क्वांटाइजेशन पर इसे तीन NVIDIA A100 80GB GPUs की जरूरत पड़ी, इसलिए फुल-प्रिसिजन सेटअप के लिए भी इसी तरह के हार्डवेयर का बजट रखें।
पूरे लोकल वॉकथ्रू के लिए, हमारा ट्यूटोरियल देखें: Unsloth Studio और OpenCode के साथ DeepSeek-V4-Flash चलाना, जो GPU डिस्ट्रीब्यूशन और इन्फरेंस सेटअप को विस्तार से कवर करता है।
V4.1 Flash कीमत और openness पर DeepSeek का बयान है, जबकि बाकी फ्रंटियर प्रति 1M टोकन $10/$50 की ओर बढ़ रहा है और एक्सेस को पेड टियर्स के पीछे सीमित कर रहा है।
MIT वेट्स, नैटिव इमेज इनपुट, GPQA Diamond पर 90.9, और GPT-6 Astra से 30x कम पीक प्राइसिंग के साथ 552B MoE मॉडल हाई-वॉल्यूम वर्कलोड्स के लिए गंभीर ऑफर है।
मैं कोडिंग एजेंट्स और बैच रीज़निंग जॉब्स के लिए इस पर स्विच करूंगा, खासकर यदि आप ऑफ-पीक शेड्यूल कर सकते हैं।
नकारात्मकताएं वहां आती हैं जहां आप Terminal-Bench 3.0 पर 30.0 का स्कोर देखते हैं, जो दिखाता है कि यह सबसे कठिन एजेंटिक टास्क्स पर लड़खड़ाता है, और पीक/ऑफ-पीक बिलिंग वह शेड्यूलिंग कार्य जोड़ती है जिसे आपको खुद संभालना होगा।
यदि आप ऐसे मॉडलों के इर्द-गिर्द एजेंट वर्कफ़्लोज़ बनाना चाहते हैं, तो हमारा AI Agent Fundamentals स्किल ट्रैक शुरू करने के लिए अच्छा स्थान है।
शीर्ष DataCamp कोर्स
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
