Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.7K
A corrida por modelos de ponta no fim de 2026 virou, em grande parte, uma disputa de preço — não apenas de capacidade. Só em setembro, vimos o GPT-6 Astra da OpenAI e o Claude Fable 5.1 da Anthropic fixarem preços em $10 por 1M de tokens de entrada e $50 por 1M de tokens de saída, sem opção em camadas gratuitas.
A resposta da DeepSeek foi ir na direção oposta.
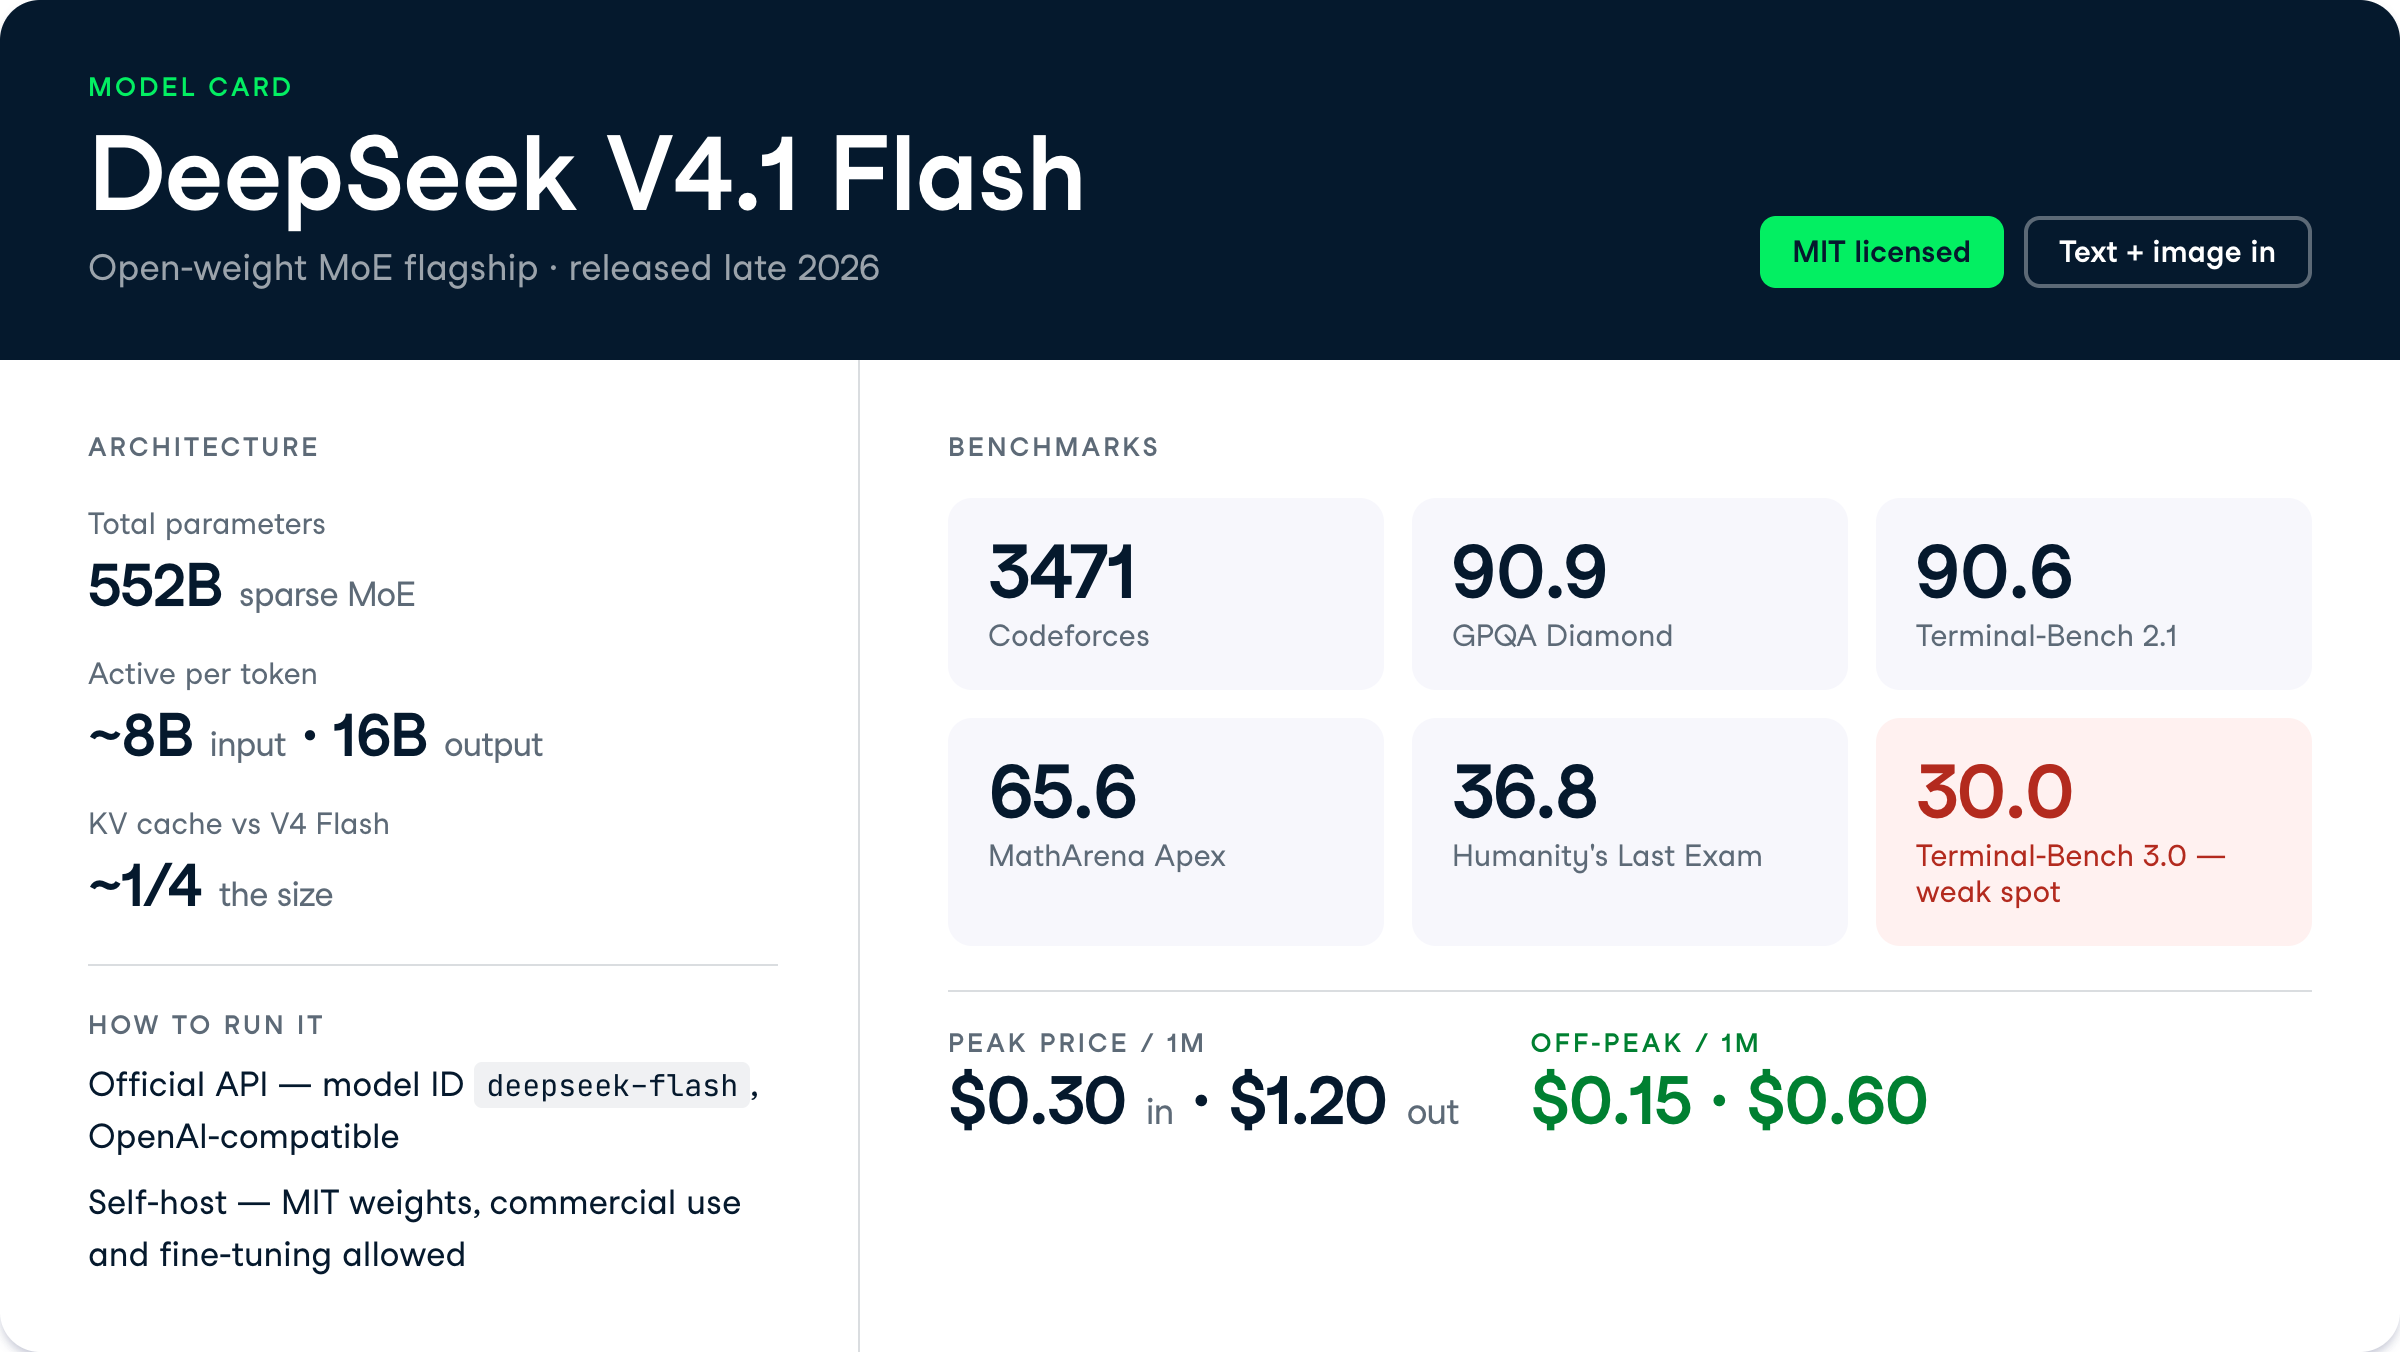
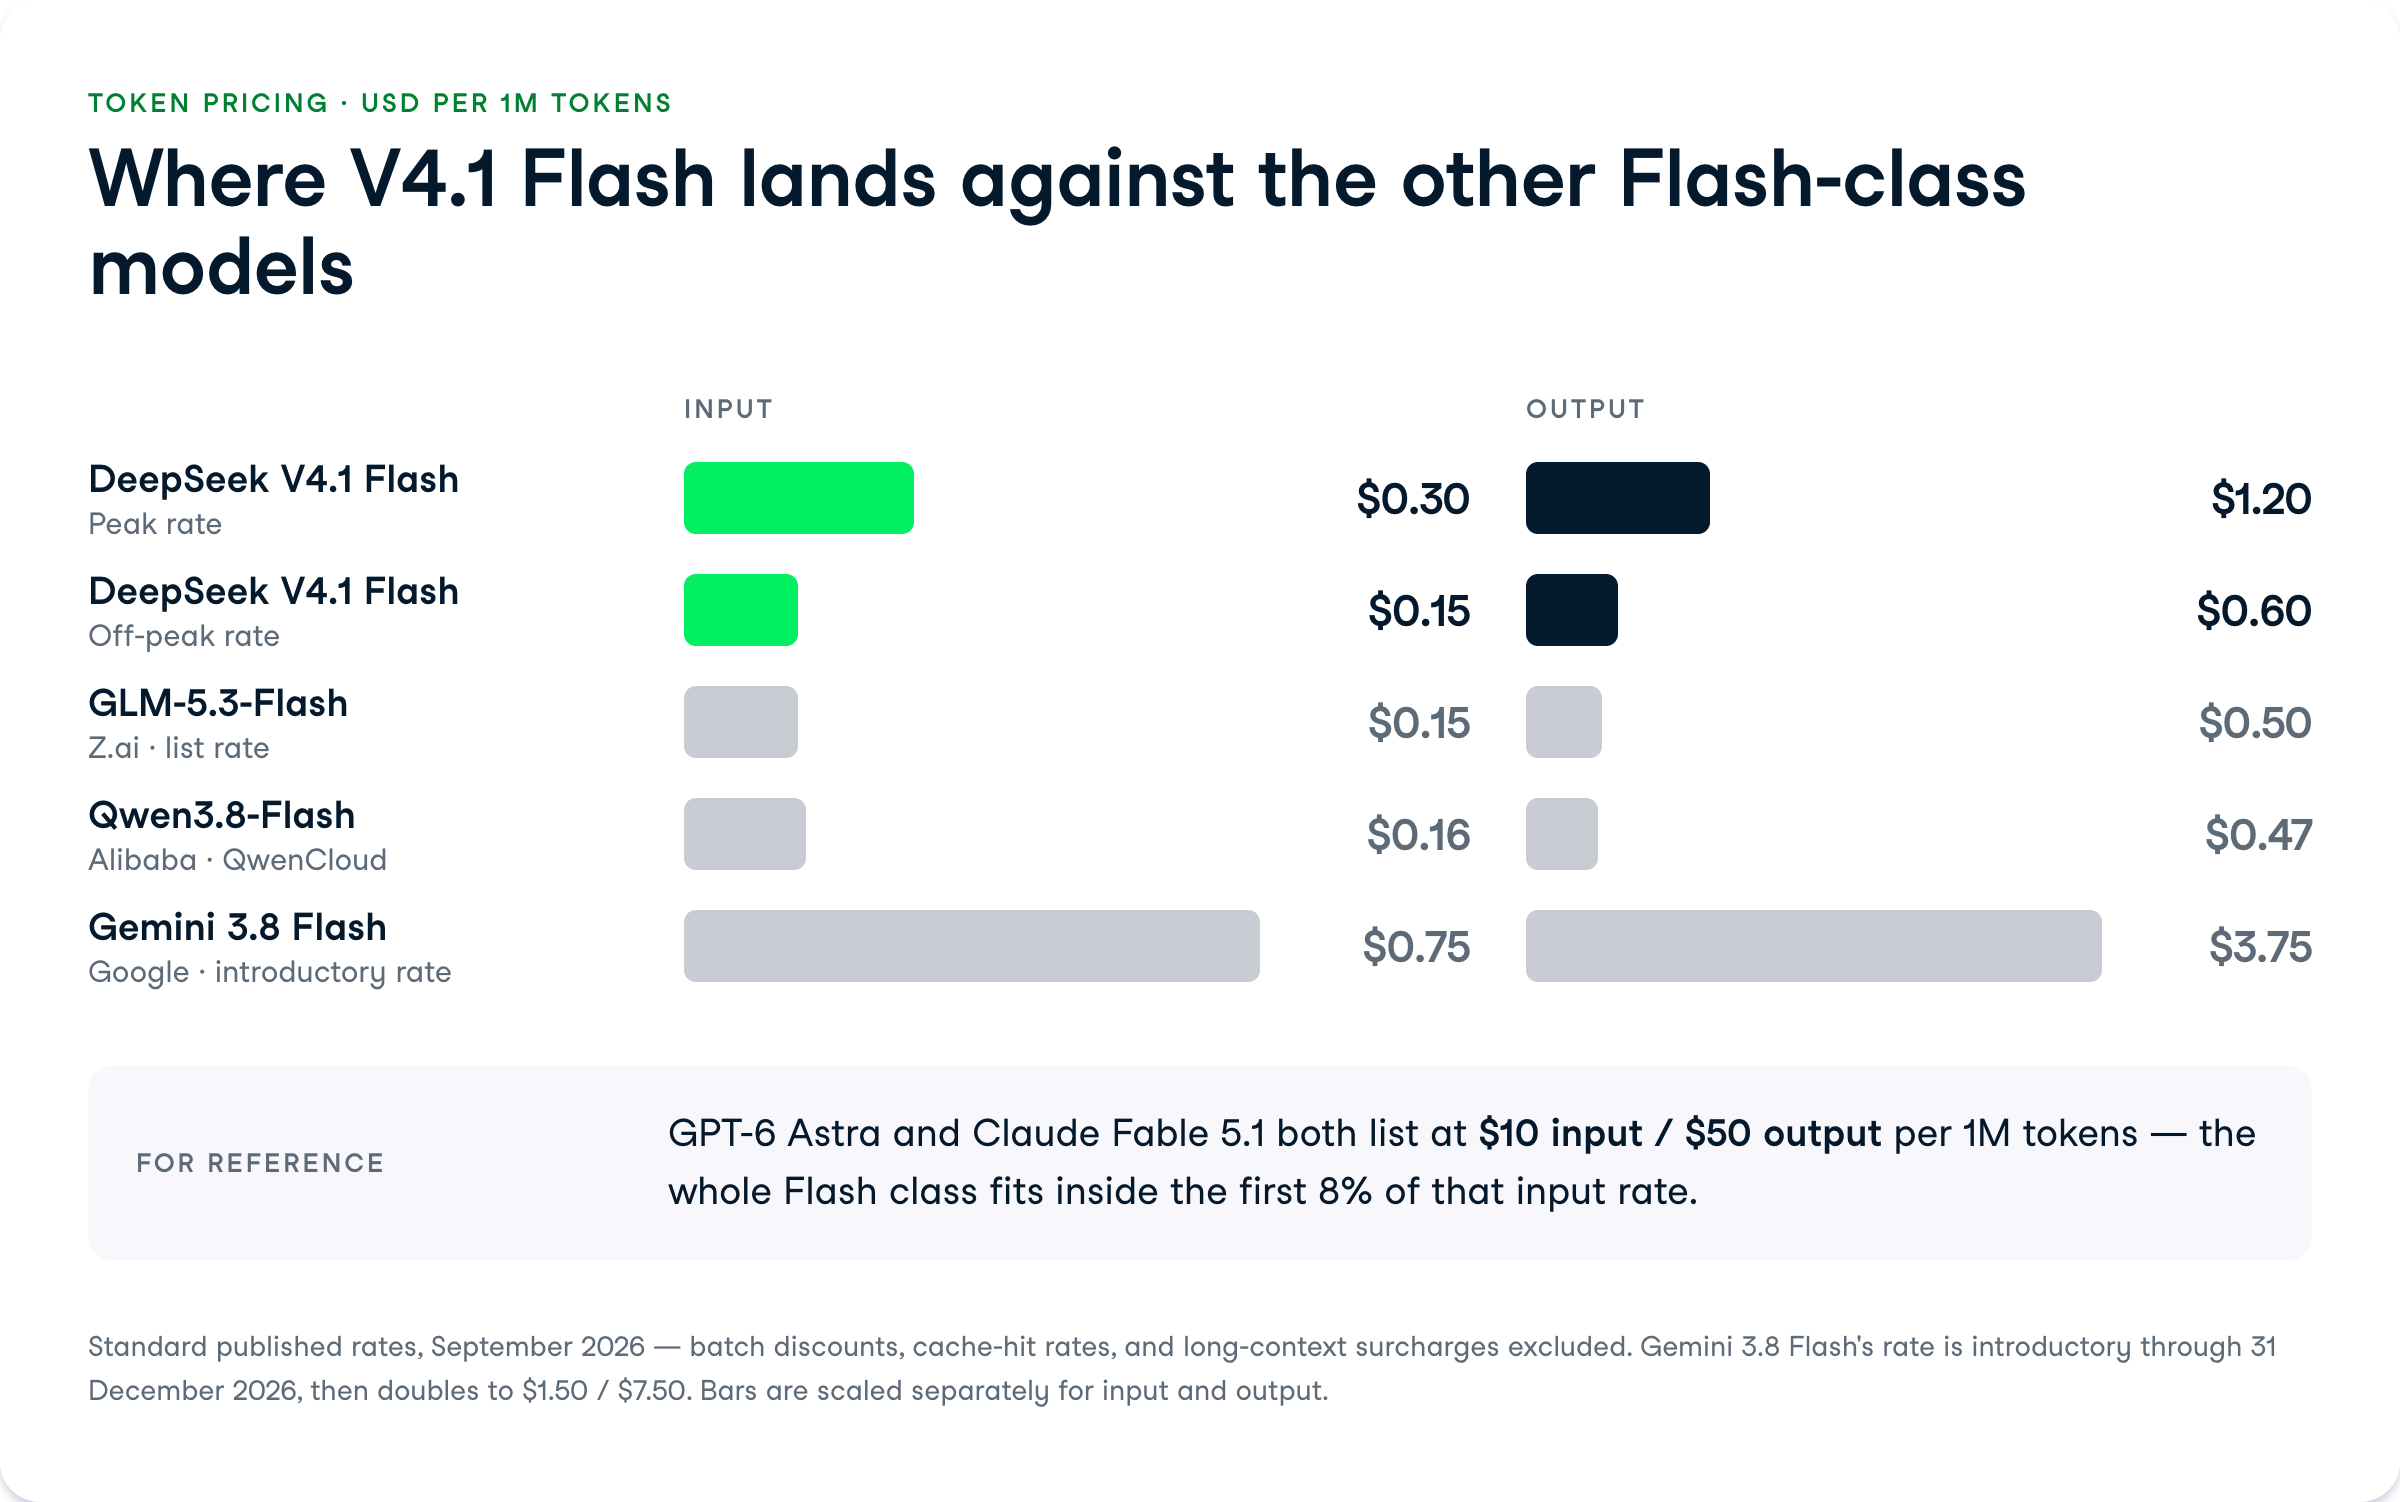
O DeepSeek V4.1 Flash é um modelo mixture-of-experts de 552B parâmetros que ativa cerca de 8B para entrada e 16B para saída, oferece pesos abertos sob licença MIT e custa $0,30/$1,20 por 1M de tokens no pico, caindo para $0,15/$0,60 fora do pico — superando outros modelos Flash da mesma faixa, como o Gemini 3.8 Flash e o GLM-5.3-Flash.
Neste artigo, explico o que há de novo no DeepSeek V4.1 Flash, destacando os recursos e analisando os benchmarks. Se quiser ver o modelo em ação, confira nosso tutorial da API do DeepSeek V4.1.
Para saber mais sobre a família DeepSeek, veja nosso guia sobre como executar o DeepSeek-V4-Flash-0731 com Unsloth Studio e OpenCode e também nossa comparação entre DeepSeek v4.1 Flash e Gemini 3.8 Flash.
O DeepSeek V4.1 Flash é o modelo mais recente da linha Flash da DeepSeek, posicionado como uma opção eficiente e de alta vazão, não um “pesadão” de pesquisa.
Ele usa uma arquitetura MoE esparsa com 552B parâmetros no total, dos quais apenas ~8B ficam ativos por token na entrada e 16B na saída. Essa ativação esparsa mantém o custo de serviço baixo e ainda alcança resultados de ponta em vários benchmarks.
A grande mudança em relação à geração anterior é a eficiência.
A DeepSeek reduziu o KV cache para cerca de um quarto do tamanho do V4 Flash anterior, diminuindo o uso de memória e permitindo contextos mais longos a um custo menor. A empresa também afirma que o V4.1 Flash supera o V4 Pro 0813 em desempenho, custo, velocidade e tempo total, e por isso o V4 Pro está sendo descontinuado.
Nos benchmarks, o número que chama atenção é 90,6 no Terminal-Bench 2.1. Quando testamos o DeepSeek-V4-Flash-0731 anterior, ele marcou 82,7 no mesmo teste — então o V4.1 Flash é um salto real em tarefas agentic no terminal dentro da mesma família.
O conjunto de recursos do V4.1 Flash gira em torno de duas ideias: rodar barato e manter-se aberto. Veja o que mais importa para um cientista de dados ou engenheiro de ML no dia a dia.
O V4.1 Flash vem com pesos sob licença MIT — a mais permissiva entre as comuns — permitindo uso comercial, redistribuição e fine-tuning sem limites de receita.
Para times com exigências de privacidade, isso significa rodar o modelo totalmente na sua própria infraestrutura, sem enviar requisições para a API da DeepSeek.
O contraponto é que a licença MIT transfere para você a responsabilidade por segurança, fine-tuning e otimização de inferência.
Quando executamos localmente o V4-Flash-0731 anterior, ele precisou de três GPUs NVIDIA A100 de 80GB em quantização Q8 — então self-hosting só é viável se você tiver memória de GPU de verdade sobrando.
O V4.1 Flash aceita imagens diretamente na entrada, sem adaptador de visão ou pré-processamento à parte. Dá para enviar capturas de tela, gráficos ou documentos digitalizados na mesma requisição junto com texto — útil para pipelines com muitos documentos e fluxos de agentes de UI.
Entrada multimodal nativa nessa faixa de preço é raro. No ZeroBench-main com ferramentas, o V4.1 Flash marca 49,0 — um bom indicativo de como ele lida com raciocínio sobre insumos visuais.
O KV cache no V4.1 Flash tem cerca de um quarto do tamanho do V4 Flash anterior, reduzindo o custo de memória para manter contextos longos em sessão de serviço.
Para quem roda inferência contínua, um KV cache menor significa mais sessões simultâneas por GPU ou menos overhead de memória por requisição.
Com input de cache-hit a $0,006 por 1M de tokens no pico, a reutilização de contexto fica baratíssima. Se você envia o mesmo system prompt ou documento repetidas vezes, a parte em cache sai quase de graça.
A DeepSeek opera um esquema de dois níveis em que o preço fora do pico é metade do preço de pico, incentivando o envio de lotes e rotinas agendadas para janelas fora do pico. Isso transforma $0,30/$1,20 em $0,15/$0,60 por 1M de tokens se você puder agendar os jobs.
O porém é operacional. Cargas sempre ativas ficam mais difíceis de prever em custo, e capturar o desconto exige lógica de agendamento que você mesmo precisa construir e manter.
O V4.1 Flash vai melhor em avaliações de agentes e raciocínio, alcançando pontuações próximas das de ponta por uma fração do custo por token.
Os números caem bem nas avaliações agentic mais difíceis — ponto importante antes de direcioná-lo a tarefas de longo horizonte.
O V4.1 Flash marca 90,6 no Terminal-Bench 2.1, que mede como um modelo completa tarefas multi-etapas em um ambiente de terminal.
Para comparação, o DeepSeek-V4-Flash-0731 fez 82,7 no mesmo benchmark em nossos testes, e o GPT-5.6 Terra atingiu 87,4 na nossa comparação Terra vs. Sonnet 5.
O cenário muda nas avaliações agentic mais duras.
O V4.1 Flash cai para 30,0 no Terminal-Bench 3.0 — sinal de que ele resolve bem tarefas padrão de terminal, mas patina no conjunto agentic mais exigente. Sua pontuação de 3471 no Codeforces indica forte capacidade em programação competitiva.
No GPQA Diamond, um conjunto de questões de ciências em nível de pós-graduação, projetado para ser difícil de responder apenas de memória, o V4.1 Flash marca 90,9.
É um resultado forte para essa faixa de preço e coloca o modelo na conversa com rivais bem mais caros.
No Humanity's Last Exam (HLE), um benchmark propositalmente brutal de nível expert, o V4.1 Flash marca 36,8, ou 39,1 com a configuração estrelada.
Para comparação, em avaliações agentic de ciência como o Terminal-Bench-Science 0.1, o Claude Fable 5.1 fica em 52,6% contra rivais mais duros. O V4.1 Flash não lidera os testes mais extremos, mas passa longe de decepcionar.
O V4.1 Flash marca 65,6 no MathArena Apex, um benchmark de competição matemática que recompensa raciocínio simbólico em múltiplas etapas.
É um dos melhores resultados do modelo e sugere que ele é uma boa escolha para cargas quantitativas e intensivas em matemática.
Uma pontuação na casa dos 60 e poucos aqui importa para quem constrói ferramentas que exigem aritmética e álgebra confiáveis — muitos modelos baratos tropeçam justamente nessas tarefas.
A decisão aqui é menos sobre variantes e mais sobre como você implanta o V4.1 Flash, já que os mesmos pesos rodam de três formas. Sua escolha depende de previsibilidade de custos, privacidade dos dados e capacidade de agendar jobs.
A DeepSeek também está realizando uma migração. A partir de 12h (horário de Pequim) de 14 de setembro de 2026, até o futuro lançamento do V4.1 Pro, requisições para endpoints legados estão sendo redirecionadas — direcionando usuários existentes para a família V4.1. Se você ainda usa o V4 Pro 0813, esse modelo está sendo descontinuado; planeje a migração para o V4.1 Flash agora.
| Uso | Caminho recomendado | Por quê |
|---|---|---|
| Agente de código sempre ativo e em alto volume | API oficial, preço de pico | $0,30/$1,20 por 1M já fica muito abaixo dos rivais de ponta; sem overhead de agendamento |
| Jobs grandes de raciocínio ou matemática em lote | API oficial, fora do pico | Fora do pico reduz para $0,15/$0,60 por 1M se você puder agendar a execução |
| Dados sensíveis ou proprietários | Self-host com pesos MIT | Mantém a inferência no seu hardware; exige memória de GPU de verdade |
| Reutilização pesada de contexto | API com cache de prompt | Cache-hit de entrada a $0,006 por 1M torna a repetição de contexto quase gratuita |
O V4.1 Flash é um dos modelos mais baratos e capazes disponíveis — especialmente fora do pico. Veja como ficam as tarifas por token.
| Tarifa | Pico | Fora do pico |
|---|---|---|
| Entrada por 1M de tokens | $0,30 | $0,15 |
| Saída por 1M de tokens | $1,20 | $0,60 |
| Entrada com cache-hit por 1M de tokens | $0,006 | Não divulgado |
Os preços fora do pico são a metade dos de pico, e o esquema é pensado para empurrar lotes e rotinas agendadas para janelas fora do pico.
Para contextualizar a tarifa de pico: GPT-6 Astra e Claude Fable 5.1 cobram $10 por 1M de entrada e $50 por 1M de saída — então o V4.1 Flash é cerca de 30x mais barato na entrada e 40x mais barato na saída no pico.
O modelo que está sendo descontinuado, V4 Pro 0813, custa $0,435 por 1M de entrada e $0,87 por 1M de saída com contexto de 1M de tokens.
Como a DeepSeek afirma que o V4.1 Flash supera o V4 Pro em desempenho, custo e velocidade, há pouca razão para continuar no modelo antigo.
O V4.1 Flash está disponível pela API oficial da DeepSeek, e os pesos com licença MIT foram publicados para self-hosting.
A partir de 14 de setembro de 2026, requisições para endpoints legados são redirecionadas para a família V4.1 até o lançamento do V4.1 Pro.
O V4.1 Flash é tanto um modelo de API quanto uma versão de pesos abertos — você pode acessá-lo de duas formas.
Na API, o ID do modelo costuma aparecer como deepseek-flash, e o endpoint é compatível com o da OpenAI — ou seja, a maior parte do código cliente da OpenAI funciona mudando a base URL.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
Para self-hosting, os pesos com licença MIT permitem uso comercial, redistribuição e fine-tuning sem limites de receita.
Quando executamos localmente o V4-Flash-0731 com o Unsloth Studio, foram necessárias três GPUs NVIDIA A100 80GB em quantização Q8 — então planeje hardware similar para configuração em precisão total.
Para um passo a passo completo, veja nosso tutorial sobre rodar o DeepSeek-V4-Flash com Unsloth Studio e OpenCode, que detalha a distribuição em GPU e a configuração de inferência.
O V4.1 Flash é a DeepSeek fazendo uma aposta em preço e abertura, enquanto o resto do mercado de ponta caminha para $10/$50 por 1M de tokens e restringe acesso a camadas pagas.
Um MoE de 552B com pesos MIT, entrada nativa de imagem, 90,9 no GPQA Diamond e preço de pico 30x abaixo do GPT-6 Astra é uma proposta séria para cargas em alto volume.
Eu migraria para ele em agentes de código e jobs de raciocínio em lote — principalmente se você puder agendar fora do pico.
Os pontos negativos aparecem ao olhar os 30,0 no Terminal-Bench 3.0, mostrando instabilidade nas tarefas agentic mais difíceis, e a cobrança por pico/fora do pico adiciona trabalho de agendamento do seu lado.
Se você quer construir fluxos de agentes em torno de modelos assim, nossa trilha de aprendizado AI Agent Fundamentals é um ótimo ponto de partida.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
Richie Cotton
blog
Dr Ana Rojo-Echeburúa
9 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
11 min