
Last chance! 50% off DataCamp Premium
Sale ends in
2026 sonlarında öne çıkan model yarışında ham yetenekten çok fiyat üzerinden bir silahlanma yarışı gördük. Sadece eylülde, OpenAI’ın GPT-6 Astra’sı ve Anthropic’in Claude Fable 5.1’i 1M giriş token’ı için $10 ve 1M çıkış token’ı için $50 seviyesinde konumlandı ve her ikisi de ücretsiz katmanlarda sunulmuyor.
DeepSeek’in yanıtı ise bütünüyle ters yönde ilerlemek.
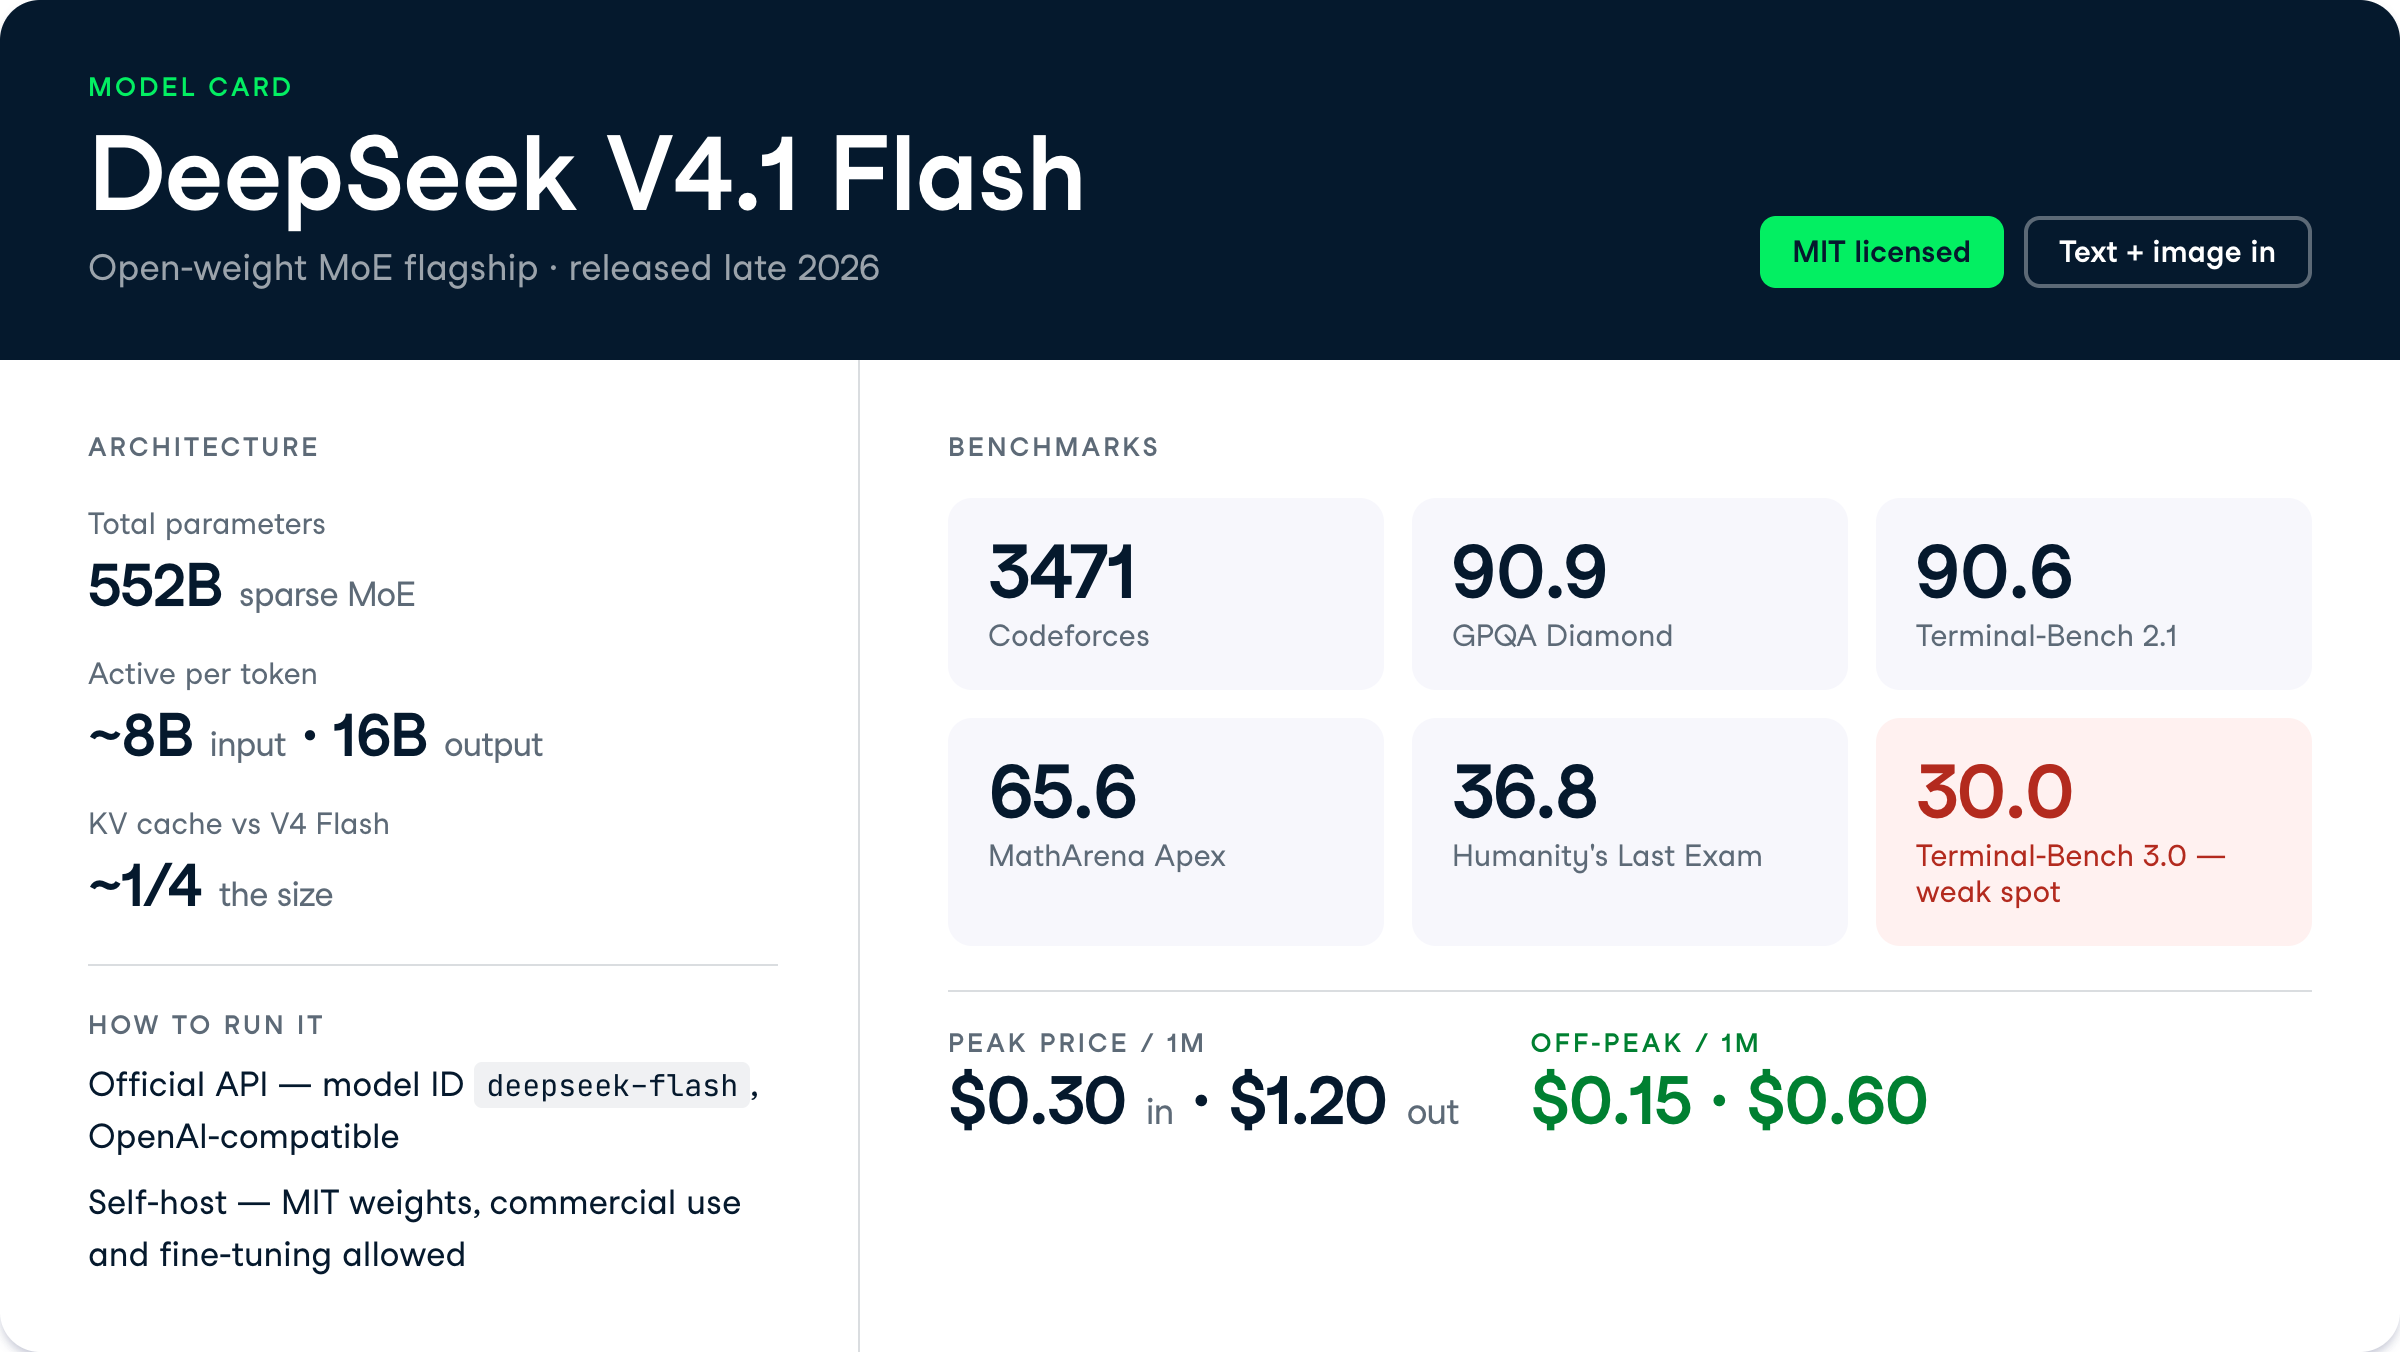
DeepSeek V4.1 Flash, girişte yaklaşık 8B ve çıkışta 16B parametre etkinleştiren 552B parametreli bir uzman karışımı (MoE) modeli; MIT lisanslı açık ağırlıklarla geliyor ve zirvede 1M token başına $0,30/$1,20, yoğun olmayan saatlerde $0,15/$0,60’a düşen fiyatıyla Gemini 3.8 Flash ve GLM-5.3-Flash gibi benzer Flash modellerini geride bırakıyor.
Bu yazıda, DeepSeek V4.1 Flash ile gelen tüm yenilikleri, yeni özellikleri ve kıyaslamaları ele alacağım. Modeli çalışırken görmek isterseniz, DeepSeek V4.1 API eğitimimize göz atın.
DeepSeek ailesi hakkında daha fazla bilgi için, DeepSeek-V4-Flash-0731’i Unsloth Studio ve OpenCode ile çalıştırma rehberimizi ve DeepSeek v4.1 Flash ile Gemini 3.8 Flash karşılaştırmamızı inceleyin.
DeepSeek V4.1 Flash, DeepSeek’in Flash serisindeki en yeni model; araştırma sınıfı ağır sıklet olmaktan ziyade verimli, yüksek aktarım katmanı olarak konumlanıyor.
Toplam 552B parametreli seyrek bir uzman karışımı (MoE) mimarisi; token başına girişte yalnızca yaklaşık 8B, çıkışta ise 16B parametre etkin. Bu seyrek etkinleşme, bir yandan sunum maliyetlerini düşük tutarken diğer yandan çeşitli kıyaslamalarda sınır düzey puanlara ulaşmasını sağlıyor.
Önceki nesle kıyasla manşet değişiklik verimlilik.
DeepSeek, KV önbelleğini önceki V4 Flash’ın boyutunun yaklaşık dörtte birine düşürdü; bu da bellek ayak izini azaltarak daha uzun bağlamları daha ucuza sunmayı mümkün kılıyor. Şirket ayrıca V4.1 Flash’ın performans, maliyet, hız ve toplam sürede eski V4 Pro 0813’ü geride bıraktığını, bu nedenle V4 Pro’nun aşamalı olarak kaldırıldığını belirtiyor.
Kıyaslamalarda öne çıkan sayı, Terminal-Bench 2.1’de 90,6. Daha önce DeepSeek-V4-Flash-0731’i test ettiğimizde aynı kıyaslamada 82,7 puan almıştı; dolayısıyla V4.1 Flash, aynı aile içinde terminal tabanlı ajans işlerinde gerçek bir sıçrama.
V4.1 Flash’in özellik seti iki fikir etrafında şekilleniyor: ucuza çalışmak ve açık kalmak. İşte çalışan bir veri bilimci veya ML mühendisi için en önemli yetenekler.
V4.1 Flash, en müsamahakâr yaygın lisans olan MIT lisanslı ağırlıklarla gelir; bu lisans gelir eşiği olmadan ticari kullanım, yeniden dağıtım ve ince ayar yapılmasına izin verir.
Veri gizliliği kısıtları olan ekipler için bu, istekleri DeepSeek API’sine göndermek yerine modeli tamamen kendi donanımınızda çalıştırabileceğiniz anlamına gelir.
Dezavantajı, MIT lisansının güvenlik, ince ayar ve çıkarım optimizasyonu sorumluluğunu size yüklemesidir.
Önceki V4-Flash-0731’i yerelde çalıştırdığımızda, Q8 quantization ile üç adet NVIDIA A100 80GB GPU gerekiyordu; dolayısıyla kendi barındırma yalnızca ciddi GPU belleğiniz varsa makul bir seçenektir.
V4.1 Flash, ayrı bir görsel adaptör veya ön işleme adımı olmadan görselleri doğrudan girdi olarak kabul eder. Bu sayede ekran görüntülerini, grafiklerini veya belge taramalarını metinle birlikte aynı isteğe ekleyebilirsiniz; bu da belge ağırlıklı hatlar ve arayüz aracısı iş akışları için faydalıdır.
Bu fiyat noktasında yerel çok kipli girdi sıra dışı. Araçlarla birlikte ZeroBench-main değerlendirmesinde V4.1 Flash 49,0 puan alıyor; bu da görsel girdiler üzerinde akıl yürütmeyi nasıl ele aldığına dair kabaca bir sinyal veriyor.
V4.1 Flash’teki KV önbellek, önceki V4 Flash’in yaklaşık dörtte biri boyutunda; bu da bir sunum oturumunda uzun bağlamları tutmanın bellek maliyetini düşürür.
Sürekli çalışan çıkarım yürüten herkes için daha küçük KV önbellek, GPU başına daha fazla eşzamanlı oturum ya da istek başına daha düşük bellek yükü anlamına gelir.
Önbellek isabetli girişin zirvede 1M token başına $0,006 olarak fiyatlandırılmasıyla birleştiğinde, bağlam yeniden kullanımı son derece ucuz hale gelir. Aynı sistem istemini veya belgeyi istekler arasında tekrar tekrar gönderiyorsanız, önbelleğe alınmış bölüm neredeyse hiçbir şeye mal olmaz.
DeepSeek, yoğun olmayan saatlerde fiyatların zirvenin yarısına çekildiği iki kademeli bir fiyatlandırma uyguluyor; amaç, toplu ve zamanlanmış iş yüklerini yoğun olmayan zaman aralıklarına itmek. İşlerinizi zamanlayabilirseniz bu, 1M token başına $0,30/$1,20’yi $0,15/$0,60’a çevirir.
Ancak operasyonel bir çekince var. Sürekli çalışan iş yüklerinin maliyetini öngörmek zorlaşır ve indirimi yakalamak, sizin kurup sürdürmeniz gereken iş zamanlama mantığı gerektirir.
V4.1 Flash en güçlü gösterimini ajans ve akıl yürütme kıyaslamalarında yapıyor; token maliyetinin bir kısmına sınır seviyesine yakın puanlara ulaşıyor.
En zorlu ajans değerlendirmelerinde puanları belirgin şekilde düşüyor; bu yüzden onu uzun ufuklu görevlere yönlendirmeden önce bunu bilmek önemli.
V4.1 Flash, çok adımlı görevleri terminal ortamında ne kadar iyi tamamladığını ölçen Terminal-Bench 2.1’de 90,6 puan alıyor.
Ölçek için, DeepSeek-V4-Flash-0731 aynı kıyaslamada testlerimizde 82,7 puan aldı ve GPT-5.6 Terra, Terra vs. Sonnet 5 karşılaştırmamızda 87,4’e ulaştı.
Daha zor ajans değerlendirmelerinde tablo değişiyor.
V4.1 Flash, Terminal-Bench 3.0’da 30,0’a düşüyor; yani model, standart terminal görevlerini iyi yönetirken daha talepkar ajans paketinde zorlanıyor. 3471’lik Codeforces derecesi, güçlü bir yarışmacı programlama yeteneğine işaret ediyor.
Sadece hafızadan yanıtlamayı zorlaştıracak şekilde tasarlanmış lisansüstü seviye bilim sorularından oluşan GPQA Diamond’da V4.1 Flash 90,9 puan alıyor.
Bu, bu fiyat bandındaki bir model için güçlü bir sonuç ve onu çok daha pahalı sınır modellerle aynı cümlede anılabilir kılıyor.
Kasıtlı olarak çetin bir uzman düzeyi kıyaslama olan Humanity’s Last Exam (HLE)’de V4.1 Flash 36,8; yıldızlı yapılandırmayla 39,1 puan alıyor.
Kıyas için, Terminal-Bench-Science 0.1 gibi ajans-bilim değerlendirmelerinde Claude Fable 5.1 daha zorlu rakiplere karşı %52,6 gösteriyor; dolayısıyla V4.1 Flash en zor uzman değerlendirmelerinde zirve yapmıyor, ancak kötü bir tablo da çizmiyor.
V4.1 Flash, çok adımlı sembolik akıl yürütmeyi ödüllendiren bir yarışma matematiği kıyaslaması olan MathArena Apex’te 65,6 puan alıyor.
Bu, modelin güçlü sonuçlarından biri ve nicel ile matematik ağırlıklı iş yükleri için makul bir tercih olduğunu gösteriyor.
Burada 60’ların ortasında bir puan, güvenilir aritmetik ve cebirsel akıl yürütme gerektiren araçlar inşa eden herkes için önemlidir; çünkü daha ucuz modellerin birçoğu tam da bu görevlerde dağılıyor.
Karar, model varyantlarından ziyade V4.1 Flash’i nasıl devreye aldığınızla ilgili; zira aynı ağırlıklar üç şekilde çalışıyor. Seçiminiz maliyet öngörülebilirliği, veri gizliliği ve işleri zamanlayıp zamanlayamayacağınıza iner.
DeepSeek ayrıca bir geçiş dönemi yürütüyor. 14 Eylül 2026 Pekin Saati 12:00’den, V4.1 Pro’nun gelecekteki çıkışına kadar, eski uç noktalara yapılan istekler yeniden yönlendiriliyor; bu da mevcut kullanıcıları V4.1 ailesine itiyor. Hâlâ V4 Pro 0813 üzerindeyseniz, o model aşamalı olarak kaldırılıyor; bu yüzden V4.1 Flash’e geçişi şimdiden planlayın.
| Kullanım durumu | Önerilen yol | Neden |
|---|---|---|
| Yüksek hacimli, sürekli açık kodlama aracısı | Resmi API, zirve fiyatlandırma | 1M başına $0,30/$1,20 zaten sınır rakiplerin çok altında; zamanlama yükü yok |
| Geniş toplu akıl yürütme veya matematik işleri | Resmi API, yoğun olmayan saatler | Yoğun olmayan saatler, koşuyu zamanlayabilirseniz oranı 1M başına $0,15/$0,60’a yarıya indirir |
| Hassas veya mülkiyetli veriler | MIT ağırlıklarıyla kendi barındır | Çıkarımı kendi donanımınızda tutar; ciddi GPU belleği gerektirir |
| Ağır bağlam yeniden kullanımı | İstem önbellekleme ile API | 1M başına $0,006 önbellek isabetli giriş, tekrarlanan bağlamı neredeyse ücretsiz kılar |
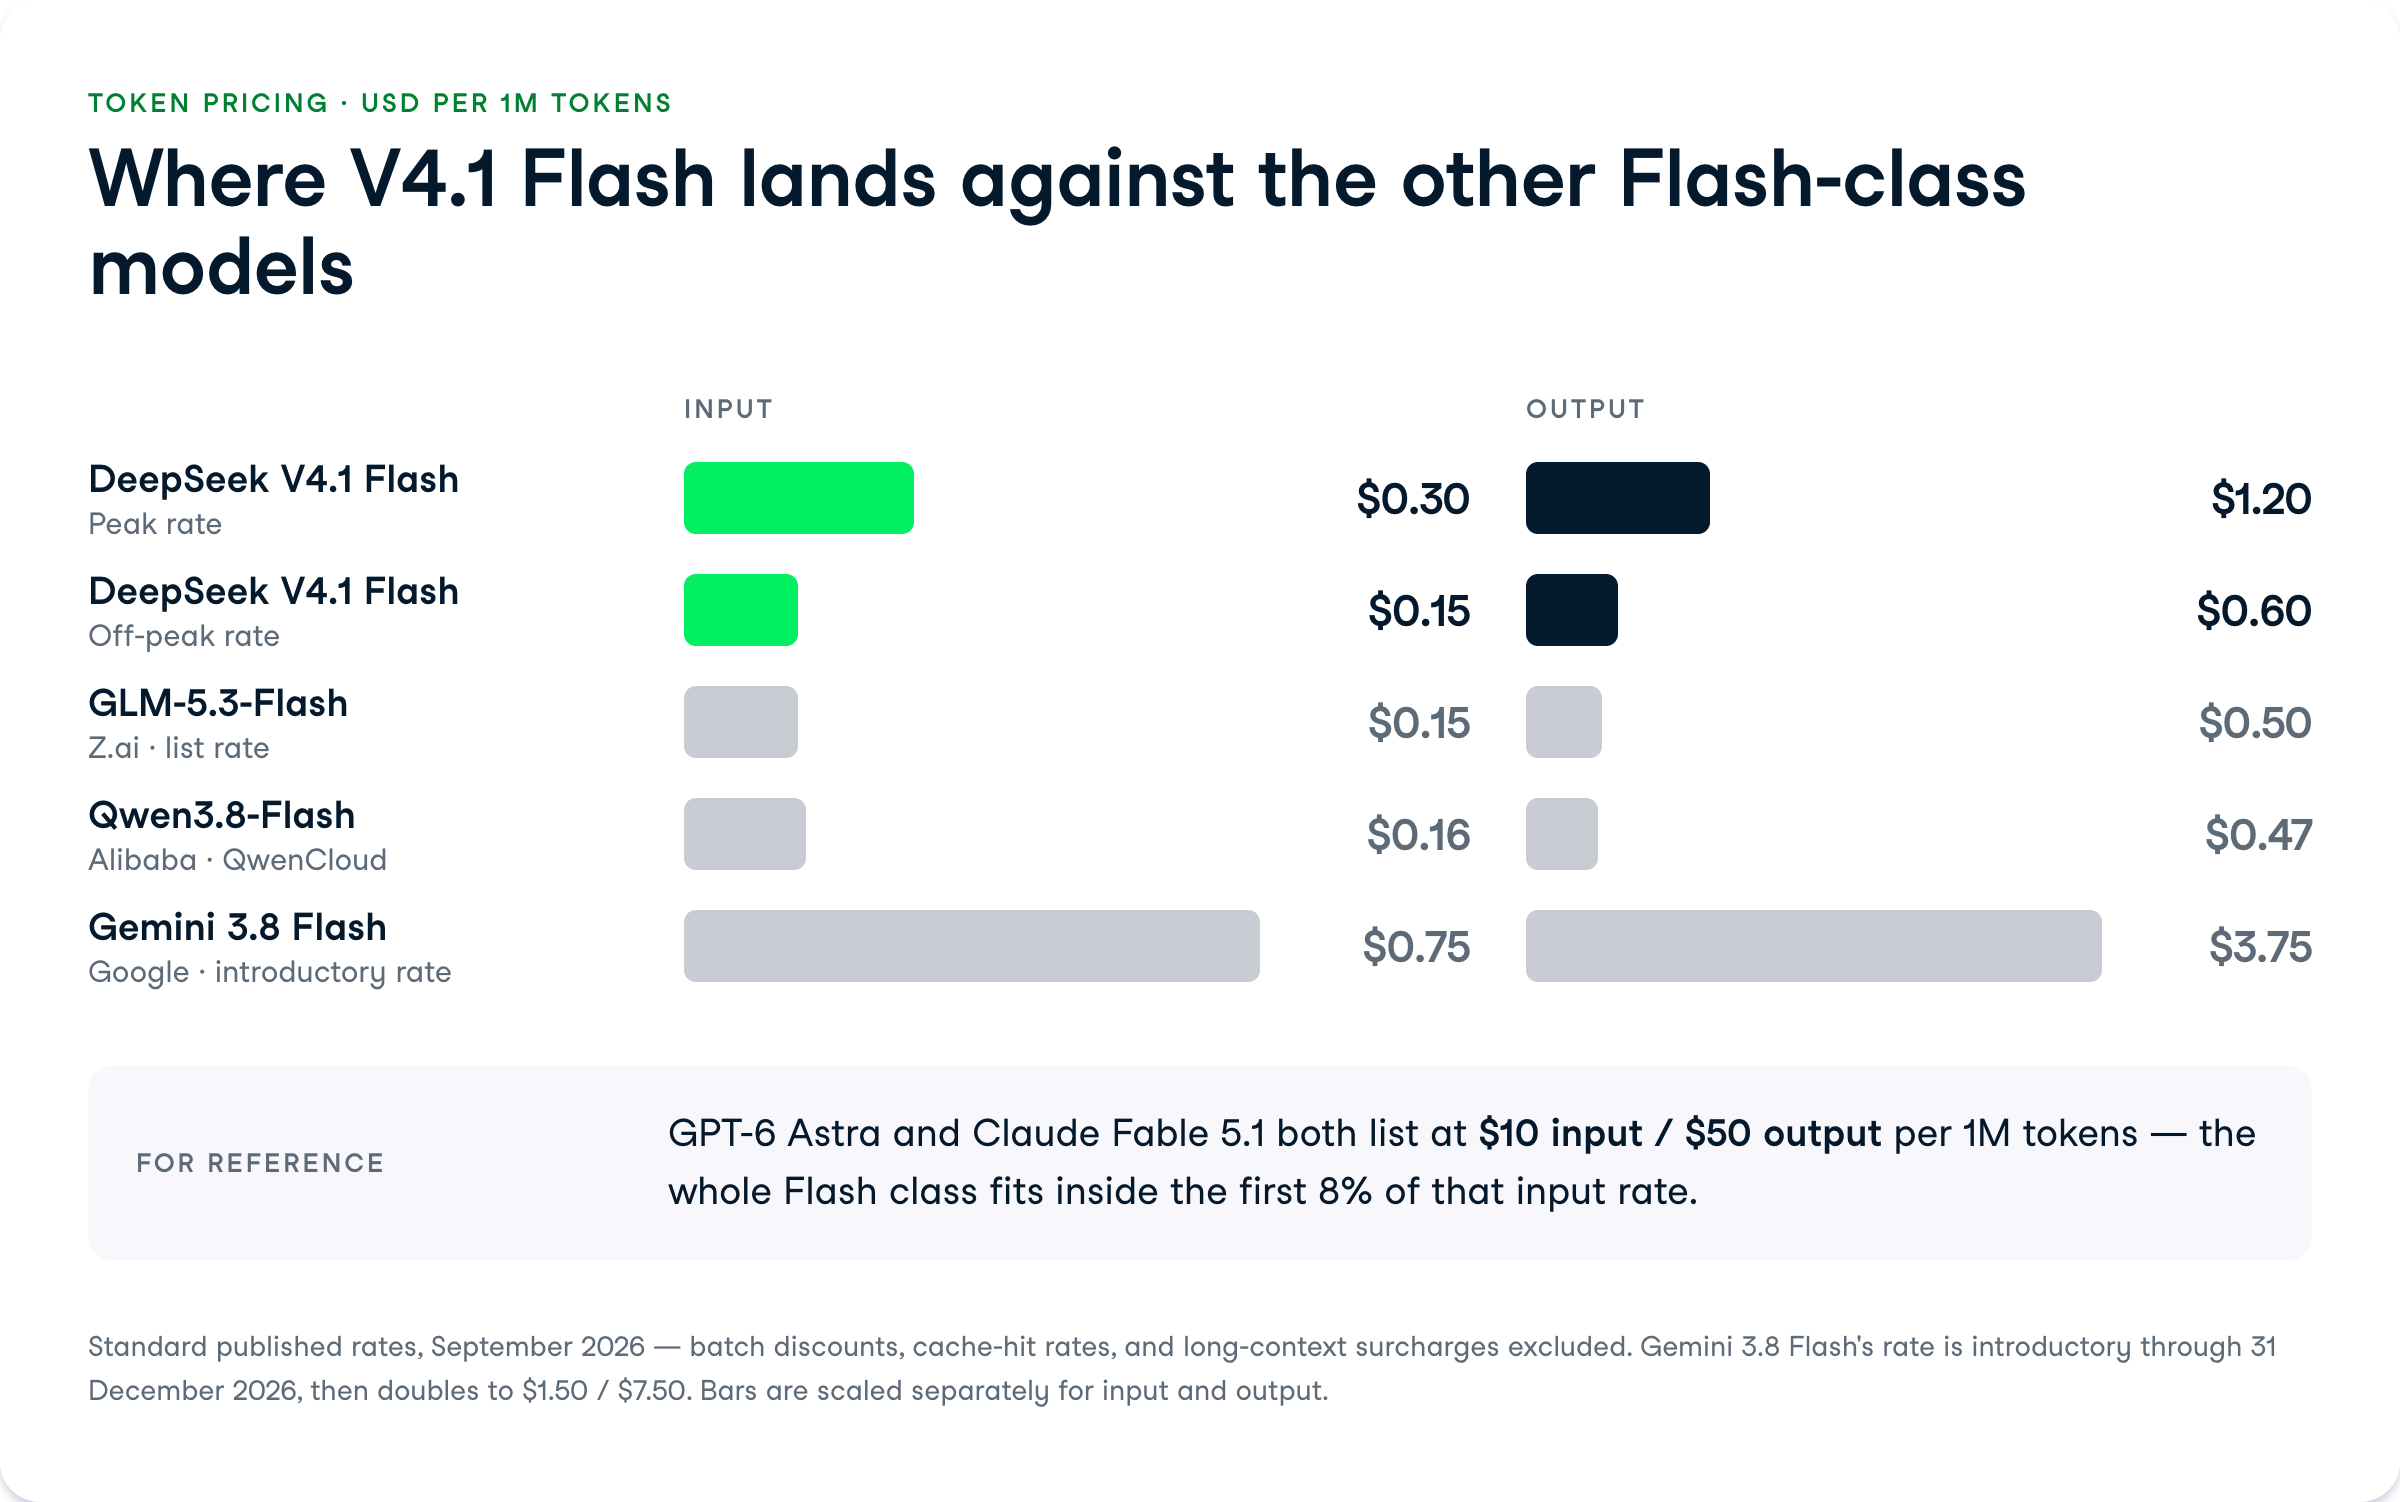
V4.1 Flash, özellikle yoğun olmayan saatlerde, mevcut en uygun fiyatlı yetkin modellerden biri. Token fiyatlaması şu şekilde ayrışıyor.
| Oran | Zirve | Yoğun olmayan |
|---|---|---|
| 1M token başına giriş | $0,30 | $0,15 |
| 1M token başına çıkış | $1,20 | $0,60 |
| 1M token başına önbellek isabetli giriş | $0,006 | Yayınlanmadı |
Yoğun olmayan saat fiyatları zirvenin yarısına ayarlanmış durumda ve bu şema, toplu ve zamanlanmış iş yüklerini yoğun olmayan zaman dilimlerine yönlendirmek üzere tasarlanmış.
Zirve oranını bağlama oturtmak gerekirse, GPT-6 Astra ve Claude Fable 5.1 1M giriş için $10 ve 1M çıkış için $50 talep ediyor; dolayısıyla V4.1 Flash, zirvede girişte yaklaşık 30 kat, çıkışta 40 kat daha ucuz.
Aşamalı olarak kaldırılan V4 Pro 0813 ise 1M giriş token’ı için $0,435 ve 1M çıkış token’ı için $0,87 olarak fiyatlandırılmıştı; bağlam 1M token.
DeepSeek, V4.1 Flash’in performans, maliyet ve hızda V4 Pro’yu geçtiğini iddia ettiğinden, eski modelde kalmak için pek bir neden yok.
V4.1 Flash, resmi DeepSeek API üzerinden erişilebilir ve MIT lisanslı ağırlıkları kendi barındırma için yayımlanmıştır.
14 Eylül 2026’dan itibaren, V4.1 Pro çıkana kadar eski uç nokta istekleri V4.1 ailesine yönlendiriliyor.
V4.1 Flash hem bir API modeli hem de açık ağırlık sürümüdür; dolayısıyla iki yoldan erişebilirsiniz.
API tarafında model kimliği yaygın olarak deepseek-flash şeklinde listelenir ve uç nokta OpenAI ile uyumludur; bu da çoğu mevcut OpenAI istemci kodunun yalnızca temel URL değişikliğiyle çalıştığı anlamına gelir.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
Kendi barındırma için, MIT lisanslı ağırlıklar gelir eşiği olmadan ticari kullanım, yeniden dağıtım ve ince ayar yapılmasına izin verir.
Önceki V4-Flash-0731’i Unsloth Studio ile yerelde çalıştırdığımızda, Q8 quantization ile üç adet NVIDIA A100 80GB GPU gerektirdi; bu nedenle tam hassasiyetli kurulum için benzer donanımı bütçelemeniz gerekir.
Tam bir yerel adım adım anlatım için, GPU dağıtımı ve çıkarım kurulumunu ayrıntılı şekilde ele alan DeepSeek-V4-Flash’i Unsloth Studio ve OpenCode ile çalıştırma eğitimimize bakın.
V4.1 Flash, diğer sınır modeller 1M token başına $10/$50 seviyesine tırmanıp erişimi ücretli katmanların arkasına alırken, DeepSeek’in fiyat ve açıklık konusundaki iddiasını ortaya koyuyor.
MIT ağırlıklara sahip 552B MoE model, yerel görsel girdi, GPQA Diamond’da 90,9 ve zirvede GPT-6 Astra’dan 30 kat daha düşük fiyat; yüksek hacimli iş yükleri için ciddi bir teklif.
Özellikle yoğun olmayan saatleri zamanlayabiliyorsanız, kodlama aracılarında ve toplu akıl yürütme işlerinde buna geçerdim.
Olumsuz taraflar, Terminal-Bench 3.0’da 30,0 puan gibi, en zorlu ajans görevlerinde bocaladığını gösteren sonuçlar ve zirve/yoğun olmayan saat faturalandırmasının size ek zamanlama işi yüklemesidir.
Bu tür modeller etrafında aracı iş akışları kurmak istiyorsanız, AI Agent Fundamentals beceri yolumuz iyi bir başlangıç noktasıdır.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




