Khóa học
Lập trình với AI dành cho Developer
1 giờ 30 phút
11.5K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleCuộc đua mô hình tuyến đầu vào cuối năm 2026 phần lớn đã trở thành cuộc chạy đua về giá hơn là năng lực thô. Chỉ riêng trong tháng 9, chúng ta đã thấy GPT-6 Astra của OpenAI và Claude Fable 5.1 của Anthropic đều ở mức $10 cho mỗi 1M token đầu vào và $50 cho mỗi 1M token đầu ra, và cả hai đều không có gói miễn phí.
Câu trả lời của DeepSeek là đi theo hướng hoàn toàn ngược lại.
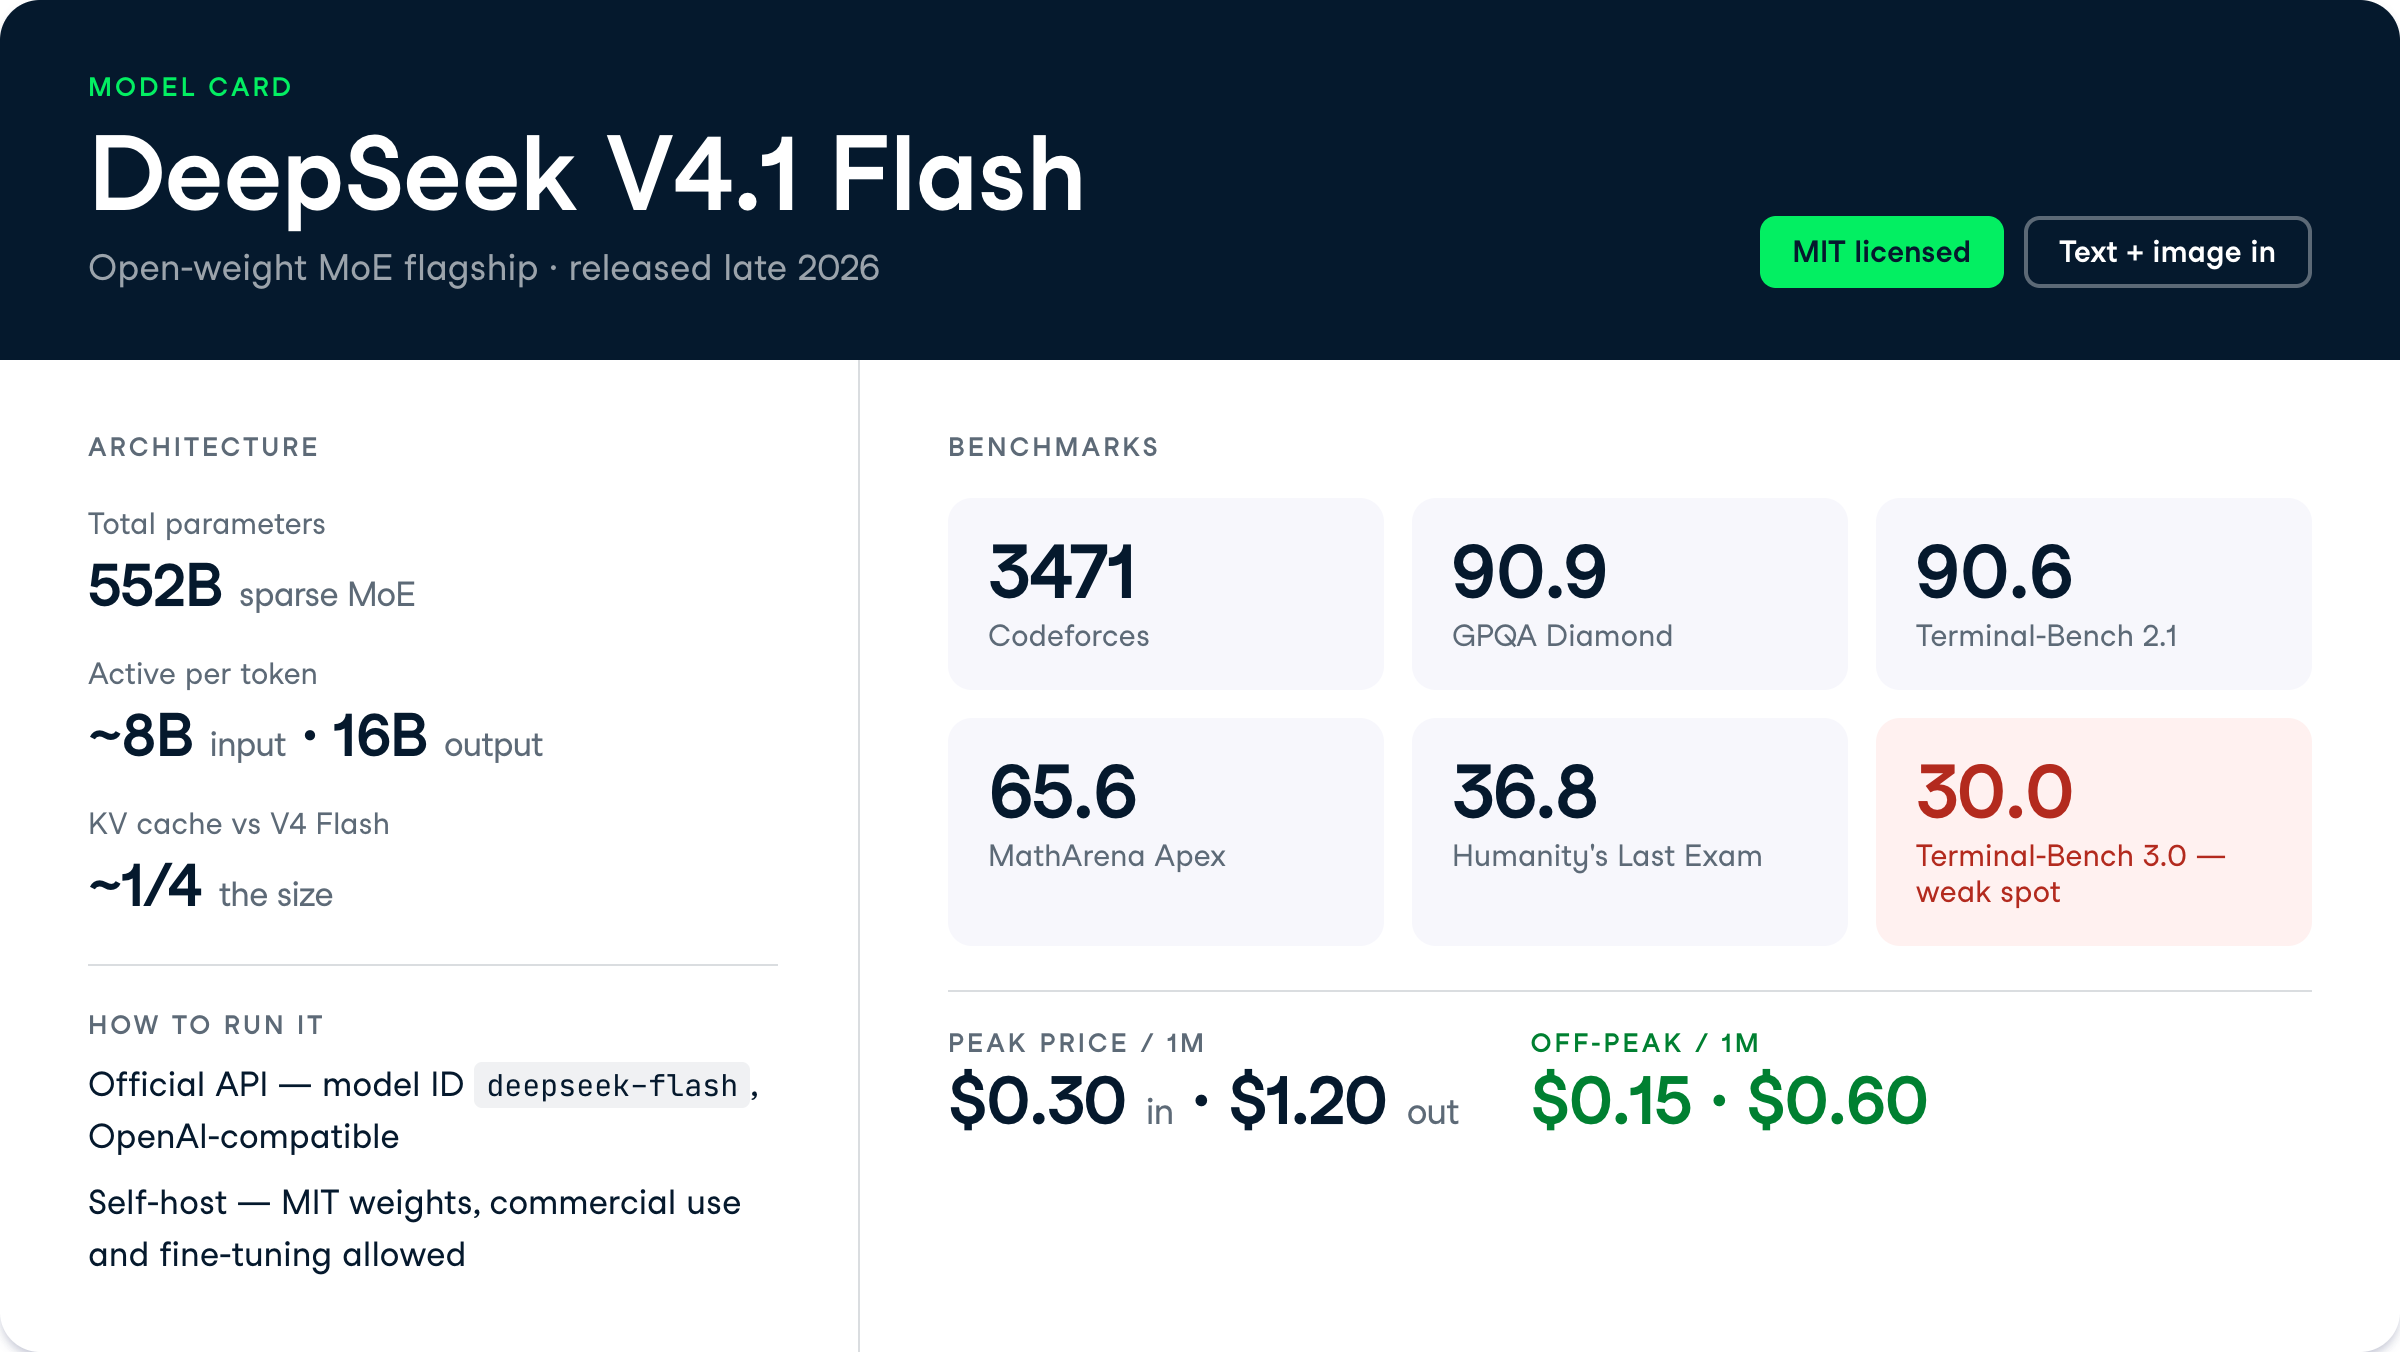
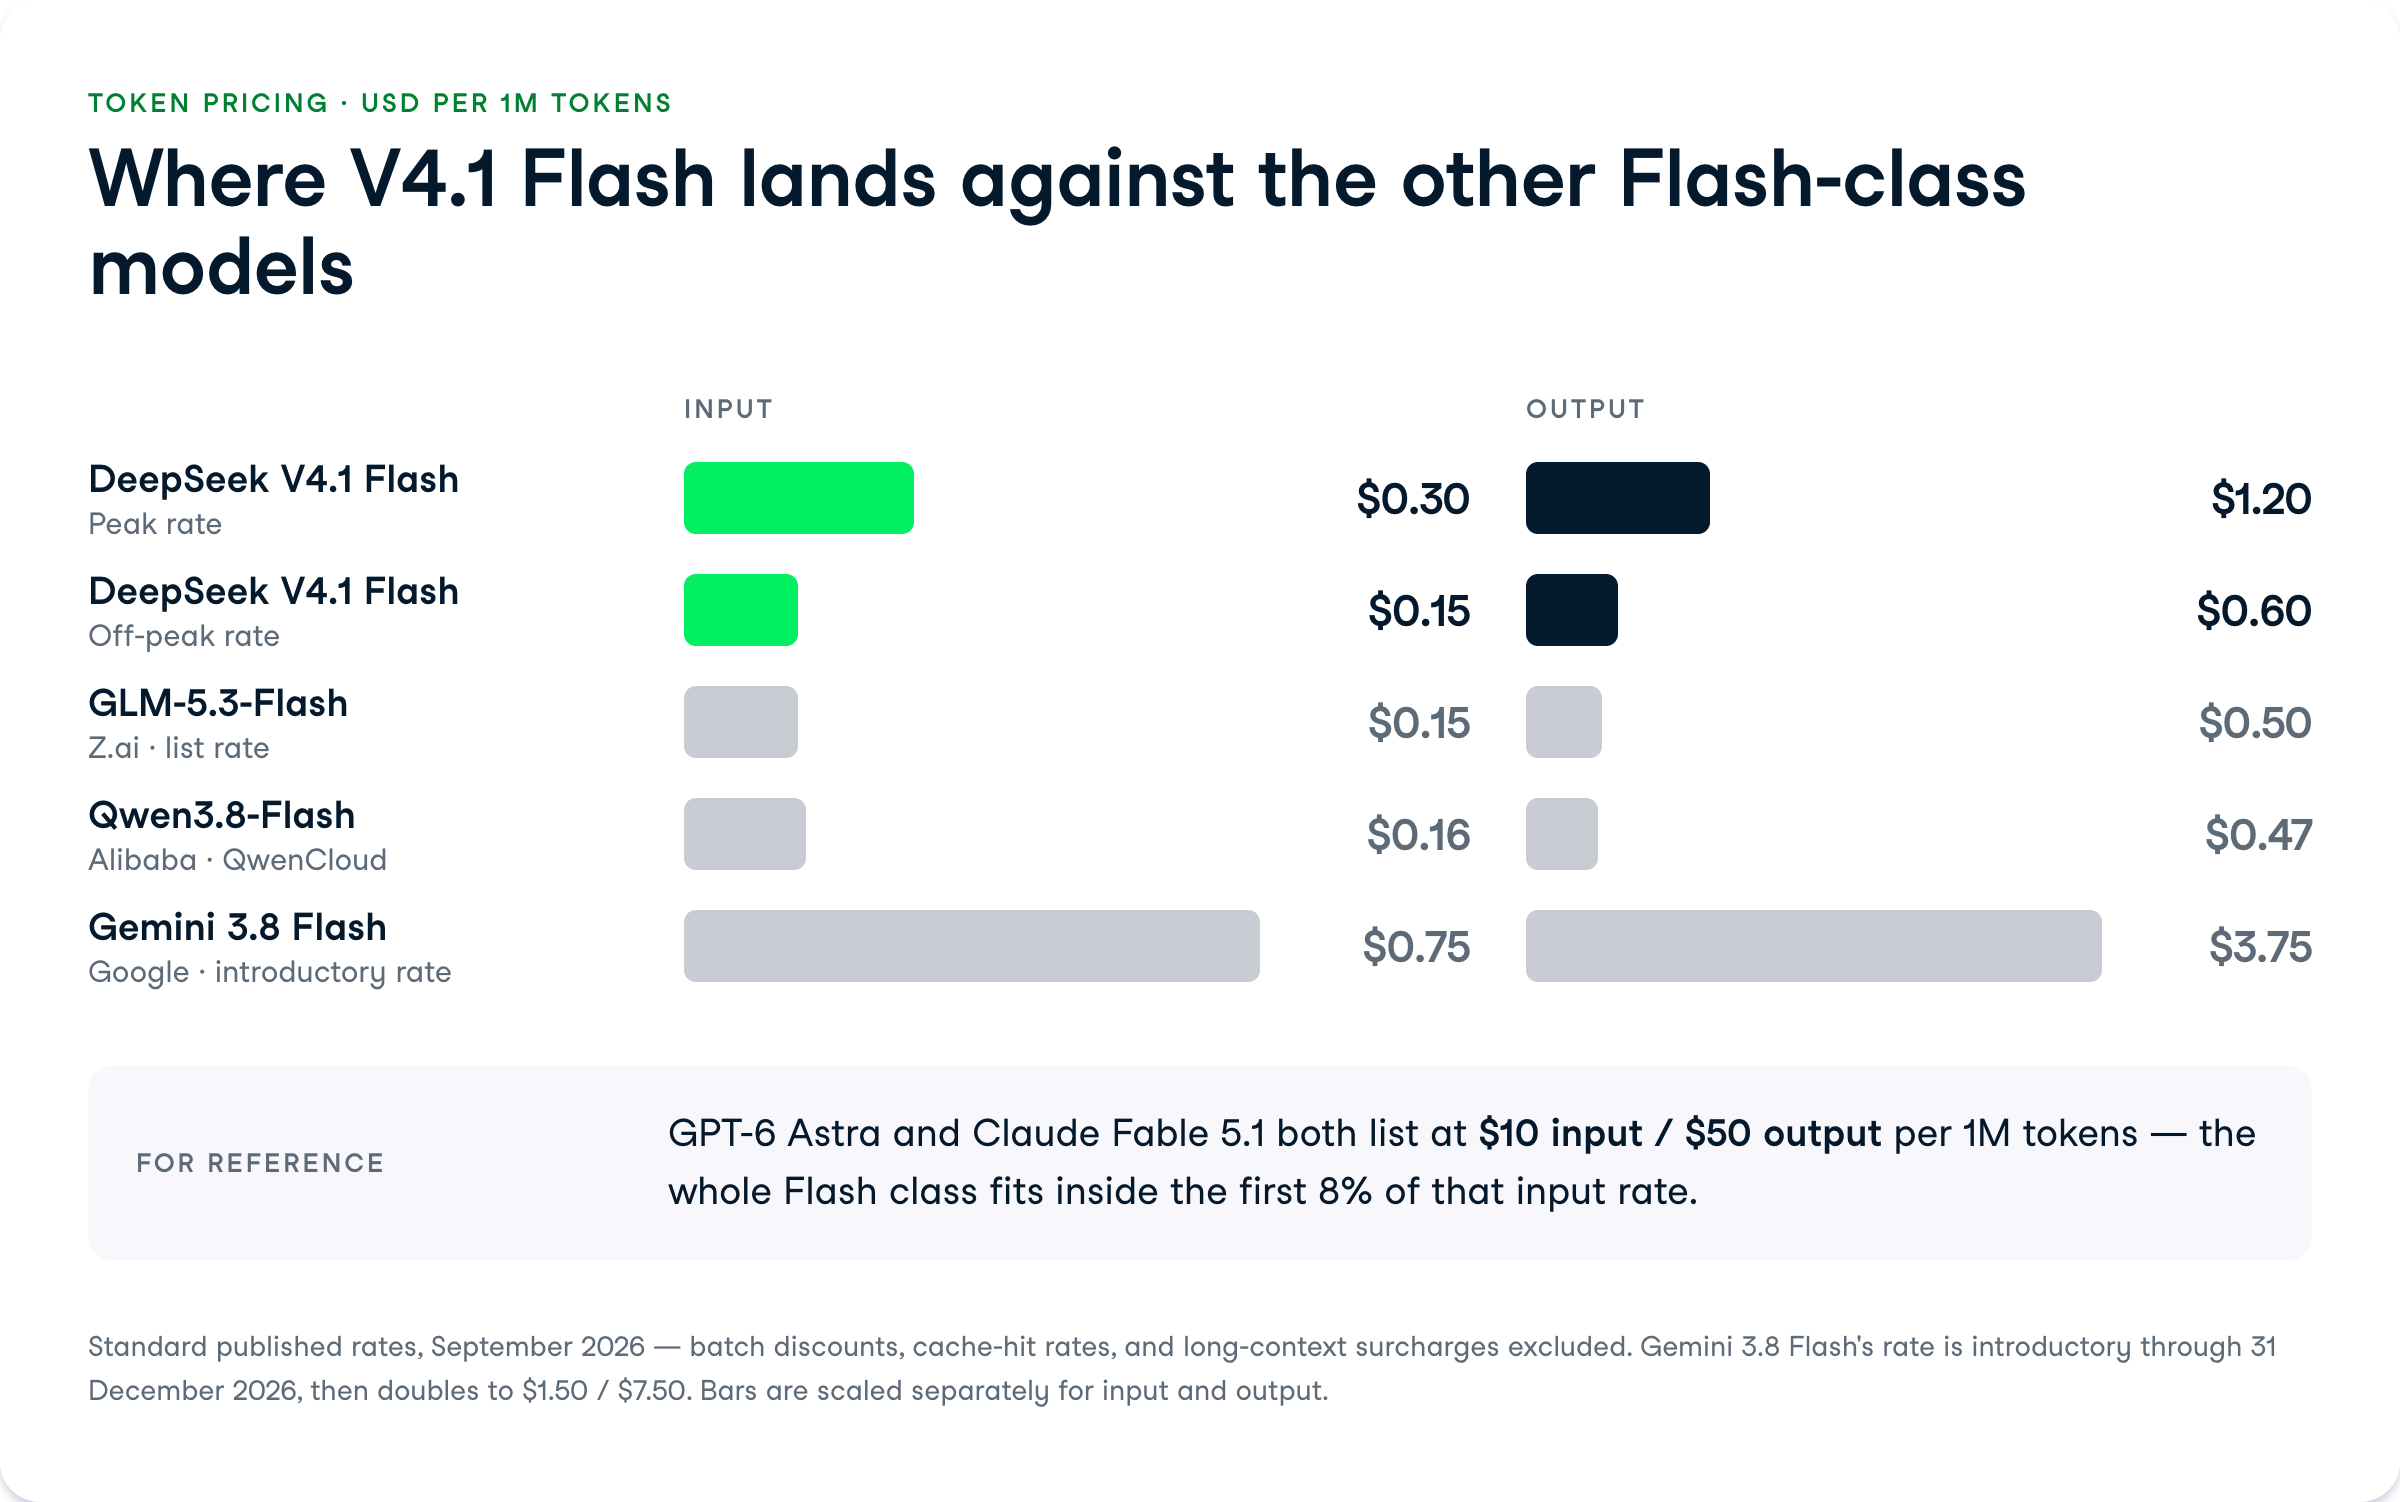
DeepSeek V4.1 Flash là một mô hình mixture-of-experts 552B tham số, kích hoạt khoảng 8B tham số cho đầu vào và 16B cho đầu ra, đi kèm trọng số mở theo giấy phép MIT và có giá $0.30/$1.20 mỗi 1M token vào giờ cao điểm, giảm còn $0.15/$0.60 ngoài giờ cao điểm, vượt mặt các mẫu Flash tương tự khác như Gemini 3.8 Flash và GLM-5.3-Flash.
Trong bài viết này, tôi sẽ điểm qua mọi điều mới về DeepSeek V4.1 Flash, xem các tính năng mới và khám phá các điểm chuẩn. Nếu bạn muốn xem mô hình hoạt động, hãy đọc hướng dẫn API DeepSeek V4.1 của chúng tôi.
Để tìm hiểu thêm về họ DeepSeek, hãy xem hướng dẫn chạy DeepSeek-V4-Flash-0731 với Unsloth Studio và OpenCode và bài so sánh DeepSeek v4.1 Flash vs Gemini 3.8 Flash.
DeepSeek V4.1 Flash là mẫu mới nhất trong dòng Flash của DeepSeek, định vị là phân khúc hiệu quả, thông lượng cao thay vì hạng nặng phục vụ nghiên cứu.
Đây là kiến trúc mixture-of-experts (MoE) thưa với tổng 552B tham số, trong đó chỉ khoảng 8B hoạt động mỗi token ở đầu vào và 16B ở đầu ra. Kích hoạt thưa là yếu tố giúp chi phí phục vụ thấp trong khi vẫn đạt điểm ở mức tuyến đầu trên một số điểm chuẩn.
Điểm nhấn so với thế hệ trước là hiệu suất.
DeepSeek đã thu nhỏ bộ đệm KV xuống khoảng một phần tư so với V4 Flash trước đó, giúp giảm chi phí bộ nhớ và cho phép mô hình phục vụ ngữ cảnh dài rẻ hơn. Công ty cũng cho biết V4.1 Flash vượt V4 Pro 0813 về hiệu năng, chi phí, tốc độ và tổng thời gian, và V4 Pro đang dần bị thay thế vì lý do này.
Về điểm chuẩn, con số nổi bật là 90.6 trên Terminal-Bench 2.1. Khi chúng tôi thử nghiệm DeepSeek-V4-Flash-0731 trước đó, mẫu này đạt 82.7 trên cùng điểm chuẩn, vì vậy V4.1 Flash thực sự tiến bộ rõ rệt ở công việc agent trong môi trường terminal trong cùng họ mô hình.
Bộ tính năng của V4.1 Flash xoay quanh hai ý tưởng: chạy rẻ và giữ tính mở. Dưới đây là các khả năng quan trọng nhất với một nhà khoa học dữ liệu hoặc kỹ sư ML đang làm việc.
V4.1 Flash đi kèm trọng số theo giấy phép MIT, là giấy phép phổ biến khoan dung nhất, cho phép sử dụng thương mại, phân phối lại và tinh chỉnh mà không có ngưỡng doanh thu.
Với các nhóm có ràng buộc về quyền riêng tư dữ liệu, điều này có nghĩa bạn có thể chạy mô hình hoàn toàn trên phần cứng của riêng mình thay vì gửi yêu cầu đến API của DeepSeek.
Đổi lại, giấy phép MIT chuyển trách nhiệm về an toàn, tinh chỉnh và tối ưu hóa suy luận sang cho bạn.
Khi chúng tôi chạy V4-Flash-0731 trước đó tại chỗ, mô hình cần ba GPU NVIDIA A100 80GB ở mức lượng tử hóa Q8, vì vậy tự lưu trữ chỉ khả thi khi bạn có bộ nhớ GPU thực sự dư dả.
V4.1 Flash chấp nhận hình ảnh trực tiếp làm đầu vào, không cần bộ chuyển đổi thị giác riêng hay bước tiền xử lý. Điều này cho phép bạn đưa ảnh chụp màn hình, biểu đồ hoặc bản quét tài liệu vào cùng một yêu cầu bên cạnh văn bản, hữu ích cho các pipeline nặng tài liệu và quy trình tác tử giao diện người dùng.
Đầu vào đa phương thức gốc ở mức giá này là điều hiếm. Trên đánh giá ZeroBench-main với công cụ, V4.1 Flash đạt 49.0, cung cấp một tín hiệu sơ bộ về cách mô hình xử lý suy luận qua đầu vào trực quan.
Bộ đệm KV trong V4.1 Flash chỉ khoảng một phần tư so với V4 Flash trước đó, giúp giảm chi phí bộ nhớ khi giữ ngữ cảnh dài trong một phiên phục vụ.
Với bất kỳ ai chạy suy luận liên tục, bộ đệm KV nhỏ hơn có nghĩa là hoặc nhiều phiên đồng thời hơn mỗi GPU hoặc chi phí bộ nhớ trên mỗi yêu cầu thấp hơn.
Kết hợp với đầu vào trúng bộ nhớ đệm được tính $0.006 mỗi 1M token vào giờ cao điểm, việc tái sử dụng ngữ cảnh trở nên cực kỳ rẻ. Nếu bạn gửi lặp đi lặp lại cùng một system prompt hoặc tài liệu qua các yêu cầu, phần đã được lưu trong bộ đệm gần như không tốn chi phí.
DeepSeek vận hành cơ chế hai mức giá, trong đó giá ngoài giờ được đặt bằng một nửa giá cao điểm, với mục tiêu hướng các tác vụ theo lô và theo lịch vào khung giờ ngoài giờ. Điều đó biến $0.30/$1.20 thành $0.15/$0.60 mỗi 1M token nếu bạn có thể căn thời gian chạy công việc.
Lưu ý là khía cạnh vận hành. Tải công việc luôn bật sẽ khó dự đoán chi phí hơn, và để nhận được mức giảm giá, bạn cần logic lập lịch công việc do chính bạn xây dựng và duy trì.
Điểm mạnh nhất của V4.1 Flash là trên các điểm chuẩn về tác tử và suy luận, nơi nó đạt điểm cận tuyến đầu với một phần nhỏ chi phí token.
Điểm số của mô hình giảm mạnh ở các đánh giá tác tử khó nhất, điều này đáng lưu ý trước khi bạn giao cho nó các tác vụ tầm nhìn dài.
V4.1 Flash đạt 90.6 trên Terminal-Bench 2.1, đo lường mức độ mô hình hoàn thành các tác vụ nhiều bước trong môi trường terminal.
Để so sánh, DeepSeek-V4-Flash-0731 đạt 82.7 trên cùng điểm chuẩn trong thử nghiệm của chúng tôi, và GPT-5.6 Terra đạt 87.4 trong so sánh Terra vs. Sonnet 5 của chúng tôi.
Bức tranh thay đổi ở các đánh giá tác tử khó hơn.
V4.1 Flash giảm xuống 30.0 trên Terminal-Bench 3.0, vì vậy mô hình xử lý tốt các tác vụ terminal tiêu chuẩn nhưng gặp khó với bộ bài kiểm tra tác tử đòi hỏi hơn. Điểm Codeforces 3471 cho thấy năng lực lập trình thi đấu mạnh.
Trên GPQA Diamond, bộ câu hỏi khoa học trình độ sau đại học được thiết kế để khó trả lời chỉ từ ghi nhớ, V4.1 Flash đạt 90.9.
Đó là kết quả mạnh cho một mô hình trong dải giá này và đưa nó vào cuộc trò chuyện với các mô hình tuyến đầu đắt đỏ hơn nhiều.
Trên Humanity's Last Exam (HLE), một điểm chuẩn chuyên gia cố ý khắc nghiệt, V4.1 Flash đạt 36.8, hoặc 39.1 với cấu hình gắn sao.
Để so sánh, các đánh giá tác tử-khoa học như Terminal-Bench-Science 0.1 cho thấy Claude Fable 5.1 ở mức 52.6% trước các đối thủ khó hơn, vì vậy V4.1 Flash không dẫn đầu ở các bài kiểm tra chuyên gia khó nhất, nhưng cũng không hề yếu kém.
V4.1 Flash đạt 65.6 trên MathArena Apex, một điểm chuẩn toán thi đấu đề cao suy luận ký hiệu nhiều bước.
Đây là một trong những kết quả mạnh hơn của mô hình và gợi ý rằng nó là lựa chọn hợp lý cho các tác vụ định lượng và nặng toán.
Một điểm số ở khoảng giữa 60 tại đây có ý nghĩa với bất kỳ ai xây dựng công cụ cần suy luận số học và đại số đáng tin cậy, vì nhiều mô hình rẻ hơn thường sụp đổ đúng ở các tác vụ này.
Quyết định ở đây ít liên quan đến biến thể mô hình và nhiều hơn về cách bạn triển khai V4.1 Flash, vì cùng trọng số có thể chạy theo ba cách. Lựa chọn của bạn xoay quanh khả năng dự đoán chi phí, quyền riêng tư dữ liệu và việc bạn có thể lập lịch công việc hay không.
DeepSeek cũng đang triển khai giai đoạn chuyển đổi. Từ 12:00 giờ Bắc Kinh ngày 14/09/2026 cho đến khi phát hành V4.1 Pro trong tương lai, các yêu cầu đến endpoint cũ sẽ được chuyển hướng, đẩy người dùng hiện tại về họ V4.1. Nếu bạn vẫn dùng V4 Pro 0813, mô hình đó đang bị loại bỏ dần, vì vậy hãy lên kế hoạch chuyển sang V4.1 Flash ngay bây giờ.
| Trường hợp sử dụng | Lộ trình khuyến nghị | Lý do |
|---|---|---|
| Tác tử mã hóa khối lượng lớn, luôn bật | API chính thức, giá cao điểm | $0.30/$1.20 mỗi 1M vốn đã thấp hơn nhiều so với đối thủ tuyến đầu; không tốn chi phí lập lịch |
| Các tác vụ suy luận hoặc toán theo lô lớn | API chính thức, ngoài giờ | Ngoài giờ giảm một nửa còn $0.15/$0.60 mỗi 1M nếu bạn có thể lập lịch chạy |
| Dữ liệu nhạy cảm hoặc độc quyền | Tự lưu trữ trọng số MIT | Giữ suy luận trên phần cứng của bạn; cần bộ nhớ GPU đáng kể |
| Tái sử dụng ngữ cảnh nặng | API với bộ nhớ đệm prompt | Đầu vào trúng bộ nhớ đệm $0.006 mỗi 1M khiến ngữ cảnh lặp lại gần như miễn phí |
V4.1 Flash là một trong những mô hình có năng lực rẻ nhất hiện có, đặc biệt là ngoài giờ. Dưới đây là chi tiết giá theo token.
| Mức | Cao điểm | Ngoài giờ |
|---|---|---|
| Đầu vào mỗi 1M token | $0.30 | $0.15 |
| Đầu ra mỗi 1M token | $1.20 | $0.60 |
| Đầu vào trúng bộ nhớ đệm mỗi 1M token | $0.006 | Chưa công bố |
Giá ngoài giờ được đặt bằng một nửa giá cao điểm và cơ chế này được thiết kế để đẩy các tác vụ theo lô và theo lịch vào khung giờ ngoài giờ.
Để đặt giá cao điểm vào bối cảnh, GPT-6 Astra và Claude Fable 5.1 đều tính $10 cho mỗi 1M đầu vào và $50 cho mỗi 1M đầu ra, vì vậy V4.1 Flash rẻ hơn khoảng 30 lần ở đầu vào và 40 lần ở đầu ra vào giờ cao điểm.
Mô hình sắp bị loại bỏ, V4 Pro 0813, có giá $0.435 mỗi 1M đầu vào và $0.87 mỗi 1M đầu ra với ngữ cảnh 1M token.
Bởi DeepSeek cho rằng V4.1 Flash vượt V4 Pro về hiệu năng, chi phí và tốc độ, hầu như không có lý do để ở lại mô hình cũ.
V4.1 Flash có sẵn qua API chính thức của DeepSeek, và trọng số theo giấy phép MIT được công bố để tự lưu trữ.
Từ ngày 14/09/2026, các yêu cầu đến endpoint cũ sẽ được chuyển hướng về họ V4.1 cho đến khi V4.1 Pro ra mắt.
V4.1 Flash vừa là mô hình API vừa là bản phát hành trọng số mở, vì vậy bạn có thể tiếp cận theo hai cách.
Trên API, ID mô hình thường được liệt kê là deepseek-flash, và endpoint tương thích với OpenAI, nghĩa là hầu hết mã khách OpenAI hiện có sẽ hoạt động chỉ với thay đổi base URL.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
Để tự lưu trữ, trọng số theo giấy phép MIT cho phép sử dụng thương mại, phân phối lại và tinh chỉnh mà không có ngưỡng doanh thu.
Khi chúng tôi chạy V4-Flash-0731 trước đó tại chỗ với Unsloth Studio, mô hình cần ba GPU NVIDIA A100 80GB ở mức lượng tử hóa Q8, vì vậy hãy dự trù phần cứng tương tự cho thiết lập độ chính xác đầy đủ.
Để xem hướng dẫn đầy đủ tại chỗ, hãy xem bài hướng dẫn chạy DeepSeek-V4-Flash với Unsloth Studio và OpenCode của chúng tôi, trong đó trình bày chi tiết phân phối GPU và thiết lập suy luận.
V4.1 Flash là tuyên bố của DeepSeek về giá và tính mở, trong khi phần còn lại của tuyến đầu đang leo lên mức $10/$50 mỗi 1M token và khóa quyền truy cập sau các gói trả phí.
Một mô hình MoE 552B với trọng số MIT, đầu vào hình ảnh gốc, 90.9 trên GPQA Diamond và giá cao điểm thấp hơn GPT-6 Astra 30 lần là một đề nghị nghiêm túc cho khối lượng công việc lớn.
Tôi sẽ chuyển sang mô hình này cho tác tử mã hóa và các tác vụ suy luận theo lô, đặc biệt nếu bạn có thể lập lịch ngoài giờ.
Điểm trừ xuất hiện khi nhìn vào mức 30.0 trên Terminal-Bench 3.0, cho thấy mô hình chệch choạc ở các tác vụ tác tử khó nhất, và cơ chế tính phí cao điểm/ngoài giờ khiến bạn phải tự đảm nhận công việc lập lịch.
Nếu bạn muốn xây dựng quy trình tác tử xoay quanh các mô hình như thế này, lộ trình kỹ năng AI Agent Fundamentals của chúng tôi là điểm khởi đầu tốt.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
