Alla fine del 2017, un articolo di ricerca intitolato Attention Is All You Need introdusse un meccanismo rivoluzionario destinato a ridefinire radicalmente l’intelligenza artificiale. Al cuore di questa svolta c’era la self-attention, un’idea semplice ma potente che consente ai modelli di comprendere le relazioni all’interno dei dati determinando quali elementi meritano attenzione.
Oggi, la self-attention alimenta tutto, dalle capacità conversazionali di ChatGPT ai sistemi avanzati di riconoscimento delle immagini. È sicuramente una delle innovazioni più trasformative nella storia del machine learning.
In questa guida ti accompagno nella self-attention, dalle basi concettuali alle applicazioni, mostrando come questo meccanismo aiuti i modelli a catturare dipendenze a lungo raggio e a elaborare le informazioni in parallelo, capacità prima irraggiungibili con le reti neurali tradizionali.
Se sei alle prime armi con i transformer, valuta uno dei nostri corsi introduttivi su Concetti sui Large Language Models (LLM) e Modelli Transformer con PyTorch.
Che cos’è la Self-Attention?
Per esperienza didattica, il punto di partenza migliore è una sfida fondamentale nell’elaborazione di sequenze: come può un modello stabilire quali parti dell’input sono più rilevanti in un dato momento?
Partiamo dall’intuizione prima di tuffarci nella matematica.
Comprensione concettuale della self-attention
La self-attention è un meccanismo che pesa l’importanza dei diversi elementi in una sequenza in relazione tra loro. Quando si elabora la frase "The animal didn't cross the road because it was too tired", la self-attention aiuta il modello a capire che "it" si riferisce a "animal" e non a "road", una relazione che copre più parole.
Questo è in realtà l’esempio che uso sempre quando introduco il concetto agli studenti. Scatta subito perché rispecchia il nostro modo naturale di leggere.
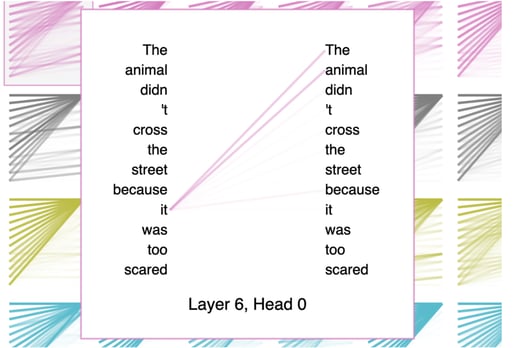
Meccanismo di attenzione
Ciò che rende particolarmente potente la self-attention è la capacità di calcolare queste relazioni per tutte le posizioni di una sequenza simultaneamente. A differenza delle reti neurali ricorrenti che elaborano le sequenze passo dopo passo, la self-attention esamina ogni elemento in relazione a tutti gli altri in un’unica passata in avanti.
Questo calcolo in parallelo riduce drasticamente i tempi di addestramento catturando al contempo le dipendenze indipendentemente dalla loro distanza nella sequenza.
È importante distinguere la self-attention da meccanismi correlati. Nella self-attention, una sequenza presta attenzione a sé stessa. Ogni elemento interroga informazioni da tutte le posizioni all’interno della stessa sequenza.
La cross-attention, invece, consente a una sequenza di prestare attenzione a un’altra, come quando un decoder guarda alle uscite dell’encoder durante la traduzione automatica.
La masked self-attention aggiunge un vincolo ulteriore: impedisce alle posizioni di prestare attenzione a posizioni successive, assicurando che le previsioni dipendano solo da output noti, essenziale per la generazione autoregressiva di testo.
Ma da dove nasce davvero questa idea e quali problemi è stata progettata per risolvere?
Origini e motivazioni della self-attention
Prima dell’emergere della self-attention, il campo si scontrava con importanti limitazioni nel modeling di sequenze.
Le reti neurali ricorrenti, incluse LSTM e GRU, elaborano le sequenze in modo sequenziale, creando un collo di bottiglia fondamentale: faticavano con le dipendenze a lungo raggio perché l’informazione doveva passare attraverso molti stati intermedi, portando a gradienti che svaniscono e contesto dimenticato.
L’evoluzione verso la self-attention è iniziata con i meccanismi di attenzione nelle architetture encoder-decoder basate su RNN. Nel 2014, Bahdanau e colleghi introdussero un meccanismo di attenzione che consentiva ai decoder di accedere a tutti gli stati nascosti dell’encoder invece di fare affidamento su un singolo vettore di contesto a lunghezza fissa.
Questa svolta affrontò il problema della compressione dell’informazione, in cui sequenze di input a lunghezza variabile venivano compresse in rappresentazioni a lunghezza fissa indipendentemente dalla loro complessità.
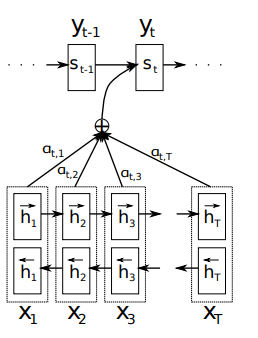
Illustrazione grafica del modello proposto da Bahdanau
Un anno dopo, Luong propose meccanismi di attenzione semplificati, inclusa l’attenzione scaled dot-product che avrebbe poi influenzato il design dei transformer. Sebbene questi primi meccanismi di attenzione migliorassero le prestazioni, dipendevano ancora dall’elaborazione sequenziale delle RNN.
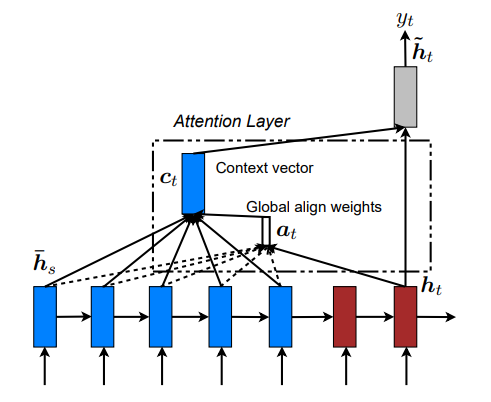
Modello di attenzione globale (Luong)
La vera rivoluzione è arrivata quando i ricercatori si sono chiesti: e se eliminassimo la ricorrenza affidandoci solo all’attenzione? Questa domanda ha portato all’architettura transformer, in cui la self-attention è diventata il meccanismo principale per comprendere le relazioni sequenziali.
Il quadro matematico della Self-Attention
Ora che abbiamo chiarito perché la self-attention è importante, vediamo come funziona concretamente a livello matematico.
Rappresentazioni di query, key e value
La self-attention trasforma le sequenze di input attraverso tre proiezioni apprese: query, key e value. Pensale come diverse "viste" della stessa informazione, ognuna con uno scopo distinto nel calcolo dell’attenzione.
Per una sequenza di input con dimensione di embedding d_model, creiamo tre matrici di pesi: W_Q, W_K e W_V. Moltiplicando la nostra matrice di input X per questi pesi, otteniamo:
-
Query matrix Q = X · W_Q: rappresenta "cosa sto cercando"
-
Key matrix K = X · W_K: rappresenta "cosa offro"
-
Value matrix V = X · W_V: rappresenta "ciò che contengo davvero"
Trovo utile questa analogia della biblioteca: entri con una query in mente, le schede di indice sono le key, e i libri veri e propri sono i value.
Tipicamente, queste matrici proiettano in una dimensione più piccola d_k (spesso d_model diviso per il numero di teste di attenzione), che gestisce la complessità computazionale mantenendo la capacità rappresentazionale. Questa riduzione dimensionale diventa particolarmente importante quando si scala a sequenze più lunghe.
Con Q, K e V pronte, possiamo calcolare l’attenzione vera e propria.
Scaled dot-product attention
Il calcolo dell’attenzione segue una formula elegante. Per prima cosa, calcoliamo gli score di attenzione facendo il prodotto scalare tra query e key. Questa operazione misura la compatibilità tra ciò che ogni posizione sta cercando e ciò che ogni altra posizione offre.
Tuttavia, all’aumentare della dimensionalità, questi prodotti scalari possono crescere molto in magnitudine, spingendo la funzione softmax in regioni con gradienti estremamente piccoli. Per evitare questa instabilità numerica, si scala dividendo per la radice quadrata della dimensione delle key.
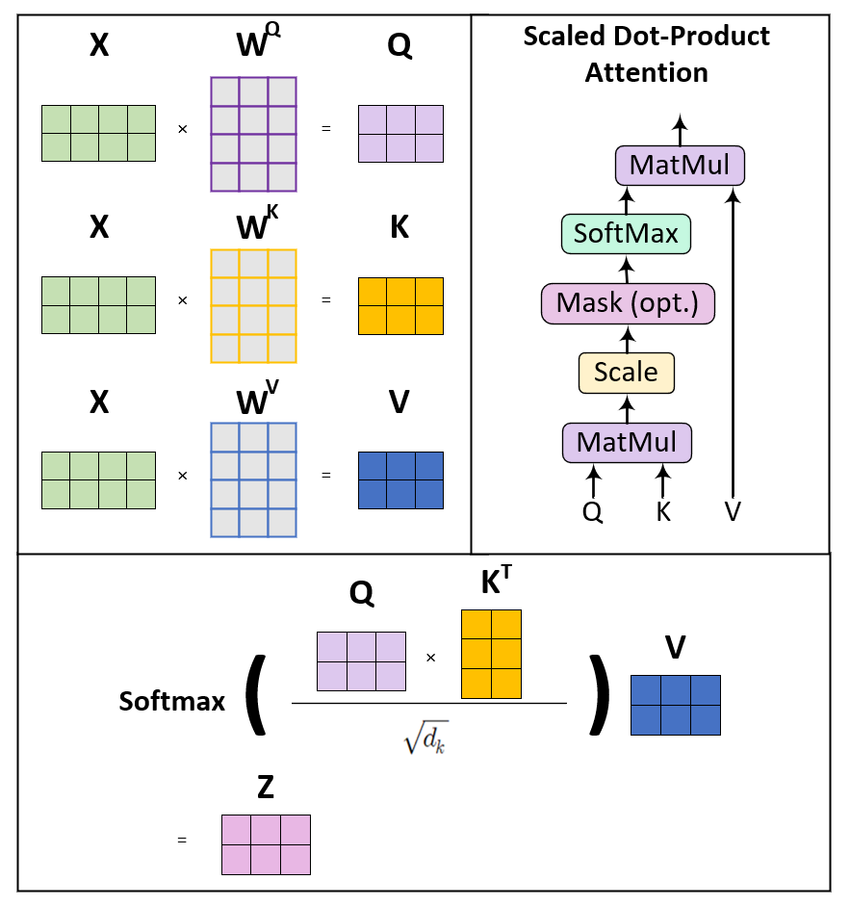
Scaled dot-product attention
Questo fattore di scala mantiene una varianza appropriata lungo la rete, garantendo gradienti stabili durante l’addestramento. Senza di esso, i modelli con embedding ad alta dimensione faticherebbero a imparare efficacemente, poiché la softmax restituirebbe distribuzioni quasi one-hot che non riescono a distribuire l’attenzione in modo significativo.
Prima di proseguire, c’è un aspetto importante da affrontare: il positional encoding.
Positional encoding
Ecco la parte che mi ha sorpreso di più quando ho studiato questo argomento: la self-attention è completamente invariante per permutazione. Se rimescoli i token in input, otterrai lo stesso output. Solo rimescolato di conseguenza.
Mi ci è voluto un attimo per afferrare l’implicazione: il meccanismo è potente, ma essenzialmente cieco all’ordine. Per i compiti in cui l’ordine conta (come comprendere il linguaggio), dobbiamo iniettare esplicitamente informazioni posizionali.
Il transformer originale usava posizional encoding sinusoidali, applicando funzioni seno e coseno a diverse frequenze su ciascuna dimensione. Questa scelta non era arbitraria. I pattern ondulatori permettono ai modelli di imparare ad attenzionare posizioni relative e l’encoding si estende naturalmente a lunghezze di sequenza mai viste.
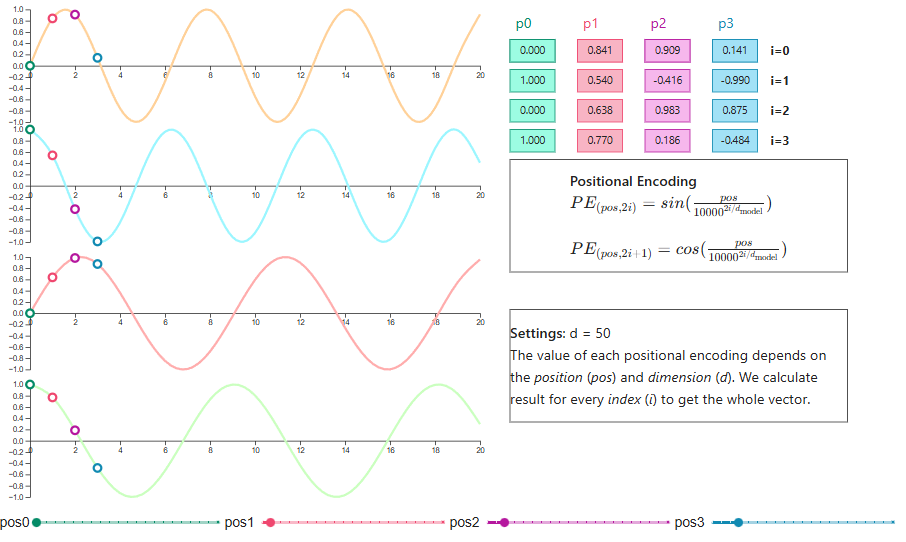
Visualizzazione del positional encoding
Innovazioni più recenti includono RoPE (Rotary Position Embedding), che ruota i vettori di query e key in uno spazio multidimensionale di angoli proporzionali alle loro posizioni. Dopo la rotazione, il prodotto scalare tra query e key codifica naturalmente la distanza relativa.
RoPE ha avuto un’ampia adozione in modelli come LLaMA grazie alle sue forti capacità di extrapolation.
Un altro approccio, ALiBi (Attention with Linear Biases), segue una strada diversa aggiungendo penalità dipendenti dalla posizione direttamente agli score di attenzione. Invece di modificare gli embedding, ALiBi introduce bias nei pesi di attenzione per favorire i token vicini, con un’intensità del bias che varia tra le diverse teste di attenzione.
Questo metodo dimostra un’impressionante capacità di extrapolation a lunghezze di sequenza molto oltre quelle viste in addestramento.
Softmax e pesi di attenzione
Dopo aver calcolato gli score di attenzione scalati, applichiamo la softmax lungo la dimensione delle key. Questa normalizzazione converte gli score grezzi in una distribuzione di probabilità, assicurando che i pesi di attenzione sommino a uno per ogni posizione di query.
La funzione softmax enfatizza le relazioni con lo score più alto sopprimendo le connessioni irrilevanti. Tuttavia, talvolta può portare a distribuzioni eccessivamente appuntite, in particolare nelle prime fasi dell’addestramento, quando il modello non ha ancora imparato pattern di attenzione sfumati.
Per mitigare questo effetto, spesso si applica il dropout ai pesi di attenzione, azzerando casualmente alcune connessioni per incoraggiare la robustezza.
Calcolo dei vettori di contesto
Avendo in mano i pesi di attenzione, calcoliamo l’output finale come somma pesata dei vettori value.
Ogni posizione riceve una rappresentazione consapevole del contesto che aggrega informazioni da tutta la sequenza, con contributi proporzionali ai pesi di attenzione. Questa combinazione pesata permette all’informazione di fluire in modo dinamico in base a relazioni apprese piuttosto che a schemi fissi.
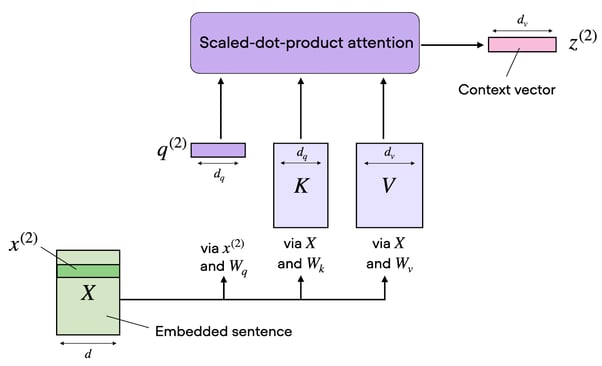
Calcolo del vettore di contesto
L’attenzione a singola testa ci porta sorprendentemente lontano, ma ha un tetto. È qui che le cose si fanno più interessanti.
Multi-Head Attention e sottospazi di rappresentazione multipli
Sebbene l’attenzione a singola testa sia potente, ha un limite fondamentale: può catturare un solo tipo di relazione alla volta.
Motivazione e architettura
La multi-head attention affronta questo limite eseguendo diverse computazioni di attenzione in parallelo, ciascuna focalizzata su aspetti differenti delle relazioni in input. Ad esempio, ci potrebbe essere una testa specializzata in ciascuno dei seguenti aspetti:
- Dipendenze sintattiche locali
- Relazioni semantiche a lungo raggio
- Pattern posizionali
Per quanto ho osservato lavorando con questi modelli, questa specializzazione spesso emerge in modo organico durante l’addestramento. Non la progetti a priori, e credo che sia uno degli aspetti più affascinanti dell’intero meccanismo.
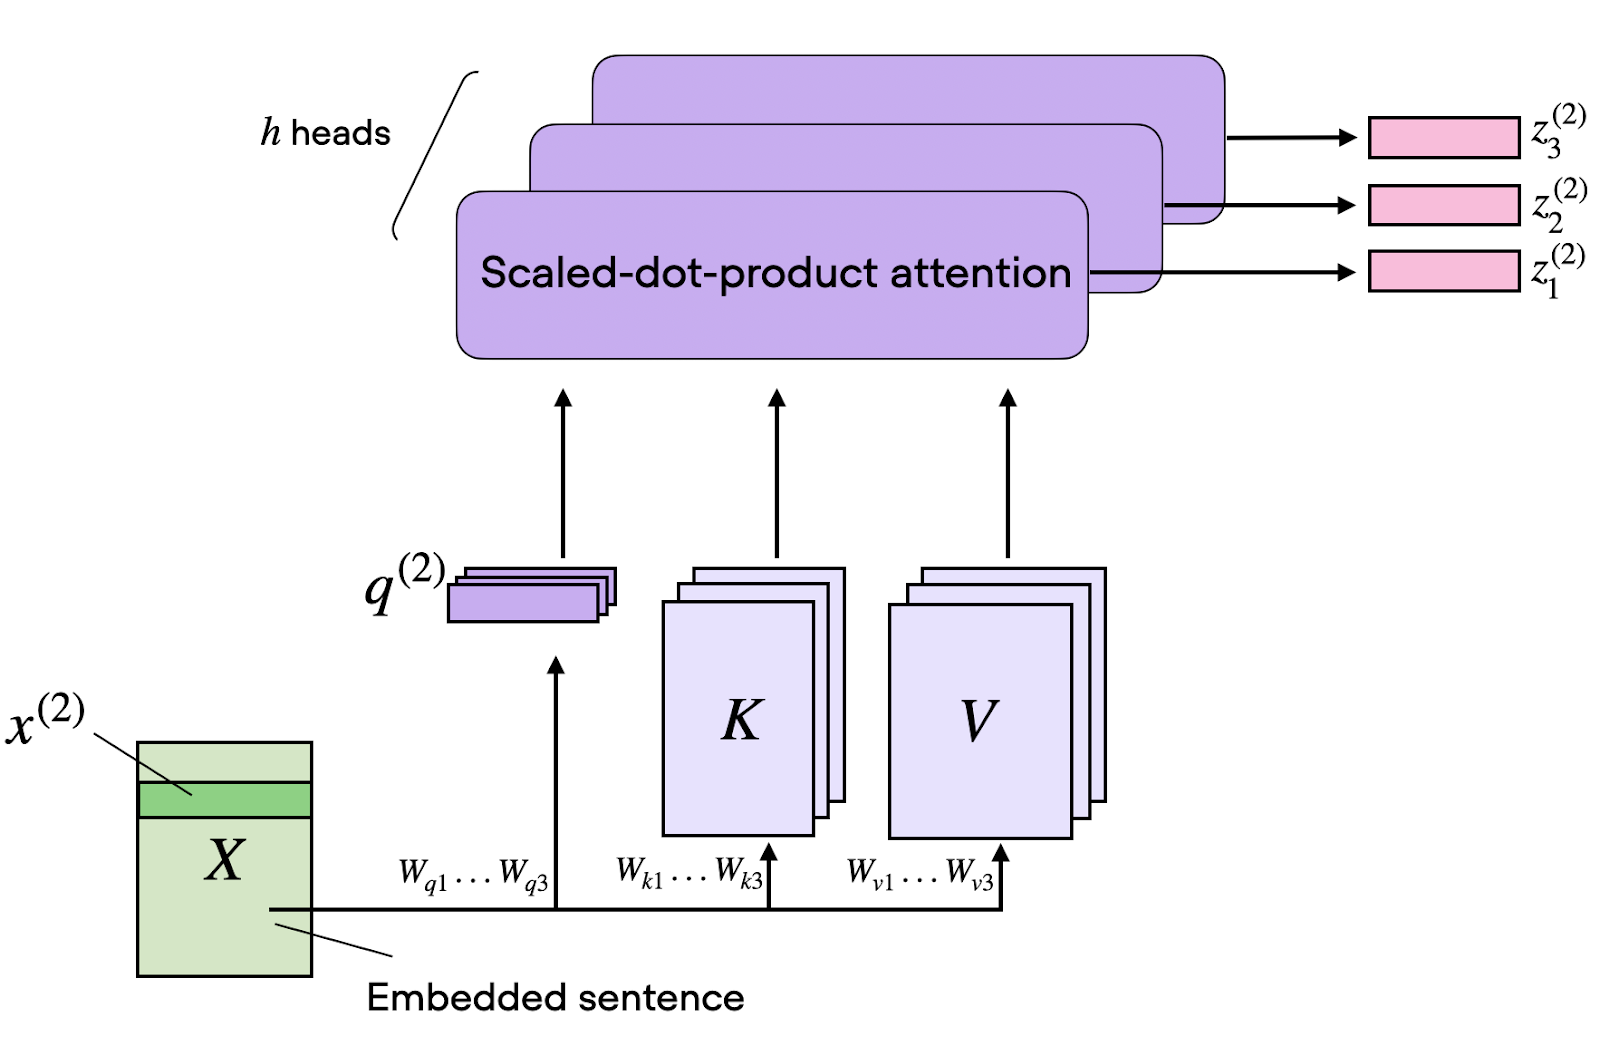
Multi-head attention
L’implementazione prevede la suddivisione delle matrici Q, K e V lungo l’asse dimensionale, l’elaborazione di ciascuna parte tramite teste di attenzione separate e il concatenamento dei risultati.
Se abbiamo 8 teste e embedding a 512 dimensioni, ogni testa opera su sottospazi a 64 dimensioni. Questa elaborazione in parallelo non aumenta la complessità rispetto alla lunghezza della sequenza ma moltiplica la capacità del modello di apprendere pattern diversi.
Cosa imparano le diverse teste
La ricerca su ciò che effettivamente imparano le diverse teste di attenzione ha rivelato pattern affascinanti.
Nei modelli di traduzione, alcune teste prestano costantemente attenzione alle relazioni posizionali, focalizzandosi sulle parole vicine indipendentemente dal contenuto. Altre teste si specializzano in ruoli sintattici, identificando relazioni soggetto-verbo o verbo-oggetto. Una terza categoria guarda a token rari o ad alta informazione come nomi propri e termini tecnici.
In modo interessante, studi di interpretabilità mostrano che molte teste sembrano ridondanti, e i modelli possono mantenere le prestazioni anche quando una frazione significativa di teste viene potata. Questa ridondanza probabilmente contribuisce alla robustezza, assicurando che pattern critici abbiano più percorsi attraverso la rete.
Nell’attenzione encoder-decoder, le teste negli strati decoder più avanzati risultano le più essenziali per la qualità della traduzione, mentre le teste di self-attention dell’encoder possono spesso essere ridotte sostanzialmente.
Definite le basi matematiche, vediamo come la self-attention si integra nell’architettura completa del transformer.
L’encoder: attenzione all-to-all
Nel transformer encoder, i layer di self-attention consentono a ciascuna posizione di prestare attenzione a tutte le altre posizioni nella sequenza di input. Questo schema "all-to-all" abilita un flusso di contesto bidirezionale, in cui ogni token costruisce una rappresentazione informata dall’intera sequenza.
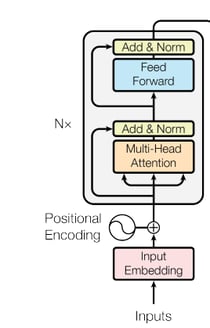
Architettura dell’encoder
Ogni layer dell’encoder combina multi-head self-attention con una rete feed-forward position-wise. La rete feed-forward elabora ogni posizione in modo indipendente ma identico, applicando la stessa trasformazione appresa a tutti i token.
Connessioni residuali e layer normalization circondano entrambe le sotto-sezioni, stabilizzando i gradienti e permettendo architetture più profonde. Impilare più layer encoder crea rappresentazioni sempre più astratte: i layer iniziali catturano pattern superficiali, quelli più profondi codificano relazioni semantiche.
Il decoder: attenzione mascherata e causalità
Il decoder modifica la self-attention per rispettare i vincoli autoregressivi. Quando genera testo, il modello può basarsi solo sui token già prodotti. Dare un’occhiata ai token futuri sarebbe barare durante l’addestramento.
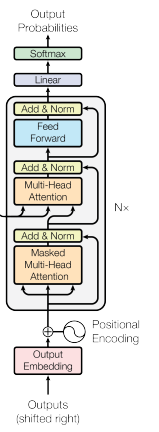
Architettura del decoder
La masked self-attention lo realizza impostando a meno infinito (che diventa zero dopo la softmax) i pesi di attenzione per tutte le posizioni successive a quella corrente.
Questo assicura che le previsioni dipendano solo dal contesto precedente e che sia mantenuto l’ordinamento causale necessario per i compiti di generazione. In inferenza, questa causalità diventa naturale: semplicemente non abbiamo ancora token futuri a cui prestare attenzione.
Cross-attention: collegare encoder e decoder
Tra i layer di self-attention del decoder si trova la cross-attention, che permette al decoder di condizionarsi sulle uscite dell’encoder. Qui le query provengono dal decoder (rappresentano "ciò che devo generare"), mentre key e value provengono dall’encoder (rappresentano "ciò che fornisce l’input").
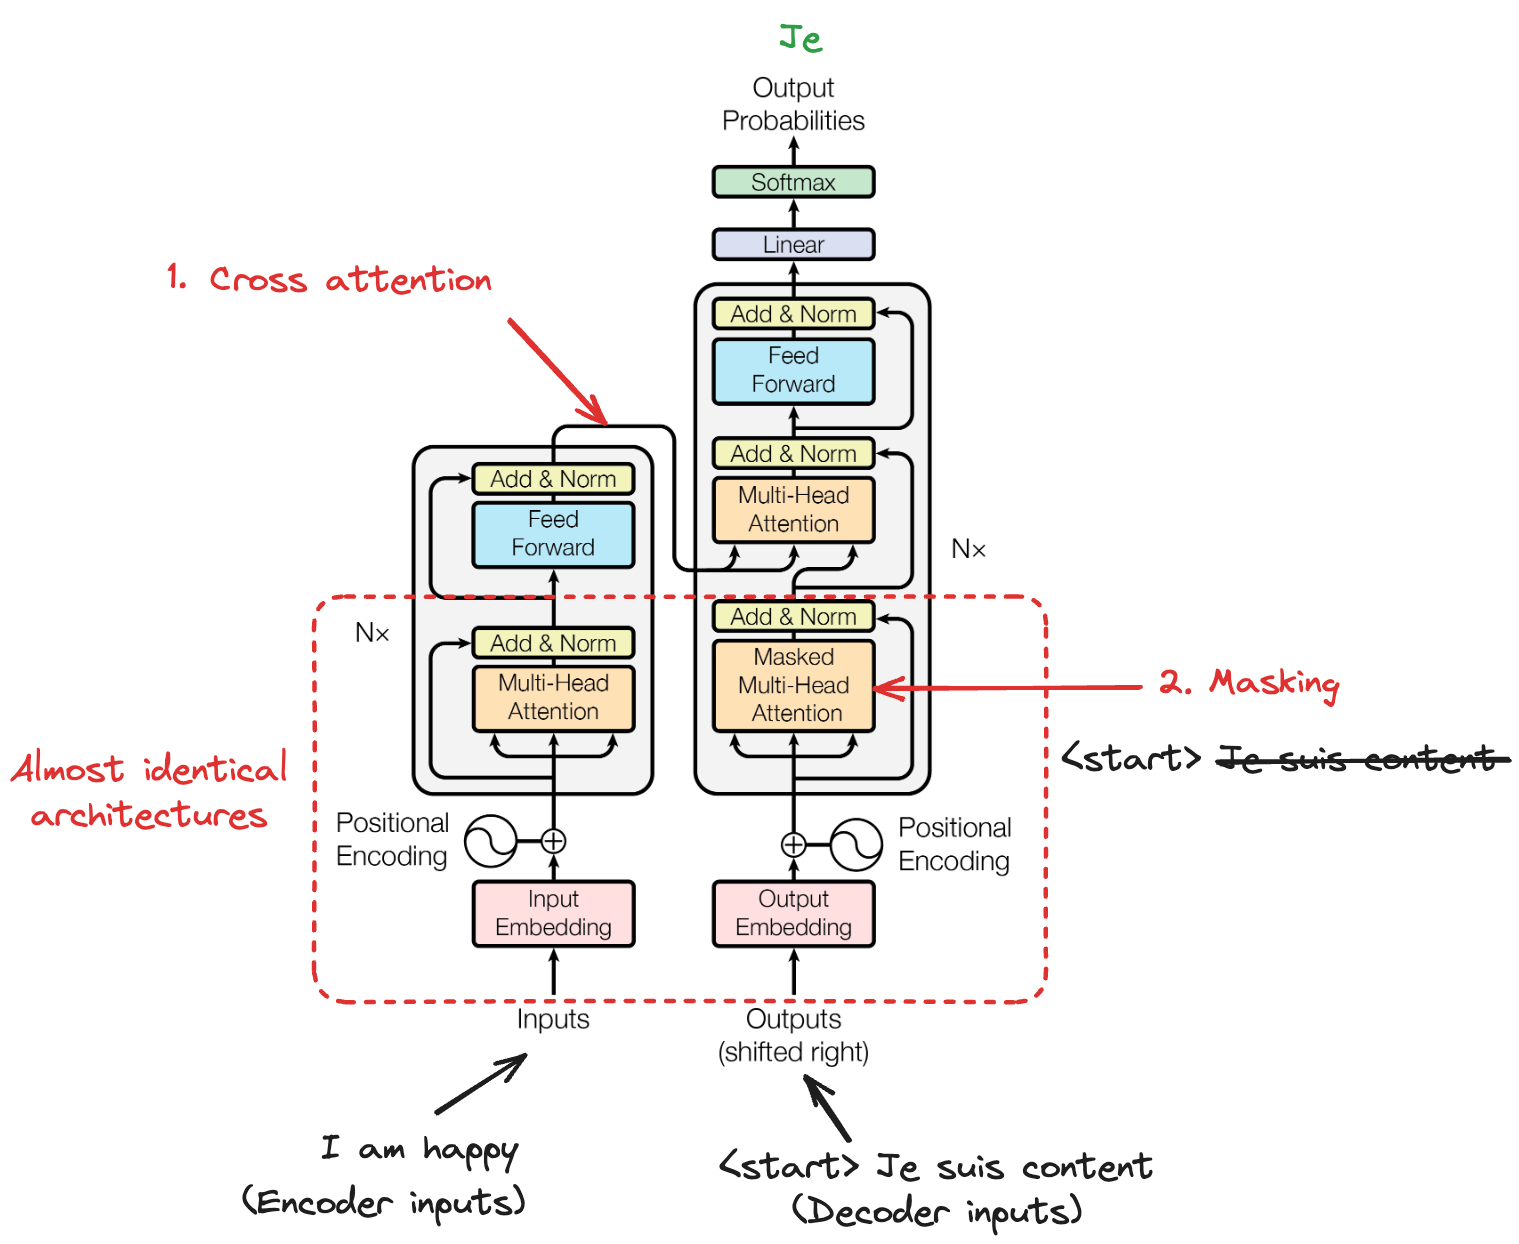
Architettura del Transformer
Questo meccanismo di cross-attention è essenziale per i compiti sequenza-a-sequenza come la traduzione, in cui il decoder deve allineare le parole in output con le parole rilevanti in input. A differenza della self-attention, la cross-attention crea dipendenze tra due sequenze diverse, permettendo il flusso di informazioni dalla sorgente al bersaglio.
Teoria a parte, cosa ha reso possibile in pratica la self-attention? La risposta è più ampia di quanto molti si aspettino.
Applicazioni della Self-Attention tra i domini
Dopo aver visto come funziona la self-attention nell’architettura transformer, esaminiamo dove questo meccanismo ha avuto un impatto concreto nel mondo reale.
Il valore particolare della self-attention sta nella sua natura agnostica al dominio. Lo stesso quadro matematico che aiuta i modelli a comprendere le relazioni linguistiche può catturare pattern in immagini, audio e persino combinazioni di tipi di dati diversi.
A mio avviso, questa qualità agnostica al dominio è ciò che rende davvero entusiasmante la self-attention. Direi che è meno uno strumento di NLP e più un meccanismo general-purpose per apprendere relazioni.
Applicazioni nel Natural Language Processing
I modelli transformer eccellono nel catturare dipendenze a lungo raggio sfuggite alle architetture precedenti. Nell’NLP, la self-attention alimenta modelli d’avanguardia praticamente in ogni task.
- Traduzione automatica: allineamento di frasi sorgente e bersaglio indipendentemente dalla distanza
- Analisi del sentiment: identificazione di segnali contestuali che modificano il significato
- Question answering: collegamento delle domande ai passaggi pertinenti, anche quando separati da molti token.
Come puoi vedere nell’immagine qui sotto, l’architettura dei modelli differisce a seconda che il focus sia sul decoder o sull’encoder.
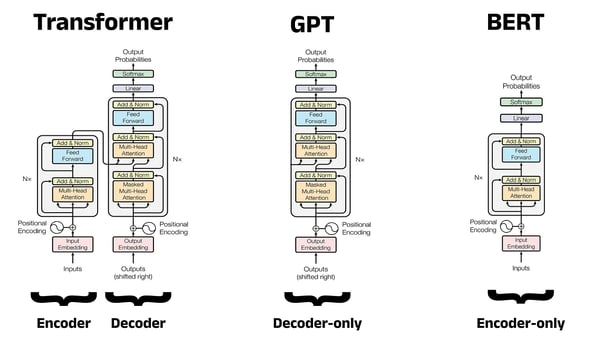
Confronto di architettura: Transformer vs. GPT vs. BERT
Modelli come BERT usano self-attention bidirezionale nella loro architettura solo-encoder, permettendo di costruire ricche rappresentazioni contestuali per compiti di classificazione e comprensione.
I modelli GPT, come il recente GPT-5.3 Codex, usano la masked self-attention nel design solo-decoder, ottenendo notevoli capacità di generazione del testo.
T5 impiega l’architettura completa encoder-decoder del transformer, trattando tutti i task di NLP come problemi text-to-text.
Applicazioni nella computer vision
L’adattamento Vision Transformer (ViT) ha portato la self-attention nella computer vision trattando le immagini come sequenze di patch. Invece di elaborare i pixel tramite layer convoluzionali, ViT suddivide le immagini in patch di dimensione fissa (tipicamente 16×16), appiattisce ogni patch in un vettore ed elabora la sequenza tramite layer transformer.
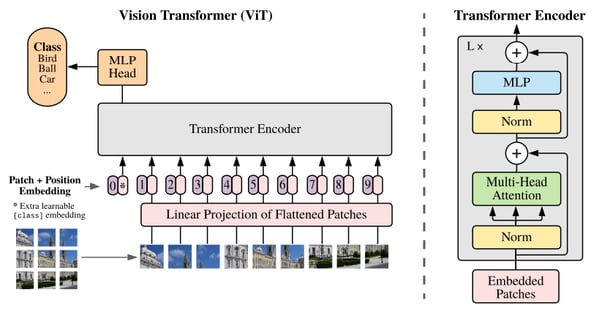
Vision Transformer
Questo approccio cattura relazioni globali che i campi recettivi locali delle reti convoluzionali potrebbero non cogliere. ViT e le sue varianti ora raggiungono risultati all’avanguardia in classificazione di immagini, object detection, segmentazione semantica e altri ambiti:
- Imaging medico: correlazione di anomalie sottili tra diverse regioni di una scansione.
- Analisi di immagini satellitari: collegamento di elementi distanti, come siti di deforestazione, alle loro cause.
Speech, sistemi di raccomandazione e apprendimento multimodale
L’utilità della self-attention si estende all’elaborazione vocale, dove cattura le dipendenze temporali nelle sequenze audio più efficacemente dei modelli ricorrenti. Nei sistemi di raccomandazione, la self-attention aiuta a modellare i pattern di preferenza utente prestando attenzione alle interazioni storiche rilevanti.
Forse le più entusiasmanti sono le applicazioni multimodali che combinano visione e linguaggio. Modelli come CLIP usano la cross-attention tra rappresentazioni di immagini e testo, abilitando la classificazione di immagini zero-shot e la generazione di immagini da descrizioni testuali.
Ciò che questi sistemi hanno in comune: dimostrano la capacità fondamentale della self-attention di apprendere relazioni tra qualsiasi dato sequenziale o strutturato, a prescindere dalla modalità.
Varianti avanzate di Self-Attention e sviluppi recenti
Sebbene la self-attention abbia avuto un successo notevole in vari domini, emergono nuove sfide quando si distribuiscono modelli transformer su larga scala. Man mano che i modelli crescono fino a miliardi di parametri e processano contesti che si estendono a centinaia di migliaia di token, la larghezza di banda della memoria e i costi computazionali diventano colli di bottiglia critici.
Lo sviluppo di nuovi modelli si concentra sempre più nel rendere la self-attention più veloce ed efficiente senza sacrificarne le capacità fondamentali. Trovo questa tensione tra capacità ed efficienza una delle questioni aperte più interessanti del momento. Diamo un’occhiata ad alcuni sviluppi attuali.
Grouped-query e multi-query attention
La multi-head attention standard mantiene proiezioni key e value separate per ogni testa, creando un notevole overhead di memoria in inferenza. La multi-query attention (MQA) riduce questo costo condividendo un’unica testa key-value (KV) tra tutte le teste di query, riducendo drasticamente la cache KV e accelerando il decoding. Tuttavia, la MQA può degradare la qualità.
La grouped-query attention (GQA) è un approccio più bilanciato, dividendo le teste di query in gruppi che condividono le coppie key-value. Con 32 teste di query e 8 gruppi, ogni gruppo di 4 query condivide una testa key-value. Per esempio, la famiglia di modelli Mistral 3 usa questo approccio e riesce a ottenere una qualità quasi pari alla full-attention con notevoli guadagni in velocità.
Architetture ibride che combinano attention e state space models
Mentre la GQA affronta l’efficienza della memoria, un’altra linea di ricerca attacca il collo di bottiglia computazionale fondamentale dell’attenzione da un’angolazione diversa.
Lavori recenti esplorano la combinazione della self-attention con modelli a spazi di stato per migliorare l’efficienza. Sistemi come S4 e Hyena usano spazi di stato strutturati per modellare dipendenze a lungo raggio con complessità lineare anziché quadratica.
Questi approcci affrontano il limite fondamentale della self-attention: il costo computazionale scala quadraticamente con la lunghezza della sequenza, rendendo estremamente costosi i contesti molto lunghi.
Scaling in inferenza e ottimizzazione a test-time
Oltre a ripensare l’architettura, i ricercatori hanno trovato modi ingegnosi per ottimizzare i meccanismi di attenzione esistenti.
Oltre ai cambiamenti architetturali, progressi recenti ottimizzano l’attenzione in inferenza. La quantizzazione riduce la precisione della cache KV a 8 o 4 bit, tagliando drasticamente la memoria con perdita di qualità minima.
Flash Attention riorganizza l’accesso alla memoria GPU per minimizzare il movimento dei dati, ottenendo accelerazioni di 2-3×. La test-time compute optimization, in cui i modelli eseguono più passaggi durante la generazione, suggerisce che un’applicazione strategica dell’attenzione potrebbe dare risultati migliori del semplice aumento della dimensione del modello.
Conclusione
La self-attention è uno dei meccanismi più trasformativi nella storia del machine learning. Consentendo ai modelli di determinare dinamicamente quali elementi dell’input meritano attenzione, ha risolto problemi di lunga data nel catturare dipendenze a lungo raggio e nell’elaborare sequenze in modo efficiente.
L’eleganza matematica dell’attenzione scaled dot-product, potenziata dalle architetture multi-head, offre solidità teorica ed efficacia pratica.
Dai modelli di linguaggio allo stato-dell’arte alla rivoluzione della computer vision e all’abilitazione di sistemi di IA multimodale, la self-attention continua ad ampliare la sua portata. Innovazioni recenti come la grouped-query attention, le architetture ibride e l’ottimizzazione in inferenza mostrano che stiamo ancora scoprendo modi per rendere questo meccanismo più efficiente e capace.
Se vuoi entrare in tutti i dettagli e fare pratica concreta, ti consiglio di iscriverti al nostro percorso di competenze Developing Large Language Models.







Alla fine del 2017, un articolo di ricerca intitolato Attention Is All You Need introdusse un meccanismo rivoluzionario destinato a ridefinire radicalmente l’intelligenza artificiale. Al cuore di questa svolta c’era la self-attention, un’idea semplice ma potente che consente ai modelli di comprendere le relazioni all’interno dei dati determinando quali elementi meritano attenzione.
Oggi, la self-attention alimenta tutto, dalle capacità conversazionali di ChatGPT ai sistemi avanzati di riconoscimento delle immagini. È sicuramente una delle innovazioni più trasformative nella storia del machine learning.
In questa guida ti accompagno nella self-attention, dalle basi concettuali alle applicazioni, mostrando come questo meccanismo aiuti i modelli a catturare dipendenze a lungo raggio e a elaborare le informazioni in parallelo, capacità prima irraggiungibili con le reti neurali tradizionali.
Se sei alle prime armi con i transformer, valuta uno dei nostri corsi introduttivi su Concetti sui Large Language Models (LLM) e Modelli Transformer con PyTorch.
Che cos’è la Self-Attention?
Per esperienza didattica, il punto di partenza migliore è una sfida fondamentale nell’elaborazione di sequenze: come può un modello stabilire quali parti dell’input sono più rilevanti in un dato momento?
Partiamo dall’intuizione prima di tuffarci nella matematica.
Comprensione concettuale della self-attention
La self-attention è un meccanismo che pesa l’importanza dei diversi elementi in una sequenza in relazione tra loro. Quando si elabora la frase "The animal didn't cross the road because it was too tired", la self-attention aiuta il modello a capire che "it" si riferisce a "animal" e non a "road", una relazione che copre più parole.
Questo è in realtà l’esempio che uso sempre quando introduco il concetto agli studenti. Scatta subito perché rispecchia il nostro modo naturale di leggere.
Meccanismo di attenzione
Ciò che rende particolarmente potente la self-attention è la capacità di calcolare queste relazioni per tutte le posizioni di una sequenza simultaneamente. A differenza delle reti neurali ricorrenti che elaborano le sequenze passo dopo passo, la self-attention esamina ogni elemento in relazione a tutti gli altri in un’unica passata in avanti.
Questo calcolo in parallelo riduce drasticamente i tempi di addestramento catturando al contempo le dipendenze indipendentemente dalla loro distanza nella sequenza.
È importante distinguere la self-attention da meccanismi correlati. Nella self-attention, una sequenza presta attenzione a sé stessa. Ogni elemento interroga informazioni da tutte le posizioni all’interno della stessa sequenza.
La cross-attention, invece, consente a una sequenza di prestare attenzione a un’altra, come quando un decoder guarda alle uscite dell’encoder durante la traduzione automatica.
La masked self-attention aggiunge un vincolo ulteriore: impedisce alle posizioni di prestare attenzione a posizioni successive, assicurando che le previsioni dipendano solo da output noti, essenziale per la generazione autoregressiva di testo.
Ma da dove nasce davvero questa idea e quali problemi è stata progettata per risolvere?
Origini e motivazioni della self-attention
Prima dell’emergere della self-attention, il campo si scontrava con importanti limitazioni nel modeling di sequenze.
Le reti neurali ricorrenti, incluse LSTM e GRU, elaborano le sequenze in modo sequenziale, creando un collo di bottiglia fondamentale: faticavano con le dipendenze a lungo raggio perché l’informazione doveva passare attraverso molti stati intermedi, portando a gradienti che svaniscono e contesto dimenticato.
L’evoluzione verso la self-attention è iniziata con i meccanismi di attenzione nelle architetture encoder-decoder basate su RNN. Nel 2014, Bahdanau e colleghi introdussero un meccanismo di attenzione che consentiva ai decoder di accedere a tutti gli stati nascosti dell’encoder invece di fare affidamento su un singolo vettore di contesto a lunghezza fissa.
Questa svolta affrontò il problema della compressione dell’informazione, in cui sequenze di input a lunghezza variabile venivano compresse in rappresentazioni a lunghezza fissa indipendentemente dalla loro complessità.
Illustrazione grafica del modello proposto da Bahdanau
Un anno dopo, Luong propose meccanismi di attenzione semplificati, inclusa l’attenzione scaled dot-product che avrebbe poi influenzato il design dei transformer. Sebbene questi primi meccanismi di attenzione migliorassero le prestazioni, dipendevano ancora dall’elaborazione sequenziale delle RNN.
Modello di attenzione globale (Luong)
La vera rivoluzione è arrivata quando i ricercatori si sono chiesti: e se eliminassimo la ricorrenza affidandoci solo all’attenzione? Questa domanda ha portato all’architettura transformer, in cui la self-attention è diventata il meccanismo principale per comprendere le relazioni sequenziali.
Il quadro matematico della Self-Attention
Ora che abbiamo chiarito perché la self-attention è importante, vediamo come funziona concretamente a livello matematico.
Rappresentazioni di query, key e value
La self-attention trasforma le sequenze di input attraverso tre proiezioni apprese: query, key e value. Pensale come diverse "viste" della stessa informazione, ognuna con uno scopo distinto nel calcolo dell’attenzione.
Per una sequenza di input con dimensione di embedding
d_model, creiamo tre matrici di pesi:W_Q,W_KeW_V. Moltiplicando la nostra matrice di inputXper questi pesi, otteniamo:Query matrix
Q = X · W_Q: rappresenta "cosa sto cercando"Key matrix
K = X · W_K: rappresenta "cosa offro"Value matrix
V = X · W_V: rappresenta "ciò che contengo davvero"Trovo utile questa analogia della biblioteca: entri con una query in mente, le schede di indice sono le key, e i libri veri e propri sono i value.
Tipicamente, queste matrici proiettano in una dimensione più piccola
d_k(spessod_modeldiviso per il numero di teste di attenzione), che gestisce la complessità computazionale mantenendo la capacità rappresentazionale. Questa riduzione dimensionale diventa particolarmente importante quando si scala a sequenze più lunghe.Con Q, K e V pronte, possiamo calcolare l’attenzione vera e propria.
Scaled dot-product attention
Il calcolo dell’attenzione segue una formula elegante. Per prima cosa, calcoliamo gli score di attenzione facendo il prodotto scalare tra query e key. Questa operazione misura la compatibilità tra ciò che ogni posizione sta cercando e ciò che ogni altra posizione offre.
Tuttavia, all’aumentare della dimensionalità, questi prodotti scalari possono crescere molto in magnitudine, spingendo la funzione softmax in regioni con gradienti estremamente piccoli. Per evitare questa instabilità numerica, si scala dividendo per la radice quadrata della dimensione delle key.
Scaled dot-product attention
Questo fattore di scala mantiene una varianza appropriata lungo la rete, garantendo gradienti stabili durante l’addestramento. Senza di esso, i modelli con embedding ad alta dimensione faticherebbero a imparare efficacemente, poiché la softmax restituirebbe distribuzioni quasi one-hot che non riescono a distribuire l’attenzione in modo significativo.
Prima di proseguire, c’è un aspetto importante da affrontare: il positional encoding.
Positional encoding
Ecco la parte che mi ha sorpreso di più quando ho studiato questo argomento: la self-attention è completamente invariante per permutazione. Se rimescoli i token in input, otterrai lo stesso output. Solo rimescolato di conseguenza.
Mi ci è voluto un attimo per afferrare l’implicazione: il meccanismo è potente, ma essenzialmente cieco all’ordine. Per i compiti in cui l’ordine conta (come comprendere il linguaggio), dobbiamo iniettare esplicitamente informazioni posizionali.
Il transformer originale usava posizional encoding sinusoidali, applicando funzioni seno e coseno a diverse frequenze su ciascuna dimensione. Questa scelta non era arbitraria. I pattern ondulatori permettono ai modelli di imparare ad attenzionare posizioni relative e l’encoding si estende naturalmente a lunghezze di sequenza mai viste.
Visualizzazione del positional encoding
Innovazioni più recenti includono RoPE (Rotary Position Embedding), che ruota i vettori di query e key in uno spazio multidimensionale di angoli proporzionali alle loro posizioni. Dopo la rotazione, il prodotto scalare tra query e key codifica naturalmente la distanza relativa.
RoPE ha avuto un’ampia adozione in modelli come LLaMA grazie alle sue forti capacità di extrapolation.
Un altro approccio, ALiBi (Attention with Linear Biases), segue una strada diversa aggiungendo penalità dipendenti dalla posizione direttamente agli score di attenzione. Invece di modificare gli embedding, ALiBi introduce bias nei pesi di attenzione per favorire i token vicini, con un’intensità del bias che varia tra le diverse teste di attenzione.
Questo metodo dimostra un’impressionante capacità di extrapolation a lunghezze di sequenza molto oltre quelle viste in addestramento.
Softmax e pesi di attenzione
Dopo aver calcolato gli score di attenzione scalati, applichiamo la softmax lungo la dimensione delle key. Questa normalizzazione converte gli score grezzi in una distribuzione di probabilità, assicurando che i pesi di attenzione sommino a uno per ogni posizione di query.
La funzione softmax enfatizza le relazioni con lo score più alto sopprimendo le connessioni irrilevanti. Tuttavia, talvolta può portare a distribuzioni eccessivamente appuntite, in particolare nelle prime fasi dell’addestramento, quando il modello non ha ancora imparato pattern di attenzione sfumati.
Per mitigare questo effetto, spesso si applica il dropout ai pesi di attenzione, azzerando casualmente alcune connessioni per incoraggiare la robustezza.
Calcolo dei vettori di contesto
Avendo in mano i pesi di attenzione, calcoliamo l’output finale come somma pesata dei vettori value.
Ogni posizione riceve una rappresentazione consapevole del contesto che aggrega informazioni da tutta la sequenza, con contributi proporzionali ai pesi di attenzione. Questa combinazione pesata permette all’informazione di fluire in modo dinamico in base a relazioni apprese piuttosto che a schemi fissi.
Calcolo del vettore di contesto
L’attenzione a singola testa ci porta sorprendentemente lontano, ma ha un tetto. È qui che le cose si fanno più interessanti.
Multi-Head Attention e sottospazi di rappresentazione multipli
Sebbene l’attenzione a singola testa sia potente, ha un limite fondamentale: può catturare un solo tipo di relazione alla volta.
Motivazione e architettura
La multi-head attention affronta questo limite eseguendo diverse computazioni di attenzione in parallelo, ciascuna focalizzata su aspetti differenti delle relazioni in input. Ad esempio, ci potrebbe essere una testa specializzata in ciascuno dei seguenti aspetti:
Per quanto ho osservato lavorando con questi modelli, questa specializzazione spesso emerge in modo organico durante l’addestramento. Non la progetti a priori, e credo che sia uno degli aspetti più affascinanti dell’intero meccanismo.
Multi-head attention
L’implementazione prevede la suddivisione delle matrici
Q,KeVlungo l’asse dimensionale, l’elaborazione di ciascuna parte tramite teste di attenzione separate e il concatenamento dei risultati.Se abbiamo 8 teste e embedding a 512 dimensioni, ogni testa opera su sottospazi a 64 dimensioni. Questa elaborazione in parallelo non aumenta la complessità rispetto alla lunghezza della sequenza ma moltiplica la capacità del modello di apprendere pattern diversi.
Cosa imparano le diverse teste
La ricerca su ciò che effettivamente imparano le diverse teste di attenzione ha rivelato pattern affascinanti.
Nei modelli di traduzione, alcune teste prestano costantemente attenzione alle relazioni posizionali, focalizzandosi sulle parole vicine indipendentemente dal contenuto. Altre teste si specializzano in ruoli sintattici, identificando relazioni soggetto-verbo o verbo-oggetto. Una terza categoria guarda a token rari o ad alta informazione come nomi propri e termini tecnici.
In modo interessante, studi di interpretabilità mostrano che molte teste sembrano ridondanti, e i modelli possono mantenere le prestazioni anche quando una frazione significativa di teste viene potata. Questa ridondanza probabilmente contribuisce alla robustezza, assicurando che pattern critici abbiano più percorsi attraverso la rete.
Nell’attenzione encoder-decoder, le teste negli strati decoder più avanzati risultano le più essenziali per la qualità della traduzione, mentre le teste di self-attention dell’encoder possono spesso essere ridotte sostanzialmente.
La Self-Attention nell’architettura Transformer
Definite le basi matematiche, vediamo come la self-attention si integra nell’architettura completa del transformer.
L’encoder: attenzione all-to-all
Nel transformer encoder, i layer di self-attention consentono a ciascuna posizione di prestare attenzione a tutte le altre posizioni nella sequenza di input. Questo schema "all-to-all" abilita un flusso di contesto bidirezionale, in cui ogni token costruisce una rappresentazione informata dall’intera sequenza.
Architettura dell’encoder
Ogni layer dell’encoder combina multi-head self-attention con una rete feed-forward position-wise. La rete feed-forward elabora ogni posizione in modo indipendente ma identico, applicando la stessa trasformazione appresa a tutti i token.
Connessioni residuali e layer normalization circondano entrambe le sotto-sezioni, stabilizzando i gradienti e permettendo architetture più profonde. Impilare più layer encoder crea rappresentazioni sempre più astratte: i layer iniziali catturano pattern superficiali, quelli più profondi codificano relazioni semantiche.
Il decoder: attenzione mascherata e causalità
Il decoder modifica la self-attention per rispettare i vincoli autoregressivi. Quando genera testo, il modello può basarsi solo sui token già prodotti. Dare un’occhiata ai token futuri sarebbe barare durante l’addestramento.
Architettura del decoder
La masked self-attention lo realizza impostando a meno infinito (che diventa zero dopo la softmax) i pesi di attenzione per tutte le posizioni successive a quella corrente.
Questo assicura che le previsioni dipendano solo dal contesto precedente e che sia mantenuto l’ordinamento causale necessario per i compiti di generazione. In inferenza, questa causalità diventa naturale: semplicemente non abbiamo ancora token futuri a cui prestare attenzione.
Cross-attention: collegare encoder e decoder
Tra i layer di self-attention del decoder si trova la cross-attention, che permette al decoder di condizionarsi sulle uscite dell’encoder. Qui le query provengono dal decoder (rappresentano "ciò che devo generare"), mentre key e value provengono dall’encoder (rappresentano "ciò che fornisce l’input").
Architettura del Transformer
Questo meccanismo di cross-attention è essenziale per i compiti sequenza-a-sequenza come la traduzione, in cui il decoder deve allineare le parole in output con le parole rilevanti in input. A differenza della self-attention, la cross-attention crea dipendenze tra due sequenze diverse, permettendo il flusso di informazioni dalla sorgente al bersaglio.
Teoria a parte, cosa ha reso possibile in pratica la self-attention? La risposta è più ampia di quanto molti si aspettino.
Applicazioni della Self-Attention tra i domini
Dopo aver visto come funziona la self-attention nell’architettura transformer, esaminiamo dove questo meccanismo ha avuto un impatto concreto nel mondo reale.
Il valore particolare della self-attention sta nella sua natura agnostica al dominio. Lo stesso quadro matematico che aiuta i modelli a comprendere le relazioni linguistiche può catturare pattern in immagini, audio e persino combinazioni di tipi di dati diversi.
A mio avviso, questa qualità agnostica al dominio è ciò che rende davvero entusiasmante la self-attention. Direi che è meno uno strumento di NLP e più un meccanismo general-purpose per apprendere relazioni.
Applicazioni nel Natural Language Processing
I modelli transformer eccellono nel catturare dipendenze a lungo raggio sfuggite alle architetture precedenti. Nell’NLP, la self-attention alimenta modelli d’avanguardia praticamente in ogni task.
Come puoi vedere nell’immagine qui sotto, l’architettura dei modelli differisce a seconda che il focus sia sul decoder o sull’encoder.
Confronto di architettura: Transformer vs. GPT vs. BERT
Modelli come BERT usano self-attention bidirezionale nella loro architettura solo-encoder, permettendo di costruire ricche rappresentazioni contestuali per compiti di classificazione e comprensione.
I modelli GPT, come il recente GPT-5.3 Codex, usano la masked self-attention nel design solo-decoder, ottenendo notevoli capacità di generazione del testo.
T5 impiega l’architettura completa encoder-decoder del transformer, trattando tutti i task di NLP come problemi text-to-text.
Applicazioni nella computer vision
L’adattamento Vision Transformer (ViT) ha portato la self-attention nella computer vision trattando le immagini come sequenze di patch. Invece di elaborare i pixel tramite layer convoluzionali, ViT suddivide le immagini in patch di dimensione fissa (tipicamente 16×16), appiattisce ogni patch in un vettore ed elabora la sequenza tramite layer transformer.
Vision Transformer
Questo approccio cattura relazioni globali che i campi recettivi locali delle reti convoluzionali potrebbero non cogliere. ViT e le sue varianti ora raggiungono risultati all’avanguardia in classificazione di immagini, object detection, segmentazione semantica e altri ambiti:
Speech, sistemi di raccomandazione e apprendimento multimodale
L’utilità della self-attention si estende all’elaborazione vocale, dove cattura le dipendenze temporali nelle sequenze audio più efficacemente dei modelli ricorrenti. Nei sistemi di raccomandazione, la self-attention aiuta a modellare i pattern di preferenza utente prestando attenzione alle interazioni storiche rilevanti.
Forse le più entusiasmanti sono le applicazioni multimodali che combinano visione e linguaggio. Modelli come CLIP usano la cross-attention tra rappresentazioni di immagini e testo, abilitando la classificazione di immagini zero-shot e la generazione di immagini da descrizioni testuali.
Ciò che questi sistemi hanno in comune: dimostrano la capacità fondamentale della self-attention di apprendere relazioni tra qualsiasi dato sequenziale o strutturato, a prescindere dalla modalità.
Varianti avanzate di Self-Attention e sviluppi recenti
Sebbene la self-attention abbia avuto un successo notevole in vari domini, emergono nuove sfide quando si distribuiscono modelli transformer su larga scala. Man mano che i modelli crescono fino a miliardi di parametri e processano contesti che si estendono a centinaia di migliaia di token, la larghezza di banda della memoria e i costi computazionali diventano colli di bottiglia critici.
Lo sviluppo di nuovi modelli si concentra sempre più nel rendere la self-attention più veloce ed efficiente senza sacrificarne le capacità fondamentali. Trovo questa tensione tra capacità ed efficienza una delle questioni aperte più interessanti del momento. Diamo un’occhiata ad alcuni sviluppi attuali.
Grouped-query e multi-query attention
La multi-head attention standard mantiene proiezioni key e value separate per ogni testa, creando un notevole overhead di memoria in inferenza. La multi-query attention (MQA) riduce questo costo condividendo un’unica testa key-value (KV) tra tutte le teste di query, riducendo drasticamente la cache KV e accelerando il decoding. Tuttavia, la MQA può degradare la qualità.
La grouped-query attention (GQA) è un approccio più bilanciato, dividendo le teste di query in gruppi che condividono le coppie key-value. Con 32 teste di query e 8 gruppi, ogni gruppo di 4 query condivide una testa key-value. Per esempio, la famiglia di modelli Mistral 3 usa questo approccio e riesce a ottenere una qualità quasi pari alla full-attention con notevoli guadagni in velocità.
Architetture ibride che combinano attention e state space models
Mentre la GQA affronta l’efficienza della memoria, un’altra linea di ricerca attacca il collo di bottiglia computazionale fondamentale dell’attenzione da un’angolazione diversa.
Lavori recenti esplorano la combinazione della self-attention con modelli a spazi di stato per migliorare l’efficienza. Sistemi come S4 e Hyena usano spazi di stato strutturati per modellare dipendenze a lungo raggio con complessità lineare anziché quadratica.
Questi approcci affrontano il limite fondamentale della self-attention: il costo computazionale scala quadraticamente con la lunghezza della sequenza, rendendo estremamente costosi i contesti molto lunghi.
Scaling in inferenza e ottimizzazione a test-time
Oltre a ripensare l’architettura, i ricercatori hanno trovato modi ingegnosi per ottimizzare i meccanismi di attenzione esistenti.
Oltre ai cambiamenti architetturali, progressi recenti ottimizzano l’attenzione in inferenza. La quantizzazione riduce la precisione della cache KV a 8 o 4 bit, tagliando drasticamente la memoria con perdita di qualità minima.
Flash Attention riorganizza l’accesso alla memoria GPU per minimizzare il movimento dei dati, ottenendo accelerazioni di 2-3×. La test-time compute optimization, in cui i modelli eseguono più passaggi durante la generazione, suggerisce che un’applicazione strategica dell’attenzione potrebbe dare risultati migliori del semplice aumento della dimensione del modello.
Conclusione
La self-attention è uno dei meccanismi più trasformativi nella storia del machine learning. Consentendo ai modelli di determinare dinamicamente quali elementi dell’input meritano attenzione, ha risolto problemi di lunga data nel catturare dipendenze a lungo raggio e nell’elaborare sequenze in modo efficiente.
L’eleganza matematica dell’attenzione scaled dot-product, potenziata dalle architetture multi-head, offre solidità teorica ed efficacia pratica.
Dai modelli di linguaggio allo stato-dell’arte alla rivoluzione della computer vision e all’abilitazione di sistemi di IA multimodale, la self-attention continua ad ampliare la sua portata. Innovazioni recenti come la grouped-query attention, le architetture ibride e l’ottimizzazione in inferenza mostrano che stiamo ancora scoprendo modi per rendere questo meccanismo più efficiente e capace.
Se vuoi entrare in tutti i dettagli e fare pratica concreta, ti consiglio di iscriverti al nostro percorso di competenze Developing Large Language Models.