
Corso
Concetti sui Large Language Models (LLM)
2 ore
111.7K
Il meccanismo di attention è al cuore dei modelli transformer. Tutte le architetture di modelli più diffuse, come GPT, LLaMA e Mixture of Experts (MoE), vi fanno affidamento per collegare i token e costruire significato.
Ma l'attention è costosa. Il suo calcolo implica grandi moltiplicazioni di matrici e, soprattutto, un enorme movimento di dati tra la memoria della GPU e le unità di calcolo. Con l'aumentare della lunghezza delle sequenze, la larghezza di banda della memoria diventa il vero collo di bottiglia.
Ottimizzare l'attention, quindi, ha un impatto sproporzionato sulle prestazioni degli LLM, ed è qui che entra in gioco Flash Attention. In questo articolo ti guiderò attraverso cos'è Flash Attention, come funziona e come usarla con PyTorch e Hugging Face Transformers.
Se cerchi un modo per iniziare con gli LLM, ti consiglio il nostro corso introduttivo sui concetti degli LLM.
Flash Attention è un meccanismo di attention ottimizzato per i transformer, che lo rende drasticamente più veloce e più efficiente in memoria sulle GPU.
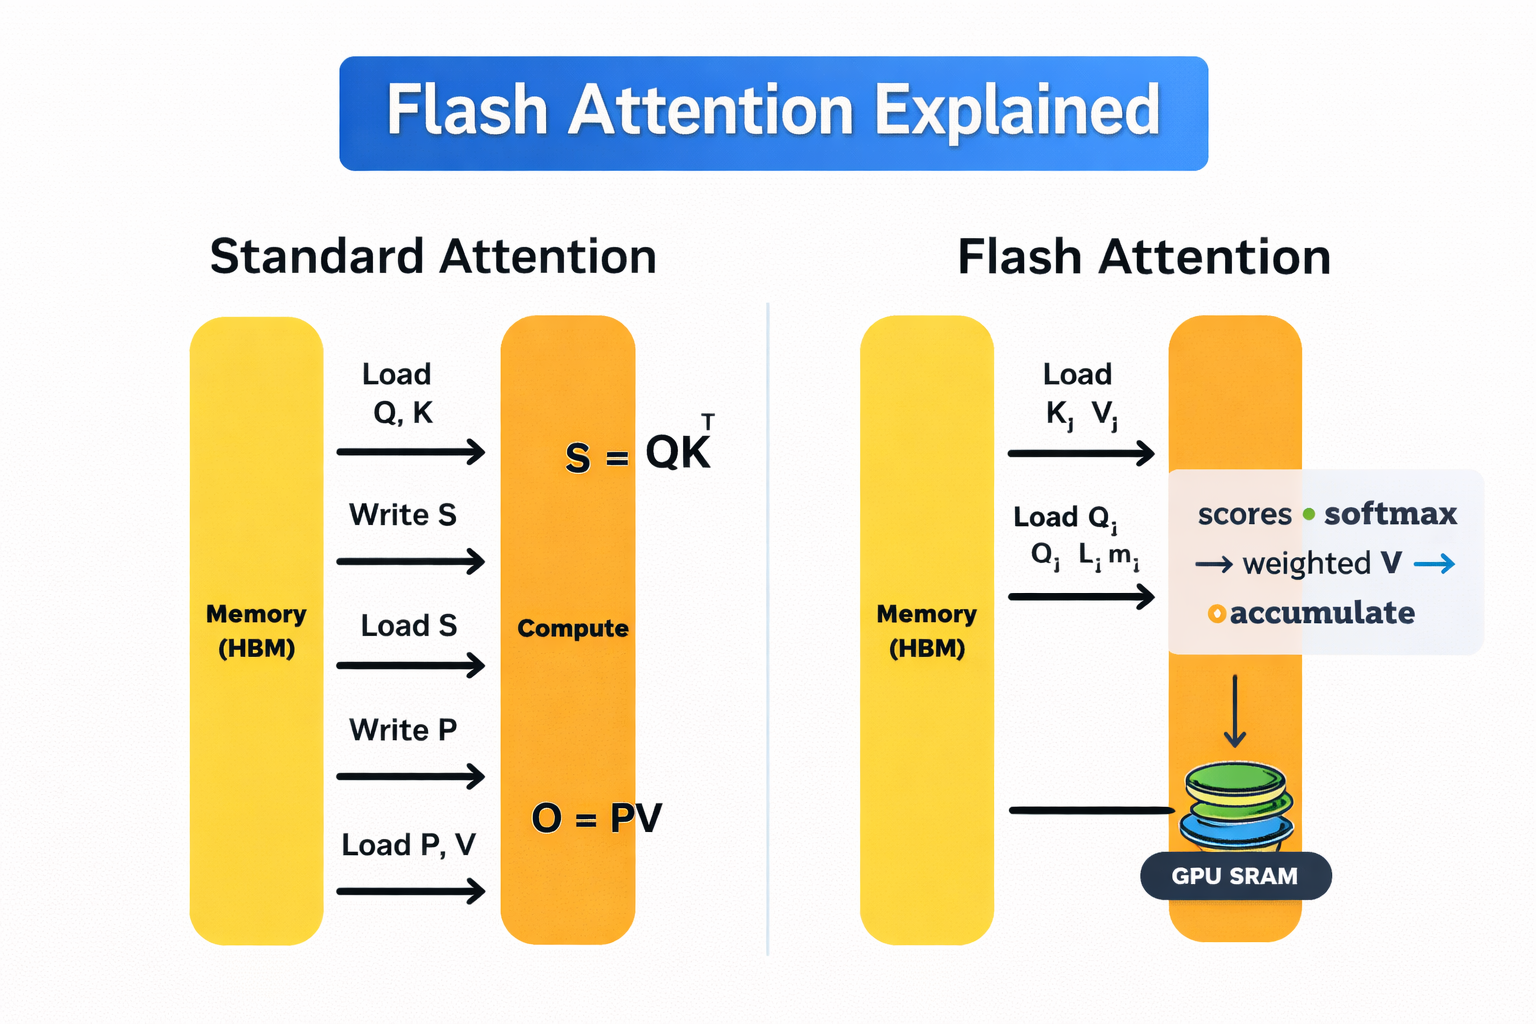
Attention standard vs Flash attention
Le GPU hanno due tipi principali di memoria. La memoria ad alta larghezza di banda (HBM) è grande ma relativamente lenta. La SRAM on-chip è estremamente veloce ma molto limitata in dimensioni.
L'auto-attention standard sposta continuamente i dati tra queste due. Questo avanti e indietro è costoso e diventa un costo significativo con l'aumentare della lunghezza della sequenza.
Flash Attention lo evita calcolando l'attention in piccole tile che entrano completamente nella SRAM veloce. Ogni tile viene elaborata end-to-end, con la softmax applicata in modo incrementale, così i risultati intermedi non devono essere scritti di nuovo in HBM. Di conseguenza, l'intera matrice di attention non viene mai memorizzata.
A differenza dei metodi di attention sparsa o lineare, Flash Attention non è un'approssimazione. Produce esattamente lo stesso output matematico dell'auto-attention standard, solo eseguito in modo più efficiente dal punto di vista della memoria.
Flash Attention raggiunge la sua efficienza riprogettando il modo in cui calcola l'attention sulla GPU. Segue un meccanismo semplice: svolgere il più possibile il lavoro nella memoria veloce on-chip ed evitare movimenti inutili verso la memoria lenta.
Un modo utile per pensarci è un'analogia con la cucina. La SRAM on-chip della GPU è come un piano di lavoro piccolo e veloce. È lì che prepari e cucini davvero. La memoria ad alta larghezza di banda della GPU (HBM) è come un grande supermercato in fondo alla strada. Può contenere tutto ciò di cui hai bisogno, ma andarci e tornare richiede tempo.
In poche parole, l'attenzione standard continua a correre al supermercato dopo ogni passaggio. Al contrario, Flash Attention pianifica la “cucina” in modo che tutto stia sul piano di lavoro mentre cucini. Vediamo questo in dettaglio:
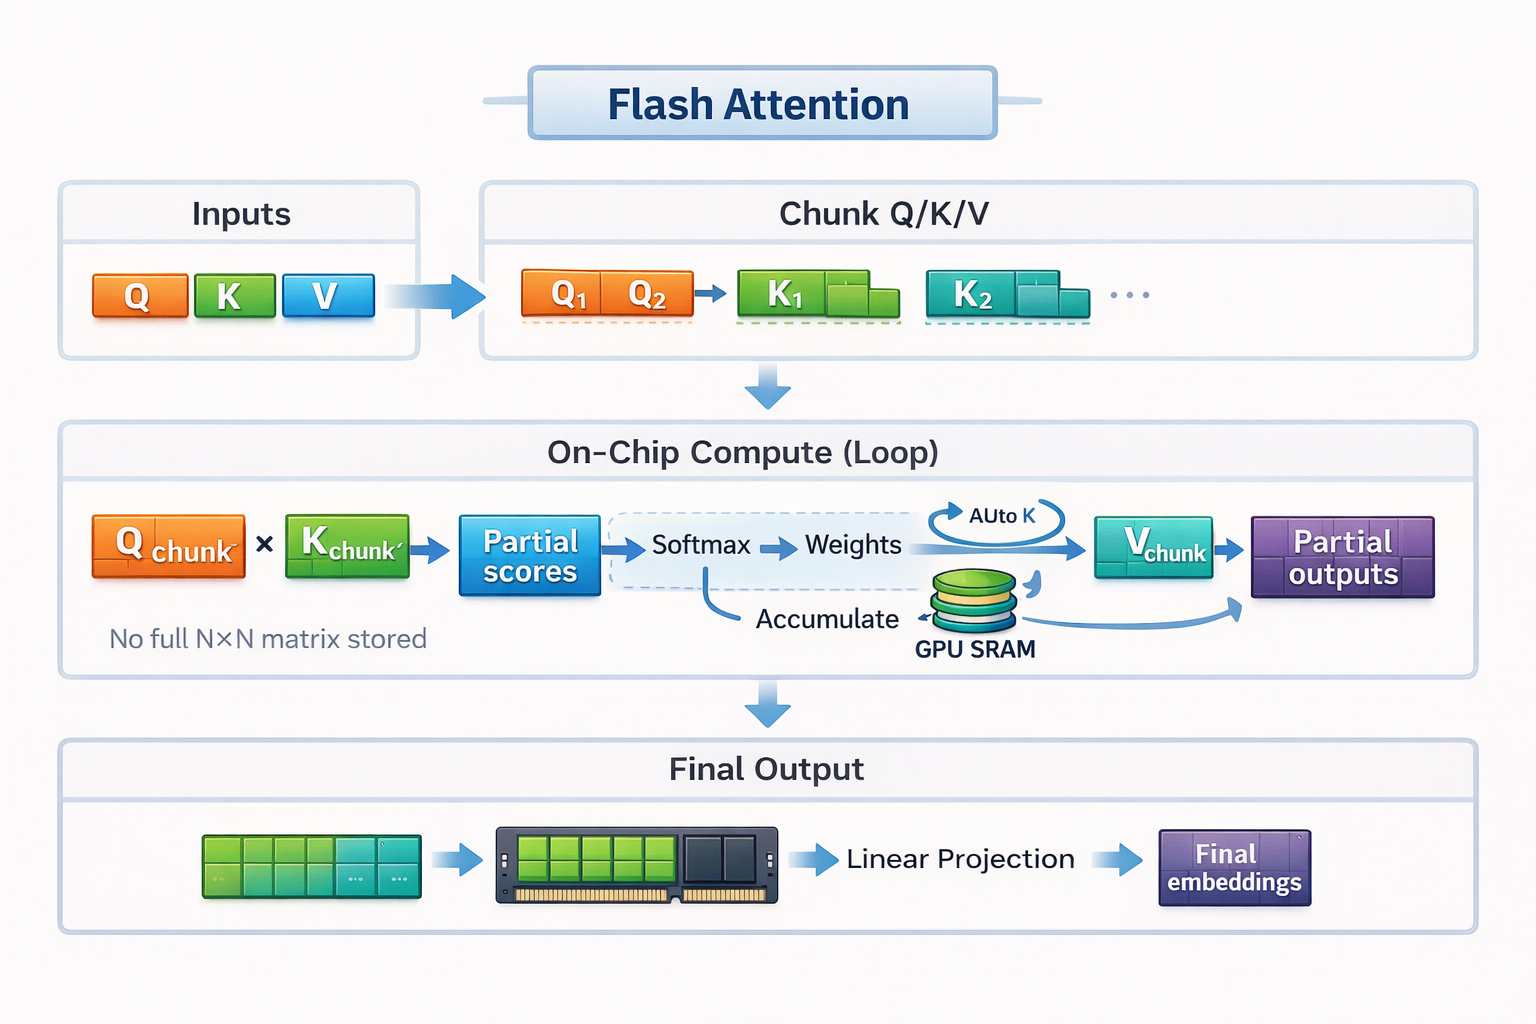
Meccanismo di funzionamento di Flash Attention
Flash Attention si basa su due idee chiave: tiling e ricomputazione.
Restando nell'esempio della cucina, il tiling è il modo in cui Flash Attention fa entrare il calcolo dell'attention sul piccolo piano di lavoro.
Invece di caricare l'intera sequenza e costruire una matrice di attention completa, Flash Attention suddivide gli input in piccoli blocchi, o tile. Ogni tile entra completamente nella SRAM veloce della GPU. Flash Attention calcola l'attention una tile alla volta, dall'inizio alla fine, prima di passare alla successiva.
Dall'analogia della cucina, non puoi far stare gli ingredienti per un intero banchetto su un piccolo piano di lavoro. Quindi prepari e cucini in piccoli lotti. Tagli qualche verdura, la cucini, liberi lo spazio e poi passi al lotto successivo. Lavorando così, eviti di correre continuamente avanti e indietro dal supermercato.
Questa esecuzione blocco per blocco consente a Flash Attention di mantenere i dati locali, veloci ed efficienti, senza mai materializzare l'intera matrice di attention nella memoria lenta.
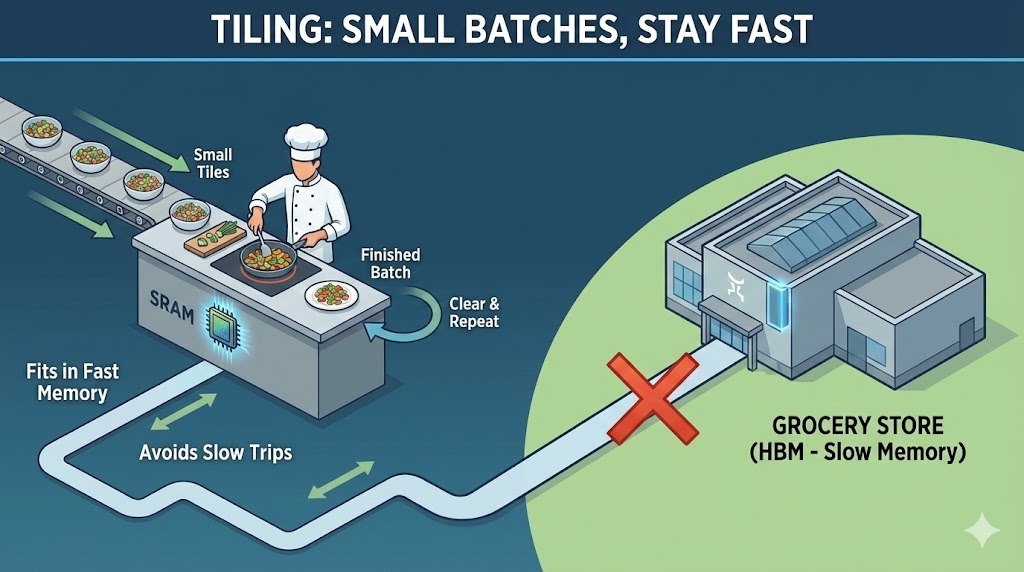
Tiling in Flash Attention
Durante l'addestramento, l'attention standard memorizza grandi risultati intermedi così da poterli riutilizzare nella backward pass. Quella memorizzazione ha un costo di memoria elevato. Flash Attention adotta un approccio diverso. Invece di conservare questi intermedi, ricalcola piccole parti dei punteggi di attention ogni volta che servono.
Tornando in cucina, è come tritare le cipolle. Potresti andare al supermercato per conservare le cipolle tritate e poi tornarci più tardi per recuperarle. Oppure potresti buttarle e semplicemente ritritarne una fresca quando è il momento di cucinare. Sorprendentemente, la seconda opzione è più veloce perché evita spostamenti frequenti/più lunghi.
Sulle GPU moderne, la ricomputazione segue la stessa logica perché il calcolo extra costa poco rispetto ai movimenti di memoria. Ricalcolando piccoli valori invece di memorizzarli e rileggerli, Flash Attention riduce significativamente il traffico di memoria mantenendo efficiente l'addestramento.
Insieme, tiling e ricomputazione permettono a Flash Attention di mantenere il calcolo dell'attention sul piano di lavoro, minimizzare i viaggi al supermercato e sfruttare appieno i punti di forza dell'hardware GPU moderno.
Flash Attention 2 (FA2), rilasciata nel 2023, è un grande aggiornamento rispetto alla prima generazione. Mantiene la stessa idea di base di attention esatta consapevole dell'IO, ma migliora l'efficienza su diverse dimensioni che contano nei carichi di lavoro reali.
La prima versione di Flash Attention parallelizzava il calcolo lungo la dimensione del batch e le teste di attention. Funzionava bene per setup di training con batch grandi. Ma era meno ideale per l'inferenza, dove i batch sono spesso piccoli e le sequenze lunghe.
FA2 aggiunge parallelismo direttamente lungo la dimensione della lunghezza della sequenza. Questo consente a più parti del calcolo dell'attention di essere eseguite simultaneamente, anche quando il batch è piccolo. Distribuendo il lavoro tra i token nella sequenza, la v2 mantiene più unità di calcolo della GPU occupate contemporaneamente.
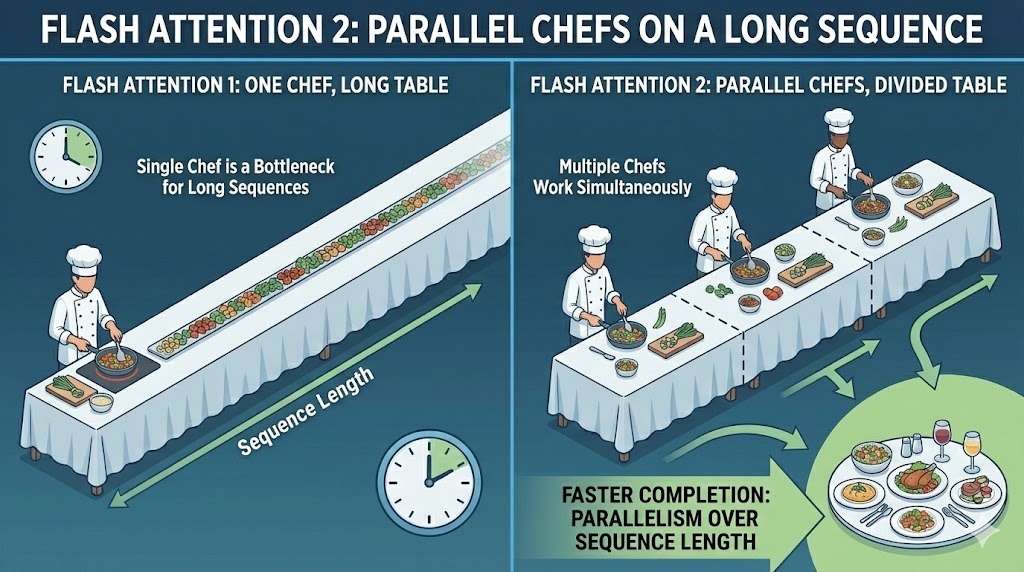
Parallelismo tra batch in Flash Attention 2
Il vantaggio pratico è una maggiore throughput e un migliore utilizzo dell'hardware negli scenari di inferenza comuni, dove lunghi prompt e batch piccoli sono la norma.
Le GPU sono estremamente efficienti nella moltiplicazione di matrici. L'hardware specializzato chiamato Tensor Cores può eseguire operazioni di moltiplicazione generale di matrici (GEMM) a velocità molto elevata.
Il problema è che l'attention non è solo moltiplicazione di matrici: include operazioni come scaling, masking e softmax, che girano sui core standard della GPU e sono molto più lente in confronto.
FA2 ha ridotto questo squilibrio. Ristruttura il calcolo per minimizzare le operazioni in virgola mobile non matriciali, soprattutto quelle coinvolte nel riscalare i punteggi di attention. Gran parte del tempo di esecuzione è speso dentro grandi operazioni di matrice efficienti che i Tensor Cores possono accelerare.
Flash Attention v1 era ottimizzata per dimensioni di testa di 64 o 128, in linea con modelli come BERT e GPT-3. Con l'evoluzione delle architetture, le dimensioni delle teste sono cresciute per supportare embedding più ampi e maggiore capacità del modello.
FA2 ha esteso il supporto a dimensioni di testa fino a 256. Questo l'ha resa compatibile con architetture più recenti che si affidano a teste di attention più larghe.
Flash Attention 3 (FA3) è lo standard industriale attuale che alimenta modelli all'avanguardia come GPT-5.2. Si basa sulla stessa base di attention esatta consapevole dell'IO delle versioni precedenti, ma è progettata specificamente per le GPU NVIDIA H100 (Hopper).
Il cambiamento chiave è che FA3 è progettata per sfruttare le nuove funzionalità hardware asincrone di Hopper, consentendo a movimento dei dati e calcolo di sovrapporsi molto più aggressivamente rispetto a prima.
Nelle versioni precedenti, tutti i thread della GPU, noti come warp, seguivano lo stesso percorso di esecuzione. FA3 cambia questo modello tramite la specializzazione dei warp. Assegna a ciascun warp uno di due ruoli distinti:
Questa separazione consente a trasferimento dati e calcolo di avvenire contemporaneamente. Mentre i warp produttori prelevano le tile successive di dati, i warp consumatori restano impegnati a calcolare sulle tile correnti, migliorando sensibilmente la latenza
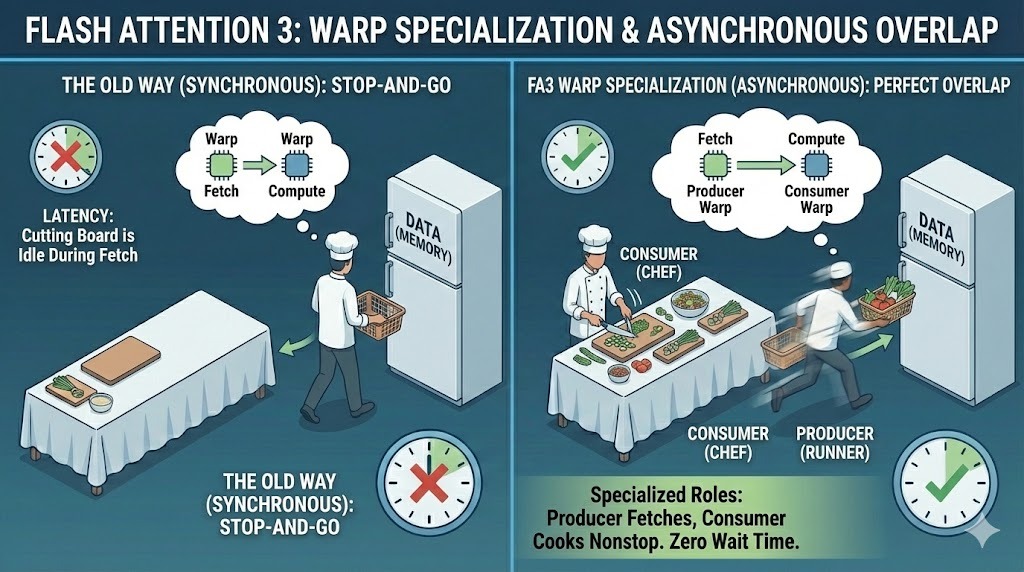
Specializzazione dei warp in Flash Attention 3
Flash Attention 3 introduce anche il supporto nativo per FP8, ovvero la precisione in virgola mobile a 8 bit. Le versioni precedenti si basavano principalmente su FP16 o BF16, che già riducevano l'uso di memoria rispetto a FP32, ma consumavano comunque molta larghezza di banda.
FP8 dimezza circa ancora una volta l'impronta in memoria. Questa riduzione si traduce direttamente in maggiore throughput e minore pressione sulla memoria. Sulle GPU Hopper, FP8 è accelerato dall'hardware, il che significa che FA3 può elaborare più operazioni di attention al secondo senza sacrificare l'accuratezza a livello di modello.
Questa capacità è uno dei motivi principali per cui modelli di grandi dimensioni come Gemini 3 possono gestire finestre di contesto enormi servendo milioni di utenti in modo efficiente.
Un ultimo tassello del design di FA3 è l'uso del Tensor Memory Accelerator (TMA) dell'H100. Il TMA è un hardware specializzato che gestisce le copie di memoria in modo asincrono, senza occupare i core di calcolo principali.
Flash Attention 3 utilizza il TMA per spostare tile di dati in background mentre il calcolo prosegue senza interruzioni. Sovrapponendo strettamente il movimento dei dati con la matematica, FA3 riesce a estrarre quasi il 75 percento delle prestazioni teoriche di picco dell'hardware.
Flash Attention 4 (FA4) rappresenta il prossimo passo sperimentale nell'ottimizzazione dell'attention. È progettata per le future GPU Blackwell B200 di NVIDIA ed esplora ciò che diventa possibile quando i kernel di attention sono costruiti per una classe di hardware completamente nuova.
Poiché le dimensioni dei modelli continuano a crescere e gli addestramenti si avvicinano alla scala del trilione di parametri, anche Flash Attention 3 alla fine incontrerà dei limiti. FA4 è un tentativo precoce di rimuovere quei limiti spingendo l'utilizzo dell'hardware oltre qualsiasi kernel di attention precedente.
In questa fase, Flash Attention 4 è una tecnologia di ricerca e pre-produzione. Mostra un grande potenziale, ma non è ancora utilizzata in modelli distribuiti o di livello produttivo.
Uno dei traguardi principali di Flash Attention 4 è la prestazione. È il primo kernel di attention progettato per superare 1 PFLOPS, ovvero un quadrilione di operazioni in virgola mobile al secondo, su una singola GPU.
Punta a un futuro in cui addestrare modelli con trilioni di parametri richiederebbe tempi impraticabili per essere completato. A quella scala, anche piccole inefficienze si sommano in ritardi enormi. FA4 mira a rendere fattibili quegli addestramenti futuri estraendo prestazioni estreme da un singolo chip.
Per raggiungere tali prestazioni, FA4 spinge l'asincronia molto oltre le versioni precedenti. Estende il modello produttore-consumatore in pipeline multi-stadio altamente complesse, in cui movimento dei dati, calcolo e sincronizzazione operano tutti in modo indipendente.
Invece di una sovrapposizione relativamente semplice tra caricamento e calcolo, FA4 gestisce un'esecuzione profondamente asincrona su più stadi. Parti diverse del kernel procedono a velocità diverse, coordinate da una pianificazione a livello hardware piuttosto che da un flusso unico sincronizzato.
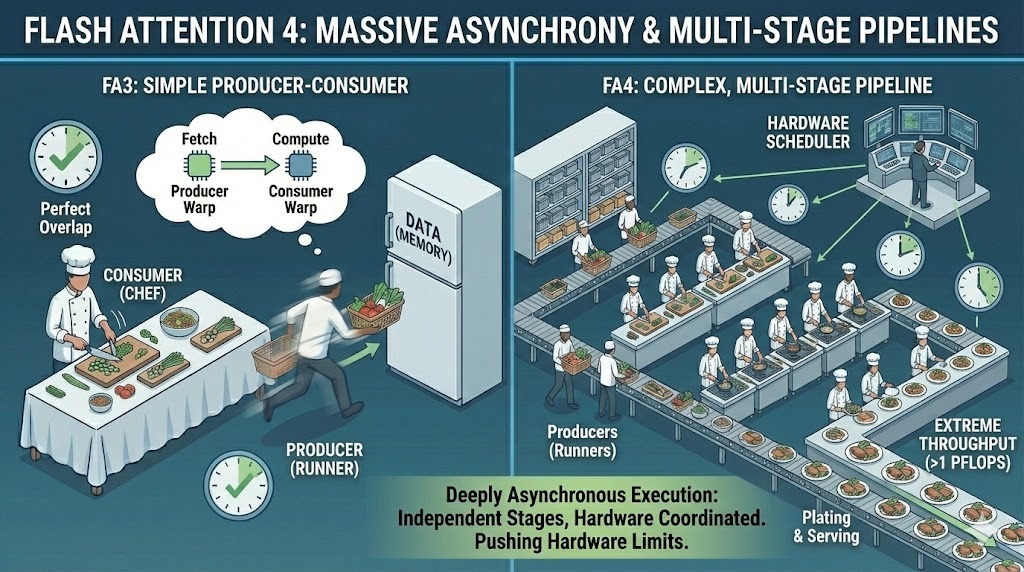
Asincronia massiccia in Flash Attention 4
Questa complessità è anche il motivo per cui FA4 resta sperimentale. Gestire accuratezza, stabilità e integrazione a questo livello è impegnativo. La community ha ancora bisogno di lavoro prima che i team possano usarla in modo affidabile all'interno di grandi modelli in produzione.
Vediamo come Flash Attention si confronta con il meccanismo di attention standard in alcuni ambiti chiave.
I benchmark mostrano costantemente che tutte le versioni di Flash Attention superano l'auto-attention standard, con guadagni che aumentano all'aumentare della lunghezza della sequenza.
L'articolo originale su Flash Attention riporta accelerazioni di circa 2–4× rispetto all'attention standard ottimizzata. Flash Attention 2 migliora ulteriormente aumentando il parallelismo e saturando meglio la GPU, spesso offrendo in pratica un altro ~2× di miglioramento.
Flash Attention 3 spinge le prestazioni ancora oltre sulle GPU Hopper, soprattutto con FP8, raggiungendo un utilizzo dell'hardware molto più alto rispetto a quanto possa ottenere l'attention standard.
L'attention standard materializza esplicitamente l'intera matrice di attention N × N, il che porta a una crescita quadratica della memoria rispetto alla lunghezza della sequenza. Con l'aumentare di N, l'uso di memoria esplode, saturando rapidamente la memoria della GPU. Flash Attention evita di memorizzare del tutto questa matrice.
Calcolando l'attention in tile e mantenendo i risultati intermedi nella memoria veloce on-chip, riduce l'uso di memoria a lineare rispetto alla lunghezza della sequenza per dimensioni di testa fissate. Questo passaggio da una scalabilità quadratica a lineare rimuove il più grande collo di bottiglia strutturale dell'attention standard.
Quella riduzione della memoria abilita direttamente finestre di contesto più lunghe. Con l'attention standard, i modelli spesso vanno in out-of-memory quando le sequenze raggiungono poche migliaia di token.
Flash Attention rende pratici contesti da 4k e 8k token su una singola GPU, e sblocca anche finestre molto più lunghe, come 16k o 32k token, su quello stesso dispositivo se combinata con altre tecniche di risparmio di memoria.
Non confonderti: le enormi finestre da milioni di token ottenute in alcuni modelli di frontiera attuali come Gemini 3 sono ottenute suddividendo la sequenza tra grandi cluster di GPU, poiché superano di gran lunga la capacità di memoria di qualsiasi singolo dispositivo.
Usare oggi Flash Attention è molto più semplice di un tempo. Nella maggior parte dei casi, non devi scrivere kernel CUDA personalizzati o cambiare l'architettura del modello. Il supporto è già integrato negli strumenti più popolari.
Dalla versione PyTorch 2.0, Flash Attention è disponibile direttamente tramite torch.nn.functional.scaled_dot_product_attention. Quando chiami questa funzione, PyTorch seleziona automaticamente il backend di attention più veloce disponibile per il tuo hardware.
Sulle GPU supportate, quel backend è Flash Attention. Dal punto di vista dell'utente, spesso il codice sembra quello dell'attention standard, ma sotto il cofano PyTorch invia a un kernel di Flash Attention ottimizzato.
Se usi Hugging Face Transformers, abilitare Flash Attention di solito è una modifica di una riga. Impostare attn_implementation="flash_attention_2" nella configurazione del modello indica alla libreria di usare Flash Attention 2 ovunque possibile.
Per molti modelli transformer, questo basta per ottenere miglioramenti sia in velocità sia in memoria senza toccare il resto del codice di training o inferenza.
Flash Attention 2 è pensata per GPU NVIDIA moderne e gira al meglio su architetture Ampere, Ada e Hopper, tra cui A100, RTX 3090, RTX 4090 e H100. Queste GPU offrono la larghezza di banda di memoria e le caratteristiche architetturali necessarie per sfruttare appieno il tiling e il parallelismo in FA2.
Vale anche la pena notare che la Flash Attention v1 originale supporta anche GPU più vecchie. Schede basate su Turing come T4 e RTX 2080 possono ancora usare Flash Attention v1, mentre le versioni più recenti richiedono hardware più moderno per sbloccare tutti i guadagni di prestazioni.
In pratica, se stai già usando PyTorch 2.x o Hugging Face Transformers su una GPU NVIDIA moderna, Flash Attention spesso è a portata di un semplice switch di configurazione.
L'attenzione standard ha sbattuto contro un muro perché la crescita quadratica della memoria ha reso le sequenze lunghe lente, costose o semplicemente impossibili a causa di errori di memoria insufficiente. Flash Attention ha cambiato le carte in tavola riprogettando l'esecuzione dell'attention.
Riducendo l'uso di memoria da quadratico a lineare rispetto alla lunghezza della sequenza, Flash Attention rende pratico il modeling a lungo contesto. Finestre di contesto che prima saturavano le GPU a poche migliaia di token ora scalano a 4k, 8k e persino oltre 32k token sullo stesso hardware.
Se lavori con transformer su larga scala e non usi Flash Attention, molto probabilmente stai lasciando prestazioni sul tavolo.
Desideri creare modelli tuoi che possano usare Flash Attention? Segui il nostro corso sui modelli transformer con PyTorch!
Corsi di AI
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



