2017 के अंत में, Attention Is All You Need शीर्षक वाले एक शोध पत्र ने एक क्रांतिकारी तंत्र पेश किया जिसने कृत्रिम बुद्धिमत्ता की दिशा ही बदल दी। इस सफलता के केंद्र में था सेल्फ-अटेंशन—एक सरल, फिर भी शक्तिशाली विचार जो यह तय करके कि किन तत्वों पर ध्यान दिया जाना चाहिए, मॉडलों को डेटा के भीतर संबंधों को समझने में सक्षम बनाता है।
आज, सेल्फ-अटेंशन ChatGPT की बातचीत की क्षमता से लेकर उन्नत इमेज रिकग्निशन सिस्टम तक सब कुछ चला रहा है। यह निस्संदेह मशीन लर्निंग के इतिहास की सबसे परिवर्तनकारी नवाचारों में से एक है।
इस गाइड में, मैं आपको अवधारणात्मक नींव से लेकर अनुप्रयोगों तक सेल्फ-अटेंशन से परिचित कराऊंगा, दिखाऊंगा कि यह तंत्र मॉडलों को लंबी दूरी की निर्भरताओं को पकड़ने और सूचना को समानांतर में संसाधित करने में कैसे मदद करता है—ऐसी क्षमताएं जो पारंपरिक न्यूरल नेटवर्क के साथ पहले संभव नहीं थीं।
यदि आप ट्रांसफॉर्मर्स में नए हैं, तो हमारे परिचयात्मक कोर्स—Large Language Models (LLMs) Concepts और Transformer Models with PyTorch—में से कोई एक लेने पर विचार करें।
Self-Attention क्या है?
अपने अनुभव में, इस अवधारणा को सिखाने की सबसे अच्छी शुरुआत अनुक्रम प्रसंस्करण की एक बुनियादी चुनौती से होती है: किसी भी क्षण एक मॉडल अपने इनपुट के किन हिस्सों को सबसे अधिक प्रासंगिक कैसे तय करे?
कोई भी गणित शुरू करने से पहले, पहले अंतर्ज्ञान से शुरुआत करते हैं।
सेल्फ-अटेंशन की अवधारणात्मक समझ
सेल्फ-अटेंशन एक तंत्र है जो किसी अनुक्रम के विभिन्न तत्वों की एक-दूसरे के सापेक्ष महत्ता को तौलता है। जब वाक्य "The animal didn't cross the road because it was too tired" संसाधित किया जाता है, तो सेल्फ-अटेंशन मॉडल को यह समझने में मदद करता है कि "it" का संदर्भ "animal" से है, न कि "road" से—एक ऐसा संबंध जो कई शब्दों में फैला है।
यह वास्तव में वही उदाहरण है जिसे मैं छात्रों को यह अवधारणा समझाते समय हमेशा उपयोग करता हूँ। यह तुरंत समझ में आता है क्योंकि यह वैसा ही है जैसा हम स्वाभाविक रूप से पढ़ते हैं।
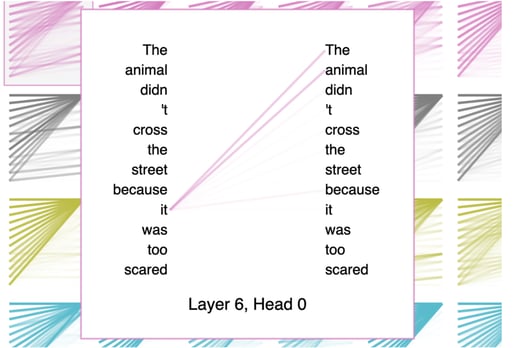
अटेंशन मैकेनिज्म
सेल्फ-अटेंशन की खास ताकत इसकी यह क्षमता है कि वह अनुक्रम के सभी स्थानों के लिए इन संबंधों की गणना एक साथ कर सकता है। आवर्ती न्यूरल नेटवर्क्स के विपरीत, जो अनुक्रमों को कदम-दर-कदम संसाधित करते हैं, सेल्फ-अटेंशन एक ही फॉरवर्ड पास में हर तत्व को हर दूसरे तत्व के संदर्भ में देखता है।
यह समानांतर गणना प्रशिक्षण समय को नाटकीय रूप से कम कर देती है, जबकि अनुक्रम में दूरी की परवाह किए बिना निर्भरताओं को पकड़ लेती है।
सेल्फ-अटेंशन को संबंधित तंत्रों से अलग समझना महत्वपूर्ण है। सेल्फ-अटेंशन में, एक अनुक्रम स्वयं पर ध्यान देता है। प्रत्येक तत्व उसी अनुक्रम के सभी स्थानों से जानकारी क्वेरी करता है।
क्रॉस-अटेंशन इसके विपरीत, एक अनुक्रम को दूसरे पर ध्यान देने देता है, जैसे मशीन अनुवाद के दौरान डिकोडर का एन्कोडर आउटपुट्स पर ध्यान देना।
मास्क्ड सेल्फ-अटेंशन एक अतिरिक्त बाधा जोड़ता है: यह स्थानों को आगे आने वाले स्थानों पर ध्यान देने से रोकता है, ताकि भविष्यवाणियां केवल ज्ञात आउटपुट्स पर निर्भर रहें—जो ऑटोरिग्रेसिव टेक्स्ट जनरेशन के लिए आवश्यक है।
लेकिन यह विचार आया कहां से, और इसे किन समस्याओं को सुलझाने के लिए डिजाइन किया गया था?
सेल्फ-अटेंशन की उत्पत्ति और प्रेरणा
सेल्फ-अटेंशन के आने से पहले, यह क्षेत्र अनुक्रम मॉडलिंग में महत्वपूर्ण सीमाओं से जूझ रहा था।
रकरेंट न्यूरल नेटवर्क्स, जिनमें LSTM और GRU शामिल हैं, अनुक्रमों को क्रमिक रूप से संसाधित करते हैं, जिससे एक बुनियादी बाधा बनती है: वे लंबी दूरी की निर्भरताओं से जूझते हैं क्योंकि जानकारी को कई मध्यवर्ती अवस्थाओं से गुजरना पड़ता है, जिससे वैनिशिंग ग्रेडिएंट्स और संदर्भ का खो जाना होता है।
सेल्फ-अटेंशन की ओर विकास RNN-आधारित एन्कोडर-डिकोडर आर्किटेक्चर्स में अटेंशन मैकेनिज्म से शुरू हुआ। 2014 में, Bahdanau और सहलेखकों ने एक अटेंशन तंत्र पेश किया जिसने डिकोडर्स को एकल फिक्स्ड-लेंथ कॉन्टेक्स्ट वेक्टर पर निर्भर रहने के बजाय सभी एन्कोडर हिडन स्टेट्स तक पहुंचने दिया।
इस सफलता ने सूचना संपीड़न समस्या को संबोधित किया, जहां विभिन्न-लंबाई वाले इनपुट अनुक्रमों को उनकी जटिलता की परवाह किए बिना फिक्स्ड-लेंथ प्रतिनिधित्वों में समेट दिया जाता था।
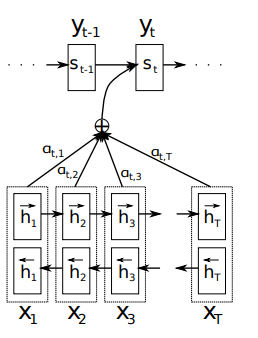
प्रस्तावित मॉडल का Bahdanau द्वारा ग्राफिकल चित्रण
एक साल बाद, Luong ने सरलीकृत अटेंशन तंत्र प्रस्तावित किए, जिनमें स्केल्ड डॉट-प्रोडक्ट दृष्टिकोण शामिल था, जिसने बाद में ट्रांसफॉर्मर डिजाइन को प्रभावित किया। यद्यपि ये प्रारंभिक अटेंशन तंत्र प्रदर्शन में सुधार करते थे, वे अभी भी क्रमिक RNN प्रसंस्करण पर निर्भर थे।
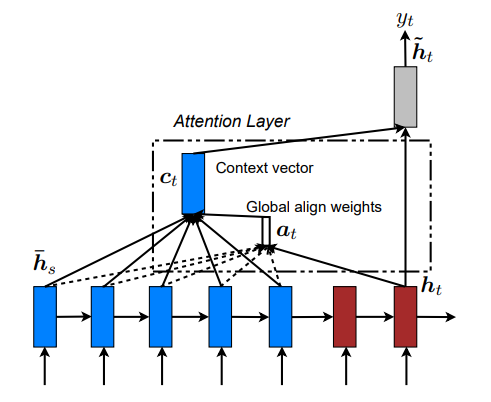
ग्लोबल अटेंशनल मॉडल (Luong)
सच्ची क्रांति तब आई जब शोधकर्ताओं ने सवाल किया: क्या होगा यदि हम रिकरेंस को हटा दें और केवल अटेंशन पर निर्भर रहें? इस प्रश्न ने ट्रांसफॉर्मर आर्किटेक्चर का मार्ग प्रशस्त किया, जहां अनुक्रमिक संबंधों को समझने के लिए सेल्फ-अटेंशन प्राथमिक तंत्र बन गया।
Self-Attention का गणितीय ढांचा
अब जब हमने समझ लिया है कि सेल्फ-अटेंशन क्यों महत्वपूर्ण है, तो देखते हैं कि यह गणितीय स्तर पर वास्तव में कैसे काम करता है।
क्वेरी, की और वैल्यू अभिव्यक्तियाँ
सेल्फ-अटेंशन इनपुट अनुक्रमों को तीन सीखी गई प्रोजेक्शनों के माध्यम से रूपांतरित करता है: क्वेरीज, कीज़ और वैल्यूज़। इन्हें एक ही जानकारी के अलग-अलग "दृश्यों" के रूप में सोचें, जिनमें से प्रत्येक अटेंशन गणना में एक विशिष्ट भूमिका निभाता है।
इनपुट अनुक्रम के लिए, जिसका एम्बेडिंग आयाम d_model है, हम तीन वेट मैट्रिस बनाते हैं: W_Q, W_K, और W_V। जब हम अपने इनपुट मैट्रिक्स X को इन वेट्स से गुणा करते हैं, तो हमें मिलता है:
-
क्वेरी मैट्रिक्स Q = X · W_Q: "मैं क्या ढूंढ रहा हूँ" को दर्शाता है
-
की मैट्रिक्स K = X · W_K: "मैं क्या उपलब्ध कराता हूँ" को दर्शाता है
-
वैल्यू मैट्रिक्स V = X · W_V: "मेरे भीतर वास्तव में क्या है" को दर्शाता है
मुझे यह लाइब्रेरी उपमा सहायक लगती है: आप मन में एक क्वेरी लेकर अंदर जाते हैं, इंडेक्स कार्ड्स आपकी कीज़ हैं, और असली किताबें आपकी वैल्यूज़।
आमतौर पर, ये मैट्रिस छोटे आयाम d_k पर प्रोजेक्ट करती हैं (अक्सर अटेंशन हेड्स की संख्या से विभाजित d_model), जो संगणनात्मक जटिलता को संभालता है और साथ ही अभिव्यक्ति क्षमता बनाए रखता है। लंबी अनुक्रमों तक स्केल करने पर यह आयामी कमी विशेष रूप से महत्वपूर्ण हो जाती है।
Q, K और V तैयार होने पर, अब हम स्वयं अटेंशन की गणना कर सकते हैं।
स्केल्ड डॉट-प्रोडक्ट अटेंशन
अटेंशन की गणना एक सुंदर सूत्र का पालन करती है। सबसे पहले, हम क्वेरीज और कीज़ के बीच डॉट प्रोडक्ट लेकर अटेंशन स्कोर की गणना करते हैं। यह ऑपरेशन यह मापता है कि प्रत्येक स्थान जो ढूंढ रहा है और हर दूसरा स्थान जो उपलब्ध कराता है, उनके बीच कितनी अनुकूलता है।
हालांकि, जैसे-जैसे आयाम बढ़ता है, ये डॉट प्रोडक्ट्स परिमाण में बहुत बड़े हो सकते हैं, जिससे softmax फंक्शन अत्यंत छोटे ग्रेडिएंट वाले क्षेत्रों में धकेल दिया जाता है। इस संख्यात्मक अस्थिरता से बचने के लिए, हम की आयाम के वर्गमूल से भाग देकर स्केल करते हैं।
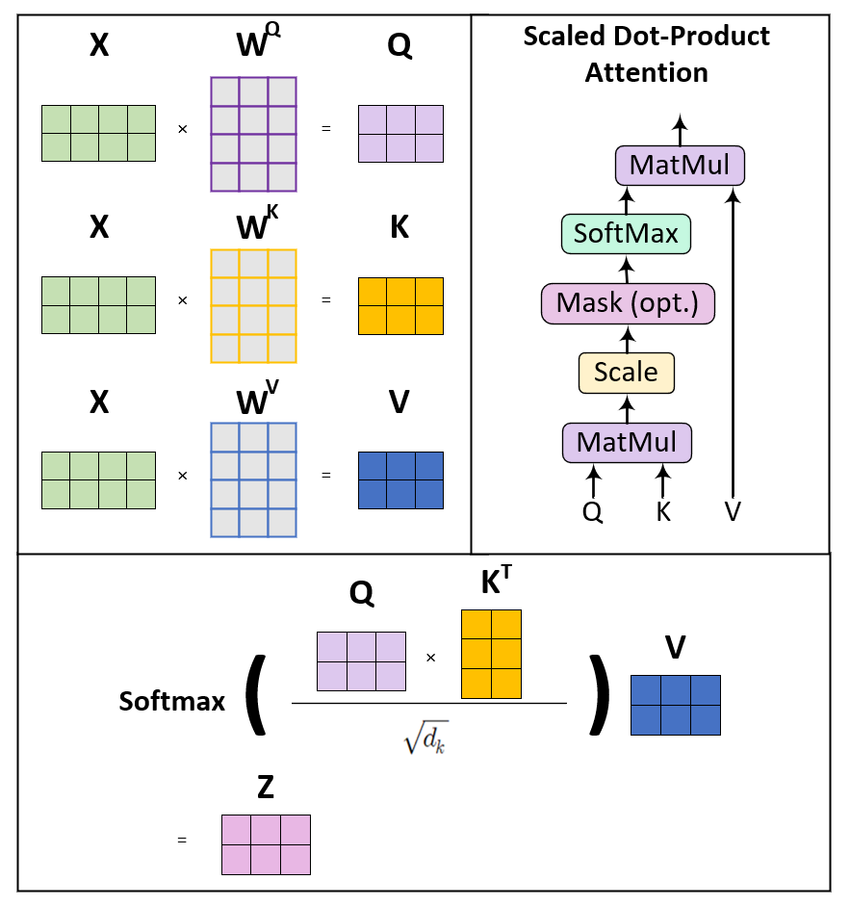
स्केल्ड डॉट-प्रोडक्ट अटेंशन
यह स्केलिंग फैक्टर पूरे नेटवर्क में उपयुक्त विचरण बनाए रखता है, जिससे प्रशिक्षण के दौरान स्थिर ग्रेडिएंट सुनिश्चित होते हैं। इसके बिना, उच्च-आयामी एम्बेडिंग वाले मॉडल प्रभावी रूप से सीखने के लिए संघर्ष करेंगे, क्योंकि softmax लगभग वन-हॉट वितरण देता, जो सार्थक ढंग से अटेंशन वितरित करने में विफल रहता।
आगे बढ़ने से पहले, एक महत्वपूर्ण कमी को संबोधित करना आवश्यक है: पोजिशनल एनकोडिंग।
पोजिशनल एनकोडिंग
जब मैंने इसे पहली बार पढ़ा तो मुझे सबसे ज्यादा यह बात चकित कर गई: सेल्फ-अटेंशन पूरी तरह परिमेय-अपरिवर्तनीय है। आप इनपुट टोकन्स को शफल कर दें, और आपको वही आउटपुट मिलेगा—बस उसी अनुरूप शफल्ड।
इस निहितार्थ को समझने में मुझे एक पल लगा: तंत्र शक्तिशाली है, लेकिन क्रम के प्रति मूलतः अंधा। जहाँ क्रम मायने रखता है (जैसे भाषा की समझ), वहाँ हमें स्पष्ट रूप से पोजिशनल जानकारी इंजेक्ट करनी पड़ती है।
मूल ट्रांसफॉर्मर ने साइनसोइडल पोजिशन एनकोडिंग्स का उपयोग किया, जिसमें प्रत्येक आयाम पर अलग-अलग आवृत्तियों के साइन और कोसाइन फंक्शंस लगाए गए। यह चयन मनमाना नहीं था। तरंग जैसी पैटर्न मॉडल्स को सापेक्ष स्थानों पर ध्यान देना सीखने देते हैं, और एनकोडिंग अनदेखी अनुक्रम लंबाइयों तक स्वाभाविक रूप से विस्तृत हो जाती है।
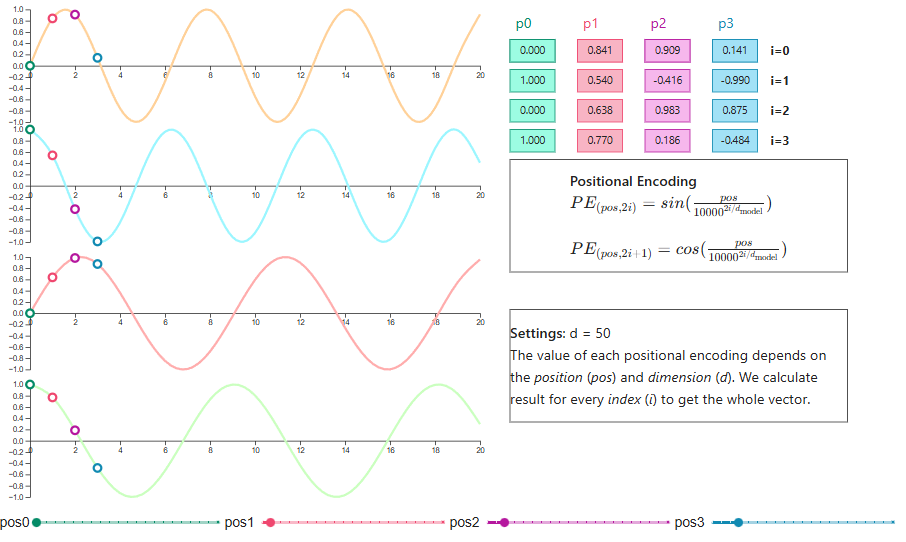
पोजिशनल एनकोडिंग का दृश्यावलोकन
हाल के नवाचारों में RoPE (Rotary Position Embedding) शामिल है, जो क्वेरी और की वेक्टरों को उनके स्थानों के अनुपात में कोणों द्वारा बहु-आयामी स्थान में घुमाता है। रोटेशन के बाद, क्वेरी और की के बीच डॉट प्रोडक्ट स्वाभाविक रूप से सापेक्ष दूरी को एनकोड करता है।
मजबूत एक्सट्रपलेशन क्षमताओं के कारण RoPE को LLaMA जैसे मॉडलों में व्यापक रूप से अपनाया गया है।
एक अन्य दृष्टिकोण, ALiBi (Attention with Linear Biases), ध्यान स्कोर में सीधे पोजिशन-निर्भर दंड जोड़कर अलग रास्ता अपनाता है। एम्बेडिंग्स को संशोधित करने के बजाय, ALiBi अटेंशन वेट्स को पास के टोकन्स का पक्ष लेने के लिए बायस करता है, जिसमें बायस की तीव्रता विभिन्न अटेंशन हेड्स में बदलती रहती है।
यह तरीका प्रशिक्षण के दौरान देखी गई लंबाइयों से बहुत आगे की अनुक्रम लंबाइयों तक प्रभावशाली एक्सट्रपलेशन दर्शाता है।
Softmax और अटेंशन वेट्स
स्केल्ड अटेंशन स्कोर्स की गणना के बाद, हम की आयाम पर softmax लागू करते हैं। यह सामान्यीकरण कच्चे स्कोर्स को एक प्रायिकता वितरण में बदल देता है, जिससे प्रत्येक क्वेरी स्थान के लिए अटेंशन वेट्स का योग एक हो जाता है।
Softmax उच्चतम-स्कोर वाले संबंधों पर जोर देता है और अप्रासंगिक कनेक्शनों को दबा देता है। हालांकि, यह कभी-कभी अत्यधिक तीखे वितरणों की ओर ले जा सकता है, खासकर शुरुआती प्रशिक्षण में जब मॉडल ने अभी तक सूक्ष्म अटेंशन पैटर्न नहीं सीखे होते।
इसे कम करने के लिए, प्रैक्टिशनर्स अक्सर अटेंशन वेट्स पर ड्रॉपआउट लागू करते हैं, कुछ कनेक्शनों को यादृच्छिक रूप से शून्य कर देते हैं ताकि मजबूती को बढ़ावा मिल सके।
कॉन्टेक्स्ट वेक्टरों की गणना
अटेंशन वेट्स मिलने के बाद, हम वैल्यू वेक्टरों के भारित योग के रूप में अंतिम आउटपुट की गणना करते हैं।
प्रत्येक स्थान को एक संदर्भ-सचेत अभिव्यक्ति मिलती है जो पूरे अनुक्रम से जानकारी को समेकित करती है, जिसमें योगदान अटेंशन वेट्स के अनुपात में होता है। यह भारित संयोजन जानकारी को स्थिर पैटर्न के बजाय सीखे गए संबंधों के आधार पर गतिशील रूप से प्रवाहित होने देता है।
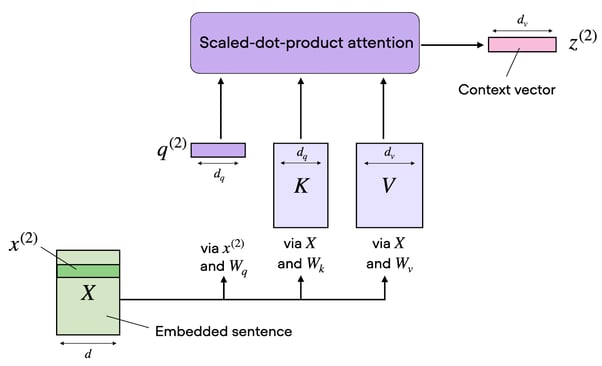
कॉन्टेक्स्ट वेक्टर की गणना
सिंगल-हेड अटेंशन हमें आश्चर्यजनक रूप से बहुत दूर तक ले जाता है, लेकिन इसकी एक सीमा है। अब चीजें और दिलचस्प हो जाती हैं।
मल्टी-हेड अटेंशन और बहु-प्रतिनिधित्व उप-अंतरिक्ष
यद्यपि सिंगल-हेड अटेंशन शक्तिशाली है, इसकी एक बुनियादी सीमा है: यह एक समय में केवल एक प्रकार का संबंध पकड़ सकता है।
प्रेरणा और आर्किटेक्चर
मल्टी-हेड अटेंशन इसे कई अटेंशन गणनाओं को समानांतर में चलाकर संबोधित करता है, जिनमें से प्रत्येक इनपुट संबंधों के अलग-अलग पहलुओं पर केंद्रित होता है। उदाहरण के लिए, अलग-अलग हेड्स इन बातों में विशेषज्ञ हो सकते हैं:
- स्थानीय वाक्य-विन्यास (सिंटैक्टिक) निर्भरताएँ
- लंबी दूरी के अर्थगत (सीमांटिक) संबंध
- पोजिशनल पैटर्न
मेरी समझ में, इन मॉडलों के साथ काम करते हुए यह विशेषज्ञता अक्सर प्रशिक्षण के दौरान स्वतः उभर आती है। आप इसे डिजाइन नहीं करते—जो मेरे विचार में पूरे तंत्र का सबसे आकर्षक पहलू है।
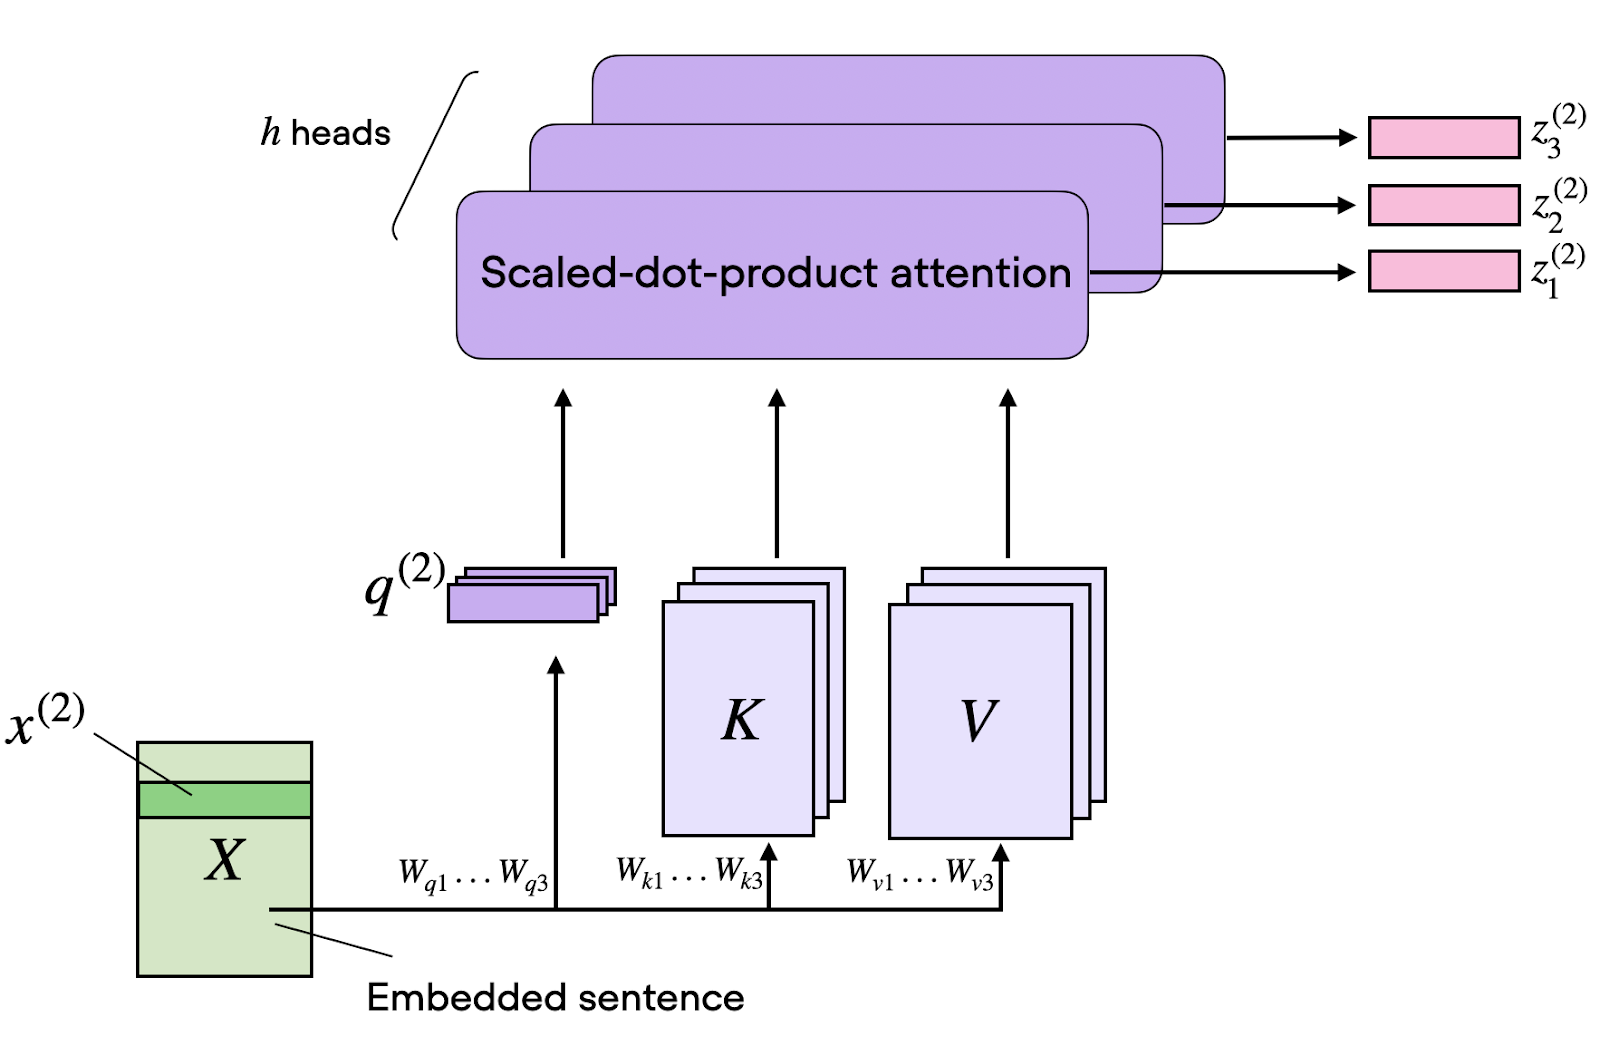
मल्टी-हेड अटेंशन
इम्प्लीमेंटेशन में Q, K और V मैट्रिस को आयाम अक्ष के साथ विभाजित करना, प्रत्येक भाग को अलग-अलग अटेंशन हेड्स से प्रोसेस करना, और परिणामों को कॉनकैटिनेट करना शामिल है।
यदि हमारे पास 8 हेड्स और 512-आयामी एम्बेडिंग्स हैं, तो प्रत्येक हेड 64-आयामी उप-अंतरिक्षों पर काम करता है। यह समानांतर प्रसंस्करण अनुक्रम लंबाई की जटिलता नहीं बढ़ाता, लेकिन मॉडल की विविध पैटर्न सीखने की क्षमता को कई गुना कर देता है।
अलग-अलग हेड्स क्या सीखते हैं
इस बात पर शोध कि अलग-अलग अटेंशन हेड्स वास्तव में क्या सीखते हैं, रोचक पैटर्न उजागर करता है।
अनुवाद मॉडलों में, कुछ हेड्स लगातार पोजिशनल संबंधों पर ध्यान देते हैं—सामग्री की परवाह किए बिना पड़ोसी शब्दों पर केंद्रित रहते हैं। अन्य हेड्स वाक्य-विन्यास भूमिकाओं में विशेषज्ञता रखते हैं, जैसे कर्ता-क्रिया या क्रिया-उद्देश्य संबंधों की पहचान। तीसरी श्रेणी दुर्लभ या उच्च-जानकारी वाले टोकन्स जैसे प्रॉपर नाउन्स और तकनीकी शब्दों पर ध्यान देती है।
दिलचस्प बात यह है कि व्याख्यात्मकता अध्ययनों से पता चलता है कि कई हेड्स अनावश्यक प्रतीत होते हैं, और जब एक महत्वपूर्ण अंश को प्रून किया जाता है तब भी मॉडल प्रदर्शन बनाए रख सकते हैं। यह अनावश्यकता सम्भवतः मजबूती में योगदान देती है, सुनिश्चित करती है कि महत्वपूर्ण पैटर्न्स के पास नेटवर्क से गुजरने के कई रास्ते हों।
एन्कोडर-डिकोडर अटेंशन में, बाद की डिकोडर लेयर्स के हेड्स अनुवाद गुणवत्ता के लिए सबसे आवश्यक सिद्ध होते हैं, जबकि एन्कोडर सेल्फ-अटेंशन हेड्स को अक्सर काफी हद तक घटाया जा सकता है।
ट्रांसफॉर्मर आर्किटेक्चर के भीतर Self-Attention
गणितीय नींव स्थापित होने के साथ, देखते हैं कि सेल्फ-अटेंशन पूर्ण ट्रांसफॉर्मर आर्किटेक्चर में कैसे एकीकृत होता है।
एन्कोडर: ऑल-टू-ऑल अटेंशन
ट्रांसफॉर्मर एन्कोडर में, सेल्फ-अटेंशन लेयर्स प्रत्येक स्थान को इनपुट अनुक्रम के हर अन्य स्थान पर ध्यान देने देती हैं। यह "ऑल-टू-ऑल" पैटर्न द्विदिश संदर्भ प्रवाह सक्षम करता है, जहां प्रत्येक टोकन पूरे अनुक्रम से सूचित एक अभिव्यक्ति बनाता है।
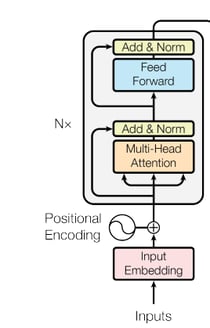
एन्कोडर आर्किटेक्चर
प्रत्येक एन्कोडर लेयर मल्टी-हेड सेल्फ-अटेंशन को पोजिशन-वाइज फीड-फॉरवर्ड नेटवर्क के साथ संयोजित करती है। फीड-फॉरवर्ड नेटवर्क प्रत्येक स्थान को स्वतंत्र रूप से, पर समान रूप से प्रोसेस करता है, सभी टोकन्स पर एक ही सीखा हुआ रूपांतरण लागू करता है।
रेज़िडुअल कनेक्शंस और लेयर नॉर्मलाइज़ेशन दोनों सब-लेयर्स को घेरते हैं, ग्रेडिएंट्स को स्थिर करते हैं और गहरे आर्किटेक्चर्स को सक्षम करते हैं। कई एन्कोडर लेयर्स को स्टैक करने से क्रमशः अधिक अमूर्त अभिव्यक्तियाँ बनती हैं—प्रारंभिक लेयर्स सतही पैटर्न पकड़ती हैं और गहरी लेयर्स अर्थगत संबंधों को एनकोड करती हैं।
डिकोडर: मास्क्ड अटेंशन और कार्य-कारण (कॉज़ैलिटी)
डिकोडर ऑटोरिग्रेसिव बाधाओं का सम्मान करने के लिए सेल्फ-अटेंशन में संशोधन करता है। टेक्स्ट जनरेट करते समय, मॉडल केवल उन टोकन्स पर निर्भर हो सकता है जिन्हें वह पहले ही उत्पन्न कर चुका है। भविष्य के टोकन्स को देख लेना प्रशिक्षण के दौरान चीटिंग होगा।
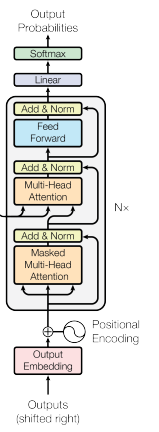
डिकोडर आर्किटेक्चर
मास्क्ड सेल्फ-अटेंशन यह काम वर्तमान स्थान के बाद आने वाले सभी स्थानों के लिए अटेंशन वेट्स को ऋण-अनंत (जो softmax के बाद शून्य हो जाते हैं) सेट करके करता है।
यह सुनिश्चित करता है कि भविष्यवाणियाँ केवल पिछले संदर्भ पर निर्भर हों, और जनरेशन कार्यों के लिए आवश्यक कार्य-कारण क्रम बना रहे। इंफेरेंस के दौरान यह कॉज़ैलिटी स्वाभाविक हो जाती है: हमारे पास अभी भविष्य के टोकन्स होते ही नहीं जिन पर ध्यान दिया जा सके।
क्रॉस-अटेंशन: एन्कोडर और डिकोडर को जोड़ना
डिकोडर की सेल्फ-अटेंशन लेयर्स के बीच क्रॉस-अटेंशन होता है, जो डिकोडर को एन्कोडर आउटपुट्स पर कंडीशन करने देता है। यहाँ क्वेरीज डिकोडर से आती हैं (दर्शाती हैं "मुझे क्या जनरेट करना है"), जबकि कीज़ और वैल्यूज़ एन्कोडर से आती हैं (दर्शाती हैं "इनपुट क्या प्रदान करता है").
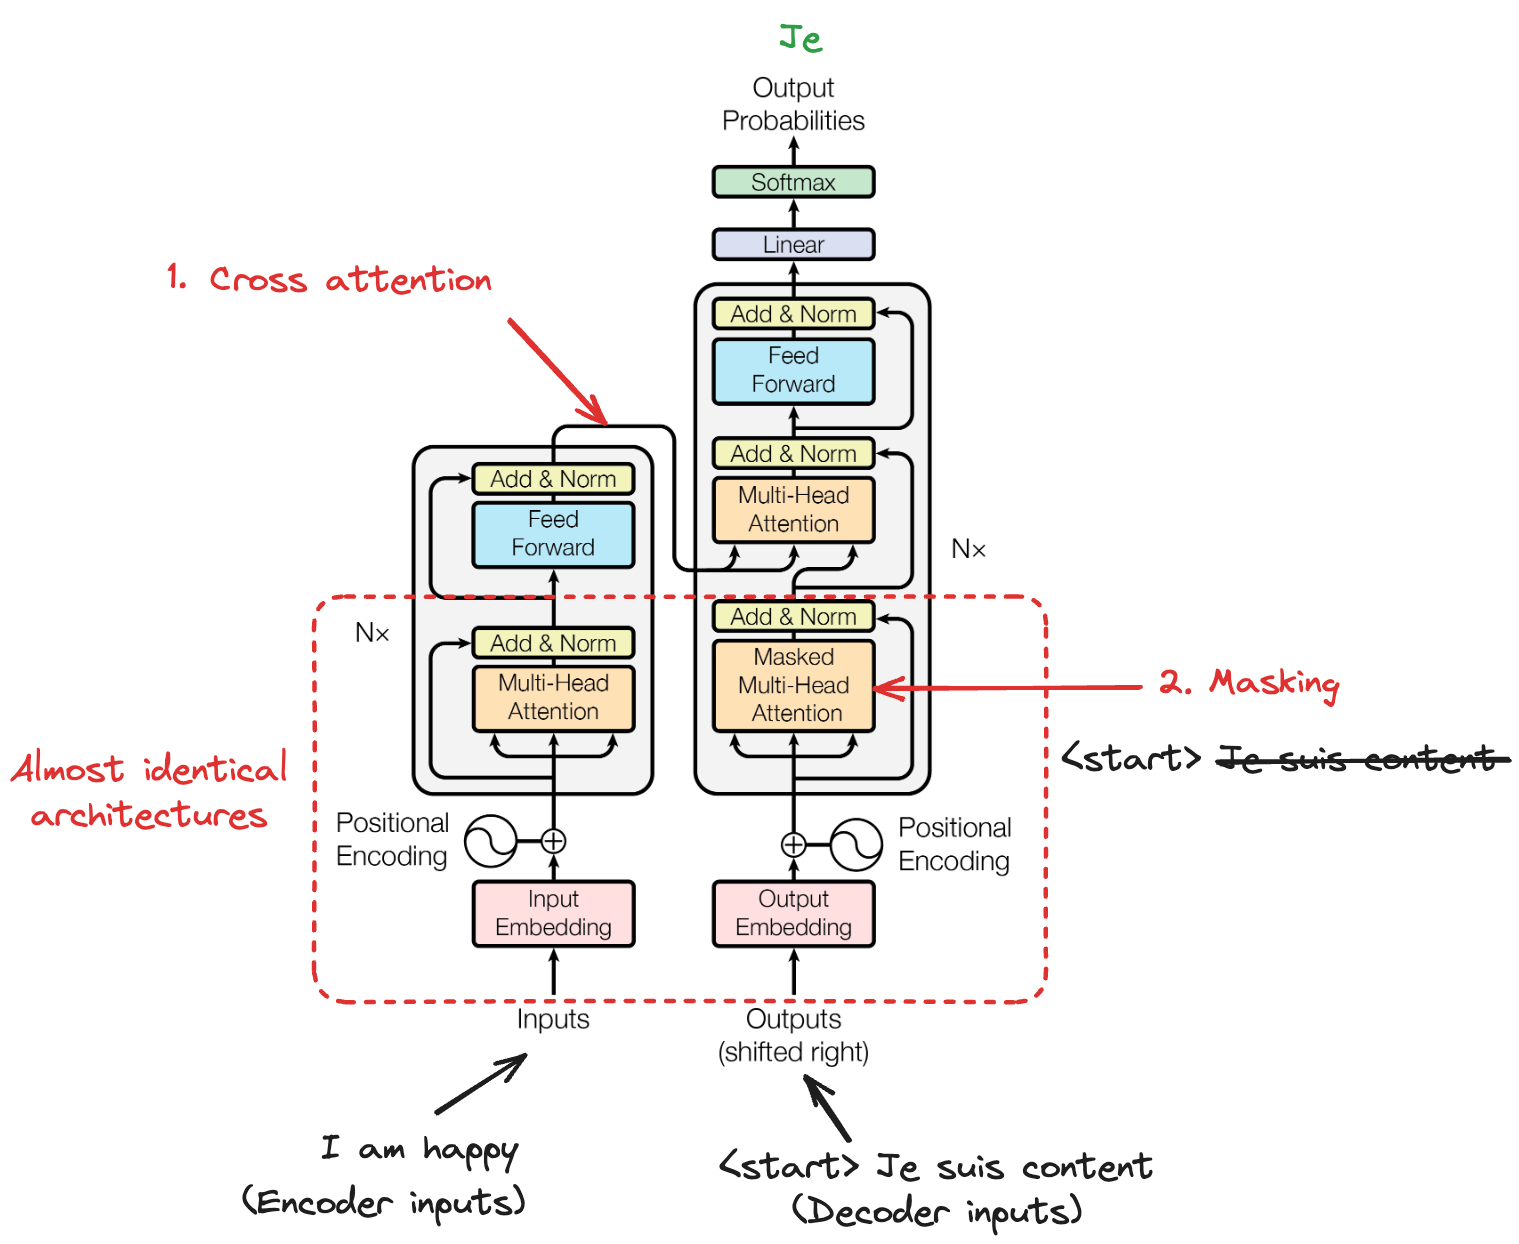
ट्रांसफॉर्मर आर्किटेक्चर
यह क्रॉस-अटेंशन तंत्र अनुवाद जैसे अनुक्रम-से-अनुक्रम कार्यों के लिए आवश्यक है, जहाँ डिकोडर को आउटपुट शब्दों को प्रासंगिक इनपुट शब्दों के साथ संरेखित करना होता है। सेल्फ-अटेंशन के विपरीत, क्रॉस-अटेंशन दो अलग-अलग अनुक्रमों के बीच निर्भरताएँ बनाता है, जिससे सूचना स्रोत से लक्ष्य तक प्रवाहित हो पाती है।
सिद्धांत एक तरफ, व्यवहार में सेल्फ-अटेंशन ने वास्तव में क्या सक्षम किया है? उत्तर अधिकांश लोगों की अपेक्षा से व्यापक है।
विभिन्न क्षेत्रों में Self-Attention के अनुप्रयोग
ट्रांसफॉर्मर आर्किटेक्चर के भीतर सेल्फ-अटेंशन कैसे काम करता है, यह देखने के बाद, आइए देखें कि इस तंत्र ने वास्तविक दुनिया में कहाँ प्रभाव डाला है।
सेल्फ-अटेंशन को खास मूल्यवान बनाता है उसका डोमेन-अज्ञेयवादी स्वभाव। वही गणितीय ढांचा जो मॉडलों को भाषा संबंधों को समझने में मदद करता है, वह इमेजेस, ऑडियो और यहां तक कि विभिन्न डेटा प्रकारों के संयोजन में भी पैटर्न पकड़ सकता है।
मेरे विचार में, यही डोमेन-अज्ञेयवादी गुणवत्ता सेल्फ-अटेंशन को सचमुच रोमांचक बनाती है। मैं कहूंगा कि यह केवल NLP का औज़ार नहीं, बल्कि एक सामान्य-उद्देश्य संबंध-सीखने वाला तंत्र है।
प्राकृतिक भाषा संसाधन (NLP) अनुप्रयोग
ट्रांसफॉर्मर मॉडल्स लंबी दूरी की निर्भरताएँ पकड़ने में उत्कृष्ट हैं जिन्हें पहले की आर्किटेक्चर्स चूक जाती थीं। NLP में, सेल्फ-अटेंशन लगभग हर कार्य में ब्रेकथ्रू मॉडल्स को शक्ति देता है।
- मशीन अनुवाद: स्रोत और लक्ष्य वाक्यांशों का संरेखण, उनकी दूरी की परवाह किए बिना
- सेंटिमेंट विश्लेषण: उन संदर्भ संकेतों की पहचान जो अर्थ को संशोधित करते हैं
- प्रश्नोत्तर: प्रश्नों को प्रासंगिक अनुच्छेद खंडों से जोड़ना, भले ही वे कई टोकन्स से अलग हों।
जैसा कि आप नीचे की छवि में देख सकते हैं, मॉडलों की आर्किटेक्चर इस पर निर्भर करती है कि फोकस डिकोडर पर है या एन्कोडर पर।
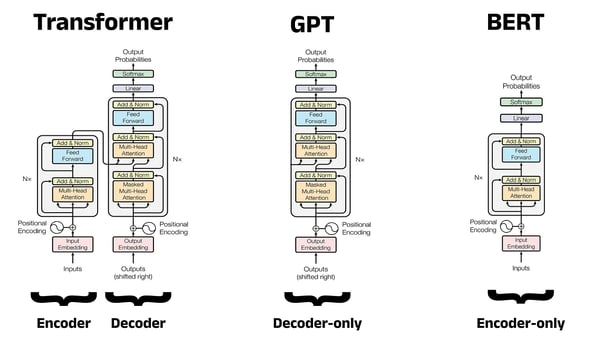
आर्किटेक्चर तुलना: Transformer बनाम GPT बनाम BERT
मॉडल्स जैसे BERT अपनी एन्कोडर-ओनली आर्किटेक्चर में द्विदिश सेल्फ-अटेंशन का उपयोग करते हैं, जिससे वे वर्गीकरण और समझ कार्यों के लिए समृद्ध संदर्भात्मक अभिव्यक्तियाँ बना पाते हैं।
हाल ही में जारी GPT-5.3 Codex जैसे GPT मॉडल्स अपने डिकोडर-ओनली डिजाइन में मास्क्ड सेल्फ-अटेंशन का उपयोग करते हैं और उल्लेखनीय टेक्स्ट जनरेशन क्षमताएँ हासिल करते हैं।
T5 पूर्ण एन्कोडर-डिकोडर ट्रांसफॉर्मर आर्किटेक्चर अपनाता है, सभी NLP कार्यों को टेक्स्ट-टू-टेक्स्ट समस्याओं के रूप में मानता है।
कंप्यूटर विज़न अनुप्रयोग
Vision Transformer (ViT) अनुकूलन ने इमेजेज़ को पैचेज़ के अनुक्रम के रूप में मानकर सेल्फ-अटेंशन को कंप्यूटर विज़न में लाया। कन्वोल्यूशनल लेयर्स के माध्यम से पिक्सेल्स को संसाधित करने के बजाय, ViT इमेजes को फिक्स्ड-साइज़ पैचेज़ (आमतौर पर 16×16) में विभाजित करता है, प्रत्येक पैच को एक वेक्टर में फ्लैट करता है, और अनुक्रम को ट्रांसफॉर्मर लेयर्स के माध्यम से प्रोसेस करता है।
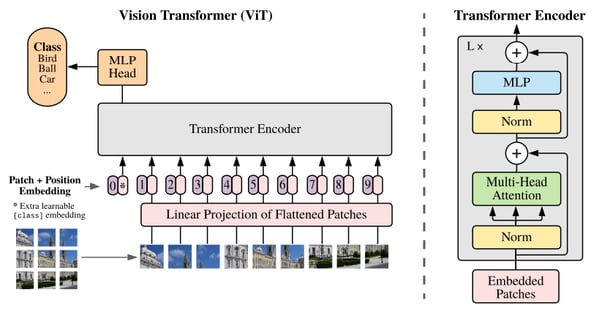
Vision Transformer
यह तरीका उन वैश्विक संबंधों को पकड़ता है जिन्हें कन्वोल्यूशनल नेटवर्क्स के स्थानीय रिसेप्टिव फील्ड्स चूक सकते हैं। ViT और इसके वैरिएंट्स अब इमेज क्लासिफिकेशन, ऑब्जेक्ट डिटेक्शन, सैमांटिक सेगमेंटेशन और अन्य क्षेत्रों में अत्याधुनिक परिणाम हासिल कर रहे हैं:
- मेडिकल इमेजिंग: स्कैन के अलग-अलग क्षेत्रों में सूक्ष्म विसंगतियों का सहसंबंध।
- सैटेलाइट इमेजरी विश्लेषण: वनों की कटाई जैसी दूरस्थ विशेषताओं का उनके कारणों से संबंध जोड़ना।
स्पीच, रिकमेंडर सिस्टम्स, और मल्टीमॉडल लर्निंग
सेल्फ-अटेंशन की उपयोगिता स्पीच प्रोसेसिंग तक फैली हुई है, जहाँ यह ऑडियो अनुक्रमों में समय-आधारित निर्भरताओं को आवर्ती मॉडलों की तुलना में अधिक प्रभावी ढंग से पकड़ता है। रीकमेंडर सिस्टम्स में, सेल्फ-अटेंशन प्रासंगिक ऐतिहासिक इंटरैक्शंस पर ध्यान देकर उपयोगकर्ता वरीयता पैटर्न का मॉडल बनाने में मदद करता है।
शायद सबसे रोमांचक मल्टीमॉडल अनुप्रयोग हैं जो विज़न और भाषा को मिलाते हैं। CLIP जैसे मॉडल इमेज और टेक्स्ट अभिव्यक्तियों के बीच क्रॉस-अटेंशन का उपयोग करते हैं, जिससे ज़ीरो-शॉट इमेज क्लासिफिकेशन और टेक्स्ट विवरणों से इमेज जनरेशन संभव होती है।
इन सभी प्रणालियों में एक समान बात है: वे किसी भी अनुक्रमिक या संरचित डेटा—मॉडैलिटी की परवाह किए बिना—के बीच संबंध सीखने की सेल्फ-अटेंशन की मूलभूत क्षमता को प्रदर्शित करते हैं।
उन्नत Self-Attention वेरिएंट्स और हालिया विकास
यद्यपि सेल्फ-अटेंशन विभिन्न डोमेनों में उल्लेखनीय रूप से सफल रहा है, ट्रांसफॉर्मर मॉडलों को बड़े पैमाने पर तैनात करते समय नई चुनौतियाँ सामने आती हैं। जैसे-जैसे मॉडल अरबों पैरामीटर्स तक बढ़ते हैं और कॉन्टेक्स्ट्स सैकड़ों हज़ार टोकन्स तक फैलते हैं, मेमोरी बैंडविड्थ और संगणनात्मक लागतें गंभीर बाधाएँ बन जाती हैं।
नए मॉडलों के विकास में फोकस बढ़ते हुए सेल्फ-अटेंशन को तेज और अधिक कुशल बनाने पर है, बिना इसकी मूल क्षमताओं का त्याग किए। मेरे लिए यह क्षमता और दक्षता के बीच यह तनाव वर्तमान समय की सबसे दिलचस्प खुली समस्याओं में से एक है। आइए कुछ वर्तमान विकास देखें।
ग्रुप्ड-क्वेरी और मल्टी-क्वेरी अटेंशन
मानक मल्टी-हेड अटेंशन प्रत्येक हेड के लिए अलग की और वैल्यू प्रोजेक्शंस बनाए रखता है, जिससे इंफेरेंस के दौरान पर्याप्त मेमोरी ओवरहेड बनता है। मल्टी-क्वेरी अटेंशन (MQA) इसे सभी क्वेरी हेड्स में एकल की-वैल्यू (KV) हेड साझा करके कम करता है, जिससे KV कैश आकार नाटकीय रूप से घटता है और डिकोडिंग तेज होती है। हालांकि, MQA गुणवत्ता को घटा सकता है।
ग्रुप्ड-क्वेरी अटेंशन (GQA) एक अधिक संतुलित दृष्टिकोण है, जो क्वेरी हेड्स को ऐसे समूहों में विभाजित करता है जो की-वैल्यू पेयर्स साझा करते हैं। 32 क्वेरी हेड्स और 8 समूहों के साथ, प्रत्येक 4 क्वेरीज का समूह एक की-वैल्यू हेड साझा करता है। उदाहरण के लिए, Mistral 3 मॉडल परिवार इस दृष्टिकोण का उपयोग करता है और महत्वपूर्ण स्पीड गेन के साथ लगभग फुल-अटेंशन गुणवत्ता प्राप्त करने में सक्षम है।
स्टेट स्पेस मॉडलों के साथ अटेंशन को मिलाने वाली हाइब्रिड आर्किटेक्चर्स
जहाँ GQA मेमोरी दक्षता को संबोधित करता है, वहीं शोध की एक और दिशा ध्यान (अटेंशन) की मूलभूत संगणनात्मक बाधा को अलग कोण से सुलझाती है।
हालिया कार्य दक्षता बढ़ाने के लिए सेल्फ-अटेंशन को स्टेट-स्पेस मॉडलों के साथ मिलाने की पड़ताल करता है। S4 और Hyena जैसे सिस्टम संरचित स्टेट स्पेसेज़ का उपयोग करके लंबी दूरी की निर्भरताओं को रैखिक (लीनियर) बजाय द्विघात (क्वाड्रेटिक) जटिलता के साथ मॉडल करते हैं।
ये दृष्टिकोण सेल्फ-अटेंशन की मूल सीमा को संबोधित करते हैं: संगणनात्मक लागत अनुक्रम की लंबाई के साथ द्विघात रूप से स्केल करती है, जिससे अत्यंत लंबे कॉन्टेक्स्ट्स अत्यधिक महंगे हो जाते हैं।
इंफेरेंस-टाइम स्केलिंग और टेस्ट-टाइम ऑप्टिमाइज़ेशन
स्वयं आर्किटेक्चर की पुनर्कल्पना से परे, शोधकर्ताओं ने मौजूदा अटेंशन तंत्रों को अनुकूलित करने के चतुर तरीके भी खोजे हैं।
आर्किटेक्चरल परिवर्तनों के अलावा, हालिया प्रगति इंफेरेंस के दौरान अटेंशन को अनुकूलित करती है। क्वांटाइजेशन KV कैश की परिशुद्धता को 8 या 4 बिट्स तक घटाता है, जिससे न्यूनतम गुणवत्ता हानि के साथ मेमोरी में भारी कटौती होती है।
Flash Attention GPU मेमोरी एक्सेस को पुनर्गठित करता है ताकि डेटा मूवमेंट न्यूनतम हो, और 2-3× स्पीडअप हासिल करता है। टेस्ट-टाइम कंप्यूट ऑप्टिमाइज़ेशन, जिसमें मॉडल जनरेशन के दौरान एकाधिक पासेज़ करता है, संकेत देता है कि रणनीतिक अटेंशन अनुप्रयोग शुद्ध रूप से मॉडल आकार बढ़ाने की तुलना में बेहतर परिणाम दे सकता है।
निष्कर्ष
सेल्फ-अटेंशन मशीन लर्निंग के इतिहास के सबसे परिवर्तनकारी तंत्रों में से एक है। इनपुट के किन तत्वों पर ध्यान दिया जाना चाहिए, यह गतिशील रूप से निर्धारित करने में मॉडलों को सक्षम बनाकर, इसने लंबी दूरी की निर्भरताएँ पकड़ने और अनुक्रमों को कुशलतापूर्वक संसाधित करने की दीर्घकालिक चुनौतियों को सुलझा दिया।
स्केल्ड डॉट-प्रोडक्ट अटेंशन की गणितीय सुंदरता, मल्टी-हेड आर्किटेक्चर्स के माध्यम से सशक्त होकर, सैद्धांतिक दृढ़ता और व्यावहारिक प्रभावशीलता दोनों प्रदान करती है।
From powering state-of-the-art भाषा मॉडलों को शक्ति देने से लेकर कंप्यूटर विज़न में क्रांति लाने और मल्टीमॉडल AI सिस्टम संभव करने तक, सेल्फ-अटेंशन अपना दायरा लगातार बढ़ा रहा है। ग्रुप्ड-क्वेरी अटेंशन, हाइब्रिड आर्किटेक्चर और इंफेरेंस ऑप्टिमाइज़ेशन में हालिया नवाचार दिखाते हैं कि हम अभी भी इस तंत्र को और अधिक कुशल और सक्षम बनाने के तरीके खोज रहे हैं।
यदि आप सभी विवरणों में जाना और हाथों-हाथ अभ्यास करना चाहते हैं, तो मैं हमारे Developing Large Language Models स्किल ट्रैक में नामांकन करने की सलाह देता हूँ।


2017 के अंत में, Attention Is All You Need शीर्षक वाले एक शोध पत्र ने एक क्रांतिकारी तंत्र पेश किया जिसने कृत्रिम बुद्धिमत्ता की दिशा ही बदल दी। इस सफलता के केंद्र में था सेल्फ-अटेंशन—एक सरल, फिर भी शक्तिशाली विचार जो यह तय करके कि किन तत्वों पर ध्यान दिया जाना चाहिए, मॉडलों को डेटा के भीतर संबंधों को समझने में सक्षम बनाता है।
आज, सेल्फ-अटेंशन ChatGPT की बातचीत की क्षमता से लेकर उन्नत इमेज रिकग्निशन सिस्टम तक सब कुछ चला रहा है। यह निस्संदेह मशीन लर्निंग के इतिहास की सबसे परिवर्तनकारी नवाचारों में से एक है।
इस गाइड में, मैं आपको अवधारणात्मक नींव से लेकर अनुप्रयोगों तक सेल्फ-अटेंशन से परिचित कराऊंगा, दिखाऊंगा कि यह तंत्र मॉडलों को लंबी दूरी की निर्भरताओं को पकड़ने और सूचना को समानांतर में संसाधित करने में कैसे मदद करता है—ऐसी क्षमताएं जो पारंपरिक न्यूरल नेटवर्क के साथ पहले संभव नहीं थीं।
यदि आप ट्रांसफॉर्मर्स में नए हैं, तो हमारे परिचयात्मक कोर्स—Large Language Models (LLMs) Concepts और Transformer Models with PyTorch—में से कोई एक लेने पर विचार करें।
Self-Attention क्या है?
अपने अनुभव में, इस अवधारणा को सिखाने की सबसे अच्छी शुरुआत अनुक्रम प्रसंस्करण की एक बुनियादी चुनौती से होती है: किसी भी क्षण एक मॉडल अपने इनपुट के किन हिस्सों को सबसे अधिक प्रासंगिक कैसे तय करे?
कोई भी गणित शुरू करने से पहले, पहले अंतर्ज्ञान से शुरुआत करते हैं।
सेल्फ-अटेंशन की अवधारणात्मक समझ
सेल्फ-अटेंशन एक तंत्र है जो किसी अनुक्रम के विभिन्न तत्वों की एक-दूसरे के सापेक्ष महत्ता को तौलता है। जब वाक्य "The animal didn't cross the road because it was too tired" संसाधित किया जाता है, तो सेल्फ-अटेंशन मॉडल को यह समझने में मदद करता है कि "it" का संदर्भ "animal" से है, न कि "road" से—एक ऐसा संबंध जो कई शब्दों में फैला है।
यह वास्तव में वही उदाहरण है जिसे मैं छात्रों को यह अवधारणा समझाते समय हमेशा उपयोग करता हूँ। यह तुरंत समझ में आता है क्योंकि यह वैसा ही है जैसा हम स्वाभाविक रूप से पढ़ते हैं।
अटेंशन मैकेनिज्म
सेल्फ-अटेंशन की खास ताकत इसकी यह क्षमता है कि वह अनुक्रम के सभी स्थानों के लिए इन संबंधों की गणना एक साथ कर सकता है। आवर्ती न्यूरल नेटवर्क्स के विपरीत, जो अनुक्रमों को कदम-दर-कदम संसाधित करते हैं, सेल्फ-अटेंशन एक ही फॉरवर्ड पास में हर तत्व को हर दूसरे तत्व के संदर्भ में देखता है।
यह समानांतर गणना प्रशिक्षण समय को नाटकीय रूप से कम कर देती है, जबकि अनुक्रम में दूरी की परवाह किए बिना निर्भरताओं को पकड़ लेती है।
सेल्फ-अटेंशन को संबंधित तंत्रों से अलग समझना महत्वपूर्ण है। सेल्फ-अटेंशन में, एक अनुक्रम स्वयं पर ध्यान देता है। प्रत्येक तत्व उसी अनुक्रम के सभी स्थानों से जानकारी क्वेरी करता है।
क्रॉस-अटेंशन इसके विपरीत, एक अनुक्रम को दूसरे पर ध्यान देने देता है, जैसे मशीन अनुवाद के दौरान डिकोडर का एन्कोडर आउटपुट्स पर ध्यान देना।
मास्क्ड सेल्फ-अटेंशन एक अतिरिक्त बाधा जोड़ता है: यह स्थानों को आगे आने वाले स्थानों पर ध्यान देने से रोकता है, ताकि भविष्यवाणियां केवल ज्ञात आउटपुट्स पर निर्भर रहें—जो ऑटोरिग्रेसिव टेक्स्ट जनरेशन के लिए आवश्यक है।
लेकिन यह विचार आया कहां से, और इसे किन समस्याओं को सुलझाने के लिए डिजाइन किया गया था?
सेल्फ-अटेंशन की उत्पत्ति और प्रेरणा
सेल्फ-अटेंशन के आने से पहले, यह क्षेत्र अनुक्रम मॉडलिंग में महत्वपूर्ण सीमाओं से जूझ रहा था।
रकरेंट न्यूरल नेटवर्क्स, जिनमें LSTM और GRU शामिल हैं, अनुक्रमों को क्रमिक रूप से संसाधित करते हैं, जिससे एक बुनियादी बाधा बनती है: वे लंबी दूरी की निर्भरताओं से जूझते हैं क्योंकि जानकारी को कई मध्यवर्ती अवस्थाओं से गुजरना पड़ता है, जिससे वैनिशिंग ग्रेडिएंट्स और संदर्भ का खो जाना होता है।
सेल्फ-अटेंशन की ओर विकास RNN-आधारित एन्कोडर-डिकोडर आर्किटेक्चर्स में अटेंशन मैकेनिज्म से शुरू हुआ। 2014 में, Bahdanau और सहलेखकों ने एक अटेंशन तंत्र पेश किया जिसने डिकोडर्स को एकल फिक्स्ड-लेंथ कॉन्टेक्स्ट वेक्टर पर निर्भर रहने के बजाय सभी एन्कोडर हिडन स्टेट्स तक पहुंचने दिया।
इस सफलता ने सूचना संपीड़न समस्या को संबोधित किया, जहां विभिन्न-लंबाई वाले इनपुट अनुक्रमों को उनकी जटिलता की परवाह किए बिना फिक्स्ड-लेंथ प्रतिनिधित्वों में समेट दिया जाता था।
प्रस्तावित मॉडल का Bahdanau द्वारा ग्राफिकल चित्रण
एक साल बाद, Luong ने सरलीकृत अटेंशन तंत्र प्रस्तावित किए, जिनमें स्केल्ड डॉट-प्रोडक्ट दृष्टिकोण शामिल था, जिसने बाद में ट्रांसफॉर्मर डिजाइन को प्रभावित किया। यद्यपि ये प्रारंभिक अटेंशन तंत्र प्रदर्शन में सुधार करते थे, वे अभी भी क्रमिक RNN प्रसंस्करण पर निर्भर थे।
ग्लोबल अटेंशनल मॉडल (Luong)
सच्ची क्रांति तब आई जब शोधकर्ताओं ने सवाल किया: क्या होगा यदि हम रिकरेंस को हटा दें और केवल अटेंशन पर निर्भर रहें? इस प्रश्न ने ट्रांसफॉर्मर आर्किटेक्चर का मार्ग प्रशस्त किया, जहां अनुक्रमिक संबंधों को समझने के लिए सेल्फ-अटेंशन प्राथमिक तंत्र बन गया।
Self-Attention का गणितीय ढांचा
अब जब हमने समझ लिया है कि सेल्फ-अटेंशन क्यों महत्वपूर्ण है, तो देखते हैं कि यह गणितीय स्तर पर वास्तव में कैसे काम करता है।
क्वेरी, की और वैल्यू अभिव्यक्तियाँ
सेल्फ-अटेंशन इनपुट अनुक्रमों को तीन सीखी गई प्रोजेक्शनों के माध्यम से रूपांतरित करता है: क्वेरीज, कीज़ और वैल्यूज़। इन्हें एक ही जानकारी के अलग-अलग "दृश्यों" के रूप में सोचें, जिनमें से प्रत्येक अटेंशन गणना में एक विशिष्ट भूमिका निभाता है।
इनपुट अनुक्रम के लिए, जिसका एम्बेडिंग आयाम
d_modelहै, हम तीन वेट मैट्रिस बनाते हैं:W_Q,W_K, औरW_V। जब हम अपने इनपुट मैट्रिक्सXको इन वेट्स से गुणा करते हैं, तो हमें मिलता है:क्वेरी मैट्रिक्स
Q = X · W_Q: "मैं क्या ढूंढ रहा हूँ" को दर्शाता हैकी मैट्रिक्स
K = X · W_K: "मैं क्या उपलब्ध कराता हूँ" को दर्शाता हैवैल्यू मैट्रिक्स
V = X · W_V: "मेरे भीतर वास्तव में क्या है" को दर्शाता हैमुझे यह लाइब्रेरी उपमा सहायक लगती है: आप मन में एक क्वेरी लेकर अंदर जाते हैं, इंडेक्स कार्ड्स आपकी कीज़ हैं, और असली किताबें आपकी वैल्यूज़।
आमतौर पर, ये मैट्रिस छोटे आयाम
d_kपर प्रोजेक्ट करती हैं (अक्सर अटेंशन हेड्स की संख्या से विभाजितd_model), जो संगणनात्मक जटिलता को संभालता है और साथ ही अभिव्यक्ति क्षमता बनाए रखता है। लंबी अनुक्रमों तक स्केल करने पर यह आयामी कमी विशेष रूप से महत्वपूर्ण हो जाती है।Q, K और V तैयार होने पर, अब हम स्वयं अटेंशन की गणना कर सकते हैं।
स्केल्ड डॉट-प्रोडक्ट अटेंशन
अटेंशन की गणना एक सुंदर सूत्र का पालन करती है। सबसे पहले, हम क्वेरीज और कीज़ के बीच डॉट प्रोडक्ट लेकर अटेंशन स्कोर की गणना करते हैं। यह ऑपरेशन यह मापता है कि प्रत्येक स्थान जो ढूंढ रहा है और हर दूसरा स्थान जो उपलब्ध कराता है, उनके बीच कितनी अनुकूलता है।
हालांकि, जैसे-जैसे आयाम बढ़ता है, ये डॉट प्रोडक्ट्स परिमाण में बहुत बड़े हो सकते हैं, जिससे softmax फंक्शन अत्यंत छोटे ग्रेडिएंट वाले क्षेत्रों में धकेल दिया जाता है। इस संख्यात्मक अस्थिरता से बचने के लिए, हम की आयाम के वर्गमूल से भाग देकर स्केल करते हैं।
स्केल्ड डॉट-प्रोडक्ट अटेंशन
यह स्केलिंग फैक्टर पूरे नेटवर्क में उपयुक्त विचरण बनाए रखता है, जिससे प्रशिक्षण के दौरान स्थिर ग्रेडिएंट सुनिश्चित होते हैं। इसके बिना, उच्च-आयामी एम्बेडिंग वाले मॉडल प्रभावी रूप से सीखने के लिए संघर्ष करेंगे, क्योंकि softmax लगभग वन-हॉट वितरण देता, जो सार्थक ढंग से अटेंशन वितरित करने में विफल रहता।
आगे बढ़ने से पहले, एक महत्वपूर्ण कमी को संबोधित करना आवश्यक है: पोजिशनल एनकोडिंग।
पोजिशनल एनकोडिंग
जब मैंने इसे पहली बार पढ़ा तो मुझे सबसे ज्यादा यह बात चकित कर गई: सेल्फ-अटेंशन पूरी तरह परिमेय-अपरिवर्तनीय है। आप इनपुट टोकन्स को शफल कर दें, और आपको वही आउटपुट मिलेगा—बस उसी अनुरूप शफल्ड।
इस निहितार्थ को समझने में मुझे एक पल लगा: तंत्र शक्तिशाली है, लेकिन क्रम के प्रति मूलतः अंधा। जहाँ क्रम मायने रखता है (जैसे भाषा की समझ), वहाँ हमें स्पष्ट रूप से पोजिशनल जानकारी इंजेक्ट करनी पड़ती है।
मूल ट्रांसफॉर्मर ने साइनसोइडल पोजिशन एनकोडिंग्स का उपयोग किया, जिसमें प्रत्येक आयाम पर अलग-अलग आवृत्तियों के साइन और कोसाइन फंक्शंस लगाए गए। यह चयन मनमाना नहीं था। तरंग जैसी पैटर्न मॉडल्स को सापेक्ष स्थानों पर ध्यान देना सीखने देते हैं, और एनकोडिंग अनदेखी अनुक्रम लंबाइयों तक स्वाभाविक रूप से विस्तृत हो जाती है।
पोजिशनल एनकोडिंग का दृश्यावलोकन
हाल के नवाचारों में RoPE (Rotary Position Embedding) शामिल है, जो क्वेरी और की वेक्टरों को उनके स्थानों के अनुपात में कोणों द्वारा बहु-आयामी स्थान में घुमाता है। रोटेशन के बाद, क्वेरी और की के बीच डॉट प्रोडक्ट स्वाभाविक रूप से सापेक्ष दूरी को एनकोड करता है।
मजबूत एक्सट्रपलेशन क्षमताओं के कारण RoPE को LLaMA जैसे मॉडलों में व्यापक रूप से अपनाया गया है।
एक अन्य दृष्टिकोण, ALiBi (Attention with Linear Biases), ध्यान स्कोर में सीधे पोजिशन-निर्भर दंड जोड़कर अलग रास्ता अपनाता है। एम्बेडिंग्स को संशोधित करने के बजाय, ALiBi अटेंशन वेट्स को पास के टोकन्स का पक्ष लेने के लिए बायस करता है, जिसमें बायस की तीव्रता विभिन्न अटेंशन हेड्स में बदलती रहती है।
यह तरीका प्रशिक्षण के दौरान देखी गई लंबाइयों से बहुत आगे की अनुक्रम लंबाइयों तक प्रभावशाली एक्सट्रपलेशन दर्शाता है।
Softmax और अटेंशन वेट्स
स्केल्ड अटेंशन स्कोर्स की गणना के बाद, हम की आयाम पर softmax लागू करते हैं। यह सामान्यीकरण कच्चे स्कोर्स को एक प्रायिकता वितरण में बदल देता है, जिससे प्रत्येक क्वेरी स्थान के लिए अटेंशन वेट्स का योग एक हो जाता है।
Softmax उच्चतम-स्कोर वाले संबंधों पर जोर देता है और अप्रासंगिक कनेक्शनों को दबा देता है। हालांकि, यह कभी-कभी अत्यधिक तीखे वितरणों की ओर ले जा सकता है, खासकर शुरुआती प्रशिक्षण में जब मॉडल ने अभी तक सूक्ष्म अटेंशन पैटर्न नहीं सीखे होते।
इसे कम करने के लिए, प्रैक्टिशनर्स अक्सर अटेंशन वेट्स पर ड्रॉपआउट लागू करते हैं, कुछ कनेक्शनों को यादृच्छिक रूप से शून्य कर देते हैं ताकि मजबूती को बढ़ावा मिल सके।
कॉन्टेक्स्ट वेक्टरों की गणना
अटेंशन वेट्स मिलने के बाद, हम वैल्यू वेक्टरों के भारित योग के रूप में अंतिम आउटपुट की गणना करते हैं।
प्रत्येक स्थान को एक संदर्भ-सचेत अभिव्यक्ति मिलती है जो पूरे अनुक्रम से जानकारी को समेकित करती है, जिसमें योगदान अटेंशन वेट्स के अनुपात में होता है। यह भारित संयोजन जानकारी को स्थिर पैटर्न के बजाय सीखे गए संबंधों के आधार पर गतिशील रूप से प्रवाहित होने देता है।
कॉन्टेक्स्ट वेक्टर की गणना
सिंगल-हेड अटेंशन हमें आश्चर्यजनक रूप से बहुत दूर तक ले जाता है, लेकिन इसकी एक सीमा है। अब चीजें और दिलचस्प हो जाती हैं।
मल्टी-हेड अटेंशन और बहु-प्रतिनिधित्व उप-अंतरिक्ष
यद्यपि सिंगल-हेड अटेंशन शक्तिशाली है, इसकी एक बुनियादी सीमा है: यह एक समय में केवल एक प्रकार का संबंध पकड़ सकता है।
प्रेरणा और आर्किटेक्चर
मल्टी-हेड अटेंशन इसे कई अटेंशन गणनाओं को समानांतर में चलाकर संबोधित करता है, जिनमें से प्रत्येक इनपुट संबंधों के अलग-अलग पहलुओं पर केंद्रित होता है। उदाहरण के लिए, अलग-अलग हेड्स इन बातों में विशेषज्ञ हो सकते हैं:
मेरी समझ में, इन मॉडलों के साथ काम करते हुए यह विशेषज्ञता अक्सर प्रशिक्षण के दौरान स्वतः उभर आती है। आप इसे डिजाइन नहीं करते—जो मेरे विचार में पूरे तंत्र का सबसे आकर्षक पहलू है।
मल्टी-हेड अटेंशन
इम्प्लीमेंटेशन में
Q,KऔरVमैट्रिस को आयाम अक्ष के साथ विभाजित करना, प्रत्येक भाग को अलग-अलग अटेंशन हेड्स से प्रोसेस करना, और परिणामों को कॉनकैटिनेट करना शामिल है।यदि हमारे पास 8 हेड्स और 512-आयामी एम्बेडिंग्स हैं, तो प्रत्येक हेड 64-आयामी उप-अंतरिक्षों पर काम करता है। यह समानांतर प्रसंस्करण अनुक्रम लंबाई की जटिलता नहीं बढ़ाता, लेकिन मॉडल की विविध पैटर्न सीखने की क्षमता को कई गुना कर देता है।
अलग-अलग हेड्स क्या सीखते हैं
इस बात पर शोध कि अलग-अलग अटेंशन हेड्स वास्तव में क्या सीखते हैं, रोचक पैटर्न उजागर करता है।
अनुवाद मॉडलों में, कुछ हेड्स लगातार पोजिशनल संबंधों पर ध्यान देते हैं—सामग्री की परवाह किए बिना पड़ोसी शब्दों पर केंद्रित रहते हैं। अन्य हेड्स वाक्य-विन्यास भूमिकाओं में विशेषज्ञता रखते हैं, जैसे कर्ता-क्रिया या क्रिया-उद्देश्य संबंधों की पहचान। तीसरी श्रेणी दुर्लभ या उच्च-जानकारी वाले टोकन्स जैसे प्रॉपर नाउन्स और तकनीकी शब्दों पर ध्यान देती है।
दिलचस्प बात यह है कि व्याख्यात्मकता अध्ययनों से पता चलता है कि कई हेड्स अनावश्यक प्रतीत होते हैं, और जब एक महत्वपूर्ण अंश को प्रून किया जाता है तब भी मॉडल प्रदर्शन बनाए रख सकते हैं। यह अनावश्यकता सम्भवतः मजबूती में योगदान देती है, सुनिश्चित करती है कि महत्वपूर्ण पैटर्न्स के पास नेटवर्क से गुजरने के कई रास्ते हों।
एन्कोडर-डिकोडर अटेंशन में, बाद की डिकोडर लेयर्स के हेड्स अनुवाद गुणवत्ता के लिए सबसे आवश्यक सिद्ध होते हैं, जबकि एन्कोडर सेल्फ-अटेंशन हेड्स को अक्सर काफी हद तक घटाया जा सकता है।
ट्रांसफॉर्मर आर्किटेक्चर के भीतर Self-Attention
गणितीय नींव स्थापित होने के साथ, देखते हैं कि सेल्फ-अटेंशन पूर्ण ट्रांसफॉर्मर आर्किटेक्चर में कैसे एकीकृत होता है।
एन्कोडर: ऑल-टू-ऑल अटेंशन
ट्रांसफॉर्मर एन्कोडर में, सेल्फ-अटेंशन लेयर्स प्रत्येक स्थान को इनपुट अनुक्रम के हर अन्य स्थान पर ध्यान देने देती हैं। यह "ऑल-टू-ऑल" पैटर्न द्विदिश संदर्भ प्रवाह सक्षम करता है, जहां प्रत्येक टोकन पूरे अनुक्रम से सूचित एक अभिव्यक्ति बनाता है।
एन्कोडर आर्किटेक्चर
प्रत्येक एन्कोडर लेयर मल्टी-हेड सेल्फ-अटेंशन को पोजिशन-वाइज फीड-फॉरवर्ड नेटवर्क के साथ संयोजित करती है। फीड-फॉरवर्ड नेटवर्क प्रत्येक स्थान को स्वतंत्र रूप से, पर समान रूप से प्रोसेस करता है, सभी टोकन्स पर एक ही सीखा हुआ रूपांतरण लागू करता है।
रेज़िडुअल कनेक्शंस और लेयर नॉर्मलाइज़ेशन दोनों सब-लेयर्स को घेरते हैं, ग्रेडिएंट्स को स्थिर करते हैं और गहरे आर्किटेक्चर्स को सक्षम करते हैं। कई एन्कोडर लेयर्स को स्टैक करने से क्रमशः अधिक अमूर्त अभिव्यक्तियाँ बनती हैं—प्रारंभिक लेयर्स सतही पैटर्न पकड़ती हैं और गहरी लेयर्स अर्थगत संबंधों को एनकोड करती हैं।
डिकोडर: मास्क्ड अटेंशन और कार्य-कारण (कॉज़ैलिटी)
डिकोडर ऑटोरिग्रेसिव बाधाओं का सम्मान करने के लिए सेल्फ-अटेंशन में संशोधन करता है। टेक्स्ट जनरेट करते समय, मॉडल केवल उन टोकन्स पर निर्भर हो सकता है जिन्हें वह पहले ही उत्पन्न कर चुका है। भविष्य के टोकन्स को देख लेना प्रशिक्षण के दौरान चीटिंग होगा।
डिकोडर आर्किटेक्चर
मास्क्ड सेल्फ-अटेंशन यह काम वर्तमान स्थान के बाद आने वाले सभी स्थानों के लिए अटेंशन वेट्स को ऋण-अनंत (जो softmax के बाद शून्य हो जाते हैं) सेट करके करता है।
यह सुनिश्चित करता है कि भविष्यवाणियाँ केवल पिछले संदर्भ पर निर्भर हों, और जनरेशन कार्यों के लिए आवश्यक कार्य-कारण क्रम बना रहे। इंफेरेंस के दौरान यह कॉज़ैलिटी स्वाभाविक हो जाती है: हमारे पास अभी भविष्य के टोकन्स होते ही नहीं जिन पर ध्यान दिया जा सके।
क्रॉस-अटेंशन: एन्कोडर और डिकोडर को जोड़ना
डिकोडर की सेल्फ-अटेंशन लेयर्स के बीच क्रॉस-अटेंशन होता है, जो डिकोडर को एन्कोडर आउटपुट्स पर कंडीशन करने देता है। यहाँ क्वेरीज डिकोडर से आती हैं (दर्शाती हैं "मुझे क्या जनरेट करना है"), जबकि कीज़ और वैल्यूज़ एन्कोडर से आती हैं (दर्शाती हैं "इनपुट क्या प्रदान करता है").
ट्रांसफॉर्मर आर्किटेक्चर
यह क्रॉस-अटेंशन तंत्र अनुवाद जैसे अनुक्रम-से-अनुक्रम कार्यों के लिए आवश्यक है, जहाँ डिकोडर को आउटपुट शब्दों को प्रासंगिक इनपुट शब्दों के साथ संरेखित करना होता है। सेल्फ-अटेंशन के विपरीत, क्रॉस-अटेंशन दो अलग-अलग अनुक्रमों के बीच निर्भरताएँ बनाता है, जिससे सूचना स्रोत से लक्ष्य तक प्रवाहित हो पाती है।
सिद्धांत एक तरफ, व्यवहार में सेल्फ-अटेंशन ने वास्तव में क्या सक्षम किया है? उत्तर अधिकांश लोगों की अपेक्षा से व्यापक है।
विभिन्न क्षेत्रों में Self-Attention के अनुप्रयोग
ट्रांसफॉर्मर आर्किटेक्चर के भीतर सेल्फ-अटेंशन कैसे काम करता है, यह देखने के बाद, आइए देखें कि इस तंत्र ने वास्तविक दुनिया में कहाँ प्रभाव डाला है।
सेल्फ-अटेंशन को खास मूल्यवान बनाता है उसका डोमेन-अज्ञेयवादी स्वभाव। वही गणितीय ढांचा जो मॉडलों को भाषा संबंधों को समझने में मदद करता है, वह इमेजेस, ऑडियो और यहां तक कि विभिन्न डेटा प्रकारों के संयोजन में भी पैटर्न पकड़ सकता है।
मेरे विचार में, यही डोमेन-अज्ञेयवादी गुणवत्ता सेल्फ-अटेंशन को सचमुच रोमांचक बनाती है। मैं कहूंगा कि यह केवल NLP का औज़ार नहीं, बल्कि एक सामान्य-उद्देश्य संबंध-सीखने वाला तंत्र है।
प्राकृतिक भाषा संसाधन (NLP) अनुप्रयोग
ट्रांसफॉर्मर मॉडल्स लंबी दूरी की निर्भरताएँ पकड़ने में उत्कृष्ट हैं जिन्हें पहले की आर्किटेक्चर्स चूक जाती थीं। NLP में, सेल्फ-अटेंशन लगभग हर कार्य में ब्रेकथ्रू मॉडल्स को शक्ति देता है।
जैसा कि आप नीचे की छवि में देख सकते हैं, मॉडलों की आर्किटेक्चर इस पर निर्भर करती है कि फोकस डिकोडर पर है या एन्कोडर पर।
आर्किटेक्चर तुलना: Transformer बनाम GPT बनाम BERT
मॉडल्स जैसे BERT अपनी एन्कोडर-ओनली आर्किटेक्चर में द्विदिश सेल्फ-अटेंशन का उपयोग करते हैं, जिससे वे वर्गीकरण और समझ कार्यों के लिए समृद्ध संदर्भात्मक अभिव्यक्तियाँ बना पाते हैं।
हाल ही में जारी GPT-5.3 Codex जैसे GPT मॉडल्स अपने डिकोडर-ओनली डिजाइन में मास्क्ड सेल्फ-अटेंशन का उपयोग करते हैं और उल्लेखनीय टेक्स्ट जनरेशन क्षमताएँ हासिल करते हैं।
T5 पूर्ण एन्कोडर-डिकोडर ट्रांसफॉर्मर आर्किटेक्चर अपनाता है, सभी NLP कार्यों को टेक्स्ट-टू-टेक्स्ट समस्याओं के रूप में मानता है।
कंप्यूटर विज़न अनुप्रयोग
Vision Transformer (ViT) अनुकूलन ने इमेजेज़ को पैचेज़ के अनुक्रम के रूप में मानकर सेल्फ-अटेंशन को कंप्यूटर विज़न में लाया। कन्वोल्यूशनल लेयर्स के माध्यम से पिक्सेल्स को संसाधित करने के बजाय, ViT इमेजes को फिक्स्ड-साइज़ पैचेज़ (आमतौर पर 16×16) में विभाजित करता है, प्रत्येक पैच को एक वेक्टर में फ्लैट करता है, और अनुक्रम को ट्रांसफॉर्मर लेयर्स के माध्यम से प्रोसेस करता है।
Vision Transformer
यह तरीका उन वैश्विक संबंधों को पकड़ता है जिन्हें कन्वोल्यूशनल नेटवर्क्स के स्थानीय रिसेप्टिव फील्ड्स चूक सकते हैं। ViT और इसके वैरिएंट्स अब इमेज क्लासिफिकेशन, ऑब्जेक्ट डिटेक्शन, सैमांटिक सेगमेंटेशन और अन्य क्षेत्रों में अत्याधुनिक परिणाम हासिल कर रहे हैं:
स्पीच, रिकमेंडर सिस्टम्स, और मल्टीमॉडल लर्निंग
सेल्फ-अटेंशन की उपयोगिता स्पीच प्रोसेसिंग तक फैली हुई है, जहाँ यह ऑडियो अनुक्रमों में समय-आधारित निर्भरताओं को आवर्ती मॉडलों की तुलना में अधिक प्रभावी ढंग से पकड़ता है। रीकमेंडर सिस्टम्स में, सेल्फ-अटेंशन प्रासंगिक ऐतिहासिक इंटरैक्शंस पर ध्यान देकर उपयोगकर्ता वरीयता पैटर्न का मॉडल बनाने में मदद करता है।
शायद सबसे रोमांचक मल्टीमॉडल अनुप्रयोग हैं जो विज़न और भाषा को मिलाते हैं। CLIP जैसे मॉडल इमेज और टेक्स्ट अभिव्यक्तियों के बीच क्रॉस-अटेंशन का उपयोग करते हैं, जिससे ज़ीरो-शॉट इमेज क्लासिफिकेशन और टेक्स्ट विवरणों से इमेज जनरेशन संभव होती है।
इन सभी प्रणालियों में एक समान बात है: वे किसी भी अनुक्रमिक या संरचित डेटा—मॉडैलिटी की परवाह किए बिना—के बीच संबंध सीखने की सेल्फ-अटेंशन की मूलभूत क्षमता को प्रदर्शित करते हैं।
उन्नत Self-Attention वेरिएंट्स और हालिया विकास
यद्यपि सेल्फ-अटेंशन विभिन्न डोमेनों में उल्लेखनीय रूप से सफल रहा है, ट्रांसफॉर्मर मॉडलों को बड़े पैमाने पर तैनात करते समय नई चुनौतियाँ सामने आती हैं। जैसे-जैसे मॉडल अरबों पैरामीटर्स तक बढ़ते हैं और कॉन्टेक्स्ट्स सैकड़ों हज़ार टोकन्स तक फैलते हैं, मेमोरी बैंडविड्थ और संगणनात्मक लागतें गंभीर बाधाएँ बन जाती हैं।
नए मॉडलों के विकास में फोकस बढ़ते हुए सेल्फ-अटेंशन को तेज और अधिक कुशल बनाने पर है, बिना इसकी मूल क्षमताओं का त्याग किए। मेरे लिए यह क्षमता और दक्षता के बीच यह तनाव वर्तमान समय की सबसे दिलचस्प खुली समस्याओं में से एक है। आइए कुछ वर्तमान विकास देखें।
ग्रुप्ड-क्वेरी और मल्टी-क्वेरी अटेंशन
मानक मल्टी-हेड अटेंशन प्रत्येक हेड के लिए अलग की और वैल्यू प्रोजेक्शंस बनाए रखता है, जिससे इंफेरेंस के दौरान पर्याप्त मेमोरी ओवरहेड बनता है। मल्टी-क्वेरी अटेंशन (MQA) इसे सभी क्वेरी हेड्स में एकल की-वैल्यू (KV) हेड साझा करके कम करता है, जिससे KV कैश आकार नाटकीय रूप से घटता है और डिकोडिंग तेज होती है। हालांकि, MQA गुणवत्ता को घटा सकता है।
ग्रुप्ड-क्वेरी अटेंशन (GQA) एक अधिक संतुलित दृष्टिकोण है, जो क्वेरी हेड्स को ऐसे समूहों में विभाजित करता है जो की-वैल्यू पेयर्स साझा करते हैं। 32 क्वेरी हेड्स और 8 समूहों के साथ, प्रत्येक 4 क्वेरीज का समूह एक की-वैल्यू हेड साझा करता है। उदाहरण के लिए, Mistral 3 मॉडल परिवार इस दृष्टिकोण का उपयोग करता है और महत्वपूर्ण स्पीड गेन के साथ लगभग फुल-अटेंशन गुणवत्ता प्राप्त करने में सक्षम है।
स्टेट स्पेस मॉडलों के साथ अटेंशन को मिलाने वाली हाइब्रिड आर्किटेक्चर्स
जहाँ GQA मेमोरी दक्षता को संबोधित करता है, वहीं शोध की एक और दिशा ध्यान (अटेंशन) की मूलभूत संगणनात्मक बाधा को अलग कोण से सुलझाती है।
हालिया कार्य दक्षता बढ़ाने के लिए सेल्फ-अटेंशन को स्टेट-स्पेस मॉडलों के साथ मिलाने की पड़ताल करता है। S4 और Hyena जैसे सिस्टम संरचित स्टेट स्पेसेज़ का उपयोग करके लंबी दूरी की निर्भरताओं को रैखिक (लीनियर) बजाय द्विघात (क्वाड्रेटिक) जटिलता के साथ मॉडल करते हैं।
ये दृष्टिकोण सेल्फ-अटेंशन की मूल सीमा को संबोधित करते हैं: संगणनात्मक लागत अनुक्रम की लंबाई के साथ द्विघात रूप से स्केल करती है, जिससे अत्यंत लंबे कॉन्टेक्स्ट्स अत्यधिक महंगे हो जाते हैं।
इंफेरेंस-टाइम स्केलिंग और टेस्ट-टाइम ऑप्टिमाइज़ेशन
स्वयं आर्किटेक्चर की पुनर्कल्पना से परे, शोधकर्ताओं ने मौजूदा अटेंशन तंत्रों को अनुकूलित करने के चतुर तरीके भी खोजे हैं।
आर्किटेक्चरल परिवर्तनों के अलावा, हालिया प्रगति इंफेरेंस के दौरान अटेंशन को अनुकूलित करती है। क्वांटाइजेशन KV कैश की परिशुद्धता को 8 या 4 बिट्स तक घटाता है, जिससे न्यूनतम गुणवत्ता हानि के साथ मेमोरी में भारी कटौती होती है।
Flash Attention GPU मेमोरी एक्सेस को पुनर्गठित करता है ताकि डेटा मूवमेंट न्यूनतम हो, और 2-3× स्पीडअप हासिल करता है। टेस्ट-टाइम कंप्यूट ऑप्टिमाइज़ेशन, जिसमें मॉडल जनरेशन के दौरान एकाधिक पासेज़ करता है, संकेत देता है कि रणनीतिक अटेंशन अनुप्रयोग शुद्ध रूप से मॉडल आकार बढ़ाने की तुलना में बेहतर परिणाम दे सकता है।
निष्कर्ष
सेल्फ-अटेंशन मशीन लर्निंग के इतिहास के सबसे परिवर्तनकारी तंत्रों में से एक है। इनपुट के किन तत्वों पर ध्यान दिया जाना चाहिए, यह गतिशील रूप से निर्धारित करने में मॉडलों को सक्षम बनाकर, इसने लंबी दूरी की निर्भरताएँ पकड़ने और अनुक्रमों को कुशलतापूर्वक संसाधित करने की दीर्घकालिक चुनौतियों को सुलझा दिया।
स्केल्ड डॉट-प्रोडक्ट अटेंशन की गणितीय सुंदरता, मल्टी-हेड आर्किटेक्चर्स के माध्यम से सशक्त होकर, सैद्धांतिक दृढ़ता और व्यावहारिक प्रभावशीलता दोनों प्रदान करती है।
From powering state-of-the-art भाषा मॉडलों को शक्ति देने से लेकर कंप्यूटर विज़न में क्रांति लाने और मल्टीमॉडल AI सिस्टम संभव करने तक, सेल्फ-अटेंशन अपना दायरा लगातार बढ़ा रहा है। ग्रुप्ड-क्वेरी अटेंशन, हाइब्रिड आर्किटेक्चर और इंफेरेंस ऑप्टिमाइज़ेशन में हालिया नवाचार दिखाते हैं कि हम अभी भी इस तंत्र को और अधिक कुशल और सक्षम बनाने के तरीके खोज रहे हैं।
यदि आप सभी विवरणों में जाना और हाथों-हाथ अभ्यास करना चाहते हैं, तो मैं हमारे Developing Large Language Models स्किल ट्रैक में नामांकन करने की सलाह देता हूँ।