
Kursus
Konsep Large Language Models (LLM)
2 jam
112.1K
Pada akhir 2017, sebuah makalah riset berjudul Attention Is All You Need memperkenalkan sebuah mekanisme revolusioner yang secara fundamental membentuk ulang kecerdasan buatan. Di jantung terobosan ini terdapat self-attention, sebuah gagasan sederhana namun kuat yang memungkinkan model memahami hubungan dalam data dengan menentukan elemen mana yang pantas menjadi fokus.
Saat ini, self-attention menjadi tulang punggung segala hal, mulai dari kemampuan percakapan ChatGPT hingga sistem pengenalan gambar canggih. Ini jelas merupakan salah satu inovasi paling transformatif dalam sejarah pembelajaran mesin.
Dalam panduan ini, saya akan mengajak Anda menelusuri self-attention dari landasan konseptual hingga penerapannya, menunjukkan bagaimana mekanisme ini membantu model menangkap dependensi jarak jauh dan memproses informasi secara paralel—kapabilitas yang sebelumnya tak dapat dicapai oleh jaringan saraf tradisional.
Jika Anda baru mengenal transformer, pertimbangkan untuk mengikuti salah satu kursus pengantar kami tentang Konsep Large Language Models (LLM) dan Model Transformer dengan PyTorch.
Berdasarkan pengalaman saya mengajarkan konsep ini, titik awal terbaik adalah tantangan mendasar dalam pemrosesan urutan: bagaimana sebuah model menentukan bagian mana dari inputnya yang paling relevan pada momen tertentu?
Mari mulai dari intuisi sebelum menyelami matematika.
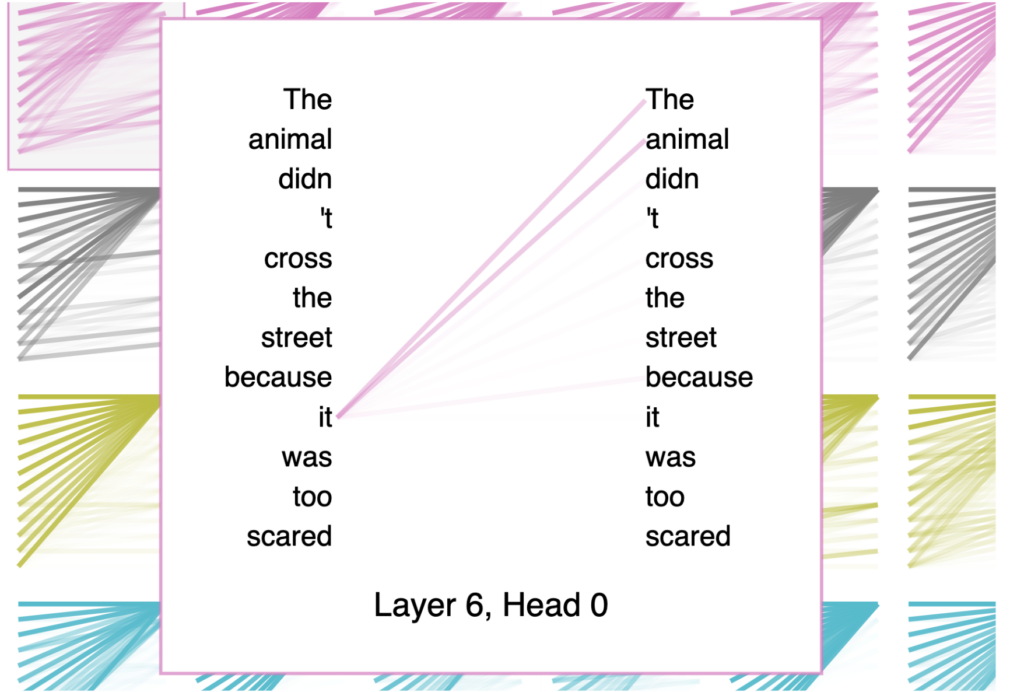
Self-attention adalah mekanisme yang menimbang pentingnya berbagai elemen dalam sebuah urutan relatif satu sama lain. Saat memproses kalimat "The animal didn't cross the road because it was too tired," self-attention membantu model memahami bahwa "it" merujuk kembali ke "animal" alih-alih "road", sebuah hubungan yang membentang melintasi beberapa kata.
Ini sebenarnya contoh yang selalu saya gunakan saat memperkenalkan konsep ini kepada siswa. Mereka langsung paham karena mencerminkan cara kita membaca secara alami.
Yang membuat self-attention sangat kuat adalah kemampuannya menghitung hubungan-hubungan ini untuk semua posisi dalam sebuah urutan secara bersamaan. Berbeda dengan recurrent neural network yang memproses urutan selangkah demi selangkah, self-attention memeriksa setiap elemen terhadap setiap elemen lainnya dalam satu forward pass.
Perhitungan paralel ini secara dramatis mengurangi waktu pelatihan sekaligus menangkap dependensi terlepas dari jaraknya dalam urutan.
Penting untuk membedakan self-attention dari mekanisme terkait. Dalam self-attention, sebuah urutan memperhatikan dirinya sendiri. Setiap elemen melakukan query informasi dari semua posisi dalam urutan yang sama.
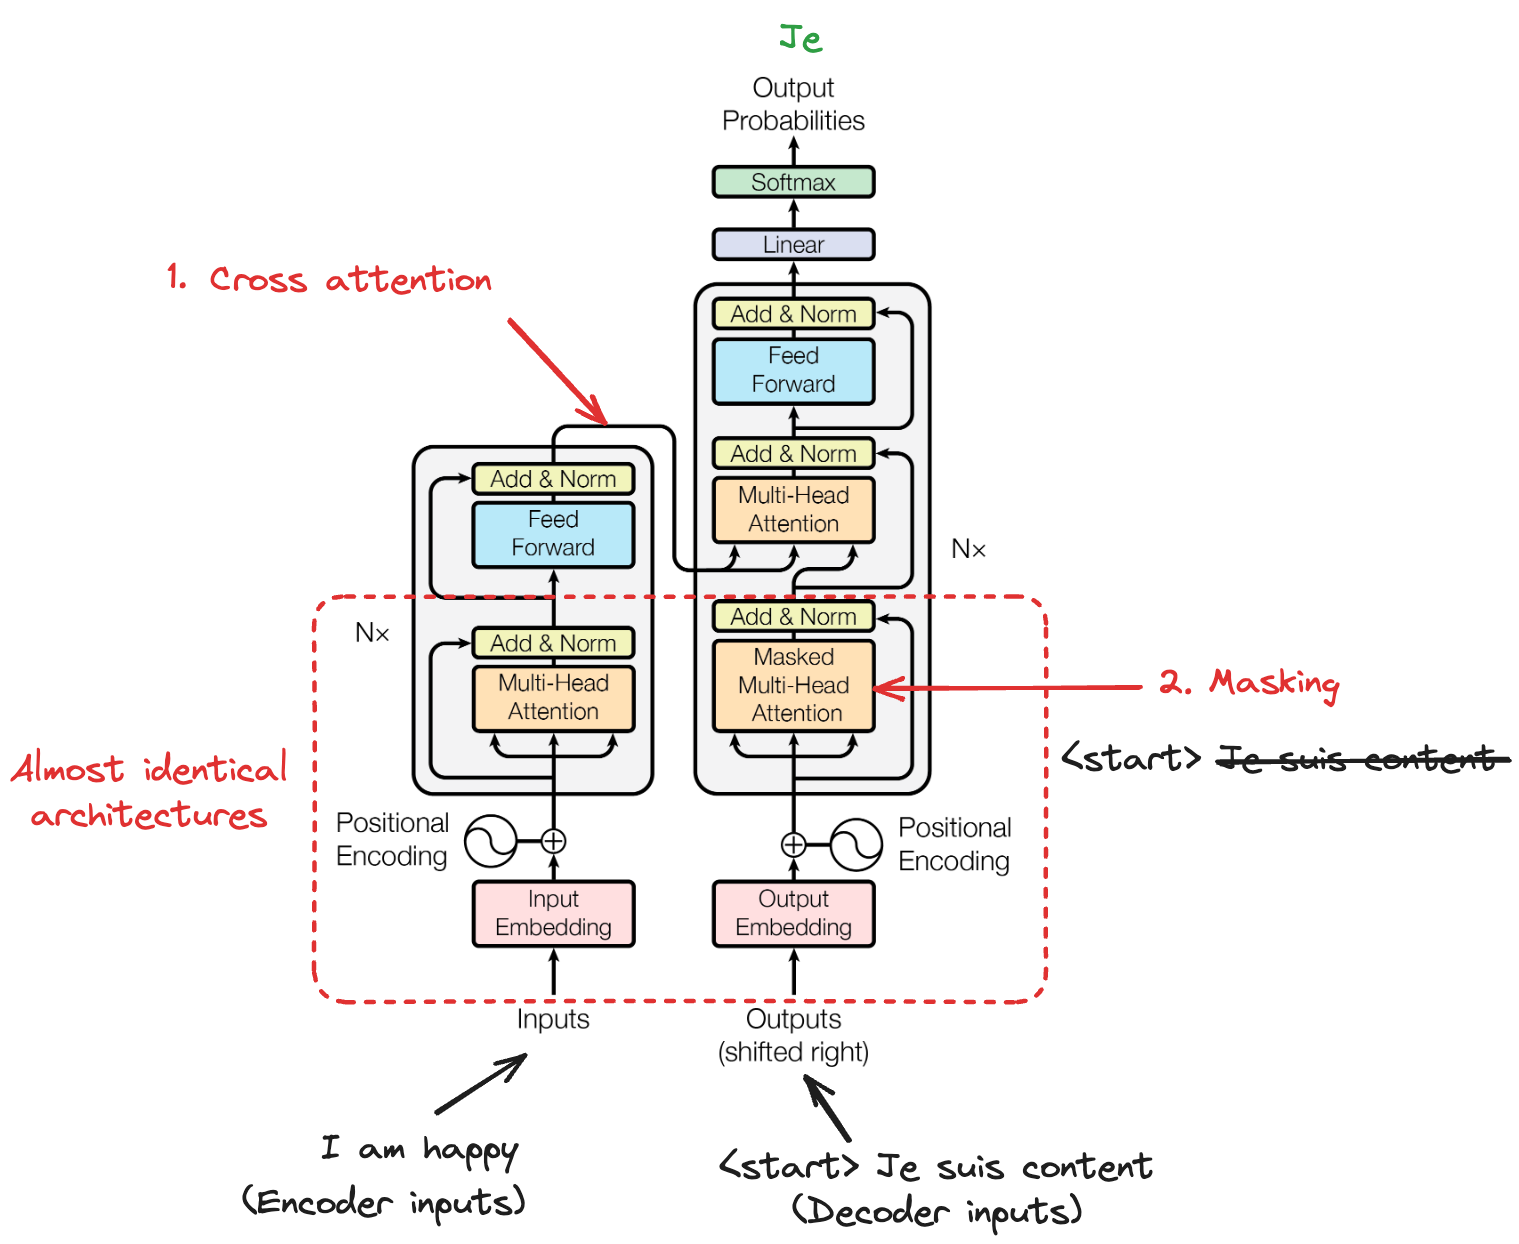
Cross-attention, sebaliknya, memungkinkan satu urutan memperhatikan urutan lain, seperti ketika sebuah decoder memperhatikan keluaran encoder selama penerjemahan mesin.
Masked self-attention menambahkan batasan tambahan: mencegah posisi-posisi memperhatikan posisi-posisi setelahnya, memastikan prediksi hanya bergantung pada keluaran yang sudah diketahui—esensial untuk generasi teks autoregresif.
Namun dari mana sebenarnya ide ini berasal, dan masalah apa yang dirancang untuk dipecahkan?
Sebelum self-attention muncul, bidang ini bergulat dengan keterbatasan signifikan dalam pemodelan urutan.
Recurrent neural network, termasuk LSTM dan GRU, memproses urutan secara berurutan, menciptakan hambatan mendasar: mereka kesulitan dengan dependensi jarak jauh karena informasi harus melewati banyak keadaan perantara, yang menyebabkan gradien menghilang dan konteks terlupakan.
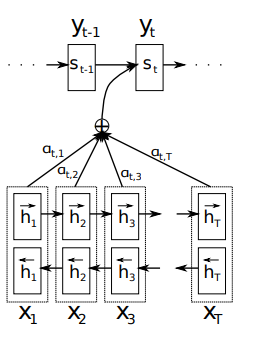
Evolusi menuju self-attention dimulai dengan mekanisme attention dalam arsitektur encoder-decoder berbasis RNN. Pada 2014, Bahdanau dan kolega memperkenalkan mekanisme attention yang memungkinkan decoder mengakses semua hidden state encoder alih-alih mengandalkan satu vektor konteks berdimensi tetap.
Terobosan ini mengatasi masalah kompresi informasi, di mana urutan input berdimensi variabel dipaksa ke dalam representasi berdimensi tetap terlepas dari kompleksitasnya.
Ilustrasi grafis Bahdanau atas model yang diusulkan
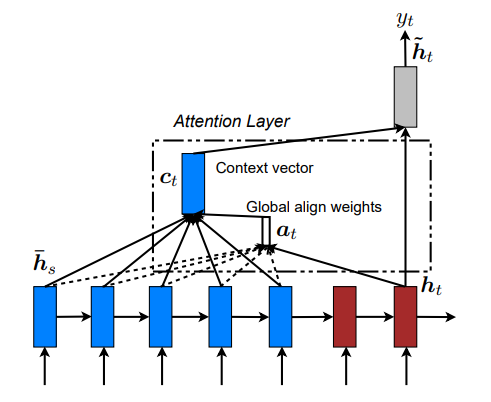
Setahun kemudian, Luong mengusulkan mekanisme attention yang disederhanakan, termasuk pendekatan scaled dot-product yang kelak memengaruhi desain transformer. Meski mekanisme attention awal ini meningkatkan kinerja, tetap saja bergantung pada pemrosesan RNN yang berurutan.
Model attentional global (Luong)
Revolusi sejati terjadi ketika peneliti bertanya: Bagaimana jika kita menghilangkan rekursi dan hanya mengandalkan attention? Pertanyaan ini mengarah ke arsitektur transformer, di mana self-attention menjadi mekanisme utama untuk memahami hubungan berurutan.
Setelah memahami mengapa self-attention penting, mari kita lihat bagaimana cara kerjanya pada tingkat matematis.
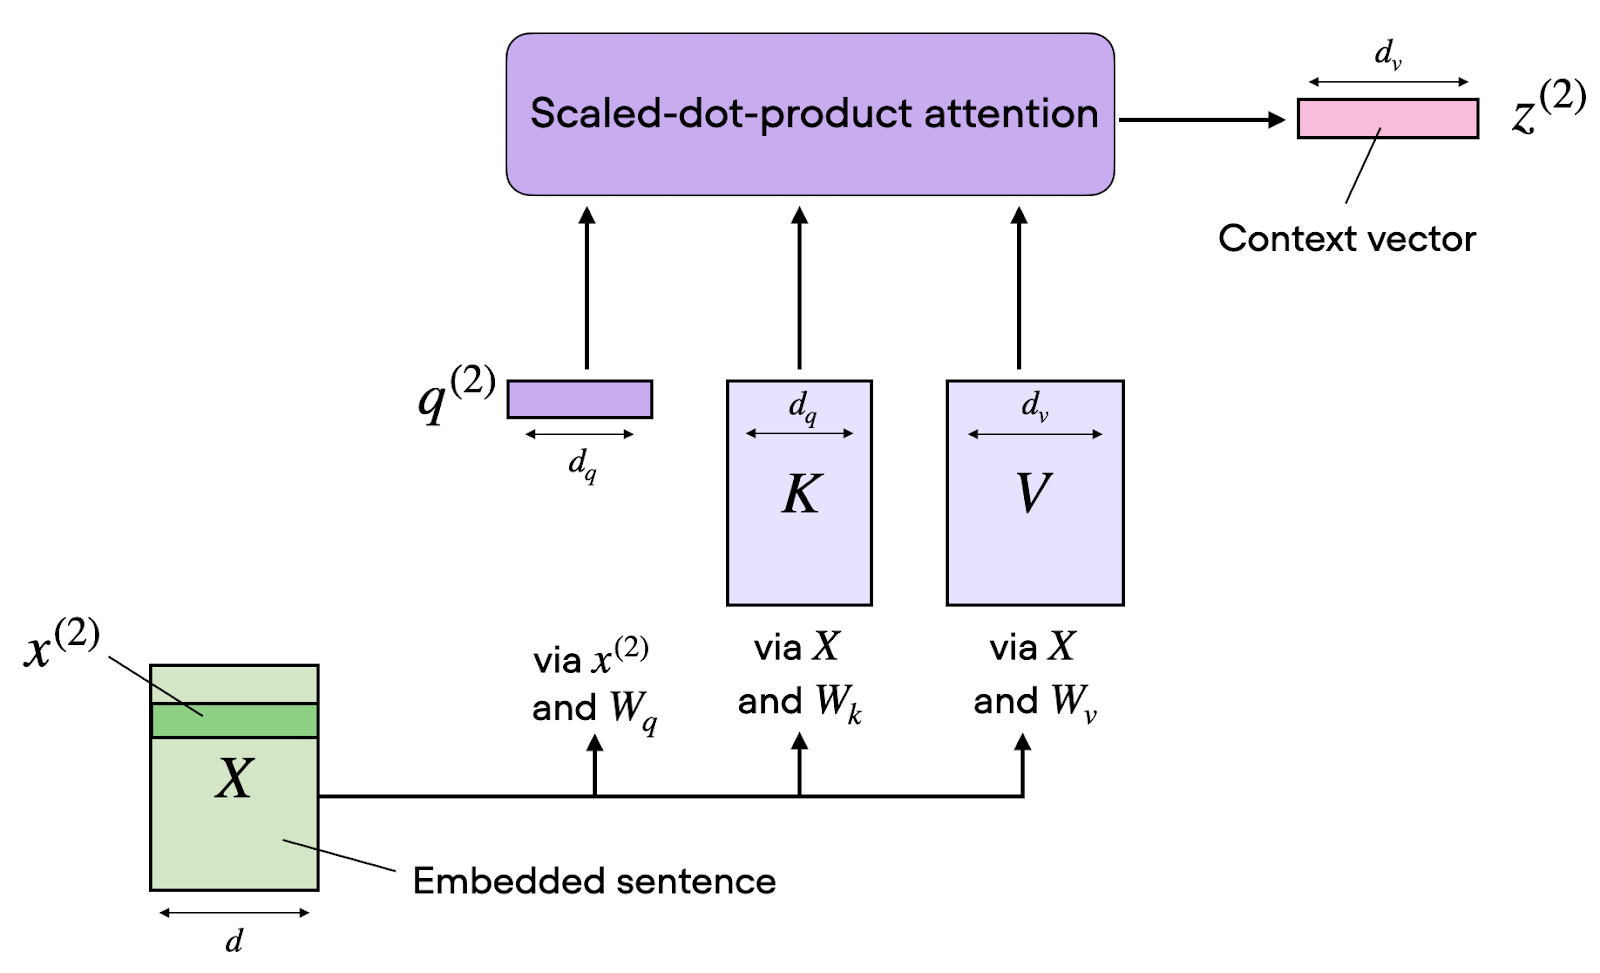
Self-attention mentransformasikan urutan input melalui tiga proyeksi yang dipelajari: query, key, dan value. Anggaplah ini sebagai "sudut pandang" berbeda dari informasi yang sama, masing-masing melayani tujuan berbeda dalam perhitungan attention.
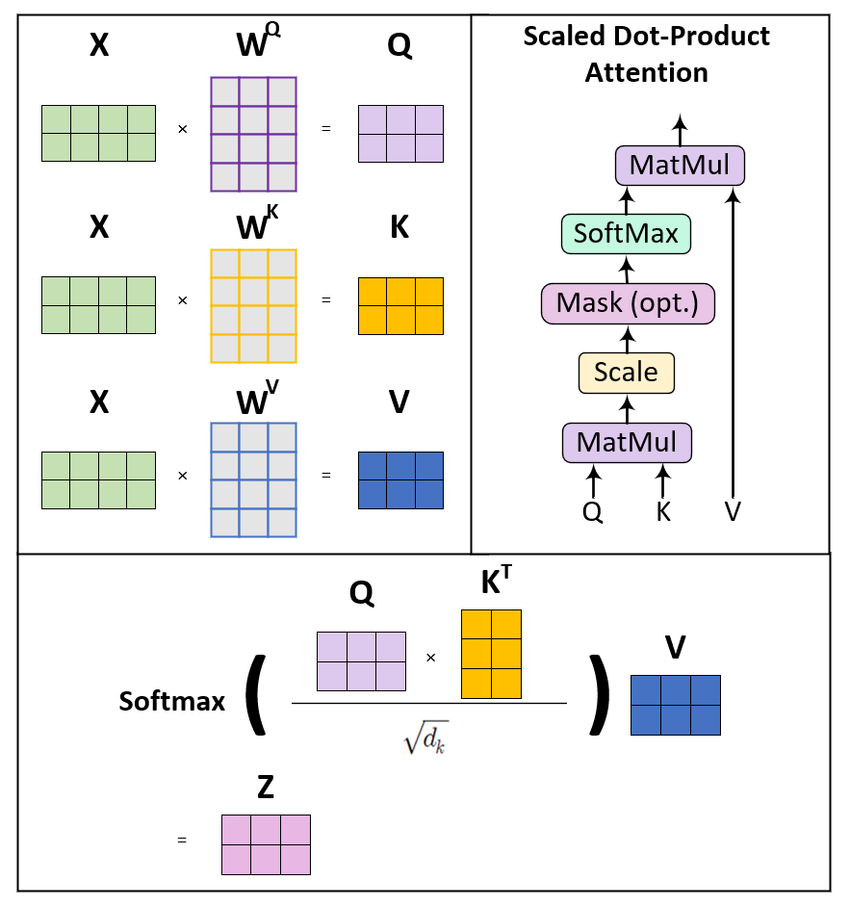
Untuk urutan input dengan dimensi embedding d_model, kita membuat tiga matriks bobot: W_Q, W_K, dan W_V. Saat kita mengalikan matriks input X dengan bobot-bobot ini, kita memperoleh:
Matriks Query Q = X · W_Q: mewakili "apa yang saya cari"
Matriks Key K = X · W_K: mewakili "apa yang saya tawarkan"
Matriks Value V = X · W_V: mewakili "apa yang sebenarnya saya kandung"
Analogi perpustakaan ini membantu: Anda datang dengan query di benak, kartu indeks adalah key Anda, dan buku-buku sebenarnya adalah value Anda.
Biasanya, matriks-matriks ini diproyeksikan ke dimensi yang lebih kecil d_k (sering kali d_model dibagi jumlah attention head), yang mengelola kompleksitas komputasi sambil mempertahankan kapasitas representasi. Reduksi dimensi ini menjadi penting saat melakukan skala ke urutan yang lebih panjang.
Dengan Q, K, dan V di tangan, kini kita dapat menghitung attention itu sendiri.
Perhitungan attention mengikuti rumus yang elegan. Pertama, kita menghitung skor attention dengan mengambil dot product antara query dan key. Operasi ini mengukur kompatibilitas antara apa yang dicari setiap posisi dan apa yang ditawarkan setiap posisi lainnya.
Namun, saat dimensi meningkat, dot product ini dapat menjadi sangat besar, mendorong fungsi softmax ke wilayah dengan gradien yang sangat kecil. Untuk mencegah ketidakstabilan numerik ini, kita melakukan penskalaan dengan membagi dengan akar kuadrat dari dimensi key.
Scaled dot-product attention
Faktor penskalaan ini menjaga varians yang sesuai di seluruh jaringan, memastikan gradien tetap stabil selama pelatihan. Tanpanya, model dengan embedding berdimensi tinggi akan kesulitan belajar secara efektif, karena softmax akan menghasilkan distribusi nyaris one-hot yang gagal mendistribusikan perhatian secara bermakna.
Sebelum lanjut, ada satu celah penting yang perlu kita bahas: Positional encoding.
Bagian yang paling mengejutkan saya saat pertama mempelajari ini adalah: self-attention sepenuhnya invarian terhadap permutasi. Acak urutan token input, Anda akan mendapatkan keluaran yang sama—hanya urutannya yang ikut berubah.
Butuh waktu bagi saya untuk memahami implikasinya: mekanismenya kuat, tetapi pada dasarnya buta terhadap urutan. Untuk tugas yang urutannya penting (seperti pemahaman bahasa), kita perlu secara eksplisit menyuntikkan informasi posisi.
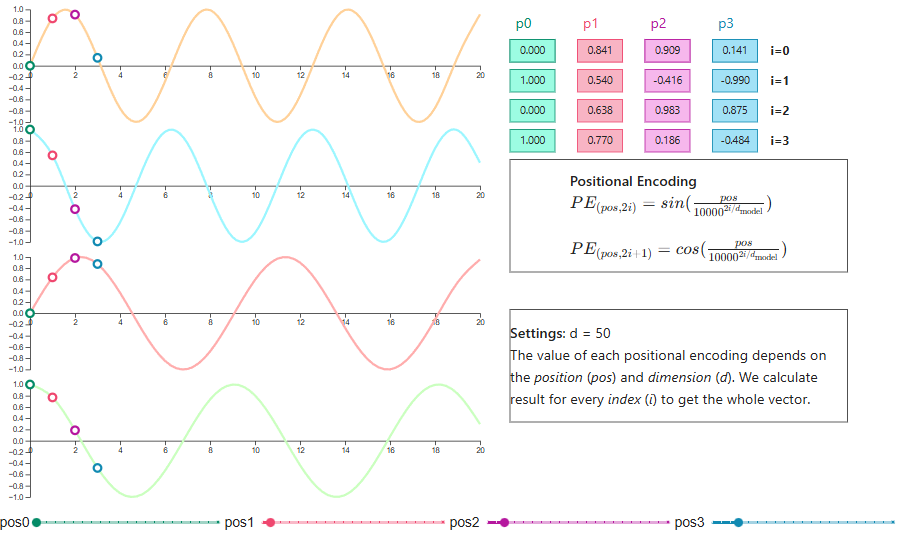
Transformer asli menggunakan positional encoding sinusoidal, menerapkan fungsi sinus dan kosinus dengan frekuensi berbeda pada setiap dimensi. Pilihan ini bukan tanpa alasan. Pola gelombang memungkinkan model belajar memperhatikan posisi relatif, dan encoding ini secara alami meluas ke panjang urutan yang belum pernah dilihat.
Visualisasi positional encoding
Inovasi terbaru mencakup RoPE (Rotary Position Embedding), yang memutar vektor query dan key dalam ruang multi-dimensi dengan sudut yang proporsional terhadap posisinya. Setelah diputar, dot product antara query dan key secara alami mengenkode jarak relatif.
RoPE telah banyak diadopsi dalam model seperti LLaMA karena kemampuan ekstrapolasinya yang kuat.
Pendekatan lain, ALiBi (Attention with Linear Biases), mengambil jalur berbeda dengan menambahkan penalti bergantung posisi langsung ke skor attention. Alih-alih memodifikasi embedding, ALiBi memberi bias pada bobot attention agar lebih mengutamakan token yang berdekatan, dengan intensitas bias bervariasi di berbagai attention head.
Metode ini menunjukkan ekstrapolasi yang mengesankan ke panjang urutan jauh melampaui yang terlihat selama pelatihan.
Setelah menghitung skor attention yang telah diskalakan, kita menerapkan softmax di sepanjang dimensi key. Normalisasi ini mengubah skor mentah menjadi distribusi probabilitas, memastikan bobot attention berjumlah satu untuk setiap posisi query.
Fungsi softmax menekankan hubungan dengan skor tertinggi sambil menekan koneksi yang tidak relevan. Namun, ini kadang dapat menghasilkan distribusi yang terlalu runcing, khususnya pada tahap awal pelatihan ketika model belum mempelajari pola attention yang bernuansa.
Untuk mengatasinya, praktisi sering menerapkan dropout pada bobot attention, secara acak men-nol-kan sebagian koneksi untuk mendorong ketangguhan.
Dengan bobot attention di tangan, kita menghitung keluaran akhir sebagai jumlah berbobot dari vektor value.
Setiap posisi menerima representasi yang sadar konteks yang mengagregasikan informasi dari seluruh urutan, dengan kontribusi proporsional terhadap bobot attention. Kombinasi berbobot ini memungkinkan informasi mengalir secara dinamis berdasarkan hubungan yang dipelajari alih-alih pola tetap.
Attention satu head membawa kita cukup jauh, tetapi ada batasnya. Di sinilah semuanya menjadi lebih menarik.
Walau attention satu head itu kuat, ada keterbatasan mendasar: ia hanya dapat menangkap satu jenis hubungan pada satu waktu.
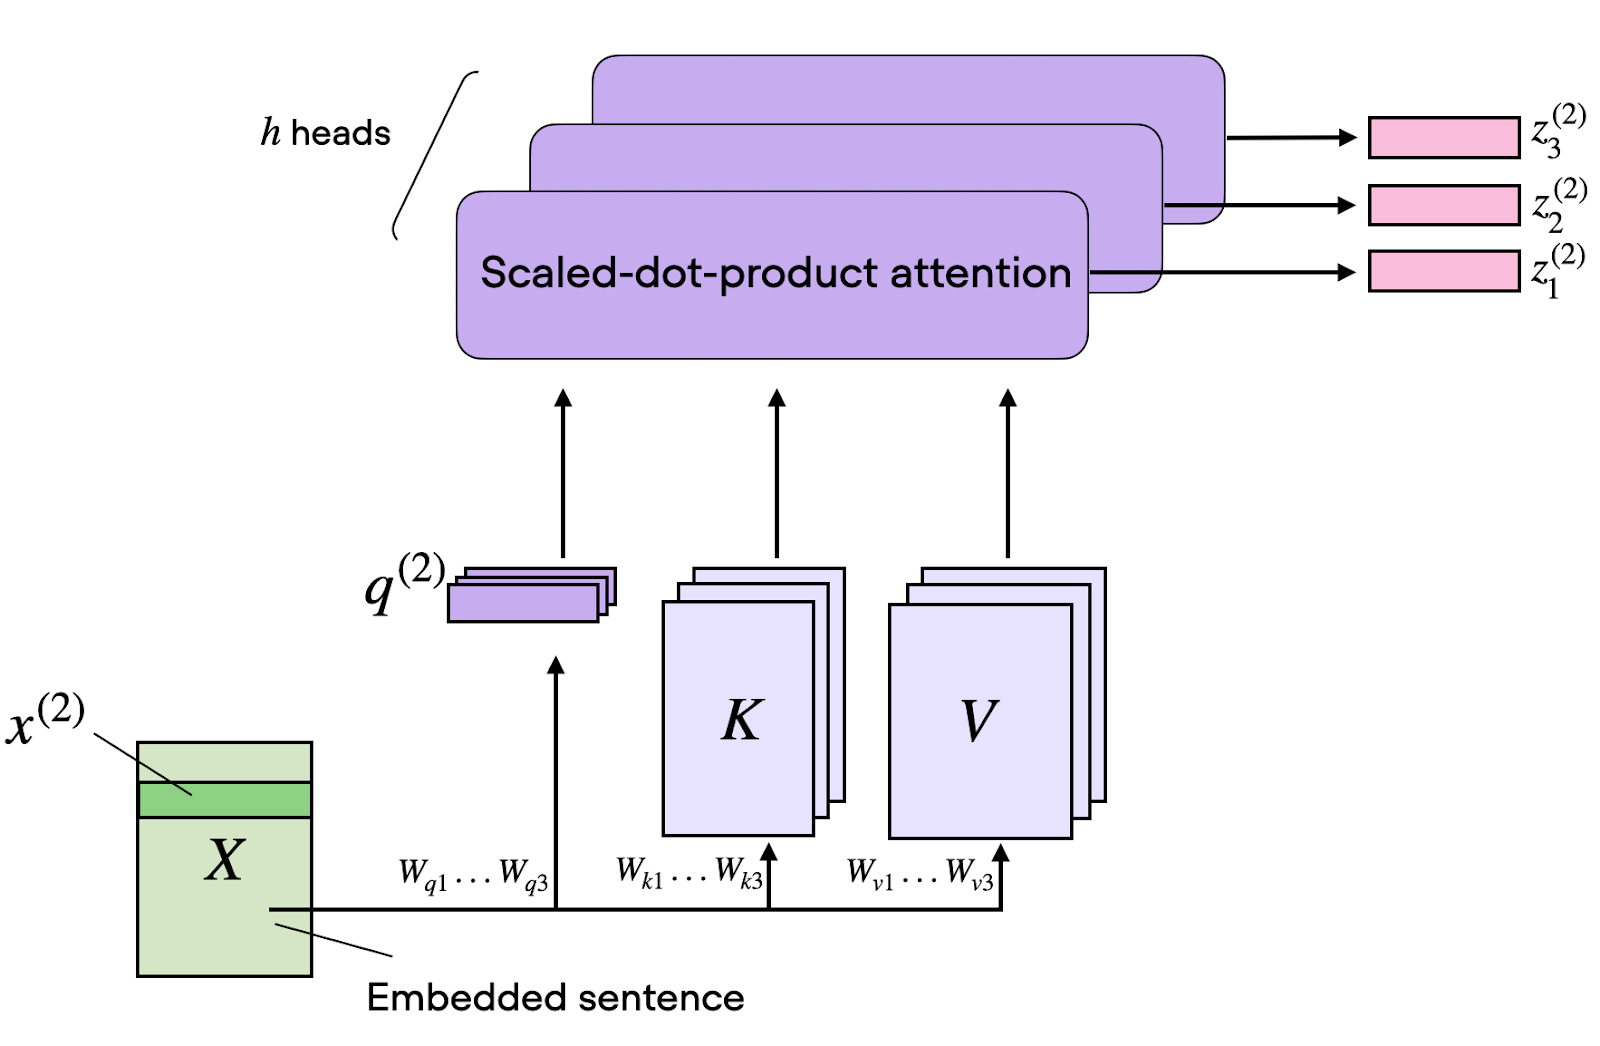
Multi-head attention mengatasinya dengan menjalankan beberapa perhitungan attention secara paralel, masing-masing berfokus pada aspek berbeda dari hubungan input. Misalnya, mungkin ada satu head yang mengkhususkan diri dalam:
Dari yang saya amati saat bekerja dengan model-model ini, spesialisasi ini sering muncul secara organik selama pelatihan. Anda tidak merancangnya, dan menurut saya ini salah satu aspek paling menarik dari keseluruhan mekanisme.
Implementasinya melibatkan pemisahan matriks Q, K, dan V sepanjang sumbu dimensi, memproses setiap bagian melalui head attention terpisah, lalu menggabungkan hasilnya.
Jika kita memiliki 8 head dan embedding 512 dimensi, setiap head beroperasi pada subruang berdimensi 64. Pemrosesan paralel ini tidak meningkatkan kompleksitas panjang urutan, tetapi melipatgandakan kapasitas model untuk mempelajari pola yang beragam.
Riset tentang apa yang sebenarnya dipelajari head-head attention yang berbeda mengungkap pola-pola menarik.
Dalam model penerjemahan, beberapa head secara konsisten memperhatikan hubungan posisional, berfokus pada kata-kata yang berdekatan terlepas dari isinya. Head lain mengkhususkan diri pada peran sintaksis, mengidentifikasi hubungan subjek-verba atau verba-objek. Kategori ketiga memperhatikan token langka atau berinformasi tinggi seperti nama diri dan istilah teknis.
Menariknya, studi interpretabilitas menunjukkan banyak head tampak redundan, dan model dapat mempertahankan kinerja meski sebagian besar head dipangkas. Redundansi ini kemungkinan berkontribusi pada ketangguhan, memastikan pola kritis memiliki banyak jalur melalui jaringan.
Dalam attention encoder-decoder, head di lapisan decoder yang lebih akhir terbukti paling esensial untuk kualitas terjemahan, sementara head self-attention encoder sering kali dapat dikurangi secara signifikan.
Dengan landasan matematika yang sudah dibahas, mari kita lihat bagaimana self-attention terintegrasi ke dalam arsitektur transformer yang lengkap.
Dalam encoder transformer, lapisan self-attention memungkinkan setiap posisi memperhatikan setiap posisi lain dalam urutan input. Pola "semua-ke-semua" ini memungkinkan aliran konteks dua arah, di mana setiap token membangun representasi yang diinformasikan oleh seluruh urutan.
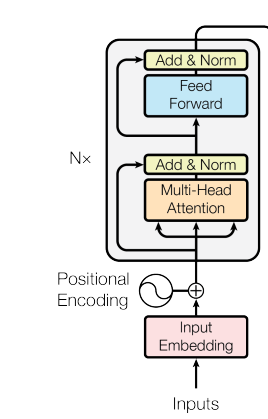
Arsitektur encoder
Setiap lapisan encoder menggabungkan multi-head self-attention dengan jaringan feed-forward berbasis posisi. Jaringan feed-forward memproses setiap posisi secara independen namun identik, menerapkan transformasi terpelajar yang sama ke semua token.
Koneksi residual dan normalisasi lapisan mengelilingi kedua sub-lapisan, menstabilkan gradien dan memungkinkan arsitektur yang lebih dalam. Menumpuk beberapa lapisan encoder menciptakan representasi yang semakin abstrak, dengan lapisan awal menangkap pola permukaan dan lapisan lebih dalam mengenkode hubungan semantik.
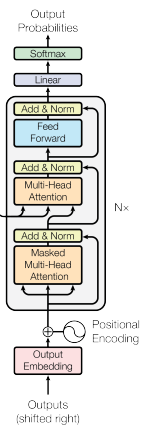
Decoder memodifikasi self-attention agar mematuhi batasan autoregresif. Saat menghasilkan teks, model hanya dapat bergantung pada token yang telah dihasilkannya. Mengintip token masa depan saat pelatihan akan dianggap curang.
Arsitektur decoder
Masked self-attention mewujudkannya dengan menetapkan bobot attention ke minus tak-hingga (yang menjadi nol setelah softmax) untuk semua posisi setelah posisi saat ini.
Ini memastikan bahwa prediksi hanya bergantung pada konteks sebelumnya, dan ketertiban kausal yang diperlukan untuk tugas generatif tetap terjaga. Selama inferensi, kausalitas ini terasa alami: kita memang belum memiliki token masa depan untuk diperhatikan.
Di antara lapisan self-attention decoder terdapat cross-attention, yang memungkinkan decoder berkondisi pada keluaran encoder. Di sini, query berasal dari decoder (mewakili "apa yang perlu saya hasilkan"), sementara key dan value berasal dari encoder (mewakili "apa yang disediakan input").
Arsitektur transformer
Mekanisme cross-attention ini penting untuk tugas urutan-ke-urutan seperti penerjemahan, di mana decoder harus menyelaraskan kata keluaran dengan kata input yang relevan. Berbeda dengan self-attention, cross-attention menciptakan dependensi antara dua urutan berbeda, memungkinkan informasi mengalir dari sumber ke target.
Terlepas dari teori, apa yang sebenarnya dimungkinkan self-attention dalam praktik? Jawabannya lebih luas daripada yang diperkirakan kebanyakan orang.
Setelah menelusuri cara kerja self-attention dalam arsitektur transformer, mari lihat di mana mekanisme ini memberikan dampak nyata di dunia nyata.
Yang membuat self-attention sangat berharga adalah sifatnya yang agnostik domain. Kerangka matematika yang sama yang membantu model memahami hubungan bahasa juga dapat menangkap pola dalam gambar, audio, dan bahkan kombinasi berbagai jenis data.
Menurut saya, kualitas agnostik domain inilah yang membuat self-attention benar-benar menarik. Saya berpendapat ini bukan sekadar alat NLP, melainkan mekanisme pembelajaran hubungan yang serbaguna.
Model transformer unggul dalam menangkap dependensi jarak jauh yang terlewatkan arsitektur sebelumnya. Dalam NLP, self-attention menjadi motor penggerak model terobosan di hampir setiap tugas.
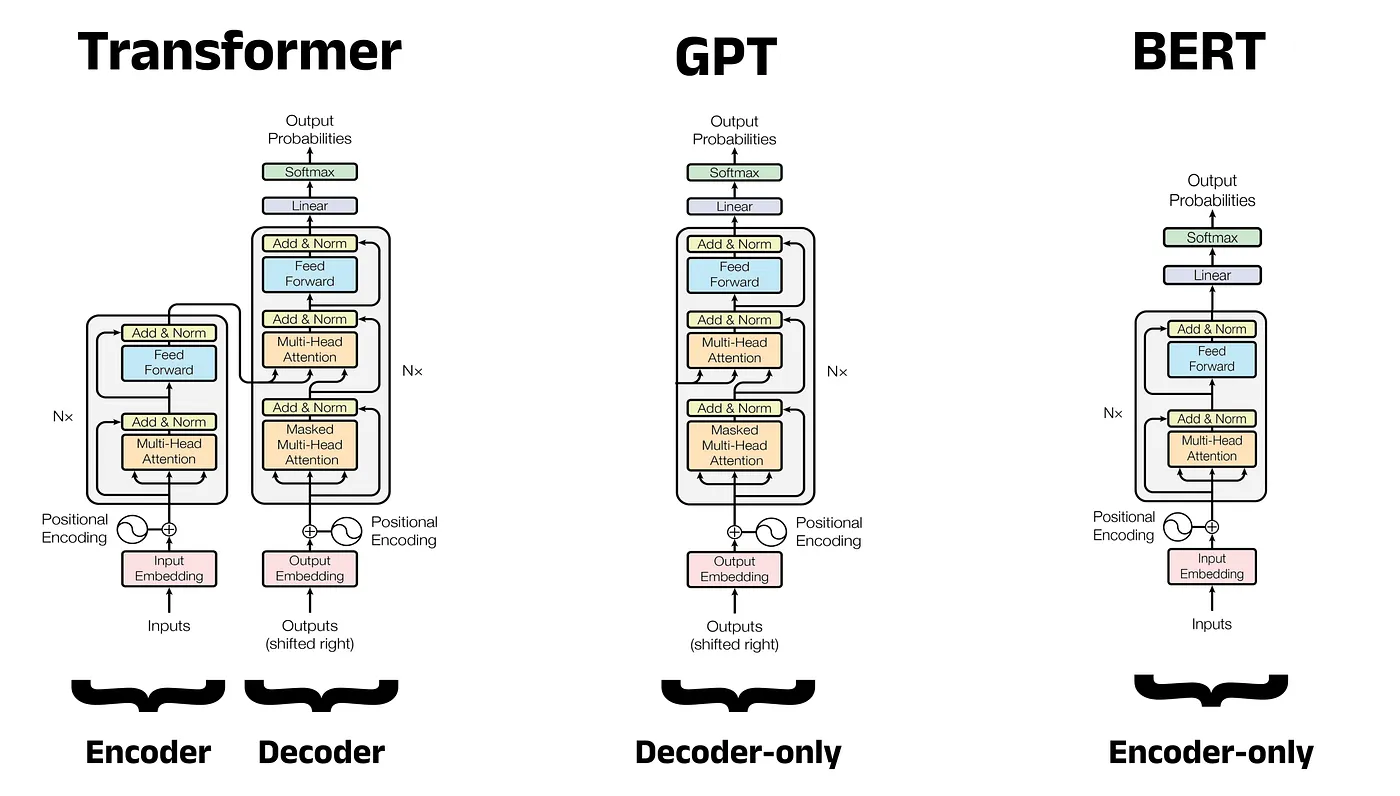
Seperti terlihat pada gambar di bawah, arsitektur model berbeda bergantung pada apakah fokusnya pada decoder atau encoder.
Perbandingan arsitektur: Transformer vs. GPT vs. BERT
Model seperti BERT menggunakan self-attention dua arah dalam arsitektur yang hanya encoder, memungkinkannya membangun representasi kontekstual yang kaya untuk tugas klasifikasi dan pemahaman.
Model GPT seperti GPT-5.3 Codex yang baru dirilis menggunakan masked self-attention dalam desain yang hanya decoder, mencapai kemampuan generasi teks yang luar biasa.
T5 menggunakan arsitektur transformer encoder-decoder penuh, memperlakukan semua tugas NLP sebagai masalah teks-ke-teks.
Adaptasi Vision Transformer (ViT) membawa self-attention ke visi komputer dengan memperlakukan gambar sebagai urutan patch. Alih-alih memproses piksel melalui lapisan konvolusional, ViT membagi gambar menjadi patch berukuran tetap (biasanya 16×16), meratakan setiap patch menjadi vektor, dan memproses urutan tersebut melalui lapisan transformer.
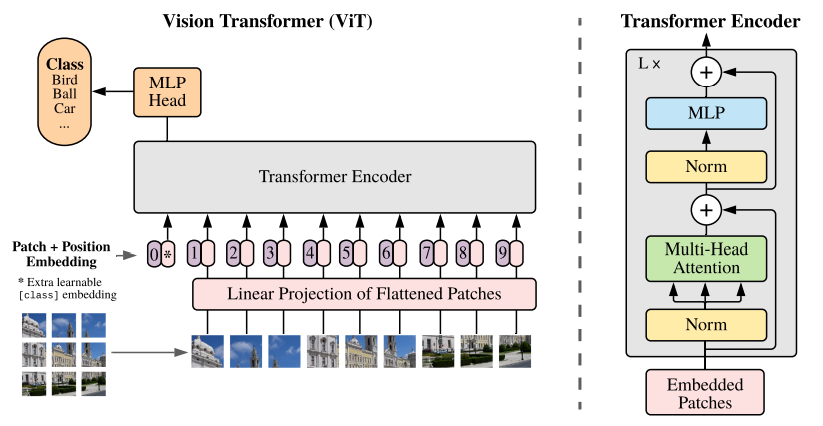
Pendekatan ini menangkap hubungan global yang mungkin terlewat oleh bidang reseptif lokal jaringan konvolusional. ViT dan variannya kini mencapai hasil state-of-the-art dalam klasifikasi gambar, deteksi objek, segmentasi semantik, dan bidang lainnya:
Kegunaan self-attention meluas ke pemrosesan ujaran, di mana ia menangkap dependensi temporal dalam urutan audio lebih efektif daripada model rekuren. Dalam rekomendasi, self-attention membantu memodelkan pola preferensi pengguna dengan memperhatikan interaksi historis yang relevan.
Mungkin yang paling menarik adalah aplikasi multimodal yang menggabungkan visi dan bahasa. Model seperti CLIP menggunakan cross-attention antara representasi gambar dan teks, memungkinkan klasifikasi gambar zero-shot dan pembuatan gambar dari deskripsi teks.
Kesamaan semua sistem ini: mereka menunjukkan kapabilitas fundamental self-attention untuk mempelajari hubungan antara data berurutan atau terstruktur apa pun, terlepas dari modalitas.
Meskipun self-attention sangat berhasil di berbagai domain, tantangan baru muncul saat menerapkan model transformer dalam skala besar. Seiring model tumbuh hingga miliaran parameter dan memproses konteks yang membentang hingga ratusan ribu token, bandwidth memori dan biaya komputasi menjadi hambatan kritis.
Fokus pengembangan model baru semakin mengarah pada membuat self-attention lebih cepat dan efisien tanpa mengorbankan kapabilitas intinya. Saya melihat ketegangan antara kapabilitas dan efisiensi ini sebagai salah satu masalah terbuka paling menarik di bidang ini saat ini. Mari kita lihat beberapa perkembangan terkini.
Multi-head attention standar mempertahankan proyeksi key dan value terpisah untuk setiap head, menciptakan beban memori besar saat inferensi. Multi-query attention (MQA) menguranginya dengan membagi satu head key-value (KV) untuk semua head query, secara drastis mengurangi ukuran cache KV dan mempercepat decoding. Namun, MQA dapat menurunkan kualitas.
Grouped-query attention (GQA) adalah pendekatan yang lebih seimbang, membagi head query menjadi kelompok yang berbagi pasangan key-value. Dengan 32 head query dan 8 grup, setiap grup berisi 4 query yang berbagi satu head key-value. Misalnya, keluarga model Mistral 3 menggunakan pendekatan ini dan mampu mencapai kualitas mendekati full-attention dengan peningkatan kecepatan yang signifikan.
Sementara GQA mengatasi efisiensi memori, lini riset lain menanggulangi hambatan komputasi mendasar attention dari sudut berbeda.
Pekerjaan terbaru mengeksplorasi penggabungan self-attention dengan state-space model untuk meningkatkan efisiensi. Sistem seperti S4 dan Hyena menggunakan state space terstruktur untuk memodelkan dependensi jarak jauh dengan kompleksitas linier alih-alih kuadrat.
Pendekatan ini mengatasi keterbatasan fundamental self-attention: biaya komputasi meningkat kuadrat terhadap panjang urutan, membuat konteks yang sangat panjang menjadi sangat mahal.
Di luar membayangkan ulang arsitekturnya, peneliti juga menemukan cara cerdas untuk mengoptimalkan mekanisme attention yang ada.
Selain perubahan arsitektur, kemajuan terbaru mengoptimalkan attention saat inferensi. Kuantisasi mengurangi presisi cache KV menjadi 8 atau 4 bit, memangkas memori secara drastis dengan kehilangan kualitas minimal.
Flash Attention menata ulang pengakses memori GPU untuk meminimalkan perpindahan data, mencapai percepatan 2–3×. Optimisasi komputasi saat pengujian, di mana model melakukan beberapa pass selama generasi, menunjukkan bahwa penerapan attention yang strategis dapat menghasilkan hasil lebih baik ketimbang sekadar memperbesar ukuran model.
Self-attention adalah salah satu mekanisme paling transformatif dalam sejarah pembelajaran mesin. Dengan memungkinkan model secara dinamis menentukan elemen mana dari input yang layak menjadi fokus, mekanisme ini memecahkan tantangan lama dalam menangkap dependensi jarak jauh dan memproses urutan secara efisien.
Keanggunan matematis scaled dot-product attention, yang ditingkatkan melalui arsitektur multi-head, memberikan landasan teoritis sekaligus efektivitas praktis.
Dari menggerakkan model bahasa tercanggih hingga merevolusi visi komputer dan memampukan sistem AI multimodal, self-attention terus memperluas jangkauannya. Inovasi terbaru dalam grouped-query attention, arsitektur hibrida, dan optimisasi inferensi menunjukkan bahwa kita masih menemukan cara untuk membuat mekanisme ini lebih efisien dan kapabel.
Jika Anda ingin mendalami semua detail dan berlatih langsung, saya merekomendasikan mendaftar ke jalur keahlian Developing Large Language Models kami.
Kursus LLM
Kursus
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




