Cuối năm 2017, một bài báo nghiên cứu có tiêu đề Attention Is All You Need đã giới thiệu một cơ chế mang tính cách mạng, làm thay đổi căn bản trí tuệ nhân tạo. Trọng tâm của bước đột phá này là self-attention, một ý tưởng đơn giản nhưng mạnh mẽ cho phép mô hình hiểu các mối quan hệ trong dữ liệu bằng cách xác định những thành phần nào xứng đáng được tập trung.
Ngày nay, self-attention là động lực phía sau mọi thứ, từ khả năng đối thoại của ChatGPT đến các hệ thống nhận diện hình ảnh tiên tiến. Đây chắc chắn là một trong những đổi mới có sức biến đổi lớn nhất trong lịch sử học máy.
Trong hướng dẫn này, tôi sẽ dẫn bạn đi từ nền tảng khái niệm đến các ứng dụng của self-attention, chỉ ra cách cơ chế này giúp mô hình nắm bắt các phụ thuộc tầm xa và xử lý thông tin song song — những năng lực trước đây các mạng nơ-ron truyền thống không thể đạt được.
Nếu bạn mới làm quen với transformers, hãy cân nhắc tham gia một trong các khóa nhập môn của chúng tôi về Khái niệm về Mô hình Ngôn ngữ Lớn (LLMs) và Mô hình Transformer với PyTorch.
Self-Attention là gì?
Theo kinh nghiệm giảng dạy của tôi, điểm khởi đầu tốt nhất là một thách thức cơ bản trong xử lý chuỗi: làm thế nào để một mô hình xác định phần nào của đầu vào là liên quan nhất tại một thời điểm bất kỳ?
Hãy bắt đầu với trực giác trước khi đi vào phần toán học.
Hiểu self-attention ở mức khái niệm
Self-attention là một cơ chế gán trọng số tầm quan trọng cho các phần tử khác nhau trong một chuỗi tương quan với nhau. Khi xử lý câu "The animal didn't cross the road because it was too tired," self-attention giúp mô hình hiểu rằng "it" ám chỉ "animal" chứ không phải "road", tức một mối quan hệ trải qua nhiều từ.
Đây thực sự là ví dụ tôi luôn dùng khi giới thiệu khái niệm cho học viên. Nó lập tức tạo sự liên kết vì phản chiếu cách chúng ta đọc tự nhiên.
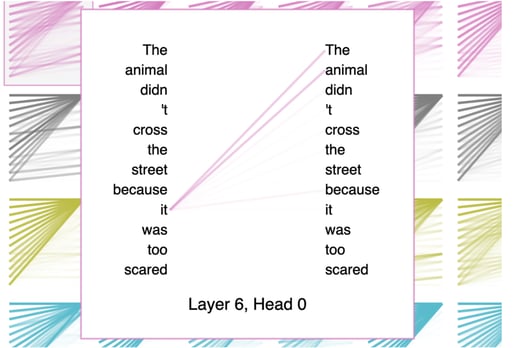
Cơ chế Attention
Điều làm self-attention đặc biệt mạnh mẽ là khả năng tính toán các mối quan hệ này cho mọi vị trí trong chuỗi đồng thời. Không giống mạng nơ-ron hồi quy xử lý tuần tự từng bước, self-attention xem xét mọi phần tử trong tương quan với mọi phần tử khác chỉ trong một lượt lan truyền xuôi.
Việc tính toán song song này giúp giảm đáng kể thời gian huấn luyện đồng thời nắm bắt các phụ thuộc bất kể khoảng cách trong chuỗi.
Cần phân biệt self-attention với các cơ chế liên quan. Trong self-attention, một chuỗi tập trung vào chính nó. Mỗi phần tử truy vấn thông tin từ mọi vị trí trong cùng chuỗi.
Cross-attention thì ngược lại, cho phép một chuỗi tập trung vào chuỗi khác, như khi decoder tập trung vào đầu ra của encoder trong dịch máy.
Masked self-attention bổ sung một ràng buộc: ngăn các vị trí chú ý đến những vị trí phía sau, đảm bảo dự đoán chỉ phụ thuộc vào các đầu ra đã biết — điều cốt yếu cho sinh văn bản tự hồi quy.
Nhưng ý tưởng này thực sự đến từ đâu và được thiết kế để giải quyết những vấn đề gì?
Nguồn gốc và động lực của self-attention
Trước khi self-attention xuất hiện, lĩnh vực này phải vật lộn với những hạn chế lớn trong mô hình hóa chuỗi.
Các mạng nơ-ron hồi quy, bao gồm LSTM và GRU, xử lý chuỗi theo trình tự, tạo ra một nút thắt cổ chai cơ bản: chúng gặp khó với các phụ thuộc tầm xa vì thông tin phải đi qua nhiều trạng thái trung gian, dẫn đến độ dốc biến mất và ngữ cảnh bị lãng quên.
Sự phát triển hướng tới self-attention bắt đầu với các cơ chế attention trong kiến trúc encoder–decoder dựa trên RNN. Năm 2014, Bahdanau và cộng sự đã giới thiệu cơ chế attention cho phép decoder truy cập tất cả các trạng thái ẩn của encoder thay vì dựa vào một vector ngữ cảnh có độ dài cố định duy nhất.
Đột phá này giải quyết vấn đề nén thông tin, khi các chuỗi đầu vào có độ dài biến thiên bị ép vào các biểu diễn độ dài cố định bất kể độ phức tạp của chúng.
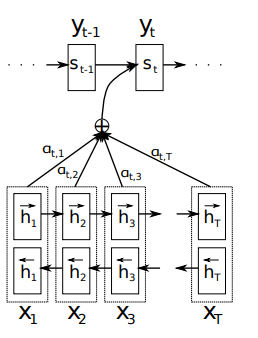
Minh họa đồ họa mô hình được đề xuất của Bahdanau
Một năm sau, Luong đề xuất các cơ chế attention giản lược, gồm cả phương pháp tích vô hướng có tỉ lệ, sau này ảnh hưởng đến thiết kế transformer. Dù các cơ chế attention ban đầu này cải thiện hiệu năng, chúng vẫn phụ thuộc vào quá trình xử lý tuần tự của RNN.
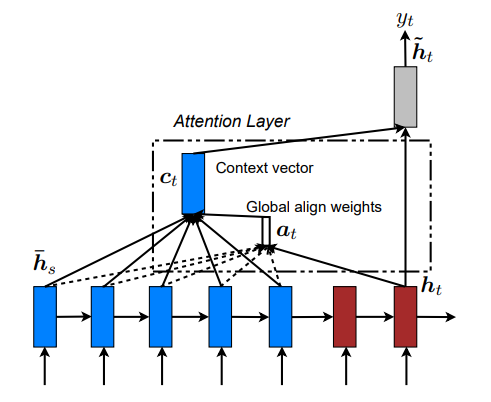
Mô hình attention toàn cục (Luong)
Cuộc cách mạng thực sự bắt đầu khi các nhà nghiên cứu đặt câu hỏi: Điều gì xảy ra nếu ta loại bỏ tính hồi quy và chỉ dựa vào attention? Câu hỏi này dẫn tới kiến trúc transformer, nơi self-attention trở thành cơ chế chủ đạo để hiểu các quan hệ tuần tự.
Khung toán học của Self-Attention
Giờ đây khi đã xác lập tầm quan trọng của self-attention, hãy xem nó vận hành ở cấp độ toán học như thế nào.
Biểu diễn query, key và value
Self-attention biến đổi chuỗi đầu vào qua ba phép chiếu học được: query, key và value. Hãy xem chúng như các "góc nhìn" khác nhau của cùng một thông tin, mỗi loại phục vụ một mục đích riêng trong phép tính attention.
Với chuỗi đầu vào có chiều nhúng d_model, ta tạo ba ma trận trọng số: W_Q, W_K và W_V. Khi nhân ma trận đầu vào X với các trọng số này, ta thu được:
-
Ma trận Query Q = X · W_Q: đại diện cho "tôi đang tìm gì"
-
Ma trận Key K = X · W_K: đại diện cho "tôi cung cấp gì"
-
Ma trận Value V = X · W_V: đại diện cho "tôi thực sự chứa gì"
Tôi thấy phép ẩn dụ thư viện này hữu ích: bạn bước vào với một truy vấn trong đầu, các thẻ mục lục là key của bạn, còn những cuốn sách thực sự là value.
Thông thường, các ma trận này chiếu về chiều nhỏ hơn d_k (thường là d_model chia cho số đầu attention), giúp quản lý độ phức tạp tính toán trong khi vẫn duy trì năng lực biểu diễn. Giảm chiều này đặc biệt quan trọng khi mở rộng tới các chuỗi dài hơn.
Khi đã có Q, K và V, ta có thể tính attention.
Attention tích vô hướng có tỉ lệ
Bản thân phép tính attention tuân theo một công thức tao nhã. Trước hết, ta tính điểm attention bằng tích vô hướng giữa query và key. Phép toán này đo mức độ tương thích giữa điều mỗi vị trí đang tìm kiếm và điều mọi vị trí khác cung cấp.
Tuy nhiên, khi chiều không gian tăng, các tích vô hướng này có thể trở nên rất lớn, đẩy hàm softmax vào vùng có độ dốc cực nhỏ. Để tránh bất ổn số học này, ta chia cho căn bậc hai của chiều key để thu nhỏ.
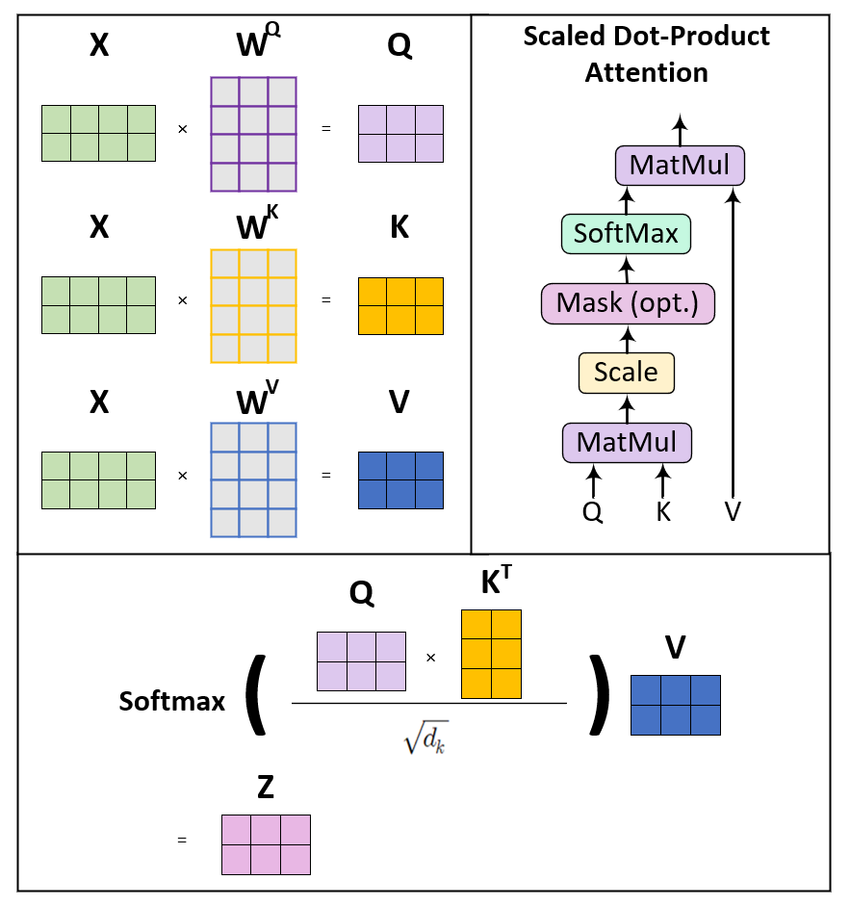
Attention tích vô hướng có tỉ lệ
Hệ số tỉ lệ này duy trì phương sai phù hợp trong toàn mạng, đảm bảo độ dốc ổn định khi huấn luyện. Nếu không có nó, các mô hình với nhúng chiều cao sẽ khó học hiệu quả, vì softmax sẽ cho ra phân phối gần như one-hot, không phân bổ attention một cách có ý nghĩa.
Trước khi tiếp tục, có một khoảng trống quan trọng cần xử lý: Mã hóa vị trí.
Mã hóa vị trí
Điều khiến tôi ngạc nhiên nhất khi lần đầu nghiên cứu: self-attention hoàn toàn bất biến theo hoán vị. Xáo trộn các token đầu vào, bạn sẽ nhận cùng một đầu ra — chỉ là bị xáo trộn tương ứng.
Tôi phải mất một lúc để thấm hàm ý: cơ chế này mạnh mẽ nhưng về bản chất mù với trật tự. Với các nhiệm vụ mà thứ tự quan trọng (như hiểu ngôn ngữ), ta cần đưa thông tin vị trí một cách tường minh.
Transformer gốc dùng mã hóa vị trí hình sin, áp dụng các hàm sin và cos với tần số khác nhau cho từng chiều. Lựa chọn này không hề ngẫu nhiên. Dạng sóng cho phép mô hình học cách chú ý tới vị trí tương đối, và phần mã hóa này mở rộng tự nhiên tới các độ dài chuỗi chưa thấy trước đó.
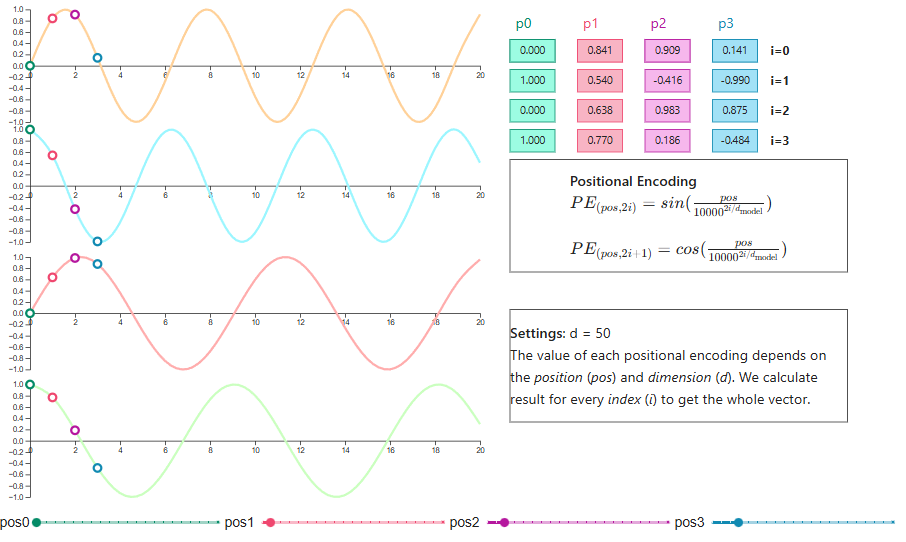
Minh họa mã hóa vị trí
Những đổi mới gần đây gồm RoPE (Rotary Position Embedding), xoay các vector query và key trong không gian đa chiều theo góc tỷ lệ với vị trí của chúng. Sau khi xoay, tích vô hướng giữa query và key tự nhiên mã hóa khoảng cách tương đối.
RoPE đã được áp dụng rộng rãi trong các mô hình như LLaMA vì khả năng ngoại suy mạnh.
Một cách tiếp cận khác, ALiBi (Attention with Linear Biases), đi theo hướng thêm trực tiếp các hình phạt phụ thuộc vị trí vào điểm attention. Thay vì sửa đổi nhúng, ALiBi làm lệch trọng số attention để ưu tiên các token gần, với cường độ độ lệch thay đổi giữa các đầu attention khác nhau.
Phương pháp này cho thấy khả năng ngoại suy ấn tượng tới độ dài chuỗi vượt xa so với khi huấn luyện.
Softmax và trọng số attention
Sau khi tính điểm attention đã được tỉ lệ, ta áp dụng softmax theo chiều key. Phép chuẩn hóa này biến các điểm thô thành phân phối xác suất, đảm bảo tổng trọng số attention bằng một cho mỗi vị trí query.
Hàm softmax làm nổi bật những mối quan hệ có điểm cao nhất đồng thời triệt tiêu các kết nối không liên quan. Tuy nhiên, đôi khi điều này dẫn tới phân phối quá nhọn, đặc biệt ở giai đoạn đầu huấn luyện khi mô hình chưa học được các mẫu attention tinh tế.
Để giảm thiểu, người thực hành thường áp dụng dropout lên trọng số attention, ngẫu nhiên đưa một số kết nối về 0 để tăng độ bền vững.
Tính vector ngữ cảnh
Khi đã có trọng số attention, ta tính đầu ra cuối cùng như tổng có trọng số của các vector value.
Mỗi vị trí nhận một biểu diễn nhận thức ngữ cảnh, tổng hợp thông tin từ toàn bộ chuỗi, với mức đóng góp tỷ lệ với trọng số attention. Sự kết hợp có trọng số này cho phép thông tin luân chuyển linh hoạt dựa trên các mối quan hệ được học thay vì các khuôn mẫu cố định.
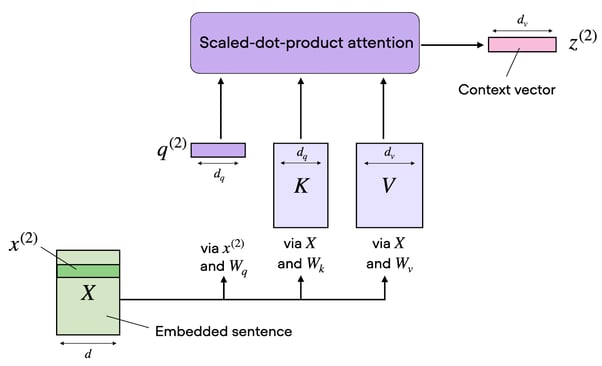
Tính toán vector ngữ cảnh
Attention một đầu mang lại kết quả đáng ngạc nhiên, nhưng vẫn có trần. Đây là lúc mọi thứ trở nên thú vị hơn.
Multi-Head Attention và các không gian biểu diễn con
Dù attention một đầu rất mạnh, nó có một hạn chế cơ bản: chỉ có thể nắm bắt một kiểu quan hệ tại một thời điểm.
Động lực và kiến trúc
Multi-head attention khắc phục điều này bằng cách chạy song song nhiều phép tính attention, mỗi phép tập trung vào những khía cạnh khác nhau của các mối quan hệ đầu vào. Chẳng hạn, có thể có mỗi đầu chuyên về:
- Các phụ thuộc cú pháp cục bộ
- Các quan hệ ngữ nghĩa tầm xa
- Các mẫu về vị trí
Qua quan sát khi làm việc với các mô hình này, sự chuyên biệt thường nảy sinh một cách tự nhiên trong quá trình huấn luyện. Bạn không cần thiết kế nó, và tôi cho rằng đó là một trong những khía cạnh hấp dẫn nhất của toàn bộ cơ chế.
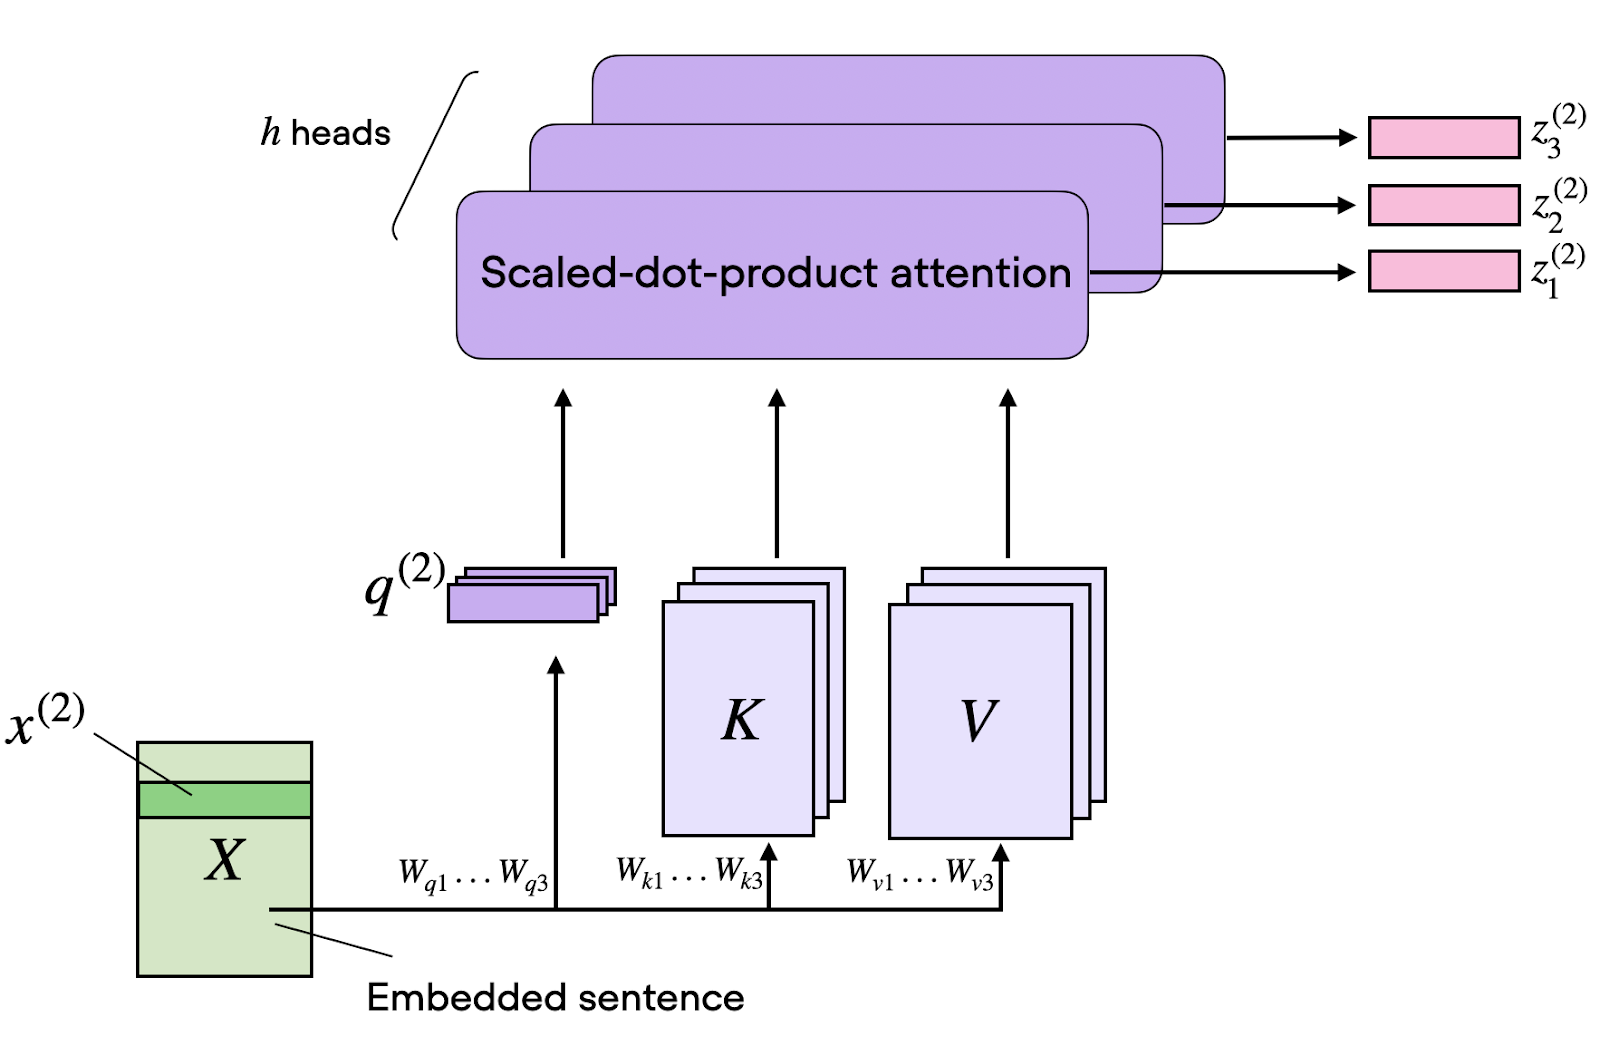
Multi-head attention
Việc hiện thực bao gồm tách các ma trận Q, K và V theo trục chiều, xử lý mỗi phần tách qua các đầu attention riêng biệt và ghép nối kết quả lại.
Nếu có 8 đầu và nhúng 512 chiều, mỗi đầu làm việc trên không gian con 64 chiều. Xử lý song song này không làm tăng độ phức tạp theo độ dài chuỗi nhưng nhân lên năng lực của mô hình trong việc học các mẫu đa dạng.
Các đầu khác nhau học gì
Nghiên cứu về những gì các đầu attention khác nhau thực sự học được đã hé lộ các mẫu thú vị.
Trong các mô hình dịch, một số đầu nhất quán chú ý tới quan hệ vị trí, tập trung vào từ lân cận bất kể nội dung. Các đầu khác chuyên về vai trò cú pháp, xác định quan hệ chủ ngữ–động từ hay động từ–tân ngữ. Một nhóm thứ ba chú ý tới các token hiếm hoặc giàu thông tin như danh từ riêng và thuật ngữ kỹ thuật.
Thú vị là, các nghiên cứu khả giải cho thấy nhiều đầu dường như dư thừa, và mô hình vẫn giữ được hiệu năng ngay cả khi cắt bớt một phần đáng kể số đầu. Sự dư thừa này có lẽ góp phần vào độ bền vững, đảm bảo các mẫu quan trọng có nhiều con đường xuyên suốt mạng.
Trong attention encoder–decoder, các đầu ở những lớp decoder muộn tỏ ra thiết yếu nhất cho chất lượng dịch, trong khi các đầu self-attention của encoder thường có thể giảm bớt đáng kể.
Khi đã nắm nền tảng toán học, hãy xem self-attention được tích hợp vào kiến trúc transformer hoàn chỉnh như thế nào.
Encoder: attention mọi–với–mọi
Trong encoder của transformer, các lớp self-attention cho phép mỗi vị trí chú ý tới mọi vị trí khác trong chuỗi đầu vào. Mẫu "mọi–với–mọi" này cho phép dòng chảy ngữ cảnh hai chiều, nơi mỗi token xây dựng một biểu diễn được thông tin bởi toàn bộ chuỗi.
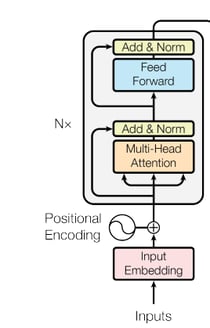
Kiến trúc Encoder
Mỗi lớp encoder kết hợp multi-head self-attention với mạng feed-forward theo vị trí. Mạng feed-forward xử lý từng vị trí một cách độc lập nhưng giống hệt nhau, áp dụng cùng một biến đổi học được cho tất cả token.
Các kết nối hồi tiếp (residual) và chuẩn hóa lớp bao quanh cả hai tầng con, ổn định độ dốc và cho phép kiến trúc sâu hơn. Xếp chồng nhiều lớp encoder tạo ra các biểu diễn ngày càng trừu tượng, với các lớp đầu nắm bắt mẫu bề mặt và các lớp sâu mã hóa quan hệ ngữ nghĩa.
Decoder: attention có mặt nạ và tính nhân quả
Decoder điều chỉnh self-attention để tôn trọng ràng buộc tự hồi quy. Khi sinh văn bản, mô hình chỉ có thể dựa vào các token đã tạo. Nhìn lén các token tương lai sẽ là gian lận trong huấn luyện.
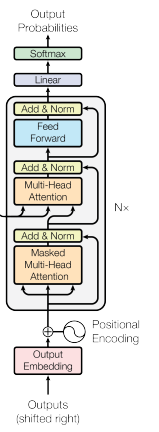
Kiến trúc Decoder
Masked self-attention thực hiện điều này bằng cách đặt trọng số attention về âm vô cùng (sau softmax trở thành 0) cho tất cả các vị trí sau vị trí hiện tại.
Điều này đảm bảo dự đoán chỉ phụ thuộc vào ngữ cảnh trước đó, duy trì trật tự nhân quả cần thiết cho các nhiệm vụ sinh. Trong suy luận, tính nhân quả này trở nên tự nhiên: đơn giản là ta chưa có các token tương lai để chú ý tới.
Cross-attention: kết nối encoder và decoder
Giữa các lớp self-attention của decoder là cross-attention, cho phép decoder điều kiện hóa theo đầu ra của encoder. Ở đây, query đến từ decoder (đại diện cho "tôi cần tạo gì"), còn key và value đến từ encoder (đại diện cho "đầu vào cung cấp gì").
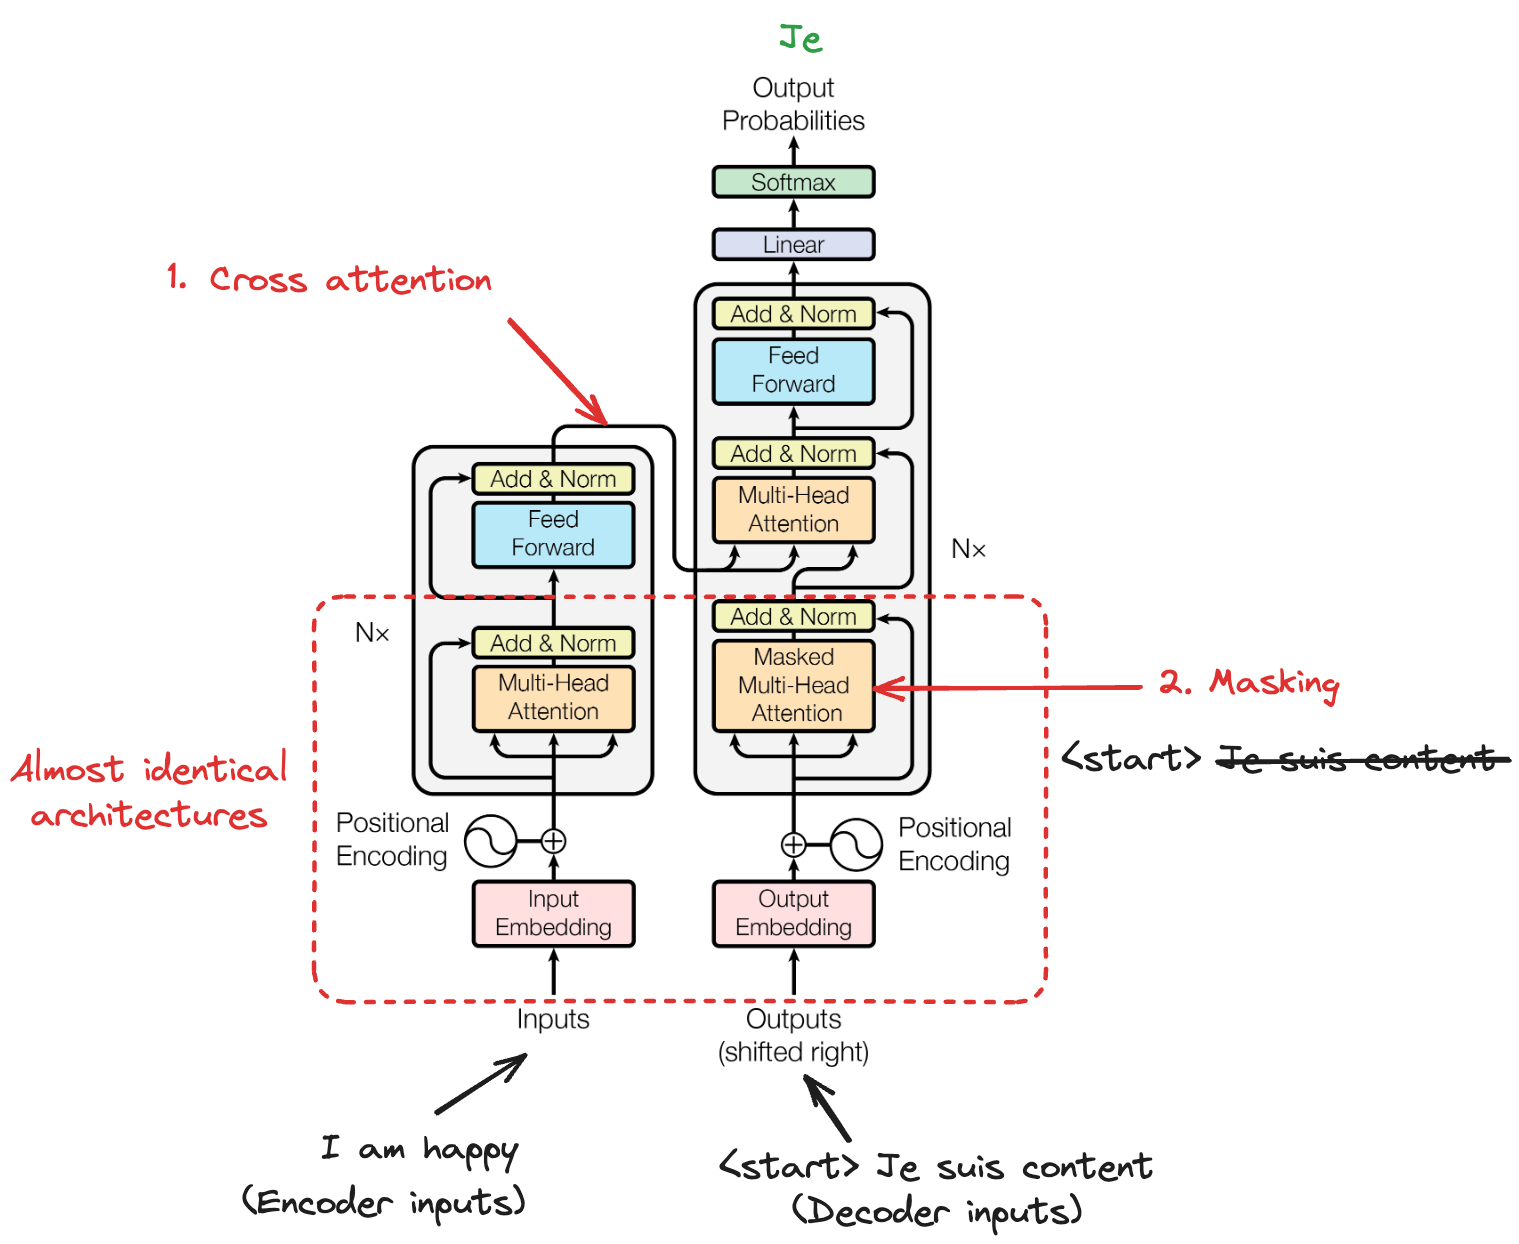
Kiến trúc Transformer
Cơ chế cross-attention này là thiết yếu cho các bài toán chuỗi–sang–chuỗi như dịch, nơi decoder phải căn chỉnh từ đầu ra với các từ đầu vào liên quan. Không giống self-attention, cross-attention tạo phụ thuộc giữa hai chuỗi khác nhau, cho phép thông tin chảy từ nguồn sang đích.
Bỏ qua lý thuyết, self-attention thực sự đã cho phép những gì trong thực tiễn? Câu trả lời rộng hơn nhiều người nghĩ.
Ứng dụng của Self-Attention trên nhiều lĩnh vực
Sau khi khám phá cách self-attention hoạt động trong kiến trúc transformer, hãy xem cơ chế này đã tạo tác động trong thế giới thực ở đâu.
Điều khiến self-attention đặc biệt hữu dụng là tính phi miền của nó. Cùng một khung toán học giúp mô hình hiểu các quan hệ ngôn ngữ cũng có thể nắm bắt mẫu trong hình ảnh, âm thanh và thậm chí là sự kết hợp các kiểu dữ liệu khác nhau.
Theo quan điểm của tôi, chính phẩm chất phi miền này làm self-attention thực sự đáng hứng thú. Tôi cho rằng nó ít là công cụ NLP, mà là một cơ chế học quan hệ dùng chung.
Ứng dụng trong xử lý ngôn ngữ tự nhiên
Các mô hình Transformer xuất sắc trong việc nắm bắt các phụ thuộc tầm xa mà các kiến trúc trước đó bỏ lỡ. Trong NLP, self-attention thúc đẩy hàng loạt mô hình đột phá hầu như ở mọi tác vụ.
- Dịch máy: Căn chỉnh cụm từ nguồn và đích bất kể khoảng cách
- Phân tích cảm xúc: nhận diện các tín hiệu ngữ cảnh làm thay đổi nghĩa
- Hỏi đáp: Kết nối câu hỏi với các đoạn văn liên quan, ngay cả khi cách xa nhau nhiều token.
Như bạn có thể thấy trong hình dưới đây, kiến trúc của các mô hình khác nhau tùy theo trọng tâm là decoder hay encoder.
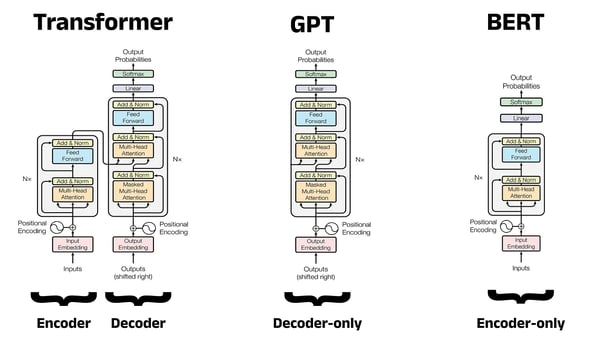
So sánh kiến trúc: Transformer vs. GPT vs. BERT
Các mô hình như BERT dùng self-attention hai chiều trong kiến trúc chỉ encoder, cho phép xây dựng các biểu diễn theo ngữ cảnh phong phú cho các nhiệm vụ phân loại và hiểu.
Các mô hình GPT như GPT-5.3 Codex mới phát hành dùng masked self-attention trong thiết kế chỉ decoder, đạt khả năng sinh văn bản ấn tượng.
T5 sử dụng đầy đủ kiến trúc transformer encoder–decoder, xem mọi tác vụ NLP như bài toán văn bản–sang–văn bản.
Ứng dụng trong thị giác máy tính
Vision Transformer (ViT) đưa self-attention vào thị giác máy tính bằng cách coi ảnh như chuỗi các ô (patch). Thay vì xử lý điểm ảnh qua các lớp tích chập, ViT chia hình thành các ô cố định (thường 16×16), làm phẳng mỗi ô thành một vector và xử lý chuỗi qua các lớp transformer.
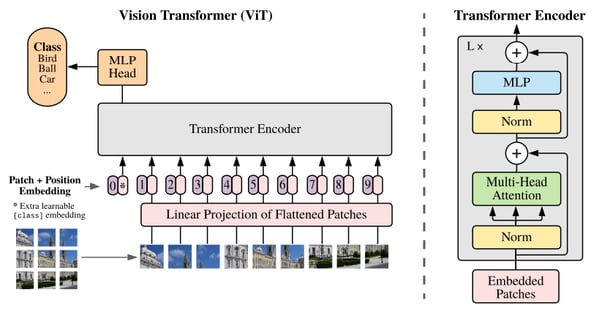
Vision Transformer
Cách tiếp cận này nắm bắt các mối quan hệ toàn cục mà trường tiếp nhận cục bộ của mạng tích chập có thể bỏ lỡ. ViT và các biến thể hiện đạt kết quả hiện đại nhất trong phân loại ảnh, phát hiện vật thể, phân đoạn ngữ nghĩa và các lĩnh vực khác:
- Ảnh y khoa: Liên hệ các bất thường tinh vi trên các vùng khác nhau của ảnh quét.
- Phân tích ảnh vệ tinh: Kết nối các đặc trưng xa nhau như điểm phá rừng với nguyên nhân của chúng.
Tiếng nói, hệ gợi ý và học đa phương thức
Tính hữu dụng của self-attention mở rộng sang xử lý tiếng nói, nơi nó nắm bắt các phụ thuộc theo thời gian trong chuỗi âm thanh hiệu quả hơn các mô hình hồi quy. Trong recommender systems, self-attention giúp mô hình hóa mẫu sở thích người dùng bằng cách chú ý tới các tương tác lịch sử liên quan.
Có lẽ phấn khởi nhất là các ứng dụng đa phương thức kết hợp thị giác và ngôn ngữ. Các mô hình như CLIP dùng cross-attention giữa biểu diễn ảnh và văn bản, cho phép phân loại ảnh zero-shot và sinh ảnh từ mô tả văn bản.
Điểm chung của tất cả các hệ thống này: Chúng cho thấy năng lực cốt lõi của self-attention trong việc học các mối quan hệ giữa bất kỳ dữ liệu tuần tự hay có cấu trúc nào, bất kể phương thức.
Các biến thể Self-Attention nâng cao và phát triển gần đây
Dù self-attention đã thành công đáng kể trên nhiều lĩnh vực, những thách thức mới nảy sinh khi triển khai các mô hình transformer ở quy mô lớn. Khi mô hình tăng lên hàng tỷ tham số và xử lý ngữ cảnh kéo dài tới hàng trăm nghìn token, băng thông bộ nhớ và chi phí tính toán trở thành các nút thắt quan trọng.
Trọng tâm phát triển mô hình mới ngày càng hướng tới việc làm cho self-attention nhanh hơn và hiệu quả hơn mà không đánh đổi các khả năng cốt lõi. Tôi thấy sự căng kéo giữa năng lực và hiệu quả là một trong những bài toán mở thú vị nhất hiện nay. Hãy điểm qua một số tiến triển hiện tại.
Grouped-query và multi-query attention
Attention đa đầu tiêu chuẩn duy trì các phép chiếu key và value riêng cho mỗi đầu, tạo chi phí bộ nhớ đáng kể khi suy luận. Multi-query attention (MQA) giảm chi phí này bằng cách dùng chung một đầu key–value (KV) cho tất cả các đầu query, cắt giảm mạnh kích thước bộ đệm KV và tăng tốc giải mã. Tuy nhiên, MQA có thể làm giảm chất lượng.
Grouped-query attention (GQA) là cách cân bằng hơn, chia các đầu query thành nhóm dùng chung cặp key–value. Với 32 đầu query và 8 nhóm, mỗi nhóm 4 query dùng chung một đầu key–value. Chẳng hạn, họ mô hình Mistral 3 dùng cách này và đạt chất lượng gần như attention đầy đủ với mức tăng tốc đáng kể.
Kiến trúc lai kết hợp attention với mô hình không gian trạng thái
Trong khi GQA giải quyết hiệu quả bộ nhớ, một hướng nghiên cứu khác xử lý nút thắt tính toán cơ bản của attention theo một cách khác.
Các công trình gần đây khám phá việc kết hợp self-attention với mô hình không gian trạng thái để cải thiện hiệu quả. Các hệ thống như S4 và Hyena dùng không gian trạng thái có cấu trúc để mô hình hóa phụ thuộc tầm xa với độ phức tạp tuyến tính thay vì bậc hai.
Những cách tiếp cận này giải quyết hạn chế cơ bản của self-attention: chi phí tính toán tỉ lệ bậc hai theo độ dài chuỗi, khiến ngữ cảnh cực dài trở nên quá tốn kém.
Mở rộng trong thời gian suy luận và tối ưu hóa lúc kiểm thử
Ngoài việc hình dung lại kiến trúc, các nhà nghiên cứu còn tìm ra những cách khéo léo để tối ưu các cơ chế attention hiện có.
Bên cạnh thay đổi kiến trúc, những tiến bộ gần đây tối ưu attention trong khi suy luận. Lượng tử hóa giảm độ chính xác bộ đệm KV xuống 8 hoặc 4 bit, cắt giảm mạnh bộ nhớ với tổn thất chất lượng tối thiểu.
Flash Attention tổ chức lại truy cập bộ nhớ GPU để giảm thiểu di chuyển dữ liệu, đạt tăng tốc 2–3 lần. Tối ưu tính toán khi kiểm thử, nơi mô hình thực hiện nhiều lượt trong quá trình sinh, gợi ý rằng việc áp dụng attention có chiến lược có thể mang lại kết quả tốt hơn so với chỉ đơn thuần tăng kích thước mô hình.
Kết luận
Self-attention là một trong những cơ chế có sức biến đổi lớn nhất trong lịch sử học máy. Bằng cách cho phép mô hình linh hoạt xác định thành phần nào của đầu vào xứng đáng được chú ý, nó đã giải được những thách thức tồn tại lâu dài trong việc nắm bắt các phụ thuộc tầm xa và xử lý chuỗi hiệu quả.
Sự tao nhã toán học của attention tích vô hướng có tỉ lệ, được tăng cường qua kiến trúc đa đầu, mang lại cả cơ sở lý thuyết vững chắc lẫn hiệu quả thực tiễn.
Từ việc cung cấp sức mạnh cho các mô hình ngôn ngữ hiện đ-đại nhất đến cách mạng hóa thị giác máy tính và cho phép các hệ thống AI đa phương thức, self-attention tiếp tục mở rộng tầm với. Những đổi mới gần đây về grouped-query attention, kiến trúc lai và tối ưu suy luận cho thấy chúng ta vẫn đang khám phá cách làm cơ chế này hiệu quả và mạnh mẽ hơn.
Nếu bạn muốn tìm hiểu chi tiết và thực hành trực tiếp, tôi khuyến nghị đăng ký lộ trình kỹ năng Developing Large Language Models của chúng tôi.


Cuối năm 2017, một bài báo nghiên cứu có tiêu đề Attention Is All You Need đã giới thiệu một cơ chế mang tính cách mạng, làm thay đổi căn bản trí tuệ nhân tạo. Trọng tâm của bước đột phá này là self-attention, một ý tưởng đơn giản nhưng mạnh mẽ cho phép mô hình hiểu các mối quan hệ trong dữ liệu bằng cách xác định những thành phần nào xứng đáng được tập trung.
Ngày nay, self-attention là động lực phía sau mọi thứ, từ khả năng đối thoại của ChatGPT đến các hệ thống nhận diện hình ảnh tiên tiến. Đây chắc chắn là một trong những đổi mới có sức biến đổi lớn nhất trong lịch sử học máy.
Trong hướng dẫn này, tôi sẽ dẫn bạn đi từ nền tảng khái niệm đến các ứng dụng của self-attention, chỉ ra cách cơ chế này giúp mô hình nắm bắt các phụ thuộc tầm xa và xử lý thông tin song song — những năng lực trước đây các mạng nơ-ron truyền thống không thể đạt được.
Nếu bạn mới làm quen với transformers, hãy cân nhắc tham gia một trong các khóa nhập môn của chúng tôi về Khái niệm về Mô hình Ngôn ngữ Lớn (LLMs) và Mô hình Transformer với PyTorch.
Self-Attention là gì?
Theo kinh nghiệm giảng dạy của tôi, điểm khởi đầu tốt nhất là một thách thức cơ bản trong xử lý chuỗi: làm thế nào để một mô hình xác định phần nào của đầu vào là liên quan nhất tại một thời điểm bất kỳ?
Hãy bắt đầu với trực giác trước khi đi vào phần toán học.
Hiểu self-attention ở mức khái niệm
Self-attention là một cơ chế gán trọng số tầm quan trọng cho các phần tử khác nhau trong một chuỗi tương quan với nhau. Khi xử lý câu "The animal didn't cross the road because it was too tired," self-attention giúp mô hình hiểu rằng "it" ám chỉ "animal" chứ không phải "road", tức một mối quan hệ trải qua nhiều từ.
Đây thực sự là ví dụ tôi luôn dùng khi giới thiệu khái niệm cho học viên. Nó lập tức tạo sự liên kết vì phản chiếu cách chúng ta đọc tự nhiên.
Cơ chế Attention
Điều làm self-attention đặc biệt mạnh mẽ là khả năng tính toán các mối quan hệ này cho mọi vị trí trong chuỗi đồng thời. Không giống mạng nơ-ron hồi quy xử lý tuần tự từng bước, self-attention xem xét mọi phần tử trong tương quan với mọi phần tử khác chỉ trong một lượt lan truyền xuôi.
Việc tính toán song song này giúp giảm đáng kể thời gian huấn luyện đồng thời nắm bắt các phụ thuộc bất kể khoảng cách trong chuỗi.
Cần phân biệt self-attention với các cơ chế liên quan. Trong self-attention, một chuỗi tập trung vào chính nó. Mỗi phần tử truy vấn thông tin từ mọi vị trí trong cùng chuỗi.
Cross-attention thì ngược lại, cho phép một chuỗi tập trung vào chuỗi khác, như khi decoder tập trung vào đầu ra của encoder trong dịch máy.
Masked self-attention bổ sung một ràng buộc: ngăn các vị trí chú ý đến những vị trí phía sau, đảm bảo dự đoán chỉ phụ thuộc vào các đầu ra đã biết — điều cốt yếu cho sinh văn bản tự hồi quy.
Nhưng ý tưởng này thực sự đến từ đâu và được thiết kế để giải quyết những vấn đề gì?
Nguồn gốc và động lực của self-attention
Trước khi self-attention xuất hiện, lĩnh vực này phải vật lộn với những hạn chế lớn trong mô hình hóa chuỗi.
Các mạng nơ-ron hồi quy, bao gồm LSTM và GRU, xử lý chuỗi theo trình tự, tạo ra một nút thắt cổ chai cơ bản: chúng gặp khó với các phụ thuộc tầm xa vì thông tin phải đi qua nhiều trạng thái trung gian, dẫn đến độ dốc biến mất và ngữ cảnh bị lãng quên.
Sự phát triển hướng tới self-attention bắt đầu với các cơ chế attention trong kiến trúc encoder–decoder dựa trên RNN. Năm 2014, Bahdanau và cộng sự đã giới thiệu cơ chế attention cho phép decoder truy cập tất cả các trạng thái ẩn của encoder thay vì dựa vào một vector ngữ cảnh có độ dài cố định duy nhất.
Đột phá này giải quyết vấn đề nén thông tin, khi các chuỗi đầu vào có độ dài biến thiên bị ép vào các biểu diễn độ dài cố định bất kể độ phức tạp của chúng.
Minh họa đồ họa mô hình được đề xuất của Bahdanau
Một năm sau, Luong đề xuất các cơ chế attention giản lược, gồm cả phương pháp tích vô hướng có tỉ lệ, sau này ảnh hưởng đến thiết kế transformer. Dù các cơ chế attention ban đầu này cải thiện hiệu năng, chúng vẫn phụ thuộc vào quá trình xử lý tuần tự của RNN.
Mô hình attention toàn cục (Luong)
Cuộc cách mạng thực sự bắt đầu khi các nhà nghiên cứu đặt câu hỏi: Điều gì xảy ra nếu ta loại bỏ tính hồi quy và chỉ dựa vào attention? Câu hỏi này dẫn tới kiến trúc transformer, nơi self-attention trở thành cơ chế chủ đạo để hiểu các quan hệ tuần tự.
Khung toán học của Self-Attention
Giờ đây khi đã xác lập tầm quan trọng của self-attention, hãy xem nó vận hành ở cấp độ toán học như thế nào.
Biểu diễn query, key và value
Self-attention biến đổi chuỗi đầu vào qua ba phép chiếu học được: query, key và value. Hãy xem chúng như các "góc nhìn" khác nhau của cùng một thông tin, mỗi loại phục vụ một mục đích riêng trong phép tính attention.
Với chuỗi đầu vào có chiều nhúng
d_model, ta tạo ba ma trận trọng số:W_Q,W_KvàW_V. Khi nhân ma trận đầu vàoXvới các trọng số này, ta thu được:Ma trận Query
Q = X · W_Q: đại diện cho "tôi đang tìm gì"Ma trận Key
K = X · W_K: đại diện cho "tôi cung cấp gì"Ma trận Value
V = X · W_V: đại diện cho "tôi thực sự chứa gì"Tôi thấy phép ẩn dụ thư viện này hữu ích: bạn bước vào với một truy vấn trong đầu, các thẻ mục lục là key của bạn, còn những cuốn sách thực sự là value.
Thông thường, các ma trận này chiếu về chiều nhỏ hơn
d_k(thường làd_modelchia cho số đầu attention), giúp quản lý độ phức tạp tính toán trong khi vẫn duy trì năng lực biểu diễn. Giảm chiều này đặc biệt quan trọng khi mở rộng tới các chuỗi dài hơn.Khi đã có Q, K và V, ta có thể tính attention.
Attention tích vô hướng có tỉ lệ
Bản thân phép tính attention tuân theo một công thức tao nhã. Trước hết, ta tính điểm attention bằng tích vô hướng giữa query và key. Phép toán này đo mức độ tương thích giữa điều mỗi vị trí đang tìm kiếm và điều mọi vị trí khác cung cấp.
Tuy nhiên, khi chiều không gian tăng, các tích vô hướng này có thể trở nên rất lớn, đẩy hàm softmax vào vùng có độ dốc cực nhỏ. Để tránh bất ổn số học này, ta chia cho căn bậc hai của chiều key để thu nhỏ.
Attention tích vô hướng có tỉ lệ
Hệ số tỉ lệ này duy trì phương sai phù hợp trong toàn mạng, đảm bảo độ dốc ổn định khi huấn luyện. Nếu không có nó, các mô hình với nhúng chiều cao sẽ khó học hiệu quả, vì softmax sẽ cho ra phân phối gần như one-hot, không phân bổ attention một cách có ý nghĩa.
Trước khi tiếp tục, có một khoảng trống quan trọng cần xử lý: Mã hóa vị trí.
Mã hóa vị trí
Điều khiến tôi ngạc nhiên nhất khi lần đầu nghiên cứu: self-attention hoàn toàn bất biến theo hoán vị. Xáo trộn các token đầu vào, bạn sẽ nhận cùng một đầu ra — chỉ là bị xáo trộn tương ứng.
Tôi phải mất một lúc để thấm hàm ý: cơ chế này mạnh mẽ nhưng về bản chất mù với trật tự. Với các nhiệm vụ mà thứ tự quan trọng (như hiểu ngôn ngữ), ta cần đưa thông tin vị trí một cách tường minh.
Transformer gốc dùng mã hóa vị trí hình sin, áp dụng các hàm sin và cos với tần số khác nhau cho từng chiều. Lựa chọn này không hề ngẫu nhiên. Dạng sóng cho phép mô hình học cách chú ý tới vị trí tương đối, và phần mã hóa này mở rộng tự nhiên tới các độ dài chuỗi chưa thấy trước đó.
Minh họa mã hóa vị trí
Những đổi mới gần đây gồm RoPE (Rotary Position Embedding), xoay các vector query và key trong không gian đa chiều theo góc tỷ lệ với vị trí của chúng. Sau khi xoay, tích vô hướng giữa query và key tự nhiên mã hóa khoảng cách tương đối.
RoPE đã được áp dụng rộng rãi trong các mô hình như LLaMA vì khả năng ngoại suy mạnh.
Một cách tiếp cận khác, ALiBi (Attention with Linear Biases), đi theo hướng thêm trực tiếp các hình phạt phụ thuộc vị trí vào điểm attention. Thay vì sửa đổi nhúng, ALiBi làm lệch trọng số attention để ưu tiên các token gần, với cường độ độ lệch thay đổi giữa các đầu attention khác nhau.
Phương pháp này cho thấy khả năng ngoại suy ấn tượng tới độ dài chuỗi vượt xa so với khi huấn luyện.
Softmax và trọng số attention
Sau khi tính điểm attention đã được tỉ lệ, ta áp dụng softmax theo chiều key. Phép chuẩn hóa này biến các điểm thô thành phân phối xác suất, đảm bảo tổng trọng số attention bằng một cho mỗi vị trí query.
Hàm softmax làm nổi bật những mối quan hệ có điểm cao nhất đồng thời triệt tiêu các kết nối không liên quan. Tuy nhiên, đôi khi điều này dẫn tới phân phối quá nhọn, đặc biệt ở giai đoạn đầu huấn luyện khi mô hình chưa học được các mẫu attention tinh tế.
Để giảm thiểu, người thực hành thường áp dụng dropout lên trọng số attention, ngẫu nhiên đưa một số kết nối về 0 để tăng độ bền vững.
Tính vector ngữ cảnh
Khi đã có trọng số attention, ta tính đầu ra cuối cùng như tổng có trọng số của các vector value.
Mỗi vị trí nhận một biểu diễn nhận thức ngữ cảnh, tổng hợp thông tin từ toàn bộ chuỗi, với mức đóng góp tỷ lệ với trọng số attention. Sự kết hợp có trọng số này cho phép thông tin luân chuyển linh hoạt dựa trên các mối quan hệ được học thay vì các khuôn mẫu cố định.
Tính toán vector ngữ cảnh
Attention một đầu mang lại kết quả đáng ngạc nhiên, nhưng vẫn có trần. Đây là lúc mọi thứ trở nên thú vị hơn.
Multi-Head Attention và các không gian biểu diễn con
Dù attention một đầu rất mạnh, nó có một hạn chế cơ bản: chỉ có thể nắm bắt một kiểu quan hệ tại một thời điểm.
Động lực và kiến trúc
Multi-head attention khắc phục điều này bằng cách chạy song song nhiều phép tính attention, mỗi phép tập trung vào những khía cạnh khác nhau của các mối quan hệ đầu vào. Chẳng hạn, có thể có mỗi đầu chuyên về:
Qua quan sát khi làm việc với các mô hình này, sự chuyên biệt thường nảy sinh một cách tự nhiên trong quá trình huấn luyện. Bạn không cần thiết kế nó, và tôi cho rằng đó là một trong những khía cạnh hấp dẫn nhất của toàn bộ cơ chế.
Multi-head attention
Việc hiện thực bao gồm tách các ma trận
Q,KvàVtheo trục chiều, xử lý mỗi phần tách qua các đầu attention riêng biệt và ghép nối kết quả lại.Nếu có 8 đầu và nhúng 512 chiều, mỗi đầu làm việc trên không gian con 64 chiều. Xử lý song song này không làm tăng độ phức tạp theo độ dài chuỗi nhưng nhân lên năng lực của mô hình trong việc học các mẫu đa dạng.
Các đầu khác nhau học gì
Nghiên cứu về những gì các đầu attention khác nhau thực sự học được đã hé lộ các mẫu thú vị.
Trong các mô hình dịch, một số đầu nhất quán chú ý tới quan hệ vị trí, tập trung vào từ lân cận bất kể nội dung. Các đầu khác chuyên về vai trò cú pháp, xác định quan hệ chủ ngữ–động từ hay động từ–tân ngữ. Một nhóm thứ ba chú ý tới các token hiếm hoặc giàu thông tin như danh từ riêng và thuật ngữ kỹ thuật.
Thú vị là, các nghiên cứu khả giải cho thấy nhiều đầu dường như dư thừa, và mô hình vẫn giữ được hiệu năng ngay cả khi cắt bớt một phần đáng kể số đầu. Sự dư thừa này có lẽ góp phần vào độ bền vững, đảm bảo các mẫu quan trọng có nhiều con đường xuyên suốt mạng.
Trong attention encoder–decoder, các đầu ở những lớp decoder muộn tỏ ra thiết yếu nhất cho chất lượng dịch, trong khi các đầu self-attention của encoder thường có thể giảm bớt đáng kể.
Self-Attention trong kiến trúc Transformer
Khi đã nắm nền tảng toán học, hãy xem self-attention được tích hợp vào kiến trúc transformer hoàn chỉnh như thế nào.
Encoder: attention mọi–với–mọi
Trong encoder của transformer, các lớp self-attention cho phép mỗi vị trí chú ý tới mọi vị trí khác trong chuỗi đầu vào. Mẫu "mọi–với–mọi" này cho phép dòng chảy ngữ cảnh hai chiều, nơi mỗi token xây dựng một biểu diễn được thông tin bởi toàn bộ chuỗi.
Kiến trúc Encoder
Mỗi lớp encoder kết hợp multi-head self-attention với mạng feed-forward theo vị trí. Mạng feed-forward xử lý từng vị trí một cách độc lập nhưng giống hệt nhau, áp dụng cùng một biến đổi học được cho tất cả token.
Các kết nối hồi tiếp (residual) và chuẩn hóa lớp bao quanh cả hai tầng con, ổn định độ dốc và cho phép kiến trúc sâu hơn. Xếp chồng nhiều lớp encoder tạo ra các biểu diễn ngày càng trừu tượng, với các lớp đầu nắm bắt mẫu bề mặt và các lớp sâu mã hóa quan hệ ngữ nghĩa.
Decoder: attention có mặt nạ và tính nhân quả
Decoder điều chỉnh self-attention để tôn trọng ràng buộc tự hồi quy. Khi sinh văn bản, mô hình chỉ có thể dựa vào các token đã tạo. Nhìn lén các token tương lai sẽ là gian lận trong huấn luyện.
Kiến trúc Decoder
Masked self-attention thực hiện điều này bằng cách đặt trọng số attention về âm vô cùng (sau softmax trở thành 0) cho tất cả các vị trí sau vị trí hiện tại.
Điều này đảm bảo dự đoán chỉ phụ thuộc vào ngữ cảnh trước đó, duy trì trật tự nhân quả cần thiết cho các nhiệm vụ sinh. Trong suy luận, tính nhân quả này trở nên tự nhiên: đơn giản là ta chưa có các token tương lai để chú ý tới.
Cross-attention: kết nối encoder và decoder
Giữa các lớp self-attention của decoder là cross-attention, cho phép decoder điều kiện hóa theo đầu ra của encoder. Ở đây, query đến từ decoder (đại diện cho "tôi cần tạo gì"), còn key và value đến từ encoder (đại diện cho "đầu vào cung cấp gì").
Kiến trúc Transformer
Cơ chế cross-attention này là thiết yếu cho các bài toán chuỗi–sang–chuỗi như dịch, nơi decoder phải căn chỉnh từ đầu ra với các từ đầu vào liên quan. Không giống self-attention, cross-attention tạo phụ thuộc giữa hai chuỗi khác nhau, cho phép thông tin chảy từ nguồn sang đích.
Bỏ qua lý thuyết, self-attention thực sự đã cho phép những gì trong thực tiễn? Câu trả lời rộng hơn nhiều người nghĩ.
Ứng dụng của Self-Attention trên nhiều lĩnh vực
Sau khi khám phá cách self-attention hoạt động trong kiến trúc transformer, hãy xem cơ chế này đã tạo tác động trong thế giới thực ở đâu.
Điều khiến self-attention đặc biệt hữu dụng là tính phi miền của nó. Cùng một khung toán học giúp mô hình hiểu các quan hệ ngôn ngữ cũng có thể nắm bắt mẫu trong hình ảnh, âm thanh và thậm chí là sự kết hợp các kiểu dữ liệu khác nhau.
Theo quan điểm của tôi, chính phẩm chất phi miền này làm self-attention thực sự đáng hứng thú. Tôi cho rằng nó ít là công cụ NLP, mà là một cơ chế học quan hệ dùng chung.
Ứng dụng trong xử lý ngôn ngữ tự nhiên
Các mô hình Transformer xuất sắc trong việc nắm bắt các phụ thuộc tầm xa mà các kiến trúc trước đó bỏ lỡ. Trong NLP, self-attention thúc đẩy hàng loạt mô hình đột phá hầu như ở mọi tác vụ.
Như bạn có thể thấy trong hình dưới đây, kiến trúc của các mô hình khác nhau tùy theo trọng tâm là decoder hay encoder.
So sánh kiến trúc: Transformer vs. GPT vs. BERT
Các mô hình như BERT dùng self-attention hai chiều trong kiến trúc chỉ encoder, cho phép xây dựng các biểu diễn theo ngữ cảnh phong phú cho các nhiệm vụ phân loại và hiểu.
Các mô hình GPT như GPT-5.3 Codex mới phát hành dùng masked self-attention trong thiết kế chỉ decoder, đạt khả năng sinh văn bản ấn tượng.
T5 sử dụng đầy đủ kiến trúc transformer encoder–decoder, xem mọi tác vụ NLP như bài toán văn bản–sang–văn bản.
Ứng dụng trong thị giác máy tính
Vision Transformer (ViT) đưa self-attention vào thị giác máy tính bằng cách coi ảnh như chuỗi các ô (patch). Thay vì xử lý điểm ảnh qua các lớp tích chập, ViT chia hình thành các ô cố định (thường 16×16), làm phẳng mỗi ô thành một vector và xử lý chuỗi qua các lớp transformer.
Vision Transformer
Cách tiếp cận này nắm bắt các mối quan hệ toàn cục mà trường tiếp nhận cục bộ của mạng tích chập có thể bỏ lỡ. ViT và các biến thể hiện đạt kết quả hiện đại nhất trong phân loại ảnh, phát hiện vật thể, phân đoạn ngữ nghĩa và các lĩnh vực khác:
Tiếng nói, hệ gợi ý và học đa phương thức
Tính hữu dụng của self-attention mở rộng sang xử lý tiếng nói, nơi nó nắm bắt các phụ thuộc theo thời gian trong chuỗi âm thanh hiệu quả hơn các mô hình hồi quy. Trong recommender systems, self-attention giúp mô hình hóa mẫu sở thích người dùng bằng cách chú ý tới các tương tác lịch sử liên quan.
Có lẽ phấn khởi nhất là các ứng dụng đa phương thức kết hợp thị giác và ngôn ngữ. Các mô hình như CLIP dùng cross-attention giữa biểu diễn ảnh và văn bản, cho phép phân loại ảnh zero-shot và sinh ảnh từ mô tả văn bản.
Điểm chung của tất cả các hệ thống này: Chúng cho thấy năng lực cốt lõi của self-attention trong việc học các mối quan hệ giữa bất kỳ dữ liệu tuần tự hay có cấu trúc nào, bất kể phương thức.
Các biến thể Self-Attention nâng cao và phát triển gần đây
Dù self-attention đã thành công đáng kể trên nhiều lĩnh vực, những thách thức mới nảy sinh khi triển khai các mô hình transformer ở quy mô lớn. Khi mô hình tăng lên hàng tỷ tham số và xử lý ngữ cảnh kéo dài tới hàng trăm nghìn token, băng thông bộ nhớ và chi phí tính toán trở thành các nút thắt quan trọng.
Trọng tâm phát triển mô hình mới ngày càng hướng tới việc làm cho self-attention nhanh hơn và hiệu quả hơn mà không đánh đổi các khả năng cốt lõi. Tôi thấy sự căng kéo giữa năng lực và hiệu quả là một trong những bài toán mở thú vị nhất hiện nay. Hãy điểm qua một số tiến triển hiện tại.
Grouped-query và multi-query attention
Attention đa đầu tiêu chuẩn duy trì các phép chiếu key và value riêng cho mỗi đầu, tạo chi phí bộ nhớ đáng kể khi suy luận. Multi-query attention (MQA) giảm chi phí này bằng cách dùng chung một đầu key–value (KV) cho tất cả các đầu query, cắt giảm mạnh kích thước bộ đệm KV và tăng tốc giải mã. Tuy nhiên, MQA có thể làm giảm chất lượng.
Grouped-query attention (GQA) là cách cân bằng hơn, chia các đầu query thành nhóm dùng chung cặp key–value. Với 32 đầu query và 8 nhóm, mỗi nhóm 4 query dùng chung một đầu key–value. Chẳng hạn, họ mô hình Mistral 3 dùng cách này và đạt chất lượng gần như attention đầy đủ với mức tăng tốc đáng kể.
Kiến trúc lai kết hợp attention với mô hình không gian trạng thái
Trong khi GQA giải quyết hiệu quả bộ nhớ, một hướng nghiên cứu khác xử lý nút thắt tính toán cơ bản của attention theo một cách khác.
Các công trình gần đây khám phá việc kết hợp self-attention với mô hình không gian trạng thái để cải thiện hiệu quả. Các hệ thống như S4 và Hyena dùng không gian trạng thái có cấu trúc để mô hình hóa phụ thuộc tầm xa với độ phức tạp tuyến tính thay vì bậc hai.
Những cách tiếp cận này giải quyết hạn chế cơ bản của self-attention: chi phí tính toán tỉ lệ bậc hai theo độ dài chuỗi, khiến ngữ cảnh cực dài trở nên quá tốn kém.
Mở rộng trong thời gian suy luận và tối ưu hóa lúc kiểm thử
Ngoài việc hình dung lại kiến trúc, các nhà nghiên cứu còn tìm ra những cách khéo léo để tối ưu các cơ chế attention hiện có.
Bên cạnh thay đổi kiến trúc, những tiến bộ gần đây tối ưu attention trong khi suy luận. Lượng tử hóa giảm độ chính xác bộ đệm KV xuống 8 hoặc 4 bit, cắt giảm mạnh bộ nhớ với tổn thất chất lượng tối thiểu.
Flash Attention tổ chức lại truy cập bộ nhớ GPU để giảm thiểu di chuyển dữ liệu, đạt tăng tốc 2–3 lần. Tối ưu tính toán khi kiểm thử, nơi mô hình thực hiện nhiều lượt trong quá trình sinh, gợi ý rằng việc áp dụng attention có chiến lược có thể mang lại kết quả tốt hơn so với chỉ đơn thuần tăng kích thước mô hình.
Kết luận
Self-attention là một trong những cơ chế có sức biến đổi lớn nhất trong lịch sử học máy. Bằng cách cho phép mô hình linh hoạt xác định thành phần nào của đầu vào xứng đáng được chú ý, nó đã giải được những thách thức tồn tại lâu dài trong việc nắm bắt các phụ thuộc tầm xa và xử lý chuỗi hiệu quả.
Sự tao nhã toán học của attention tích vô hướng có tỉ lệ, được tăng cường qua kiến trúc đa đầu, mang lại cả cơ sở lý thuyết vững chắc lẫn hiệu quả thực tiễn.
Từ việc cung cấp sức mạnh cho các mô hình ngôn ngữ hiện đ-đại nhất đến cách mạng hóa thị giác máy tính và cho phép các hệ thống AI đa phương thức, self-attention tiếp tục mở rộng tầm với. Những đổi mới gần đây về grouped-query attention, kiến trúc lai và tối ưu suy luận cho thấy chúng ta vẫn đang khám phá cách làm cơ chế này hiệu quả và mạnh mẽ hơn.
Nếu bạn muốn tìm hiểu chi tiết và thực hành trực tiếp, tôi khuyến nghị đăng ký lộ trình kỹ năng Developing Large Language Models của chúng tôi.