Eind 2017 introduceerde een onderzoeksartikel getiteld Attention Is All You Need een revolutionair mechanisme dat kunstmatige intelligentie fundamenteel zou veranderen. De kern van deze doorbraak was self-attention: een simpel maar krachtig idee waarmee modellen relaties binnen data kunnen begrijpen door te bepalen welke elementen de aandacht verdienen.
Tegenwoordig drijft self-attention alles aan, van de conversatievaardigheden van ChatGPT tot geavanceerde systemen voor beeldherkenning. Het is zonder twijfel een van de meest transformerende innovaties in de geschiedenis van machine learning.
In deze gids neem ik je mee van de conceptuele basis van self-attention tot de toepassingen ervan, en laat ik zien hoe het mechanisme modellen helpt langeafstandscorrelaties vast te leggen en informatie parallel te verwerken — capaciteiten die eerder onbereikbaar waren met traditionele neurale netwerken.
Als je nieuw bent met transformers, overweeg dan een van onze introductiecursussen over Large Language Models (LLMs) Concepts en Transformer Models with PyTorch.
Wat is self-attention?
Uit mijn ervaring met het onderwijzen van dit concept is het beste startpunt een fundamentele uitdaging in sequentieverwerking: hoe kan een model bepalen welke delen van de input op een bepaald moment het meest relevant zijn?
Laten we beginnen met de intuïtie vóór we de wiskunde induiken.
Conceptueel begrip van self-attention
Self-attention is een mechanisme dat het belang van verschillende elementen in een sequentie ten opzichte van elkaar weegt. Bij het verwerken van de zin "The animal didn't cross the road because it was too tired" helpt self-attention het model te begrijpen dat "it" terugverwijst naar "animal" en niet naar "road" — een relatie die meerdere woorden overspant.
Dit is eigenlijk het voorbeeld dat ik altijd gebruik wanneer ik het concept introduceer bij studenten. Het valt meteen op z’n plek omdat het weerspiegelt hoe we van nature lezen.
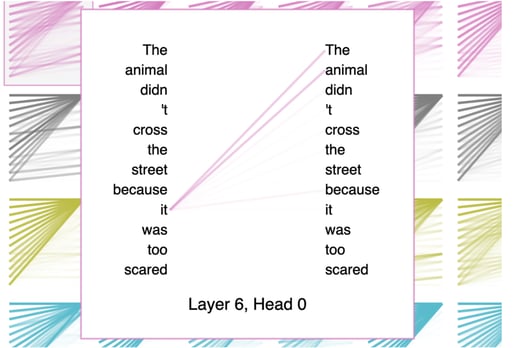
Attentionmechanisme
Wat self-attention bijzonder krachtig maakt, is het vermogen om deze relaties voor alle posities in een sequentie tegelijk te berekenen. In tegenstelling tot recurrente neurale netwerken die sequenties stap voor stap verwerken, bekijkt self-attention elk element in relatie tot elk ander element in één enkele forward pass.
Deze parallelle berekening verkort de trainingstijd drastisch en legt afhankelijkheden vast, ongeacht hun afstand in de sequentie.
Het is belangrijk om self-attention te onderscheiden van aanverwante mechanismen. Bij self-attention richt een sequentie de aandacht op zichzelf. Elk element bevraagt informatie uit alle posities binnen dezelfde sequentie.
Cross-attention daarentegen laat de ene sequentie aandacht besteden aan een andere, zoals wanneer een decoder de encoderuitvoer bekijkt bij machinevertaling.
Gemaskerde self-attention voegt een extra beperking toe: posities mogen geen aandacht besteden aan latere posities, zodat voorspellingen alleen afhangen van bekende output — essentieel voor autoregressieve tekstgeneratie.
Maar waar komt dit idee eigenlijk vandaan, en welke problemen moest het oplossen?
Oorsprong en motivatie van self-attention
Voordat self-attention opkwam, kampte het vakgebied met aanzienlijke beperkingen in sequentiemodellering.
Recurrente neurale netwerken, inclusief LSTM's en GRU's, verwerken sequenties sequentieel, wat een fundamentele bottleneck veroorzaakt: ze hadden moeite met langeafstandscorrelaties omdat informatie door vele tussenliggende toestanden moest, wat leidde tot verdwijnende gradiënten en vergeten context.
De evolutie richting self-attention begon met attentionmechanismen in RNN-gebaseerde encoder-decoderarchitecturen. In 2014 introduceerden Bahdanau en collega's een attentionmechanisme waardoor decoders toegang kregen tot alle verborgen toestanden van de encoder in plaats van te vertrouwen op één contextvector met vaste lengte.
Deze doorbraak pakte het probleem van informatiecompressie aan, waarbij invoersequenties met variabele lengte werden samengeperst tot representaties met vaste lengte, ongeacht hun complexiteit.
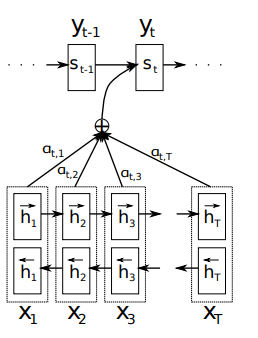
Bahdanau's grafische illustratie van het voorgestelde model
Een jaar later stelde Luong vereenvoudigde attentionmechanismen voor, waaronder de scaled dot-product-aanpak die later de transformatorontwerp zou beïnvloeden. Hoewel deze vroege attentionmechanismen de prestaties verbeterden, bleven ze afhankelijk van sequentiële RNN-verwerking.
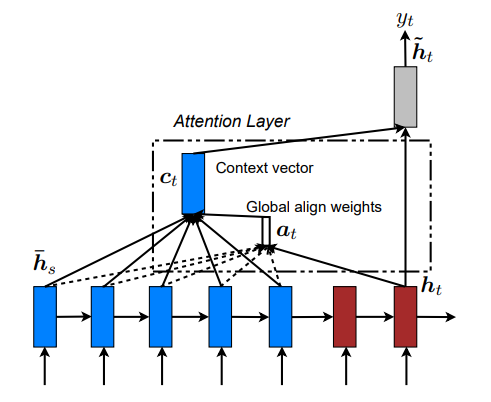
Globaal attentionmodel (Luong)
De echte revolutie kwam toen onderzoekers vroegen: wat als we recursie elimineren en uitsluitend op attention vertrouwen? Deze vraag leidde tot de transformerarchitectuur, waarin self-attention het primaire mechanisme werd voor het begrijpen van sequentierelaties.
Het wiskundige raamwerk van self-attention
Nu we hebben vastgesteld waarom self-attention ertoe doet, kijken we hoe het op wiskundig niveau werkt.
Query-, key- en value-representaties
Self-attention transformeert invoersequenties via drie geleerde projecties: queries, keys en values. Zie ze als verschillende "kijkhoeken" op dezelfde informatie, elk met een eigen rol in de attentionberekening.
Voor een invoersequentie met embeddingdimensie d_model maken we drie gewichtsmatrices: W_Q, W_K en W_V. Door onze inputmatrix X met deze gewichten te vermenigvuldigen, krijgen we:
-
Querymatrix Q = X · W_Q: staat voor "waar ben ik naar op zoek"
-
Keymatrix K = X · W_K: staat voor "wat bied ik aan"
-
Valuematrix V = X · W_V: staat voor "wat bevat ik daadwerkelijk"
Ik vind deze bibliotheekanalogie handig: je loopt binnen met een query in gedachten, de indexkaarten zijn je keys en de echte boeken zijn je values.
Doorgaans projecteren deze matrices naar een kleinere dimensie d_k (vaak d_model gedeeld door het aantal attentionheads), wat de rekensom beheersbaar houdt terwijl de representatiekracht behouden blijft. Deze dimensionaliteitsreductie wordt vooral belangrijk bij het opschalen naar langere sequenties.
Met Q, K en V op zak kunnen we nu de attention zelf berekenen.
Scaled dot-product attention
De attentionberekening volgt een elegante formule. Eerst berekenen we attentiescores via het inwendig product tussen queries en keys. Deze operatie meet de compatibiliteit tussen waar elke positie naar zoekt en wat elke andere positie aanbiedt.
Maar naarmate de dimensionaliteit toeneemt, kunnen deze inwendige producten erg groot worden, waardoor de softmaxfunctie in gebieden met extreem kleine gradiënten terechtkomt. Om deze numerieke instabiliteit te voorkomen, schalen we door te delen door de vierkantswortel van de keyedimensie.
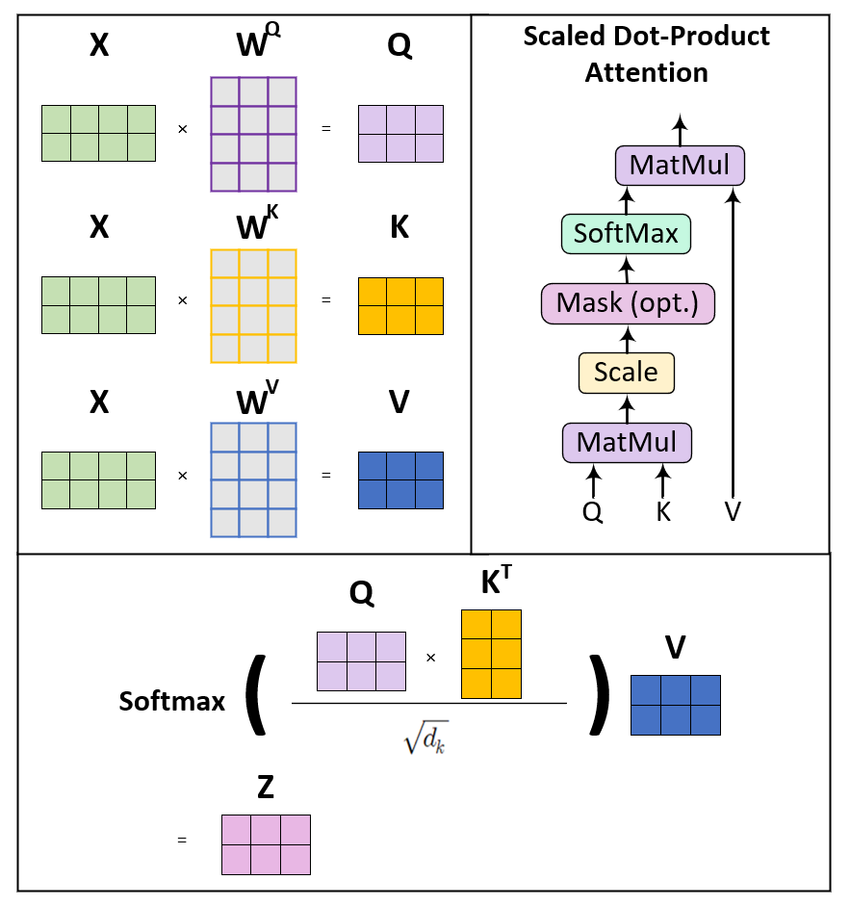
Scaled dot-product attention
Deze schaalk factor behoudt een passende variantie door het netwerk, wat zorgt voor stabiele gradiënten tijdens training. Zonder deze factor zouden modellen met embeddings met hoge dimensies moeite hebben om effectief te leren, omdat softmax bijna one-hotverdelingen zou opleveren die aandacht niet zinvol verdelen.
Voor we verdergaan, is er één belangrijk gat dat we moeten dichten: positionele encodering.
Positionele encodering
Dit verraste me het meest toen ik dit voor het eerst bestudeerde: self-attention is volledig permutatie-invariant. Hussel de invoertokens door elkaar en je krijgt dezelfde output — alleen overeenkomstig gehusseld.
Het duurde even voordat ik het besefte: het mechanisme is krachtig, maar in wezen blind voor volgorde. Voor taken waarbij volgorde ertoe doet (zoals taalbegrip) moeten we positionele informatie expliciet injecteren.
De oorspronkelijke transformer gebruikte sinusvormige positie-encoderingen, met sinus- en cosinusfuncties van verschillende frequenties per dimensie. Deze keuze was niet arbitrair. De golvende patronen stellen modellen in staat te leren letten op relatieve posities, en de encodering strekt zich van nature uit naar niet eerder geziene sequentielengtes.
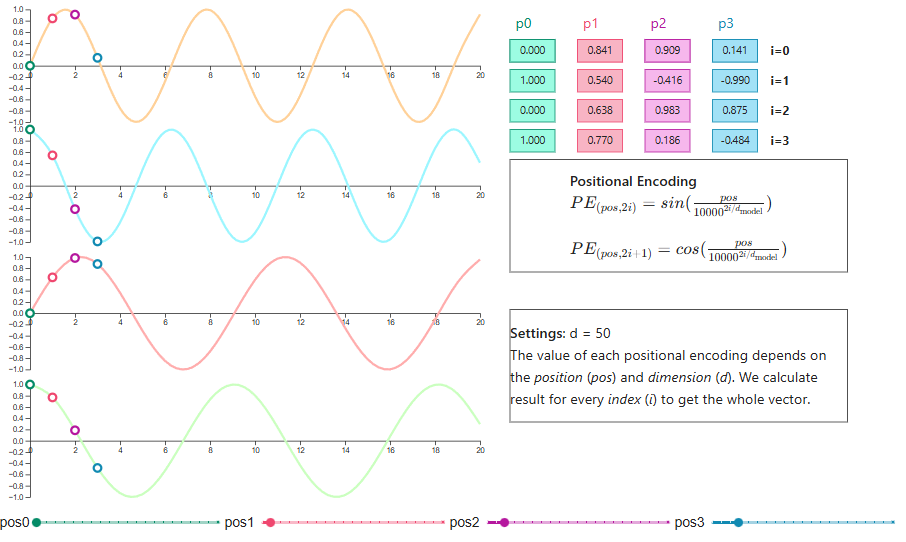
Visualisatie van positionele encodering
Recente innovaties omvatten RoPE (Rotary Position Embedding), dat query- en keyvectoren in een multidimensionale ruimte roteert met hoeken die evenredig zijn aan hun posities. Na rotatie codeert het inwendig product tussen queries en keys van nature relatieve afstand.
RoPE is wijdverbreid toegepast in modellen zoals LLaMA vanwege de sterke extrapolatiecapaciteiten.
Een andere benadering, ALiBi (Attention with Linear Biases), kiest een andere weg door positiebepaalde straffen rechtstreeks aan attentiescores toe te voegen. In plaats van embeddings te wijzigen, bevoordeelt ALiBi aandacht naar nabije tokens, waarbij de intensiteit van de bias varieert over verschillende attentionheads.
Deze methode laat indrukwekkende extrapolatie zien naar sequentielengtes die ver voorbij de trainingsomvang liggen.
Softmax en attentiongewichten
Na het berekenen van geschaalde attentiescores passen we softmax toe over de keyedimensie. Deze normalisatie zet rauwe scores om in een kansverdeling, zodat de attentiongewichten per querypositie optellen tot één.
De softmaxfunctie benadrukt de relaties met de hoogste score en onderdrukt irrelevante connecties. Dit kan echter soms leiden tot te scherpe verdelingen, vooral vroeg in de training wanneer het model nog geen genuanceerde aandachtspatronen heeft geleerd.
Om dit te beperken passen practitioners vaak dropout toe op attentiongewichten, waarbij sommige connecties willekeurig op nul worden gezet om robuustheid te stimuleren.
Contextvectoren berekenen
Met de attentiongewichten berekenen we de uiteindelijke output als een gewogen som van de valuevectoren.
Elke positie ontvangt een contextbewuste representatie die informatie uit de hele sequentie aggregeert, met bijdragen evenredig aan de attentiongewichten. Deze gewogen combinatie laat informatie dynamisch vloeien op basis van geleerde relaties in plaats van vaste patronen.
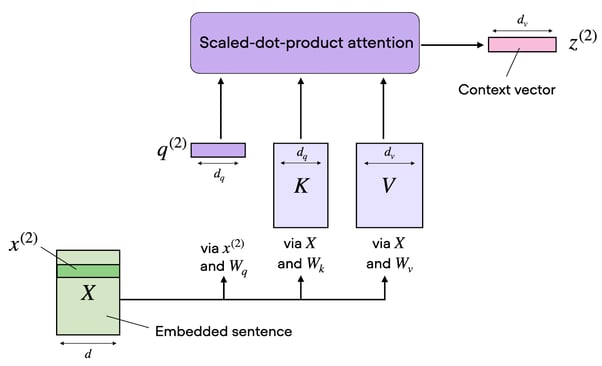
Berekening van contextvector
Single-head attention brengt je verrassend ver, maar kent een plafond. Hier wordt het interessanter.
Multi-head attention en meerdere representatiesubruimtes
Hoewel single-head attention krachtig is, kent het een fundamentele beperking: het kan slechts één type relatie tegelijk vastleggen.
Motivatie en architectuur
Multi-head attention pakt dit aan door meerdere attentionberekeningen parallel uit te voeren, die elk focussen op verschillende aspecten van de relaties in de input. Zo kan er bijvoorbeeld een head zijn die zich specialiseert in:
- Lokale syntactische afhankelijkheden
- Langeafstand semantische relaties
- Positionele patronen
Wat ik heb gezien bij het werken met deze modellen: die specialisatie ontstaat vaak organisch tijdens de training. Je ontwerpt het niet — en dat vind ik een van de fascinerendste aspecten van het hele mechanisme.
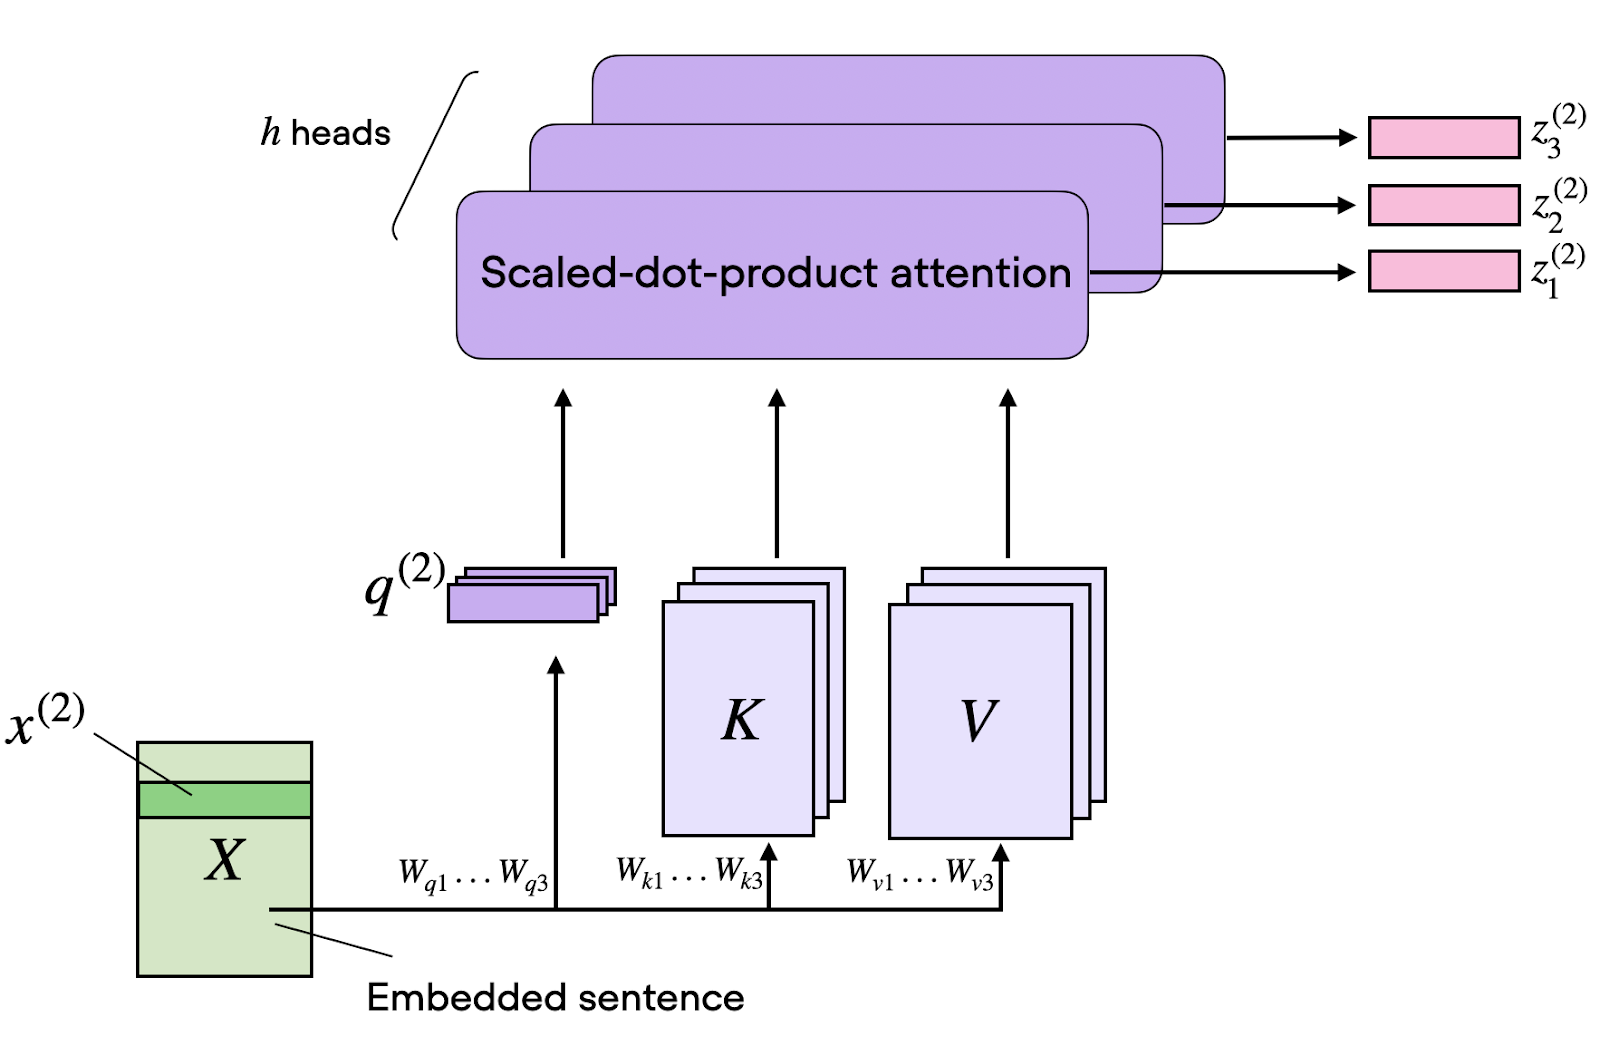
Multi-head attention
De implementatie houdt in dat we de matrices Q, K en V langs de dimensie-as splitsen, elk deel door afzonderlijke attentionheads sturen en de resultaten concateneren.
Als we 8 heads hebben en 512-dimensionale embeddings, werkt elke head op 64-dimensionale subruimtes. Deze parallelle verwerking verhoogt de complexiteit met betrekking tot sequentielengte niet, maar vergroot wel het vermogen van het model om diverse patronen te leren.
Wat verschillende heads leren
Onderzoek naar wat verschillende attentionheads daadwerkelijk leren, heeft fascinerende patronen onthuld.
In vertaalmodellen besteden sommige heads consequent aandacht aan positionele relaties en focussen ze op naburige woorden, ongeacht de inhoud. Andere heads specialiseren zich in syntactische rollen en herkennen subject-werkwoord- of werkwoord-objectrelaties. Een derde categorie richt zich op zeldzame of informatie-rijke tokens zoals eigennamen en vaktermen.
Interessant genoeg tonen interpreteerbaarheidsstudies aan dat veel heads redundant lijken, en dat modellen hun prestaties behouden zelfs wanneer een aanzienlijk deel van de heads wordt weggesnoeid. Deze redundantie draagt waarschijnlijk bij aan robuustheid, zodat kritieke patronen meerdere paden door het netwerk hebben.
Bij encoder-decoder-attention blijken heads in latere decoderlagen het belangrijkst voor vertaalkwaliteit, terwijl encoderself-attentionheads vaak substantieel kunnen worden gereduceerd.
Met de wiskundige basis gelegd, bekijken we hoe self-attention integreert in de complete transformerarchitectuur.
De encoder: alles-op-alles-attention
In de transformerencoder laten self-attentionlagen elke positie aandacht besteden aan elke andere positie in de invoersequentie. Dit "alles-op-alles"-patroon maakt bidirectionele contextstroom mogelijk, waarbij elk token een representatie opbouwt die wordt geïnformeerd door de hele sequentie.
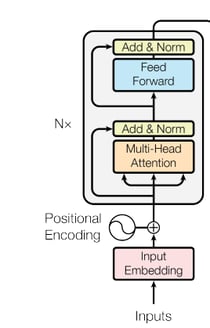
Encoderarchitectuur
Elke encoderlaag combineert multi-head self-attention met een positiegewijs feedforwardnetwerk. Het feedforwardnetwerk verwerkt elke positie onafhankelijk maar identiek, met dezelfde geleerde transformatie voor alle tokens.
Residu-verbindingen en layernormalisatie omringen beide sublagen, wat gradiënten stabiliseert en diepere architecturen mogelijk maakt. Door meerdere encoderlagen te stapelen ontstaan steeds abstracter wordende representaties: vroege lagen leggen oppervlakkige patronen vast en diepere lagen coderen semantische relaties.
De decoder: gemaskeerde attention en causaliteit
De decoder past self-attention aan om autoregressieve beperkingen te respecteren. Bij tekstgeneratie kan het model alleen conditioneren op tokens die het al heeft geproduceerd. Gluren naar toekomstige tokens zou tijdens training neerkomen op valsspelen.
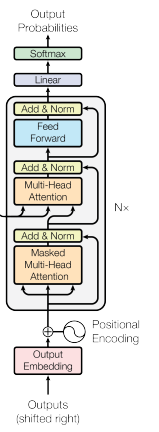
Decoderarchitectuur
Gemaskeerde self-attention doet dit door attentiegewichten op min-infiniteit te zetten (wat na softmax nul wordt) voor alle posities na de huidige.
Dit zorgt ervoor dat voorspellingen alleen afhangen van eerdere context en dat de noodzakelijke causale ordening voor generatietaken behouden blijft. Tijdens inferentie wordt deze causaliteit vanzelfsprekend: we hébben de toekomstige tokens simpelweg nog niet om aandacht aan te besteden.
Cross-attention: de verbinding tussen encoder en decoder
Tussen de self-attentionlagen van de decoder ligt cross-attention, waarmee de decoder kan conditioneren op encoderuitvoer. Hier komen de queries uit de decoder ("wat moet ik genereren"), terwijl keys en values uit de encoder komen ("wat de input biedt").
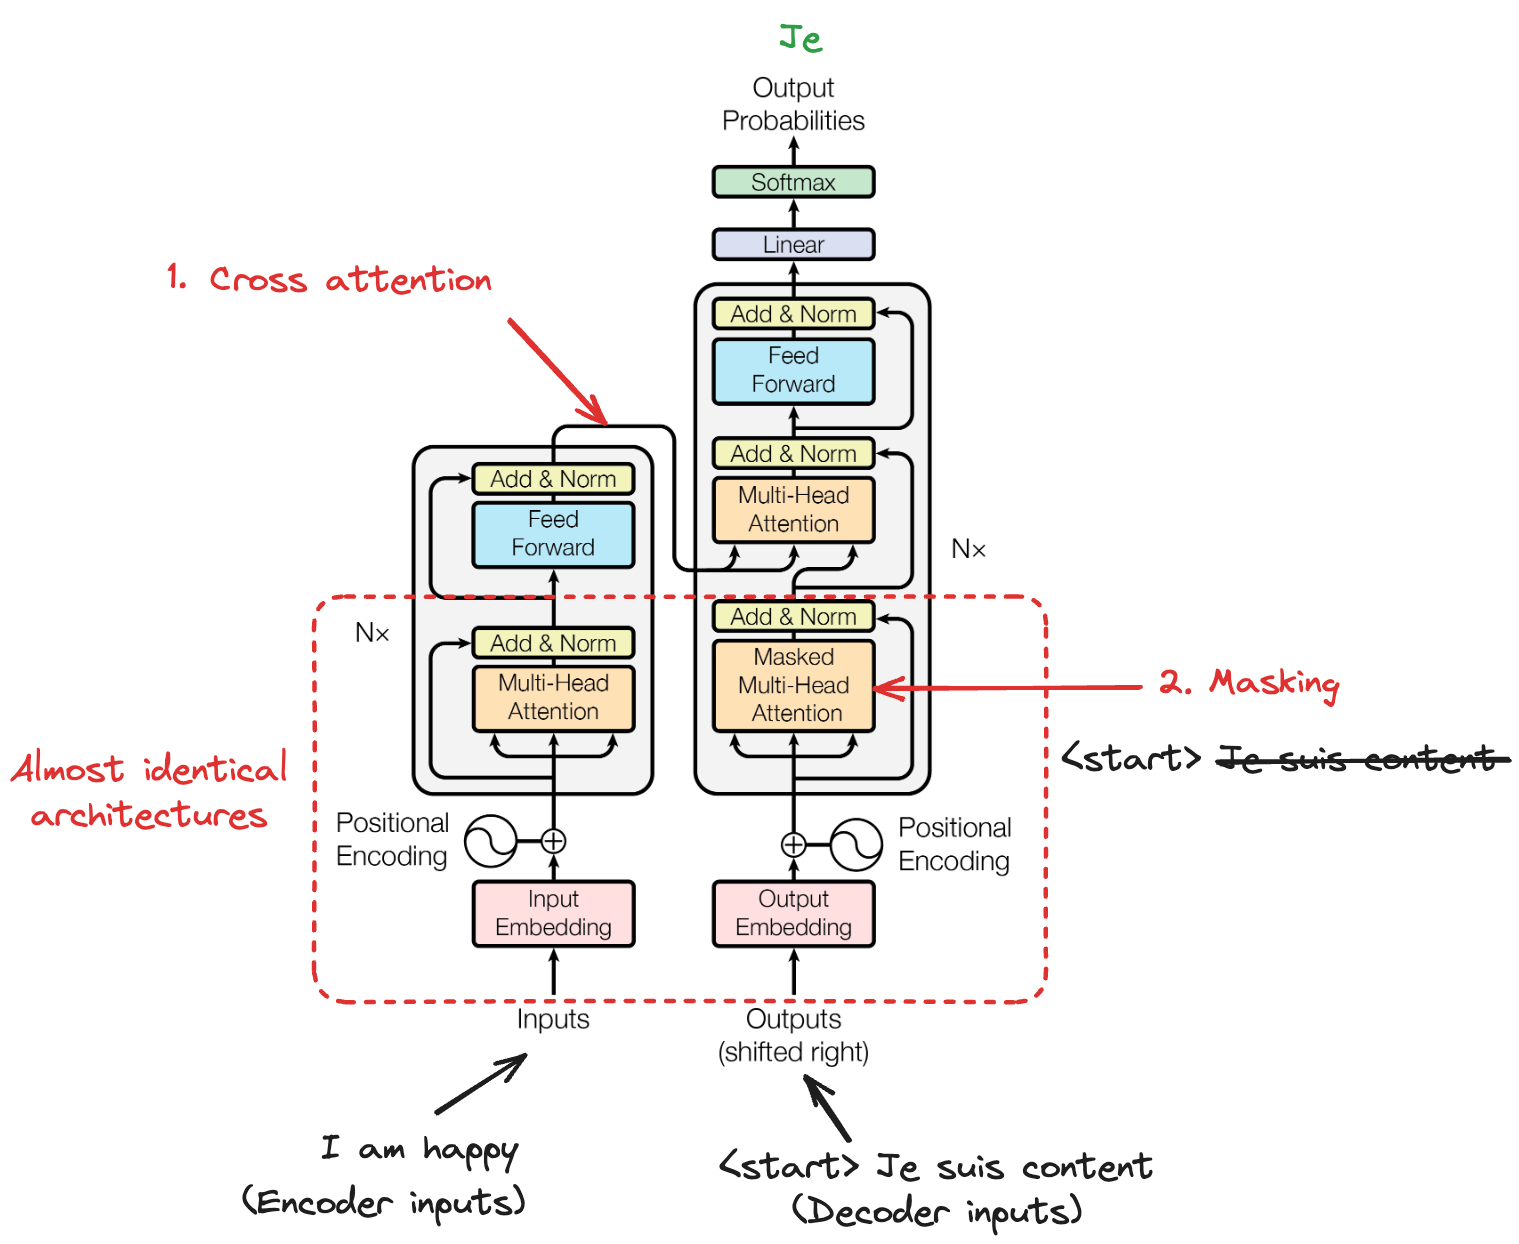
Transformerarchitectuur
Dit cross-attentionmechanisme is essentieel voor sequence-to-sequencetaken zoals vertaling, waarbij de decoder uitvoerwoorden moet afstemmen op relevante invoerwoorden. In tegenstelling tot self-attention creëert cross-attention afhankelijkheden tussen twee verschillende sequenties, zodat informatie van bron naar doel kan stromen.
Los van de theorie: wat heeft self-attention in de praktijk mogelijk gemaakt? Het antwoord is breder dan de meeste mensen verwachten.
Toepassingen van self-attention in verschillende domeinen
Nu we hebben gezien hoe self-attention werkt binnen de transformerarchitectuur, bekijken we waar dit mechanisme impact heeft in de echte wereld.
Wat self-attention bijzonder waardevol maakt, is het domeinonafhankelijke karakter. Hetzelfde wiskundige raamwerk dat modellen helpt taalkundige relaties te begrijpen, kan ook patronen vastleggen in beelden, audio en zelfs combinaties van verschillende datatypen.
Naar mijn mening is juist die domeinonafhankelijkheid wat self-attention echt spannend maakt. Ik zou zeggen dat het minder een NLP-tool is en meer een algemeen mechanisme om relaties te leren.
Toepassingen in natural language processing
Transformermodellen blinken uit in het vastleggen van langeafstandscorrelaties die eerdere architecturen misten. In NLP drijft self-attention doorbraakmodellen aan voor vrijwel elke taak.
- Machinevertaling: afstemming van bron- en doelzinnen, ongeacht hun afstand
- Sentimentanalyse: herkenning van contextuele aanwijzingen die betekenis veranderen
- Vraagbeantwoording: koppeling van vragen aan relevante passagesegmenten, zelfs wanneer ze door veel tokens gescheiden zijn.
Zoals je in de onderstaande afbeelding ziet, verschilt de architectuur van de modellen afhankelijk van of de focus op de decoder of de encoder ligt.
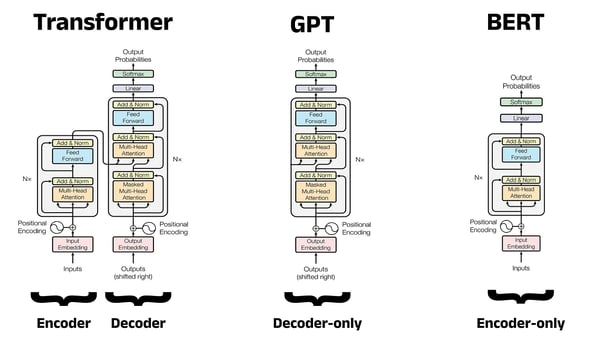
Architectuurvergelijking: Transformer vs. GPT vs. BERT
Modellen zoals BERT gebruiken bidirectionele self-attention in hun encoder-only-architectuur, waardoor ze rijke contextuele representaties kunnen opbouwen voor classificatie- en begrijptaken.
GPT-modellen zoals de recent uitgebrachte GPT-5.3 Codex gebruiken gemaskeerde self-attention in hun alleen-decoderontwerp en bereiken opmerkelijke tekstgeneratiecapaciteiten.
T5 gebruikt de volledige encoder-decodertransformerarchitectuur en behandelt alle NLP-taken als text-to-textproblemen.
Toepassingen in computervisie
De aanpassing Vision Transformer (ViT) bracht self-attention naar computervisie door afbeeldingen te behandelen als sequenties van patches. In plaats van pixels te verwerken via convolutionele lagen splitst ViT afbeeldingen op in patches met vaste grootte (meestal 16×16), vlakt elke patch af tot een vector en verwerkt de sequentie via transformerlagen.
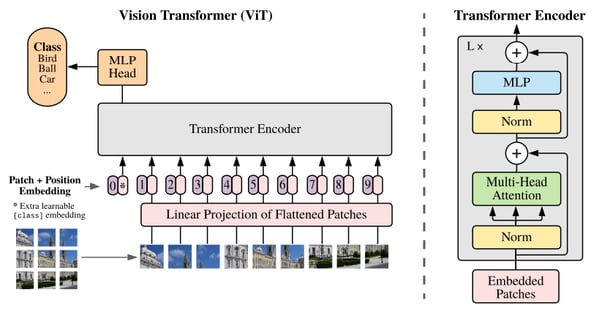
Vision Transformer
Deze aanpak legt globale relaties vast die de lokale receptieve velden van convolutionele netwerken kunnen missen. ViT en varianten behalen nu state-of-the-art resultaten in beeldclassificatie, objectdetectie, semantische segmentatie en andere velden:
- Medische beeldvorming: correlatie van subtiele afwijkingen over verschillende regio's van een scan.
- Analyse van satellietbeelden: koppeling van ver uit elkaar liggende kenmerken, zoals ontbossingslocaties, aan hun oorzaken.
Spraak, aanbevelingssystemen en multimodaal leren
Het nut van self-attention strekt zich uit tot spraakverwerking, waar het temporele afhankelijkheden in audiosequenties effectiever vastlegt dan recurrente modellen. In recommendatiesystemen helpt self-attention voorkeurspatronen van gebruikers te modelleren door aandacht te besteden aan relevante historische interacties.
Misschien het meest spannend zijn multimodale toepassingen die visie en taal combineren. Modellen zoals CLIP gebruiken cross-attention tussen beeld- en tekstrepresentaties, waardoor zero-shot beeldclassificatie en beeldgeneratie vanuit tekstbeschrijvingen mogelijk worden.
Wat al deze systemen gemeen hebben: ze demonstreren het fundamentele vermogen van self-attention om relaties te leren tussen elke sequentiële of gestructureerde data, ongeacht de modaliteit.
Geavanceerde varianten van self-attention en recente ontwikkelingen
Hoewel self-attention buitengewoon succesvol is in verschillende domeinen, ontstaan nieuwe uitdagingen bij het inzetten van transformermodellen op schaal. Naarmate modellen groeien tot miljarden parameters en contexten verwerken die oplopen tot in de honderdduizenden tokens, worden geheugendoorvoer en rekenkosten kritieke knelpunten.
De focus bij de ontwikkeling van nieuwe modellen ligt steeds meer op het sneller en efficiënter maken van self-attention zonder de kerncapaciteiten op te offeren. Deze spanning tussen capaciteit en efficiëntie vind ik een van de interessantste open problemen in het veld op dit moment. Laten we enkele recente ontwikkelingen bekijken.
Grouped-query en multi-query attention
Standaard multi-head attention behoudt aparte key- en valueprojecties per head, wat tijdens inferentie aanzienlijke geheugenoverhead creëert. Multi-query attention (MQA) vermindert dit door één key-value (KV)-head te delen over alle queryheads, waardoor de KV-cache sterk krimpt en het decoderen versnelt. MQA kan echter de kwaliteit aantasten.
Grouped-query attention (GQA) is een evenwichtigere aanpak, waarbij queryheads worden opgedeeld in groepen die key-valueparen delen. Met 32 queryheads en 8 groepen deelt elke groep van 4 queries één key-value-head. Zo gebruikt de Mistral 3-modellenfamilie deze aanpak en behaalt bijna full-attention-kwaliteit met aanzienlijke snelheidswinst.
Hybride architecturen die attention combineren met toestandsruimtemodellen
Hoewel GQA het geheugenefficiëntieprobleem aanpakt, pakt een andere onderzoekslijn de fundamentele rekenbottleneck van attention op een andere manier aan.
Recente werken verkennen het combineren van self-attention met toestandsruimtemodellen om de efficiëntie te verbeteren. Systemen zoals S4 en Hyena gebruiken gestructureerde toestandsruimtes om langeafstandscorrelaties te modelleren met lineaire in plaats van kwadratische complexiteit.
Deze benaderingen pakken de fundamentele beperking van self-attention aan: de rekenkosten schalen kwadratisch met de sequentielengte, wat extreem lange contexten onbetaalbaar maakt.
Schaalvergroting tijdens inferentie en optimalisatie op testtijd
Naast het heruitvinden van de architectuur zelf zijn er slimme manieren gevonden om bestaande attentionmechanismen te optimaliseren.
Naast architecturale veranderingen optimaliseren recente doorbraken attention tijdens inferentie. Kwantisatie verlaagt de KV-cacheprecisie naar 8 of 4 bits, wat het geheugen drastisch vermindert met minimale kwaliteitsverlies.
Flash Attention herstructureert het GPU-geheugentoegang om databeweging te minimaliseren, goed voor 2–3× snelheidswinst. Optimalisatie van rekenwerk op testtijd, waarbij modellen meerdere passes uitvoeren tijdens generatie, suggereert dat strategische toepassing van attention betere resultaten kan opleveren dan puur het vergroten van het model.
Conclusie
Self-attention is een van de meest transformerende mechanismen in de geschiedenis van machine learning. Door modellen in staat te stellen dynamisch te bepalen welke elementen van hun input de aandacht verdienen, loste het lang bestaande uitdagingen op in het vastleggen van langeafstandscorrelaties en het efficiënt verwerken van sequenties.
De wiskundige elegantie van scaled dot-product attention, versterkt door multi-headarchitecturen, biedt zowel theoretische degelijkheid als praktische effectiviteit.
Van het aandrijven van state-of-the-art taalmodellen tot het revolutioneren van computervisie en het mogelijk maken van multimodale AI-systemen — self-attention blijft zijn bereik uitbreiden. Recente innovaties in grouped-query attention, hybride architecturen en inferentie-optimalisatie laten zien dat we nog steeds nieuwe manieren ontdekken om dit mechanisme efficiënter en capabeler te maken.
Wil je de details induiken en hands-on oefenen? Schrijf je dan in voor onze skill track Developing Large Language Models.




Eind 2017 introduceerde een onderzoeksartikel getiteld Attention Is All You Need een revolutionair mechanisme dat kunstmatige intelligentie fundamenteel zou veranderen. De kern van deze doorbraak was self-attention: een simpel maar krachtig idee waarmee modellen relaties binnen data kunnen begrijpen door te bepalen welke elementen de aandacht verdienen.
Tegenwoordig drijft self-attention alles aan, van de conversatievaardigheden van ChatGPT tot geavanceerde systemen voor beeldherkenning. Het is zonder twijfel een van de meest transformerende innovaties in de geschiedenis van machine learning.
In deze gids neem ik je mee van de conceptuele basis van self-attention tot de toepassingen ervan, en laat ik zien hoe het mechanisme modellen helpt langeafstandscorrelaties vast te leggen en informatie parallel te verwerken — capaciteiten die eerder onbereikbaar waren met traditionele neurale netwerken.
Als je nieuw bent met transformers, overweeg dan een van onze introductiecursussen over Large Language Models (LLMs) Concepts en Transformer Models with PyTorch.
Wat is self-attention?
Uit mijn ervaring met het onderwijzen van dit concept is het beste startpunt een fundamentele uitdaging in sequentieverwerking: hoe kan een model bepalen welke delen van de input op een bepaald moment het meest relevant zijn?
Laten we beginnen met de intuïtie vóór we de wiskunde induiken.
Conceptueel begrip van self-attention
Self-attention is een mechanisme dat het belang van verschillende elementen in een sequentie ten opzichte van elkaar weegt. Bij het verwerken van de zin "The animal didn't cross the road because it was too tired" helpt self-attention het model te begrijpen dat "it" terugverwijst naar "animal" en niet naar "road" — een relatie die meerdere woorden overspant.
Dit is eigenlijk het voorbeeld dat ik altijd gebruik wanneer ik het concept introduceer bij studenten. Het valt meteen op z’n plek omdat het weerspiegelt hoe we van nature lezen.
Attentionmechanisme
Wat self-attention bijzonder krachtig maakt, is het vermogen om deze relaties voor alle posities in een sequentie tegelijk te berekenen. In tegenstelling tot recurrente neurale netwerken die sequenties stap voor stap verwerken, bekijkt self-attention elk element in relatie tot elk ander element in één enkele forward pass.
Deze parallelle berekening verkort de trainingstijd drastisch en legt afhankelijkheden vast, ongeacht hun afstand in de sequentie.
Het is belangrijk om self-attention te onderscheiden van aanverwante mechanismen. Bij self-attention richt een sequentie de aandacht op zichzelf. Elk element bevraagt informatie uit alle posities binnen dezelfde sequentie.
Cross-attention daarentegen laat de ene sequentie aandacht besteden aan een andere, zoals wanneer een decoder de encoderuitvoer bekijkt bij machinevertaling.
Gemaskerde self-attention voegt een extra beperking toe: posities mogen geen aandacht besteden aan latere posities, zodat voorspellingen alleen afhangen van bekende output — essentieel voor autoregressieve tekstgeneratie.
Maar waar komt dit idee eigenlijk vandaan, en welke problemen moest het oplossen?
Oorsprong en motivatie van self-attention
Voordat self-attention opkwam, kampte het vakgebied met aanzienlijke beperkingen in sequentiemodellering.
Recurrente neurale netwerken, inclusief LSTM's en GRU's, verwerken sequenties sequentieel, wat een fundamentele bottleneck veroorzaakt: ze hadden moeite met langeafstandscorrelaties omdat informatie door vele tussenliggende toestanden moest, wat leidde tot verdwijnende gradiënten en vergeten context.
De evolutie richting self-attention begon met attentionmechanismen in RNN-gebaseerde encoder-decoderarchitecturen. In 2014 introduceerden Bahdanau en collega's een attentionmechanisme waardoor decoders toegang kregen tot alle verborgen toestanden van de encoder in plaats van te vertrouwen op één contextvector met vaste lengte.
Deze doorbraak pakte het probleem van informatiecompressie aan, waarbij invoersequenties met variabele lengte werden samengeperst tot representaties met vaste lengte, ongeacht hun complexiteit.
Bahdanau's grafische illustratie van het voorgestelde model
Een jaar later stelde Luong vereenvoudigde attentionmechanismen voor, waaronder de scaled dot-product-aanpak die later de transformatorontwerp zou beïnvloeden. Hoewel deze vroege attentionmechanismen de prestaties verbeterden, bleven ze afhankelijk van sequentiële RNN-verwerking.
Globaal attentionmodel (Luong)
De echte revolutie kwam toen onderzoekers vroegen: wat als we recursie elimineren en uitsluitend op attention vertrouwen? Deze vraag leidde tot de transformerarchitectuur, waarin self-attention het primaire mechanisme werd voor het begrijpen van sequentierelaties.
Het wiskundige raamwerk van self-attention
Nu we hebben vastgesteld waarom self-attention ertoe doet, kijken we hoe het op wiskundig niveau werkt.
Query-, key- en value-representaties
Self-attention transformeert invoersequenties via drie geleerde projecties: queries, keys en values. Zie ze als verschillende "kijkhoeken" op dezelfde informatie, elk met een eigen rol in de attentionberekening.
Voor een invoersequentie met embeddingdimensie
d_modelmaken we drie gewichtsmatrices:W_Q,W_KenW_V. Door onze inputmatrixXmet deze gewichten te vermenigvuldigen, krijgen we:Querymatrix
Q = X · W_Q: staat voor "waar ben ik naar op zoek"Keymatrix
K = X · W_K: staat voor "wat bied ik aan"Valuematrix
V = X · W_V: staat voor "wat bevat ik daadwerkelijk"Ik vind deze bibliotheekanalogie handig: je loopt binnen met een query in gedachten, de indexkaarten zijn je keys en de echte boeken zijn je values.
Doorgaans projecteren deze matrices naar een kleinere dimensie
d_k(vaakd_modelgedeeld door het aantal attentionheads), wat de rekensom beheersbaar houdt terwijl de representatiekracht behouden blijft. Deze dimensionaliteitsreductie wordt vooral belangrijk bij het opschalen naar langere sequenties.Met Q, K en V op zak kunnen we nu de attention zelf berekenen.
Scaled dot-product attention
De attentionberekening volgt een elegante formule. Eerst berekenen we attentiescores via het inwendig product tussen queries en keys. Deze operatie meet de compatibiliteit tussen waar elke positie naar zoekt en wat elke andere positie aanbiedt.
Maar naarmate de dimensionaliteit toeneemt, kunnen deze inwendige producten erg groot worden, waardoor de softmaxfunctie in gebieden met extreem kleine gradiënten terechtkomt. Om deze numerieke instabiliteit te voorkomen, schalen we door te delen door de vierkantswortel van de keyedimensie.
Scaled dot-product attention
Deze schaalk factor behoudt een passende variantie door het netwerk, wat zorgt voor stabiele gradiënten tijdens training. Zonder deze factor zouden modellen met embeddings met hoge dimensies moeite hebben om effectief te leren, omdat softmax bijna one-hotverdelingen zou opleveren die aandacht niet zinvol verdelen.
Voor we verdergaan, is er één belangrijk gat dat we moeten dichten: positionele encodering.
Positionele encodering
Dit verraste me het meest toen ik dit voor het eerst bestudeerde: self-attention is volledig permutatie-invariant. Hussel de invoertokens door elkaar en je krijgt dezelfde output — alleen overeenkomstig gehusseld.
Het duurde even voordat ik het besefte: het mechanisme is krachtig, maar in wezen blind voor volgorde. Voor taken waarbij volgorde ertoe doet (zoals taalbegrip) moeten we positionele informatie expliciet injecteren.
De oorspronkelijke transformer gebruikte sinusvormige positie-encoderingen, met sinus- en cosinusfuncties van verschillende frequenties per dimensie. Deze keuze was niet arbitrair. De golvende patronen stellen modellen in staat te leren letten op relatieve posities, en de encodering strekt zich van nature uit naar niet eerder geziene sequentielengtes.
Visualisatie van positionele encodering
Recente innovaties omvatten RoPE (Rotary Position Embedding), dat query- en keyvectoren in een multidimensionale ruimte roteert met hoeken die evenredig zijn aan hun posities. Na rotatie codeert het inwendig product tussen queries en keys van nature relatieve afstand.
RoPE is wijdverbreid toegepast in modellen zoals LLaMA vanwege de sterke extrapolatiecapaciteiten.
Een andere benadering, ALiBi (Attention with Linear Biases), kiest een andere weg door positiebepaalde straffen rechtstreeks aan attentiescores toe te voegen. In plaats van embeddings te wijzigen, bevoordeelt ALiBi aandacht naar nabije tokens, waarbij de intensiteit van de bias varieert over verschillende attentionheads.
Deze methode laat indrukwekkende extrapolatie zien naar sequentielengtes die ver voorbij de trainingsomvang liggen.
Softmax en attentiongewichten
Na het berekenen van geschaalde attentiescores passen we softmax toe over de keyedimensie. Deze normalisatie zet rauwe scores om in een kansverdeling, zodat de attentiongewichten per querypositie optellen tot één.
De softmaxfunctie benadrukt de relaties met de hoogste score en onderdrukt irrelevante connecties. Dit kan echter soms leiden tot te scherpe verdelingen, vooral vroeg in de training wanneer het model nog geen genuanceerde aandachtspatronen heeft geleerd.
Om dit te beperken passen practitioners vaak dropout toe op attentiongewichten, waarbij sommige connecties willekeurig op nul worden gezet om robuustheid te stimuleren.
Contextvectoren berekenen
Met de attentiongewichten berekenen we de uiteindelijke output als een gewogen som van de valuevectoren.
Elke positie ontvangt een contextbewuste representatie die informatie uit de hele sequentie aggregeert, met bijdragen evenredig aan de attentiongewichten. Deze gewogen combinatie laat informatie dynamisch vloeien op basis van geleerde relaties in plaats van vaste patronen.
Berekening van contextvector
Single-head attention brengt je verrassend ver, maar kent een plafond. Hier wordt het interessanter.
Multi-head attention en meerdere representatiesubruimtes
Hoewel single-head attention krachtig is, kent het een fundamentele beperking: het kan slechts één type relatie tegelijk vastleggen.
Motivatie en architectuur
Multi-head attention pakt dit aan door meerdere attentionberekeningen parallel uit te voeren, die elk focussen op verschillende aspecten van de relaties in de input. Zo kan er bijvoorbeeld een head zijn die zich specialiseert in:
Wat ik heb gezien bij het werken met deze modellen: die specialisatie ontstaat vaak organisch tijdens de training. Je ontwerpt het niet — en dat vind ik een van de fascinerendste aspecten van het hele mechanisme.
Multi-head attention
De implementatie houdt in dat we de matrices
Q,KenVlangs de dimensie-as splitsen, elk deel door afzonderlijke attentionheads sturen en de resultaten concateneren.Als we 8 heads hebben en 512-dimensionale embeddings, werkt elke head op 64-dimensionale subruimtes. Deze parallelle verwerking verhoogt de complexiteit met betrekking tot sequentielengte niet, maar vergroot wel het vermogen van het model om diverse patronen te leren.
Wat verschillende heads leren
Onderzoek naar wat verschillende attentionheads daadwerkelijk leren, heeft fascinerende patronen onthuld.
In vertaalmodellen besteden sommige heads consequent aandacht aan positionele relaties en focussen ze op naburige woorden, ongeacht de inhoud. Andere heads specialiseren zich in syntactische rollen en herkennen subject-werkwoord- of werkwoord-objectrelaties. Een derde categorie richt zich op zeldzame of informatie-rijke tokens zoals eigennamen en vaktermen.
Interessant genoeg tonen interpreteerbaarheidsstudies aan dat veel heads redundant lijken, en dat modellen hun prestaties behouden zelfs wanneer een aanzienlijk deel van de heads wordt weggesnoeid. Deze redundantie draagt waarschijnlijk bij aan robuustheid, zodat kritieke patronen meerdere paden door het netwerk hebben.
Bij encoder-decoder-attention blijken heads in latere decoderlagen het belangrijkst voor vertaalkwaliteit, terwijl encoderself-attentionheads vaak substantieel kunnen worden gereduceerd.
Self-attention binnen de transformerarchitectuur
Met de wiskundige basis gelegd, bekijken we hoe self-attention integreert in de complete transformerarchitectuur.
De encoder: alles-op-alles-attention
In de transformerencoder laten self-attentionlagen elke positie aandacht besteden aan elke andere positie in de invoersequentie. Dit "alles-op-alles"-patroon maakt bidirectionele contextstroom mogelijk, waarbij elk token een representatie opbouwt die wordt geïnformeerd door de hele sequentie.
Encoderarchitectuur
Elke encoderlaag combineert multi-head self-attention met een positiegewijs feedforwardnetwerk. Het feedforwardnetwerk verwerkt elke positie onafhankelijk maar identiek, met dezelfde geleerde transformatie voor alle tokens.
Residu-verbindingen en layernormalisatie omringen beide sublagen, wat gradiënten stabiliseert en diepere architecturen mogelijk maakt. Door meerdere encoderlagen te stapelen ontstaan steeds abstracter wordende representaties: vroege lagen leggen oppervlakkige patronen vast en diepere lagen coderen semantische relaties.
De decoder: gemaskeerde attention en causaliteit
De decoder past self-attention aan om autoregressieve beperkingen te respecteren. Bij tekstgeneratie kan het model alleen conditioneren op tokens die het al heeft geproduceerd. Gluren naar toekomstige tokens zou tijdens training neerkomen op valsspelen.
Decoderarchitectuur
Gemaskeerde self-attention doet dit door attentiegewichten op min-infiniteit te zetten (wat na softmax nul wordt) voor alle posities na de huidige.
Dit zorgt ervoor dat voorspellingen alleen afhangen van eerdere context en dat de noodzakelijke causale ordening voor generatietaken behouden blijft. Tijdens inferentie wordt deze causaliteit vanzelfsprekend: we hébben de toekomstige tokens simpelweg nog niet om aandacht aan te besteden.
Cross-attention: de verbinding tussen encoder en decoder
Tussen de self-attentionlagen van de decoder ligt cross-attention, waarmee de decoder kan conditioneren op encoderuitvoer. Hier komen de queries uit de decoder ("wat moet ik genereren"), terwijl keys en values uit de encoder komen ("wat de input biedt").
Transformerarchitectuur
Dit cross-attentionmechanisme is essentieel voor sequence-to-sequencetaken zoals vertaling, waarbij de decoder uitvoerwoorden moet afstemmen op relevante invoerwoorden. In tegenstelling tot self-attention creëert cross-attention afhankelijkheden tussen twee verschillende sequenties, zodat informatie van bron naar doel kan stromen.
Los van de theorie: wat heeft self-attention in de praktijk mogelijk gemaakt? Het antwoord is breder dan de meeste mensen verwachten.
Toepassingen van self-attention in verschillende domeinen
Nu we hebben gezien hoe self-attention werkt binnen de transformerarchitectuur, bekijken we waar dit mechanisme impact heeft in de echte wereld.
Wat self-attention bijzonder waardevol maakt, is het domeinonafhankelijke karakter. Hetzelfde wiskundige raamwerk dat modellen helpt taalkundige relaties te begrijpen, kan ook patronen vastleggen in beelden, audio en zelfs combinaties van verschillende datatypen.
Naar mijn mening is juist die domeinonafhankelijkheid wat self-attention echt spannend maakt. Ik zou zeggen dat het minder een NLP-tool is en meer een algemeen mechanisme om relaties te leren.
Toepassingen in natural language processing
Transformermodellen blinken uit in het vastleggen van langeafstandscorrelaties die eerdere architecturen misten. In NLP drijft self-attention doorbraakmodellen aan voor vrijwel elke taak.
Zoals je in de onderstaande afbeelding ziet, verschilt de architectuur van de modellen afhankelijk van of de focus op de decoder of de encoder ligt.
Architectuurvergelijking: Transformer vs. GPT vs. BERT
Modellen zoals BERT gebruiken bidirectionele self-attention in hun encoder-only-architectuur, waardoor ze rijke contextuele representaties kunnen opbouwen voor classificatie- en begrijptaken.
GPT-modellen zoals de recent uitgebrachte GPT-5.3 Codex gebruiken gemaskeerde self-attention in hun alleen-decoderontwerp en bereiken opmerkelijke tekstgeneratiecapaciteiten.
T5 gebruikt de volledige encoder-decodertransformerarchitectuur en behandelt alle NLP-taken als text-to-textproblemen.
Toepassingen in computervisie
De aanpassing Vision Transformer (ViT) bracht self-attention naar computervisie door afbeeldingen te behandelen als sequenties van patches. In plaats van pixels te verwerken via convolutionele lagen splitst ViT afbeeldingen op in patches met vaste grootte (meestal 16×16), vlakt elke patch af tot een vector en verwerkt de sequentie via transformerlagen.
Vision Transformer
Deze aanpak legt globale relaties vast die de lokale receptieve velden van convolutionele netwerken kunnen missen. ViT en varianten behalen nu state-of-the-art resultaten in beeldclassificatie, objectdetectie, semantische segmentatie en andere velden:
Spraak, aanbevelingssystemen en multimodaal leren
Het nut van self-attention strekt zich uit tot spraakverwerking, waar het temporele afhankelijkheden in audiosequenties effectiever vastlegt dan recurrente modellen. In recommendatiesystemen helpt self-attention voorkeurspatronen van gebruikers te modelleren door aandacht te besteden aan relevante historische interacties.
Misschien het meest spannend zijn multimodale toepassingen die visie en taal combineren. Modellen zoals CLIP gebruiken cross-attention tussen beeld- en tekstrepresentaties, waardoor zero-shot beeldclassificatie en beeldgeneratie vanuit tekstbeschrijvingen mogelijk worden.
Wat al deze systemen gemeen hebben: ze demonstreren het fundamentele vermogen van self-attention om relaties te leren tussen elke sequentiële of gestructureerde data, ongeacht de modaliteit.
Geavanceerde varianten van self-attention en recente ontwikkelingen
Hoewel self-attention buitengewoon succesvol is in verschillende domeinen, ontstaan nieuwe uitdagingen bij het inzetten van transformermodellen op schaal. Naarmate modellen groeien tot miljarden parameters en contexten verwerken die oplopen tot in de honderdduizenden tokens, worden geheugendoorvoer en rekenkosten kritieke knelpunten.
De focus bij de ontwikkeling van nieuwe modellen ligt steeds meer op het sneller en efficiënter maken van self-attention zonder de kerncapaciteiten op te offeren. Deze spanning tussen capaciteit en efficiëntie vind ik een van de interessantste open problemen in het veld op dit moment. Laten we enkele recente ontwikkelingen bekijken.
Grouped-query en multi-query attention
Standaard multi-head attention behoudt aparte key- en valueprojecties per head, wat tijdens inferentie aanzienlijke geheugenoverhead creëert. Multi-query attention (MQA) vermindert dit door één key-value (KV)-head te delen over alle queryheads, waardoor de KV-cache sterk krimpt en het decoderen versnelt. MQA kan echter de kwaliteit aantasten.
Grouped-query attention (GQA) is een evenwichtigere aanpak, waarbij queryheads worden opgedeeld in groepen die key-valueparen delen. Met 32 queryheads en 8 groepen deelt elke groep van 4 queries één key-value-head. Zo gebruikt de Mistral 3-modellenfamilie deze aanpak en behaalt bijna full-attention-kwaliteit met aanzienlijke snelheidswinst.
Hybride architecturen die attention combineren met toestandsruimtemodellen
Hoewel GQA het geheugenefficiëntieprobleem aanpakt, pakt een andere onderzoekslijn de fundamentele rekenbottleneck van attention op een andere manier aan.
Recente werken verkennen het combineren van self-attention met toestandsruimtemodellen om de efficiëntie te verbeteren. Systemen zoals S4 en Hyena gebruiken gestructureerde toestandsruimtes om langeafstandscorrelaties te modelleren met lineaire in plaats van kwadratische complexiteit.
Deze benaderingen pakken de fundamentele beperking van self-attention aan: de rekenkosten schalen kwadratisch met de sequentielengte, wat extreem lange contexten onbetaalbaar maakt.
Schaalvergroting tijdens inferentie en optimalisatie op testtijd
Naast het heruitvinden van de architectuur zelf zijn er slimme manieren gevonden om bestaande attentionmechanismen te optimaliseren.
Naast architecturale veranderingen optimaliseren recente doorbraken attention tijdens inferentie. Kwantisatie verlaagt de KV-cacheprecisie naar 8 of 4 bits, wat het geheugen drastisch vermindert met minimale kwaliteitsverlies.
Flash Attention herstructureert het GPU-geheugentoegang om databeweging te minimaliseren, goed voor 2–3× snelheidswinst. Optimalisatie van rekenwerk op testtijd, waarbij modellen meerdere passes uitvoeren tijdens generatie, suggereert dat strategische toepassing van attention betere resultaten kan opleveren dan puur het vergroten van het model.
Conclusie
Self-attention is een van de meest transformerende mechanismen in de geschiedenis van machine learning. Door modellen in staat te stellen dynamisch te bepalen welke elementen van hun input de aandacht verdienen, loste het lang bestaande uitdagingen op in het vastleggen van langeafstandscorrelaties en het efficiënt verwerken van sequenties.
De wiskundige elegantie van scaled dot-product attention, versterkt door multi-headarchitecturen, biedt zowel theoretische degelijkheid als praktische effectiviteit.
Van het aandrijven van state-of-the-art taalmodellen tot het revolutioneren van computervisie en het mogelijk maken van multimodale AI-systemen — self-attention blijft zijn bereik uitbreiden. Recente innovaties in grouped-query attention, hybride architecturen en inferentie-optimalisatie laten zien dat we nog steeds nieuwe manieren ontdekken om dit mechanisme efficiënter en capabeler te maken.
Wil je de details induiken en hands-on oefenen? Schrijf je dan in voor onze skill track Developing Large Language Models.