Kurs
Python ile Deep Learning'e Giriş
4 sa
264.8K
Haftanın başında bir Facebook Live Code along oturumu gerçekleştirdim. Bu oturumda, romandaki en sık geçen sözcükleri çizmek için temel Doğal Dil İşleme yöntemleri kullandık: Moby Dick. Bunu yaparken, süreç odaklı kalarak aşağıdaki Veri Bilimi hattı (pipeline) üzerinden düşünmenin verimliliğini de gördük:
Bu yazıda, Moby Dick başta olmak üzere birçok romandaki sözcüklerin frekans dağılımlarını çizmek için bir veri bilimi hattı kurmayı öğreneceksiniz.
İpucu: Facebook Live’ı yeniden izlemek isterseniz aşağıdaki videoya göz atın; Hugo’nun yayına katıldığı ve oturumun başladığı 12. dakikaya atlayabilirsiniz.
Romanları size biz vermeyeceğiz: Python paketi requests kullanarak web sitesi Project Gutenberg’den (temelde büyük bir kitap korpusu) nasıl kazıyacağınızı ve bu web verisinden romanları BeautifulSoup ile nasıl çıkaracağınızı öğreneceksiniz. Ardından Doğal Dil Araç Takımı (nltk) ile romanları analiz etmeye dalacaksınız. Bu süreçte, tokenleştirme ve durak sözcükler (stopwords) gibi Doğal Dil İşleme’nin (NLP) önemli yönlerini öğreneceksiniz.
Sonuçta, Project Gutenberg’de bulabildiğiniz herhangi bir romanın sözcük frekans dağılımlarını görselleştirebileceksiniz. Geliştirdiğiniz NLP becerileri ise veri bilimcilerin karşılaştığı verilerin büyük bir kısmı yapılandırılmamış ve ciddi miktarda metin içerdiği için pek çok veride uygulanabilir olacaktır.
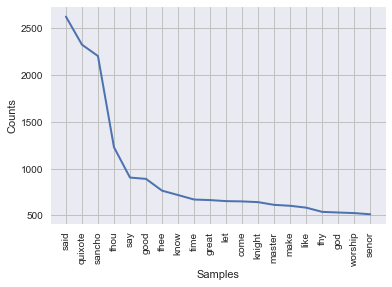
Örneğin, aşağıdaki sözcük frekans dağılımı hangi metinden olabilir?
Bu yazı bir Jupyter Notebook’tan üretildi; bu depoda bulabilirsiniz. Her türlü düşünce, yorum ve/veya fikirlerinizi benimle Twitter’da paylaşmaktan çekinmeyin: @hugobowne.
Sisteminizi kurmak ve hazır hale getirmek için README.md’deki talimatları izleyin.
Moby Dick romanında en sık geçen sözcükler nelerdir ve ne sıklıkta geçerler?
Ham veriniz, Melville’in Moby Dick romanının metnidir. Bu ~800 sözcüklük kitabın metnini Python’a nasıl alırsınız?
Bunu yapmanın birkaç yolu var ancak öncelikle metnin çevrimiçi olarak Project Gutenberg’de özgürce erişilebilir olduğunu fark edin. Oraya gidelim, Moby Dick’i bulmayı deneyelim ve ilgili URL’yi Python ad alanınıza kaydedelim:
# Store url
url = 'https://www.gutenberg.org/files/2701/2701-h/2701-h.htm'
Artık URL sizde olduğuna göre, sitenin HTML’sini getirmeniz gerekiyor.
Not: HTML, Hypertext Markup Language’ın kısaltmasıdır ve web için standart işaretleme dilidir.
Bunu yapmak için en popüler ve kullanışlı Python paketlerinden biri olan requests’ı kullanacaksınız. Daha fazlasını DataCamp’in Importing Data in Python (Part 2) kursunda bulabilirsiniz.
requests paketinin websitesine göre:
Requests, organik, otla beslenmiş HTTP/1.1 istekleri göndermenizi sağlar; üstelik el emeğine gerek yoktur.
ve aşağıdaki kuruluşlar iç bünyelerinde requests kullandıklarını belirtmektedir:
Majestelerinin Hükümeti, Amazon, Google, Twilio, NPR, Obama for America, Twitter, Sony ve isminin açıklanmasını tercih etmeyen ABD Federal kurumları.
Ayrıca,
Requests, tüm zamanların en çok indirilen Python paketlerinden biridir; her ay 13.000.000’dan fazla indirme alır. Tüm havalı çocuklar bunu yapıyor!
Web sitesinden bir GET isteği yapacaksınız; bu, ondan veri aldığınız anlamına gelir. Bir web sayfasını tarayıcıyla ziyaret ettiğinizde yaptığınız da budur. POST gibi başka istek türleri de vardır ama burada onlarla ilgilenmeyeceğiz.
requests, get işleviyle bunu kolaylaştırır. İsteği burada yapın ve dönen nesnenin türünü kontrol edin.
# Import `requests`
import requests

# Make the request and check object type
r = requests.get(url)
type(r)
requests.models.Response
Bu bir Response nesnesidir. requests hızlı başlangıç kılavuzunda bir Response nesnesinin HTML’i almanızı sağlayan bir text özniteliği olduğunu görebilirsiniz! Bunu yapalım ve HTML’i yazdırıp göz atalım:
# Extract HTML from Response object and print
html = r.text
#print(html)
Tamam! Bu HTML tam olarak istediğiniz şey değil. Ancak istediğiniz şeyi içeriyor: Moby Dick’in metni. Şimdi yapmanız gereken, romanı çıkarmak için bu HTML’i düzenlemek.
Burada BeautifulSoup paketini kullanacaksınız. Paket sitesinde şöyle diyor:
Oldukça umut verici görünüyor!
Öncelikle paket adından söz edelim: Beautiful Soup? Web geliştirmede “tag soup” terimi, bir web sayfası için yapısal veya sözdizimsel olarak hatalı yazılmış HTML kodunu ifade eder. Beautiful Soup’un en iyi yaptığı şey, bu “etiket çorbasını” yeniden güzelleştirmek ve içinden bilgiyi kolayca çıkarmaktır! Nitekim bu paketi kullanırken oluşturulan ve sorgulanan ana nesne BeautifulSoup olarak adlandırılır. Çorbayı (soup) oluşturduktan sonra, metni çıkarmak için .get_text() yöntemini kullanabiliriz.
# Import BeautifulSoup from bs4
from bs4 import BeautifulSoup


# Create a BeautifulSoup object from the HTML
soup = BeautifulSoup(html, "html5lib")
type(soup)
bs4.BeautifulSoup
Bu soup nesnelerinden, başlık gibi kazıdığınız web sitesi hakkında ilginç her türlü bilgiyi çıkarabilirsiniz:
# Get soup title
soup.title
<title>
      Moby Dick; Or the Whale, by Herman Melville
    </title>
Ya da başlığı bir dize olarak:
# Get soup title as string
soup.title.string
'\n Moby Dick; Or the Whale, by Herman Melville\n '
Ya da bir sayfadaki < a > etiketleri (köprüler) içinde bulunan tüm URL’ler:
# Get hyperlinks from soup and check out first several
soup.findAll('a')[:8]
[<a href="#link2H_4_0002"> ETYMOLOGY. </a>,
 <a href="#link2H_4_0003"> EXTRACTS (Supplied by a Sub-Sub-Librarian).
         </a>,
 <a href="#link2HCH0001"> CHAPTER 1. Loomings. </a>,
 <a href="#link2HCH0002"> CHAPTER 2. The Carpet-Bag. </a>,
 <a href="#link2HCH0003"> CHAPTER 3. The Spouter-Inn. </a>,
 <a href="#link2HCH0004"> CHAPTER 4. The Counterpane. </a>,
 <a href="#link2HCH0005"> CHAPTER 5. Breakfast. </a>,
 <a href="#link2HCH0006"> CHAPTER 6. The Street. </a>]
İstediğiniz şey, soup içinden metni çıkarmak ve bunun için tam da buna yönelik son derece faydalı bir .get_text() yöntemi var.
Metni alın, yazdırın ve bir bakın. İstediğiniz şey bu mu?
# Get the text out of the soup and print it
text = soup.get_text()
#print(text)
Dikkat edin, bu artık neredeyse istediğiniz şeye dönüştü.
Romanın metni, başında ve sonunda istenmeyen bazı şeylerle birlikte geliyor. İsterseniz bunları kaldırabilirsiniz. Ancak bu içerik miktarı, Moby Dick’in metnine göre çok daha küçük olduğundan ilk yaklaşım olarak bırakmakta sakınca yok; burada da bu yaklaşım benimsenecek. Daha sağlam sonuçlar için kaldırmanızı öneririm.
Artık ilgi duyduğunuz metin sizde olduğuna göre, her sözcüğün kaç kez geçtiğini saymanın ve istediğiniz frekans histogramını çizmenin zamanı geldi: İmdada Doğal Dil İşleme yetişiyor!
Şimdi nltk, yani Doğal Dil Araç Takımı’nı kullanarak
Metninizi tokenleştirmek, yani onu bir sözcük listesine bölmek istiyorsunuz. Özünde, boşluklarla ayrılmış metin parçalarını ayırmak istiyorsunuz.
Bunu yapmak için düzenli ifadeler denilen güçlü bir araç kullanacaksınız. Düzenli ifade ya da kısaca regex, bir arama desenini tanımlayan bir karakter dizisidir. Ünlü şekilde kafa karıştırıcıdırlar ve en iyi örnekle tanıtılırlar.
'p' ile başlayan tüm sözcükleri eşleyen düzenli ifade 'p\w+'dır. Bunu açalım:
Bunların hepsini bir araya getirdiğinizde, 'p\w+' düzenli ifadesi 'p' ile başlayan ve ardından alfasayısal karakterler ve alt çizgiler gelen tüm alt dizileri eşler. Anlamlı çoğu İngilizce metinde bu, 'p' ile başlayan sözcüklere karşılık gelir.
Şimdi yer ısındırma olarak, yerleşik Python paketi re’yi kullanarak 'peter piper picked a peck of pickled peppers' cümlesinden 'p' ile başlayan tüm sözcükleri çıkaracaksınız.
# Import regex package
import re

# Define sentence
sentence = 'peter piper pick a peck of pickled peppers'

# Define regex
ps = 'p\w+'


# Find all words in sentence that match the regex and print them
re.findall(ps, sentence)
['peter', 'piper', 'pick', 'peck', 'pickled', 'peppers']
Oldukça iyi görünüyor. Şimdi, 'p\w+' 'p' ile başlayan sözcükleri eşleyen regex ise, tüm sözcükleri eşleyen regex nedir?
Şimdi bunu yukarıdaki oyuncak Peter Piper cümlesi için yapma sırası sizde.
# Find all words and print them
re.findall('\w+', sentence)
['peter', 'piper', 'pick', 'a', 'peck', 'of', 'pickled', 'peppers']
Şimdi aynı şeyi Moby Dick metnini içeren text üzerinde yapabilirsiniz:
# Find all words in Moby Dick and print several
tokens = re.findall('\w+', text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Not: Bunu, Doğal Dil Araç Takımı olan nltk ile yapmanın bir yolu daha var:
# Import RegexpTokenizer from nltk.tokenize
from nltk.tokenize import RegexpTokenizer

# Create tokenizer
tokenizer = RegexpTokenizer('\w+')


# Create tokens
tokens = tokenizer.tokenize(text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Tamam! Neredeyse bitti. Ancak yukarıda 'Or' sözcüğünün büyük 'O' ile yazıldığına ve başka yerlerde öyle olmayabileceğine dikkat edin; ancak hem 'Or' hem 'or' aynı sözcük olarak sayılmalı. Bu nedenle, Moby Dick’teki tüm sözcüklerin büyük harflerinin küçültüldüğü bir liste oluşturmanız gerekecek. .lower() dize yöntemini faydalı bulacaksınız:
# Initialize new list
words = []


# Loop through list tokens and make lower case
for word in tokens:
    words.append(word.lower())


# Print several items from list as sanity check
words[:8]
['moby', 'dick', 'or', 'the', 'whale', 'by', 'herman', 'melville']
İngilizcede çok sık geçen 'the', 'of' ve 'a' gibi sözcükleri (durak sözcükler) kaldırmak yaygın bir uygulamadır; çünkü o kadar da ilginç değillerdir. Bu tekniklerin tümü hakkında daha fazlası için Python ile Doğal Dil İşleme Temelleri kursumuza göz atın.
nltk paketinde İngilizce durak sözcüklerin bir listesi bulunur; bunu şimdi sw olarak saklayacak ve ilk birkaç öğesini yazdıracaksınız.
Burada bir hata alırsanız, sisteminize durak sözcükleri kurmak için nltk.download('stopwords') komutunu çalıştırın.
# Import nltk
import nltk

# Get English stopwords and print some of them
sw = nltk.corpus.stopwords.words('english')
sw[:5]
['i', 'me', 'my', 'myself', 'we']
words içindeki ve sw içinde olmayan tüm sözcüklerin listesini istiyorsunuz. Bunu elde etmenin bir yolu, words’ün tüm öğeleri üzerinde döngü kurmak ve eğer sw içinde değillerse yeni bir listeye eklemektir:
# Initialize new list
words_ns = []

# Add to words_ns all words that are in words but not in sw
for word in words:
    if word not in sw:
        words_ns.append(word)

# Print several list items as sanity check
words_ns[:5]
['moby', 'dick', 'whale', 'herman', 'melville']
Sorumuz şuydu: 'Moby Dick romanında en sık geçen sözcükler nelerdir ve ne sıklıkta geçerler?'
Artık nltk kullanarak Moby Dick’teki sözcüklerin bir frekans histogramını iki satır kodla çizebilirsiniz. Bunu yapmak için,
nltk.FreqDist() işlevini kullanarak bir frekans dağılımı nesnesi oluşturursunuz;plot() yöntemini kullanırsınız.#Import datavis libraries
import matplotlib.pyplot as plt
import seaborn as sns
# Figures inline and set visualization style
%matplotlib inline
sns.set()
# Create freq dist and plot
freqdist1 = nltk.FreqDist(words_ns)
freqdist1.plot(25)
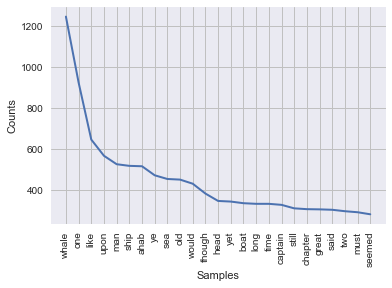
Güzel olan şu ki, sorumuza yanıt vermek için nltk’yi kullanırken, aslında çözümümüzü başkalarına aktarılabilir bir şekilde de sunduk: bir frekans dağılım grafiği! En yaygın sözcükleri ve frekanslarını buradan okuyabilirsiniz. Örneğin, durak sözcükleri hariç tutarsak 'whale' romandaki en yaygın sözcüktür (tahmin edersiniz) ve tam >1200 kez geçer!
Project Gutenberg’de pek çok roman olduğunu ve bunların sözcük frekans histogramlarını çıkarabildiğinizi gördüğünüze göre, tüm bunları yapan kendi işlevinizi yazmak mantıklı:
 def plot_word_freq(url):
    """Takes a url (from Project Gutenberg) and plots a word frequency
    distribution"""
    # Make the request and check object type
    r = requests.get(url)
    # Extract HTML from Response object and print
    html = r.text
    # Create a BeautifulSoup object from the HTML
    soup = BeautifulSoup(html, "html5lib")
    # Get the text out of the soup and print it
    text = soup.get_text()
    # Create tokenizer
    tokenizer = RegexpTokenizer('\w+')
    # Create tokens
    tokens = tokenizer.tokenize(text)
    # Initialize new list
    words = []
    # Loop through list tokens and make lower case
    for word in tokens:
        words.append(word.lower())
    # Get English stopwords and print some of them
    sw = nltk.corpus.stopwords.words('english')
    # Initialize new list
    words_ns = []
    # Add to words_ns all words that are in words but not in sw
    for word in words:
        if word not in sw:
            words_ns.append(word)
    # Create freq dist and plot
    freqdist1 = nltk.FreqDist(words_ns)
    freqdist1.plot(25)
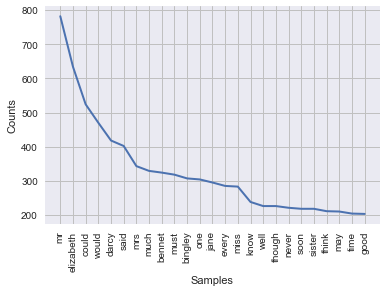
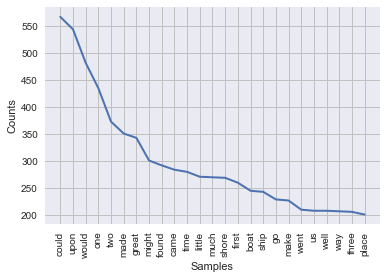
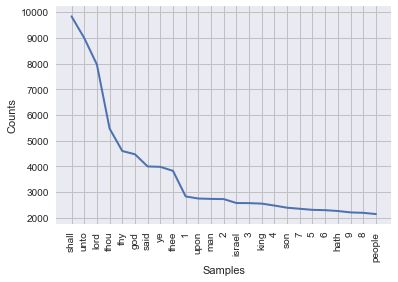
Şimdi bu işlevi kullanarak Project Gutenberg’deki diğer metinlerden sözcük frekans dağılımlarını çizin:
plot_word_freq('https://www.gutenberg.org/files/42671/42671-h/42671-h.htm')
plot_word_freq('https://www.gutenberg.org/files/521/521-h/521-h.htm')
plot_word_freq('https://www.gutenberg.org/files/10/10-h/10-h.htm')
Bu yazıda, Moby Dick başta olmak üzere birçok romandaki sözcüklerin frekans dağılımlarını çizmek için bir Veri Bilimi hattı kurmayı öğrendiniz. Romanları Python paketi requests kullanarak Project Gutenberg (geniş kitap korpusu) sitesinden nasıl kazıyacağınızı ve bu web verisinden BeautifulSoup ile romanları nasıl çıkaracağınızı öğrendiniz. Ardından Doğal Dil Araç Takımı (nltk) ile romanları analiz etmeye giriştiniz. Bu süreçte tokenleştirme ve durak sözcükler gibi Doğal Dil İşleme’nin (NLP) önemli yönlerini öğrendiniz. Artık Project Gutenberg’de bulabildiğiniz herhangi bir romanın sözcük frekans dağılımlarını görselleştirebiliyorsunuz. Geliştirdiğiniz NLP becerileri, veri bilimcilerin karşılaştığı verilerin büyük bir kısmı yapılandırılmamış ve ciddi miktarda metin içerdiği için, pek çok veride de geçerlidir.
Bu yazı bir Jupyter Notebook’tan üretildi; bu depoda bulabilirsiniz. Her türlü düşünce, yorum ve/veya fikirlerinizi benimle Twitter’da paylaşmaktan çekinmeyin: @hugobowne. Oluşturduğunuz havalı projeleri bana bildirin.
DataCamp’in Python (ve Beautiful Soup) kullanarak Web Kazıma ve Python ile Amazon’u Nasıl Kazırsınız eğitimlerine göz atın.
Python hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




