Cours
Introduction au Deep Learning en Python
4 h
264.6K
Plus tôt cette semaine, j'ai animé une session Facebook Live de code en direct. Nous y avons utilisé des techniques simples de traitement du langage naturel pour tracer les mots les plus fréquents du roman Moby Dick. Au passage, nous avons montré l'efficacité d'une démarche Data Science structurée autour du pipeline suivant, en gardant constamment le processus en tête :
Dans cet article, vous allez apprendre à construire un pipeline data science pour tracer les distributions de fréquence des mots dans Moby Dick et dans bien d'autres romans.
Astuce : si vous souhaitez revoir le Facebook Live, regardez la vidéo ci-dessous ; vous pouvez passer directement à la 12e minute, quand Hugo commence et que la session démarre vraiment.
Nous ne vous fournirons pas les romans : vous apprendrez à les extraire vous‑même depuis le site Project Gutenberg (qui constitue un vaste corpus de livres) à l'aide du package Python requests, puis à récupérer le texte des pages avec BeautifulSoup. Ensuite, vous passerez à l'analyse des romans avec le Natural Language ToolKit (nltk). Au passage, vous découvrirez des notions clés du traitement du langage naturel (NLP) comme la tokenisation et les stopwords.
À la fin, vous saurez visualiser les distributions de fréquence des mots de n'importe quel roman disponible sur Project Gutenberg. Les compétences NLP développées ici s'appliquent d'ailleurs à une grande partie des données auxquelles les data scientists sont confrontés, la majorité des données mondiales étant non structurées et largement textuelles.
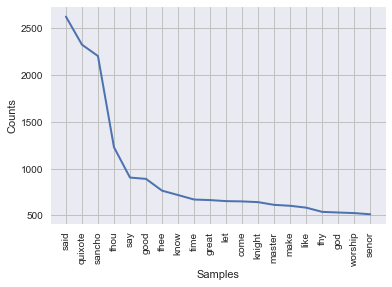
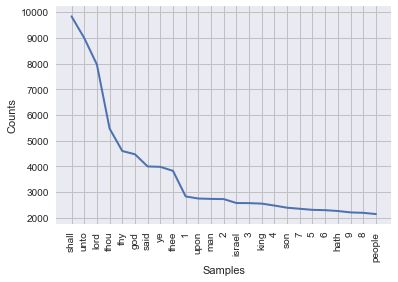
Par exemple, de quel texte pourrait provenir la distribution de fréquence suivante ?
Cet article a été généré à partir d'un Jupyter Notebook ; vous pouvez le retrouver dans ce dépôt. Si vous avez des idées, des questions ou des réflexions, contactez‑moi sur Twitter : @hugobowne.
Suivez les instructions du README.md pour préparer votre environnement.
Quels sont les mots les plus fréquents dans le roman Moby Dick et à quelle fréquence apparaissent‑ils ?
Votre donnée brute est le texte du roman Moby Dick de Melville. Comment importer dans Python le texte de ce livre d’environ 800 pages ?
Plusieurs options existent, mais notez d'abord que le texte est disponible gratuitement en ligne sur Project Gutenberg. Allons‑y, cherchons Moby Dick puis stockons l'URL correspondante dans votre espace de travail Python :
# Store url
url = 'https://www.gutenberg.org/files/2701/2701-h/2701-h.htm'
Maintenant que vous avez l'URL, il faut récupérer le HTML de la page.
Remarque : HTML signifie HyperText Markup Language, le langage de balisage standard du web.
Vous allez utiliser requests pour cela, l'un des packages Python les plus populaires et utiles. Pour en savoir plus, consultez le cours DataCamp Importing Data in Python (Part 2).
D'après le site du package requests :
Requests vous permet d'envoyer des requêtes HTTP/1.1 « organiques », sans prise de tête, et sans travail manuel.
et les organisations suivantes déclarent utiliser requests en interne :
Her Majesty's Government, Amazon, Google, Twilio, NPR, Obama for America, Twitter, Sony, et des institutions fédérales américaines préférant rester anonymes.
Par ailleurs,
Requests est l'un des packages Python les plus téléchargés de tous les temps, avec plus de 13 000 000 de téléchargements par mois. Tous les geeks l'utilisent !
Vous allez effectuer une requête GET sur le site, c'est‑à‑dire récupérer des données. C'est ce que fait votre navigateur quand vous visitez une page web. Il existe d'autres types de requêtes, comme POST, mais nous n'en parlerons pas ici.
requests simplifie cela grâce à sa fonction get. Faites la requête et vérifiez le type d'objet renvoyé.
# Import `requests`
import requests

# Make the request and check object type
r = requests.get(url)
type(r)
requests.models.Response
C'est un objet Response. Le guide de démarrage de requests indique qu'un objet Response possède un attribut text qui permet de récupérer le HTML ! Faisons‑le et affichons le HTML pour vérifier :
# Extract HTML from Response object and print
html = r.text
#print(html)
Très bien ! Ce HTML n'est pas exactement ce dont vous avez besoin. Mais il contient ce que vous cherchez : le texte de Moby Dick. Il faut maintenant préparer ce HTML pour en extraire le roman.
Ici, vous allez utiliser le package BeautifulSoup. Le site du package annonce :
Prometteur !
Un mot sur le nom du package : Beautiful Soup ? En développement web, « tag soup » désigne un HTML mal structuré ou incorrect. Beautiful Soup excelle à remettre de l'ordre dans cette « soupe » et à en extraire facilement l'information. L'objet principal que l'on crée et interroge avec ce package s'appelle justement BeautifulSoup. Une fois la soupe créée, sa méthode .get_text() permet d'extraire le texte.
# Import BeautifulSoup from bs4
from bs4 import BeautifulSoup


# Create a BeautifulSoup object from the HTML
soup = BeautifulSoup(html, "html5lib")
type(soup)
bs4.BeautifulSoup
À partir de ces objets soup, vous pouvez extraire toutes sortes d'informations intéressantes sur la page que vous scrapez, par exemple le titre :
# Get soup title
soup.title
<title>
      Moby Dick; Or the Whale, by Herman Melville
    </title>
Ou le titre sous forme de chaîne de caractères :
# Get soup title as string
soup.title.string
'\n Moby Dick; Or the Whale, by Herman Melville\n '
Ou encore toutes les URL trouvées dans les balises < a > (hyperliens) d'une page :
# Get hyperlinks from soup and check out first several
soup.findAll('a')[:8]
[<a href="#link2H_4_0002"> ETYMOLOGY. </a>,
 <a href="#link2H_4_0003"> EXTRACTS (Supplied by a Sub-Sub-Librarian).
         </a>,
 <a href="#link2HCH0001"> CHAPTER 1. Loomings. </a>,
 <a href="#link2HCH0002"> CHAPTER 2. The Carpet-Bag. </a>,
 <a href="#link2HCH0003"> CHAPTER 3. The Spouter-Inn. </a>,
 <a href="#link2HCH0004"> CHAPTER 4. The Counterpane. </a>,
 <a href="#link2HCH0005"> CHAPTER 5. Breakfast. </a>,
 <a href="#link2HCH0006"> CHAPTER 6. The Street. </a>]
Ce que vous voulez maintenant, c'est extraire le texte de soup, et la méthode .get_text() est parfaite pour cela.
Récupérez le texte, affichez‑le et examinez‑le. Est‑ce bien ce qu'il vous faut ?
# Get the text out of the soup and print it
text = soup.get_text()
#print(text)
Vous remarquerez que vous vous rapprochez du but.
Il s'agit bien du texte du roman, avec quelques éléments indésirables au début et à la fin. Vous pourriez les supprimer. Cependant, ces éléments sont négligeables par rapport au volume de Moby Dick ; dans un premier temps, on peut les laisser, ce que nous ferons ici. Pour des résultats plus robustes, je vous recommande de les retirer.
Maintenant que vous avez le texte, il est temps de compter le nombre d'occurrences de chaque mot et de tracer l'histogramme de fréquences souhaité : place au traitement du langage naturel !
Vous allez maintenant utiliser nltk, le Natural Language Toolkit, pour :
Vous souhaitez tokeniser votre texte, c'est‑à‑dire le découper en une liste de mots. Concrètement, il s'agit de séparer les segments de texte délimités par des espaces.
Pour cela, vous allez utiliser un outil puissant : les expressions régulières. Une expression régulière, ou regex, est une séquence de caractères qui définit un motif de recherche. Elles sont réputées ardues et s'apprennent mieux par l'exemple.
L'expression régulière qui correspond à tous les mots commençant par « p » est « p\w+ ». Détaillons :
Assemblé, « p\w+ » matche donc tous les sous‑chaînes qui commencent par « p » et sont suivies de caractères alphanumériques et underscores. Dans la plupart des textes anglais cohérents, cela correspondra aux mots commençant par « p ».
Vous allez maintenant utiliser le module Python re pour extraire tous les mots commençant par « p » de la phrase « peter piper picked a peck of pickled peppers » pour vous échauffer.
# Import regex package
import re

# Define sentence
sentence = 'peter piper pick a peck of pickled peppers'

# Define regex
ps = 'p\w+'


# Find all words in sentence that match the regex and print them
re.findall(ps, sentence)
['peter', 'piper', 'pick', 'peck', 'pickled', 'peppers']
Plutôt convaincant. Maintenant, si « p\w+ » matche les mots commençant par « p », quelle regex matche tous les mots ?
À vous de jouer sur notre phrase d'exemple Peter Piper ci‑dessus.
# Find all words and print them
re.findall('\w+', sentence)
['peter', 'piper', 'pick', 'a', 'peck', 'of', 'pickled', 'peppers']
Vous pouvez maintenant faire la même chose avec text, la chaîne qui contient Moby Dick :
# Find all words in Moby Dick and print several
tokens = re.findall('\w+', text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Remarque : il existe aussi une manière de le faire avec nltk, le Natural Language Toolkit :
# Import RegexpTokenizer from nltk.tokenize
from nltk.tokenize import RegexpTokenizer

# Create tokenizer
tokenizer = RegexpTokenizer('\w+')


# Create tokens
tokens = tokenizer.tokenize(text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Parfait ! Vous y êtes presque. Notez toutefois que, ci‑dessus, « Or » est en majuscule, alors qu'ailleurs il peut apparaître en minuscule ; vous voudrez compter « Or » et « or » comme le même mot. Pour cette raison, il faut construire une liste de tous les mots de Moby Dick en minuscules. La méthode de chaîne .lower() sera utile :
# Initialize new list
words = []


# Loop through list tokens and make lower case
for word in tokens:
    words.append(word.lower())


# Print several items from list as sanity check
words[:8]
['moby', 'dick', 'or', 'the', 'whale', 'by', 'herman', 'melville']
Il est d'usage de retirer les mots très fréquents en anglais comme « the », « of » ou « a » (appelés stopwords), car ils sont peu informatifs. Pour approfondir ces techniques, consultez notre cours Natural Language Processing Fundamentals in Python.
Le package nltk propose une liste de stopwords en anglais que vous allez stocker dans sw et dont vous afficherez les premiers éléments.
Si vous obtenez une erreur, exécutez la commande nltk.download('stopwords') pour installer les stopwords sur votre système.
# Import nltk
import nltk

# Get English stopwords and print some of them
sw = nltk.corpus.stopwords.words('english')
sw[:5]
['i', 'me', 'my', 'myself', 'we']
Vous voulez la liste de tous les mots de words qui ne sont pas dans sw. Une façon de l'obtenir consiste à boucler sur words et à ajouter à une nouvelle liste ceux qui ne sont pas dans sw :
# Initialize new list
words_ns = []

# Add to words_ns all words that are in words but not in sw
for word in words:
    if word not in sw:
        words_ns.append(word)

# Print several list items as sanity check
words_ns[:5]
['moby', 'dick', 'whale', 'herman', 'melville']
Notre question était : « Quels sont les mots les plus fréquents dans le roman Moby Dick et à quelle fréquence apparaissent‑ils ? »
Vous pouvez maintenant tracer, en deux lignes de code, un histogramme de fréquence des mots de Moby Dick avec nltk. Pour cela :
nltk.FreqDist() ;plot() de l'objet résultant.#Import datavis libraries
import matplotlib.pyplot as plt
import seaborn as sns
# Figures inline and set visualization style
%matplotlib inline
sns.set()
# Create freq dist and plot
freqdist1 = nltk.FreqDist(words_ns)
freqdist1.plot(25)
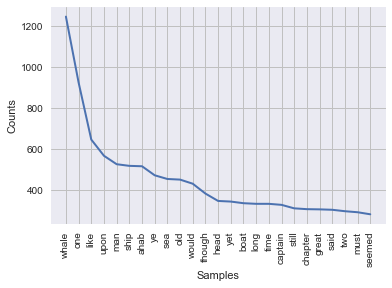
L'avantage, en utilisant nltk pour répondre à notre question, c'est que nous avons déjà présenté la solution d'une manière facilement communicable : un graphique de distribution des fréquences ! On peut lire directement les mots les plus courants et leur fréquence. Par exemple, « whale » est le mot le plus fréquent du roman (sans surprise), hors stopwords, avec plus de 1 200 occurrences !
Comme Project Gutenberg contient de nombreux romans sur lesquels tracer ces histogrammes de fréquence, il est pertinent d'écrire votre propre fonction qui automatise tout cela :
 def plot_word_freq(url):
    """Takes a url (from Project Gutenberg) and plots a word frequency
    distribution"""
    # Make the request and check object type
    r = requests.get(url)
    # Extract HTML from Response object and print
    html = r.text
    # Create a BeautifulSoup object from the HTML
    soup = BeautifulSoup(html, "html5lib")
    # Get the text out of the soup and print it
    text = soup.get_text()
    # Create tokenizer
    tokenizer = RegexpTokenizer('\w+')
    # Create tokens
    tokens = tokenizer.tokenize(text)
    # Initialize new list
    words = []
    # Loop through list tokens and make lower case
    for word in tokens:
        words.append(word.lower())
    # Get English stopwords and print some of them
    sw = nltk.corpus.stopwords.words('english')
    # Initialize new list
    words_ns = []
    # Add to words_ns all words that are in words but not in sw
    for word in words:
        if word not in sw:
            words_ns.append(word)
    # Create freq dist and plot
    freqdist1 = nltk.FreqDist(words_ns)
    freqdist1.plot(25)
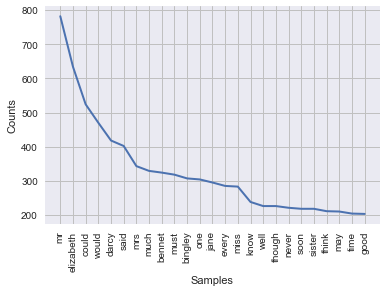
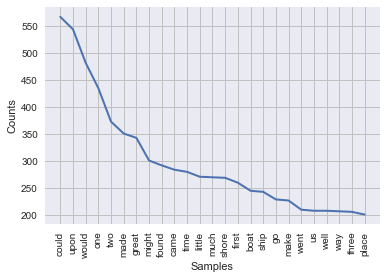
Utilisez maintenant la fonction pour tracer les distributions de fréquence d'autres textes de Project Gutenberg :
plot_word_freq('https://www.gutenberg.org/files/42671/42671-h/42671-h.htm')
plot_word_freq('https://www.gutenberg.org/files/521/521-h/521-h.htm')
plot_word_freq('https://www.gutenberg.org/files/10/10-h/10-h.htm')
Dans cet article, vous avez appris à construire un pipeline Data Science pour tracer les distributions de fréquence des mots dans Moby Dick et bien d'autres romans. Vous avez vu comment les extraire depuis Project Gutenberg (vaste corpus de livres) avec le package Python requests et comment récupérer le texte des pages web avec BeautifulSoup. Vous avez ensuite analysé les romans avec le Natural Language ToolKit (nltk). Au passage, vous avez découvert des notions importantes du NLP, comme la tokenisation et les stopwords. Vous pouvez désormais visualiser la distribution de fréquence des mots de n'importe quel roman trouvé sur Project Gutenberg. Ces compétences en NLP s'appliquent aussi à une grande partie des données auxquelles les Data Scientists sont confrontés, la majorité des données mondiales étant non structurées et très textuelles.
Cet article a été généré à partir d'un Jupyter Notebook ; vous pouvez le retrouver dans ce dépôt. Si vous avez des idées, des questions ou des réflexions, écrivez‑moi sur Twitter : @hugobowne. Dites‑moi quels projets sympas vous réalisez.
Découvrez les tutoriels de DataCamp Web scraping using Python (and Beautiful Soup) et How to Use Python to Scrape Amazon.
En savoir plus sur Python
Cours
Cours
Cours