Khóa học
Nhập môn Deep Learning với Python
4 giờ
264.8K
Đầu tuần này, tôi đã thực hiện một buổi Facebook Live Code along. Trong đó, chúng tôi dùng một số kỹ thuật Xử lý ngôn ngữ tự nhiên cơ bản để vẽ biểu đồ những từ xuất hiện thường xuyên nhất trong tiểu thuyết Moby Dick. Qua đó, bạn cũng sẽ thấy hiệu quả của việc tư duy theo quy trình sau trong Khoa học dữ liệu, luôn coi trọng tính hệ thống:
Trong bài viết này, bạn sẽ học cách xây dựng một pipeline khoa học dữ liệu để vẽ phân phối tần suất các từ trong Moby Dick, cũng như nhiều tiểu thuyết khác.
Mẹo: nếu bạn muốn xem lại buổi Facebook Live, hãy xem video sau; Bạn có thể tua đến phút 12 nơi Hugo xuất hiện và buổi học chính thức bắt đầu.
Chúng tôi sẽ không cung cấp sẵn các tiểu thuyết: bạn sẽ học cách thu thập chúng từ trang Project Gutenberg (về cơ bản là một kho sách lớn) bằng gói Python requests và cách trích xuất tiểu thuyết từ dữ liệu web này bằng BeautifulSoup. Sau đó, bạn sẽ phân tích các tiểu thuyết bằng Natural Language ToolKit (nltk). Trong quá trình này, bạn sẽ tìm hiểu những khía cạnh quan trọng của Xử lý ngôn ngữ tự nhiên (NLP) như tokenization và stopwords.
Kết thúc, bạn sẽ có thể trực quan hóa phân phối tần suất từ của bất kỳ tiểu thuyết nào bạn tìm thấy trên Project Gutenberg. Tuy nhiên, các kỹ năng NLP bạn phát triển sẽ có thể áp dụng cho phần lớn dữ liệu mà các nhà khoa học dữ liệu gặp phải, vì tỷ trọng lớn dữ liệu trên thế giới là dữ liệu phi cấu trúc và bao gồm rất nhiều văn bản.
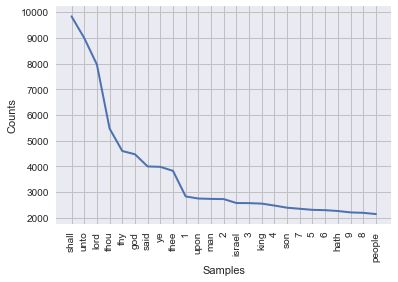
Ví dụ, biểu đồ phân phối tần suất sau đây là từ văn bản nào?
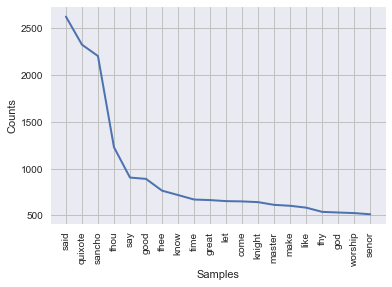
Bài viết này được tạo từ một Jupyter Notebook; Bạn có thể tìm thấy nó trong kho này. Nếu bạn có bất kỳ suy nghĩ, phản hồi và/hoặc trăn trở nào, cứ thoải mái liên hệ với tôi trên Twitter: @hugobowne.
Hãy làm theo hướng dẫn trong README.md để thiết lập hệ thống của bạn và sẵn sàng bắt đầu.
Những từ xuất hiện thường xuyên nhất trong tiểu thuyết Moby Dick là gì và chúng xuất hiện bao nhiêu lần?
Dữ liệu thô của bạn là văn bản tiểu thuyết Moby Dick của Melville. Làm thế nào để đưa văn bản của cuốn sách ~800 trang này vào Python?
Có vài cách để làm việc này, nhưng trước hết hãy nhận ra rằng văn bản được cung cấp miễn phí trên Project Gutenberg. Hãy truy cập đó, tìm Moby Dick và lưu URL tương ứng vào không gian tên Python của bạn:
# Store url
url = 'https://www.gutenberg.org/files/2701/2701-h/2701-h.htm'
Bây giờ bạn đã có URL, bạn cần lấy HTML của trang web.
Lưu ý rằng HTML là viết tắt của Hypertext Markup Language và là ngôn ngữ đánh dấu tiêu chuẩn cho web.
Bạn sẽ dùng requests để làm điều này, một trong những gói Python phổ biến và hữu ích nhất. Bạn có thể tìm hiểu thêm trong khóa Importing Data in Python (Phần 2) của DataCamp.
Theo trang web của gói requests:
Requests cho phép bạn gửi các yêu cầu HTTP/1.1 tự nhiên và thân thiện, mà không cần lao động thủ công.
và các tổ chức sau cho biết họ sử dụng requests nội bộ:
Chính phủ Nữ hoàng, Amazon, Google, Twilio, NPR, Obama for America, Twitter, Sony và các cơ quan liên bang Hoa Kỳ muốn ẩn danh.
Hơn nữa,
Requests là một trong những gói Python được tải xuống nhiều nhất mọi thời đại, với hơn 13.000.000 lượt tải mỗi tháng. Tất cả những ai sành điệu đều dùng nó!
Bạn sẽ thực hiện một yêu cầu GET từ trang web, nghĩa là bạn đang lấy dữ liệu từ đó. Đây chính là việc bạn làm khi truy cập một trang bằng trình duyệt. Còn có các loại yêu cầu khác, như POST, nhưng ở đây chúng ta không bàn đến.
requests giúp việc này trở nên đơn giản với hàm get. Hãy thực hiện yêu cầu và kiểm tra kiểu đối tượng trả về.
# Import `requests`
import requests

# Make the request and check object type
r = requests.get(url)
type(r)
requests.models.Response
Đây là một đối tượng Response. Như bạn thấy trong hướng dẫn khởi động requests, một đối tượng Response có thuộc tính text cho phép bạn lấy HTML từ đó! Hãy làm và in HTML ra để xem:
# Extract HTML from Response object and print
html = r.text
#print(html)
OK! HTML này chưa hẳn là thứ bạn muốn. Tuy nhiên, nó chứa thứ bạn cần: văn bản của Moby Dick. Giờ bạn cần xử lý HTML này để trích xuất tiểu thuyết.
Tại đây bạn sẽ dùng gói BeautifulSoup. Trang web của gói cho biết:
Có vẻ rất hứa hẹn!
Trước hết, một chút về tên gói: Beautiful Soup? Trong phát triển web, thuật ngữ "tag soup" chỉ HTML viết sai cấu trúc hoặc cú pháp cho một trang web. Điều mà Beautiful Soup làm tốt nhất là biến "tag soup" thành đẹp đẽ trở lại và dễ dàng trích xuất thông tin từ đó! Thực tế, đối tượng chính được tạo và truy vấn khi dùng gói này cũng tên là BeautifulSoup. Sau khi tạo "soup", ta có thể dùng phương thức .get_text() để trích xuất văn bản.
# Import BeautifulSoup from bs4
from bs4 import BeautifulSoup


# Create a BeautifulSoup object from the HTML
soup = BeautifulSoup(html, "html5lib")
type(soup)
bs4.BeautifulSoup
Từ các đối tượng soup này, bạn có thể trích xuất đủ loại thông tin thú vị về trang bạn đang thu thập, chẳng hạn như tiêu đề:
# Get soup title
soup.title
<title>
      Moby Dick; Or the Whale, by Herman Melville
    </title>
Hoặc tiêu đề ở dạng chuỗi:
# Get soup title as string
soup.title.string
'\n Moby Dick; Or the Whale, by Herman Melville\n '
Hoặc tất cả URL trong các thẻ < a > (liên kết):
# Get hyperlinks from soup and check out first several
soup.findAll('a')[:8]
[<a href="#link2H_4_0002"> ETYMOLOGY. </a>,
 <a href="#link2H_4_0003"> EXTRACTS (Supplied by a Sub-Sub-Librarian).
         </a>,
 <a href="#link2HCH0001"> CHAPTER 1. Loomings. </a>,
 <a href="#link2HCH0002"> CHAPTER 2. The Carpet-Bag. </a>,
 <a href="#link2HCH0003"> CHAPTER 3. The Spouter-Inn. </a>,
 <a href="#link2HCH0004"> CHAPTER 4. The Counterpane. </a>,
 <a href="#link2HCH0005"> CHAPTER 5. Breakfast. </a>,
 <a href="#link2HCH0006"> CHAPTER 6. The Street. </a>]
Điều bạn muốn là trích xuất văn bản từ soup và có một phương thức .get_text() cực kỳ hữu ích dành riêng cho việc này.
Hãy lấy văn bản, in ra và xem thử. Có đúng thứ bạn cần không?
# Get the text out of the soup and print it
text = soup.get_text()
#print(text)
Lưu ý rằng giờ đây nó gần như là thứ bạn muốn.
Đó là văn bản của tiểu thuyết với một ít phần thừa ở đầu và cuối. Bạn có thể loại bỏ nếu muốn. Tuy nhiên, phần này nhỏ hơn rất nhiều so với toàn bộ văn bản Moby Dick nên ở mức độ đầu tiên, để nguyên cũng ổn và đó sẽ là cách làm ở đây. Để kết quả vững chắc hơn, tôi khuyên nên loại bỏ.
Giờ bạn đã có văn bản quan tâm, đến lúc đếm số lần mỗi từ xuất hiện và vẽ biểu đồ tần suất như mong muốn: NLP sẽ hỗ trợ bạn!
Bây giờ bạn sẽ dùng nltk, Natural Language Toolkit, để
Bạn muốn tokenize văn bản, tức là tách nó thành một danh sách các từ. Về bản chất, bạn muốn tách những phần được phân cách bằng khoảng trắng.
Để làm điều này, bạn sẽ dùng một công cụ mạnh mẽ gọi là biểu thức chính quy. Biểu thức chính quy, hay regex, là một chuỗi ký tự định nghĩa một mẫu tìm kiếm. Chúng nổi tiếng là khó hiểu và tốt nhất nên giới thiệu bằng ví dụ.
Regex khớp với tất cả từ bắt đầu bằng 'p' là 'p\w+'. Hãy phân tích:
Kết hợp lại, regex 'p\w+' sẽ khớp mọi chuỗi con bắt đầu bằng 'p' và theo sau là các ký tự chữ-số và gạch dưới. Trong hầu hết văn bản tiếng Anh có nghĩa, điều này sẽ tương ứng với các từ bắt đầu bằng 'p'.
Bây giờ bạn sẽ dùng gói chuẩn re của Python để trích tất cả các từ bắt đầu bằng 'p' từ câu 'peter piper picked a peck of pickled peppers' như một khởi động.
# Import regex package
import re

# Define sentence
sentence = 'peter piper pick a peck of pickled peppers'

# Define regex
ps = 'p\w+'


# Find all words in sentence that match the regex and print them
re.findall(ps, sentence)
['peter', 'piper', 'pick', 'peck', 'pickled', 'peppers']
Trông khá ổn. Giờ, nếu 'p\w+' là regex khớp các từ bắt đầu bằng 'p', thì regex khớp tất cả các từ là gì?
Giờ đến lượt bạn làm điều đó cho câu ví dụ Peter Piper ở trên.
# Find all words and print them
re.findall('\w+', sentence)
['peter', 'piper', 'pick', 'a', 'peck', 'of', 'pickled', 'peppers']
Bây giờ bạn có thể làm điều tương tự với text, chuỗi chứa Moby Dick:
# Find all words in Moby Dick and print several
tokens = re.findall('\w+', text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Lưu ý rằng cũng có cách làm việc này với nltk, Natural Language Toolkit:
# Import RegexpTokenizer from nltk.tokenize
from nltk.tokenize import RegexpTokenizer

# Create tokenizer
tokenizer = RegexpTokenizer('\w+')


# Create tokens
tokens = tokenizer.tokenize(text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
OK! Gần xong rồi. Tuy nhiên, trong ví dụ trên, 'Or' viết hoa chữ 'O' và ở nơi khác có thể không, nhưng cả 'Or' và 'or' bạn đều muốn tính là cùng một từ. Vì vậy, bạn cần tạo một danh sách tất cả các từ trong Moby Dick với mọi chữ hoa đã chuyển thành chữ thường. Phương thức chuỗi .lower() sẽ hữu ích:
# Initialize new list
words = []


# Loop through list tokens and make lower case
for word in tokens:
    words.append(word.lower())


# Print several items from list as sanity check
words[:8]
['moby', 'dick', 'or', 'the', 'whale', 'by', 'herman', 'melville']
Thông lệ là loại bỏ các từ xuất hiện rất nhiều trong tiếng Anh như 'the', 'of' và 'a' (gọi là stopwords) vì chúng không quá thú vị. Để tìm hiểu thêm về các kỹ thuật này, hãy xem khóa Natural Language Processing Fundamentals in Python của chúng tôi.
Gói nltk có một danh sách stopwords tiếng Anh mà bạn sẽ lưu vào sw và in ra vài phần tử đầu.
Nếu bạn gặp lỗi ở đây, hãy chạy lệnh nltk.download('stopwords') để cài đặt stopwords trên hệ thống của bạn.
# Import nltk
import nltk

# Get English stopwords and print some of them
sw = nltk.corpus.stopwords.words('english')
sw[:5]
['i', 'me', 'my', 'myself', 'we']
Bạn muốn danh sách tất cả các từ trong words mà không nằm trong sw. Một cách là lặp qua tất cả phần tử của words và thêm vào một danh sách mới nếu chúng không thuộc sw:
# Initialize new list
words_ns = []

# Add to words_ns all words that are in words but not in sw
for word in words:
    if word not in sw:
        words_ns.append(word)

# Print several list items as sanity check
words_ns[:5]
['moby', 'dick', 'whale', 'herman', 'melville']
Câu hỏi của chúng ta là 'Những từ xuất hiện thường xuyên nhất trong tiểu thuyết Moby Dick là gì và chúng xuất hiện bao nhiêu lần?'
Bây giờ bạn có thể vẽ biểu đồ tần suất các từ trong Moby Dick chỉ với hai dòng mã bằng nltk. Để làm điều này,
nltk.FreqDist();plot() của đối tượng thu được.#Import datavis libraries
import matplotlib.pyplot as plt
import seaborn as sns
# Figures inline and set visualization style
%matplotlib inline
sns.set()
# Create freq dist and plot
freqdist1 = nltk.FreqDist(words_ns)
freqdist1.plot(25)
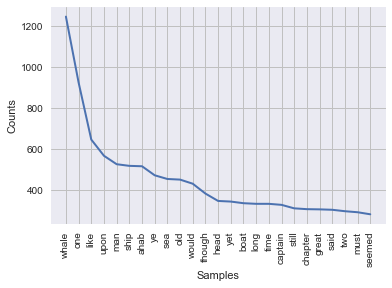
Điều hay là khi dùng nltk để trả lời câu hỏi, chúng ta thực ra đã trình bày lời giải theo cách có thể truyền đạt cho người khác: một biểu đồ phân phối tần suất! Bạn có thể đọc ra những từ phổ biến nhất cùng tần suất của chúng. Ví dụ, 'whale' là từ phổ biến nhất trong tiểu thuyết (không có gì ngạc nhiên), ngoại trừ stopwords, và nó xuất hiện hơn 1200 lần!
Vì bạn đã thấy có rất nhiều tiểu thuyết trên Project Gutenberg mà chúng ta có thể vẽ biểu đồ tần suất từ, nên hợp lý là viết một hàm riêng làm tất cả việc này:
 def plot_word_freq(url):
    """Takes a url (from Project Gutenberg) and plots a word frequency
    distribution"""
    # Make the request and check object type
    r = requests.get(url)
    # Extract HTML from Response object and print
    html = r.text
    # Create a BeautifulSoup object from the HTML
    soup = BeautifulSoup(html, "html5lib")
    # Get the text out of the soup and print it
    text = soup.get_text()
    # Create tokenizer
    tokenizer = RegexpTokenizer('\w+')
    # Create tokens
    tokens = tokenizer.tokenize(text)
    # Initialize new list
    words = []
    # Loop through list tokens and make lower case
    for word in tokens:
        words.append(word.lower())
    # Get English stopwords and print some of them
    sw = nltk.corpus.stopwords.words('english')
    # Initialize new list
    words_ns = []
    # Add to words_ns all words that are in words but not in sw
    for word in words:
        if word not in sw:
            words_ns.append(word)
    # Create freq dist and plot
    freqdist1 = nltk.FreqDist(words_ns)
    freqdist1.plot(25)
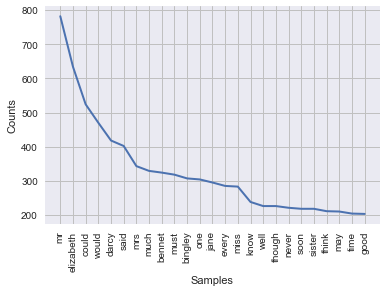
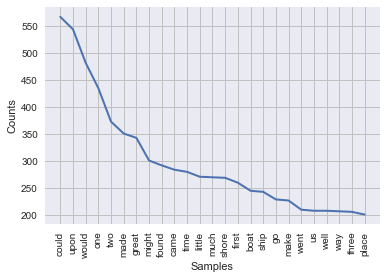
Bây giờ hãy dùng hàm để vẽ phân phối tần suất từ từ các văn bản khác trên Project Gutenberg:
plot_word_freq('https://www.gutenberg.org/files/42671/42671-h/42671-h.htm')
plot_word_freq('https://www.gutenberg.org/files/521/521-h/521-h.htm')
plot_word_freq('https://www.gutenberg.org/files/10/10-h/10-h.htm')
Trong bài viết này, bạn đã học cách xây dựng một pipeline Khoa học dữ liệu để vẽ phân phối tần suất các từ trong Moby Dick, cũng như nhiều tiểu thuyết khác. Bạn đã học cách thu thập chúng từ trang Project Gutenberg (kho sách lớn) bằng gói Python requests và cách trích xuất tiểu thuyết từ dữ liệu web này bằng BeautifulSoup. Sau đó, bạn đã phân tích các tiểu thuyết bằng Natural Language ToolKit (nltk). Trong quá trình này bạn đã tìm hiểu những khía cạnh quan trọng của NLP như tokenization và stopwords. Giờ bạn có thể trực quan hóa phân phối tần suất từ của bất kỳ tiểu thuyết nào bạn tìm thấy trên Project Gutenberg. Các kỹ năng NLP bạn phát triển cũng áp dụng được cho phần lớn dữ liệu mà các Nhà khoa học dữ liệu gặp phải, vì tỷ lệ lớn dữ liệu trên thế giới là dữ liệu phi cấu trúc và bao gồm rất nhiều văn bản.
Bài viết này được tạo từ một Jupyter Notebook; Bạn có thể tìm thấy nó trong kho này. Nếu bạn có bất kỳ ý kiến, phản hồi và/hoặc suy ngẫm nào, cứ thoải mái liên hệ với tôi trên twitter: @hugobowne. Hãy cho tôi biết những dự án hay ho bạn xây dựng.
Xem thêm các hướng dẫn của DataCamp: Web Scraping bằng Python (và Beautiful Soup) và Cách dùng Python để thu thập dữ liệu từ Amazon.
Tìm hiểu thêm về Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
