Kurs
Einführung in Deep Learning mit Python
4 Std.
264.6K
Zu Beginn dieser Woche habe ich eine Facebook Live Code-along-Session gemacht. Darin haben wir mit einfacher Natural Language Processing die am häufigsten vorkommenden Wörter im Roman Moby Dick geplottet. Dabei zeigt sich auch, wie hilfreich es ist, konsequent in folgenden Schritten einer Data-Science-Pipeline zu denken:
In diesem Beitrag lernst du, eine Data-Science-Pipeline aufzubauen, um Wortfrequenzverteilungen in Moby Dick – und vielen weiteren Romanen – zu plotten.
Tipp: Wenn du das Facebook Live nachschauen willst, sieh dir folgendes Video an. Du kannst bis zur 12. Minute vorspulen, wo Hugo dazukommt und die Session startet.
Wir stellen die Romane nicht bereit: Du lernst, sie von der Website Project Gutenberg (einem großen Korpus an Büchern) mit dem Python-Package requests zu scrapen und mit BeautifulSoup aus den Webdaten zu extrahieren. Anschließend analysierst du die Romane mit dem Natural Language ToolKit (nltk). Dabei lernst du zentrale NLP-Konzepte wie Tokenisierung und Stoppwörter kennen.
Am Ende kannst du die Wortfrequenzverteilung jedes Romans, den du auf Project Gutenberg findest, visualisieren. Die erlernten NLP-Kompetenzen lassen sich aber auf einen Großteil der Daten anwenden, mit denen Data Scientists arbeiten, denn ein Großteil der weltweiten Daten ist unstrukturiert – einschließlich vieler Texte.
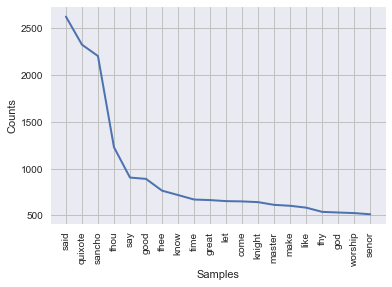
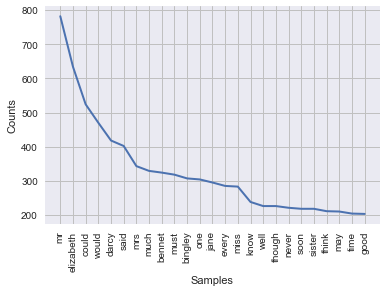
Zum Beispiel: Aus welchem Text stammt wohl die folgende Wortfrequenzverteilung?
Dieser Beitrag wurde aus einem Jupyter Notebook generiert. Du findest es in diesem Repository. Wenn du Gedanken, Feedback oder Einfälle hast, schreib mir gern auf Twitter: @hugobowne.
Folge den Anweisungen in der README.md, um dein System einzurichten.
Welche Wörter kommen im Roman Moby Dick am häufigsten vor und wie oft?
Deine Rohdaten sind der Text von Melvilles Roman Moby Dick. Wie bekommst du diesen rund 800-seitigen Text nach Python?
Es gibt mehrere Wege. Wichtig ist zunächst: Der Text ist frei online verfügbar auf Project Gutenberg. Lass uns dorthin gehen, Moby Dick suchen und die relevante URL in deinem Python-Namespace speichern:
# Store url
url = 'https://www.gutenberg.org/files/2701/2701-h/2701-h.htm'
Jetzt, wo du die URL hast, musst du das HTML der Website abrufen.
Hinweis: HTML steht für Hypertext Markup Language und ist die Standardsprache für das Web.
Dafür verwendest du requests, eines der beliebtesten und nützlichsten Python-Packages. Mehr dazu findest du in DataCamps Kurs Importing Data in Python (Part 2).
Laut der Website des requests-Packages gilt:
Requests allows you to send organic, grass-fed HTTP/1.1 requests, without the need for manual labor.
Und folgende Organisationen nutzen requests nach eigenen Angaben intern:
Her Majesty's Government, Amazon, Google, Twilio, NPR, Obama for America, Twitter, Sony, and Federal U.S. Institutions that prefer to be unnamed.
Außerdem:
Requests is one of the most downloaded Python packages of all time, pulling in over 13,000,000 downloads every month. All the cool kids are doing it!
Du wirst einen GET-Request an die Website schicken, d. h. du holst Daten ab. Genau das macht auch dein Browser beim Aufrufen einer Webseite. Es gibt noch andere Request-Typen, z. B. POST, aber darum kümmern wir uns hier nicht.
Mit der Funktion get ist das in requests sehr einfach. Führe den Request aus und prüfe, welchen Objekttyp du zurückbekommst.
# Import `requests`
import requests

# Make the request and check object type
r = requests.get(url)
type(r)
requests.models.Response
Das ist ein Response-Objekt. In der requests-Schnellstartanleitung siehst du, dass ein Response-Objekt ein Attribut text hat, mit dem du das HTML bekommst. Holen wir es und werfen einen Blick darauf:
# Extract HTML from Response object and print
html = r.text
#print(html)
Okay! Dieses HTML ist noch nicht genau das, was du willst. Es enthält aber den gewünschten Text: Moby Dick. Jetzt musst du das HTML aufbereiten, um den Roman zu extrahieren.
Hier nutzt du das Package BeautifulSoup. Auf der Website steht:
Das klingt vielversprechend!
Kurz zum Namen: Beautiful Soup? In der Webentwicklung bezeichnet "Tag Soup" HTML, das strukturell oder syntaktisch fehlerhaft ist. BeautifulSoup macht diese Tag-Suppe wieder schön und extrahiert Informationen daraus mit Leichtigkeit. Das zentrale Objekt heißt tatsächlich BeautifulSoup. Nachdem wir die Suppe erzeugt haben, können wir mit .get_text() den Text extrahieren.
# Import BeautifulSoup from bs4
from bs4 import BeautifulSoup


# Create a BeautifulSoup object from the HTML
soup = BeautifulSoup(html, "html5lib")
type(soup)
bs4.BeautifulSoup
Aus diesem Soup-Objekt kannst du alle möglichen Informationen der Seite ziehen, zum Beispiel den Titel:
# Get soup title
soup.title
<title>
      Moby Dick; Or the Whale, by Herman Melville
    </title>
Oder den Titel als String:
# Get soup title as string
soup.title.string
'\n Moby Dick; Or the Whale, by Herman Melville\n '
Oder alle URLs innerhalb der <a>-Tags (Hyperlinks):
# Get hyperlinks from soup and check out first several
soup.findAll('a')[:8]
[<a href="#link2H_4_0002"> ETYMOLOGY. </a>,
 <a href="#link2H_4_0003"> EXTRACTS (Supplied by a Sub-Sub-Librarian).
         </a>,
 <a href="#link2HCH0001"> CHAPTER 1. Loomings. </a>,
 <a href="#link2HCH0002"> CHAPTER 2. The Carpet-Bag. </a>,
 <a href="#link2HCH0003"> CHAPTER 3. The Spouter-Inn. </a>,
 <a href="#link2HCH0004"> CHAPTER 4. The Counterpane. </a>,
 <a href="#link2HCH0005"> CHAPTER 5. Breakfast. </a>,
 <a href="#link2HCH0006"> CHAPTER 6. The Street. </a>]
Wir wollen den reinen Text aus soup extrahieren. Dafür gibt es die praktische Methode .get_text().
Hol dir den Text, gib ihn aus und schau ihn dir an. Ist es das, was du brauchst?
# Get the text out of the soup and print it
text = soup.get_text()
#print(text)
Das ist jetzt fast das, was wir wollen.
Es ist der Romantext mit etwas unerwünschtem Inhalt am Anfang und Ende. Du könntest ihn entfernen. Da dieser Anteil aber im Vergleich zum eigentlichen Text sehr klein ist, lassen wir ihn hier der Einfachheit halber drin. Für robuste Ergebnisse würde ich empfehlen, ihn zu entfernen.
Jetzt, wo du den relevanten Text hast, ist es Zeit zu zählen, wie oft jedes Wort vorkommt, und das gewünschte Frequenzhistogramm zu plotten. Natural Language Processing hilft uns dabei!
Du nutzt jetzt nltk, das Natural Language Toolkit, um
Du möchtest den Text tokenisieren, also in eine Liste von Wörtern zerlegen. Im Kern willst du an Whitespace-Grenzen aufteilen.
Dafür nutzt du ein mächtiges Werkzeug: reguläre Ausdrücke. Ein regulärer Ausdruck, kurz Regex, ist eine Zeichenfolge, die ein Suchmuster definiert. Sie sind berüchtigt knifflig und lassen sich am besten per Beispiel einführen.
Der Regex, der alle mit „p“ beginnenden Wörter findet, lautet „p\w+“. Aufgeschlüsselt heißt das:
Zusammengesetzt matcht „p\w+“ alle Teilstrings, die mit „p“ starten und von alphanumerischen Zeichen/Unterstrichen gefolgt werden. In sinnvollen englischen Texten entspricht das Wörtern, die mit „p“ beginnen.
Als Aufwärmübung nutzt du das eingebaute Python-Package re, um alle mit „p“ beginnenden Wörter aus „peter piper picked a peck of pickled peppers“ zu extrahieren.
# Import regex package
import re

# Define sentence
sentence = 'peter piper pick a peck of pickled peppers'

# Define regex
ps = 'p\w+'


# Find all words in sentence that match the regex and print them
re.findall(ps, sentence)
['peter', 'piper', 'pick', 'peck', 'pickled', 'peppers']
Sieht gut aus. Wenn „p\w+“ Wörter findet, die mit „p“ beginnen – welcher Regex findet dann alle Wörter?
Genau das machst du jetzt für unseren Peter-Piper-Satz oben.
# Find all words and print them
re.findall('\w+', sentence)
['peter', 'piper', 'pick', 'a', 'peck', 'of', 'pickled', 'peppers']
Jetzt kannst du dasselbe mit text machen, der Zeichenkette, die Moby Dick enthält:
# Find all words in Moby Dick and print several
tokens = re.findall('\w+', text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Hinweis: Das geht auch mit nltk, dem Natural Language Toolkit:
# Import RegexpTokenizer from nltk.tokenize
from nltk.tokenize import RegexpTokenizer

# Create tokenizer
tokenizer = RegexpTokenizer('\w+')


# Create tokens
tokens = tokenizer.tokenize(text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Fast geschafft! Beachte aber: Oben steht „Or“ mit großem „O“. An anderer Stelle könnte es klein geschrieben sein. „Or“ und „or“ möchtest du als dasselbe Wort zählen. Daher brauchst du eine Wortliste aus Moby Dick, in der alle Großbuchstaben in Kleinbuchstaben umgewandelt sind. Die String-Methode .lower() hilft dir dabei:
# Initialize new list
words = []


# Loop through list tokens and make lower case
for word in tokens:
    words.append(word.lower())


# Print several items from list as sanity check
words[:8]
['moby', 'dick', 'or', 'the', 'whale', 'by', 'herman', 'melville']
Üblicherweise entfernt man sehr häufige Wörter der englischen Sprache wie „the“, „of“ und „a“ (sogenannte Stoppwörter), weil sie wenig aussagekräftig sind. Mehr zu diesen Techniken findest du in unserem Kurs Natural Language Processing Fundamentals in Python.
Das Package nltk enthält eine Liste englischer Stoppwörter. Diese speicherst du jetzt als sw und gibst die ersten Elemente aus.
Wenn hier ein Fehler auftritt, führe nltk.download('stopwords') aus, um die Stoppwörter zu installieren.
# Import nltk
import nltk

# Get English stopwords and print some of them
sw = nltk.corpus.stopwords.words('english')
sw[:5]
['i', 'me', 'my', 'myself', 'we']
Du möchtest alle Wörter aus words, die nicht in sw stehen. Eine Möglichkeit: Über words iterieren und jedes Wort, das nicht in sw ist, zu einer neuen Liste hinzufügen:
# Initialize new list
words_ns = []

# Add to words_ns all words that are in words but not in sw
for word in words:
    if word not in sw:
        words_ns.append(word)

# Print several list items as sanity check
words_ns[:5]
['moby', 'dick', 'whale', 'herman', 'melville']
Unsere Frage lautete: „Welche Wörter kommen im Roman Moby Dick am häufigsten vor und wie oft?“
Jetzt kannst du mit nltk in zwei Zeilen ein Frequenzhistogramm der Wörter in Moby Dick plotten. Dazu
nltk.FreqDist() undplot().#Import datavis libraries
import matplotlib.pyplot as plt
import seaborn as sns
# Figures inline and set visualization style
%matplotlib inline
sns.set()
# Create freq dist and plot
freqdist1 = nltk.FreqDist(words_ns)
freqdist1.plot(25)
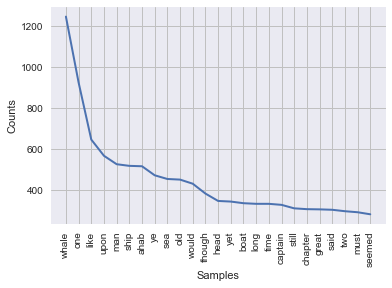
Das Coole ist: Mit nltk haben wir beim Beantworten der Frage die Lösung bereits so visualisiert, dass andere sie verstehen können – als Frequenzverteilungs-Plot. Du kannst die häufigsten Wörter samt Häufigkeit ablesen. Zum Beispiel ist „whale“ das häufigste Wort im Roman (wer hätte es gedacht) – abgesehen von Stoppwörtern – und kommt über 1200 Mal vor.
Da es auf Project Gutenberg so viele Romane gibt, für die wir solche Wortfrequenz-Histogramme erstellen können, lohnt es sich, eine eigene Funktion dafür zu schreiben:
 def plot_word_freq(url):
    """Takes a url (from Project Gutenberg) and plots a word frequency
    distribution"""
    # Make the request and check object type
    r = requests.get(url)
    # Extract HTML from Response object and print
    html = r.text
    # Create a BeautifulSoup object from the HTML
    soup = BeautifulSoup(html, "html5lib")
    # Get the text out of the soup and print it
    text = soup.get_text()
    # Create tokenizer
    tokenizer = RegexpTokenizer('\w+')
    # Create tokens
    tokens = tokenizer.tokenize(text)
    # Initialize new list
    words = []
    # Loop through list tokens and make lower case
    for word in tokens:
        words.append(word.lower())
    # Get English stopwords and print some of them
    sw = nltk.corpus.stopwords.words('english')
    # Initialize new list
    words_ns = []
    # Add to words_ns all words that are in words but not in sw
    for word in words:
        if word not in sw:
            words_ns.append(word)
    # Create freq dist and plot
    freqdist1 = nltk.FreqDist(words_ns)
    freqdist1.plot(25)
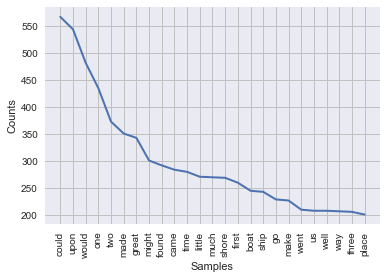
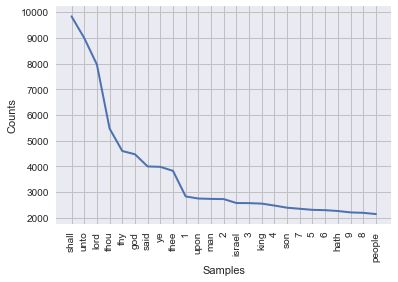
Nutze die Funktion jetzt für andere Texte auf Project Gutenberg:
plot_word_freq('https://www.gutenberg.org/files/42671/42671-h/42671-h.htm')
plot_word_freq('https://www.gutenberg.org/files/521/521-h/521-h.htm')
plot_word_freq('https://www.gutenberg.org/files/10/10-h/10-h.htm')
In diesem Beitrag hast du gelernt, eine Data-Science-Pipeline zu bauen, um Wortfrequenzverteilungen in Moby Dick und vielen weiteren Romanen zu plotten. Du hast gesehen, wie du die Texte mit dem Python-Package requests von Project Gutenberg (großes Buchkorpus) scrapest und sie mit BeautifulSoup aus Webdaten extrahierst. Dann hast du die Romane mit dem Natural Language ToolKit (nltk) analysiert. Dabei hast du wichtige NLP-Aspekte wie Tokenisierung und Stoppwörter kennengelernt. Jetzt kannst du die Wortfrequenzverteilung jedes Romans auf Project Gutenberg visualisieren. Die entwickelten NLP-Kompetenzen lassen sich auch auf viele andere Daten anwenden, denn ein Großteil der von Data Scientists genutzten Daten ist unstrukturiert und enthält viel Text.
Dieser Beitrag wurde aus einem Jupyter Notebook generiert. Du findest es in diesem Repository. Wenn du Gedanken, Feedback oder Ideen hast, schreib mir gern auf Twitter: @hugobowne. Lass mich wissen, welche coolen Projekte du baust.
Sieh dir auch die DataCamp-Tutorials Web Scraping using Python (and Beautiful Soup) und How to Use Python to Scrape Amazon an.
Erfahre mehr über Python
Kurs
Kurs
Kurs
Tutorial
DataCamp Team
5 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Satyabrata Pal
15 Min.






