Curso
Introdução a Deep Learning em Python
4 h
264.6K
No começo desta semana, fiz uma sessão de Live Code no Facebook. Nela, usamos Processamento de Linguagem Natural básico para plotar as palavras que mais aparecem no romance Moby Dick. Com isso, vimos na prática a eficácia de pensar em termos do seguinte pipeline de ciência de dados, sempre com foco no processo:
Neste post, você vai aprender a construir um pipeline de ciência de dados para plotar distribuições de frequência de palavras em Moby Dick, entre muitos outros romances.
Dica: se quiser rever o Facebook Live, confira o vídeo a seguir. Você pode pular para o minuto 12, quando o Hugo entra e a sessão realmente começa.
Não vamos te dar os romances: você vai aprender a coletá-los do site Project Gutenberg (que basicamente reúne um grande corpus de livros) usando o pacote do Python requests e a extrair o texto desses dados da web com o BeautifulSoup. Depois, você vai mergulhar na análise usando o Natural Language Toolkit (nltk). No caminho, vai aprender conceitos importantes de Processamento de Linguagem Natural (NLP), como tokenização e stopwords.
No fim, você será capaz de visualizar distribuições de frequência de palavras de qualquer romance que encontrar no Project Gutenberg. As habilidades de NLP que você vai desenvolver, porém, se aplicam a grande parte dos dados que cientistas de dados encontram, já que a maior parte dos dados do mundo é não estruturada e inclui muito texto.
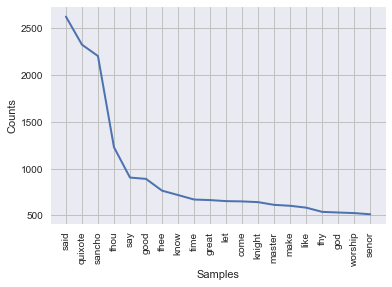
Por exemplo, de onde você acha que vem a seguinte distribuição de frequência de palavras?
Este post foi gerado a partir de um Jupyter Notebook. Você pode encontrá-lo neste repositório. Se tiver comentários, respostas e/ou reflexões, fale comigo no Twitter: @hugobowne.
Siga as instruções no README.md para preparar seu sistema e começar.
Quais são as palavras mais frequentes no romance Moby Dick e com que frequência elas aparecem?
Seus dados brutos são o texto do romance Moby Dick, de Melville. Como você colocaria o texto desse livro de ~800 páginas dentro do Python?
Existem várias formas, mas primeiro vale notar que o texto está disponível gratuitamente online no Project Gutenberg. Vamos até lá, procurar Moby Dick e então guardar a URL relevante no seu namespace do Python:
# Store url
url = 'https://www.gutenberg.org/files/2701/2701-h/2701-h.htm'
Agora que você tem a URL, precisa buscar o HTML do site.
Observação: HTML significa Hypertext Markup Language e é a linguagem de marcação padrão da web.
Você vai usar o requests para fazer isso — um dos pacotes do Python mais populares e úteis que existem. Saiba mais no curso da DataCamp Importing Data in Python (Part 2).
Segundo o site do pacote requests:
Requests permite enviar requisições HTTP/1.1 orgânicas, grass-fed, sem trabalho manual.
e as seguintes organizações afirmam usar requests internamente:
Her Majesty's Government, Amazon, Google, Twilio, NPR, Obama for America, Twitter, Sony e instituições federais dos EUA que preferem não ser identificadas.
Além disso,
Requests é um dos pacotes Python mais baixados de todos os tempos, com mais de 13.000.000 de downloads por mês. Todo mundo descolado usa!
Você fará uma requisição GET ao site, ou seja, vai obter dados dele. É isso que acontece quando você visita uma página pelo navegador. Existem outros tipos de requisição, como POST, mas não vamos entrar nisso aqui.
O requests facilita isso com a função get. Faça a requisição e confira o tipo de objeto retornado.
# Import `requests`
import requests

# Make the request and check object type
r = requests.get(url)
type(r)
requests.models.Response
Isso é um objeto Response. Você pode ver no guia rápido do requests que um objeto Response tem um atributo text que permite acessar o HTML! Vamos fazer isso e imprimir o HTML para conferir:
# Extract HTML from Response object and print
html = r.text
#print(html)
Perfeito! Esse HTML não é exatamente o que você quer. Mas ele contém o que você quer: o texto de Moby Dick. Agora você precisa tratar esse HTML para extrair o romance.
Aqui você vai usar o pacote BeautifulSoup. O site do pacote diz:
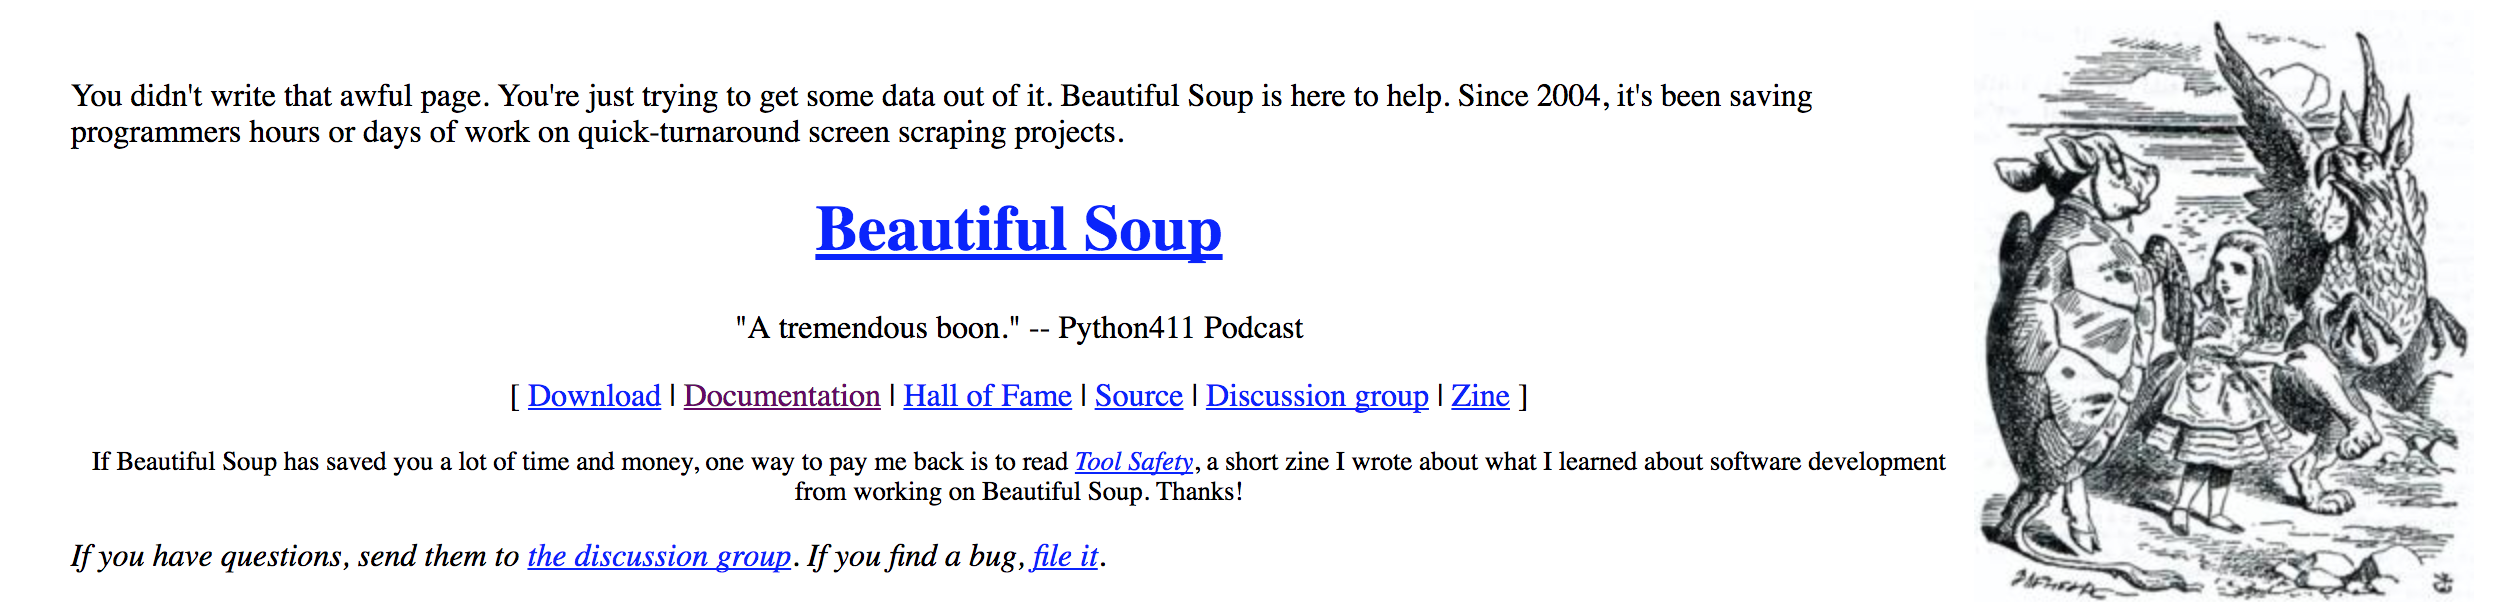
Parece promissor!
Antes, uma palavra sobre o nome do pacote: Beautiful Soup? Em desenvolvimento web, o termo "tag soup" se refere a HTML estrutural ou sintaticamente incorreto escrito para uma página. O que o Beautiful Soup faz de melhor é transformar essa bagunça em algo bonito de novo e extrair informações com facilidade! De fato, o principal objeto criado e consultado ao usar esse pacote se chama BeautifulSoup. Depois de criar a sopa, podemos usar o método .get_text() para extrair o texto.
# Import BeautifulSoup from bs4
from bs4 import BeautifulSoup


# Create a BeautifulSoup object from the HTML
soup = BeautifulSoup(html, "html5lib")
type(soup)
bs4.BeautifulSoup
A partir desses objetos de sopa, dá para extrair todo tipo de informação interessante sobre o site que você está raspando, como o título:
# Get soup title
soup.title
<title>
      Moby Dick; Or the Whale, by Herman Melville
    </title>
Ou o título como string:
# Get soup title as string
soup.title.string
'\n Moby Dick; Or the Whale, by Herman Melville\n '
Ou todas as URLs encontradas nas tags <a> (hyperlinks) de uma página:
# Get hyperlinks from soup and check out first several
soup.findAll('a')[:8]
[<a href="#link2H_4_0002"> ETYMOLOGY. </a>,
 <a href="#link2H_4_0003"> EXTRACTS (Supplied by a Sub-Sub-Librarian).
         </a>,
 <a href="#link2HCH0001"> CHAPTER 1. Loomings. </a>,
 <a href="#link2HCH0002"> CHAPTER 2. The Carpet-Bag. </a>,
 <a href="#link2HCH0003"> CHAPTER 3. The Spouter-Inn. </a>,
 <a href="#link2HCH0004"> CHAPTER 4. The Counterpane. </a>,
 <a href="#link2HCH0005"> CHAPTER 5. Breakfast. </a>,
 <a href="#link2HCH0006"> CHAPTER 6. The Street. </a>]
O que você quer é extrair o texto do soup, e existe um método super útil chamado .get_text() justamente para isso.
Obtenha o texto, imprima e dê uma olhada. É o que você precisa?
# Get the text out of the soup and print it
text = soup.get_text()
#print(text)
Perceba que agora está quase lá.
É o texto do romance, com alguns trechos indesejados no começo e no fim. Você poderia removê-los se quisesse. No entanto, esse conteúdo é tão menor do que o texto de Moby Dick que, numa primeira aproximação, tudo bem deixar — e é o que faremos aqui. Para resultados mais robustos, eu sugeriria remover.
Agora que você tem o texto de interesse, é hora de contar quantas vezes cada palavra aparece e plotar o histograma de frequência desejado: é aí que o NLP entra em cena!
Agora você vai usar o nltk, o Natural Language Toolkit, para
Você quer tokenizar o texto, isto é, dividi-lo em uma lista de palavras. Essencialmente, separar as partes divididas por espaços em branco.
Para isso, vamos usar uma ferramenta poderosa chamada expressões regulares. Uma expressão regular, ou regex, é uma sequência de caracteres que define um padrão de busca. Elas são famosas por serem confusas, e o melhor é apresentá-las com exemplos.
A expressão regular que corresponde a todas as palavras que começam com 'p' é 'p\w+'. Vamos destrinchar:
Juntando tudo, a expressão 'p\w+' casa todas as substrings que começam com 'p' e são seguidas por caracteres alfanuméricos e underscores. Em textos em inglês com sentido, isso corresponde às palavras que começam com 'p'.
Agora você vai usar o pacote padrão do Python, o re, para extrair todas as palavras que começam com 'p' da frase 'peter piper picked a peck of pickled peppers' como aquecimento.
# Import regex package
import re

# Define sentence
sentence = 'peter piper pick a peck of pickled peppers'

# Define regex
ps = 'p\w+'


# Find all words in sentence that match the regex and print them
re.findall(ps, sentence)
['peter', 'piper', 'pick', 'peck', 'pickled', 'peppers']
Parece ótimo. Agora, se 'p\w+' é o regex que casa palavras começando com 'p', qual é o regex que casa todas as palavras?
Agora é com você fazer isso para a nossa frase de exemplo do Peter Piper acima.
# Find all words and print them
re.findall('\w+', sentence)
['peter', 'piper', 'pick', 'a', 'peck', 'of', 'pickled', 'peppers']
Agora você pode fazer o mesmo com o text, a string que contém Moby Dick:
# Find all words in Moby Dick and print several
tokens = re.findall('\w+', text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Observação: também dá para fazer isso com o nltk, o Natural Language Toolkit:
# Import RegexpTokenizer from nltk.tokenize
from nltk.tokenize import RegexpTokenizer

# Create tokenizer
tokenizer = RegexpTokenizer('\w+')


# Create tokens
tokens = tokenizer.tokenize(text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Beleza! Estamos quase lá. Note, porém, que acima 'Or' está com 'O' maiúsculo e, em outros lugares, pode não estar — mas tanto 'Or' quanto 'or' você vai querer contar como a mesma palavra. Por isso, você precisa construir uma lista de todas as palavras em Moby Dick com todas as letras convertidas para minúsculas. O método de string .lower() vai ajudar:
# Initialize new list
words = []


# Loop through list tokens and make lower case
for word in tokens:
    words.append(word.lower())


# Print several items from list as sanity check
words[:8]
['moby', 'dick', 'or', 'the', 'whale', 'by', 'herman', 'melville']
É prática comum remover palavras que aparecem muito no inglês, como 'the', 'of' e 'a' (as chamadas stopwords), porque não são tão interessantes. Para saber mais sobre essas técnicas, confira nosso curso Natural Language Processing Fundamentals in Python.
O pacote nltk tem uma lista de stopwords em inglês, que agora você vai guardar como sw e imprimir os primeiros elementos.
Se aparecer erro aqui, rode o comando nltk.download('stopwords') para instalar as stopwords no seu sistema.
# Import nltk
import nltk

# Get English stopwords and print some of them
sw = nltk.corpus.stopwords.words('english')
sw[:5]
['i', 'me', 'my', 'myself', 'we']
Você quer a lista de todas as palavras em words que não estão em sw. Uma forma é percorrer todos os elementos de words e adicioná-los a uma nova lista se não estiverem em sw:
# Initialize new list
words_ns = []

# Add to words_ns all words that are in words but not in sw
for word in words:
    if word not in sw:
        words_ns.append(word)

# Print several list items as sanity check
words_ns[:5]
['moby', 'dick', 'whale', 'herman', 'melville']
Nossa pergunta era: "Quais são as palavras mais frequentes no romance Moby Dick e com que frequência elas aparecem?"
Agora você pode plotar um histograma de frequência das palavras em Moby Dick com duas linhas de código usando o nltk. Para isso,
nltk.FreqDist();plot() do objeto resultante.#Import datavis libraries
import matplotlib.pyplot as plt
import seaborn as sns
# Figures inline and set visualization style
%matplotlib inline
sns.set()
# Create freq dist and plot
freqdist1 = nltk.FreqDist(words_ns)
freqdist1.plot(25)
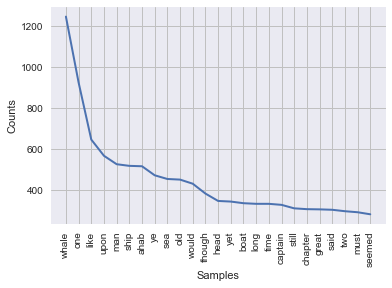
O legal é que, ao usar o nltk para responder à pergunta, a gente já apresentou a solução de um jeito comunicável: um gráfico de distribuição de frequência! Dá para ver as palavras mais comuns e suas frequências. Por exemplo, 'whale' é a palavra mais comum no romance (quem diria), desconsiderando as stopwords, e aparece mais de 1200 vezes!
Como você viu que há muitos romances no Project Gutenberg para os quais podemos fazer esses histogramas de frequência de palavras, faz sentido escrever uma função que faça tudo isso:
 def plot_word_freq(url):
    """Takes a url (from Project Gutenberg) and plots a word frequency
    distribution"""
    # Make the request and check object type
    r = requests.get(url)
    # Extract HTML from Response object and print
    html = r.text
    # Create a BeautifulSoup object from the HTML
    soup = BeautifulSoup(html, "html5lib")
    # Get the text out of the soup and print it
    text = soup.get_text()
    # Create tokenizer
    tokenizer = RegexpTokenizer('\w+')
    # Create tokens
    tokens = tokenizer.tokenize(text)
    # Initialize new list
    words = []
    # Loop through list tokens and make lower case
    for word in tokens:
        words.append(word.lower())
    # Get English stopwords and print some of them
    sw = nltk.corpus.stopwords.words('english')
    # Initialize new list
    words_ns = []
    # Add to words_ns all words that are in words but not in sw
    for word in words:
        if word not in sw:
            words_ns.append(word)
    # Create freq dist and plot
    freqdist1 = nltk.FreqDist(words_ns)
    freqdist1.plot(25)
Agora use a função para plotar distribuições de frequência de palavras de outros textos no Project Gutenberg:
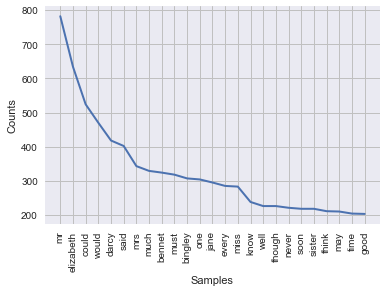
plot_word_freq('https://www.gutenberg.org/files/42671/42671-h/42671-h.htm')
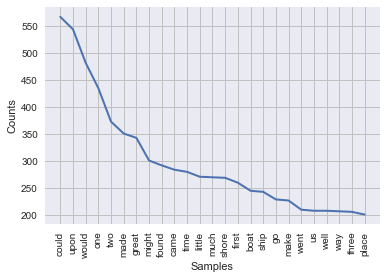
plot_word_freq('https://www.gutenberg.org/files/521/521-h/521-h.htm')
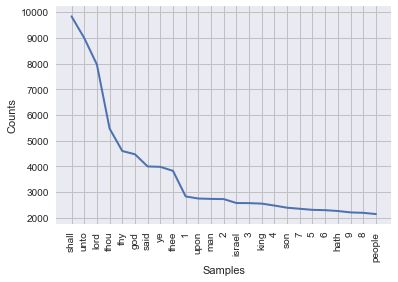
plot_word_freq('https://www.gutenberg.org/files/10/10-h/10-h.htm')
Neste post, você aprendeu a construir um pipeline de ciência de dados para plotar distribuições de frequência de palavras em Moby Dick, entre muitos outros romances. Você aprendeu a coletá-los do site Project Gutenberg (um grande corpus de livros) usando o pacote do Python requests e a extrair os textos desses dados da web com o BeautifulSoup. Depois, partiu para analisar os romances usando o Natural Language Toolkit (nltk). Nesse processo, conheceu aspectos importantes de NLP, como tokenização e stopwords. Agora você consegue visualizar distribuições de frequência de palavras de qualquer romance que encontrar no Project Gutenberg. As habilidades de NLP que você desenvolveu também se aplicam a grande parte dos dados que cientistas de dados encontram, já que a maior parcela dos dados do mundo é não estruturada e inclui muito texto.
Este post foi gerado a partir de um Jupyter Notebook. Você pode encontrá-lo neste repositório. Se tiver ideias, respostas e/ou reflexões, fale comigo no Twitter: @hugobowne. Quero saber dos projetos legais que você vai criar.
Confira os tutoriais da DataCamp Web Scraping using Python (and Beautiful Soup) e How to Use Python to Scrape Amazon.
Saiba mais sobre Python
Curso
Curso
Curso
Tutorial
Abid Ali Awan
6 min
Tutorial
Moez Ali
13 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Kurtis Pykes
11 min
Tutorial
Moez Ali
14 min
Tutorial
Moez Ali
12 min


