강의
Python으로 배우는 시계열 분석
4시간
70.9K
대부분의 온라인 콘텐츠는 바로 ARIMA로 넘어가며, 있어도 AR 부분은 한두 줄로 설명하고 끝납니다. 하지만 AR은 모델의 토대입니다. 이를 이해하지 못하면 ARIMA의 나머지도 제대로 이해할 수 없습니다.
쉽게 말해, 자기회귀 모델은 시계열의 과거 값들로부터 미래 값을 예측합니다. 경제, 금융, 신호 처리, 기후 데이터 등에서 자주 볼 수 있습니다. 기본적으로 회귀 모델이므로, 이미 알고 있는 회귀 지식을 시계열 예측과 연결해 주며, ARIMA가 구축된 기반이기도 합니다.
이 글에서는 자기회귀 모델이 어떻게 작동하는지, Python의 statsmodels로 어떻게 적합하는지, 그리고 올바른 시차 차수는 어떻게 고르는지 단계별로 안내합니다.
자기회귀 모델은 이전 값들의 가중합으로 시계열의 다음 값을 예측합니다.
이름에서 "auto"는 자기(self), "regression"은 다른 변수로 한 변수를 예측함을 뜻합니다. 따라서 자기회귀 모델은 한 시계열을 그 자체의 과거 값들로 회귀하는 것입니다.
예를 들어 내일의 전력 수요를 예측한다고 합시다. 오늘의 수요는 좋은 출발점이고, 어제의 수요는 추가 정보를 줍니다. 자기회귀 모델은 이런 직관을 수식으로 만들고, 데이터로부터 가중치를 학습합니다.
AR 모델은 AR(p)로 표기하며, 여기서 p는 모델의 차수입니다. 차수는 모델이 사용하는 과거 값의 개수를 뜻합니다:
p개 값을 사용합니다차수가 높다고 해서 자동으로 더 좋은 모델은 아닙니다. 글 뒷부분에서 p를 고르는 방법을 보여드립니다.
AR(p) 모델의 일반형은 다음과 같습니다:
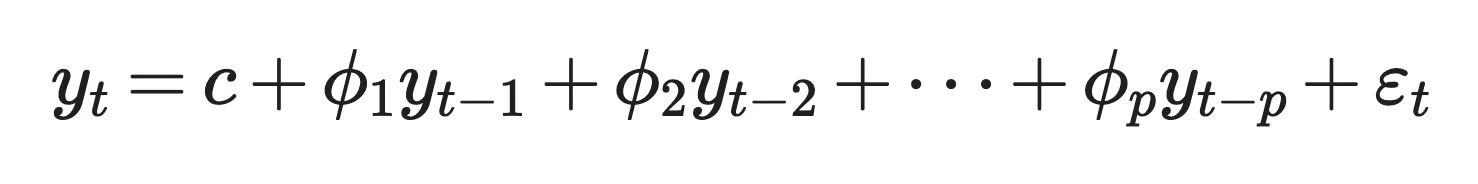
AR(p) 모델의 일반형
각 항의 역할은 다음과 같습니다
y_t: 시점 t의 시계열 값으로, 예측하려는 대상입니다
c: 상수항으로, 계수들과 함께 시계열의 장기 평균을 결정합니다
phi_1부터 phi_p까지: 계수로, 각 과거 값이 예측에 얼마나 기여하는지 알려줍니다
y_t-1부터 y_t-p까지: 지연(lag)된 값들로, "지연"은 몇 단계 이전을 보는지를 의미합니다
epsilon_t: 백색잡음으로, 평균이 0이고 분산이 일정하며 시간에 따른 상관이 없는 무작위 오차입니다
간단히 말해, 모델은 직전 p개의 각 값을 그에 해당하는 가중치로 곱하고 상수를 더합니다. 남는 부분이 잡음이며, 이는 과거로 설명되지 않는 y_t의 일부입니다.
AR(1)은 가장 단순한 형태입니다:
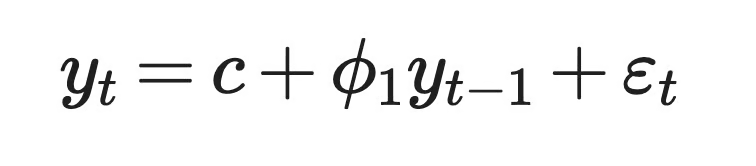
AR(1) 모델
phi_1의 값은 오늘이 내일에 얼마나 영향을 미치는지를 좌우합니다.
예를 들어 c = 2, phi_1 = 0.8라고 합시다. 오늘 값이 15라면, 모델은 내일을 2 + 0.8 x 15 = 14로 예측합니다. 그다음 예측은 2 + 0.8 x 14 = 13.2입니다. 각 단계는 시계열을 10, 즉 장기 평균 c / (1 - phi_1)에 점점 가깝게 이동시킵니다.
만약 phi_1가 음수라면, 시계열은 한 단계마다 평균 위아래로 번갈아가며 튑니다.
AR(2)는 두 번째 지연을 추가합니다:
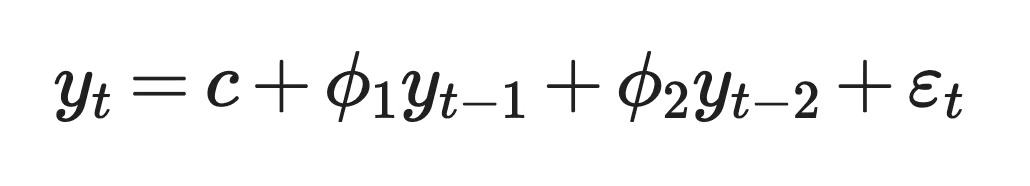
AR(2) 모델
두 개의 지연을 사용하면 AR(1)로는 설명되지 않는, 예를 들어 순환과 같은 패턴을 묘사할 수 있습니다. 예컨대 phi_1가 양수이고 phi_2가 음수이면, 시계열이 파동처럼 오르내리며 대략 일정한 주기로 반복될 수 있습니다.
결국 모든 AR 모델은 두 가지 선택으로 귀결됩니다. 몇 개의 지연을 쓸지, 그리고 그 지연들에 어떤 가중치를 줄지입니다.
AR 모델이 작동하려면 데이터가 두 가지 조건을 만족해야 합니다. 과거 값이 미래 값과 관련되어 있어야 하고, 시계열이 시간이 지나도 같은 방식으로 거동해야 합니다. 전자는 자기상관(autocorrelation), 후자는 정상성(stationarity)이라고 합니다.
자기상관은 시계열과 그 지연된 사본 간의 상관입니다.
이것이 AR 모델이 존재하는 이유입니다. 오늘의 값이 내일에 대해 아무것도 알려주지 않는다면, 모델은 과거 값들로부터 배울 것이 없습니다.
코드에서는 값의 열을 복사해 한 행 아래로 내립니다. 그러면 각 행이 어떤 값과 그 직전 값을 짝지웁니다. 두 열의 상관이 시차 1 자기상관입니다. 두 행을 내리면 시차 2 자기상관을 얻습니다.
pandas에서는 다음과 같습니다:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))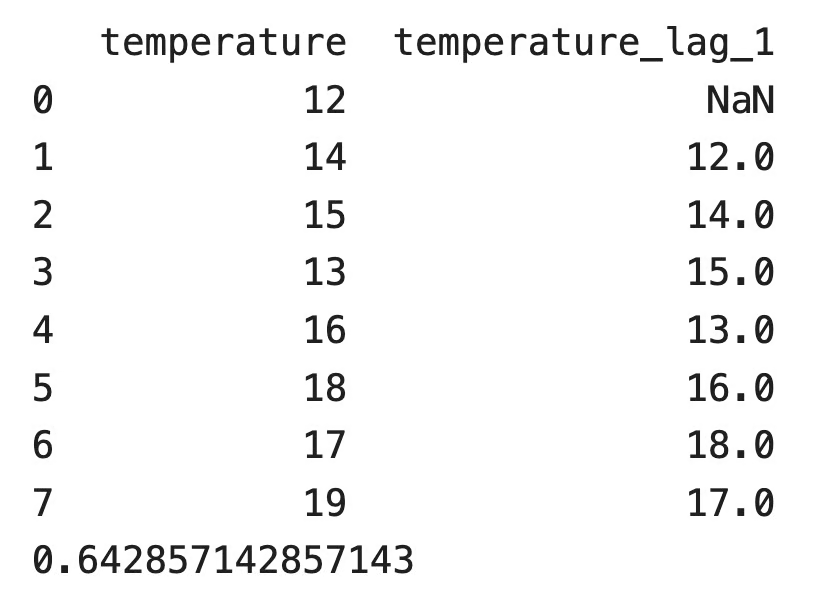
온도 열과 시차 1 사본이 있는 DataFrame
지연된 열의 첫 행이 비어 있는 이유는 첫 번째 관측 이전에는 값이 없기 때문입니다. pandas는 그 행을 건너뛰고 시차 1 자기상관 0.643을 반환합니다. 이 시계열에서는 따뜻한 날 뒤에 따뜻한 날이 오는 경향이 있습니다.
자기상관의 부호는 시계열의 거동을 바꿉니다:
자기상관이 0에 가깝다면 과거는 도움이 되지 않습니다. 이 경우 AR 모델은 평균을 예측하는 것보다 크게 나아지지 못합니다.
AR 모델은 정상적인 시계열을 필요로 합니다.
정상 시계열은 시계열의 어느 구간을 보더라도 평균, 분산, 주어진 시차에서의 자기상관이 같습니다. 통계학에서는 이를 약한 의미의 정상성(weak-sense stationarity)이라고 합니다.
이 조건이 중요한 이유는 모델이 하나의 고정된 계수 집합을 추정하기 때문입니다. 시계열의 평균이 시간이 지남에 따라 변하면, 오래된 데이터로 학습한 계수는 최신 데이터를 설명하지 못합니다. 주가처럼 수년에 걸쳐 추세를 보이는 시계열은 비정상적(non-stationary)인 대표적 예입니다. 일일 수익률은 훨씬 더 정상에 가깝습니다.
AR(1)에서는 계수 자체가 과정의 정상성을 결정합니다. 규칙은 간단합니다: phi_1은 -1과 1 사이여야 합니다.
abs(phi_1) < 1: 충격은 시간이 지나며 사라지고, 시계열은 평균으로 되돌아옵니다
phi_1 = 1: 시계열은 랜덤 워크가 되며, 충격이 사라지지 않습니다
abs(phi_1) > 1: 각 충격이 점점 커지며 시계열이 폭주합니다
AR(2)에는 세 조건이 동시에 필요합니다: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1, abs(phi_2) < 1.
두 개 이상의 지연에서는 일반 규칙이 필요합니다. 모든 AR(p) 모델에는 고유다항식이 있습니다:
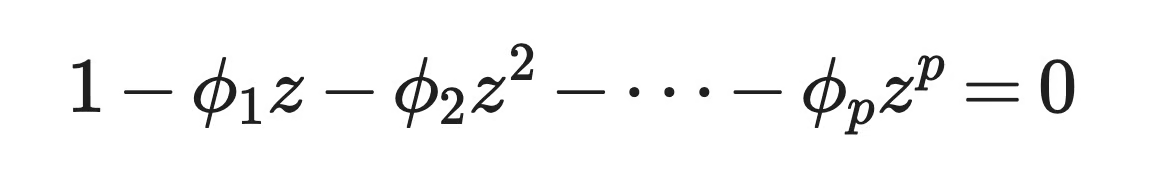
특성다항식
이 다항식의 모든 근이 단위원 밖에 있을 때(각 근 z의 절댓값이 1보다 클 때) 약한 의미의 정상입니다. 근은 복소수가 될 수 있으므로 경계가 직선이 아니라 복소평면의 원이 됩니다.
AR(1)로 확인해볼 수 있습니다. 다항식은 1 - phi_1 z = 0이므로 근은 z = 1 / phi_1입니다. 그 근이 단위원 밖에 있으려면 abs(phi_1) < 1이어야 하며, 이는 앞서 본 규칙과 같습니다.
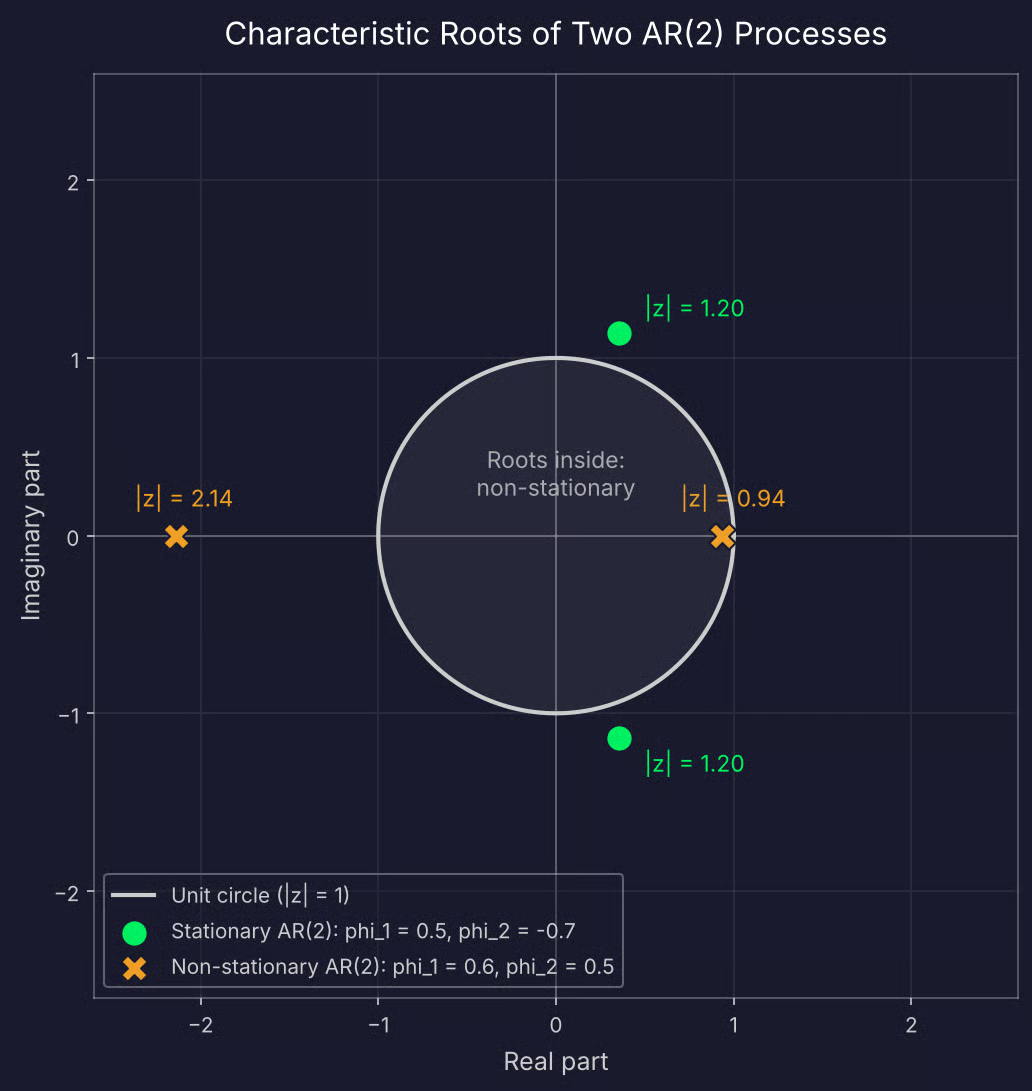
정상/비정상 AR(2) 과정의 근
직접 근을 계산할 일은 없습니다. statsmodels가 모델 적합 후 이를 반환하며, Python 섹션에서 데이터 자체의 정상성 검정 방법도 보여드립니다.
만약 시계열이 정상적이지 않다면, 차분(각 값을 다음 값에서 빼기)하여 차분값을 모델링할 수 있습니다. 이것이 ARIMA 모델의 "I"가 의미하는 바입니다.
모든 AR 모델의 방정식은 같습니다. 유형마다 달라지는 것은 차수 p, 즉 모델이 사용하는 과거 값의 개수입니다.
AR(1)은 직전 값 하나만으로 다음 값을 예측합니다.
선형회귀 같다고 느껴진다면 맞습니다. y_t-1을 x축, y_t를 y축에 두면 AR(1)은 점들을 가로지르는 직선을 적합합니다. 상수 c는 절편, phi_1은 기울기입니다. 단순 선형회귀를 안다면 AR(1)의 추정도 아는 셈입니다.
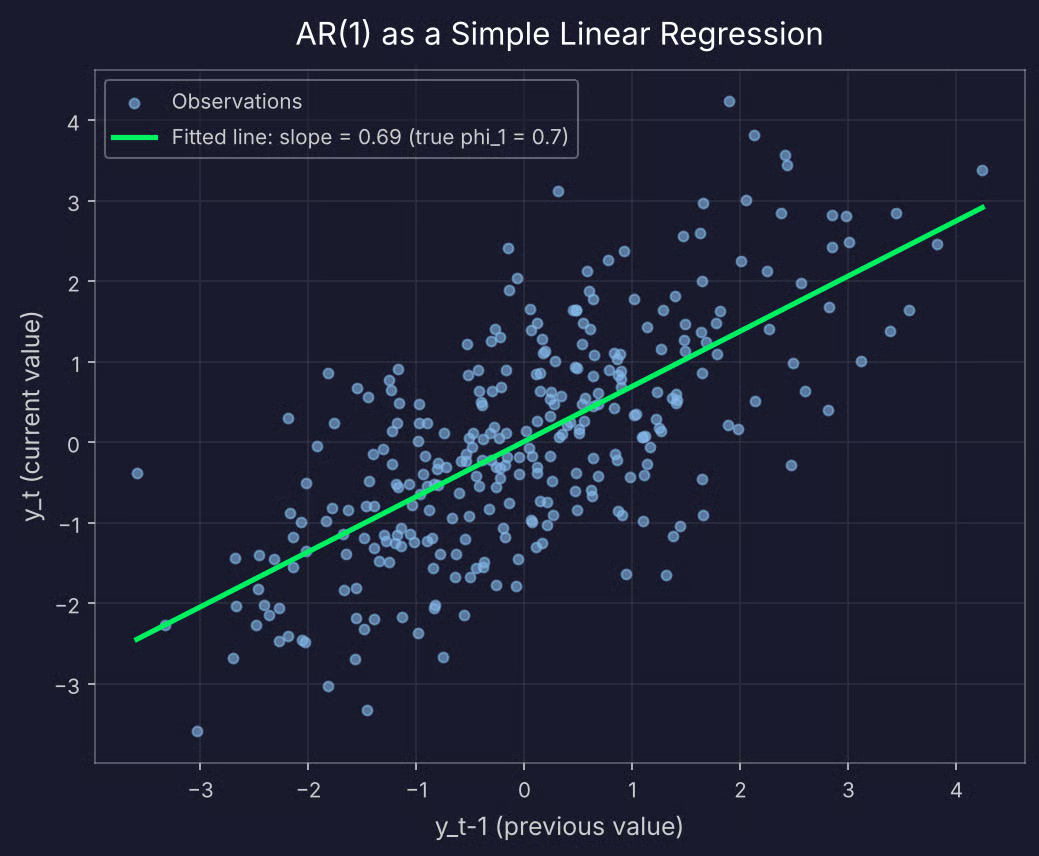
AR(1)에서 y_t 대 y_t-1 산점도
하지만 한 가지 차이가 있습니다. 표준 회귀에서는 예측 변수와 타깃 변수가 서로 다른 변수입니다. AR(1)에서는 예측 변수가 한 단계 시프트된 같은 시계열입니다. 그래서 행을 섞거나 임의의 학습/검증 분할을 사용할 수 없습니다. 데이터의 순서 자체가 모델의 일부이기 때문입니다.
phi_1의 값은 시계열 모양을 바꿉니다:
phi_1 = 0.3: 각 값이 다음 값에 거의 정보를 주지 않으므로, 시계열은 거의 잡음처럼 보입니다
phi_1 = 0.9: 시계열이 길고 매끄러운 흔들림을 보이며 평균으로 돌아오는 데 시간이 걸립니다
phi_1 = -0.8: 거의 매 스텝에서 평균 위아래로 지그재그를 그립니다
phi_1 = 1: 시계열이 랜덤 워크가 되어 평균으로 되돌아갈 기준이 사라집니다. 이는 앞 절의 비정상 사례입니다
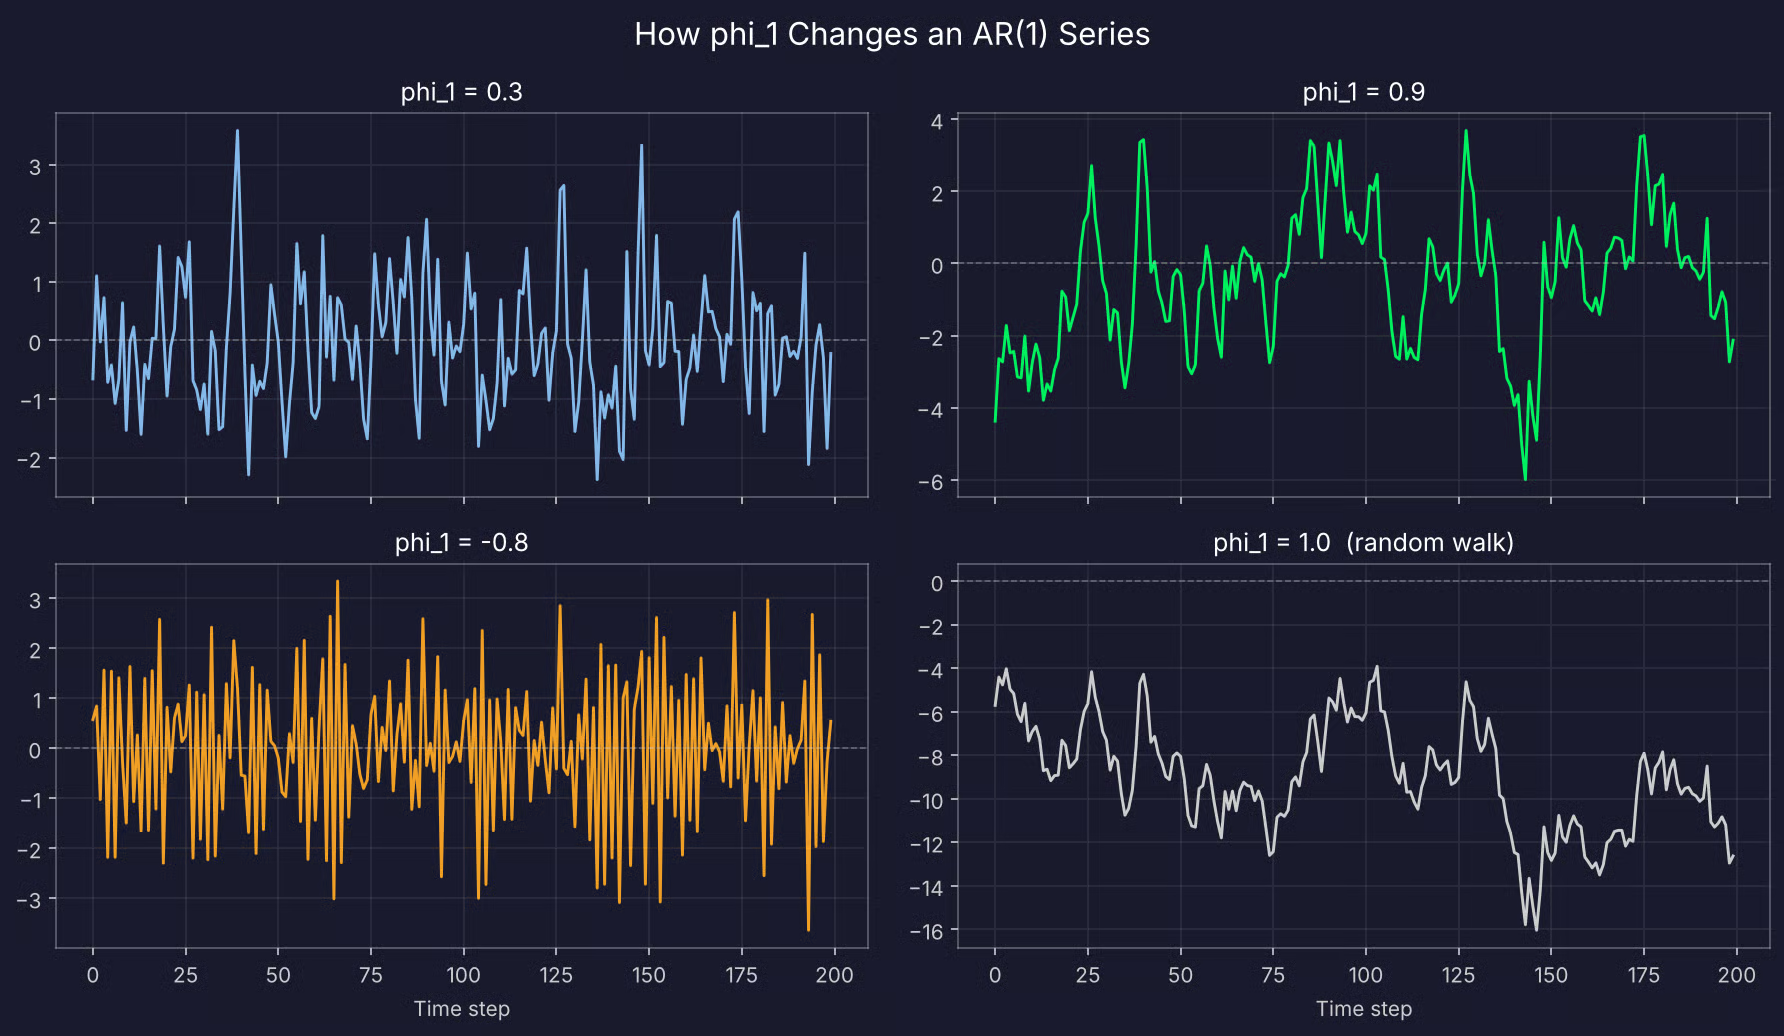
시뮬레이션된 AR(1) 시계열 4개
phi_1이 1 또는 -1에 가까워질수록 단일 충격이 시계열에 미치는 영향이 더 오래갑니다.
AR(2)는 직전 두 값을 사용합니다. 두 번째 지연은 주로 순환과 같은, AR(1)로는 만들 수 없는 패턴을 가능하게 합니다.
두 가지 계수 조합을 비교해보면 다음과 같습니다:
phi_1 = 0.5, phi_2 = 0.3: 두 지연이 같은 방향으로 작용하여, 더 길고 매끄러운 흔들림을 보이는 AR(1)처럼 보입니다
phi_1 = 0.5, phi_2 = -0.7: 두 번째 지연이 첫 번째와 반대로 작용하여, 대략 다섯 단계마다 반복되는 파동처럼 오르내립니다
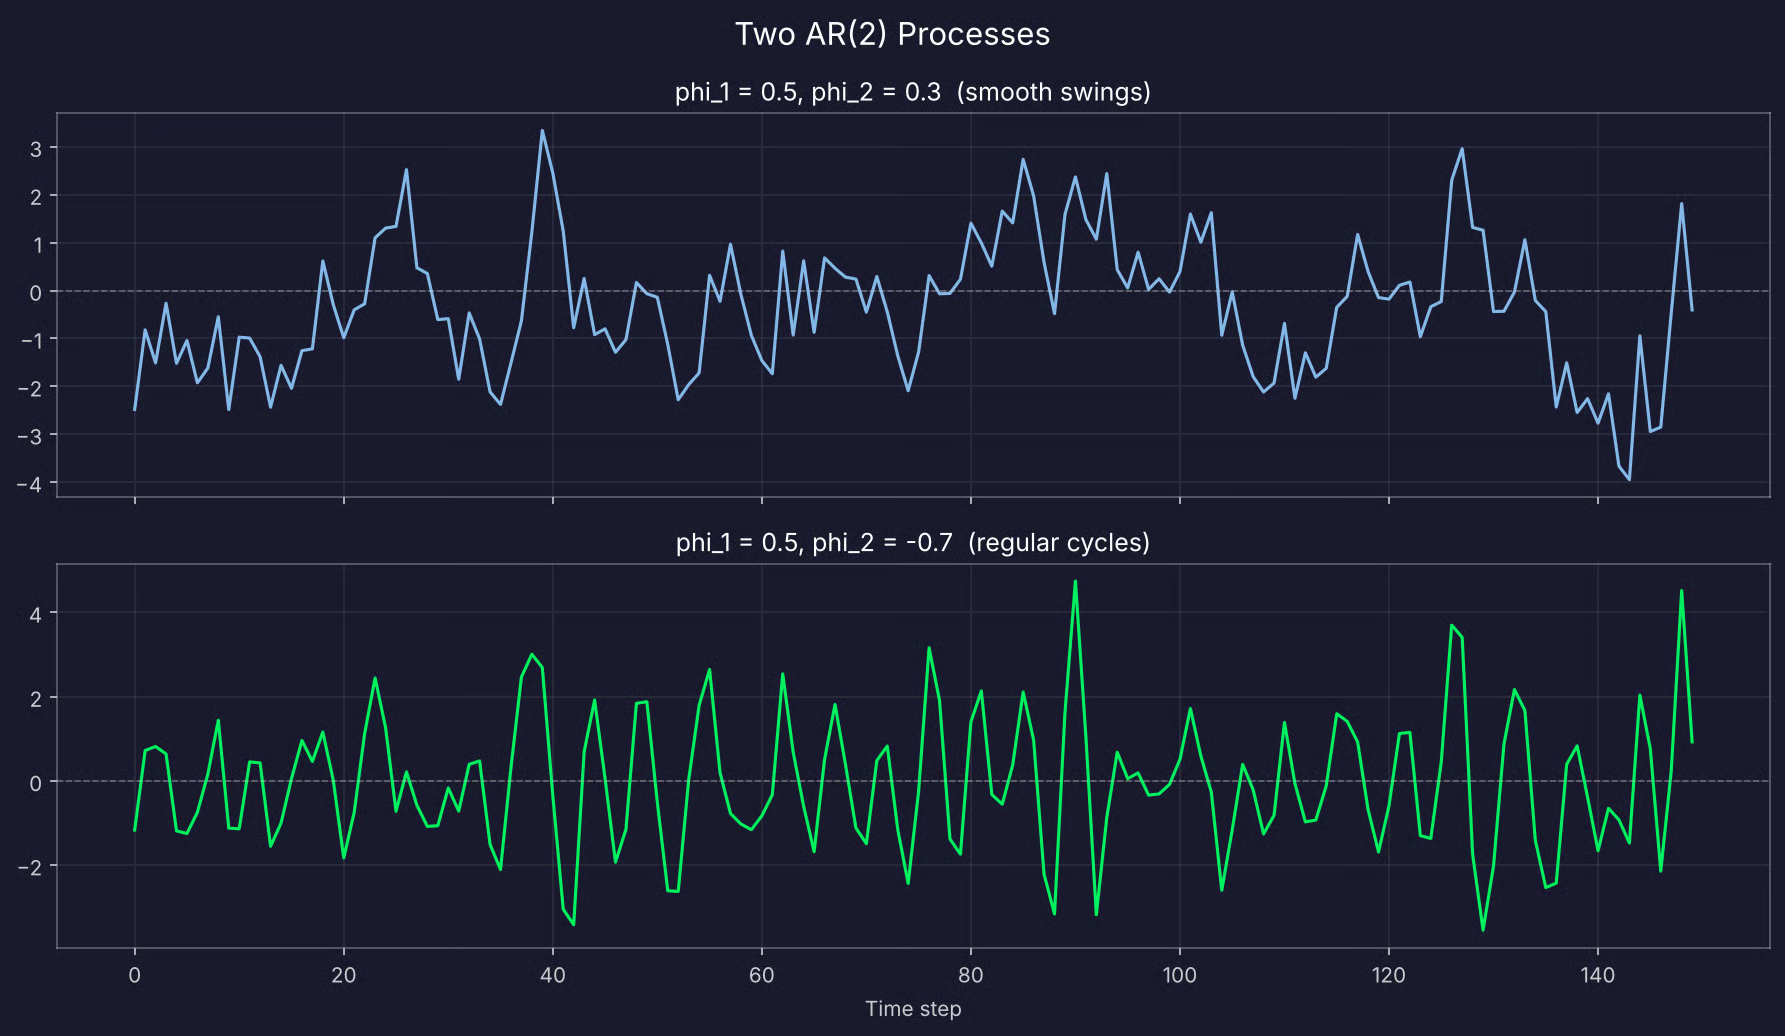
시뮬레이션된 AR(2) 시계열 두 개
AR(3), AR(4) 등은 한 번에 한 지연씩 추가합니다. 더 먼 과거가 최근보다 유용한 정보를 담을 때 필요합니다.
예를 들어 월별 매출을 모델링하는데, 전년도 같은 달이 이번 달을 잘 예측한다고 합시다. AR(12) 모델은 그 12개월 지연과 그 사이 11개의 지연을 포함합니다.
지연을 하나 추가할 때마다 추정할 계수도 하나 늘어납니다. 더 많은 데이터가 필요하고, 과적합 위험도 커집니다. 해석도 어려워집니다. 12개의 계수를 숫자만 보고 시계열의 거동을 직관적으로 파악하기는 어렵습니다. 대신 근을 확인합니다.
Python 섹션에서 PACF와 AIC로 적절한 차수를 고르는 방법을 보여드립니다.
AR 모델은 데이터가 순서를 가지며, 가까운 과거가 가까운 미래에 대해 말해주는 곳이라면 어디서든 등장합니다.
대부분의 활용은 네 그룹으로 나뉩니다:
마지막 예시는 많은 분들을 놀라게 합니다. 오늘날 챗봇의 배후 용어가 지금 읽고 있는 통계에서 나왔기 때문입니다.
이 섹션에서는 원시 데이터부터 평가 가능한 예측까지, Python의 statsmodels로 자기회귀 모델을 적합해 보겠습니다.
데이터 처리를 위한 pandas와 NumPy, 모델과 검정을 위한 statsmodels, 오차 지표를 위한 scikit-learn이 필요합니다:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorAR(2) 과정으로 2년간의 일일 전력 수요를 시뮬레이션합니다.
시뮬레이션 데이터를 쓰는 이유는 진짜 계수를 미리 알고 있기 때문입니다. 이렇게 하면 모델이 이를 제대로 찾는지, 시차 선택 도구가 올바른 차수를 가리키는지 확인할 수 있습니다.
과정은 c = 15, phi_1 = 0.6, phi_2 = 0.25이며, 장기 평균은 100 MWh가 됩니다:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()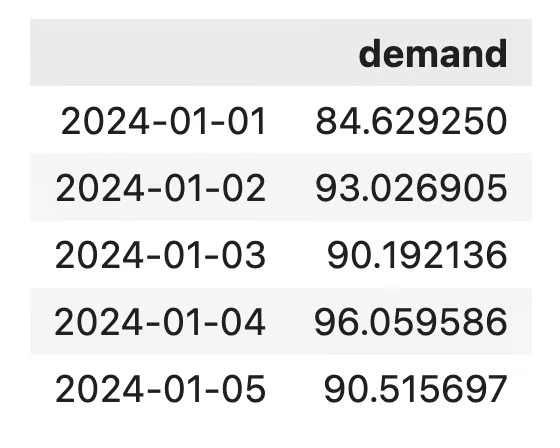
일일 전력 수요 데이터셋
처음 100일은 제거했습니다. 워밍업 기간을 두면 시계열이 본래 거동으로 자리 잡은 후부터 사용할 수 있기 때문입니다.
전체 시리즈는 다음과 같습니다:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()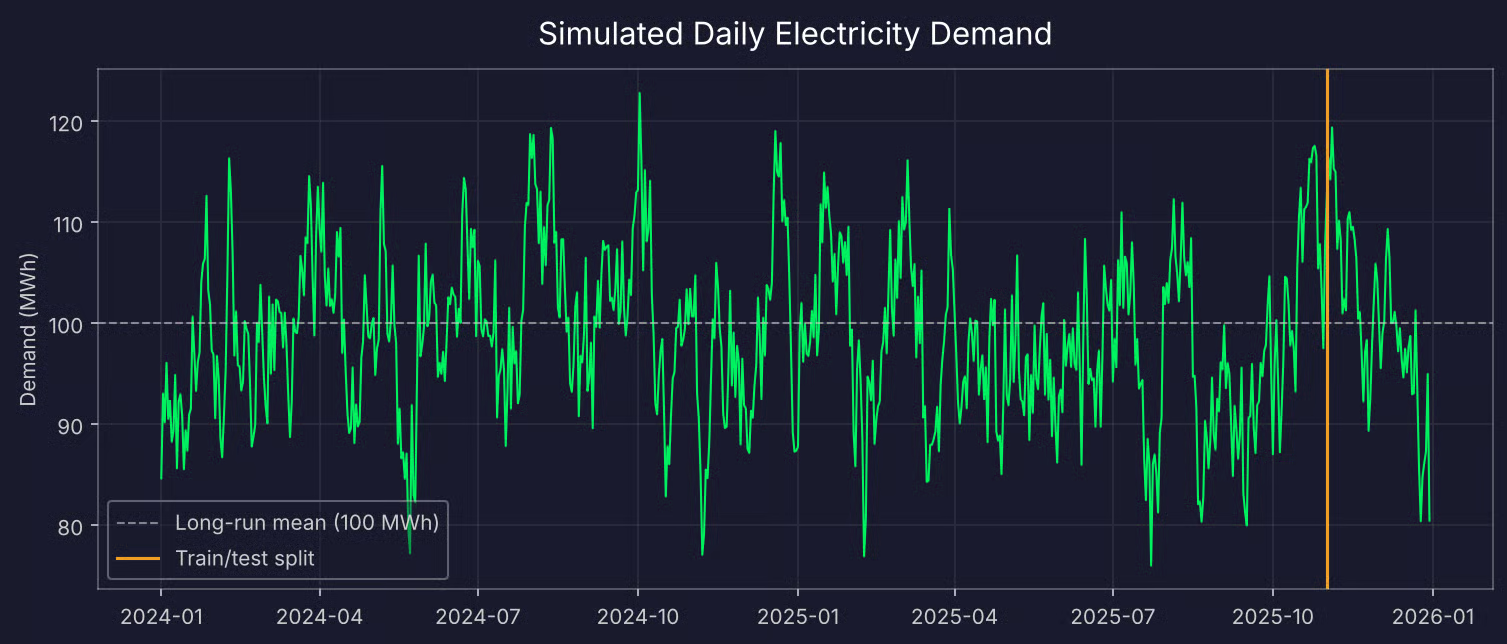
2년치 시뮬레이션된 일일 전력 수요
시계열은 추세 없이 100 주변을 오르내립니다. 정상 시계열이 보여야 하는 모습이지만, 시각적 확인만으로는 충분하지 않습니다.
보강 딕키-풀러(ADF) 검정은 시계열이 정상인지 확인합니다. 귀무가설은 비정상이라는 것이므로, 작은 p-값이 바람직합니다:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")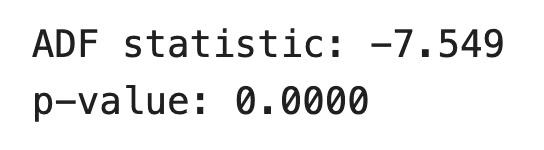
ADF 검정 결과
p-값이 0.05보다 훨씬 작으므로, 귀무가설을 기각하고 시계를 정상으로 볼 수 있습니다.
자신의 데이터가 이 검정을 통과하지 못한다면 df["demand"].diff().dropna()로 차분한 다음 다시 검정하세요.
시계열 데이터는 섞을 수 없으므로, 테스트 세트는 시리즈의 끝에서 떼어내야 합니다. 마지막 60일을 테스트로 두겠습니다:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
훈련용 670일, 테스트용 60일이 남습니다.
모델 성능을 좌우하는 단계입니다. 지연을 너무 적게 선택하면 데이터의 패턴을 놓치고, 너무 많이 선택하면 훈련 데이터의 잡음을 학습해 미래에 재현되지 않습니다.
이를 위한 도구는 두 가지가 있습니다.
첫째는 부분자기상관함수(PACF)입니다. PACF는 더 짧은 모든 시차의 효과를 제거한 뒤, 시계열과 각 시차의 상관을 보여줍니다. AR(p) 과정에서는 PACF가 시차 p까지 유의하게 튀고, 그 이후에는 0 근처로 떨어집니다:
plot_pacf(train, lags=20, method="ywm")
plt.show()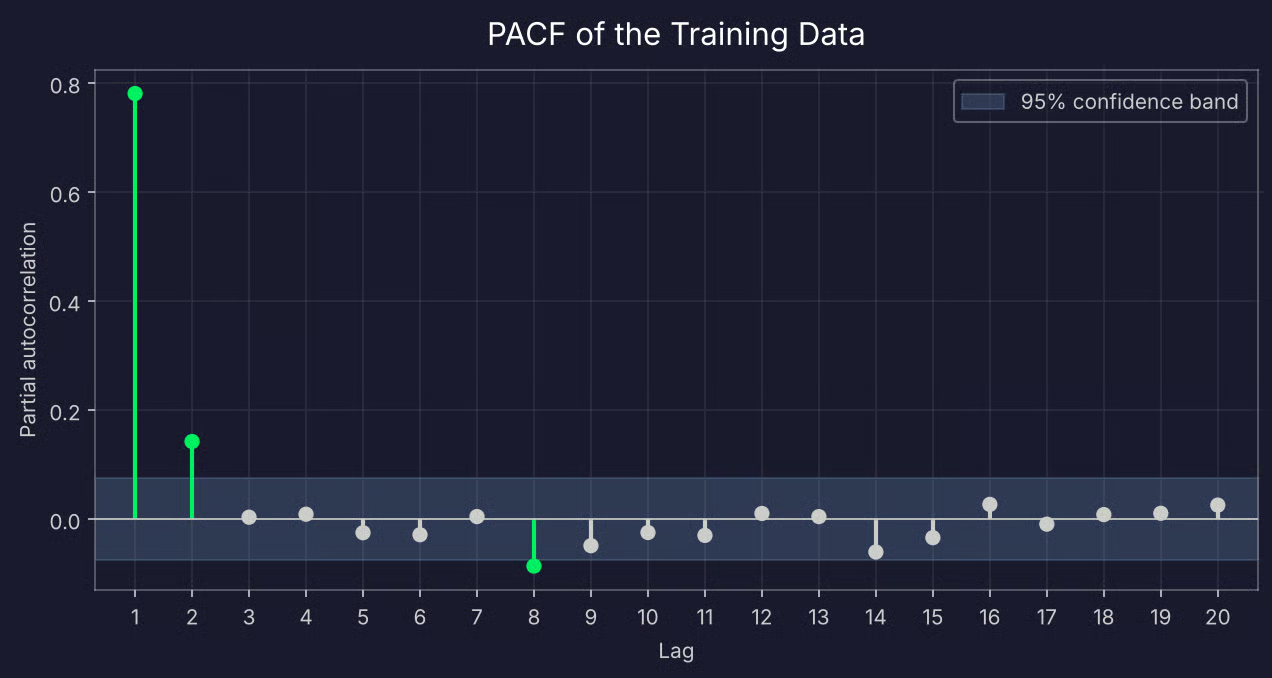
훈련 데이터의 PACF
시차 1과 2는 신뢰대역을 크게 벗어나고, 시차 3은 0 근처로 내려갑니다. AR(2)를 가리킵니다.
시차 8에서 작은 스파이크가 신뢰대역 가장자리를 조금 넘습니다. 너무 의미를 두지 마세요. 대역은 95% 신뢰수준으로 그려지므로, 20개 시차에서는 우연히 한두 개가 넘을 수 있습니다.
둘째는 정보 기준입니다. AIC와 BIC는 데이터 적합도를 보상하는 한편, 매개변수 하나마다 패널티를 부여합니다. BIC의 패널티가 더 커서 더 작은 모델을 고르는 경향이 있습니다. statsmodels는 최대 차수까지 모든 차수를 시험하고 최적을 반환할 수 있습니다:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")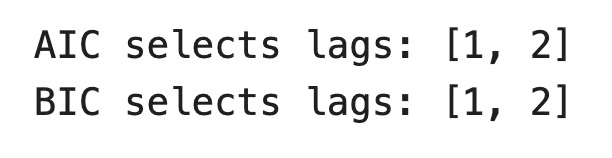
AIC/BIC 시차 선택
두 기준 모두 PACF와 일치합니다. 실무에서는 AIC가 BIC보다 약간 더 큰 모델을 고르는 경우가 종종 있습니다. 그럴 땐 더 작은 쪽으로 시작하세요.
차수를 정했다면 적합은 두 줄이면 됩니다:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")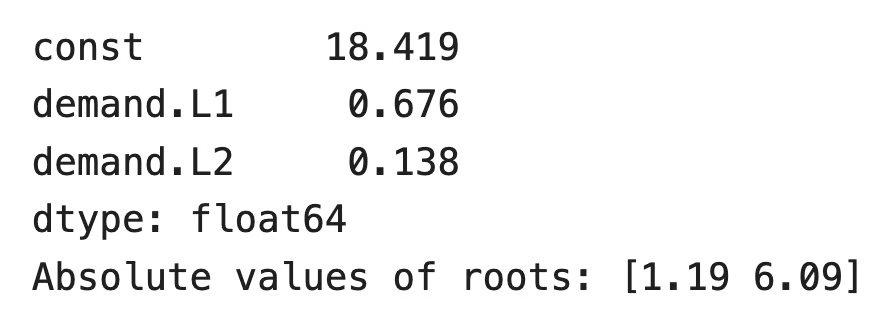
AR(2) 모델 매개변수
진짜 값은 0.6과 0.25입니다. 모델은 첫 번째 지연에 조금 더, 두 번째 지연에 조금 덜 가중을 두지만, 두 계수의 합은 비슷합니다(0.81 대 0.85). 데이터 670개로는 정확히 같은 값을 복원하기 어렵습니다.
두 근의 절댓값이 모두 1보다 크므로 적합된 모델은 정상입니다. 표준오차, p-값, 전체 근 표가 필요하면 results.summary()를 호출하세요.
테스트 구간 예측에는 두 가지 방법이 있으며, 서로 다른 질문에 답합니다:
다단계 예측은 적합 결과에서 바로 얻습니다. 단계별 예측은 학습된 계수를 전체 시리즈에 적용합니다:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")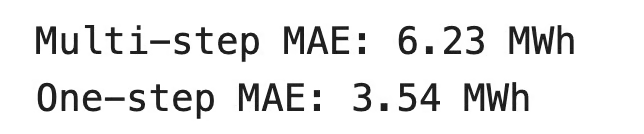
예측 결과
평균 절대 오차(MAE)는 예측값과 실제값의 절대 차이의 평균입니다. 데이터와 같은 단위이므로 직관적으로 읽을 수 있습니다. 단계별 예측은 평균 3.54 MWh만큼 빗나갔습니다.
두 예측을 실제값과 비교하면 다음과 같습니다:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()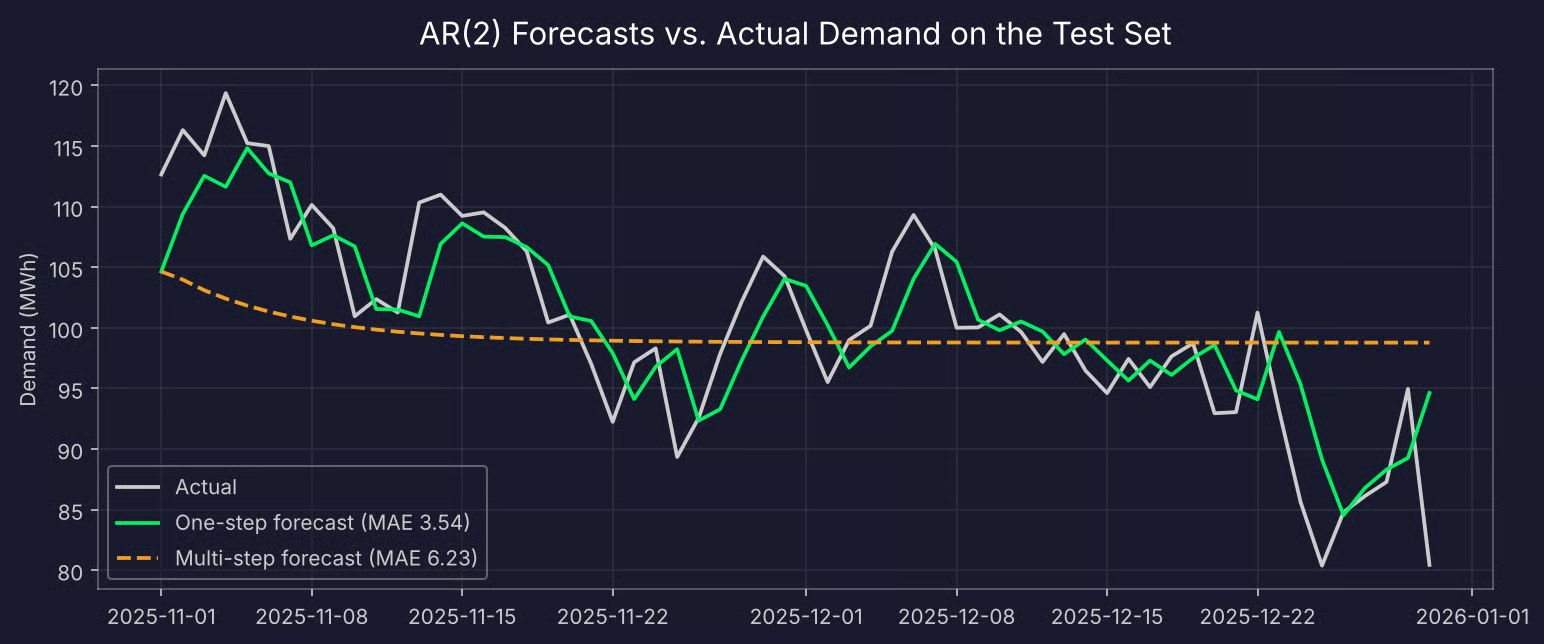
단계별/다단계 AR(2) 예측과 실제 수요 비교
단계별 예측은 실제값을 하루 정도 뒤따라가며 밀접하게 추적합니다. 다단계 예측은 마지막 관측값에서 시작해 약 3주 안에 평균 부근으로 평탄해집니다.
모든 정상 AR 모델이 이렇게 거동합니다. 예측 시점이 멀어질수록 과거가 말해주는 정보는 줄어들고, 최선의 추정치는 장기 평균이 됩니다. 그래서 AR 모델은 단기 예측에 가장 잘 맞습니다.
더 많은 이력을 쓰면 더 좋은 예측이 될 거라 생각하기 쉽습니다. 지연 수를 늘려가며 모델을 적합하고 단계별 MAE를 비교해 보겠습니다:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")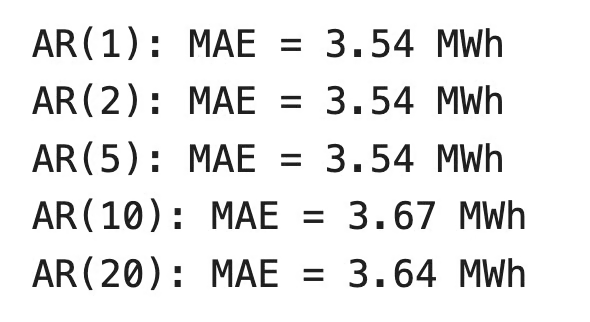
지연 수 증가에 따른 MAE
오차는 AR(2) 이후로 개선되지 않고, AR(10)과 AR(20)에서는 오히려 악화됩니다. 추가된 계수들이 훈련 데이터의 잡음을 적합한 것입니다.
여기서는 AR(1)이 AR(2)만큼 잘하는 것도 볼 수 있습니다. 추정된 두 번째 계수가 작아 이 테스트 세트에서는 기여가 거의 없기 때문입니다. 두 모델의 성능이 같다면, 더 단순한 모델이 설명도 쉽고 새 데이터에서 망가질 가능성도 작습니다.
비용 측면도 있습니다. AR(20)은 3개 대신 21개의 매개변수를 추정합니다.
결론적으로, PACF와 정보 기준으로 차수를 정하고, 테스트 세트로 확인만 하세요.
AR 모델은 많은 예측 문제에 잘 맞지만, 모든 경우는 아닙니다. 어디에서 잘 작동하고 어디에서 그렇지 않은지, 그리고 이를 기반으로 한 모델들과 어떻게 비교되는지 살펴봅니다.
AR 모델의 주된 장점은 두 가지입니다:
주요 한계도 두 가지입니다:
한 가지 문제가 더 있습니다. 지연된 값들은 같은 시계열에서 왔기 때문에 서로 상관되어 있습니다. 수요 데이터에서 y_t-1과 y_t-2의 상관은 0.78입니다.
이것은 다중공선성이라고 하며, 이는 어떤 회귀 모델에도 영향을 줍니다. 두 예측 변수가 함께 움직이면, 모델은 어느 변수가 원인인지 구분하기 어렵습니다. 계수는 덜 안정적이 되고, 표준오차는 커집니다.
이는 앞서 본 현상을 설명합니다. 모델은 0.6과 0.25 대신 0.676과 0.138을 추정했습니다. 한 지연에서 다른 지연으로 가중이 이동했지만, 합은 비슷하게 유지됐습니다. 예측은 크게 나빠지지 않지만, 개별 계수에 대한 신뢰는 떨어집니다. 지연을 추가할수록 문제가 악화됩니다.
AR은 고전적 시계열 예측의 세 가지 구성요소 중 하나입니다. 나머지 둘은 이동평균(MA) 모델과 이를 결합한 ARIMA입니다.
AR 모델은 과거 값으로 예측합니다. MA 모델은 과거 오차로 예측합니다:
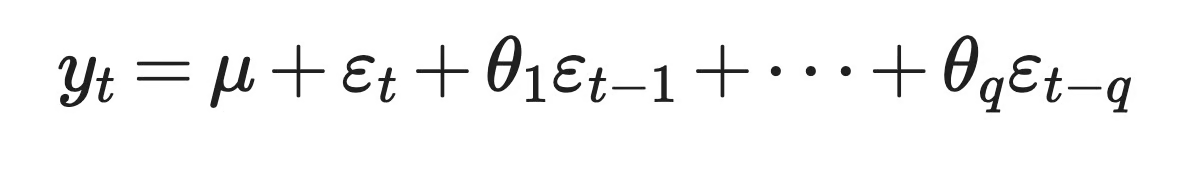
ARMA 모델
여기서 mu는 시계열의 평균, theta_1부터 theta_q는 계수, epsilon_t-1부터 epsilon_t-q는 이전 단계의 무작위 충격입니다. 굴리는 평균(rolling mean)과 혼동하지 마세요. 이름은 같지만 모델은 다릅니다.
두 모델은 충격에 다르게 반응합니다. MA(q) 모델에서는 충격의 영향이 정확히 q단계 지속됩니다. AR 모델에서는 충격이 시간이 지나며 사라지지만 완전히 0이 되지는 않습니다. 이 차이 때문에 차수 선택 도구도 다릅니다. AR 모델에서는 PACF가 시차 p 이후 잘려나가고, MA 모델에서는 ACF가 시차 q 이후 잘려나갑니다.
ARIMA는 이를 모두 합칩니다. ARIMA(p, d, q)는 세 부분으로 구성됩니다:
즉 AR은 ARIMA의 특수한 경우입니다. d와 q를 0으로 두면 AR 모델이 됩니다. 수요 데이터로 확인해 봅시다:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))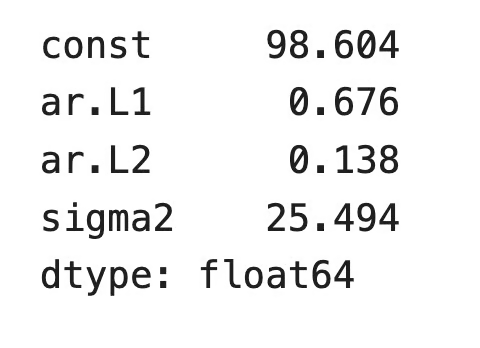
적분과 이동평균 차수가 0인 ARIMA 모델
AR 계수는 AutoReg 결과와 일치합니다. 상수가 다른 이유는 ARIMA는 시계열의 평균을 보고하고, AutoReg는 절편 c를 보고하기 때문입니다.
이제 ARIMA가 더 나아가는 지점을 보겠습니다. 도시가 성장해 전력 수요가 매일 조금씩 증가한다고 합시다. 시계열에 추세가 생겨 ADF 검정을 통과하지 못하며, AR 모델은 더 이상 원시 시리즈에 바로 적용될 수 없습니다.
하지만 ARIMA(2, 1, 0)은 가능합니다. 한 번 차분하여 원시 값 대신 일일 변화량을 모델링하고, 그 변화량에 AR(2)를 적합합니다. 폭염 같은 충격이 다음 날 수요에도 영향을 미친다면, MA 항을 추가해 ARIMA(2, 1, 1)을 사용할 수 있습니다.
AR 부분은 어떤 경우에도 같은 역할을 합니다. ARIMA는 그저 데이터를 준비하고 남은 부분을 모델링합니다. 더 깊이 배우고 싶다면 ARIMA Models in R 코스가 전과정을 다룹니다.
자기회귀 모델은 시리즈의 과거로부터 다음 값을 예측합니다. 예측 변수가 타깃의 지연 사본이라는 점만 제외하면 선형회귀와 같으며, 가장 이해하기 쉬운 시계열 모델 중 하나입니다.
경제, 음성 부호화, EEG 분석, 심지어 오늘날 언어 모델의 이름에서도 만나게 됩니다. 또한 정상 데이터가 필요하고, 올바른 시차 차수에 의존하며, 지연 변수 간 상관으로 개별 계수의 신뢰도가 떨어지는 등 한계도 보았습니다.
AR 모델을 이해하면 고전적 예측의 나머지가 훨씬 쉬워집니다. 다음 단계는 자연스럽게 ARIMA이며, 우리의 ARIMA 튜토리얼에서 차분과 MA 항이 여기서 배운 내용을 어떻게 확장하는지 확인하세요. 실습 중심 경로로는 ARIMA Models in Python 코스를 추천합니다.
DataCamp로 학습하세요
강의
강의
강의