Kurs
Python ile Zaman Serisi Analizi
4 sa
70.9K
Çevrimiçi içeriklerin çoğu doğrudan ARIMA’ya geçer ve AR kısmına varsa bir satır ayırır. Oysa AR, modelin temelidir. Onu anlamazsanız, ARIMA’nın geri kalanı da anlam ifade etmez.
Basitçe söylemek gerekirse, otokorelasyonlu bir model bir zaman serisinin gelecekteki değerlerini kendi geçmiş değerlerinden tahmin eder. Ekonomi, finans, işaret işleme ve iklim verilerinde karşınıza çıkar. Esasen bir regresyon modelidir; bu yüzden regresyona dair bildiklerinizi zaman serisi tahmini ile ilişkilendirir ve ARIMA’nın üzerine kurulduğu temeli oluşturur.
Bu yazıda, otokorelasyonlu bir modelin nasıl çalıştığını, Python’da statsmodels ile nasıl kurulduğunu ve doğru gecikme derecesinin nasıl seçileceğini adım adım anlatacağım.
Otokorelasyonlu bir model, bir zaman serisinin bir sonraki değerini önceki değerlerinin ağırlıklı toplamından tahmin eder.
İsmindeki “auto” kendi anlamına gelir; “regression” ise bir değişkeni diğerlerinden tahmin etmeyi ifade eder. Dolayısıyla otokorelasyonlu model, bir serinin kendi geçmişine karşı yapılan bir regresyondur.
Diyelim ki yarının elektrik talebini tahmin etmek istiyorsunuz. Bugünün talebi iyi bir başlangıç noktasıdır ve dünün talebi biraz daha bilgi ekler. Otokorelasyonlu model bu sezgiyi bir formüle döker ve ağırlıkları verilerinizden öğrenir.
AR modelleri AR(p) olarak yazılır; burada p modelin derecesidir. Derece, modelin kaç geçmiş değeri kullandığını söyler:
p değeri kullanırDaha yüksek derece, otomatik olarak daha iyi bir model demek değildir. Yazının ilerleyen kısmında p’yi nasıl seçeceğinizi göstereceğim.
Genel bir AR(p) modelinin biçimi şöyledir:
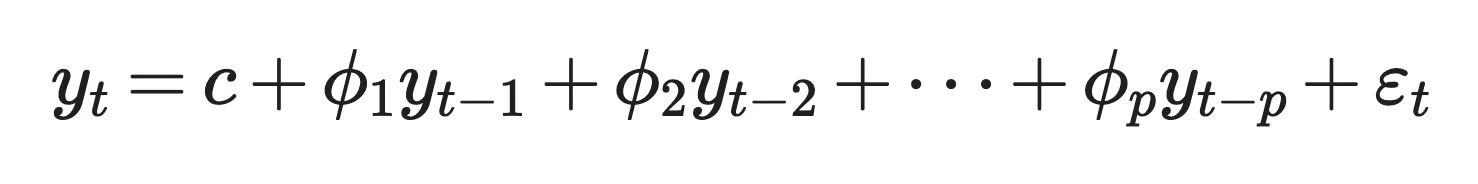
Genel AR(p) modeli
Her terimin ne yaptığı şöyle:
y_t: Zaman t’deki seri değeri; yani tahmin etmek istediğiniz değer
c: Sabit terim; katsayılarla birlikte serinin uzun dönem ortalamasını belirler
phi_1 ile phi_p: Katsayılar; her bir geçmiş değerin tahmine ne kadar katkı verdiğini gösterir
y_t-1 ile y_t-p: Gecikmeli değerler; “gecikme” kaç adım geriye baktığınızı ifade eder
epsilon_t: Beyaz gürültü; ortalaması sıfır, varyansı sabit ve zaman içinde otokorelasyonu olmayan rastgele hata
Basitçe, model son p değerin her birini kendi ağırlığıyla çarpar ve sabiti ekler. Geriye kalan kısım gürültüdür; yani geçmişin açıklayamadığı y_t bölümü.
AR(1) en basit sürümdür:
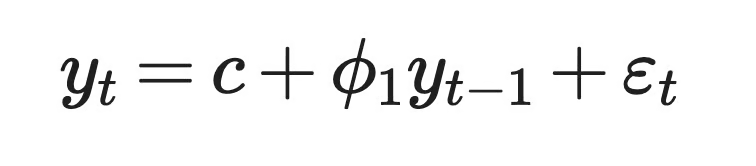
AR(1) modeli
phi_1’in değeri bugünün yarına ne kadar etki ettiğini belirler.
c = 2 ve phi_1 = 0.8 olsun. Bugünkü değer 15 ise model yarın için 2 + 0.8 x 15 = 14 tahmini verir. Sonraki tahmin 2 + 0.8 x 14 = 13.2 olur. Her adım seri değerini, uzun dönem ortalaması olan c / (1 - phi_1) yani 10’a doğru yaklaştırır.
Eğer phi_1 negatifse, seri her adımda ortalamanın üstü ve altı arasında zıplar.
AR(2) ikinci bir gecikme ekler:
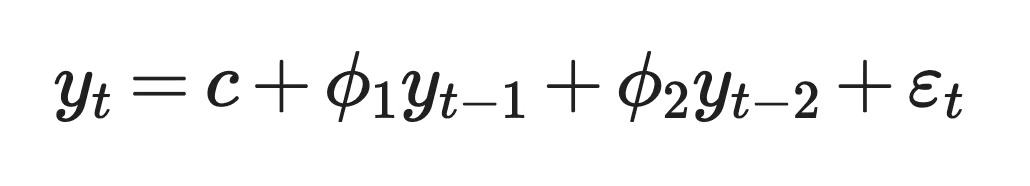
AR(2) modeli
İki gecikmeyle, model AR(1)’in yakalayamadığı desenleri, örneğin döngüleri, tanımlayabilir. Örneğin, pozitif bir phi_1 ile negatif bir phi_2, iş döngüsüne benzer şekilde dalgalar halinde yükselip alçalan bir seri üretebilir.
Dolayısıyla her AR modelinde iki karar vardır: kaç gecikme kullanılacağı ve bunlara hangi ağırlıkların verileceği.
Bir AR modelinin çalışması için verinizde iki koşulun sağlanması gerekir. Geçmiş değerler gelecekle ilişkili olmalı ve seri zaman içinde aynı şekilde davranmalı. İlki otokorelasyon, ikincisi durağanlık olarak adlandırılır.
Otokorelasyon, bir zaman serisi ile kendisinin gecikmeli bir kopyası arasındaki korelasyondur.
AR modellerinin varlık sebebi budur. Eğer bugünün değeri yarın hakkında hiçbir şey söylemiyorsa, modelin geçmişten öğreneceği bir şey yoktur.
Kodda, bir değerler sütununu alır, kopyalar ve kopyayı bir satır aşağı kaydırırsınız. Böylece her satır bir değeri bir öncekiyle eşleştirir. İki sütun arasındaki korelasyon gecikme-1 otokorelasyonudur. İki satır kaydırdığınızda gecikme-2 otokorelasyonunu elde edersiniz.
pandas ile şöyle görünür:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))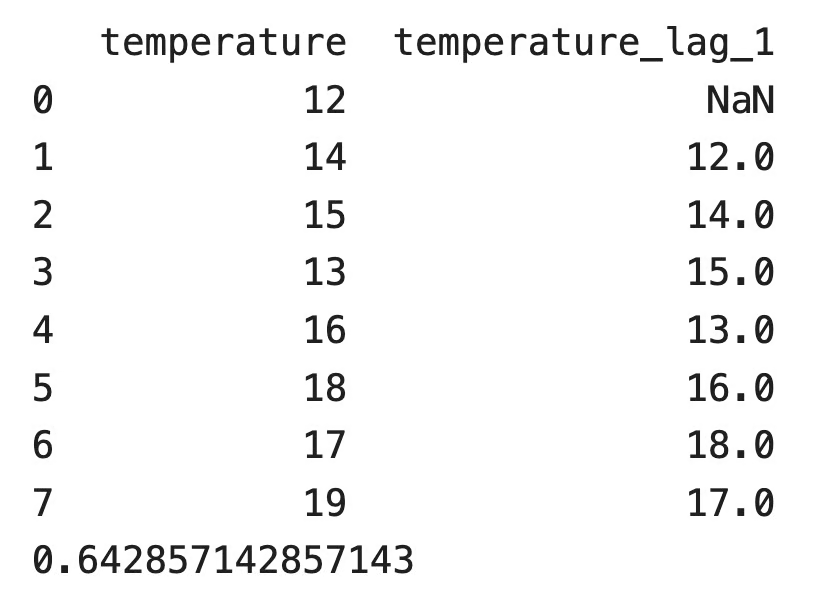
Sıcaklık sütunu ve gecikme-1 kopyasıyla DataFrame
Gecikmeli sütunun ilk satırı boştur, çünkü ilk değerden önce bir okuma yoktur. pandas bu satırı atlar ve 0.643’lük bir gecikme-1 otokorelasyonu verir. Bu seride sıcak günleri genelde sıcak günler izler.
Otokorelasyonun işareti serinin davranışını değiştirir:
Sıfıra yakın bir otokorelasyon, geçmişin yardımcı olmadığını gösterir. Bu durumda bir AR modeli ortalama tahminden çok daha iyi sonuç vermez.
AR modelleri durağan bir zaman serisine ihtiyaç duyar.
Durağan bir seride, serinin hangi kısmına bakarsanız bakın ortalama, varyans ve belirli bir gecikmedeki otokorelasyon aynıdır. İstatistikçiler buna zayıf anlamda durağanlık der.
Bu önemlidir çünkü model sabit bir katsayı kümesi tahmin eder. Eğer serinin ortalaması zamanla kayıyorsa, eski verilerden öğrenilen katsayılar yeni verileri tanımlayamaz. Hisse fiyatları yıllar içinde trend gösterdikleri için durağan olmayan serilere klasik bir örnektir. Günlük getiriler ise durağanlığa çok daha yakındır.
Bir AR sürecinin durağan olup olmadığına katsayılar karar verir. AR(1) için kural basittir: phi_1 -1 ile 1 arasında olmalıdır.
abs(phi_1) < 1: Şoklar zamanla sönümlenir ve seri ortalamasına geri döner
phi_1 = 1: Seri rassal yürüyüşe dönüşür ve şoklar hiç sönümlenmez
abs(phi_1) > 1: Her bir şok büyüyerek artar ve seri patlar
AR(2) aynı anda üç koşula ihtiyaç duyar: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1 ve abs(phi_2) < 1.
İki gecikmeden sonra genel bir kurala ihtiyaç vardır. Her AR(p) modelinin karakteristik bir polinomu bulunur:
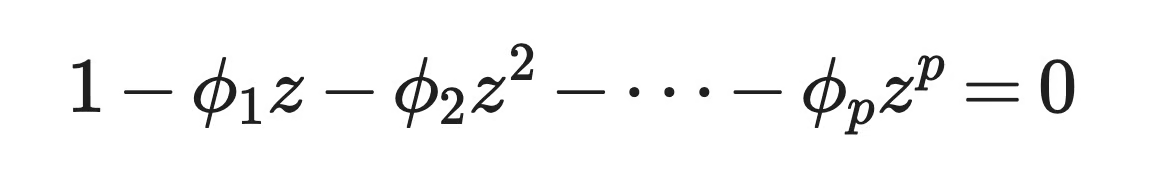
Karakteristik polinom
Tüm kökler birim çemberin dışında olduğunda süreç zayıf anlamda durağandır; yani her kökün z mutlak değeri 1’den büyüktür. Kökler karmaşık sayı olabilir; bu yüzden sınır karmaşık düzlemde bir doğru değil, bir çemberdir.
Bunu AR(1) ile kontrol edebilirsiniz. Polinom 1 - phi_1 z = 0’dır; dolayısıyla kök z = 1 / phi_1 olur. Bu kök sadece abs(phi_1) < 1 iken birim çemberin dışındadır; bu da önceki kuralla aynıdır.
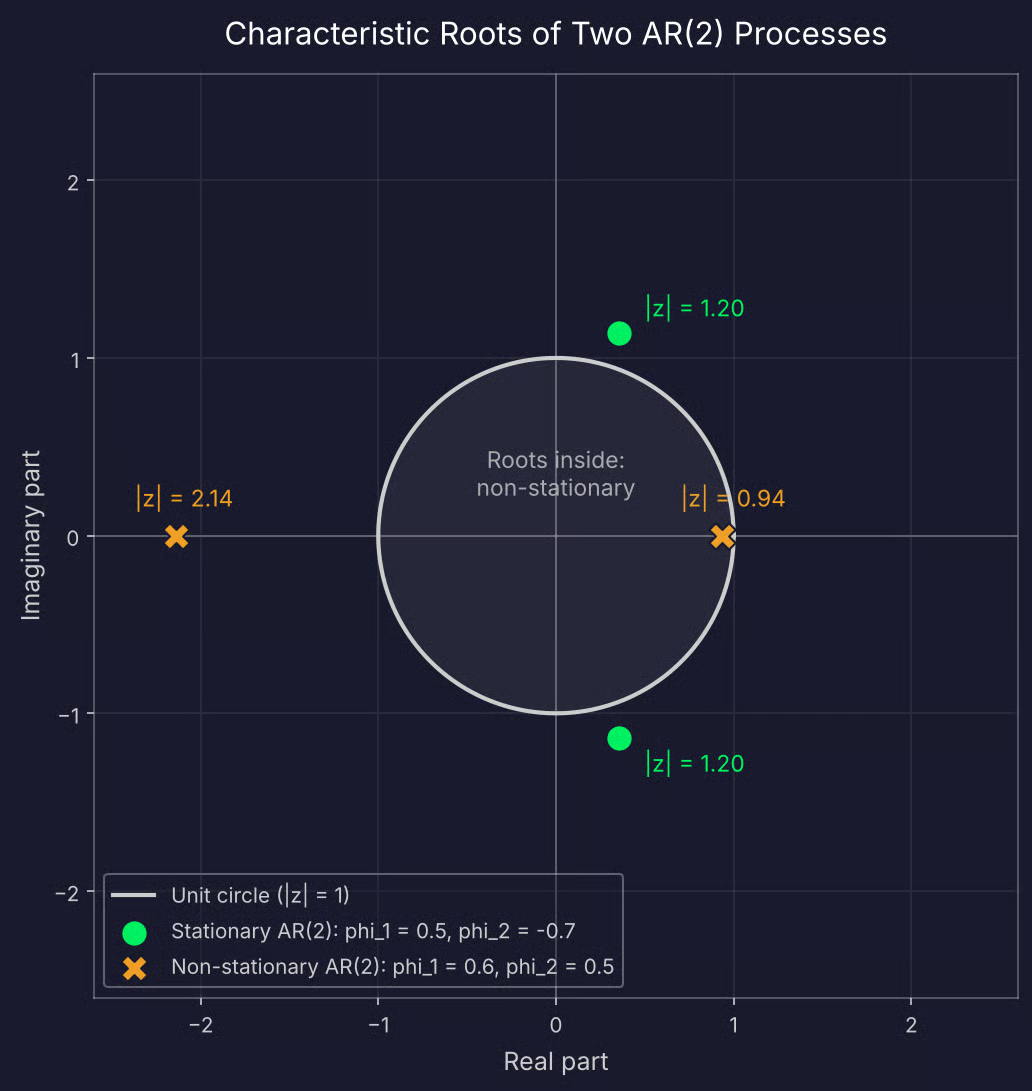
Durağan ve durağan olmayan bir AR(2) sürecinin kökleri
Bu kökleri elle hesaplamazsınız. statsmodels bir modeli kurduktan sonra bunları döndürür; ayrıca Python bölümünde verinin kendisini durağanlık açısından nasıl sınayacağınızı göstereceğim.
Eğer seriniz durağan değilse fark alabilirsiniz — her değerden bir sonrakini çıkarır ve farkları modelleyebilirsiniz. Bu, ARIMA modellerindeki “I” harfinin ifade ettiği şeydir.
Her AR modelinin denklemi aynıdır. Türler arasında değişen şey derecedir (p); yani modelin kaç geçmiş değeri kullandığı.
AR(1) yalnızca bir önceki değeri kullanarak bir sonrakini tahmin eder.
Bu kulağa doğrusal regresyonu andırıyorsa, nedeni budur. y_t-1’i x eksenine, y_t’yi y eksenine koyduğunuzda AR(1), noktalar üzerinden düz bir çizgi uydurur. c sabittir (intercept) ve phi_1 eğimdir. Basit doğrusal regresyonu biliyorsanız, AR(1)’in nasıl tahmin edildiğini zaten biliyorsunuz.
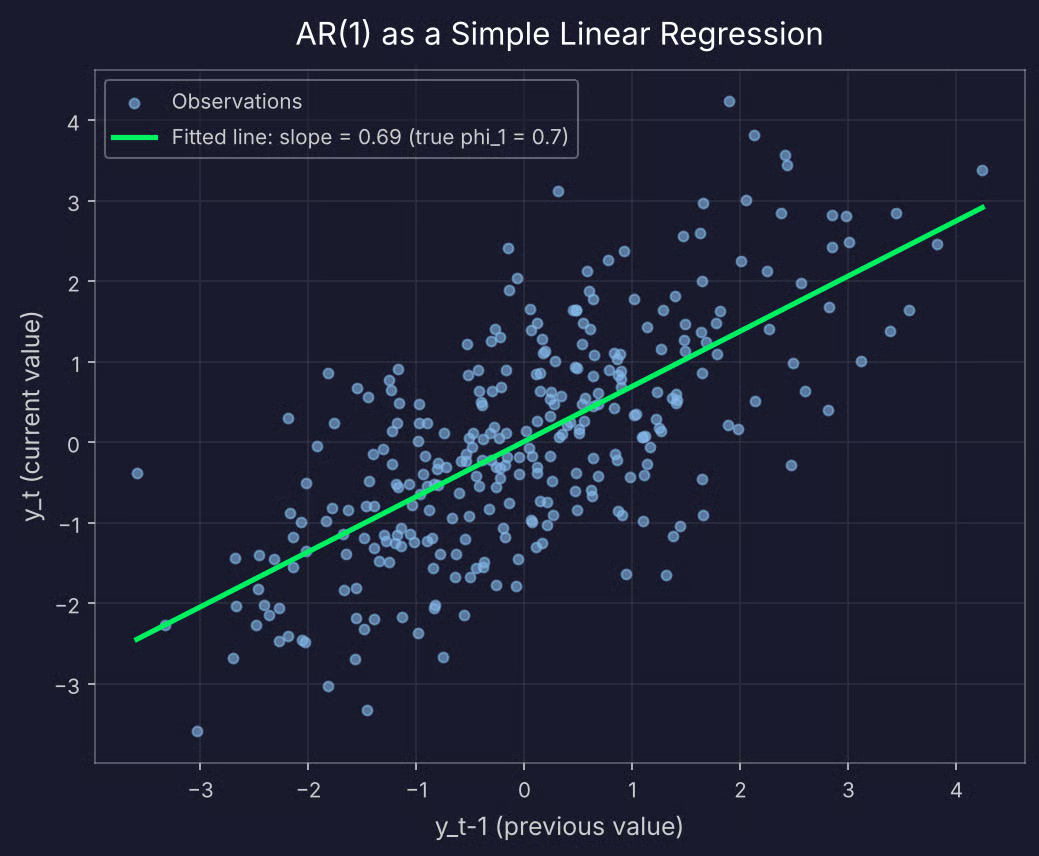
AR(1) için y_t’ye karşı y_t-1 saçılım grafiği
Ama bir fark vardır. Standart bir regresyonda yordayıcı ve hedef farklı değişkenlerdir. AR(1)’de ise yordayıcı, hedef serisinin bir adım kaydırılmış halidir. Bu yüzden satırları karıştıramaz ya da rastgele bir train/test bölmesi yapamazsınız — verinin sırası modelin bir parçasıdır.
phi_1’in değeri serinin görünümünü değiştirir:
phi_1 = 0.3: Seri neredeyse rastgele gürültü gibidir; çünkü her değer bir sonrakine az bilgi taşır
phi_1 = 0.9: Seri uzun, yumuşak salınımlarla hareket eder ve ortalamasına dönmesi zaman alır
phi_1 = -0.8: Seri neredeyse her adımda ortalamanın üstü ve altı arasında zikzak yapar
phi_1 = 1: Seri rassal yürüyüşe dönüşür ve geri döneceği bir ortalama olmadan sürüklenir; bu, önceki bölümdeki durağan olmayan durumdur
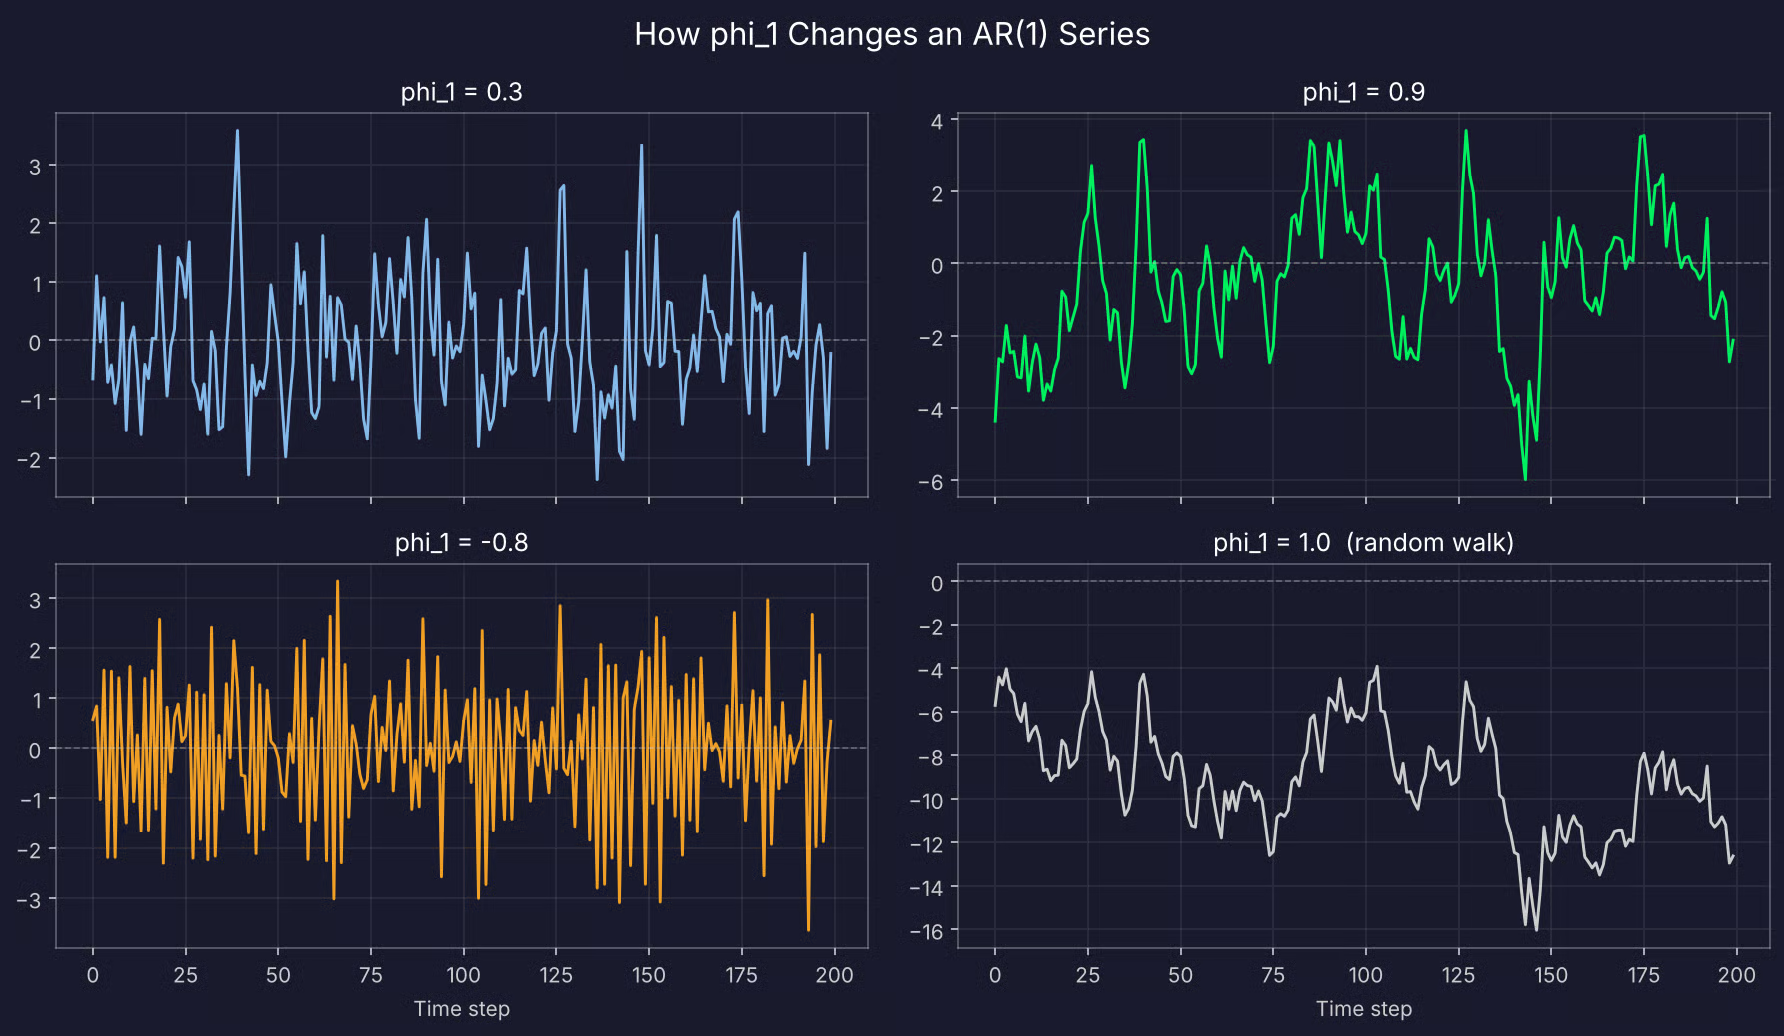
Dört simüle AR(1) serisi
phi_1 1’e ya da -1’e yaklaştıkça, tek bir şokun seriyi etkileme süresi uzar.
AR(2) önceki iki değeri kullanır. İkinci gecikme, özellikle döngüler gibi AR(1)’in üretemediği desenleri mümkün kılar.
İki katsayı kümesinin karşılaştırması şöyledir:
phi_1 = 0.5, phi_2 = 0.3: Her iki gecikme de aynı yönde iter; seri daha uzun ve daha yumuşak salınımlı bir AR(1) gibi görünür
phi_1 = 0.5, phi_2 = -0.7: İkinci gecikme ilkine karşı çalışır; seri yaklaşık her beş adımda tekrar eden dalgalar halinde yükselip düşer
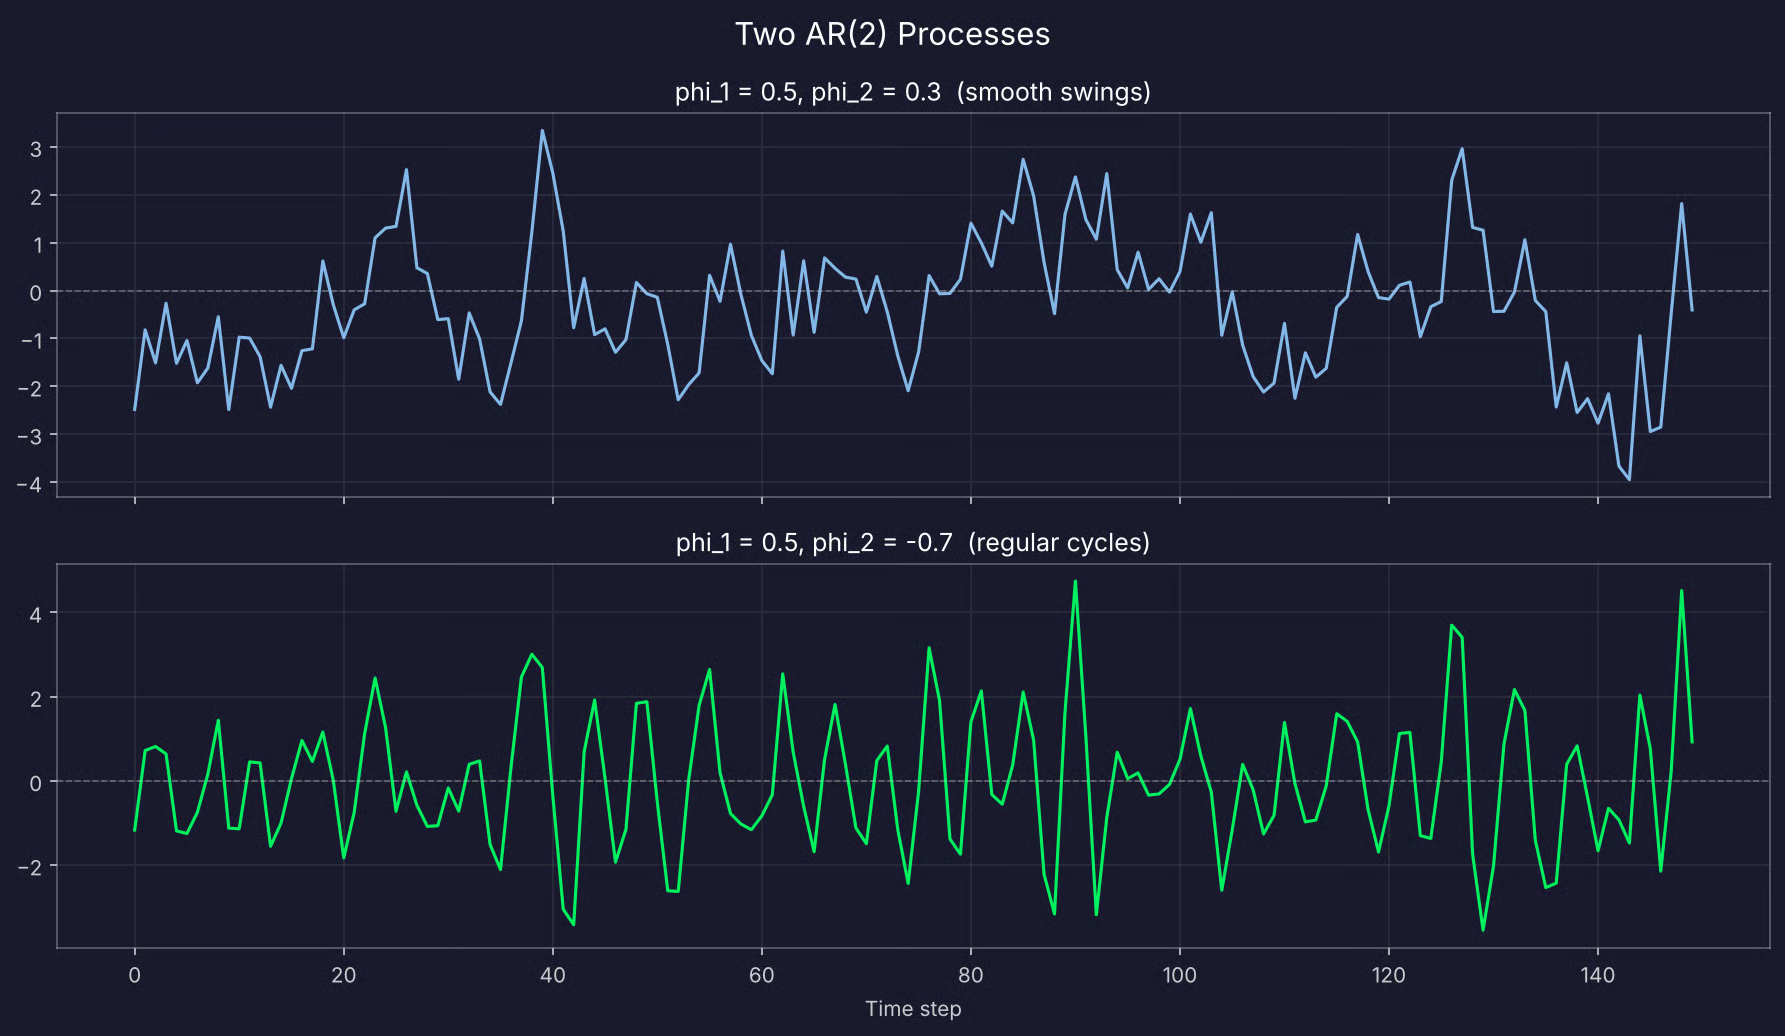
İki simüle AR(2) serisi
AR(3), AR(4) ve sonrası, her seferinde bir gecikme ekler. Daha gerideki değerler, yakın geçmişin sunmadığı bilgi taşıdığında bunlara ihtiyaç duyarsınız.
Örneğin aylık satışları modelliyorsunuz ve geçen yılın aynı ayı bu ayı iyi tahmin ediyor. Bir AR(12) modeli, o 12 aylık gecikmeyi ve aradaki 11 gecikmeyi içerir.
Her ekstra gecikme, tahmin edilmesi gereken bir katsayı ekler. Bu da daha fazla veri gerektirir ve aşırı uyum (overfitting) riskini artırır. Katsayıların okunması da zorlaşır — 12 katsayıyla, sayılara bakıp serinin ne yapacağını söylemek zordur. Bunun yerine kökleri kontrol edersiniz.
Doğru dereceyi Python bölümünde PACF ve AIC ile nasıl seçeceğinizi göstereceğim.
AR modelleri, verilerin sıralı olduğu ve yakın geçmişin yakın geleceğe dair bir şeyler söylediği her yerde karşınıza çıkar.
Kullanımların çoğu dört grupta toplanır:
Sonuncusu birçok kişiyi şaşırtır, çünkü bugünlerin sohbet botlarının ardındaki terim, burada okuduğunuz istatistikten gelir.
Bu bölümde, ham veriden değerlendirilebilir bir tahmine kadar Python’da statsmodels ile bir otokorelasyonlu model kuracağım.
Veri için pandas ve NumPy, model ve testler için statsmodels, hata metriği için scikit-learn gerekir:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorBir AR(2) sürecinden iki yıllık günlük elektrik talebi simüle edeceğim.
Simüle veriyi seçtim çünkü gerçek katsayıları baştan biliyorsunuz. Böylece modelin onları bulup bulmadığını ve gecikme seçimi araçlarının doğru dereceyi işaret edip etmediğini kontrol edebilirsiniz.
Süreçte c = 15, phi_1 = 0.6 ve phi_2 = 0.25 var; bu da uzun dönem ortalamasını 100 MWh yapar:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()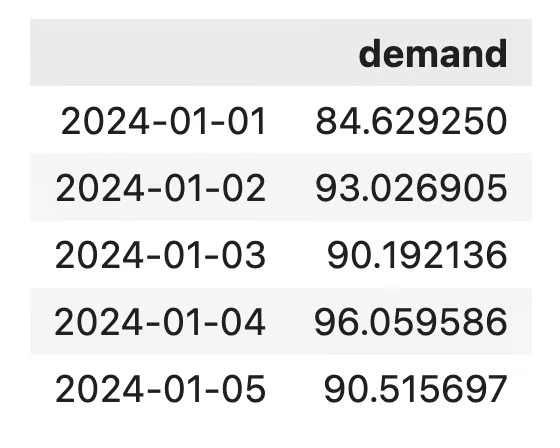
Günlük elektrik talebi veri seti
İlk 100 simüle gün kaldırılmıştır; çünkü bu yanma (burn-in) dönemi, serinin kullanılmaya başlamadan önce normal davranışına oturması için zaman tanır.
Tüm seri şöyle görünüyor:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()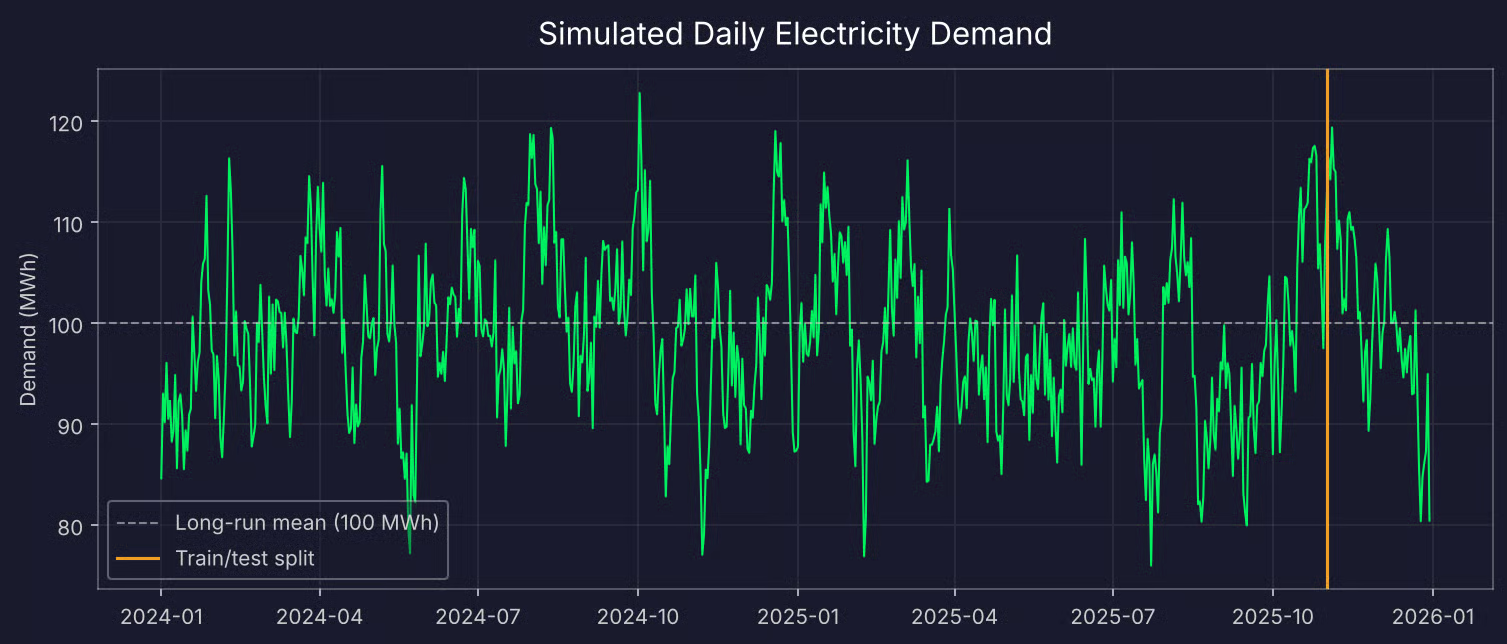
İki yıllık simüle günlük elektrik talebi
Seri, trend olmadan 100 etrafında yükselip alçalır; durağan bir serinin görünmesi gerektiği gibi. Ancak görsel kontrol kanıt değildir.
Genişletilmiş Dickey-Fuller (ADF) testi, bir serinin durağan olup olmadığını kontrol eder. Sıfır hipotezi serinin durağan olmadığıdır; dolayısıyla küçük bir p-değeri istenen sonuçtur:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")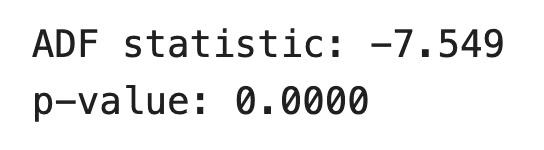
ADF test sonuçları
p-değeri 0.05’in oldukça altındadır; bu nedenle sıfır hipotezini reddedebilir ve seriyi durağan kabul edebilirsiniz.
Kendi veriniz bu testte kalırsa, df["demand"].diff().dropna() ile fark alıp testi yeniden çalıştırın.
Zaman serisi verisi karıştırılamaz; bu yüzden test kümesi serinin sonundan alınmalıdır. Son 60 günü test için ayıracağım:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Böylece 670 gün eğitim, 60 gün test için kalır.
Modelin başarısını belirleyen adımdır. Çok az gecikme seçerseniz model verideki desenleri kaçırır. Çok fazla seçerseniz, gelecekte tekrarlanmayacak eğitim gürültüsünü uydurur.
Bunun için iki aracınız var.
İlki kısmi otokorelasyon fonksiyonudur (PACF). Daha kısa gecikmelerin etkisi çıkarıldıktan sonra, seri ile her bir gecikme arasındaki korelasyonu gösterir. Bir AR(p) süreci için PACF, gecikme p’ye kadar anlamlı sivrimler gösterir ve sonrasında sıfır civarına iner:
plot_pacf(train, lags=20, method="ywm")
plt.show()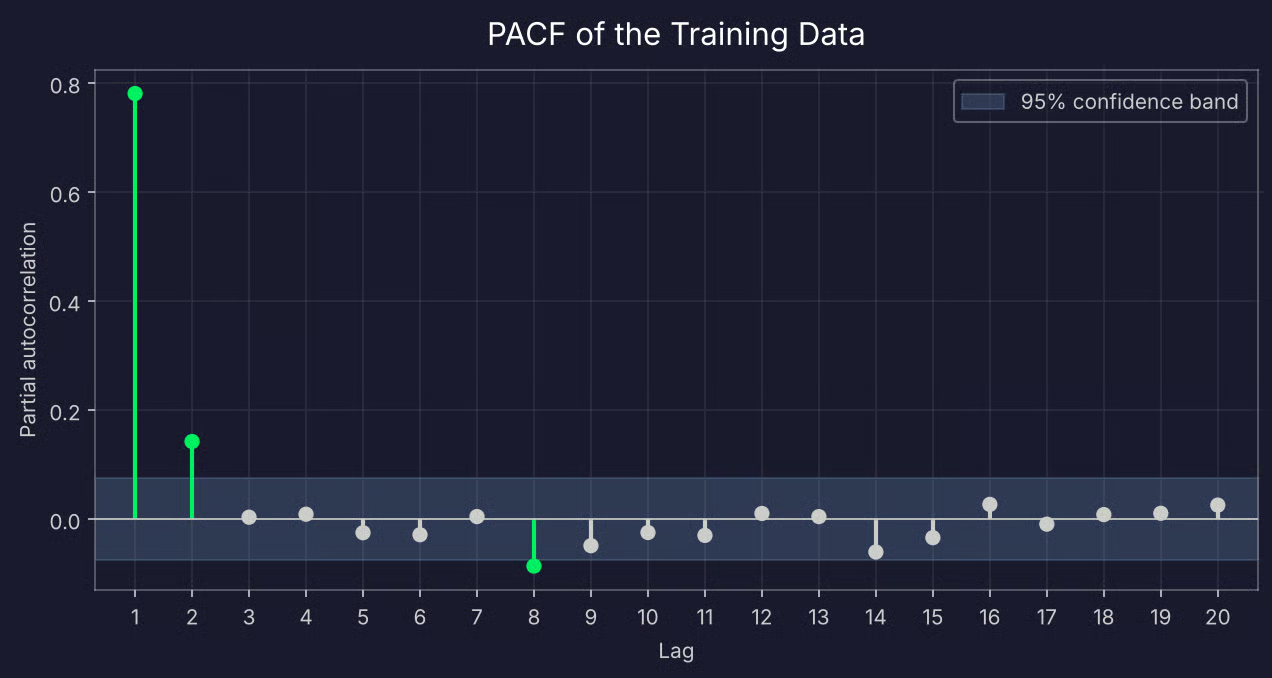
Eğitim verisinin PACF’i
1 ve 2. gecikmeler güven bandının oldukça dışındadır; 3. gecikme sıfıra yaklaşır. Bu, AR(2)’ye işaret eder.
8. gecikmede, bandın kenarını az geçen küçük bir sivrim de var. Buna fazla anlam yüklemeyin. Bant %95 güvenle çizilir; dolayısıyla 20 gecikmede, bunlardan yaklaşık birinin tesadüfen bandı aşmasını beklersiniz.
İkinci araç bilgi ölçütleridir. AIC ve BIC, veriyi iyi uyduran modeli ödüller ve her ekstra parametre için cezalandırır. BIC daha büyük ceza uygular; bu yüzden daha küçük modelleri seçme eğilimindedir. statsmodels, belirli bir maksimuma kadar her dereceyi test edebilir ve en iyisini döndürebilir:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")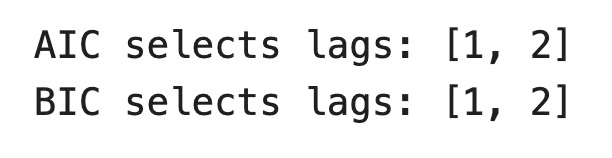
AIC/BIC gecikme seçimi
Her iki ölçüt de PACF ile aynı fikirdedir. Pratikte AIC’nin BIC’ten biraz daha büyük bir model seçtiğini sık görürsünüz. Böyle bir durumda küçük olanla başlayın.
Dereceyi seçtikten sonra modeli kurmak iki satır kod alır:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")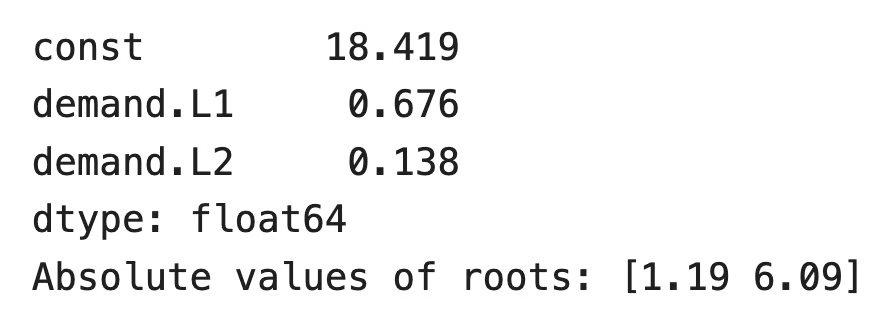
AR(2) model parametreleri
Gerçek değerler 0.6 ve 0.25’tir. Model birinci gecikmeye biraz daha, ikinciye biraz daha az ağırlık verir; ancak iki katsayının toplamı yakın (0.81’e karşı 0.85). 670 veri noktasında birebir aynı değerleri beklemezsiniz.
Her iki kökün de modülü 1’den büyüktür; dolayısıyla kurulan model durağandır. Standart hatalar, p-değerleri ve tam kök tablosu için results.summary() çağırabilirsiniz.
Test dönemini tahmin etmenin iki yolu vardır ve farklı sorulara cevap verirler:
Çok adımlı tahminler doğrudan kurulan sonuçlardan gelir. Tek adımlı tahminlerde ise eğitilmiş katsayıları tam seriye uygularsınız:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")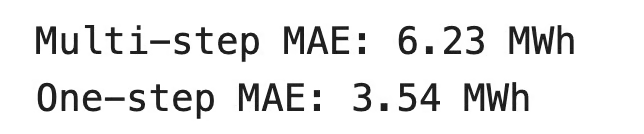
Tahmin sonuçları
Ortalama mutlak hata (MAE), tahminlerle gerçek değerler arasındaki mutlak farkların ortalamasıdır. Verinin birimiyle aynıdır; bu yüzden doğrudan okunabilir. Tek adımlı tahmin ortalamada 3.54 MWh sapar.
İki tahminin gerçek değerlerle karşılaştırması şöyle:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()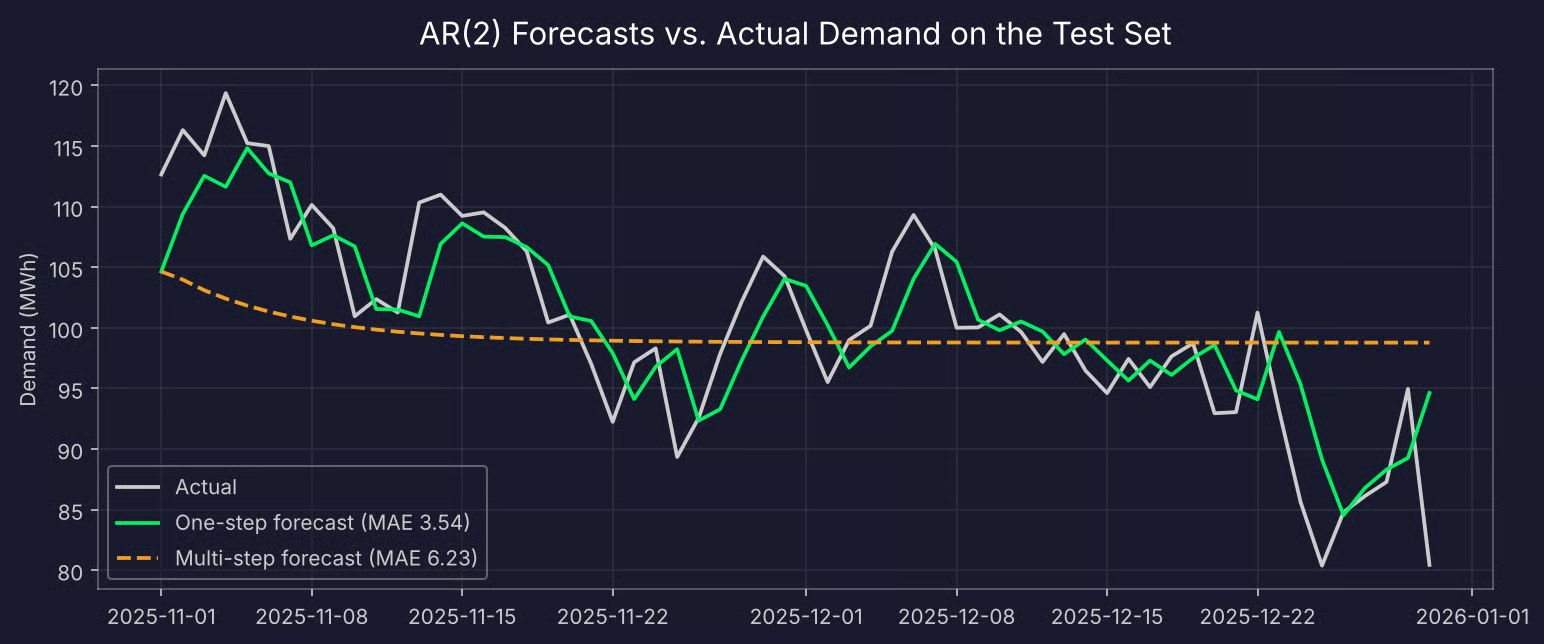
Gerçek talep ile tek adımlı ve çok adımlı AR(2) tahminlerinin karşılaştırması
Tek adımlı tahmin, yaklaşık bir gün gecikmeli olarak gerçek değerleri yakından takip eder. Çok adımlı tahmin son bilinen değerden başlar ve yaklaşık üç hafta içinde ortalamaya yakınsayıp yataylaşır.
Her durağan AR modelinin davranışı böyledir — ileriye doğru tahmin arttıkça, geçmişin söylediği azalır ve en iyi tahmin uzun dönem ortalaması olur. Bu yüzden AR modelleri kısa vadeli tahminlerde en iyi sonucu verir.
Daha fazla geçmiş bilginin daha iyi tahmin demek olduğunu varsaymak kolaydır. Bunu, artan sayıda gecikmeyle modeller kurup tek adımlı MAE’lerini karşılaştırarak test edelim:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")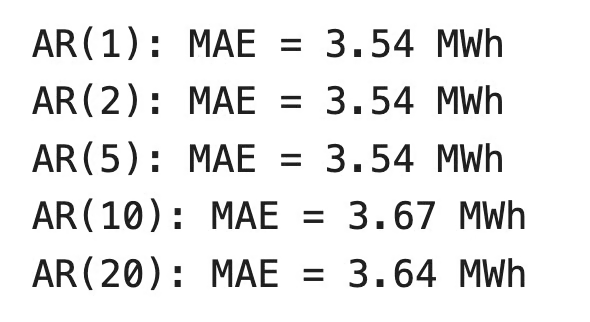
Daha fazla gecikmeyle MAE
Hata AR(2)’den sonra iyileşmez; AR(10) ve AR(20)’de kötüleşir. Bu ekstra katsayılar eğitim verisindeki gürültüyü uydurur.
Ayrıca burada AR(1)’in AR(2) kadar iyi olduğunu da göreceksiniz. Tahmin edilen ikinci katsayı küçüktür; bu yüzden bu test setinde az katkı sağlar. İki model aynı performansı veriyorsa, basit olanı açıklaması daha kolaydır ve yeni veride bozulma olasılığı daha düşüktür.
Bir maliyet tarafı da var. AR(20), 3 yerine 21 parametre tahmin eder.
Özetle, dereceyi PACF ve bilgi ölçütlerinin önermesine izin verin; ardından bir test setinde sadece doğrulayın.
AR modelleri birçok tahmin problemine uygundur; ama hepsine değil. Nerede işe yaradıkları, nerede yaramadıkları ve üzerine kurulan modellerle nasıl karşılaştırıldıkları burada.
AR modellerinin iki ana faydası vardır:
Ayrıca iki ana sınırlaması vardır:
Bir sorun daha var. Gecikmeli değerler, aynı seriden geldikleri için birbirleriyle koreledir. Talep verisinde y_t-1 ile y_t-2 arasındaki korelasyon 0.78’dir.
Bu, çoklu bağlantı olarak adlandırılır ve her regresyon modelini etkiler. İki yordayıcı birlikte hareket ettiğinde, model hangisinin sorumlu olduğunu ayırt etmekte zorlanır. Katsayılar daha az kararlı hale gelir ve standart hataları artar.
Bu, daha önce gördüğünüzü açıklar. Model, 0.6 ve 0.25 yerine 0.676 ve 0.138 tahmin etti — ağırlığı bir gecikmeden diğerine kaydırdı; ancak toplam yakın kaldı. Tahminler bundan çok etkilenmez; fakat tekil katsayılara o kadar güvenemezsiniz. Her ekstra gecikme sorunu büyütür.
AR, klasik zaman serisi tahmininin üç yapıtaşından biridir. Diğer ikisi hareketli ortalama (MA) modelleri ve bunları birleştiren ARIMA’dır.
AR modeli geçmiş değerlerden tahmin eder. MA modeli ise geçmiş hatalardan tahmin eder:
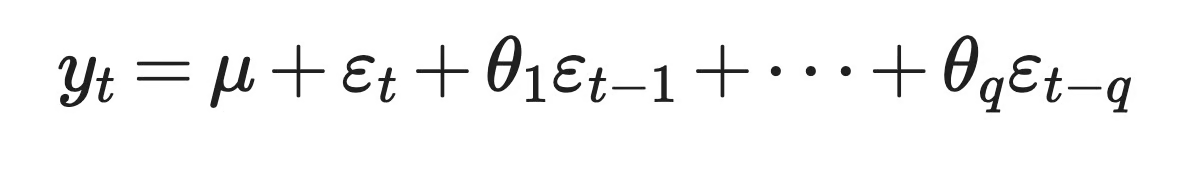
ARMA modeli
Burada mu serinin ortalamasıdır; theta_1’dan theta_q’ya katsayılardır ve epsilon_t-1’den epsilon_t-q’ya önceki adımlardaki rastgele şoklardır. Bunu, kayan ortalama anlamındaki hareketli ortalamayla karıştırmayın. İsim aynı, model farklıdır.
İki model şoklara farklı tepkiler verir. Bir MA(q) modelinde, bir şok seriyi tam q adım etkiler. Bir AR modelinde ise şok zamanla sönümlenir ama asla tamamen sıfıra inmez. Bu fark aynı zamanda dereceyi seçmek için farklı araçlar kullanmanızın nedenidir — AR modellerinde PACF gecikme p’den sonra kesilir; MA modellerinde ACF gecikme q’dan sonra kesilir.
ARIMA hepsini bir araya getirir. ARIMA(p, d, q) üç bölümden oluşur:
Bu, AR’ın ARIMA’nın özel bir durumu olduğu anlamına gelir. d ve q’yu sıfıra ayarlarsanız bir AR modeli elde edersiniz. Bunu talep verisiyle kontrol edebilirsiniz:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))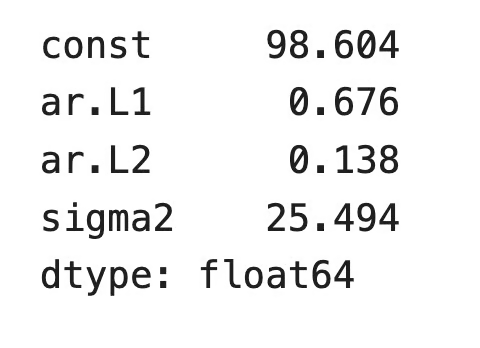
Bütünleşme ve hareketli ortalama derecesi 0 olan ARIMA modeli
AR katsayıları AutoReg’den gelenlerle eşleşir. Sabit farkıdır; çünkü ARIMA serinin ortalamasını, AutoReg ise sabiti (c) raporlar.
Şimdi ARIMA’nın daha ileri gittiği yeri görelim. Diyelim ki şehir büyüyor ve elektrik talebi her gün biraz artıyor. Seri artık trendlidir; bu yüzden ADF testi başarısız olur ve bir AR modeli seriyle doğrudan çalışamaz.
Ama ARIMA(2, 1, 0) modeli çalışabilir. Serinin bir kez farkını alır; böylece model ham değerler yerine günlük değişimleri işler ve ardından bu değişimlere AR(2) uydurur. Isı dalgası gibi bir şok ertesi gün talebi de etkilerse bir MA terimi ekleyerek ARIMA(2, 1, 1) elde edebilirsiniz.
AR kısmı her durumda aynı işi yapar. ARIMA sadece veriyi onun için hazırlar ve geriye kalan kısmı modeller. Daha derine inmek isterseniz, R ile ARIMA Modelleri kursu sürecin tamamını kapsar.
Otokorelasyonlu bir model, bir serinin bir sonraki değerini kendi geçmişinden tahmin eder. Yordayıcıların hedefin gecikmeli kopyaları olduğu doğrusal bir regresyondur; bu da onu anlaşılması en kolay zaman serisi modellerinden biri yapar.
Ekonomide, konuşma kodlamada, EEG analizinde ve hatta günümüz dil modellerinin adında bile karşınıza çıkar. Ayrıca nerede en iyi seçenek olmadığını da gördünüz; zira durağan veri ister, doğru gecikme derecesine bağlıdır ve korelasyonlu gecikmeler tek tek katsayıları daha az güvenilir kılar.
AR modellerini anlarsanız, klasik tahminin geri kalanı çok daha kolaylaşır. ARIMA doğal bir sonraki adımdır ve ARIMA rehberimiz, fark alma ve MA terimlerinin burada öğrendiklerinizi nasıl genişlettiğini gösterir. Uygulamalı bir yol için Python ile ARIMA Modelleri kursumuzu deneyin.
DataCamp ile öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




