Khóa học
Phân tích chuỗi thời gian với Python
4 giờ
70.9K
Hầu hết nội dung trực tuyến đi thẳng vào ARIMA và nếu có thì cũng chỉ dành một dòng cho phần AR. Nhưng AR là nền tảng của mô hình. Nếu bạn không hiểu nó, phần còn lại của ARIMA cũng sẽ không có ý nghĩa.
Nói đơn giản, mô hình tự hồi quy dự đoán các giá trị tương lai của một chuỗi thời gian từ chính các giá trị quá khứ của nó. Bạn sẽ thấy nó trong kinh tế, tài chính, xử lý tín hiệu và dữ liệu khí hậu. Về cơ bản đây là một mô hình hồi quy, nên nó kết nối những gì bạn đã biết về hồi quy với dự báo chuỗi thời gian, và là nền tảng mà ARIMA được xây dựng trên đó.
Trong bài viết này, tôi sẽ hướng dẫn bạn cách một mô hình tự hồi quy hoạt động, cách fit trong Python với statsmodels, và cách chọn bậc trễ phù hợp.
Mô hình tự hồi quy dự đoán giá trị tiếp theo của một chuỗi thời gian từ tổng có trọng số của các giá trị trước đó.
Trong tên gọi, "auto" nghĩa là tự thân, và "hồi quy" nghĩa là bạn dự đoán một biến từ các biến khác. Vậy mô hình tự hồi quy là hồi quy của một chuỗi trên chính quá khứ của nó.
Giả sử bạn muốn dự đoán nhu cầu điện ngày mai. Nhu cầu hôm nay là điểm khởi đầu tốt, và nhu cầu hôm qua bổ sung thêm chút thông tin. Mô hình tự hồi quy biến trực giác đó thành công thức và học các trọng số từ dữ liệu của bạn.
Các mô hình AR được viết là AR(p), trong đó p là bậc của mô hình. Bậc cho biết mô hình dùng bao nhiêu giá trị quá khứ:
p giá trị liền trướcBậc cao hơn không tự động đồng nghĩa với mô hình tốt hơn. Tôi sẽ chỉ cho bạn cách chọn p ở phần sau.
Dạng tổng quát của mô hình AR(p) như sau:
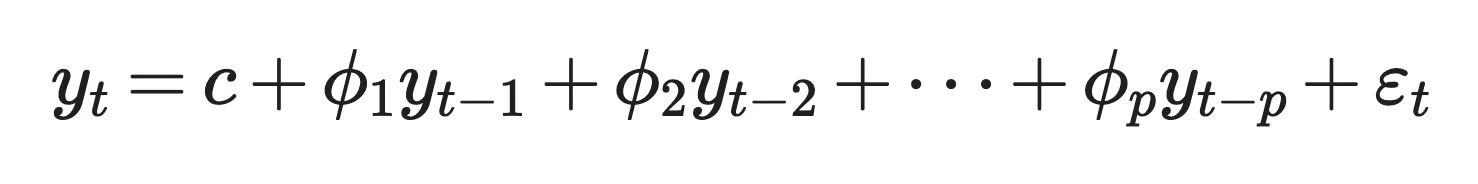
Mô hình AR(p) tổng quát
Ý nghĩa từng hạng tử
y_t: Giá trị của chuỗi tại thời điểm t, là giá trị bạn muốn dự đoán
c: Hằng số, cùng với các hệ số, xác định trung bình dài hạn của chuỗi
phi_1 đến phi_p: Các hệ số cho biết mỗi giá trị quá khứ đóng góp bao nhiêu vào dự đoán
y_t-1 đến y_t-p: Các giá trị trễ, trong đó "trễ" nghĩa là bạn nhìn lùi bao nhiêu bước
epsilon_t: Nhiễu trắng, tức sai số ngẫu nhiên có kỳ vọng bằng 0, phương sai không đổi và không tương quan theo thời gian
Nói ngắn gọn, mô hình nhân mỗi trong p giá trị gần nhất với trọng số riêng của nó và cộng hằng số. Phần còn lại là nhiễu, tức phần của y_t mà quá khứ không giải thích được.
AR(1) là phiên bản đơn giản nhất:
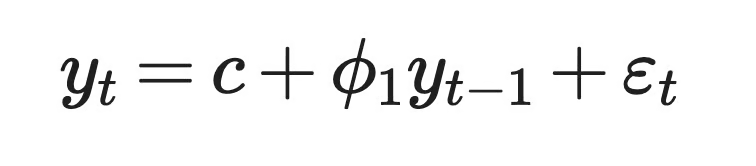
Mô hình AR(1)
Giá trị của phi_1 kiểm soát mức độ ảnh hưởng của hôm nay lên ngày mai.
Giả sử c = 2 và phi_1 = 0.8. Nếu giá trị hôm nay là 15, mô hình dự đoán cho ngày mai là 2 + 0.8 x 15 = 14. Dự đoán tiếp theo là 2 + 0.8 x 14 = 13.2. Mỗi bước đưa chuỗi tiến gần tới 10, tức trung bình dài hạn, c / (1 - phi_1).
Nếu phi_1 âm, chuỗi sẽ nhảy qua lại trên và dưới trung bình từ bước này sang bước khác.
AR(2) thêm một trễ thứ hai:
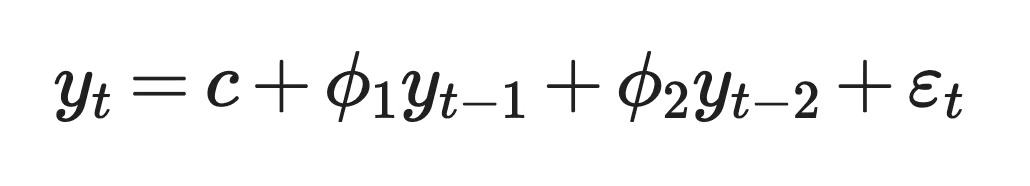
Mô hình AR(2)
Với hai trễ, mô hình có thể mô tả các mẫu mà AR(1) không làm được, như chu kỳ. Ví dụ, phi_1 dương với phi_2 âm có thể tạo ra chuỗi lên xuống theo làn sóng, giống chu kỳ kinh doanh.
Vì vậy, mọi mô hình AR đều quy về hai lựa chọn — dùng bao nhiêu trễ và gán trọng số gì cho chúng.
Mô hình AR chỉ hoạt động khi dữ liệu của bạn thỏa hai điều kiện. Giá trị quá khứ phải liên quan đến giá trị tương lai, và chuỗi phải cư xử giống nhau theo thời gian. Điều đầu gọi là tự tương quan (autocorrelation), và điều thứ hai gọi là tính dừng (stationarity).
Tự tương quan là tương quan giữa một chuỗi thời gian và một bản sao bị trễ của chính nó.
Đó là lý do mô hình AR tồn tại. Nếu giá trị hôm nay không nói được gì về ngày mai, mô hình sẽ không học được gì từ quá khứ.
Trong mã, bạn lấy một cột giá trị, sao chép nó, và dịch bản sao xuống một hàng. Giờ mỗi hàng ghép một giá trị với giá trị liền trước nó. Tương quan giữa hai cột là tự tương quan trễ-1. Khi bạn dịch hai hàng, bạn được tự tương quan trễ-2.
Ví dụ trong pandas như sau:
import pandas as pd

df = pd.DataFrame({"temperature": [12, 14, 15, 13, 16, 18, 17, 19]})

# Shift the column down by one row to create the lag-1 copy
df["temperature_lag_1"] = df["temperature"].shift(1)

print(df)
print(df["temperature"].autocorr(lag=1))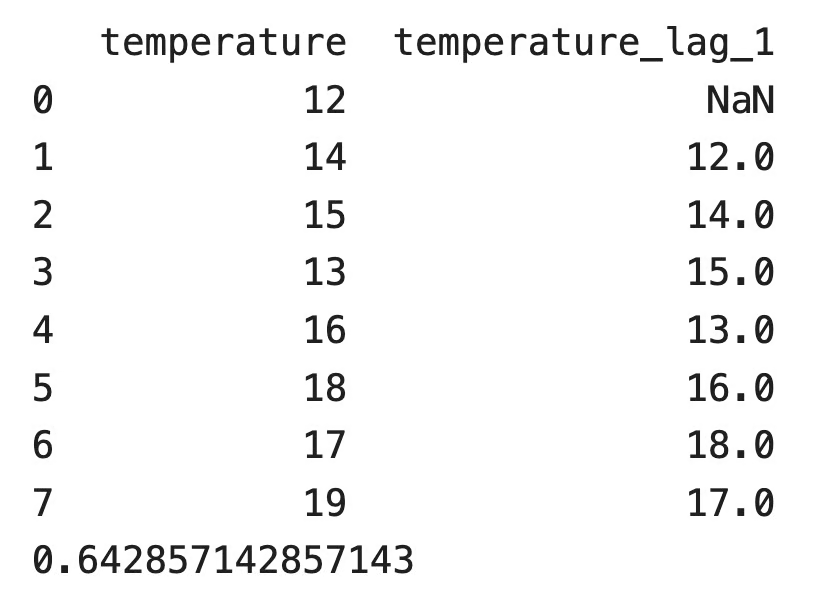
DataFrame với cột nhiệt độ và bản sao trễ-1
Hàng đầu tiên của cột trễ bị rỗng vì không có giá trị trước giá trị đầu. pandas bỏ qua hàng đó và trả về tự tương quan trễ-1 là 0.643. Những ngày ấm áp có xu hướng theo sau bởi những ngày ấm áp trong chuỗi này.
Dấu của tự tương quan làm thay đổi cách chuỗi vận động:
Tự tương quan gần bằng không nghĩa là quá khứ không giúp được gì. Khi đó, mô hình AR sẽ không tốt hơn nhiều so với dự đoán trung bình.
Mô hình AR cần một chuỗi thời gian dừng.
Một chuỗi dừng có cùng trung bình, cùng phương sai, và cùng tự tương quan tại một trễ cho trước, bất kể bạn nhìn phần nào của chuỗi. Các nhà thống kê gọi đây là tính dừng yếu.
Điều này quan trọng vì mô hình ước lượng một bộ hệ số cố định. Nếu trung bình của chuỗi trôi dạt theo thời gian, các hệ số học từ dữ liệu cũ sẽ không mô tả được dữ liệu mới. Giá cổ phiếu là ví dụ điển hình của chuỗi không dừng vì có xu hướng theo năm. Lợi nhuận ngày thì gần với dừng hơn nhiều.
Chính các hệ số quyết định một quá trình AR có dừng hay không. Với AR(1), quy tắc đơn giản: phi_1 phải nằm giữa -1 và 1.
abs(phi_1) < 1: Cú sốc mờ dần theo thời gian, và chuỗi trở về trung bình
phi_1 = 1: Chuỗi trở thành bước ngẫu nhiên (random walk), và cú sốc không bao giờ mờ đi
abs(phi_1) > 1: Mỗi cú sốc ngày càng lớn, và chuỗi bùng nổ
AR(2) cần đồng thời ba điều kiện: phi_1 + phi_2 < 1, phi_2 - phi_1 < 1, và abs(phi_2) < 1.
Sau hai trễ, bạn cần quy tắc tổng quát. Mỗi mô hình AR(p) có một đa thức đặc trưng:
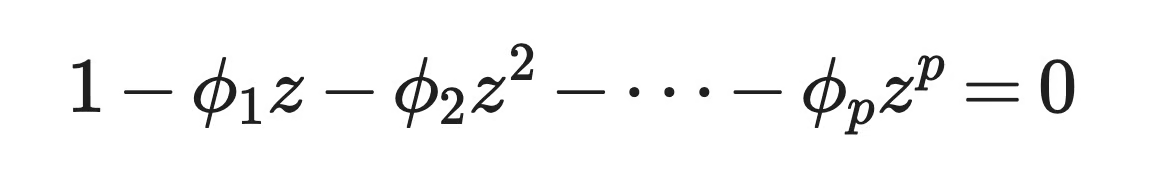
Đa thức đặc trưng
Quá trình là dừng yếu khi mọi nghiệm của đa thức này nằm ngoài vòng tròn đơn vị, tức mỗi nghiệm z có giá trị tuyệt đối lớn hơn 1. Nghiệm có thể là số phức, đó là lý do biên là hình tròn trên mặt phức chứ không phải đường thẳng.
Bạn có thể kiểm tra với AR(1). Đa thức là 1 - phi_1 z = 0, nên nghiệm là z = 1 / phi_1. Nghiệm đó nằm ngoài vòng tròn đơn vị chỉ khi abs(phi_1) < 1, trùng với quy tắc trước đó.
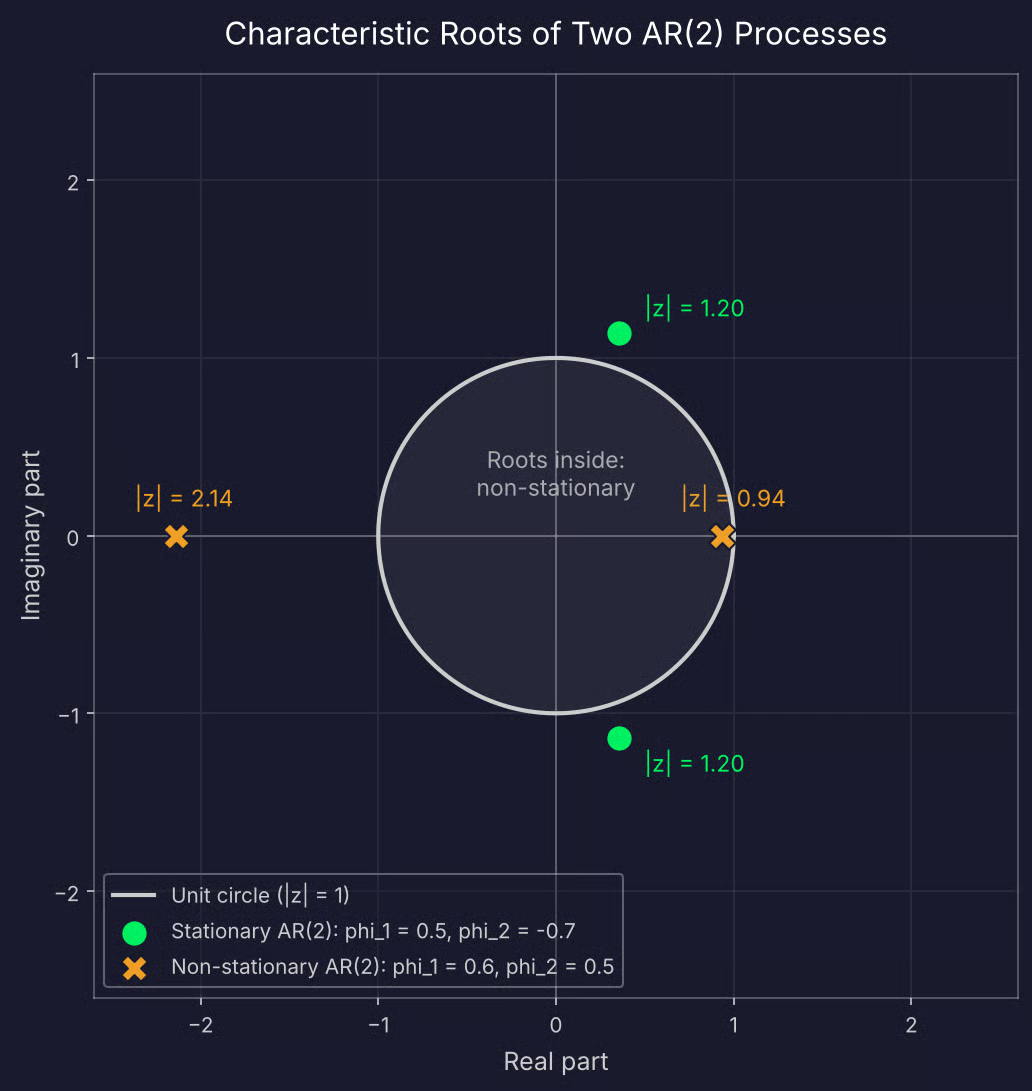
Nghiệm của một quá trình AR(2) dừng và không dừng
Bạn sẽ không tính các nghiệm này bằng tay. statsmodels trả về chúng sau khi bạn fit mô hình, và tôi sẽ chỉ cách kiểm định chính dữ liệu về tính dừng ở phần Python.
Nếu chuỗi của bạn không dừng, bạn có thể sai phân nó — lấy mỗi giá trị trừ đi giá trị kế tiếp — và mô hình hóa các sai phân. Đó là ý nghĩa của chữ "I" trong các mô hình ARIMA.
Mọi mô hình AR có cùng phương trình. Thay đổi giữa các loại là bậc p, tức số lượng giá trị quá khứ mô hình sử dụng.
AR(1) chỉ dùng giá trị liền trước để dự đoán giá trị tiếp theo.
Nếu nghe giống hồi quy tuyến tính, là vì đúng thế. Khi bạn đặt y_t-1 trên trục x và y_t trên trục y, AR(1) fit một đường thẳng qua các điểm. Hằng số c là tung độ gốc, và phi_1 là hệ số góc. Nếu bạn biết hồi quy tuyến tính đơn, bạn đã biết cách ước lượng AR(1).
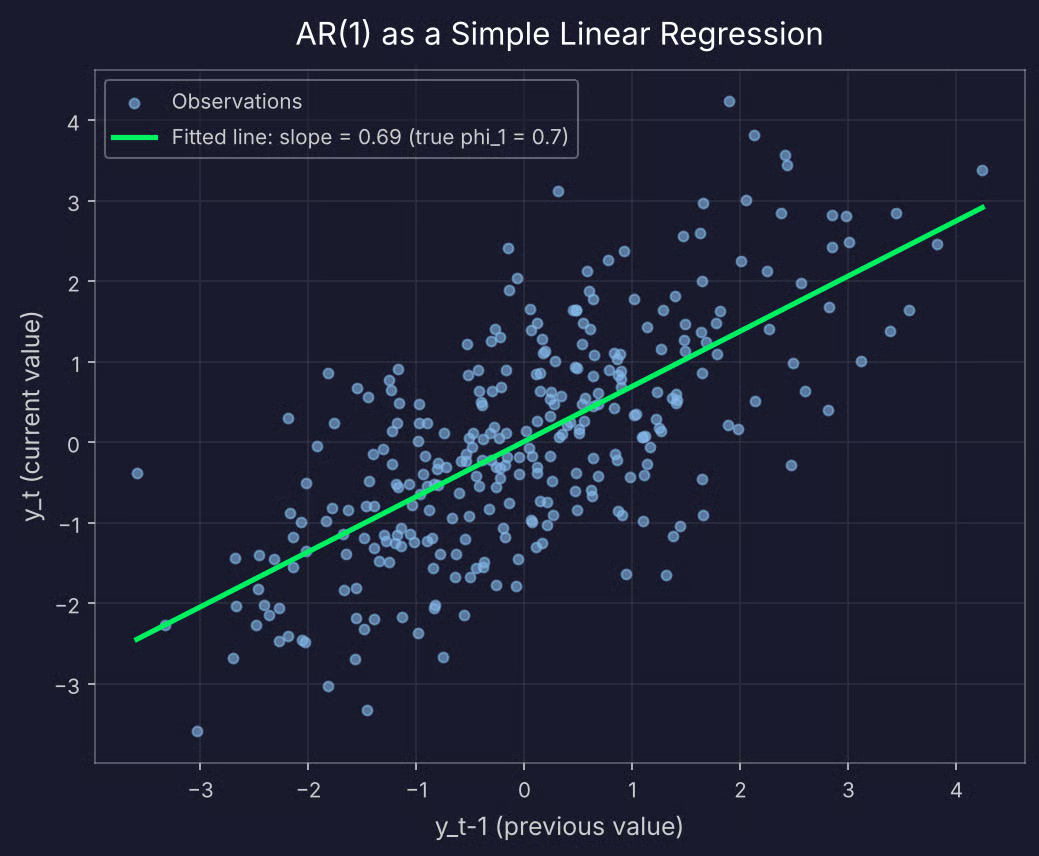
Biểu đồ phân tán y_t so với y_t-1 cho AR(1)
Nhưng có một khác biệt. Trong hồi quy chuẩn, biến dự báo và biến mục tiêu là các biến tách biệt. Trong AR(1), biến dự báo là cùng chuỗi nhưng bị dịch lùi một bước. Đó là lý do bạn không thể xáo trộn các hàng hay dùng chia train/test ngẫu nhiên — thứ tự dữ liệu là một phần của mô hình.
Giá trị của phi_1 làm thay đổi diện mạo chuỗi:
phi_1 = 0.3: Chuỗi trông gần như nhiễu ngẫu nhiên, vì mỗi giá trị mang ít thông tin về giá trị kế tiếp
phi_1 = 0.9: Chuỗi di chuyển thành những đợt dài, mượt và mất thời gian để quay về trung bình
phi_1 = -0.8: Chuỗi ziczac trên dưới trung bình gần như ở mọi bước
phi_1 = 1: Chuỗi trở thành bước ngẫu nhiên và trôi dạt, không có trung bình để quay về, tức trường hợp không dừng từ phần trước
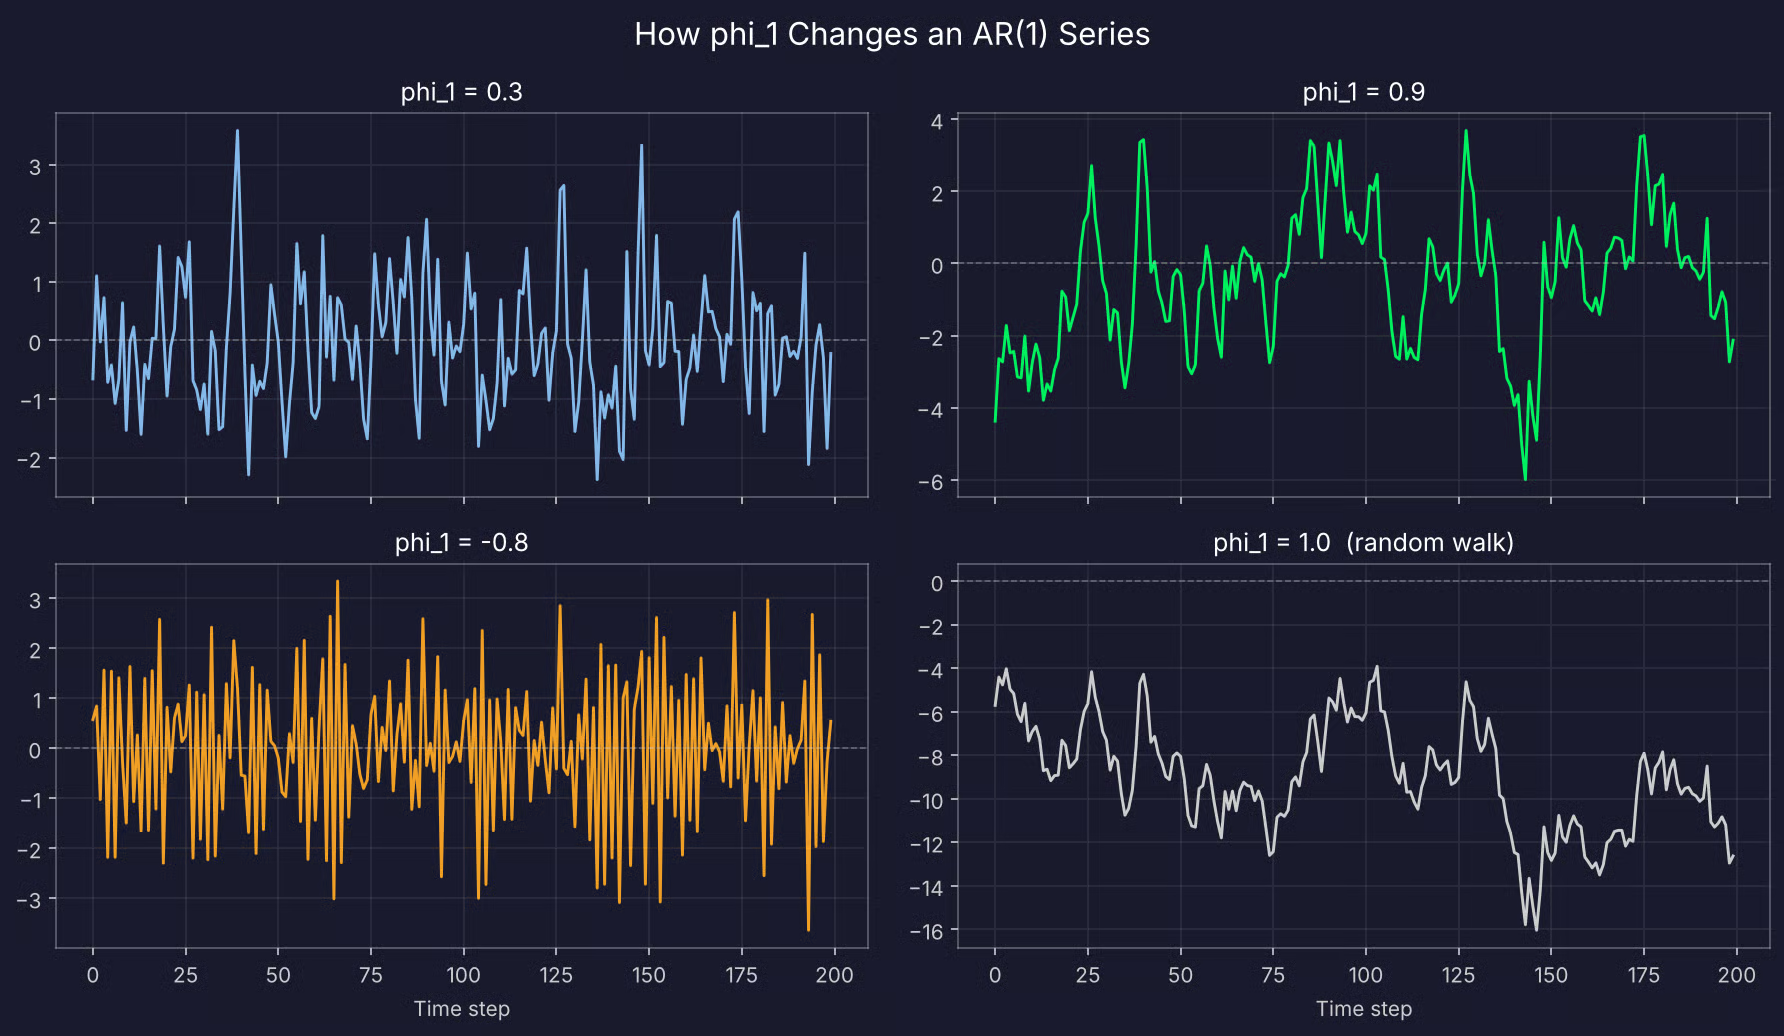
Bốn chuỗi AR(1) mô phỏng
phi_1 càng gần 1 hoặc -1, tác động của một cú sốc đơn lẻ lên chuỗi càng kéo dài.
AR(2) dùng hai giá trị liền trước. Trễ thứ hai cho phép mô hình tạo ra các mẫu mà AR(1) không có, chủ yếu là chu kỳ.
So sánh hai bộ hệ số như sau:
phi_1 = 0.5, phi_2 = 0.3: Cả hai trễ cùng đẩy theo một hướng, nên chuỗi trông như AR(1) với những đợt dài và mượt hơn
phi_1 = 0.5, phi_2 = -0.7: Trễ thứ hai chống lại trễ thứ nhất, và chuỗi lên xuống theo làn sóng lặp lại xấp xỉ mỗi năm bước
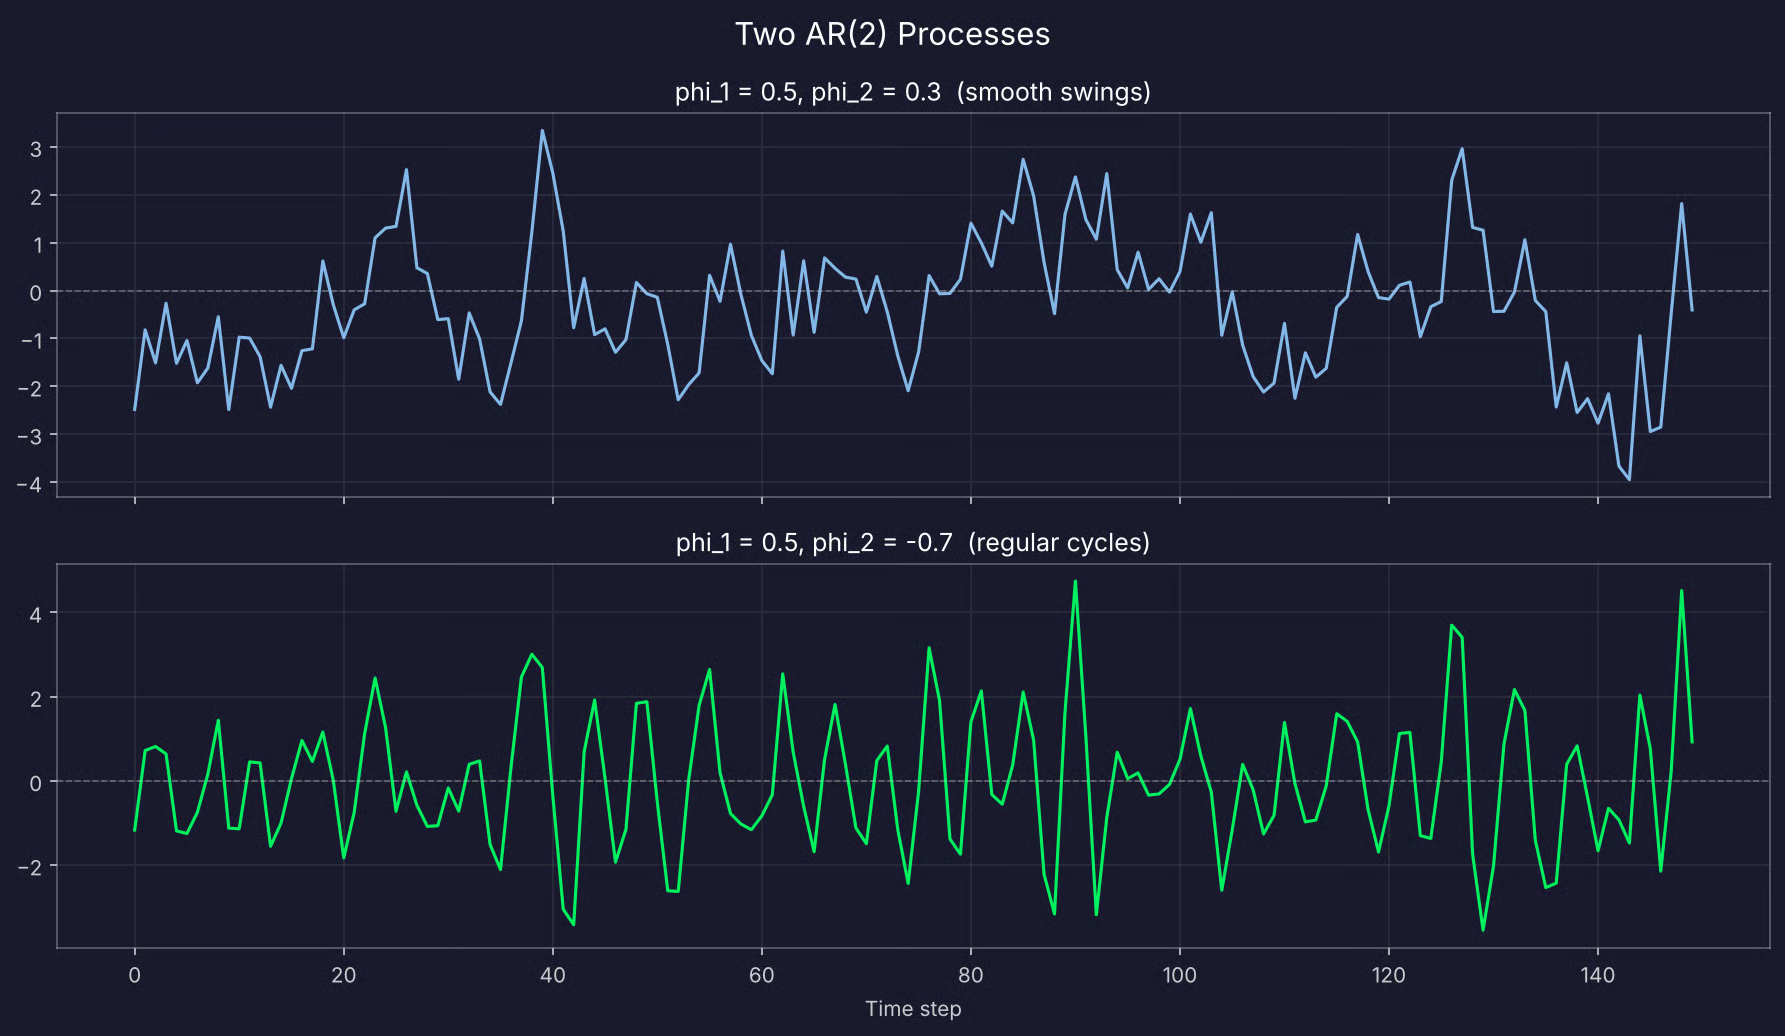
Hai chuỗi AR(2) mô phỏng
AR(3), AR(4), và hơn nữa thêm từng trễ một. Bạn cần chúng khi các giá trị xa hơn mang thông tin mà các giá trị gần không có.
Giả sử bạn mô hình hóa doanh số theo tháng, và cùng tháng năm ngoái dự đoán tốt cho tháng này. Mô hình AR(12) sẽ bao gồm trễ 12 tháng đó, cùng với 11 trễ ở giữa.
Mỗi trễ bổ sung thêm một hệ số cần ước lượng. Điều này nghĩa là bạn cần nhiều dữ liệu hơn, và rủi ro overfitting tăng. Các hệ số cũng khó đọc hơn — với 12 hệ số, bạn không thể nhìn con số mà đoán chuỗi sẽ làm gì. Thay vào đó bạn kiểm tra nghiệm.
Tôi sẽ chỉ cách chọn bậc phù hợp với PACF và AIC ở phần Python.
Mô hình AR xuất hiện ở bất cứ đâu dữ liệu có trật tự và quá khứ gần nói được điều gì đó về tương lai gần.
Phần lớn ứng dụng rơi vào bốn nhóm:
Điều cuối thường làm nhiều người ngạc nhiên vì thuật ngữ đằng sau chatbot ngày nay đến từ cùng thống kê mà bạn đang đọc ở đây.
Trong phần này, tôi sẽ fit một mô hình tự hồi quy trong Python với statsmodels, từ dữ liệu thô đến một dự báo có thể đánh giá.
Bạn cần pandas và NumPy cho dữ liệu, statsmodels cho mô hình và kiểm định, và scikit-learn cho thước đo sai số:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.ar_model import AutoReg, ar_select_order
from statsmodels.tsa.stattools import adfuller
from statsmodels.graphics.tsaplots import plot_pacf
from sklearn.metrics import mean_absolute_errorTôi sẽ mô phỏng hai năm nhu cầu điện theo ngày từ một quá trình AR(2).
Tôi chọn dữ liệu mô phỏng vì bạn biết trước các hệ số thực. Như vậy, bạn có thể kiểm tra xem mô hình có tìm ra chúng không, và công cụ chọn trễ có chỉ đến đúng bậc không.
Quá trình có c = 15, phi_1 = 0.6, và phi_2 = 0.25, đưa trung bình dài hạn về 100 MWh:
# Simulate two years of daily electricity demand (MWh) from an AR(2) process
rng = np.random.default_rng(42)
n_days, burn_in = 730, 100
c, phi_1, phi_2 = 15, 0.6, 0.25
noise = rng.normal(loc=0, scale=5, size=n_days + burn_in)

demand = np.zeros(n_days + burn_in)
demand[:2] = c / (1 - phi_1 - phi_2)
for t in range(2, n_days + burn_in):
    demand[t] = c + phi_1 * demand[t - 1] + phi_2 * demand[t - 2] + noise[t]

df = pd.DataFrame(
    {"demand": demand[burn_in:]},
    index=pd.date_range(start="2024-01-01", periods=n_days, freq="D"),
)

df.head()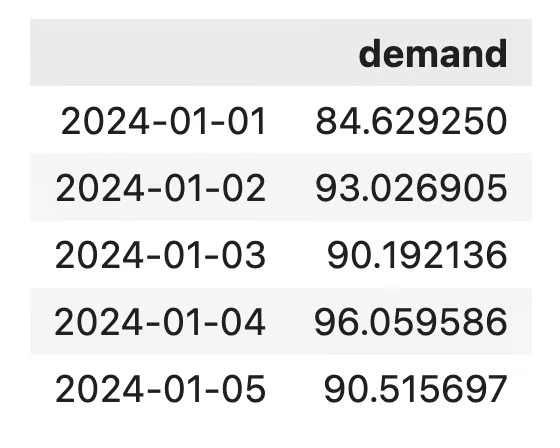
Bộ dữ liệu nhu cầu điện theo ngày
100 ngày mô phỏng đầu tiên được loại bỏ vì giai đoạn burn-in cho chuỗi thời gian để ổn định hành vi bình thường trước khi bạn bắt đầu sử dụng.
Toàn bộ chuỗi trông như sau:
df["demand"].plot(figsize=(12, 4), title="Daily electricity demand (MWh)")
plt.show()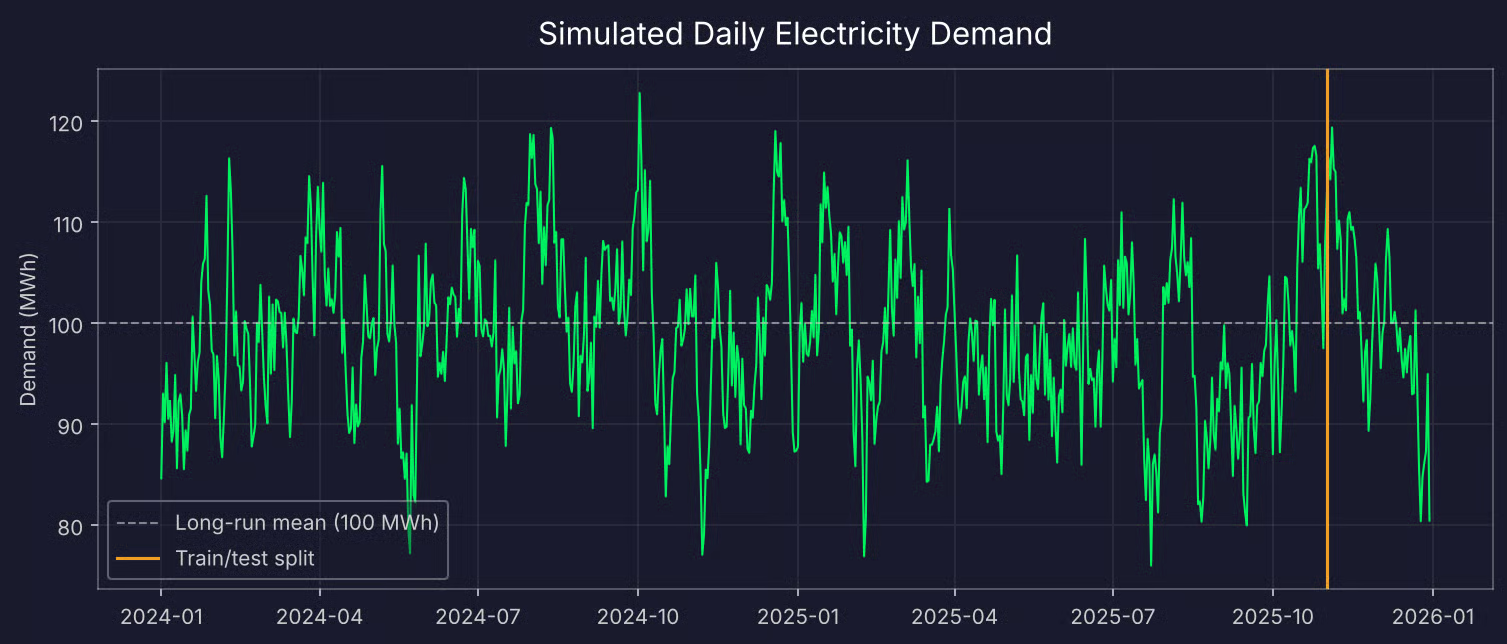
Hai năm nhu cầu điện theo ngày mô phỏng
Chuỗi dao động quanh mức 100 mà không có xu hướng, đúng với những gì một chuỗi dừng nên có. Nhưng kiểm tra bằng mắt không phải là bằng chứng.
Kiểm định Dickey-Fuller mở rộng (ADF) kiểm tra một chuỗi có dừng không. Giả thuyết không của nó là chuỗi không dừng, nên p-value nhỏ mới là điều bạn muốn:
adf_result = adfuller(df["demand"].dropna())

print(f"ADF statistic: {adf_result[0]:.3f}")
print(f"p-value: {adf_result[1]:.4f}")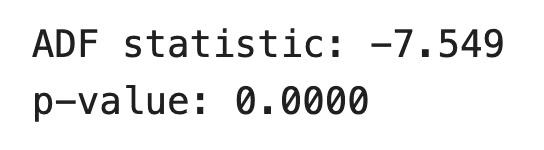
Kết quả kiểm định ADF
p-value nhỏ hơn nhiều 0.05, nên bạn có thể bác bỏ giả thuyết không và coi chuỗi là dừng.
Nếu dữ liệu của bạn không qua kiểm định này, hãy sai phân với df["demand"].diff().dropna() và chạy lại kiểm định.
Dữ liệu chuỗi thời gian không thể xáo trộn, nên tập kiểm tra phải lấy từ cuối chuỗi. Tôi sẽ giữ 60 ngày cuối để kiểm tra:
test_days = 60
train = df["demand"].iloc[:-test_days]
test = df["demand"].iloc[-test_days:]
Như vậy còn 670 ngày cho huấn luyện và 60 cho kiểm tra.
Đây là bước quyết định hiệu quả mô hình. Nếu chọn quá ít trễ, mô hình bỏ lỡ các mẫu trong dữ liệu. Nhưng nếu chọn quá nhiều, nó sẽ fit nhiễu trong dữ liệu huấn luyện mà sẽ không lặp lại trong tương lai.
Bạn có hai công cụ cho việc này.
Công cụ đầu tiên là hàm tự tương quan riêng phần (PACF). Nó hiển thị tương quan giữa chuỗi và từng trễ sau khi loại bỏ ảnh hưởng của tất cả các trễ ngắn hơn. Với một quá trình AR(p), PACF có các đỉnh ý nghĩa đến trễ p và giảm về xấp xỉ 0 sau đó:
plot_pacf(train, lags=20, method="ywm")
plt.show()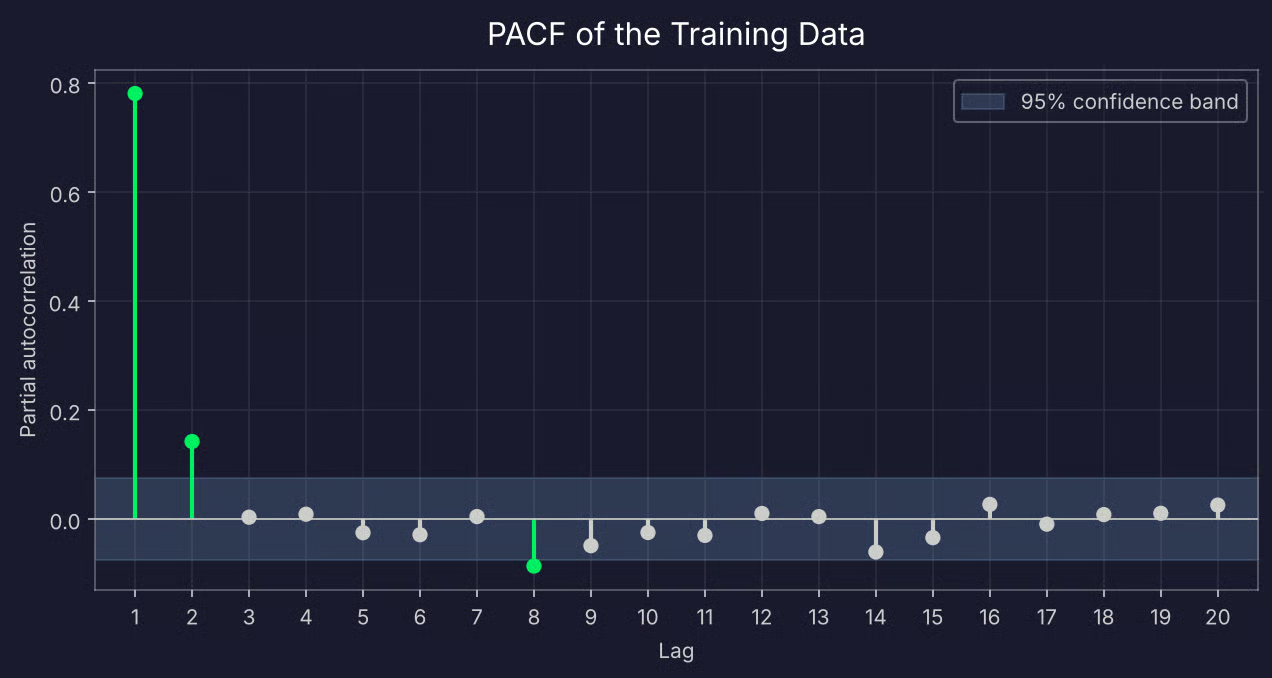
PACF của dữ liệu huấn luyện
Trễ 1 và 2 nằm xa ngoài dải tin cậy, và trễ 3 giảm gần về 0. Điều đó chỉ đến AR(2).
Cũng có một đỉnh nhỏ ở trễ 8, vừa vượt mép dải. Đừng diễn giải quá nhiều. Dải được vẽ ở mức tin cậy 95%, nên với 20 trễ, bạn kỳ vọng khoảng một trong số chúng vượt dải do ngẫu nhiên.
Công cụ thứ hai là tiêu chí thông tin. AIC và BIC đều thưởng cho mô hình fit dữ liệu tốt và phạt cho mỗi tham số thêm. BIC áp dụng hình phạt lớn hơn, nên có xu hướng chọn mô hình nhỏ hơn. statsmodels có thể thử mọi bậc đến một mức tối đa và trả về bậc tốt nhất:
for criterion in ["aic", "bic"]:
    selection = ar_select_order(train, maxlag=20, ic=criterion, trend="c")
    print(f"{criterion.upper()} selects lags: {selection.ar_lags}")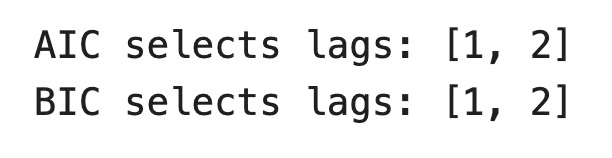
Chọn trễ theo AIC/BIC
Cả hai tiêu chí đều đồng ý với PACF. Trong thực tế, bạn thường thấy AIC chọn mô hình hơi lớn hơn BIC. Nếu vậy, hãy bắt đầu với mô hình nhỏ hơn.
Khi đã chọn bậc, fit mô hình chỉ cần hai dòng mã:
model = AutoReg(train, lags=2, trend="c")
results = model.fit()

print(results.params.round(3))
print(f"Absolute values of roots: {np.abs(results.roots).round(2)}")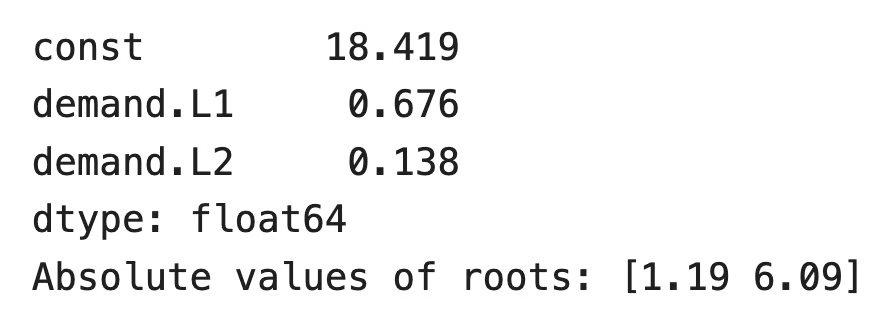
Tham số mô hình AR(2)
Giá trị thực là 0.6 và 0.25. Mô hình cho trễ thứ nhất trọng số lớn hơn một chút và trễ thứ hai nhỏ hơn, nhưng tổng hai hệ số khá gần — 0.81 so với 0.85. Với 670 điểm dữ liệu, bạn sẽ không khôi phục đúng chính xác giá trị.
Cả hai nghiệm đều có mô-đun lớn hơn 1, nên mô hình fit là dừng. Bạn có thể gọi results.summary() nếu muốn sai số chuẩn, p-value, và bảng nghiệm đầy đủ.
Có hai cách dự báo giai đoạn kiểm tra, và chúng trả lời các câu hỏi khác nhau:
Dự báo đa bước lấy trực tiếp từ kết quả fit. Với dự báo một bước, bạn áp dụng các hệ số đã huấn luyện lên toàn bộ chuỗi:
# Multi-step
multi_step = results.predict(start=len(train), end=len(df) - 1)

# One-step
full_model = AutoReg(df["demand"], lags=2, trend="c")
one_step = full_model.predict(results.params, start=len(train), end=len(df) - 1)

print(f"Multi-step MAE: {mean_absolute_error(test, multi_step):.2f} MWh")
print(f"One-step MAE: {mean_absolute_error(test, one_step):.2f} MWh")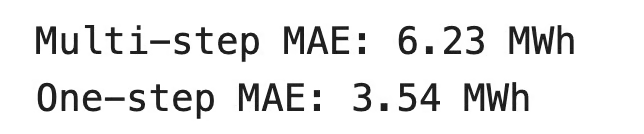
Kết quả dự báo
Sai số tuyệt đối trung bình (MAE) là chênh lệch tuyệt đối trung bình giữa dự đoán và giá trị thực. Nó cùng đơn vị với dữ liệu, nên có thể đọc trực tiếp. Dự báo một bước lệch trung bình 3.54 MWh.
So sánh hai dự báo với giá trị thực như sau:
plt.figure(figsize=(12, 4))
plt.plot(test, label="Actual")
plt.plot(one_step, label="One-step forecast")
plt.plot(multi_step, label="Multi-step forecast", linestyle="--")
plt.legend()
plt.show()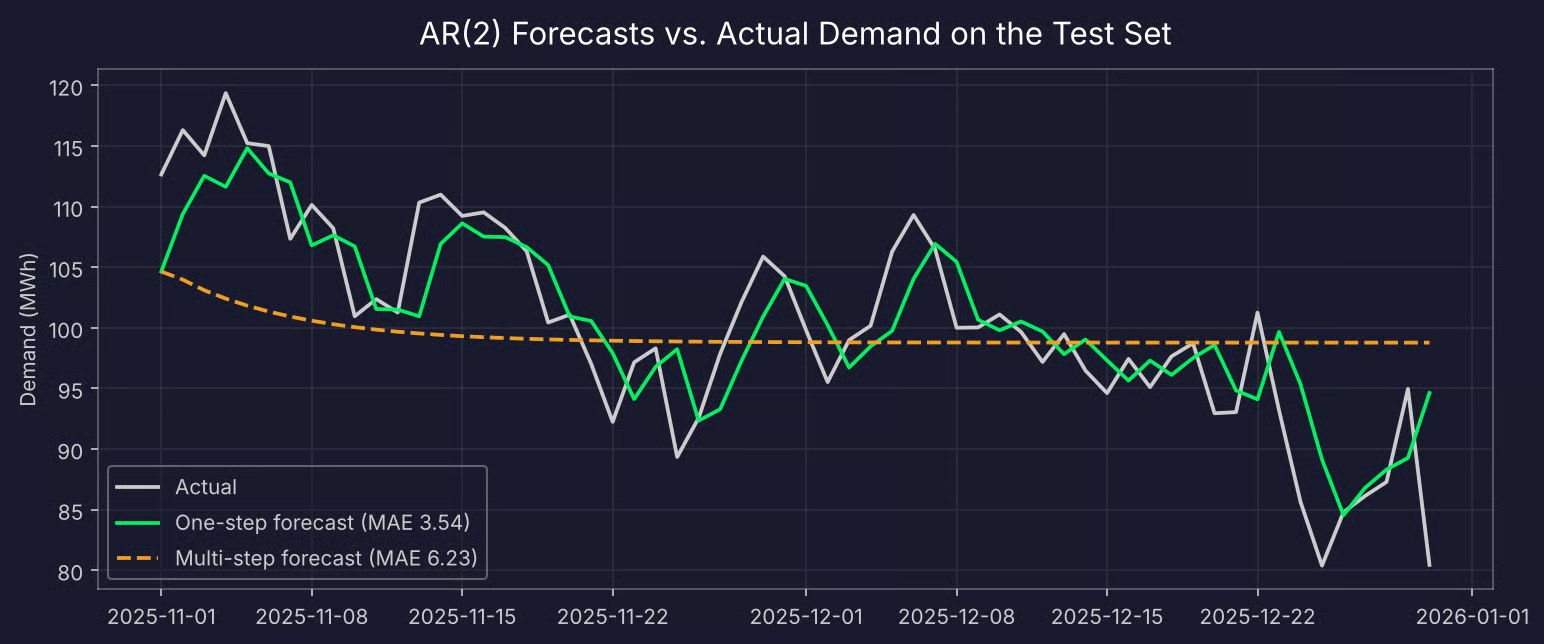
Dự báo AR(2) một bước và đa bước so với nhu cầu thực
Dự báo một bước bám sát giá trị thực, trễ khoảng một ngày. Dự báo đa bước bắt đầu tại giá trị cuối cùng đã biết rồi phẳng dần gần trung bình trong khoảng ba tuần.
Đây là cách mọi mô hình AR dừng cư xử — dự báo càng xa, quá khứ càng ít cho bạn biết, và ước đoán tốt nhất trở thành trung bình dài hạn. Đây là lý do mô hình AR hoạt động tốt nhất cho dự báo ngắn hạn.
Rất dễ cho rằng nhiều lịch sử hơn nghĩa là dự đoán tốt hơn. Hãy kiểm tra bằng cách fit các mô hình với số trễ tăng dần và so sánh MAE một bước của chúng:
for p in [1, 2, 5, 10, 20]:
    results_p = AutoReg(train, lags=p, trend="c").fit()
    preds_p = AutoReg(df["demand"], lags=p, trend="c").predict(
        results_p.params, start=len(train), end=len(df) - 1
    )
    print(f"AR({p}): MAE = {mean_absolute_error(test, preds_p):.2f} MWh")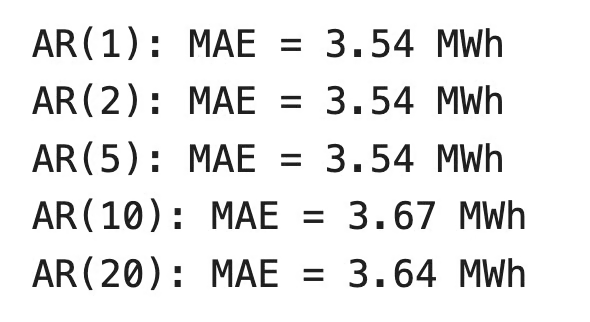
MAE khi thêm nhiều trễ
Sai số không cải thiện sau AR(2), và tệ hơn ở AR(10) và AR(20). Những hệ số thêm đó fit nhiễu trong dữ liệu huấn luyện.
Bạn cũng sẽ thấy AR(1) hiệu quả tương đương AR(2) ở đây. Hệ số thứ hai ước lượng nhỏ, nên đóng góp ít trên tập kiểm tra này. Khi hai mô hình cho kết quả như nhau, mô hình đơn giản hơn dễ giải thích hơn và ít có khả năng hỏng trên dữ liệu mới.
Còn có chi phí nữa. AR(20) ước lượng 21 tham số thay vì 3.
Tóm lại, hãy để PACF và tiêu chí thông tin gợi ý bậc, rồi xác nhận trên tập kiểm tra.
Mô hình AR phù hợp với nhiều bài toán dự báo, nhưng không phải tất cả. Dưới đây là nơi chúng hiệu quả và nơi thì không, và so sánh với các mô hình xây dựng trên chúng.
Mô hình AR có hai lợi ích chính:
Chúng cũng có hai hạn chế chính:
Còn một vấn đề nữa. Các giá trị trễ tương quan với nhau vì đến từ cùng một chuỗi. Trong dữ liệu nhu cầu, tương quan giữa y_t-1 và y_t-2 là 0.78.
Điều này được gọi là đa cộng tuyến, và nó ảnh hưởng đến bất kỳ mô hình hồi quy nào. Khi hai biến dự báo cùng biến động, mô hình khó mà biết biến nào chịu trách nhiệm. Các hệ số kém ổn định hơn và sai số chuẩn của chúng tăng.
Điều đó giải thích những gì bạn đã thấy trước đó. Mô hình ước lượng 0.676 và 0.138 thay vì 0.6 và 0.25 — nó chuyển trọng số từ một trễ sang trễ kia, nhưng tổng thì gần. Dự đoán không bị ảnh hưởng nhiều bởi điều này, nhưng bạn không thể tin cậy từng hệ số riêng lẻ như trước. Mỗi trễ thêm làm vấn đề tệ hơn.
AR là một trong ba khối xây dựng của dự báo chuỗi thời gian cổ điển. Hai mô hình còn lại là trung bình trượt (MA) và ARIMA, vốn kết hợp cả hai.
Mô hình AR dự đoán từ các giá trị quá khứ. Mô hình MA dự đoán từ các sai số quá khứ:
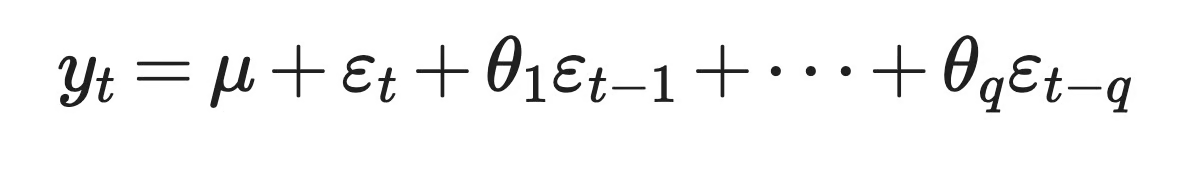
Mô hình ARMA
Ở đây, mu là trung bình của chuỗi, theta_1 đến theta_q là các hệ số, và epsilon_t-1 đến epsilon_t-q là các cú sốc ngẫu nhiên từ các bước trước. Đừng nhầm lẫn với trung bình trượt theo nghĩa trung bình lăn. Tên gọi giống nhau, nhưng mô hình khác.
Hai mô hình phản ứng với cú sốc theo những cách khác nhau. Trong mô hình MA(q), một cú sốc ảnh hưởng chuỗi đúng q bước. Trong mô hình AR, cú sốc mờ dần theo thời gian nhưng không bao giờ về đúng 0. Sự khác biệt này cũng là lý do bạn dùng các công cụ khác nhau để chọn bậc — PACF cắt sau trễ p cho mô hình AR, và ACF cắt sau trễ q cho mô hình MA.
ARIMA gộp tất cả lại. ARIMA(p, d, q) có ba phần:
Điều này nghĩa là AR là trường hợp đặc biệt của ARIMA. Nếu đặt d và q bằng 0, bạn được mô hình AR. Bạn có thể kiểm tra điều này với dữ liệu nhu cầu:
from statsmodels.tsa.arima.model import ARIMA

arima_results = ARIMA(train, order=(2, 0, 0)).fit()
print(arima_results.params.round(3))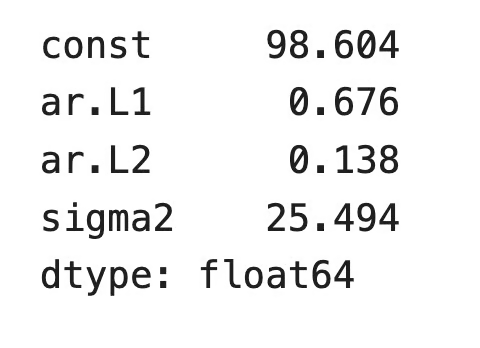
Mô hình ARIMA với bậc tích phân và trung bình trượt bằng 0
Các hệ số AR khớp với những hệ số từ AutoReg. Hằng số khác nhau vì ARIMA báo cáo trung bình của chuỗi, còn AutoReg báo cáo tung độ gốc c.
Giờ hãy xem ARIMA đi xa hơn ở đâu. Giả sử thành phố phát triển, và nhu cầu điện tăng chút ít mỗi ngày. Chuỗi nay có xu hướng, nên kiểm định ADF thất bại, và mô hình AR không còn làm việc trực tiếp với chuỗi được nữa.
Nhưng mô hình ARIMA(2, 1, 0) thì có thể. Nó sai phân chuỗi một lần, nên mô hình làm việc với thay đổi nhu cầu theo ngày thay vì giá trị thô, rồi fit AR(2) lên các thay đổi đó. Nếu một cú sốc như đợt nóng cũng ảnh hưởng đến nhu cầu ngày hôm sau, bạn có thể thêm một hạng MA và được ARIMA(2, 1, 1).
Phần AR làm cùng một việc trong mọi trường hợp. ARIMA chỉ chuẩn bị dữ liệu cho nó và mô hình hóa phần còn lại. Nếu bạn muốn đi sâu hơn, khóa học ARIMA Models in R bao quát toàn bộ quy trình.
Mô hình tự hồi quy dự đoán giá trị tiếp theo của một chuỗi từ chính quá khứ của nó. Đó là hồi quy tuyến tính trong đó các biến dự báo là các bản sao trễ của biến mục tiêu, và điều đó khiến nó là một trong những mô hình chuỗi thời gian dễ hiểu nhất.
Bạn sẽ thấy nó trong kinh tế, mã hóa giọng nói, phân tích EEG, và thậm chí trong tên gọi của các mô hình ngôn ngữ ngày nay. Bạn cũng đã thấy nơi nó không phải lựa chọn tốt nhất, vì cần dữ liệu dừng, phụ thuộc vào bậc trễ phù hợp, và các trễ tương quan khiến từng hệ số kém tin cậy hơn.
Nếu bạn hiểu mô hình AR, phần còn lại của dự báo cổ điển sẽ dễ hơn nhiều. ARIMA là bước tiếp theo tự nhiên, và hướng dẫn ARIMA của chúng tôi cho bạn thấy cách sai phân và các hạng MA mở rộng những gì bạn đã học ở đây. Với lộ trình thực hành, hãy thử khóa học ARIMA Models in Python.
Học cùng DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
